



October 9, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: October 9, 2026

Blazingly fast way to build, track and deploy your models!
يمكن لنقطة نهاية النموذج الخام أن تعيد بيانات شخصية، أو تقبل حمولة حقن أوامر، أو تقدم استجابة غير آمنة. تعالج حواجز الحماية هذه المشكلة من خلال فحص حركة البيانات وإعادة صياغتها عند الحاجة قبل وصولها إلى النموذج وقبل وصول الاستجابة إلى المستخدم.
إن وضع حواجز الحماية على بوابة الذكاء الاصطناعي يعني حصول كل تطبيق على نفس الحماية تلقائياً، دون الحاجة إلى قيام كل فريق بإعادة تنفيذ إجراءات الأمان. توفر TrueFoundry حواجز حماية مدمجة لتنقيح معلومات التعريف الشخصية واكتشاف حقن الأوامر، وكلاهما مُدار بالكامل دون الحاجة إلى ربط مفاتيح خارجية.
كما هو موضح في وثائق حواجز الحماية ، فإن تطبيق حواجز الحماية على بوابة الذكاء الاصطناعي يتم عبر خطوتين.
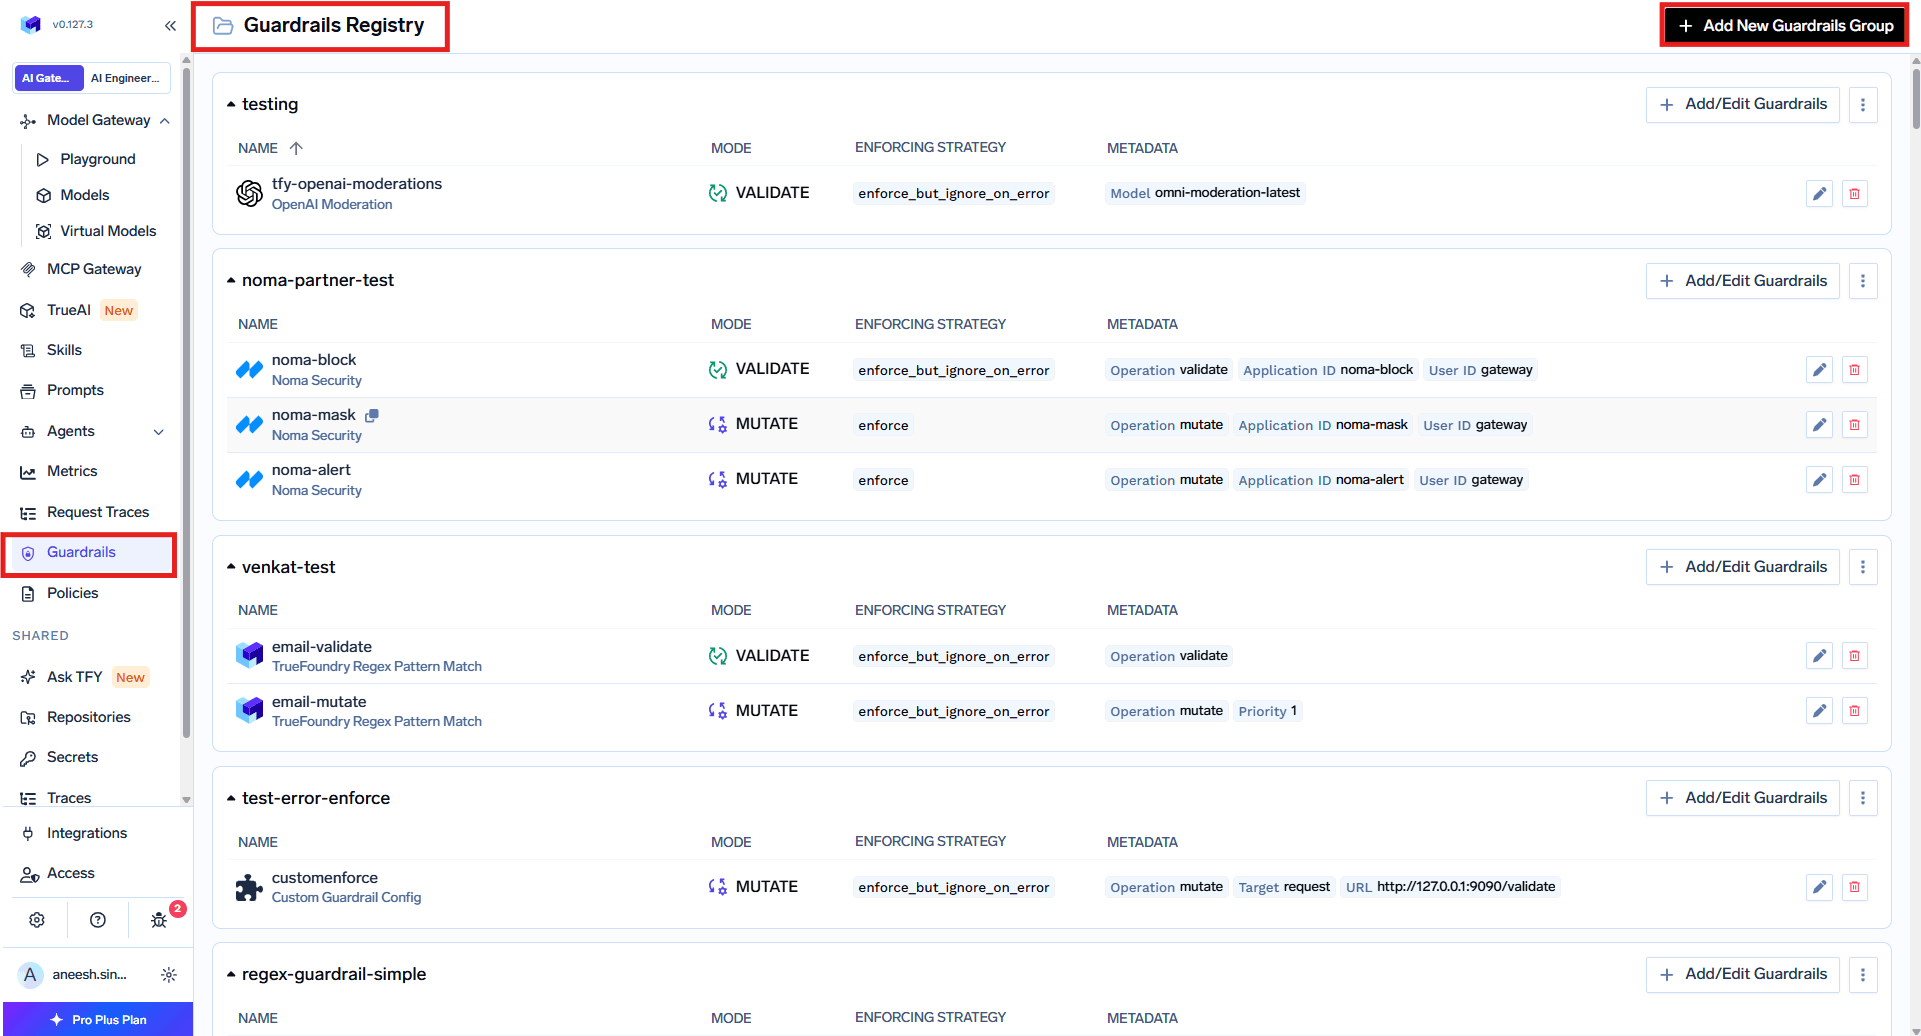
في قسم السياسات (Policies)، ثم حواجز الحماية (Guardrails)، انقر على "إضافة قاعدة" (Add Rule). تحتوي كل قاعدة على معرف فريد (Rule ID) وعدة أقسام تحدد من تنطبق عليه وأين يتم تشغيلها.
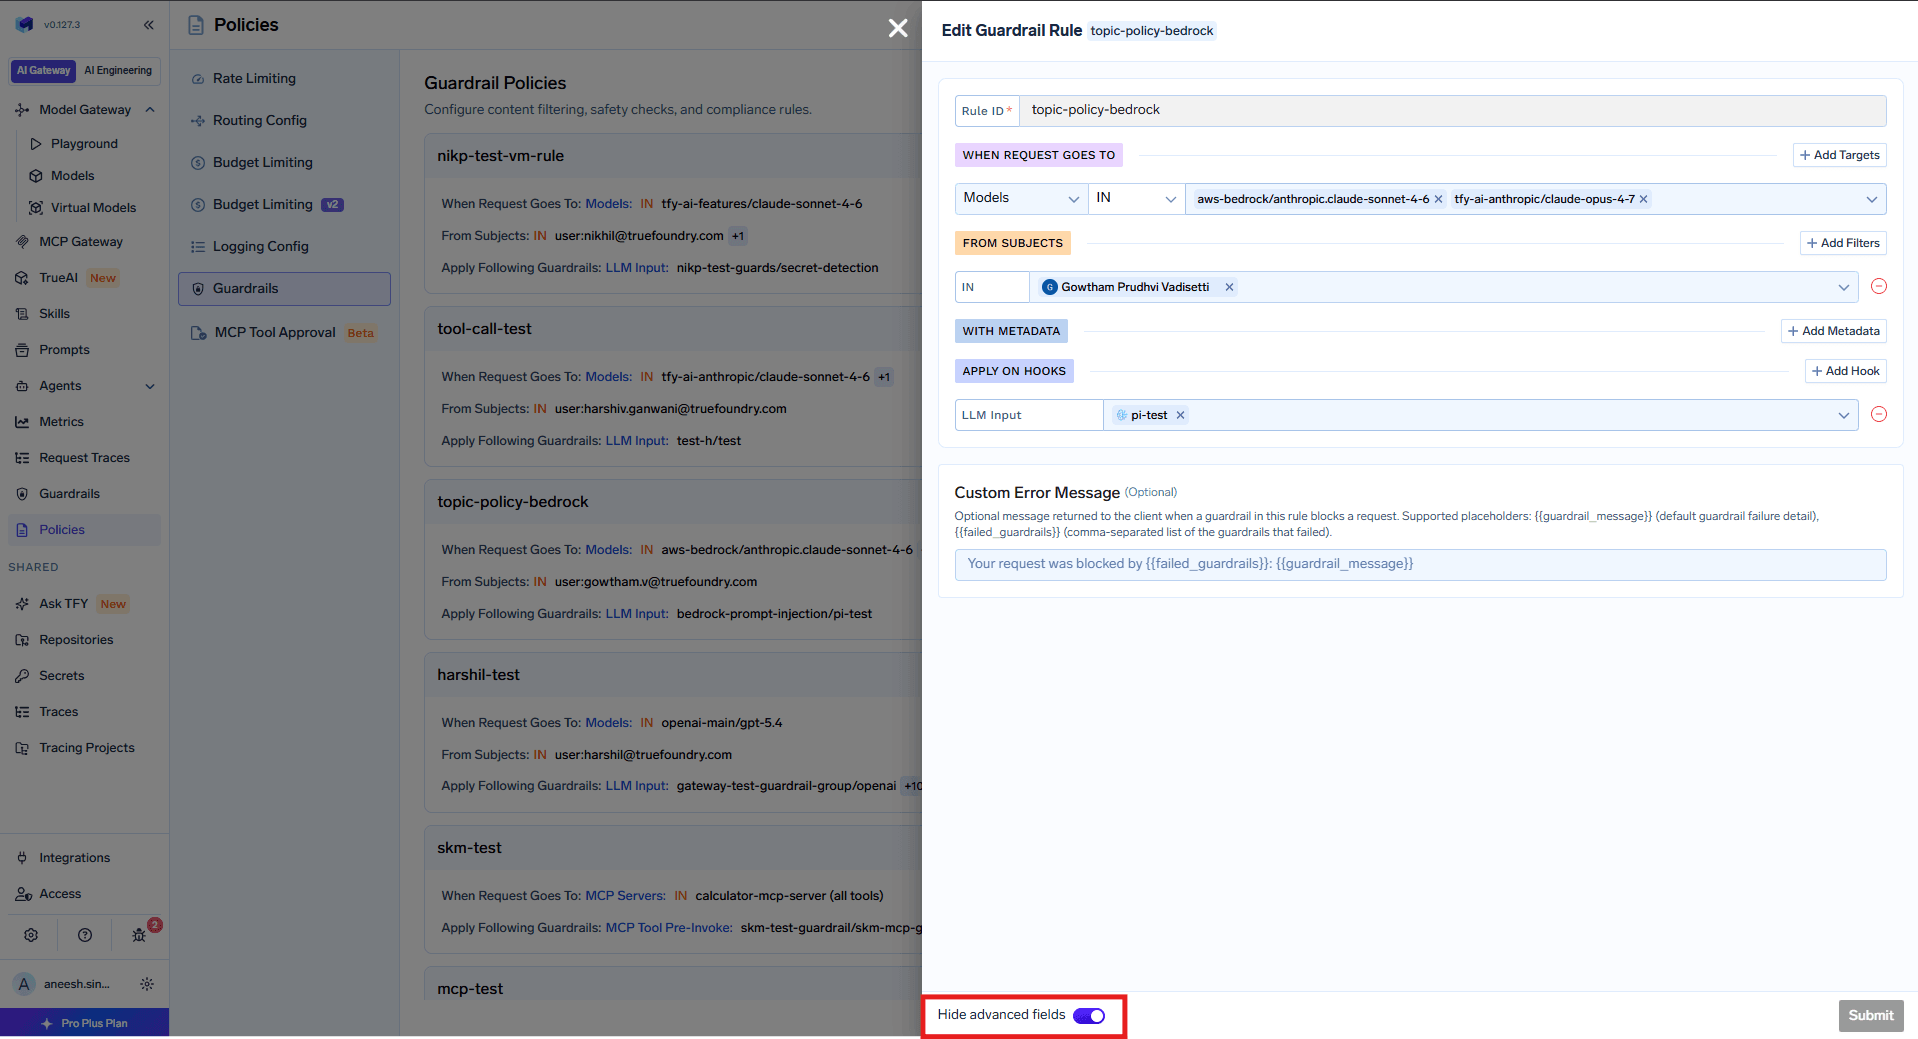
يتم تقييم جميع القواعد لكل طلب، ويتم دمج حواجز الحماية من جميع القواعد المطابقة وتطبيقها معاً. إذا كانت إحدى القواعد تطبق الكشف عن معلومات التعريف الشخصية (PII) على مدخلات نموذج اللغة الكبير، وقاعدة أخرى تطبق الكشف عن حقن المطالبات (Prompt Injection) على نفس المدخلات، فسيتم تشغيل كلتيهما.
تصفحاجز حماية الكشف عن معلومات التعريف الشخصية (PII) والمعلومات الصحية المحمية (PHI) هو حاجز حماية مدمج في TrueFoundry يقوم بتحديد وتنقيح معلومات التعريف الشخصية والمعلومات الصحية المحمية. يتم تشغيله بواسطة تقنية Azure AI Language PII Detection، وهو مدار بالكامل، لذا لا يتطلب أي مفاتيح واجهة برمجة تطبيقات (API) من أطراف خارجية.
يدعم هذا الخيار وضع التعديل (mutate mode) فقط، مما يعني أنه يقوم دائمًا بحجب الكيانات المكتشفة. في نموذج الإعدادات، يمكنك تحديد اسم، واختيار فئات معلومات التعريف الشخصية (PII) أو الإبقاء على الخيار الافتراضي الذي يشمل جميع الفئات، ثم اختيار استراتيجية التنفيذ. يتم استبدال القيم المكتشفة بعلامات النجمة، بحيث يتم إخفاء أرقام الهواتف وعناوين البريد الإلكتروني في الرسالة قبل أن يراها النموذج.
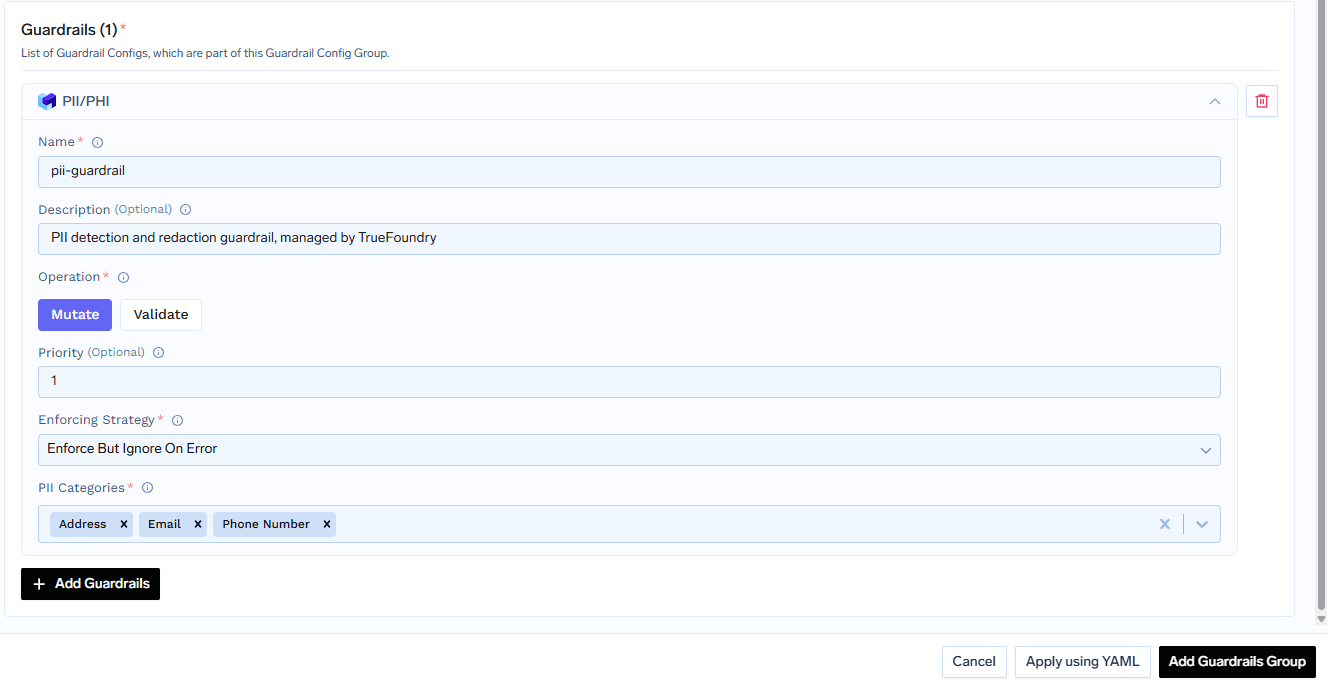
يتمثل الإعداد الشائع في تطبيق حجب معلومات التعريف الشخصية (PII) على مدخلات النموذج اللغوي الكبير (LLM) لتنقية رسائل المستخدم، وعلى مخرجاته لتنقية الردود، وكذلك على خطافات بروتوكول التحكم في النماذج (MCP) لإزالة معلومات التعريف الشخصية من معلمات الأدوات ونتائجها مثل صفوف قواعد البيانات.
تصفحاجز حماية حقن الأوامر هو حاجز حماية مدمج مدعوم بتقنية Azure Prompt Shield. يعمل على اكتشاف حقن الأوامر المباشر، وهجمات كسر الحماية (jailbreak) مثل نمط "افعل أي شيء الآن" (do anything now)، والحقن غير المباشر المخفي داخل المستندات أو محتوى السياق. يقوم النظام بتحليل مطالبة المستخدم ومحتوى المستند بشكل منفصل.
يدعم هذا الخيار وضع التحقق (validate mode) فقط، مما يعني أنه يكتشف الهجمات ويحظرها دون تعديل المحتوى. لا يتطلب الإعداد سوى اسم واستراتيجية تنفيذ. توصي الوثائق بالبدء باستراتيجية التدقيق (audit) لمراقبة الاكتشافات في سجلات الطلبات، ثم الانتقال إلى وضع التنفيذ (enforce) بمجرد التأكد من موثوقيته.
عند إرسال طلب إلى النموذج اللغوي الكبير (LLM)، تعمل حواجز حماية تعديل المدخلات أولاً وتنتظر حتى تنتهي، على سبيل المثال لحجب معلومات التعريف الشخصية من المطالبة. بعد ذلك، يتم تشغيل التحقق من المدخلات، مثل حقن الأوامر، في الخلفية أثناء معالجة طلب النموذج. إذا فشل التحقق من المدخلات بينما لا يزال النموذج قيد المعالجة، تقوم البوابة بإلغاء طلب النموذج على الفور حتى لا تتحمل تكلفته.
بعد استجابة النموذج، يمكن لعملية تعديل المخرجات إزالة البيانات السرية، كما يقوم التحقق من المخرجات بفحص النتيجة النهائية قبل وصولها إلى العميل. بالنسبة لأدوات MCP، يتم تشغيل جميع حواجز الحماية قبل استدعاء الأداة، وإذا فشل أي منها، فلن يتم تنفيذ الأداة مطلقاً. تعمل حواجز الحماية على كل استدعاء للأداة بشكل منفصل.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


TrueFoundry ships built in PII and PHI detection, powered by Azure AI Language, and prompt injection detection, powered by Azure Prompt Shield. Both are fully managed, with no external credentials required. You can also add external providers or custom guardrails.
On four hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke, and MCP Tool Post-Invoke. You attach guardrails to the hooks you want in a policy rule, and multiple guardrails can run on the same hook.
If input validation fails while the model request is in flight, the gateway cancels that model request so you do not pay for it. Output validation runs after the model responds, so in that case the model cost is already incurred.
Start with the audit enforcing strategy so detections are recorded in request traces without blocking traffic. Once you are confident in the results, switch the strategy to enforce.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد
















