


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
تكتشف معظم الفرق حاجتها إلى منصة تقييم بالطريقة نفسها: تغيير في المطالبة (prompt) بدا جيداً في كراسة التحديد (notebook) ولكنه يتراجع بشكل غير ملحوظ في بيئة الإنتاج، أو يقدم عميل لقطة شاشة لإجابة تحتوي على هلاوس (hallucination)، ولا يستطيع أحد الجزم بملائمة إصدار النموذج الجديد مقارنة بالقديم أو ما إذا كان مختلفاً فحسب. ويتضح أن السؤال "هل تطبيق LLM هذا جيد؟" لا إجابة له حتى تقوم ببناء الآلية الكفيلة بقياسه.
هذه الآلية هي ما توفره منصات تقييم LLM. لكن هذا المجال مليء بالضجيج. بعض الأدوات تركز على التقييم أولاً مع إضافة التتبع كعنصر ثانوي. وبعضها يركز على قابلية الملاحظة (observability) أولاً مع إضافة التقييمات لاحقاً. بعضها مكتبات مفتوحة المصدر تستضيفها بنفسك؛ والبعض الآخر عبارة عن برمجيات كخدمة (SaaS) مدارة. أما التحدي الأحدث فهو وكلاء الذكاء الاصطناعي (Agents): إذ إن تقييم مطالبة وإكمال منفردين يمثل مشكلة، بينما تقييم وكيل يتكون من عشر خطوات يستدعي الأدوات ويسترجع المستندات وينفذ حلقات تكرارية يمثل مشكلة أصعب بكثير.
يقدم هذا الدليل ثلاثة أمور رئيسية: يحدد دورة حياة التقييم حتى تتعرف على الإمكانيات التي تحتاجها بالفعل، ويستعرض المنصات الرئيسية (Langfuse وArize Phoenix وBraintrust وLangSmith وComet Opik وMaxim وHelicone) مع تفاصيل دقيقة حول ميزات وقصور كل منها، ويوضح مكانة بوابة الذكاء الاصطناعي (AI gateway)، لأن التتبعات وبيانات التكلفة التي تنتجها البوابة هي المادة الخام التي تستهلكها معظم منصات التقييم.
هل ترغب في الحصول على تتبعات لكل طلب، وحساب التكلفة، وحواجز حماية فورية جنباً إلى جنب مع تقييماتك؟ احجز عرضاً توضيحياً.
التقييم ليس خطوة واحدة تنفذها قبل الإطلاق، بل هو دورة تشتمل على أربع مراحل، والمنصة الاحترافية تدعمها جميعاً.
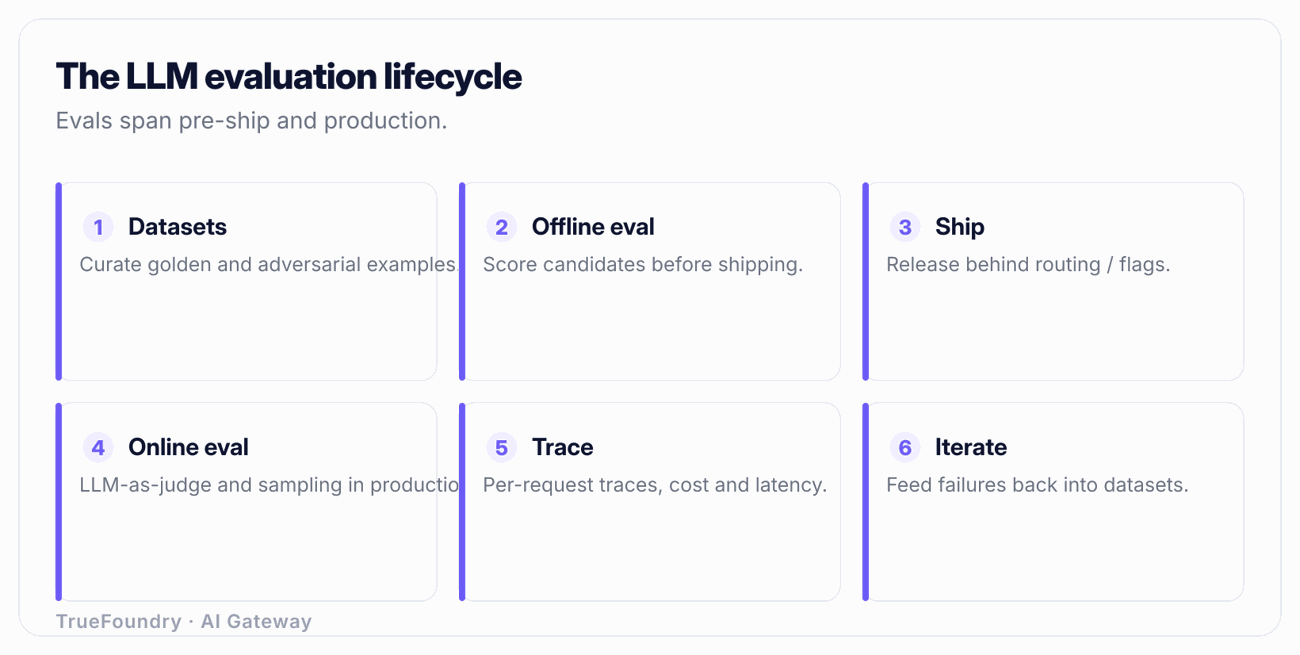
1. مجموعات البيانات (Datasets). يبدأ كل شيء بالأمثلة. مجموعة البيانات هي مجموعة من المدخلات، مرفقة اختيارياً بالمخرجات المتوقعة أو الإجابات المرجعية، والتي تمثل العمل الذي يؤديه تطبيقك. أفضل مجموعات البيانات ليست اصطناعية، بل يتم جمعها من بيئة الإنتاج: الأسئلة الحقيقية التي طرحها المستخدمون، وخاصة تلك التي شابتها أخطاء. يقوم الفريق المتمرس بانتظام بسحب تتبعات بيئة الإنتاج الفاشلة أو ذات الدرجات المنخفضة وإعادتها إلى مجموعة البيانات، بحيث تزداد صعوبة مجموعة التقييم بمضي الوقت بدلاً من البقاء جامدة عند مستوى صعوبة يوم الإطلاق.
2. التقييم غير المتصل بالإنترنت (Offline evaluation). قبل طرح أي تغيير على المطالبة أو النموذج أو استرجاع البيانات، تقوم بتشغيله مقابل مجموعة البيانات وتقييم المخرجات. تتراوح طرق التقييم من حتمية (تطابق تام، تعبيرات نمطية Regex، صحة مخطط JSON، وهل يتم تنفيذ استعلام SQL) إلى تقييم قائم على النماذج (LLM-as-judge للتحقق من الصحة والصلة بالموضوع والنبرة). التقييم غير المتصل بالإنترنت هو بوابة ما قبل الدمج: فهو يجيب على سؤال "هل جعل هذا التغيير الأمور أفضل أم أسبوع على الحالات التي أعرفها بالفعل؟"
3. التقييم المتصل بالإنترنت (Online evaluation). لا تغطي مجموعات البيانات غير المتصلة بالإنترنت كل ما قد تواجهه في بيئة الإنتاج. يقوم التقييم المتصل بالإنترنت بتشغيل أجهزة التقييم على حركة المرور الحية (عينة منها عادةً) لضبط التراجعات وأنماط الفشل الجديدة التي أغفلتها مجموعة البيانات الخاصة بك. هذا هو المكان الذي تقيس فيه أموراً مثل معدل الهلاوس في بيئة الإنتاج، ومدى صلة الإجابة، وانتهاكات حواجز الحماية في جلسات المستخدمين الحقيقية.
4. التتبع والملاحظة (Tracing and observation). الأساس الذي يرتكز عليه كلاهما هو التتبع: التقاط كل خطوة من خطوات التشغيل على شكل مقاطع هيكلية (spans). بالنسبة لروبوت دردشة بسيط، يتمثل ذلك في المطالبة المدخلة والإكمال المخرج، بالإضافة إلى عدد الرموز (tokens) وزمن الانتقال (latency). أما بالنسبة لوكيل الذكاء الاصطناعي، فالأمر عبارة عن شجرة: خطوة التخطيط، وكل استدعاء أداة مع وسائطها ونتائجها، وكل عملية استرجاع مع الأجزاء (chunks) المعادة، وكل استدعاء نموذج مع مطالبته ومخرجاته. بدون هذه الشجرة، يمكنك تقييم الإجابة النهائية للوكيل ولكن لا يمكنك معرفة سبب الخطأ، سواء كان الاسترجاع قد فشل، أم حدث خطأ في الأداة، أم أهمل النموذج السياق الجيد.
تكتمل الدورة عندما تعود النتائج من المرحلتين 3 و4 إلى المرحلة 1. تجعل المنصة الجيدة ذلك يتم بنقرة واحدة: انظر إلى تتبع سيئ في بيئة الإنتاج، وأضفه إلى مجموعة البيانات، وأعد تشغيل التقييم غير المتصل بالإنترنت مقابله باستمرار.
يضيف تقييم الوكيل مشكلتين. أولاً، المسار (trajectory) مهم، وليس فقط الإجابة النهائية. يمكن للوكيل الوصول إلى إجابة صحيحة عبر مسار معطوب (ثلاثة استدعاءات أدوات مكررة، واسترجاع أعاد بيانات لا قيمة لها أهملها النموذج بالصدفة) وتلك الهشاشة ستؤثر عليك لاحقاً. يجب عليك تقييم الخطوات وليس النتيجة فقط. ثانياً، تراكم عدم الحتمية (non-determinism). الوكيل المكون من عشر خطوات حيث تحتوي كل خطوة على بعض التباين ينتج عمليات تشغيل مختلفة تماماً من المدخلات نفسها، لذا فأنت بحاجة إلى عمليات تشغيل متعددة لكل حالة وتقييم تجميعي، وليس مجرد نجاح أو إخفاق لمرة واحدة.
بالنسبة لأي مخرجات مفتوحة، مثل الملخصات، أو إجابات الدردشة، أو الحقول المستخرجة ذات الصحة غير المحددة بدقة، لا يمكنك كتابة تعبير نمطي (regex). المقيّم العملي هو نموذج LLM آخر يتم توجيهه بمطالبة لتقييم المخرجات: LLM-as-judge.
إنها طريقة فعالة، ولكن مع محاذير تفصل بين الفرق التي تثق بفي تقييماتها والفرق التي تتعرض للمشاكل:
توفر كل منصة مذكورة أدناه خيار LLM-as-judge. وتكمن الاختلافات في مدى سهولة المعايرة، وتحديد القواعد، والحفاظ على إصدارات الحكم.
لا توجد أداة واحدة هي الأفضل للجميع. إليك استعراض واقعي للمنصات.
Langfuse. منصة مفتوحة المصدر (قابلة للاستضافة الذاتية أو سحابية مدارة)، وهي الخيار الأكثر إكمالاً بين البرمجيات مفتوحة المصدر. تجمع بين التتبع، والتقييمات، وإدارة المطالبات، ومجموعات البيانات في نظام واحد. ممتازة للفرق التي ترغب في الاستضافة الذاتية لأسباب تتعلق بإقامة البيانات والحصول على قابلية الملاحظة والتقييم دون الحاجة إلى تجميع ثلاث أدوات معاً. نموذج التتبع فيها مرن وغير مرتبط بإطار عمل معين. إذا كنت تريد منصة واحدة مفتوحة المصدر تغطي معظم دورة الحياة، فهذه هي المنصة الأولى التي تجدر تجربتها. راجع نظرتنا العامة على أدوات قابلية ملاحظة LLM لمعرفة موقعها في مشهد قابلية الملاحظة الأوسع.
Arize Phoenix. مفتوحة المصدر وتعتمد أساساً على OpenTelemetry، وهي ميزتها المحددة. تطبق Phoenix الاصطلاحات الدلالية لـ OTel لمقاطع LLM، لذا فإن التتبعات تتوافق مع البنية التحتية التي قد تكون تشغلها بالفعل، وتتجنب الانغلاق في صيغ تتبع ملكية. قوية في استكشاف أخطاء استرجاع البيانات وRAG وإصلاحها (فحص التضمين والتجزئة). إذا كانت مؤسستك تعتمد قياسيا على OpenTelemetry، فإن Phoenix هي الخيار الطبيعي. تبيع Arize أيضاً منتج مؤسسي مداد فوق النواة مفتوحة المصدر.
Braintrust. منصة مدارة تركز على التقييم أولاً. فكرتها هي التقييم كجزء من التكامل المستمر (evals-as-CI): حيث تقوم بربط التقييم بدورة التطوير لديك بحيث يتم تشغيل كل مطالبة أو تغيير في الكود مقابل مجموعات البيانات تلقائياً، مع مقارنة الدرجات تماماً مثل نتائج الاختبارات. واجهة تجربة تجريب قوية لمقارنة متغيرا المطالبات والنماذج جنباً إلى جنب. أفضل للفرق التي تكمن مشكلتها الرئيسية في "أننا نغير المطالبات باستمرار ولا نملك بوابة لمنع التراجع". وهي أقل في الاستضافة الذاتية وقابلية الملاحظة الكاملة مقارنة بـ Langfuse.
LangSmith. منصة مدارة، بناها فريق LangChain وهي مدمجة بعمق مع LangChain وLangGraph. إذا كانت بنيتك البرمجية اعتمد بالفعل على LangChain، فإن التتبع يكون شبه مجاني، وتأتي أجهزة القياس تلقائياً، وتكون عروض مسار الوكيل قوية. العيب هو أن التجربة الأكثر تكاملاً تفترض وجود بيئة LangChain؛ وخارجها، تظل صالحة للاستخدام ولكنها أقل فائدة مقارنة بالخيارات الأخرى.
Comet Opik. منصة مفتوحة المصدر، من سلسلة Comet (تتبع تجارب التعلم الآلي). تغطي التتبع والتقييمات، وتتميز بتوفير فحوصات على نمط حواجز الحماية إلى جانب التقييم. مناسبة للفرق التي تستخدم بالفعل Comet لتتبع تجارب التعلم الآلي التقليدي وترغب في إبقاء أعمال LLM في المكان نفسه، أو التي تريد أداة تقييم مفتوحة المصدر مع فحوصات إشراف مدمجة.
Maxim AI. منصة تقييم وقابلية ملاحظة توفر أيضاً Bifrost، وهي بوابة ذكاء اصطناعي مفتوحة المصدر. العرض المدمج هو "التقييم والملاحظة والتوجيه عبر مورد واحد". الفجوة التي يواجهها المشترون هي أن التقييمات والبوابة هما عملياً منتجان منفصلان وليسا لوحة تحكم واحدة، وتسعير البوابة غير معلن (يتطلب طلب الوصول)، كما أنها مورد أحدث ذات نتائج قياسية يتم الإبلاغ عنها ذاتياً إلى حد كبير. إذا كنت تفاضل بين Maxim أو بوابة Bifrost التابعة لها، فقارن عمق التقييم مقابل عمق البوابة والحوكمة بشكل منفصل، لأن أدوات قليلة فقط تعتبر الأفضل في كلا المجالين.
Helicone. منصة مفتوحة المصدر تتوجه نحو قابلية الملاحظة والوكيل (Proxy). تعمل كوكيل خفيف الوزن أمام استدعاءات النموذج وتلتقط السجلات وزمن الانتقال والتكلفة بالحد الأدنى من التكامل (تغيير عنوان URL الأساسي). التقييمات موجودة ولكنها أخص بساطة من منصات التقييم المخصصة. تكون الخيار الأفضل عندما تكون أولويتك هي قابلية الملاحظة السريعة والرخيصة بتكلفة إعداد منخفضة وتعتبر التقييم العميق أمراً ثانوياً.
إليك مقارنة ملخصة:
تعرف على كيفية إضافية TrueFoundry لقابلية الملاحظة والحوكمة إلى بيئة التقييم لديك. احجز عرضاً توضيحياً.
ينحصر الاختيار من القائمة أعلاه في مجموعة من المحاور. قم بتقييم المرشحين بناءً على هذه المحاور بدلاً من الاعتماد على التسويق القائم على عدد الميزات.
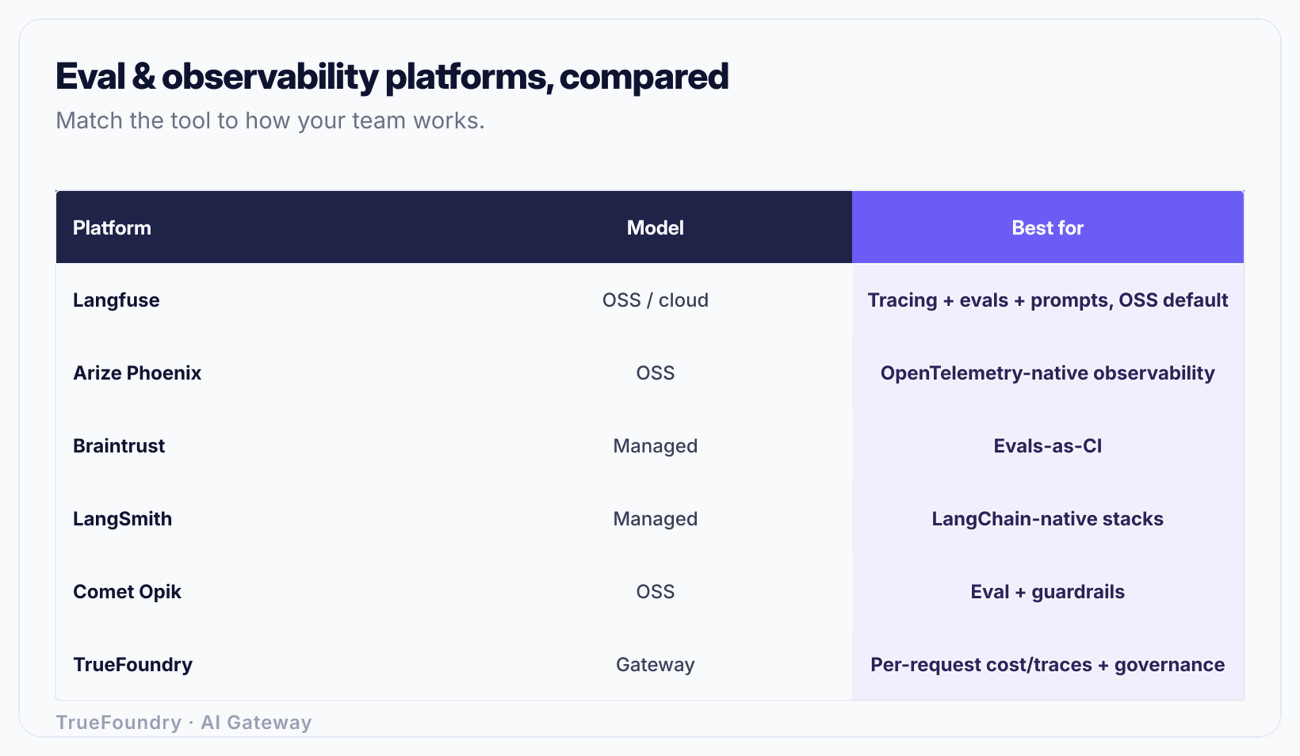
طريقة عملية لاستخدام هذه الشبكة: إذا كان القيد الصارم لديك هو "عدم خروج بيانات العملاء من VPC الخاص بنا"، فقد قمت على الفور بتقليص الخيارات إلى البرمجيات مفتوحة المصدر القابلة للاستضافة الذاتية (Langfuse، Phoenix، Opik) أو خطة مؤسسية تتضمن النشر داخل VPC، بينما تستبعد الأدوات المدارة فقط بغض النظر عن مدى جودة واجهتها. ابدأ من الشروط غير القابلة للتقاوض، ثم قم بالتحسين ضمن ما يتبقى.
تحتاج منصة التقييم إلى بيانات لتقييمها: التتبعات، والمطالبات، والإكمالات، وعدد الرموز، وأزمنة الانتقال، والتكلفة لكل استدعاء. من أين يأتي ذلك؟ بالنسبة لتطبيق واحد، يمكنك تزويده بأجهزة القياس مباشرة. أما بالنسبة لمؤسسة تشغل عشرات التطبيقات والوكلاء عبر العديد من مزودي النماذج، فإن المصدر الأكثر تنظيماً هو الطبقة التي تمر عبرها جميع الاستدعاءات بالفعل: بوابة الذكاء الاصطناعي (AI gateway).
تقع بوابة مثل TrueFoundry أمام جميع حركة مرور النماذج والمزودين خلف واجهة برمجة تطبيقات (API) موحدة ومتوافقة مع OpenAI. ونظراً لأن كل طلب يمر عبرها، فإنها تصدر قابلية ملاحظة لكل طلب: الرموز المدخلة والمخرجة، وزمن الانتقال، والنموذج والمزود المستخدمان، والتكلفة، وكلها معنونة بحسب المستخدم والفريق والتطبيق. هذا هو بالضبط التدفق الذي تريد منصة التقييم استيعابه، ويصل دون الحاجة إلى أدوات قياس لكل تطبيق لأن البوابة تنتجه بشكل مركزي.
تشغل البوابة أيضاً حواجز الحماية فورياً أثناء الاستدعاء، مثل الكشف عن معلومات الهوية الشخصية (PII)، وفحوصات اختراق المطالبات (prompt-injection)، وفحص أسرار النظام، وهي مهمة مختلفة عن التقييم غير المتصل بالإنترنت. تقوم حواجز الحماية بحظر أو تحديد الطلب أو الاستجابة السيئة فور حدوثها؛ بينما تقيس التقييمات الجودة بعد وقوع الحدث مقابل مجموعات البيانات وعينات بيئة الإنتاج. أنت بحاجة إلى الاثنين معا. فحاجز الحماية يمنع الضرر الظاهر في مسار الطلب؛ بينما تخبرك منصة التقييم ما إذا كانت جودة الإجابة تتجه للارتفاع أم الانخفاض عبر الأسابيع.
توزيع المهام واضح: تمتلك البوابة مسار الطلب (التوجيه، الاستعادة عند الفشل، التخزين المؤقت، الميزانيات، حواجز الحماية الفورية، وإصدار التتبعات)؛ بينما تمتلك منصة التقييم دورة القياس (مجموعات البيانات، التقييم المتصل وغير المتصل بالإنترنت، LLM-as-judge، ومقارنة التجارب). توفر TrueFoundry جانب البوابة وتغذية قابلية الملاحظة؛ بينما تستهلكها منصة تقييم مخصصة من القائمة أعلاه. بالنسبة للفرق التي توحد التكلفة والحوكمة عبر العديد من النماذج، فإن الجمع بين الاثنين أفضل من محاولة إجبار أي أداة على القيام بجميع المهام. يقدم دليلنا حول أفضل منصات قابلية الملاحظة للنماذج اللغوية الكبيرة في 2026 تفاصيل أعمق حول جانب قابلية الملاحظة تحديدا.
التعامل مع LLM-as-judge كحقيقة مطلقة. الحكم هو نموذج ذو تحيزات وأنماط فشل خاصة به. الفرق التي تطرح حكماً دون معايرته مقابل التسميات البشرية تنتهي بتطوير تطبيقها لإرضاء مقيّم غير معايَر، وهو أمر أسوأ من عدم وجود تقييم لأنه يعطي انطباعاً بالدقة بينما هو خاطئ. قس دائماً مدى التوافق بين الحكم والبشر أولاً.
تقييم الإجابة النهائية لوكيل الذكاء الاصطناعي فقط. الإجابة الصحيحة من مسار معطوب تعد خطأ برمجياً كامناً. إذا لم تقم بزيادة درجات الخطوات المتوسطة، فلن تلاحظ أن وكيلك يصل إلى الإجابة الصحيحة عبر ثلاثة استدعاءات أدوات غير ضرورية واسترجاع أهمله، حتى يؤدي تغيير بسيط إلى إفشاله دون أن تدري السبب.
تجميد مجموعة البيانات عند الإطلاق. تقيس مجموعة التقييم الثابتة صعوبة يوم الإطلاق للأبد بينما تتغير بيئة الإنتاج باستمرار. وبدون وجود دورة تسحب باستمرار تتبعات الإنتاج الفاشلة وتُعيدها إلى مجموعة البيانات، سيفقد شريط التقييم الأخضر معناه بمرور الوقت.
شراء أداة تقييم لمشكلة يجب أن يحلها حاجز حماية. إذا كانت حاجتك الحقيقية هي "حظر معلومات الهوية الشخصية واختراق المطالبات في مسار الطلب"، فإن ذلك يتطلب حواجز حماية فورية عند البوابة، وليس مجموعة تقييم غير متصلة بالإنترنت. وعلى العكس، فإن تشغيل مجموعات بيانات غير متصلة بالإنترنت لرصد الهجمات الحية يعتبر بطيئاً جداً. طابق الأداة مع ما إذا كان الفحص يحدث داخل المسار أم بعد وقوع الحدث.
تجاهل إقامة البيانات حتى مرحلة المشتريات. تختار الفرق أداة تقييم مدارة بناءً على واجهة المستخدم، ثم تكتشف في مراجعة الأمان أن مطالبات الإنتاج التي تحتوي على بيانات العملاء لا يمكنها الخروج من VPC. حدد مسألة البرمجيات مفتوحة المصدر مقابل المدارة وطريقة النشر أولاً؛ فهذا يستبعد الخيارات أسرع من أي ميزة أخرى.
التقييم هو النهج الذي يحول عبارت "الذكاء الاصطناعي يبدو أفضل الآن" إلى رقم يمكنك الدفاع عنه. لا تختلف المنصات كثيراً في كونها تجري تقييمات، فجميعها تفعل ذلك، بل تختلف في كيفية تعاملها مع دورة الحياة الكاملة: انتقاء مجموعات البيانات، الحظر قبل الطرح، المراقبة الحية، تتبع مسار الوكيل، وLLM-as-judge المعايَر. ابدأ من قيودك الصارمة (إقامة البيانات، إطار العمل الحالي، مفتوح المصدر مقابل مدار)، وقيم الخيارات القصيرة مقابل شبكة الاختيار، واحرص على الدورة الكاملة بدلاً من بيئة اختبار ذات مرحلة واحدة.
وتذكر أن التقييم لا يعمل بمعزل عن غيره. فالجسر أو البوابة التي تسبق نماذجك تنتج بالفعل التتبعات وبيانات التكلفة التي تحتاجها منصة التقييم لديك، وتفرض حواجز حماية في مسار الطلب لا يمكن للتقييمات غير المتصلة بالإنترنت تطبيقها. يمنحك ربط منصة تقييم قوية ببوابة توفر قابلية ملاحظة نظيفة لكل طلب وعناصر تحكم فورية كلاً من شبكة الأمان في الوقت الفعلي وإشارة الجودة طويلة المدى التي تحافظ على موثوقية منتج LLM الخاص بك.
اربط تقييماتك ببوابة محوكمة. احجز عرضاً توضيحياً.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




