October 16, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
Em 23 de julho de 2026, a OpenAI tem programado o encerramento de 15 entradas de modelos listadas — uma combinação de snapshots datados e aliases abrangendo APIs de Codex, chat, deep-research, busca, áudio, tempo real e uso computacional, conforme sua página de descontinuações. A tarefa imediata é a migração. O problema de engenharia duradoura é a propriedade da dependência: o código da aplicação não deve depender diretamente de identificadores cujos ciclos de vida são controlados por um provedor de modelos.
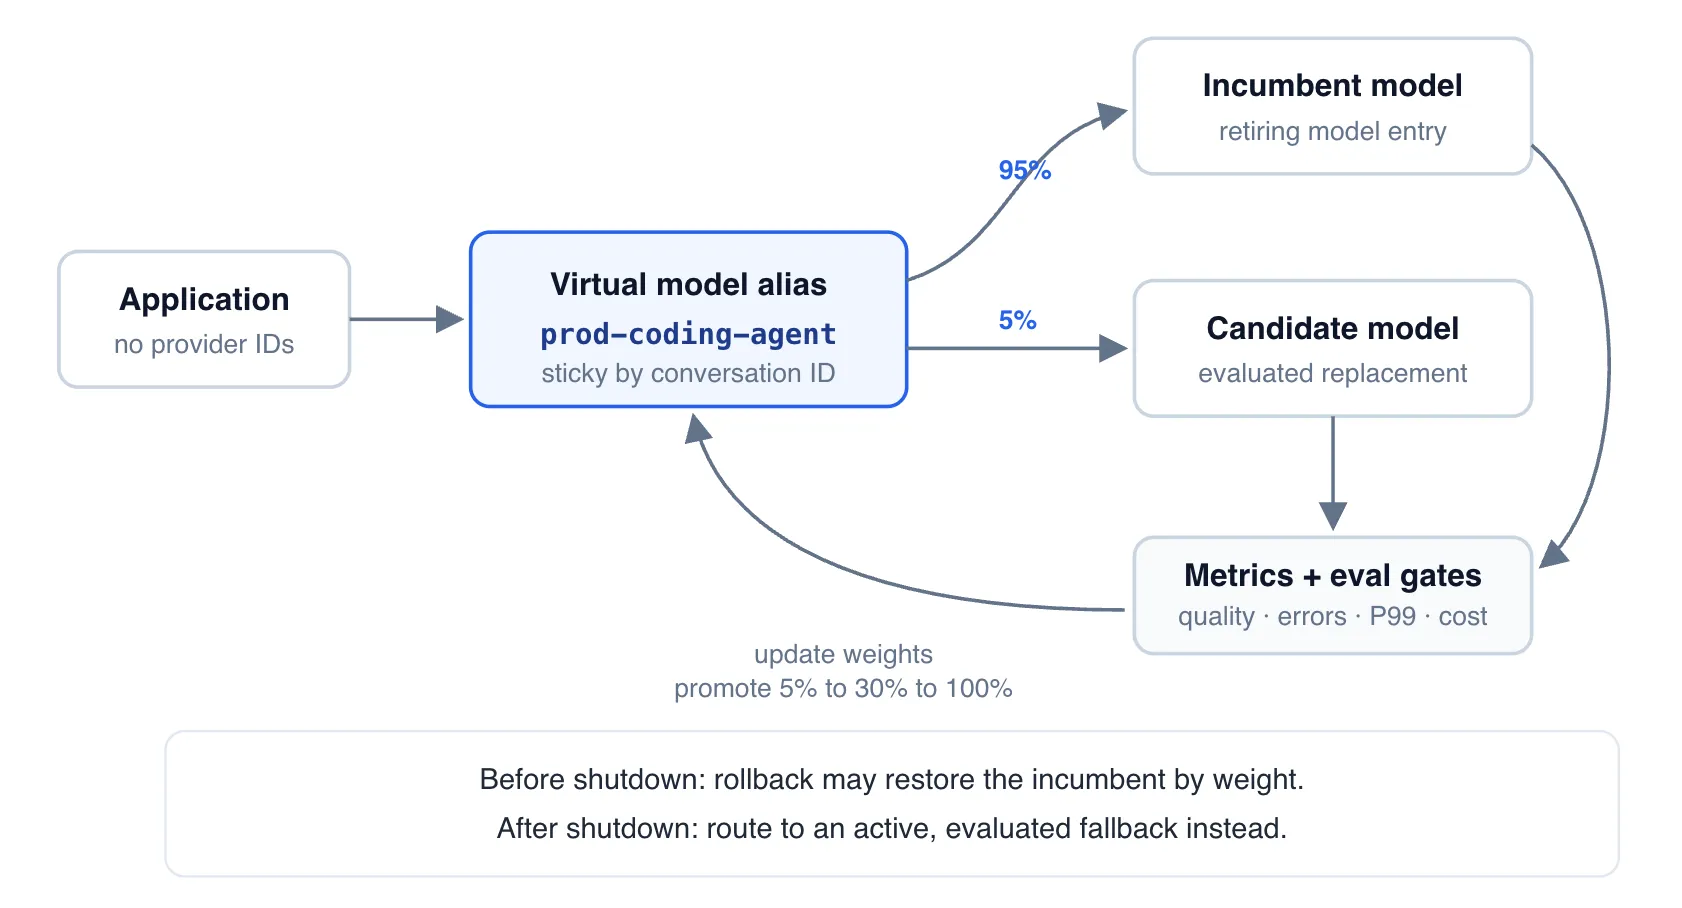
Este artigo descreve um padrão operacional mais seguro — inventariar o uso atual, colocar um alias de modelo virtual estável entre as aplicações e os modelos do provedor, avaliar substituições com base em testes específicos da carga de trabalho, transferir o tráfego síncrono através de um canário ponderado e preservar um caminho de reversão rápida.
A página de descontinuações da OpenAI define a semântica diretamente: um modelo torna-se descontinuado no momento do anúncio — ele ainda funciona, mas agora possui uma data de encerramento — e, uma vez encerrado, as solicitações para ele não são mais processadas. A política de aviso publicada é de pelo menos seis meses para modelos disponíveis de forma geral e pelo menos três meses para variantes especializadas, como modelos Codex e chat-latest. Modelos de visualização (preview) podem receber avisos com apenas duas semanas de antecedência, e a OpenAI desaconselha explicitamente o uso de visualizações para cargas de trabalho de produção críticas para o negócio, a menos que a equipe possa migrar rapidamente (página de descontinuações da OpenAI).
O anúncio de 22 de abril estabeleceu dois lotes concentrados de encerramento: 15 entradas listadas em 23 de julho e, em 23 de outubro, um conjunto adicional de snapshots e aliases legados de GPT-3.5, GPT-4, GPT-4 Turbo, GPT-4.1 Nano, GPT-4o e da série o, juntamente com gpt-image-1 e várias famílias de modelos base ajustados (fine-tuned). Observe o que 23 de outubro não é: não é toda a família GPT-4, e não é toda a série o — os snapshots datados o3-2025-04-16eo3-pro-2025-06-10 estão listados separadamente para 11 de dezembro, e apenas o gpt-4o-2024-05-13 o snapshot aparece a partir da linha GPT-4o.
A sequência de modelos de imagem merece atenção como precedente. Quando o DALL·E 2 e 3 foram desativados em 12 de maio, a OpenAI havia listado gpt-image-2,gpt-image-1, ougpt-image-1-mini como substitutos recomendados. As equipes que selecionaram gpt-image-1-mini precisam agora migrar novamente antes de seu desligamento em 1º de dezembro, e gpt-image-1 tem seu desligamento agendado para 23 de outubro. A lição é generalizável: o alvo da migração também pode estar no calendário, e uma arquitetura cuja resposta à descontinuação seja editar strings de modelo em toda parte e reimplantar repetirá esse trabalho conforme o ritmo do fornecedor.
Este não é um padrão de apenas um provedor. A Anthropic lista o Claude Opus 4.1 para aposentadoria em 5 de agosto de 2026, com uma política documentada de pelo menos 60 dias de aviso prévio para modelos lançados publicamente (descontinuações de modelos da Anthropic). O Google lista 16 de outubro de 2026 como a data mais próxima de desligamento para o Gemini 2.5 Pro, Flash e Flash-Lite, e um modelo de visualização — gemini-3.1-flash-lite-preview — funcionou de 3 de março a 25 de maio de 2026, menos de três meses do lançamento ao desligamento (descontinuações do Gemini). A própria documentação da API da DeepSeek diz que os aliases legados deepseek-chatedeepseek-reasoner será descontinuado em 24 de julho de 2026, sendo mapeado para compatibilidade com os modos de raciocínio e sem raciocínio do deepseek-v4-flash; ele não identifica essa data como um encerramento (Modelos e preços da DeepSeek). Esses quatro provedores publicam alterações no ciclo de vida dos modelos; seus períodos de aviso e mapeamentos de migração diferem.
Todo guia de migração começa com "audite seu uso", e toda equipe de plataforma sabe por que essa etapa é negligenciada: IDs de modelos ficam escondidos em configurações de serviço, constantes de notebooks, pipelines de CI, padrões de frameworks, arquivos de configuração de agentes de codificação e ferramentas de terceiros que ninguém se lembra de ter adotado. O Grep encontra as strings em seus repositórios; ele não encontra o volume, o proprietário ou o tráfego que se origina fora do controle de versão. O censo confiável é observacional: se cada chamada de modelo passa por um gateway, então o uso por modelo — dividido por equipe, aplicação, usuário e conta virtual, com custos associados — é uma consulta de painel, e a pergunta "quem ainda chama este modelo que está sendo desativado" tem uma resposta em tempo real, com nomes e valores financeiros. A própria orientação da Anthropic aponta na mesma direção, recomendando que os clientes exportem auditorias de uso por chave e por modelo antes de migrar. Esse censo também é a função de priorização: um modelo com três chamadas residuais por dia de um job em lote esquecido é um chamado; um que sustenta um recurso voltado ao cliente com um custo de seis dígitos por mês é um projeto.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada