November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O Haiku representa o modelo de entrada da Anthropic — o tipo de modelo acionado para tarefas de carga de trabalho pesadas e sensíveis ao tempo. Classificação, extração, roteamento, reescritas curtas, formatação de chamadas de ferramentas, rascunhos de primeira passagem: trabalhos em que uma resposta suficientemente capaz retornada de forma rápida e barata supera uma resposta ligeiramente melhor que custa 20× mais e demora mais tempo.
O Haiku 5.5 foi lançado em 7 de outubro de 2026. O destaque principal é a redução de preço: a Anthropic reduziu a taxa por token em até 90% em comparação com o Haiku 4.5, mantendo os recursos de nível avançado — uma janela de contexto de 1 milhão de tokens, saída máxima de 128K, prompt caching e a Batch API. Pela primeira vez, a versão econômica não é uma versão simplificada.
No entanto, há muita complexidade por trás dessa mudança. Existe uma quebra de nível na tabela de tarifas que faz sua fatura subir silenciosamente. O custo por token dá pouca pista sobre quanto qualquer coisa realmente custa. Esta análise explora ambos os aspectos.
Aqui está a tabela de tarifas completa ao lado do Haiku 4.5 e do Sonnet 5.5, para que as diferenças fiquem visíveis em ambas as direções.
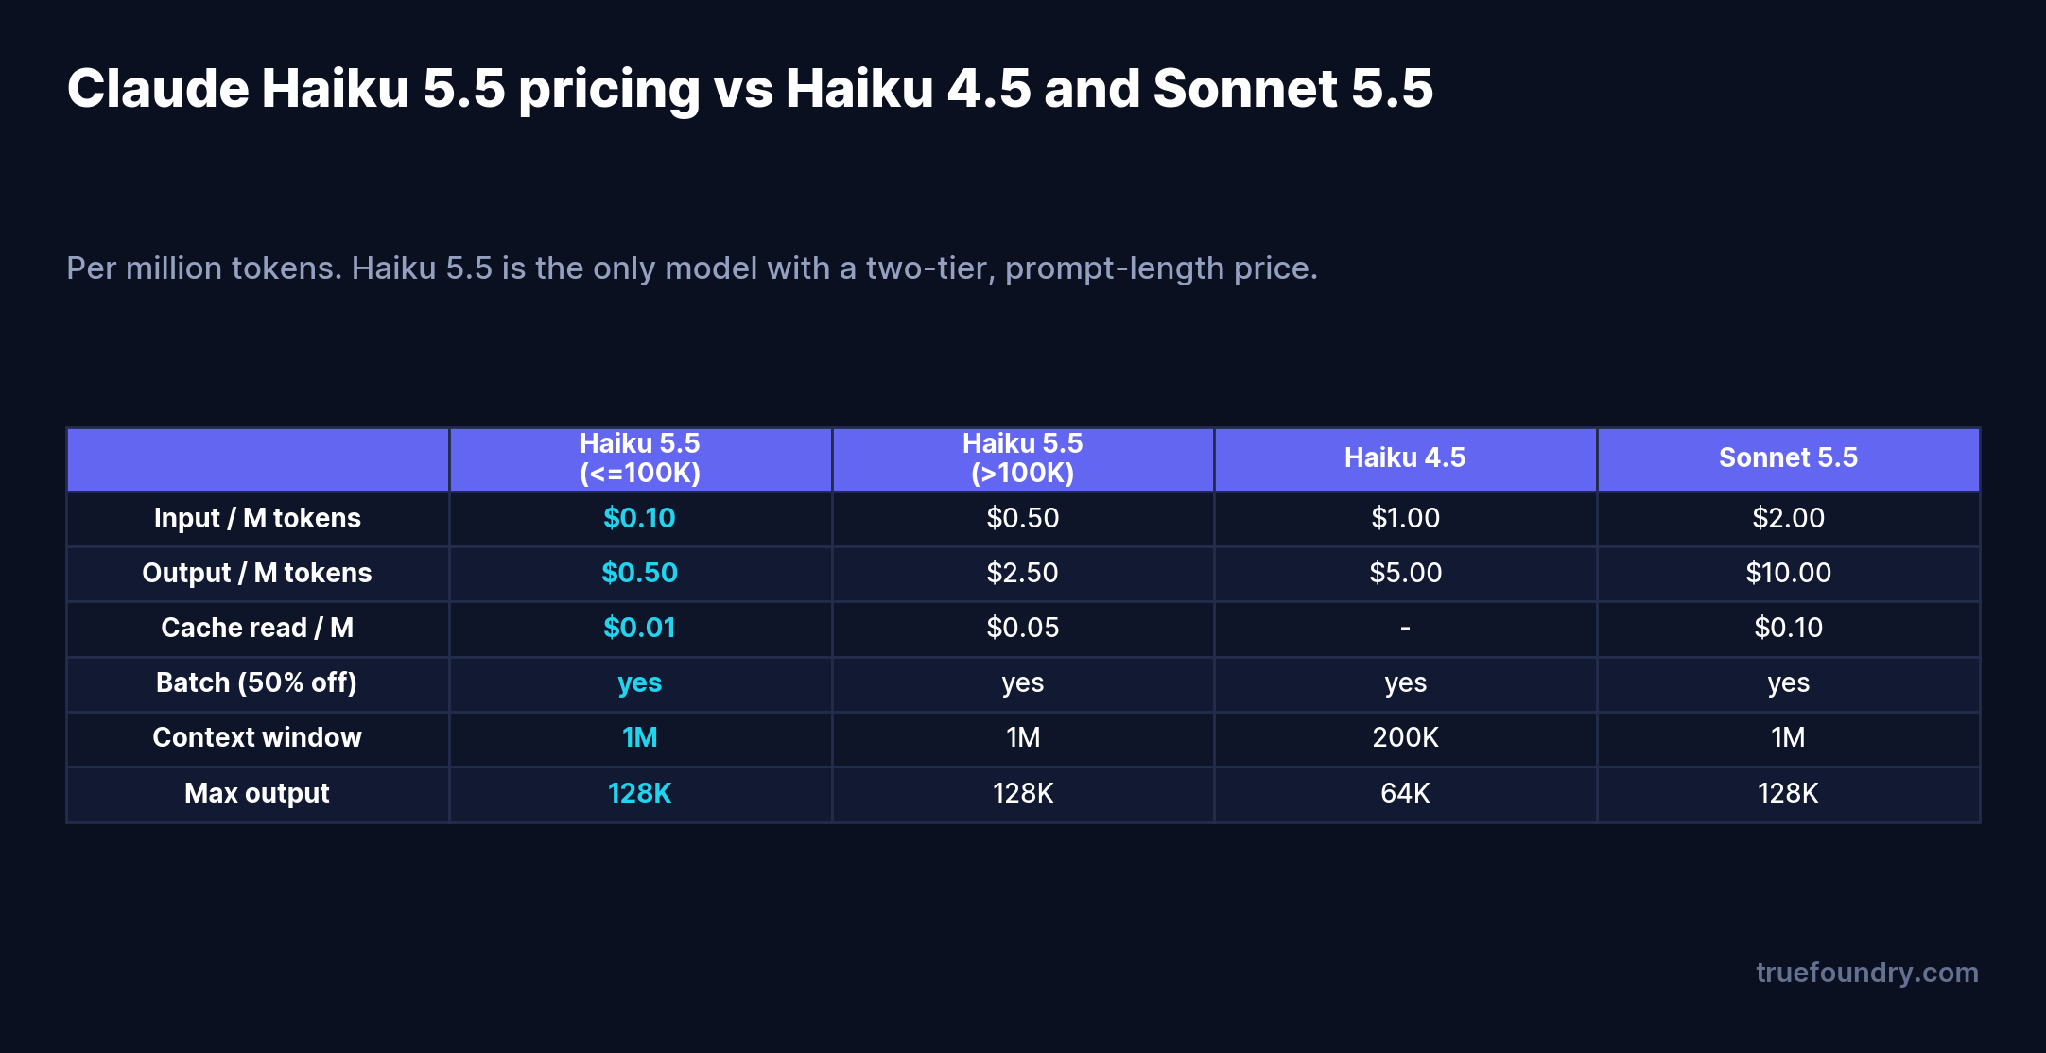
Três pontos se destacam.
O preço de entrada é o grande diferencial. A $0,10 por milhão de tokens de entrada, o Haiku 5.5 custa um décimo do Haiku 4.5 e um vigésimo do Sonnet 5.5. Para trabalhos com muito input — RAG, contexto longo, processamento de documentos —, é onde reside a maior parte da fatura, e é onde o Haiku 5.5 é mais agressivo.
O caching e o batching se somam aos ganhos. As leituras de cache custam $0,01 por milhão de tokens, portanto, um prompt de sistema estável ou um documento reutilizado é quase gratuito em chamadas repetidas. A Batch API concede mais 50% de desconto para trabalhos que toleram tempo de resposta assíncrono. Nenhum dos dois é exclusivo do Haiku, mas ambos potencializam a economia.
Tudo acima de 100K tokens é um modelo diferente em termos de preço. Esse é o detalhe importante, e ele merece sua própria seção.
O Haiku 5.5 é o único modelo na linha com um preço de dois níveis dependente do comprimento do prompt. Até 100K tokens em uma única requisição, você paga $0,10 / $0,50. No momento em que um prompt ultrapassa 100K, a taxa passa a ser de $0,50 / $2,50 — cinco vezes a taxa de entrada e cinco vezes a taxa de saída — e ela se aplica a todo o prompt, não apenas aos tokens acima do limite.
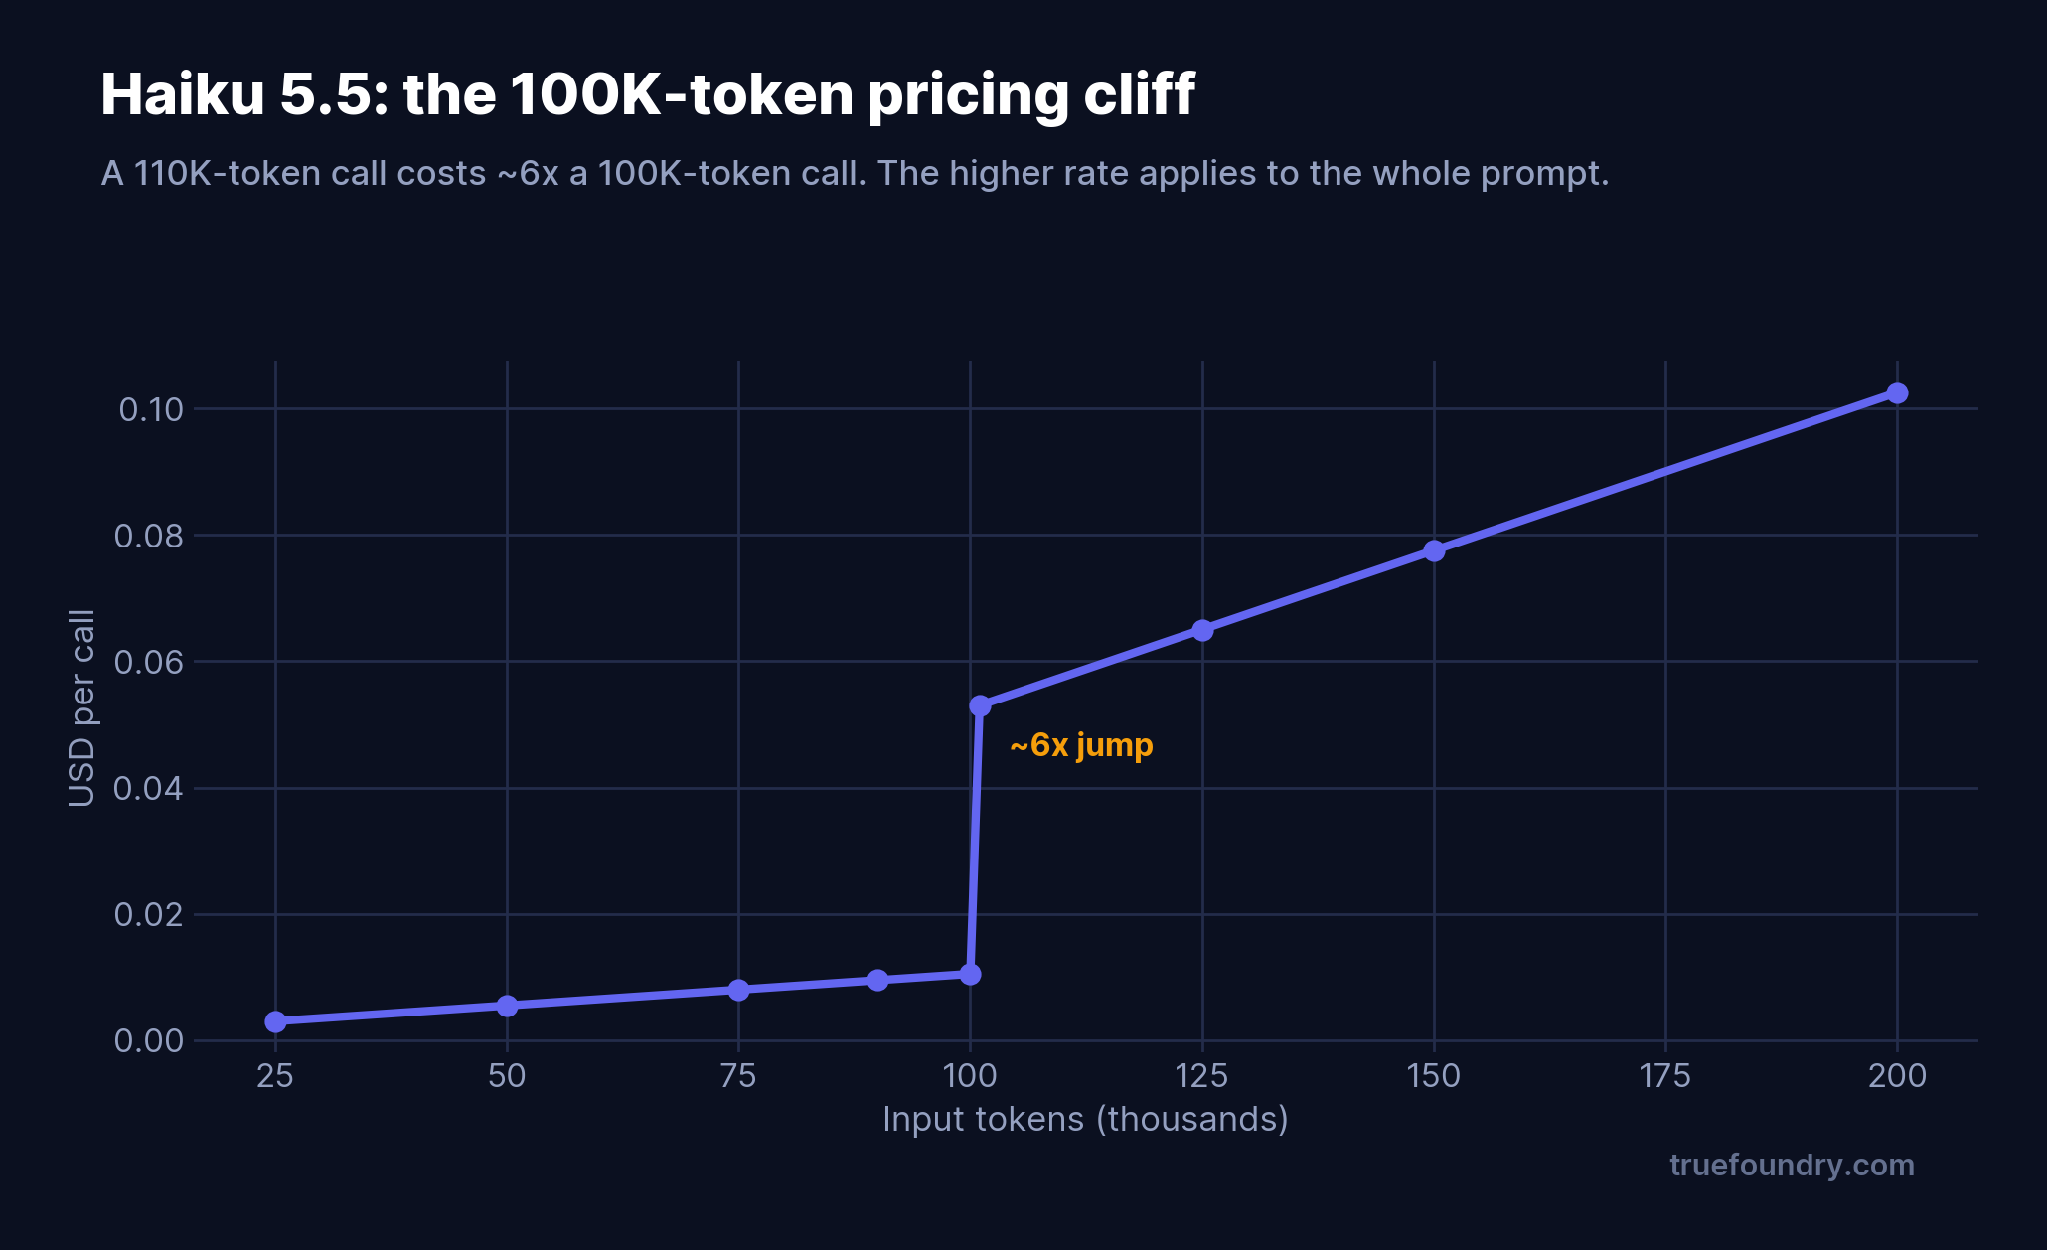
O efeito é um degrau, não uma rampa. Uma chamada de 90K tokens com 1K de saída custa cerca de $0,0095. Aumente a mesma chamada para 110K tokens e ela custará cerca de $0,0575 — aproximadamente 6× mais por 22% a mais de entrada. Nada no trabalho mudou; você apenas ultrapassou um limite de preço.
Para a maioria das cargas de trabalho, isso nunca afeta a operação, porque a maioria dos prompts está muito abaixo de 100K. No entanto, três padrões vivem bem no limite: pipelines de RAG que inserem grandes contextos recuperados, análise completa de documentos ou bases de código, e longas cadeias de agentes que acumulam histórico turno após turno. Se qualquer um desses ultrapassar rotineiramente 100K, a vantagem de 20× sobre o Sonnet diminui para cerca de 4×, e o cálculo financeiro para usar o Haiku se torna mais apertado. É fundamental saber quando o seu tráfego está cruzando essa linha — o que, novamente, é um desafio de medição.
Aqui está a armadilha em cada manchete que diz "custa $0,10 por milhão de tokens": você não compra tokens, você executa tarefas. E as tarefas têm formatos de tokens completamente diferentes.
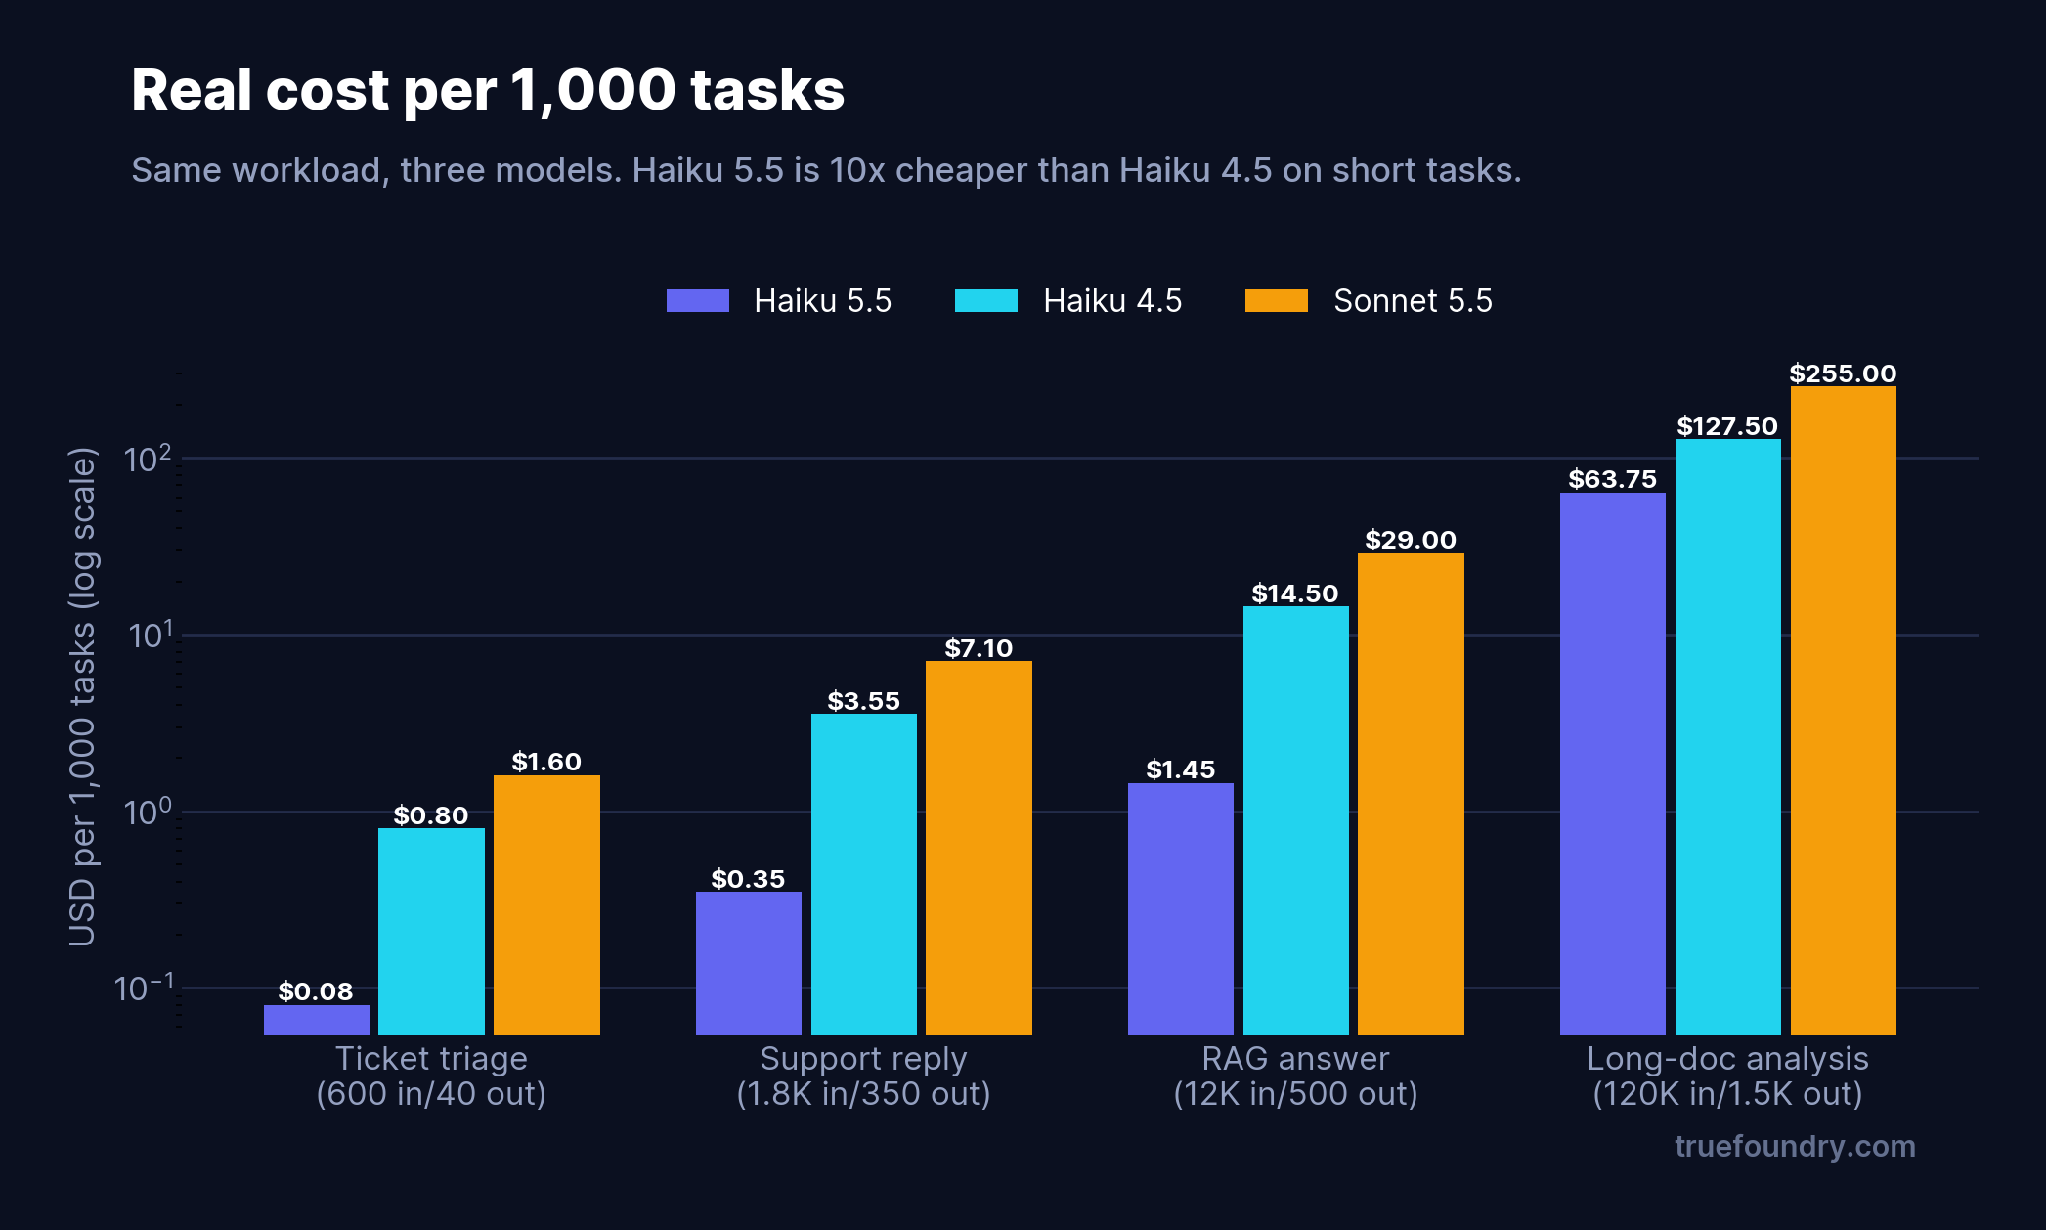
Quatro trabalhos representativos, com preços no Haiku 5.5 em seu nível padrão (o trabalho de documento longo usa a taxa >100K):
Trata-se de uma variação de 800× em um único modelo, impulsionada inteiramente pelo formato da tarefa. É por isso que "qual modelo é o mais barato" é a pergunta errada. A pergunta correta é "quanto custa a minha tarefa neste modelo, na minha proporção real de entrada/saída e no meu volume real" — e a resposta muda no momento em que seus prompts ficam mais longos ou sua saída cresce.
Dois números decidem tudo: sua proporção de entrada para saída e se você ultrapassa 100K. Um sumarizador (input enorme, output minúsculo) se comporta de maneira completamente diferente de um gerador de conteúdo (input pequeno, output enorme), porque os tokens de saída custam 5× mais que os tokens de entrada no Haiku. As taxas médias escondem isso. A medição por tarefa traz isso à tona.
Elas fazem o orçamento com base na taxa de entrada. A saída custa 5× o preço da entrada no Haiku. Um agente prolixo que gera respostas longas pode custar muito mais do que o seu volume de entrada sugere. Monitore os tokens de saída, não apenas os de entrada.
Elas ignoram a mudança de tarifa até a chegada da fatura. Um sistema de RAG que passa de 80K para 110K de contexto médio conforme a base de conhecimento cresce não falha — apenas fica silenciosamente ~6× mais caro por chamada. Sem visibilidade por requisição, ninguém percebe até que a equipe financeira questione.
Elas comparam preços de tabela em vez do custo mesclado por tarefa. O modelo que vence em uma planilha de especificações pode perder na sua combinação real de tráfego. A única comparação honesta é medir suas próprias tarefas.
Elas deixam o caching de lado. Um prompt de sistema estável reenviado em cada chamada é puro desperdício a $0,10/M quando poderia custar $0,01/M em cache. Em tráfego de alto volume no Haiku, a taxa de acerto de cache (cache hit rate) é um item de linha relevante.
O ponto central acima é sempre o mesmo: você não pode gerenciar o que não pode visualizar por tarefa. O TrueFoundry AI Gateway opera à frente de cada chamada de modelo e faz a medição, de modo que "quanto o Haiku realmente nos custa" se torna um painel dinâmico em vez de um exercício de planilha.
Quando você adiciona um modelo, o gateway associa uma base de custos. O Public Cost busca as taxas publicadas pelos provedores a partir do catálogo de preços de código aberto da TrueFoundry (github.com/truefoundry/models), preenchido automaticamente e mantido atualizado — incluindo taxas específicas por região e em camadas, que é exatamente como o nível de 100K do Haiku é manipulado. O Private Cost permite inserir taxas negociadas ou personalizadas para contratos e modelos ajustados (fine-tuned).
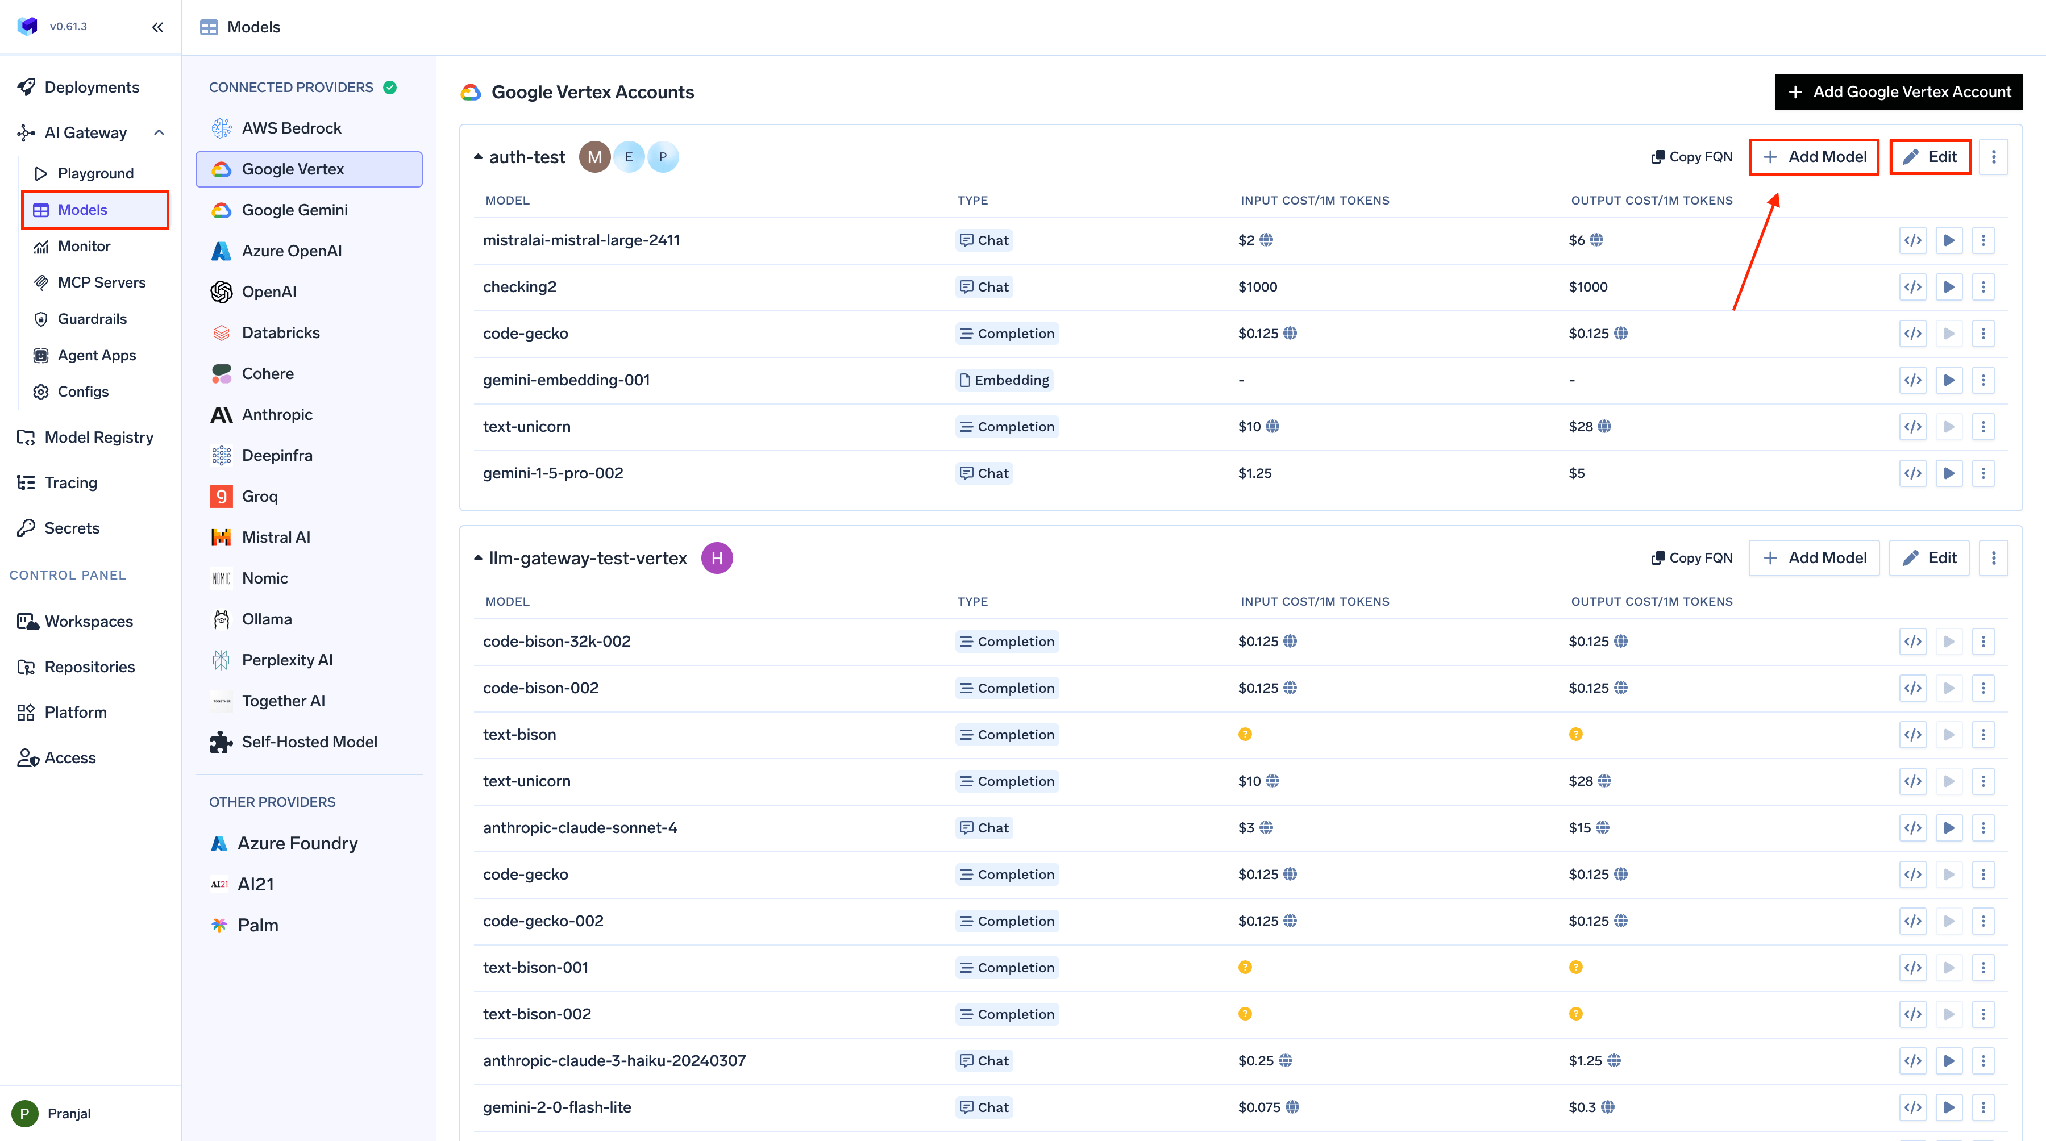
Como o catálogo modela os preços em camadas, o salto do Haiku do nível de $0,10 para o nível de $0,50 acima de 100K tokens é rastreado corretamente por requisição, em vez de ser cobrado por uma média fixa que subestimaria suas chamadas de contexto longo.
Assim que as chamadas começam a fluir, o painel de Metrics exibe o gasto total, uma tendência de Cost of Inference e detalhamentos com um clique por modelo, por usuário e por equipe.
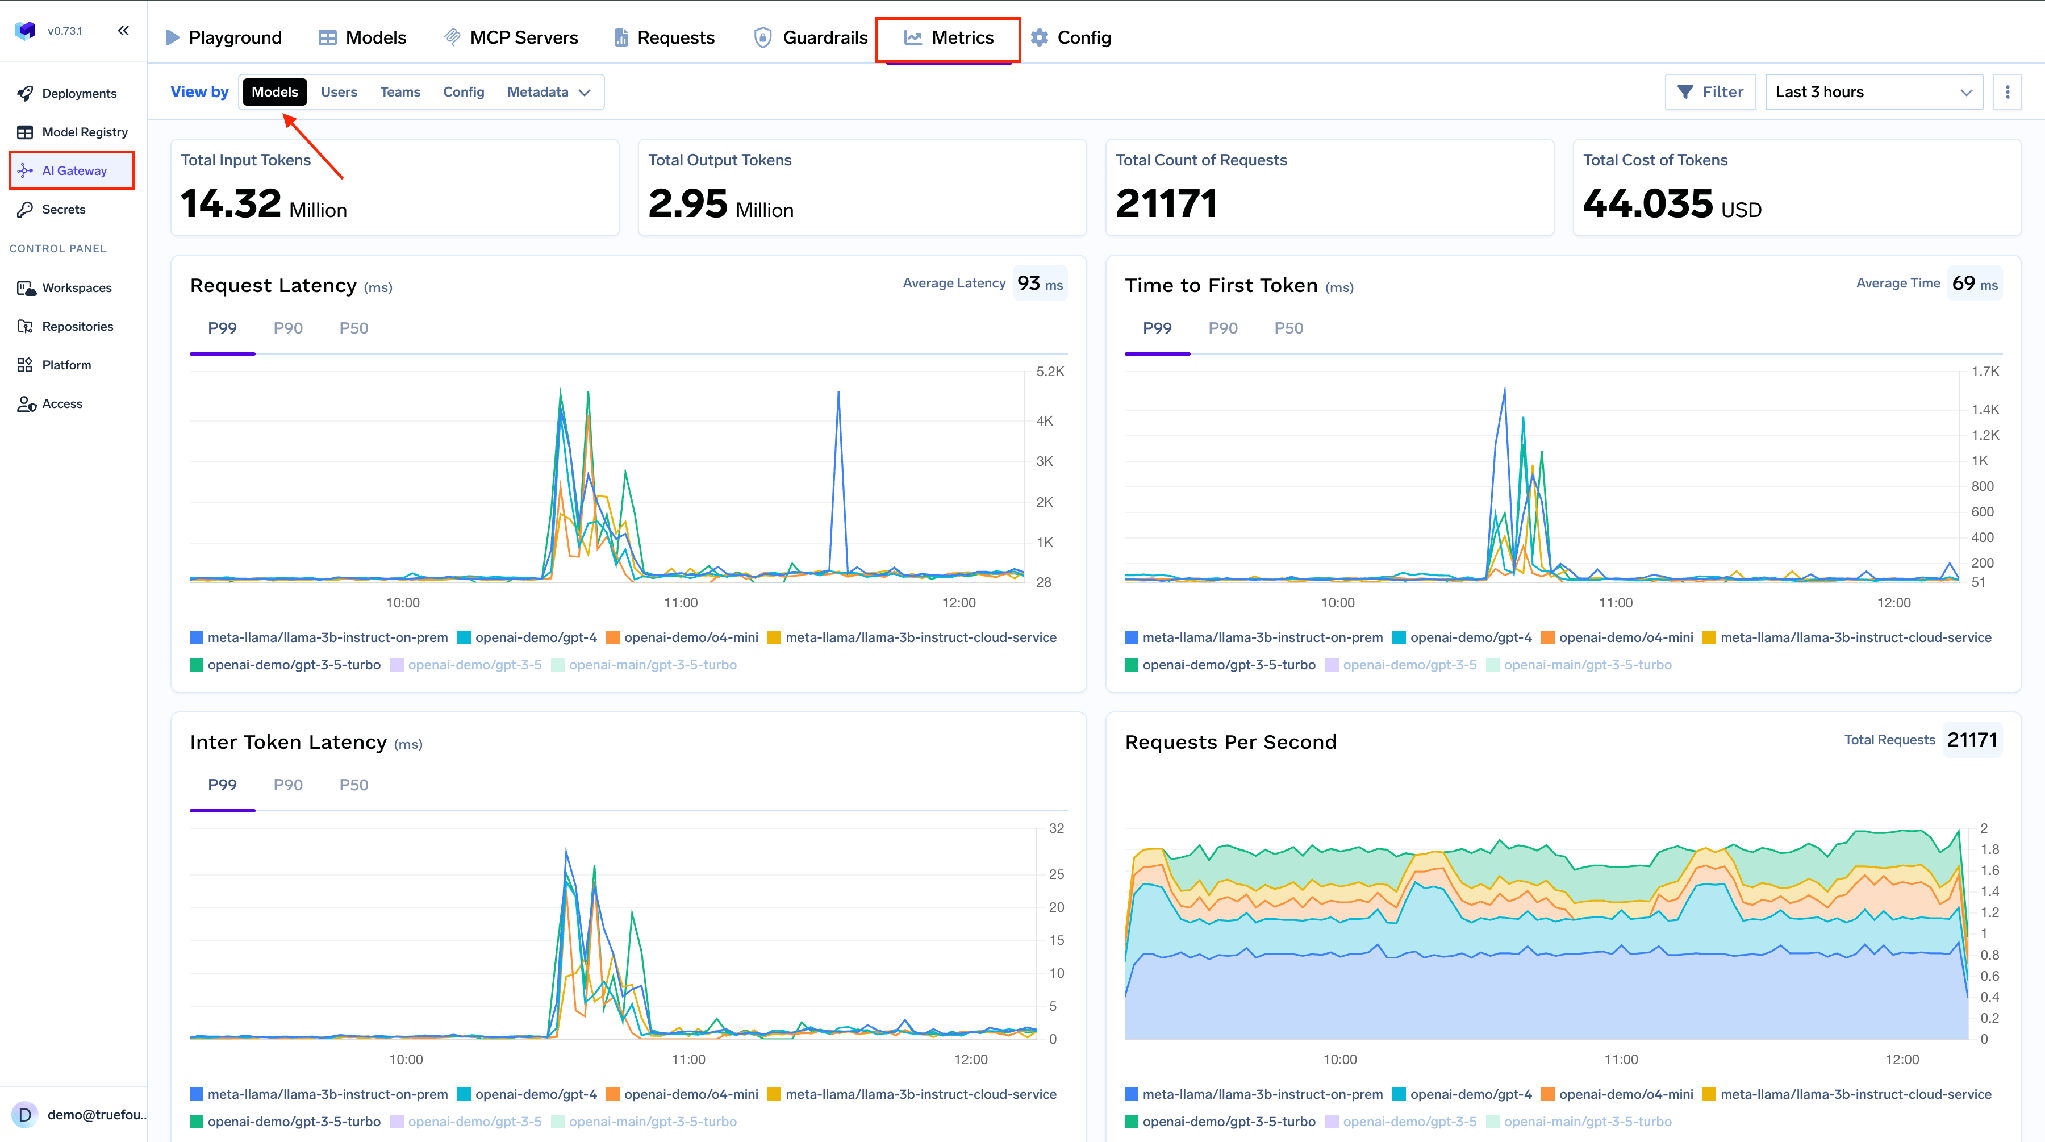
A visualização por modelo responde a "quanto o Haiku está nos custando em comparação ao Sonnet este mês"; a visualização por equipe dá suporte ao repasse de custos (chargeback); a visualização por usuário identifica o usuário avançado responsável por um terço da fatura.
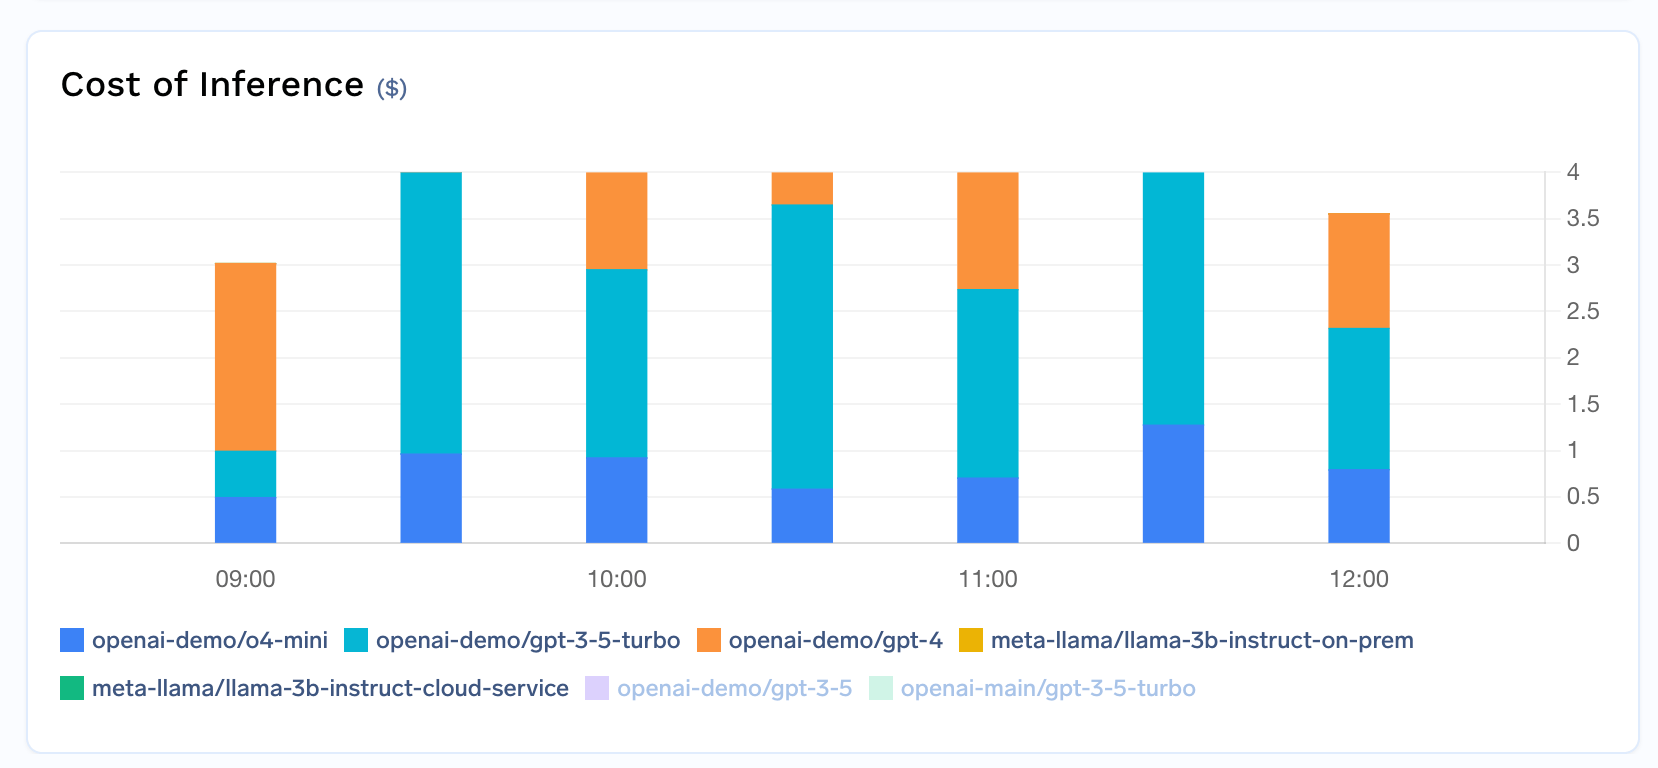
Além das visualizações integradas, você pode anexar custom metadata — application, environment, customer_id, cost_center — e agrupar os custos com base neles. Tags de contas virtuais e tokens associados a equipes injetam esses metadados automaticamente, garantindo atribuição de custos por aplicação e por cliente sem alterar uma linha do código do cliente. É possível aplicar isso com uma regra de validação de metadados que rejeita requisições sem uma chave obrigatória, e exportar os dados brutos agrupados conforme a necessidade da equipe financeira.
Para entender a mecânica em nível de token por trás desses números — taxas de texto em cache versus imagem em cache, cobrança de áudio e como fluxos cancelados são calculados —, a documentação de rastreamento de custos contém as fórmulas completas.
Uma empresa de SaaS opera um assistente de suporte ao cliente: 50.000 conversas por dia, com média de 1.800 tokens de entrada (prompt de sistema + contexto recuperado + histórico) e 350 tokens de saída por resposta.
No Haiku 5.5 no nível padrão, isso equivale a cerca de $0,355 por 1.000 respostas, ou aproximadamente $17,75 por dia — cerca de $533 por mês. O mesmo tráfego no Sonnet 5.5 custaria cerca de $7,10 por 1.000, ou $355 por dia — $10.650 por mês. A escolha do modelo gera uma variação de 20× em uma carga de trabalho idêntica.
Agora adicione o caching. O prompt de sistema e as definições de ferramentas representam ~1.200 desses 1.800 tokens de entrada e nunca mudam. Armazenados em cache a $0,01/M em vez de $0,10/M, o custo de entrada em chamadas repetidas cai substancialmente — as métricas de cache do gateway mostram a economia exata em dólares e a taxa de acerto, permitindo comprovar que a otimização trouxe resultados em vez de apenas presumir.
O ponto principal não são os valores específicos; é que cada fator — nível de modelo, caching, o limite de 100K — é mensurável por tarefa, o que significa que é gerenciável.
O Claude Haiku 5.5 é o sinal mais claro até agora de que o nível econômico não é mais um nível de concessões: contexto e saída em escala avançada por um décimo do preço da geração anterior. No entanto, a tabela de tarifas é um ponto de partida, não uma resposta final. Seu custo real é um número mesclado que depende do formato da tarefa, do tamanho da saída, do caching e de seus prompts cruzarem ou não a linha de 100K — e ele muda à medida que seu produto cresce.
As equipes que se destacam no controle de gastos com IA são aquelas que medem o custo onde ele acontece: no gateway, por tarefa, por modelo, por equipe. Essa é a diferença entre saber que você está no modelo mais barato e saber que está realmente gastando de forma eficiente.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



$0.10 per million input tokens and $0.50 per million output tokens for prompts up to 100K tokens. Above 100K, it is $0.50 input and $2.50 output, applied to the whole prompt. Cache reads are $0.01/M and the Batch API is 50% off.
Yes — substantially. Haiku 4.5 was $1.00 / $5.00 per million tokens, so Haiku 5.5’s standard tier is about 90% cheaper on the headline rate and roughly 75% cheaper to run on average across typical workloads.
Haiku 5.5 has two price tiers split at 100K tokens per prompt. Crossing 100K moves the entire prompt to the higher rate, so a 110K-token call costs about 6× a 100K-token one. It only affects long-context work.
Meter it at the gateway. TrueFoundry tracks cost per request, model, user, team, and custom metadata, so you see blended cost per task across your actual traffic instead of estimating from the rate card.
Yes. The TrueFoundry AI Gateway normalizes cost across providers, so Haiku, Sonnet, GPT, Gemini, and open models all appear in one dashboard with consistent per-task and per-team attribution.
Yes. TrueFoundry’s data plane runs in your VPC or on-prem, so prompts and usage data stay in your environment while you still get unified cost tracking and governance.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada