


August 26, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large language models zoals ChatGPT en diffusiemodellen zoals Stable Diffusion hebben de wereld in minder dan een jaar tijd veroverd. Steeds meer organisaties beginnen nu Generatieve AI te benutten voor hun bestaande en boeiende nieuwe use-cases. Hoewel de meeste bedrijven rechtstreeks gebruik kunnen maken van API's van bedrijven als OpenAI, Anthropic, Cohere, etc., gaan deze API's ook gepaard met hoge kosten. Op de lange termijn willen veel bedrijven liever kleine tot middelgrote versies van gelijkwaardige open-source LLM's zoals Llama, Flan-T5, Flan-UL2, GTP-Neo, OPT, Bloom, etc. finetunen, zoals het met de projecten Alpaca en GPT4All is gedaan.
Het finetunen van kleinere modellen met de outputs van grotere modellen kan op meerdere manieren nuttig zijn:
Om dit alles mogelijk te maken, zijn GPU's een essentieel werkpaard geworden voor elk bedrijf dat met deze fundamentele modellen werkt. Nu de omvang van modellen groeit en biljoenen parameters bereikt, wordt gedistribueerde training over meerdere GPU's langzaam de nieuwe norm. Nvidia is leidend in de hardwaremarkt met hun nieuwere kaarten uit de Ampere- en Hopper-serie. Dankzij snelle NVLink- en Infiniband-interconnects kunnen tot wel 256 Nvidia A100- of Nvidia H100-kaarten (en ~4k in super pod-clusters) met elkaar worden verbonden om in recordtijd te trainen en te infereren met steeds grotere modellen.
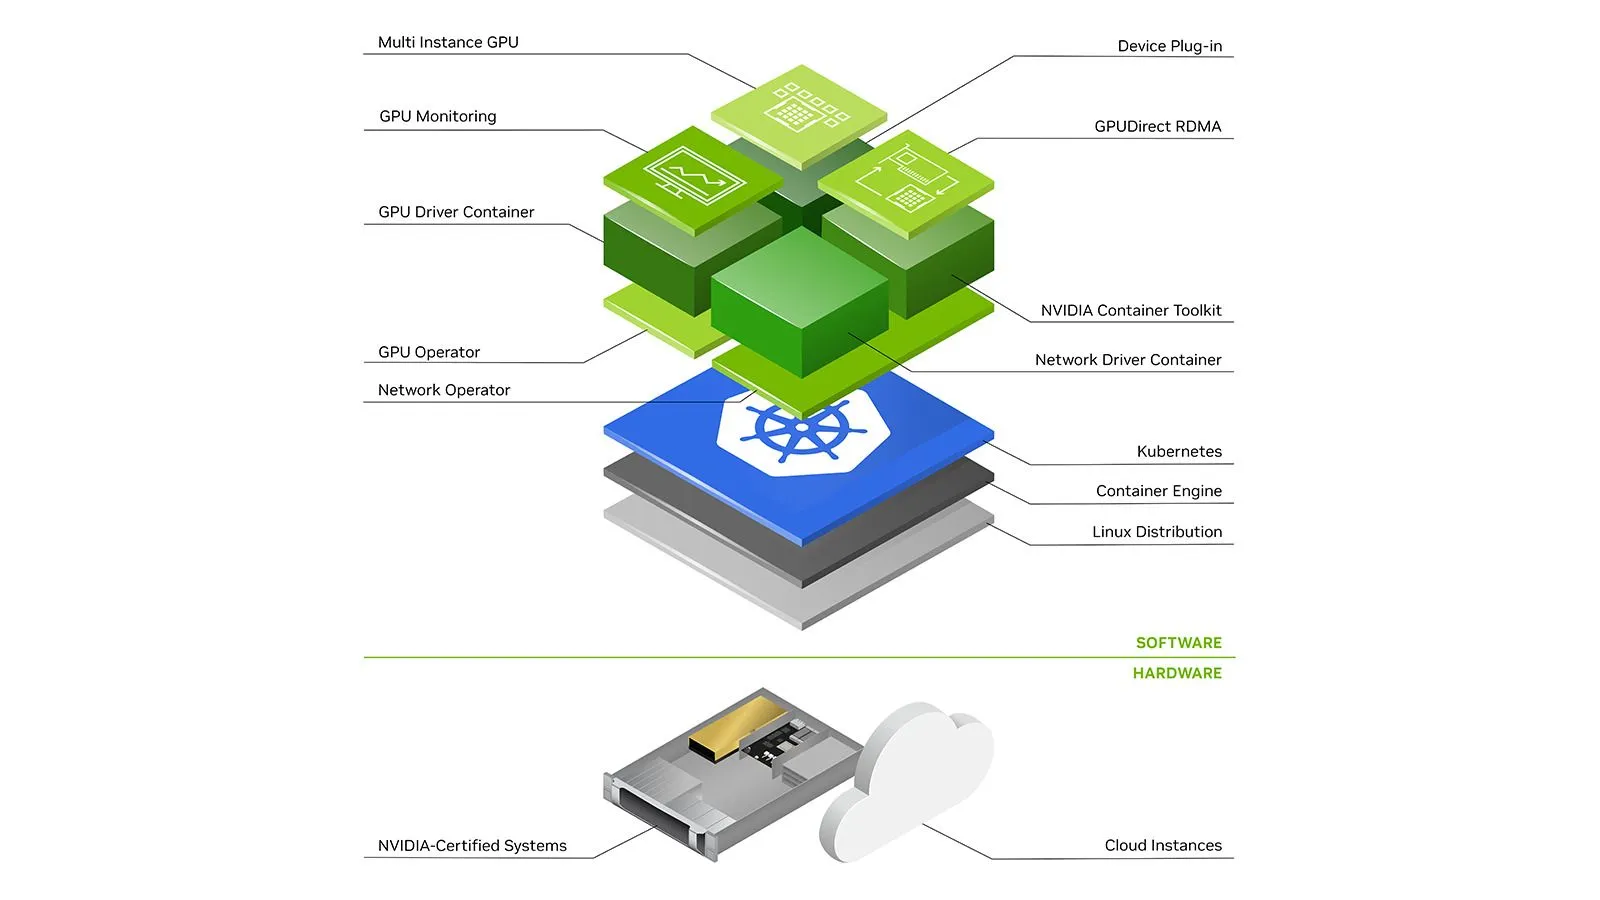
We nemen nu de componenten doornemen die nodig zijn om GPU's met Kubernetes te gebruiken - voornamelijk op AWS EKS en GCP GKE (Standard of Autopilot), maar de genoemde componenten zijn essentieel op elk K8s-cluster.

Je cloudprovider beschikt over GPU VM's, maar hoe brengen we deze naar het K8s-cluster? Eén manier is om handmatig GPU Nodepools van een vaste grootte te configureren, of met een cluster autoscaler die GPU-nodes kan toevoegen wanneer dat nodig is en weer kan afstoten wanneer ze niet meer gebruikt worden. Dit vereist echter nog steeds een handmatige configuratie van verschillende node pools. Een nog betere oplossing is het configureren van Auto Provisioning-systemen zoals AWS Karpenter of GCP Node Auto Provisioners. We bespreken deze in ons vorige artikel: Cluster Autoscaling voor de Grote 3 Clouds ☁️
apiVersion: karpenter.sh/v1alpha5
kind: Provisioner
metadata:
  name: gpu-provisioner
  namespace: karpenter
spec:
  weight: 10
  kubeletConfiguration:
    maxPods: 110
  limits:
    resources:
      cpu: "500"
  requirements:
    - key: karpenter.sh/capacity-type
      operator: In
      values:
        - spot
        - on-demand
    - key: topology.kubernetes.io/zone
      operator: In
      values:
        - ap-south-1
    - key: karpenter.k8s.aws/instance-family
      operator: In
      values:
        - p3
        - p4
        - p5
        - g4dn
        - g5
  taints:
    - key: "nvidia.com/gpu"
      effect: "NoSchedule"
  providerRef:
    name: default
  ttlSecondsAfterEmpty: 30
Voorbeeld GCP Node Auto Provisioner-configuratie
resourceLimits:
  - resourceType: 'cpu'
    minimum: 0
    maximum: 1000
  - resourceType: 'memory'
    minimum: 0
    maximum: 10000
  - resourceType: 'nvidia-tesla-v100'
    minimum: 0
    maximum: 4
  - resourceType: 'nvidia-tesla-t4'
    minimum: 0
    maximum: 4
  - resourceType: 'nvidia-tesla-a100'
    minimum: 0
    maximum: 4
autoprovisioningLocations:
  - us-central1-c
management:
  autoRepair: true
  autoUpgrade: true
shieldedInstanceConfig:
  enableSecureBoot: true
  enableIntegrityMonitoring: true
diskSizeGb: 100
Let op: hier kunnen we onze provisioners ook configureren om spot type instances te gebruiken, wat tot 30-90% kostenbesparing kan opleveren voor stateless applicaties.
Om een virtuele machine GPU's te laten gebruiken, moeten de drivers op de host zijn geïnstalleerd. Gelukkig zijn de nodes op zowel AWS EKS als GCP GKE vooraf geconfigureerd met specifieke versies van Nvidia-drivers.
Omdat elke nieuwere CUDA-versie een hogere minimale driverversie vereist, wil je de driverversie voor alle nodes mogelijk zelf beheren. Dit kan worden gedaan door nodes te provisionen met custom images zonder driver, en Nvidia gpu-operator een gespecificeerde versie te laten installeren. Dit is echter niet bij alle cloudproviders toegestaan, dus wees je bewust van de driverversies op je nodes om compatibiliteitsproblemen te voorkomen.
We bespreken de gpu-operator hieronder verder.
Omdat in Kubernetes alles binnen pods (een verzameling containers) draait, is alleen het installeren van drivers op de host niet voldoende. Nvidia biedt een zelfstandige component genaamd nvidia-container-toolkit die hooks installeert op containerd runC om de GPU-drivers en -apparaten van de host beschikbaar te maken voor de containers die op de node draaien. Zie dit artikel voor een meer gedetailleerde uitleg.

nvidia-container-toolkit kan worden geïnstalleerd om als Daemonset op de GPU-nodes te draaien.
Het hebben van GPU's op de node is niet genoeg; de Kubernetes-scheduler moet weten welke node hoeveel GPU's beschikbaar heeft. Dit kan worden gedaan met behulp van een Device Plugin. Met een device plugin kunnen aangepaste hardwareresources worden geadverteerd aan de control plane, bijv. nvidia.com/gpu . Nvidia heeft een device plugin gepubliceerd die toewijsbare GPU's op een node adverteert. Deze plugin kan eveneens als een Daemonset draaien.
Zodra de bovenstaande componenten zijn geconfigureerd, moeten we enkele zaken toevoegen aan de pod spec om deze op de GPU-node in te plannen - voornamelijk resources , affinity en tolerations
Bijv. op GCP GKE kunnen we het volgende doen:
spec:
  # We define how many gpus we want for the pod
  resources:
    limits:
      nvidia.com/gpu: 2
  # affinities help us place the pod on the GPU nodes
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              # Specify which instance family we want
              - operator: In
                key: cloud.google.com/machine-family
                values:
                  - a2
              # Specify which gpu type we want
              - operator: In
                key: cloud.google.com/gke-accelerator
                values:
                  - nvidia-tesla-a100
              # Specify we want a spot VM
              - operator: In
                key: cloud.google.com/gke-spot
                values:
                  - "true"
tolerations:
  # Spot VMs have a taint, so we mention a toleration for it
  - key: cloud.google.com/gke-spot
    operator: Equal
    value: "true"
    effect: NoSchedule
  # We taint the GPU nodes, so we mention a toleration for it
  - key: nvidia.com/gpu
    operator: Exists
    effect: NoSchedule
resources.limits sectieHoud er rekening mee dat deze configuraties verschillen op basis van de provisioning-methoden en cloudproviders die u gebruikt (bijv. Karpenter op AWS vs NAP op GKE)
Het monitoren van GPU metrics zoals Utilisation, Memory Usage, Power Draw, Temperature, etc. is belangrijk om te zorgen dat alles soepel verloopt en om verdere optimalisaties uit te voeren.
Gelukkig heeft Nvidia een component genaamd dcgm-exporter die als Daemonset op GPU-nodes kan draaien en metrics kan publiceren op een endpoint. Deze metrics kunnen vervolgens worden gescraped met Prometheus en worden geconsumeerd. Hier is een voorbeeld van een scrape config:
- job_name: gpu-metrics
  scrape_interval: 15s
  scrape_timeout: 10s
  metrics_path: /metrics
  scheme: http
  kubernetes_sd_configs:
  - role: endpoints
    namespaces:
      names:
      - <dcgm-exporter-namespace-here>
  relabel_configs:
  - source_labels: [__meta_kubernetes_pod_node_name]
    action: replace
    target_label: kubernetes_node
Houd er echter rekening mee dat dcgm-exporter moet draaien met hostIPC: true en bevoorrechte securityContext. Dit is prima voor EKS en GKE Standard. GKE Autopilot staat dergelijke toegang echter niet toe; in plaats daarvan geeft GKE metrics vrij op de voorgeconfigureerde nvidia-device-plugin Daemonsets die gescraped of bekeken kunnen worden in GCP Cloud Monitoring.
AWS EKSGCP GKE StandardGCP GKE AutopilotProvisioningKarpenter / HandmatigGCP Node Auto Provisioner / HandmatigAuto ProvisioningDriversVoorgeïnstalleerd/Installeren via gpu-operatorVoorgeïnstalleerdVoorgeïnstalleerdContainer Toolkitnvidia-container-toolkitvia gpu-operatorVoorgeconfigureerdVoorgeconfigureerdDevice Pluginnvidia-device-pluginvia gpu-operatorVoorgeconfigureerde DaemonsetVoorgeconfigureerde DaemonsetMetricsnvidia-dcgm-exportervia gpu-operatorStandalone nvidia-dcgm-exporter / Custom scrapingCustom Scraping
De hierboven genoemde gpu-operator voor de meeste onderdelen op AWS EKS is een verzameling standalone Nvidia-componenten zoals drivers, container-toolkit, device-plugin en metrics exporter onder andere, allemaal gecombineerd en geconfigureerd om samen te worden gebruikt via een enkele helm chart. De gpu-operator draait een master pod op de control plane die GPU-nodes in het cluster kan detecteren. Bij detectie van een GPU-node zet deze een worker Daemonset in die vervolgens pods plant om optioneel drivers, container toolkit, device-plugin, CUDA toolkit, metrics exporter en validators te installeren. U kunt hier meer over lezen hier.
Over het algemeen is het mogelijk om de CUDA toolkit op de hostmachine te laten installeren en deze beschikbaar te maken voor de pod via volume mounting. We merken echter dat dit erg kwetsbaar kan zijn, omdat het vereist dat u sleutelt aan PATH en LD_LIBRARY_PATH variabelen. Bovendien moeten alle pods op dezelfde node dezelfde CUDA toolkit-versie gebruiken, wat erg beperkend kan zijn. Daarom is het beter om de CUDA toolkit (of slechts delen ervan) in de container image te plaatsen.

U kunt beginnen met reeds gebouwde images geleverd door Nvidia of uw favoriete deep-learning framework of voeg het toe met één regel op het TrueFoundry-platform

Om organisaties in staat te stellen hun Generative AI-modellen sneller te fine-tunen en uit te rollen op hun bestaande infrastructuur, stelt het TrueFoundry-platform ontwikkelaars in staat om met minimale inspanning een of meer Nvidia GPUs toe te voegen aan hun applicaties, terwijl workflows worden ondersteund die samen met de beste prompt engineering tools worden gebruikt. Ontwikkelaars hoeven alleen op te geven hoeveel instanties van een aantal van de beste GPUs voor Machine Learning zoals V100, P100, A100 40GB, A100 80GB (optimaal voor training) of T4, A10 (optimaal voor inference) ze nodig hebben en wij doen de rest. Lees meer in onze docs. Naarmate GPU-ondersteunde AI-workloads naar productie verhuizen, wordt dit type infrastructuurcontrole ook belangrijk voor bredere AI security platforms, waar compute-isolatie, toegangsgovernance en observability van workloads moeten samenwerken.
GPUs zijn een fantastische technologie en dit is pas het begin voor ons. We werken actief aan de volgende uitdagingen:
Als dit interessant klinkt, neem dan contact met ons op om samen te werken aan het bouwen van het beste MLOps-platform.
TrueFoundry is een ML Deployment PaaS op Kubernetes om ontwikkelaarsworkflows te versnellen, terwijl ze volledige flexibiliteit behouden bij het testen en deployen van modellen, en tegelijkertijd volledige beveiliging en controle voor het Infra-team wordt gegarandeerd. Via ons platform stellen we Machine Learning-teams in staat om binnen 15 minuten modellen te deployen en te monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen enkele seconden te rollbacken - waardoor ze kosten besparen en modellen sneller naar productie brengen, wat zorgt voor het realiseren van echte bedrijfswaarde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox























