August 26, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
TypeSafe AI is een AI-lab opgericht door Diogo Almeida — eerder werkzaam bij OpenAI, waar hij werkte aan het onderzoek naar het opvolgen van instructies dat leidde tot ChatGPT — samen met Erik Gafni en Sasha Sheng. Na ongeveer twee jaar in stealth-modus te hebben geopereerd, publiceerde het bedrijf zijn lanceringsbericht op 15 september 2026, samen met een seed-ronde van $ 40 miljoen geleid door DCVC. DataCamp en diverse vakmedia deden er de daaropvolgende dagen verslag van.
De invalshoek in het lanceringsbericht is eerder een vraag dan een benchmark: modellen presteren al jaren op bovennatuurlijk niveau bij chat, dus waar blijft alle automatisering? Het antwoord van TypeSafe is dat de knelpunt nooit de pure intelligentie was — het is dat een model dat in proza antwoordt een onhandig onderdeel is om software op te bouwen. Het bedrijfsmanifest verwoordt het nog scherper: de huidige AI is getraind op de aanname dat er een mens aan de andere kant zit.
Jev is het eerste model dat vanuit die veronderstelling is gebouwd. De naam is afgeleid van William Stanley Jevons, wiens paradox stelt dat dalende kosten leiden tot stijgende consumptie; System One is een knik naar Daniel Kahneman's snelle, intuïtieve Systeem 1-denken, te onderscheiden van het trage, weloverwogen Systeem 2-redeneren.
Tussen de types van AI models die je in productie zou gebruiken, wordt deze gedefinieerd door wat hij opgeeft. Een chatmodel retourneert een string, en een string kan van alles zijn — een antwoord, een weigering, een alinea met redeneringen of een misvormd element waar je parser op vastloopt. Jev retourneert helemaal geen strings.
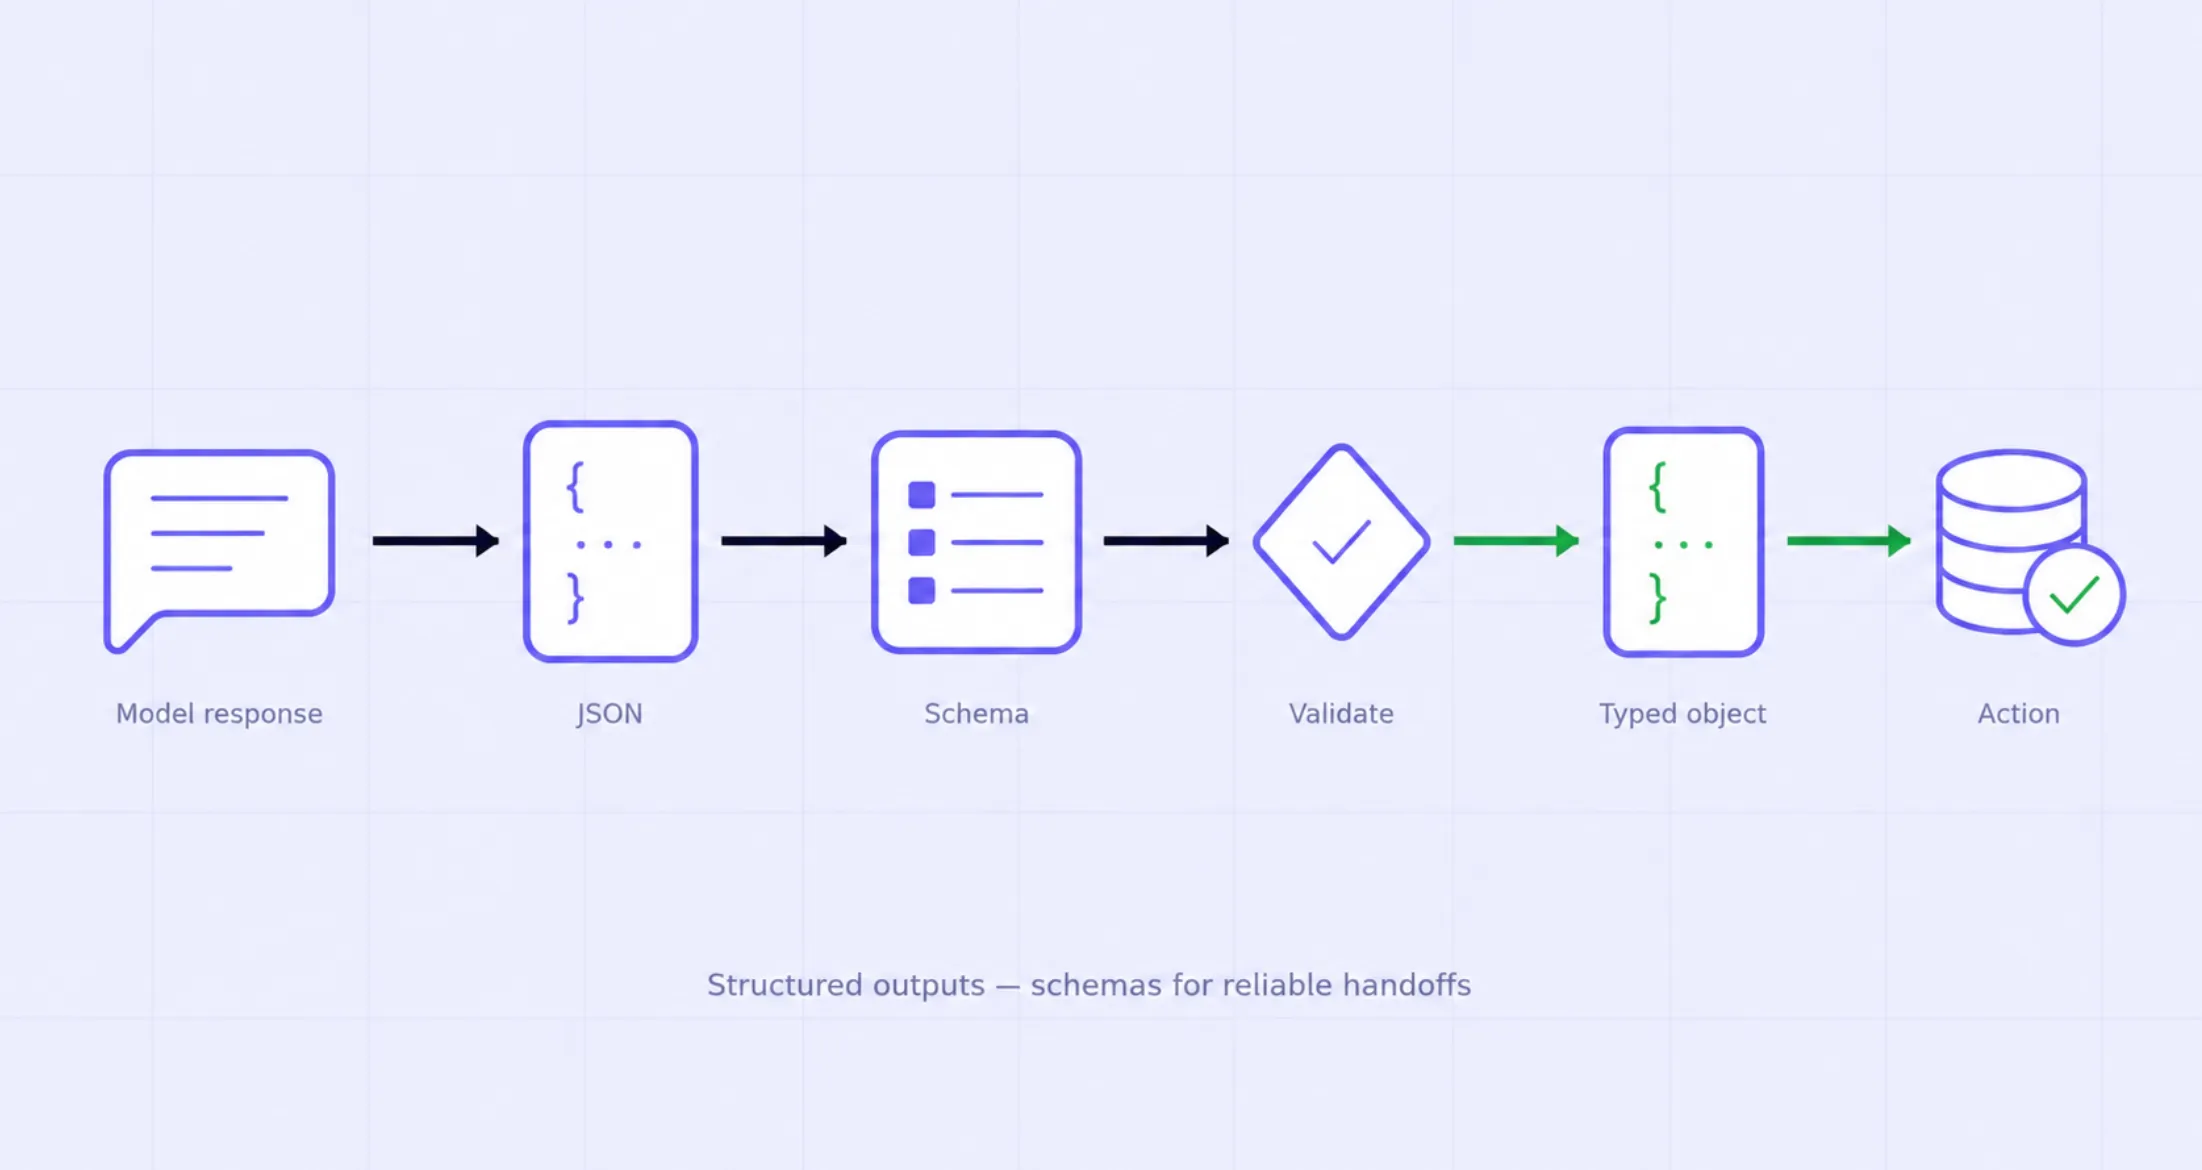
In plaats daarvan definieer je vooraf de structuur van het antwoord: welke velden je wilt en welke waarden elk veld mag aannemen. Het model retourneert die ingevulde velden, elk voorzien van een waarschijnlijkheid. TypeSafe omschrijft het resultaat als een frontier-intelligence functie-aanroep — ongestructureerde status erin, getypeerde probabilistische beslissingen eruit. In de praktijk gedraagt het zich minder als een chatbot en meer als een ai decision engine die je kunt aanroepen vanuit één regel code.
Drie eigenschappen volgen uit dat ontwerp:
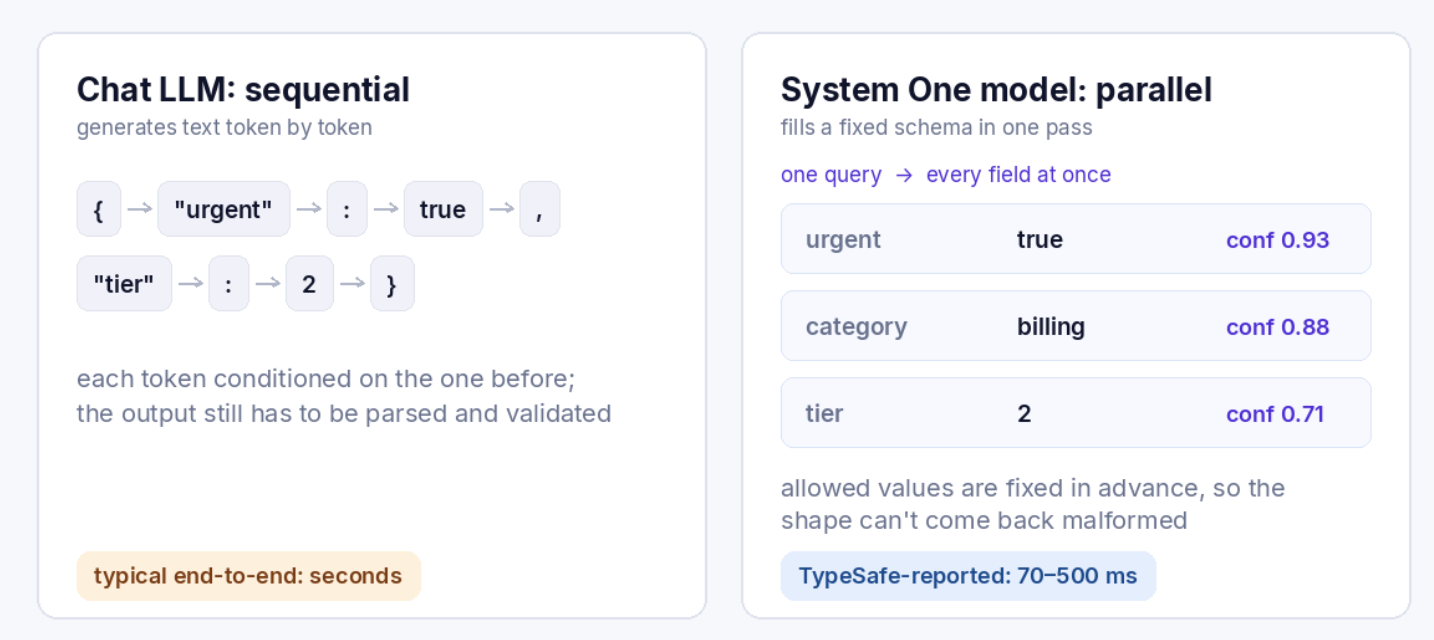
Een chat-LLM bouwt zijn antwoord token voor token op; een System One model vult elk veld van een vast schema in één run in, elk met een betrouwbaarheidsscore.
Die derde eigenschap is degene die het meest waarschijnlijk wordt onderschat. Om een model dat 95% van de tijd gelijk heeft, maar je niet kan vertellen welke aanroepen in de overige 5% vallen, kun je geen automatisering bouwen. Een model dat eerlijke onzekerheid rapporteert maakt dat wel mogelijk — je vertakt op basis van de betrouwbaarheidsscore en leidt de gevallen met een lage score door naar een mens of een groter model.
Een praktische limiet die het vermelden waard is: Jev ondersteunt een cardinaliteit van maximaal 255 opties per keuze. Daarboven gebruikt TypeSafe een tweestapsbenadering — kandidaten onafhankelijk scoren en vervolgens een expliciete keuze maken — waarvan het bedrijf erkent dat deze trager is.
Dit is het deel waar we langer bij stil moeten staan, omdat de lanceringscijfers buitengewoon groot zijn en het bewijs erachter uitzonderlijk op zichzelf staat. TypeSafe verdient de eer dat hun bericht eigen "nuance"-notities onder elk resultaat bevat, waar het meeste van het volgende vandaan komt.
Vandaag onafhankelijk te controleren:
Zelfgerapporteerd en nog niet onafhankelijk gereproduceerd:
Nog onbekend: prestaties op openbare benchmarks, gedrag bij taken die niet zuiver de vorm van een beslissing hebben, nauwkeurigheid bij domeinspecifiek werk in de handen van anderen, en alles over productiebetrouwbaarheid op schaal. Vroege toegang is pas deze week geopend.
Er is ook een formulering die precisie vereist, omdat deze in samenvattingen vervlakt zal worden. TypeSafe zegt dat Jev niet kan hallucineren, en in engere zin is dat terecht: een model dat nooit vrije tekst genereert, kan geen bronvermelding of toolnaam verzinnen. Maar llm hallucination en juistheid zijn niet hetzelfde probleem. Een model dat beperkt is tot drie toegestane categorieën kan nog steeds vol vertrouwen de verkeerde kiezen — wat geëlimineerd is, is de misvormde respons, niet het verkeerde oordeel. Kalibratie is het antwoord van TypeSafe daarop, en kalibratie is precies de claim die onafhankelijk getest moet worden. Teams die al structured outputs met JSON schema gebruiken, zullen het onderscheid herkennen: het beperken van de vorm van een antwoord heeft nooit garanties geboden voor de inhoud ervan.
Laat de specifieke lancering even terzijde, want de vorm ervan is interessanter dan de cijfers. Wat TypeSafe stelt — en waar een toenemend aantal teams onafhankelijk van elkaar op uitkomt — is dat één generiek model dat elke aanroep afhandelt een prototyping-patroon is, geen productie-patroon.
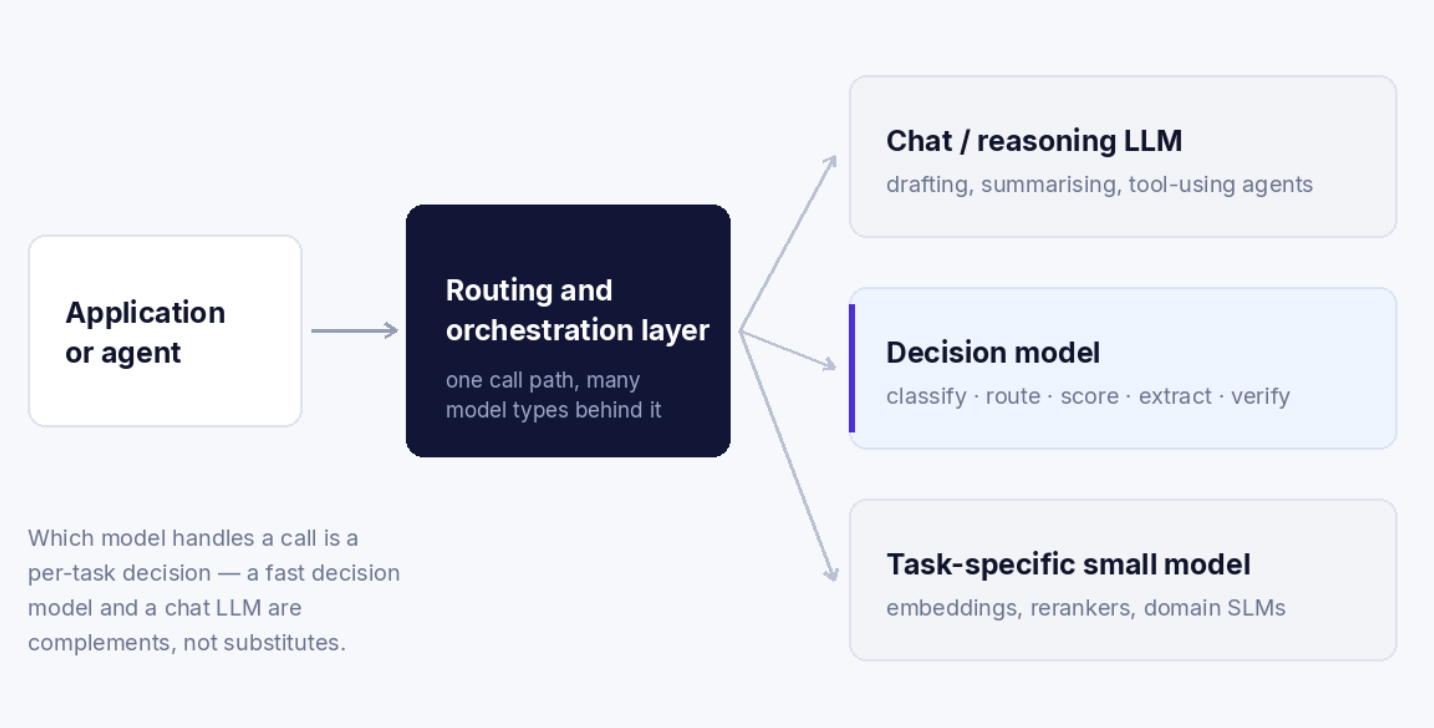
Een productie-stack bevat uiteindelijk meerdere modeltypen tegelijk, waarbij de routinglaag bepaalt welke een specifieke aanroep afhandelt.
De beslissingen binnen een draaiend systeem zijn meestal klein en repetitief: is dit ticket urgent, in welke wachtrij hoort het, overtreedt deze respons het beleid, welke van deze velden is het factuurnummer. Elk daarvan naar een frontier chatmodel sturen werkt, en teams doen het, maar het betekent dat je generatieprijzen en generatielatentie betaalt voor iets dat dichter bij een zoekopdracht ligt. Dat is dezelfde afweging achter het kiezen wanneer je een klein model specialiseert in plaats van een groot model te prompten, en het is de reden waarom verificatie-achtig werk — scoren, beoordelen, jailbreak-detectie, agent guardrails — de use case is waarmee TypeSafe vooroploopt. Guardrails moeten bij elke aanroep draaien, waardoor kosten en latentie de doorslaggevende beperking worden in plaats van pure capaciteit.
Het gevolg voor iedereen die AI in productie draait is een ai orchestration probleem in plaats van een modelselectieprobleem. Als het juiste antwoord een chat-LLM is voor sommige aanroepen, een snel beslissingsmodel voor andere, en een gefinetuned klein model voor een derde set, dan moet de laag vóór hen degene zijn die stabiel is — één aanroeppad, consistente auth en logging, en de vrijheid om te veranderen welk model een specifieke taak afhandelt zonder de applicatie te herschrijven. Dat is het uitgangspunt achter auto-routing op de TrueFoundry AI Gateway, en dat is de reden waarom een lancering als deze interessanter is als architectuursignaal dan als benchmark.
Vooralsnog is Jev een gesloten gehoste API in vroege toegang, dus er valt niets te deployen en geen integratie te evalueren. Dat kan veranderen. Het patroon dat het vertegenwoordigt zal dat vrijwel zeker niet.
TypeSafe AI's Jev is een echt andere aanpak: dat de nuttige volgende stap niet een slimmer chatmodel is, maar een betrouwbaar model dat software kan aanroepen zoals elke andere functie. Het ontwerp is coherent, de staat van dienst van de oprichter is reëel, en de doelstellingen voor prijs en latentie zijn agressief genoeg om te veranderen wat het automatiseren waard is. De benchmark-multiples zijn echter zelf beoordeeld op een formaat dat het bedrijf zelf heeft bedacht, en de sterkste claim in het bericht — kalibratie — is degene die nog door geen enkele externe partij is getest. Beide dingen kunnen waar zijn.
Wat de lancering wel bevestigt is een richting: productie-stacks bewegen naar een mix van modeltypen die per taak worden gekozen, niet één enkel model dat per bedrijf wordt gekozen. Als dat de vorm van jouw systeem is, is de laag vóór de modellen de laag die je goed moet inrichten.
Bekijk hoe de TrueFoundry AI Gateway routeert over verschillende modeltypen →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Jev is the first model in a class TypeSafe AI calls System One Models, launched in early access on September 15, 2026. Rather than generating text, it takes unstructured input plus a schema you define in advance and returns typed values with calibrated confidence scores. It's aimed at decisions made inside software — classification, routing, scoring, extraction — rather than at chat.
They're models built to make fast, structured decisions that software consumes directly, named after Daniel Kahneman's fast, intuitive System 1 thinking. The defining trade is giving up free-form text generation in exchange for parallel sampling, guaranteed schema conformance, and a probability attached to every answer.
It can't produce an answer outside the schema you defined, which rules out invented fields, malformed output, and fabricated tool names. It can still select the wrong value from the allowed set — that's an accuracy question, not a format one, and TypeSafe's response to it is calibrated confidence rather than a claim of infallibility.
No. It's a proprietary model served from TypeSafe's own hosted API, currently behind an early-access waitlist. There are no published weights and no on-prem option today.
1,000+ LLMs through a single OpenAI-compatible API. Switching models means changing the model name in the request — same URL, same credentials — which is what makes swapping in a new provider a configuration change rather than an integration project.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.



Het laatste nieuws, artikelen en bronnen in je inbox