



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
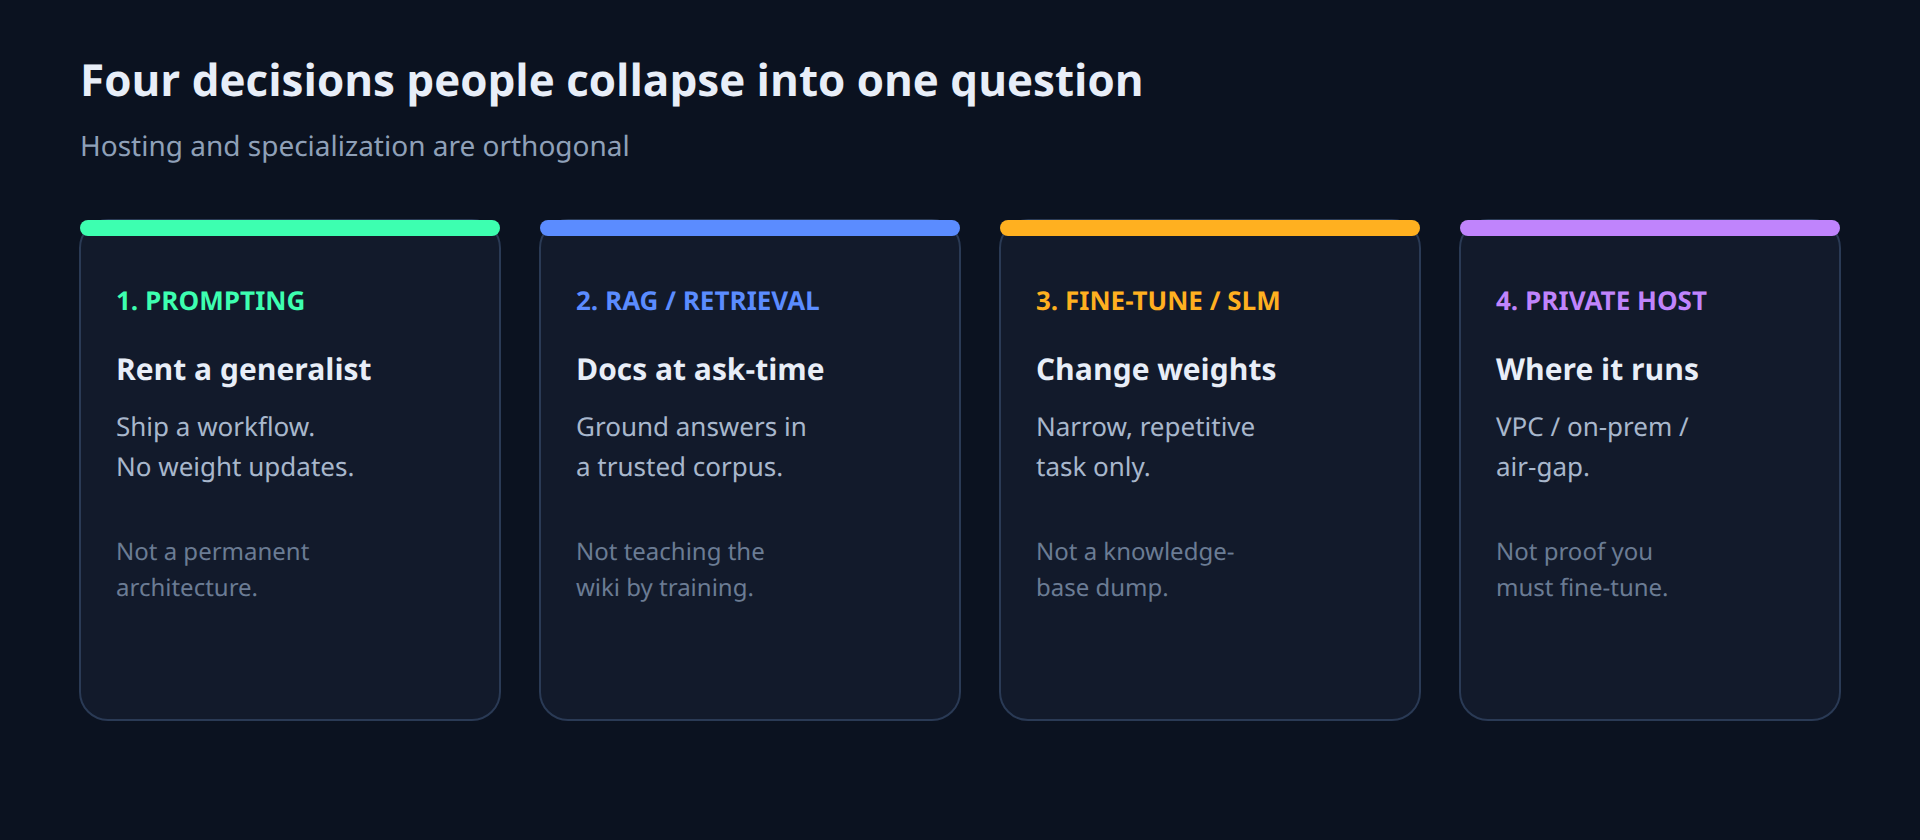
Teams vragen vaak "SLM of LLM?" alsof dat het product verklaart. Dat doet het niet. Vier verschillende beslissingen worden op één hoop gegooid:
Je kunt een private LLM prompten. Je kunt fine-tunen en nog steeds een publieke API aanroepen voor de open-ended onderdelen. Hosting en specialisatie staan los van elkaar. Het door elkaar halen hiervan is hoe gereguleerde teams een kwartaal lang vastlopen op GPU's terwijl de echte blokkade een ontbrekende documentindex was.
Om te zien hoe teams modelkeuze en uitgaven onder controle houden zodra er live verkeer is, bekijk wat een LLM gateway is. De gateway-vraag komt pas nadat je weet op welk spoor je zit.
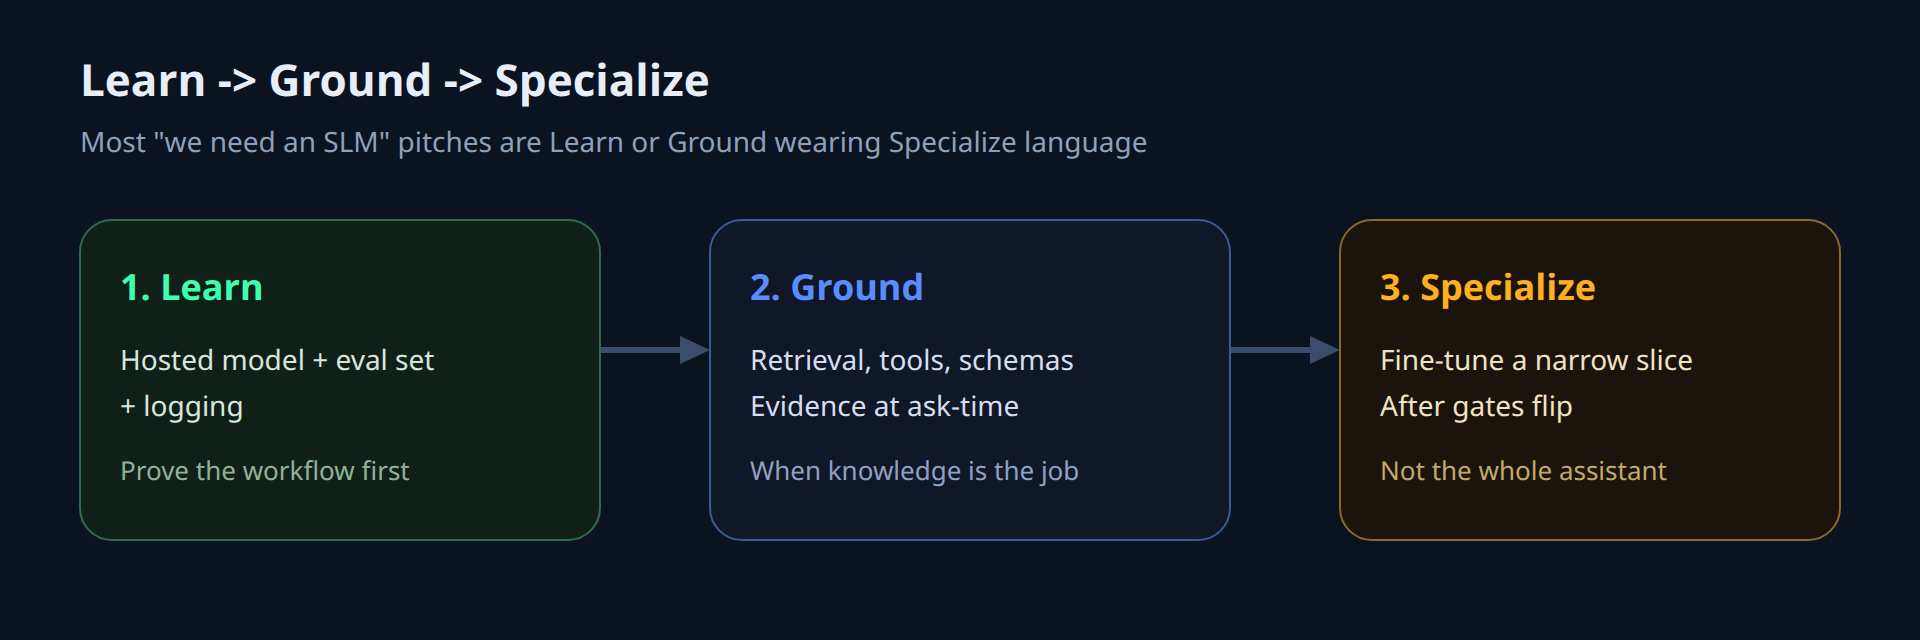
Zodra je die vier beslissingen scheidt, valt de roadmap uiteen in drie sporen:
De meeste "we hebben een SLM nodig"-pitches zijn eigenlijk Learn- of Ground-problemen gehuld in Specialize-taal.
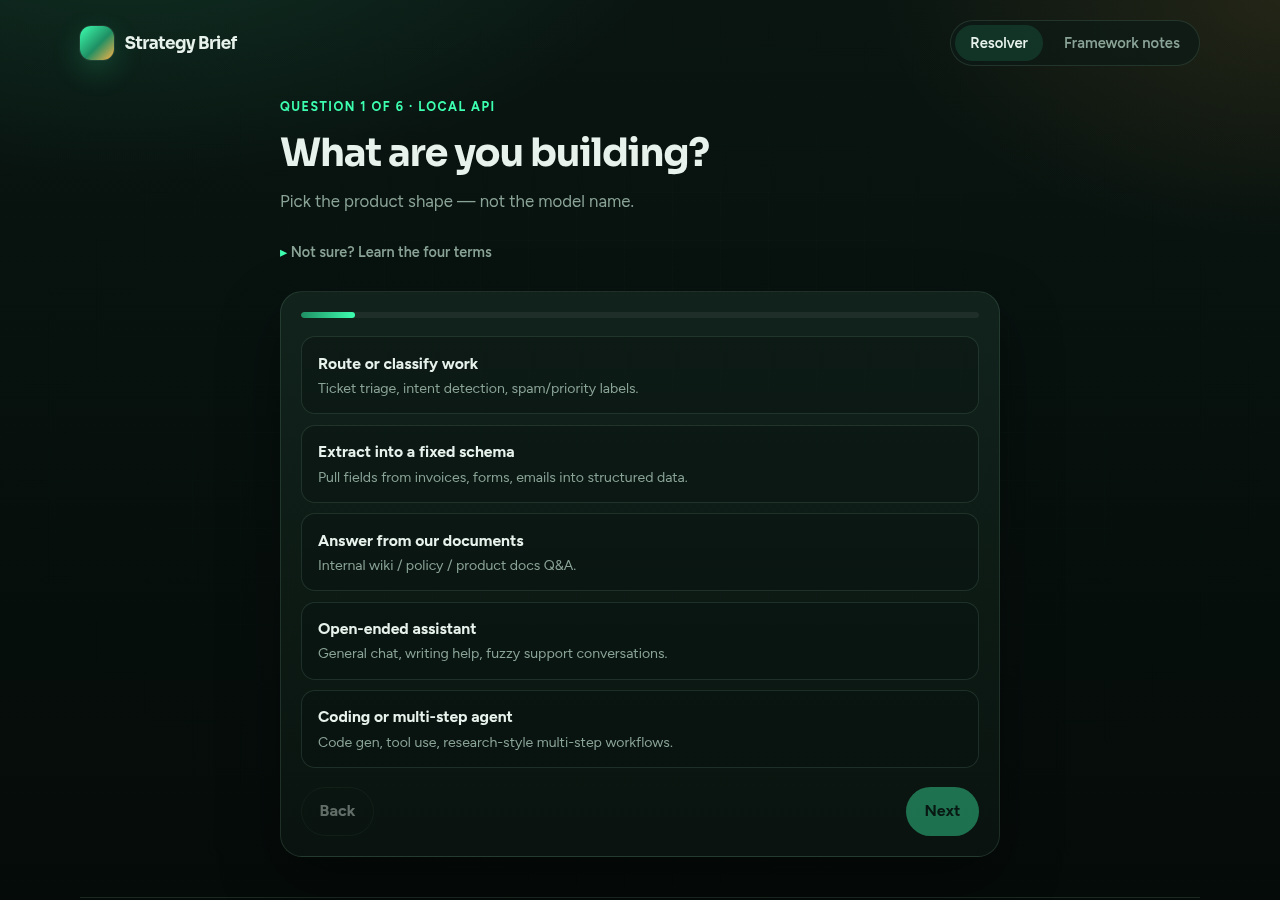
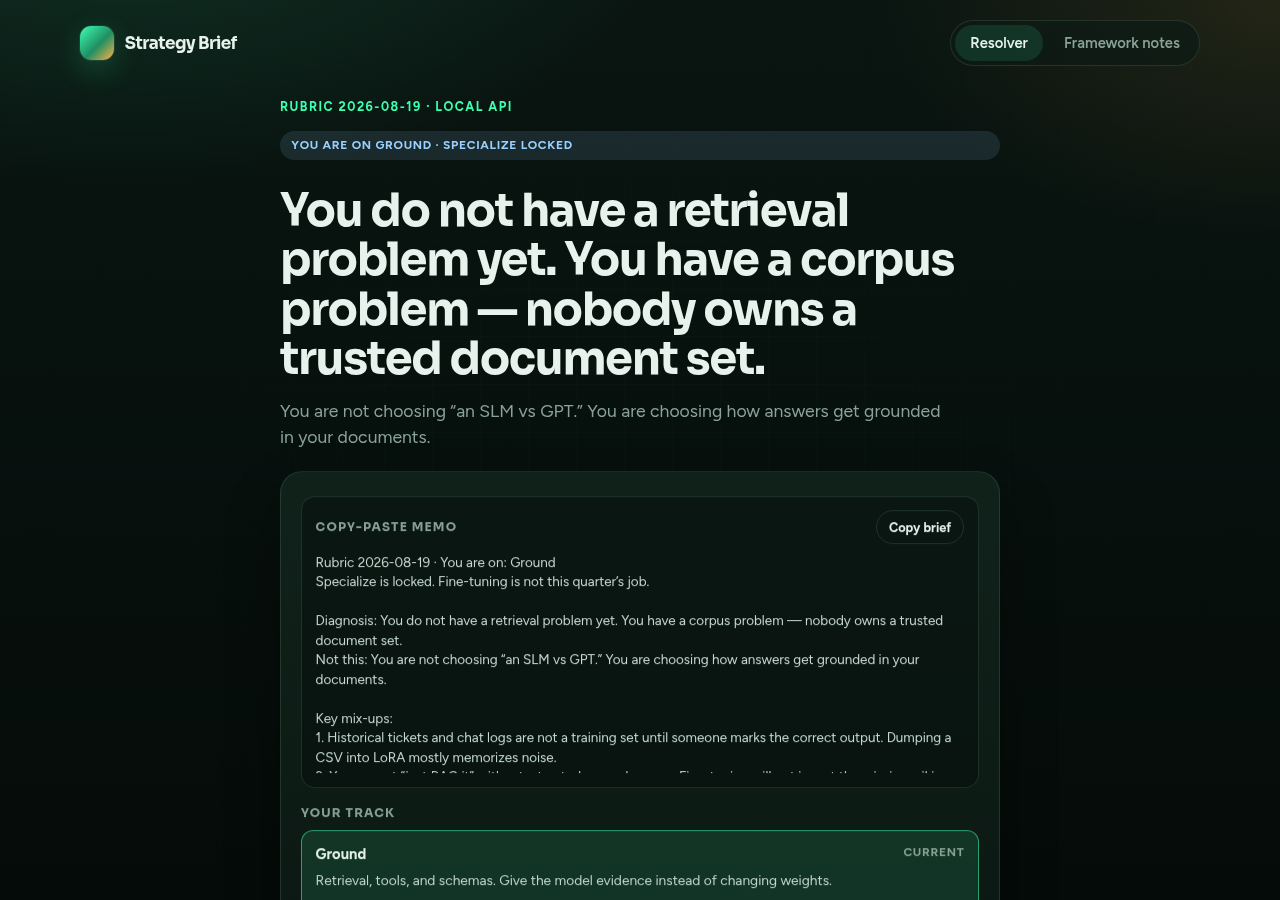
We hebben een kleine fine-tuning vs prompting resolver gebouwd rond dat kader. Beantwoord een handvol productvragen en het geeft een diagnose, vergrendelde vs huidige sporen, en een copy-paste memo. Elke keer dezelfde rubriek, zodat PM, eng en security vanuit hetzelfde document discussiëren.
Enthousiasme van ontwikkelaars maakt uit. Demo's van leveranciers maken minder uit. Geen van beide vervangt gates.
Is dit ticket-triage, veld-extractie, docs Q&A, open chat, of een multi-step agent?
Gesloten of aan schema's gebonden werk kan later worden gespecialiseerd. Open-ended assistenten en coding agents moeten bijna nooit als eerste worden gefine-tuned. Als je een specifieke subtaak kunt afsplitsen (classificeren, dan concept maken), specialiseer dan alleen die subtaak.
Interne / laag-risico gegevens kunnen starten op een publieke API met een normale review van de leverancier. PII van klanten heeft een privacyreview nodig. Gereguleerde data (PHI, financiële residentie, air-gap) dwingt tot VPC of on-prem.
Die beslissing betreft hosting. Het ontgrendelt op zichzelf geen fine-tuning. Voor uitgaven en latency zodra het volume groeit, is LLM cost optimization de parallelle discussie, geen vervanging voor labels.
Historische tickets en chatlogs zijn geen trainingsset totdat iemand de juiste output heeft gemarkeerd. Het dumpen van een CSV in LoRA memoriseert voor het grootste deel ruis.
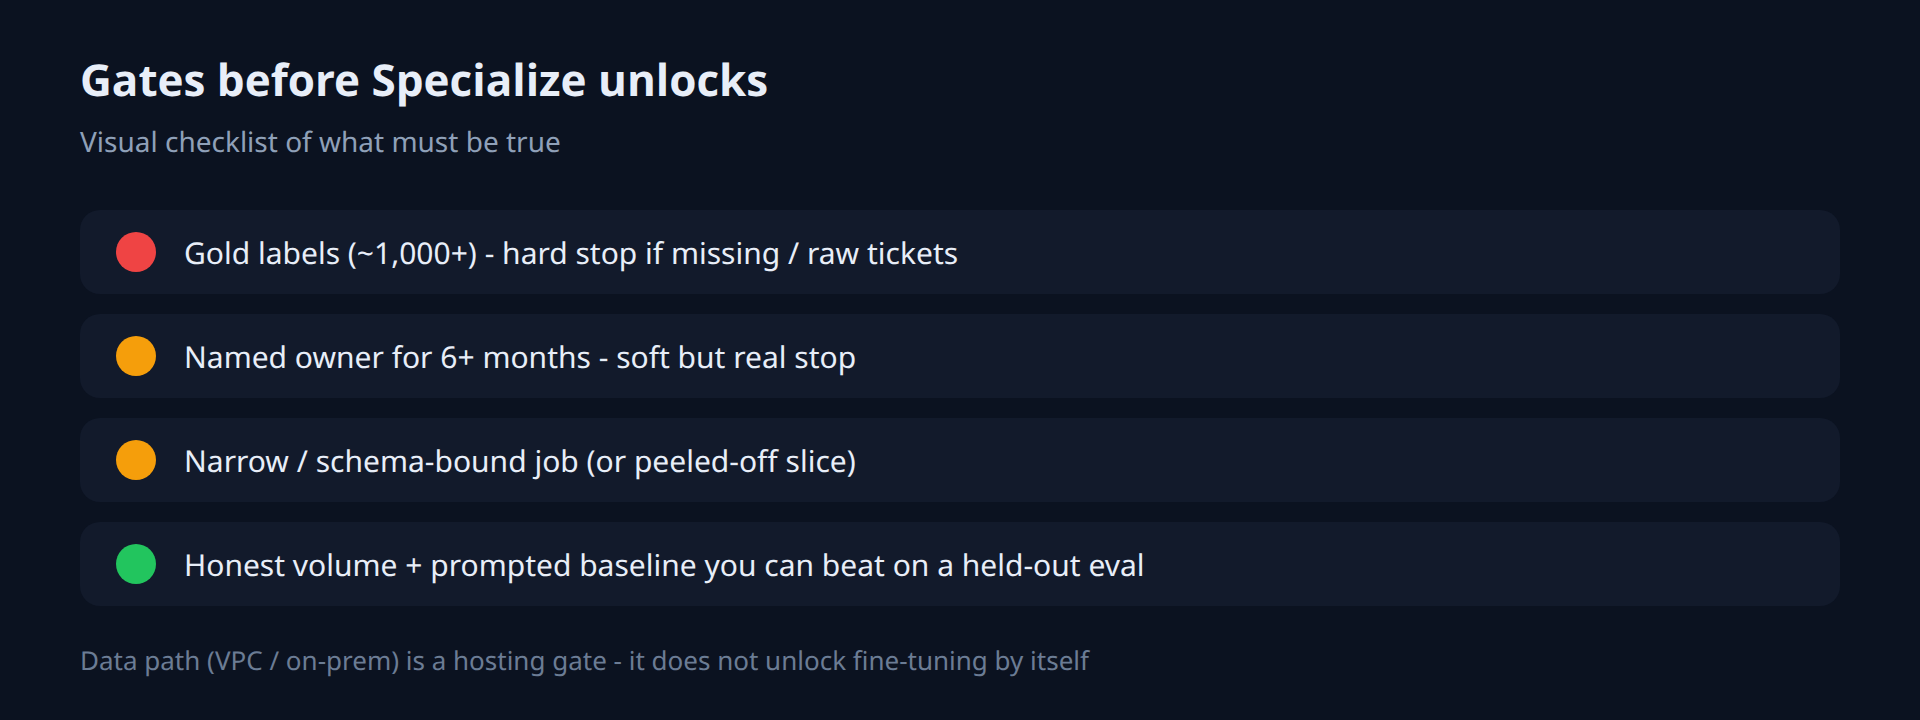
Als iemand zegt "we hebben wat voorbeelden," vraag dan of die goud of ruw zijn. Ruw telt als geen.
Fine-tuning zonder eigenaar is een bevroren prompt die je niet veilig kunt bijwerken wanneer data of het basismodel verandert. Evals, drift en hernieuwde deployments hebben een verantwoordelijke naam nodig. "Misschien later" is Learn, niet Specialize.
Pilots verdienen de GPU plus MLOps zelden terug. Honderden requests per dag kunnen nog steeds in het voordeel van API's spreken. Een hoog stabiel volume is wanneer de kostprijs per eenheid en latency een specialist beginnen te rechtvaardigen, en alleen nadat de andere gates zijn gepasseerd.
Vraag eng om de eval-set, het loggingplan, en of er al een geprompte baseline bestaat. Vraag security naar allowlists voor leveranciers, prompt-logging, en wat er gebeurt als een toekomstige functie PII begint te verzenden. Sla dit over en de fine-tune wordt een verrassing op het gebied van compliance nadat de eerste demo is geland.
Iemand wil dat het model "onze wiki kent." Dat is retrieval. Fine-tuning gaat geen ontbrekende pagina's bedenken of up-to-date blijven wanneer documenten veranderen. Als niemand een corpus beheert, heb je nog geen RAG-probleem. Je hebt een corpusprobleem. Ground eerst.
Dit is een van de weinige plekken waar Specialize een plek verdient. Houd een geprompte baseline op dezelfde eval. Voer één specifiek LoRA-experiment uit. Argumenteer pas daarna over een beheerd private endpoint vs self-host. Classificatie en extractie zijn de gebruikelijke succesfactoren, niet "vervang de hele assistent."
Teams proberen persoonlijkheid in een klein model te fine-tunen en vragen zich af waarom de kwaliteit instort bij randgevallen. Houd de open-ended agent op een generiek model. Als er een gesloten stap is vóór het opstellen van het concept (intentie, route, extractie), splits die dan af en specialiseer alleen die specifieke stap.
De spreadsheet heeft duizenden rijen. Niemand heeft ze als correct gemarkeerd. Behandel het als geen labels totdat er een beoordeling is. Specialize blijft niet voor niets vergrendeld.
Privacy kan VPC- of on-prem hosting afdwingen. Het dwingt geen gewichtsupdates af. Veel gereguleerde teams zouden een private LLM moeten prompten (Learn) of zoeken over een private index (Ground) lang voordat ze gaan trainen.
Druk op de uitgaven is reëel. Trainen zonder een onafhankelijk scorebord is hoe je een specialist oplevert die het aflegt tegen de geprompte baseline die je nooit hebt gemeten. Repareer eerst het harnas. Om routine-taken naar goedkopere modellen te routen terwijl je leert (Learn), is een LLM router vaak een goedkopere hefboom dan een fine-tune.
Wanneer de discussie begint, dwing drie zinnen af:
Lijst vervolgens de harde gates op met hun ernst. Geen labels is een harde stop. Geen eigenaar is een zachte, maar reële stop. "Wat labels" is een volgorde-probleem: genoeg om te meten, niet genoeg om te trainen. Het datapad is een hosting-gate, geen ontgrendeling van specialisatie.
We gebruiken die structuur in de strategy resolver. De output is een korte memo die PM's in een PRD of Slack-thread kunnen plakken, met de versie van de rubriek bovenaan, zodat discussies aan dezelfde regels verankerd blijven.
Het spoor kiezen is de helft van het werk. Zodra er live verkeer is, verschijnen dezelfde problemen voor elke LLM-workload.
Modelselectie blijft een instellingsvoorkeur. Fine-tunes worden opgeleverd zonder een baseline. Uitgaven en kwaliteit blijven onzichtbaar totdat iemand klaagt.
Teams die voorop blijven lopen, plaatsen meestal een controlelaag voor het modelverkeer. Een AI gateway bevindt zich tussen applicaties en providers. Het stelt standaarden in, regelt wie frontier-modellen mag aanroepen, kent kosten toe per team, en houdt inference binnen de juiste netwerkgrens. Voor de werking hiervan, zie LLM gateway en multi-model routing.
TrueFoundry's AI Gateway is één optie die voor die taak is gebouwd: één OpenAI-compatibele API over 1.000+ modellen, met quota, RBAC, kosten-tracking en routing-policies. Je kunt het draaien in je VPC, on-prem, air-gapped, of hybride, zodat de datapad-beslissing van eerder afdwingbaar blijft. Wanneer Specialize eindelijk ontgrendelt, dekt TrueFoundry's trainings- en fine-tuning pad het specifieke LoRA-werk af zonder eerst een afzonderlijke MLOps-stack toe te voegen.
Als model governance, private hosting, of een schoon pad van geprompte baseline naar specialist nog openstaan nadat je een spoor hebt gekozen, is het de moeite waard om te bekijken.
Fine-tuning vs prompting is een beslissing over budgettering en volgorde, geen merkvoorkeur. De meeste teams zouden dit kwartaal moeten Learn-en of Ground-en. Specialize moet worden verdiend: een specifieke taak, gouden labels, een genoemde eigenaar, eerlijk volume, en een geprompte baseline die je kunt verslaan.
Breng de taak in kaart voordat je een model noemt. Scheid hosting van fine-tuning. Tel beoordeelde voorbeelden, geen ticketdumps. Geef finance en security een spoor en een gatelijst, geen stemming op gevoel.
We hebben het meeste hiervan geleerd na het observeren van "laten we fine-tunen"-projecten die een kwartaal opslokten en alsnog zakten voor een eval waar het geprompte model al voor geslaagd was. De modelcatalogus zal blijven groeien. De gates worden niet simpeler. De strategische kant vroegtijdig goed krijgen, bespaart later veel ongemakkelijke herzieningen van de roadmap.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



When the job is narrow and repetitive, you have ~1,000+ clean labeled examples, a named owner for evals and redeploys, enough volume that unit cost or latency hurts, and a prompted baseline you can beat on a held-out set. If any of those are missing, keep prompting (and add RAG if the job is knowledge).
Fine-tuning changes model weights for a specialist behavior. RAG retrieves trusted docs at ask-time so answers stay grounded and fresh. Private hosting is where inference runs. You can combine them in any order; picking VPC hosting does not mean you must fine-tune.
Usually one of: no held-out eval, labels that were raw tickets, an open-ended job that should not have been specialized, or no owner to keep the specialist from drifting. Specialize without a scoreboard is guessing.
Route traffic through an AI gateway. Set default models. Gate premium access. Expose per-team spend. TrueFoundry's AI Gateway gives engineering leads usage and cost visibility across 1,000+ LLMs behind one OpenAI-compatible API, so model choices do not pile into billing surprises while you are still proving the product.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.



Het laatste nieuws, artikelen en bronnen in je inbox



















