



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De Snowflake MCP-server is een door Snowflake beheerd MCP-endpoint dat binnen een Snowflake-account draait. Model Context Protocol is de open standaard waarmee een AI-agent tools op een extern systeem kan ontdekken en aanroepen, en de implementatie van Snowflake zet Cortex-functies en ruwe SQL om in aanroepbare tools.
Het structurele verschil met een gehoste SaaS MCP-server: u bepaalt het tool-oppervlak. De server wordt aangemaakt met CREATE MCP SERVER ... FROM SPECIFICATION, waarbij de spec YAML is die elke tool, het type en de configuratie vermeldt. Er verschijnt niets in tools/list dat u er niet zelf in hebt geschreven.
Er worden vijf tooltypes ondersteund:
Een minimale spec is klein: één SYSTEM_EXECUTE_SQL-invoer met read_only: true, een timeout en een warehouse-naam, en u hebt een werkende data warehouse MCP-server. Cortex-tooltypes vereisen vereisten vooraf, hetzij een bestaande Cortex Search-service of een semantische view.
Drie limieten om te onthouden: maximaal 50 tools per server, antwoorden worden afgekapt op 250 KB, en MCP-serverobjecten worden niet gerepliceerd in failover-groepen.
De toepassingen die er echt toe doen, koppelen tools aan elkaar in plaats van één enkele query uit te voeren:
Het verschil tussen lezen en schrijven ziet er hier anders uit. Bij een data warehouse is lezen de gevaarlijke kant. Een verkeerde schrijfactie beschadigt meestal één tabel die u kunt herstellen. Een verkeerde leesactie kan stilzwijgend de PII van elke klant retourneren en honderden dollars aan compute kosten voordat iemand het merkt.
Eén analist die een MCP-client naar zijn eigen account laat wijzen is prima. Dertig analisten is een ander probleem.
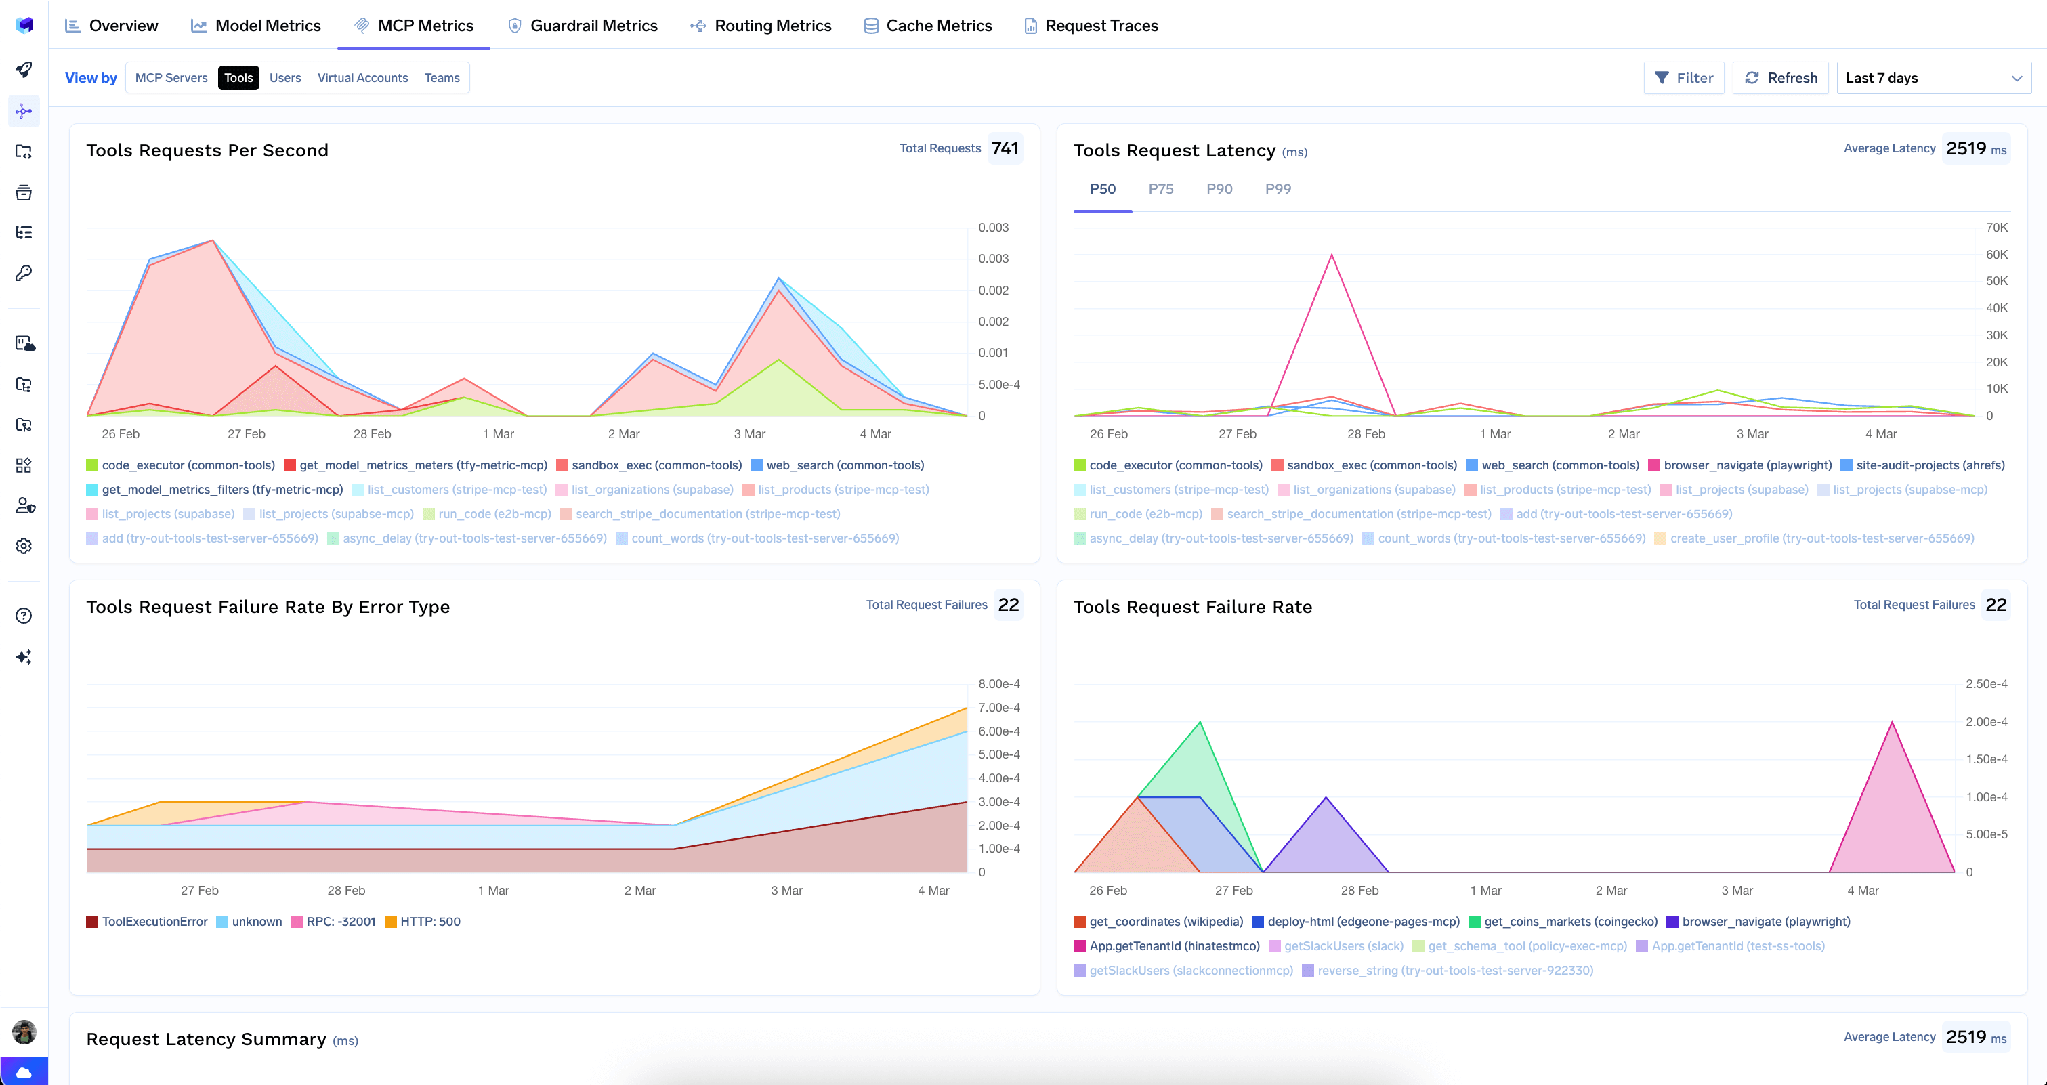
Compute-kosten worden nu een beslissing van de agent. Snowflake factureert warehouse compute per seconde zolang het warehouse draait, met een minimumheffing bij elke hervatting. Een agent die zijn eigen SQL schrijft, beslist zonder toezicht of er een partitie of een petabyte wordt gescand, en een ontbrekende WHERE-clausule op een grote feitentabel is een fout van één regel met een factuur van vier cijfers tot gevolg. Agents proberen het ook opnieuw: een aanroep die een timeout krijgt na 600 seconden en vijf keer opnieuw wordt geprobeerd, betekent vijf volledige scans, zonder dat iets in het protocol zegt dat hij moet stoppen. Dit is de enige server waar toolmetrieken en rate limits een budgetcontrole zijn, en geen administratieve luxe.
Breedte van het lezen. Een warehouse is het ene systeem waar alle gevoelige data al aan elkaar is gekoppeld. Uw repository bevat geheimen; uw ticketsysteem bevat klantnamen. Uw warehouse bevat bestellingen gekoppeld aan gebruikers gekoppeld aan betalingen, in een schema waar een brede rol bij kan. Eén enkele SELECT met een te brede scope is een groter risico dan alles wat een agent in Git of Jira zou kunnen doen, en het laat geen sporen van schade achter. De data verdwijnt gewoon.
Gedeelde inloggegevens vernietigen toewijzing. Als elke agent zich authenticeert als één servicegebruiker met één rol, heeft elke rij in de querygeschiedenis van Snowflake dezelfde actor. U kunt de vraag "welke agent, handelend voor wie, heeft om 2 uur 's nachts de betalingstabel gelezen" niet beantwoorden, en beleid per gebruiker is onmogelijk omdat er maar één gebruiker is.
Niemand is eigenaar van de spec. Twee teams schrijven twee versies, één voorzichtige en één met read_only: false en zonder timeout, en niemand beheert welke productie-agents worden geraakt.
Dat is een argument voor een control plane die er voor staat, wat het doel is van een MCP gateway.
Snowflake is geen catalogus-invoer met één klik. Het endpoint bevindt zich in uw account en de URL is accountspecifiek, dus u voert eerst de instelling aan de Snowflake-zijde uit en registreert vervolgens de resulterende URL via Connect any Remote MCP Server.
U hebt een Snowflake-account op een betaalde tier nodig, aangezien SQL-uitvoering is geblokkeerd bij proefversies, plus ACCOUNTADMIN of wereldwijde CREATE INTEGRATION, een hervatbaar warehouse, uw account-URL geschreven met koppeltekens in plaats van underscores, en een TrueFoundry MCP Server Group.
Stap 1: maak het MCP-serverobject aan. Voer in een Snowsight SQL Worksheet (Projects > Worksheets, niet het opnamescherm) CREATE OR REPLACE MCP SERVER uit met uw tool-spec. De SQL database, het schema en de servernaam worden onderdeel van de connector-URL, dus kies een beschrijfbaar, niet-systeemschema en vermijd $ in namen.
Stap 2: maak de OAuth-beveiligingsintegratie aan. Alleen ACCOUNTADMIN kan dit. Gebruik TYPE = OAUTH, OAUTH_CLIENT = CUSTOM, OAUTH_CLIENT_TYPE = 'CONFIDENTIAL' zodat het geheim aan de serverzijde blijft, OAUTH_ISSUE_REFRESH_TOKENS = TRUE, een geldigheid van het refresh-token in seconden, en OAUTH_ENFORCE_PKCE = TRUE. De redirect-URI is de callback die wordt getoond op TrueFoundry's Add MCP Server-formulier:
https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback
Eén valkuil: voeg geen BLOCKED_ROLES_LIST toe met ACCOUNTADMIN of SECURITYADMIN. OAUTH_ADD_PRIVILEGED_ROLES_TO_BLOCKED_LIST blokkeert deze standaard al, dus het vermelden ervan geeft een foutmelding. Haal inloggegevens op met SYSTEM$SHOW_OAUTH_CLIENT_SECRETS('<INTEGRATION_NAME>'), in hoofdletters.
Stap 3: maak een niet-beheerdersrol aan en verleen toegang. Beheerdersrollen zijn geblokkeerd voor OAuth, dus de gebruiker moet uitkomen op een niet-bevoorrechte standaardrol. Verleen USAGE op het warehouse, de database, het schema en de MCP-server, en verleen vervolgens afzonderlijk rechten per tool, zoals USAGE ON CORTEX SEARCH SERVICE of SELECT ON SEMANTIC VIEW. Toegang tot de server verleent geen toegang tot de tools ervan. Stel DEFAULT_ROLE en DEFAULT_WAREHOUSE in op de gebruiker; de OAuth-sessie wordt anders niet geïnitialiseerd.
Stap 4: sta gateway-egress toe. Als er netwerkbeleid is ingeschakeld, voeg dan de egress-IP's van TrueFoundry toe aan de allowlist. De gateway verbindt server-to-server vanaf de TrueFoundry-infrastructuur, niet vanaf de browser van de gebruiker, dus een werkende browsersessie bewijst niets. Op PrivateLink-accounts registreert u de openbare account-URL en houdt u het token-endpoint openbaar.
Stap 5: registreer in TrueFoundry. Klik in uw MCP Server Group op Add MCP Server en kies Connect any Remote MCP Server.
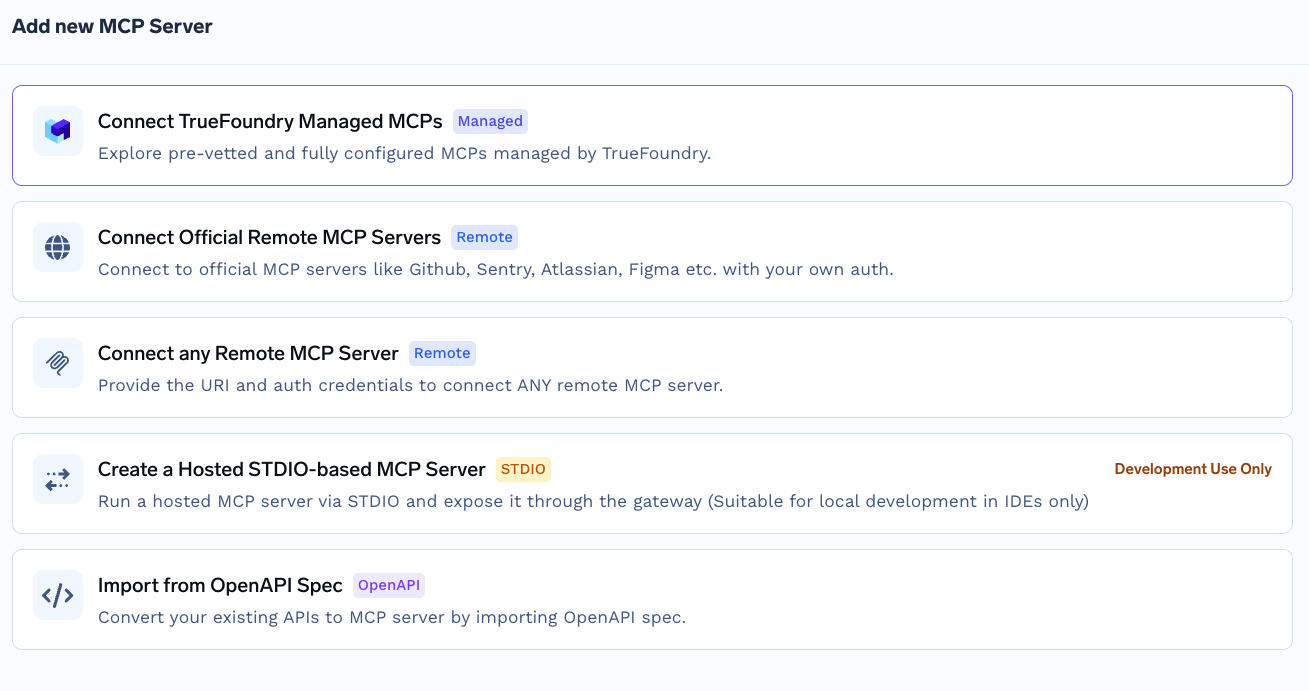
Voer de MCP-server-URL in, die deze vorm heeft:
https://<account_url>/api/v2/databases/<database>/schemas/<schema>/mcp-servers/<server_name>
Selecteer OAuth2 met grant type Authorization Code, en vul vervolgens de autorisatie-URL https://<account_url>/oauth/authorize in, de token-URL https://<account_url>/oauth/token-request, uw client ID en secret, Code Challenge Methods Supported S256, JWT Source Access Token, en Scopes refresh_token. Stel toegangsbeheer in en klik op Save. Sla de client ID en secret op in de TrueFoundry secrets store en verwijs naar de FQN in plaats van ze in te voegen.
Over scopes: behoud refresh_token, want zonder dit verlopen sessies ruwweg elke tien minuten. Verwijder de andere optie, session:role:<role>: de server negeert deze, omdat deze de rol afleidt uit DEFAULT_ROLE, en het voegt een hoofdlettergevoelige foutmodus toe.
TrueFoundry houdt inkomende authenticatie (hoe een client zich bewijst aan de gateway) gescheiden van uitgaande (hoe de gateway zich bewijst aan Snowflake). De twee lagen zijn onafhankelijk.
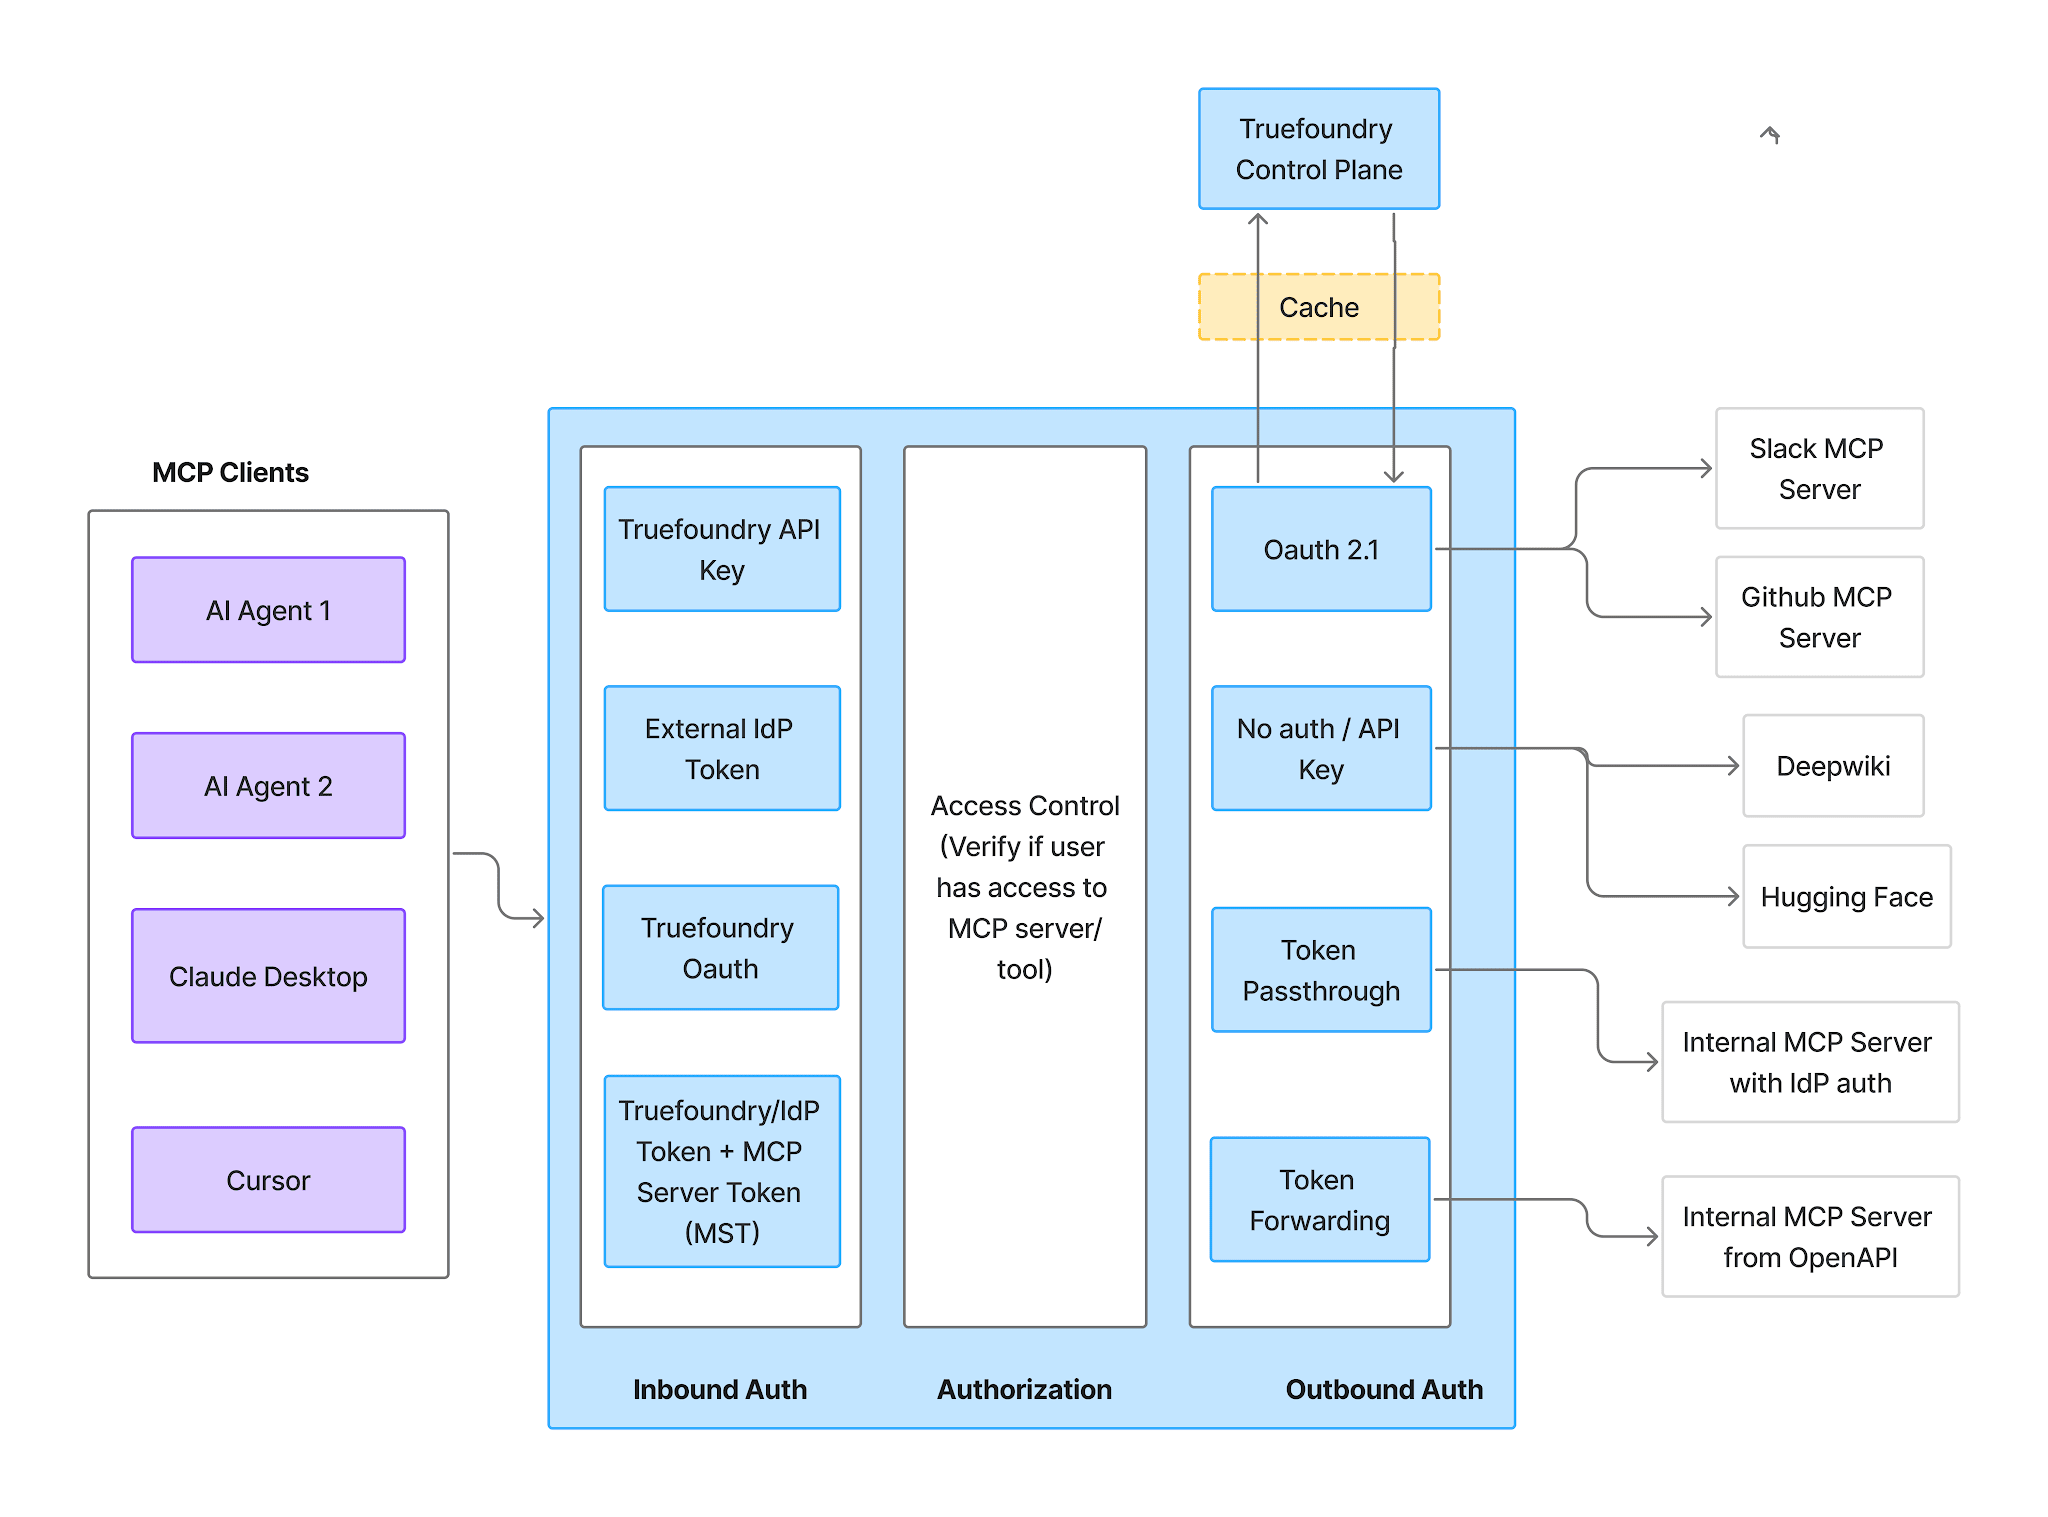
Inkomend ondersteunt vier methoden:
Virtual Account-tokens geven elke aanvraag identieke toegang, dus ze zijn hier onbruikbaar. Gebruik voor een data warehouse, waar het hele veiligheidsargument berust op het feit dat elke persoon zijn eigen rol erft, inkomend een PAT of een IdP-token.
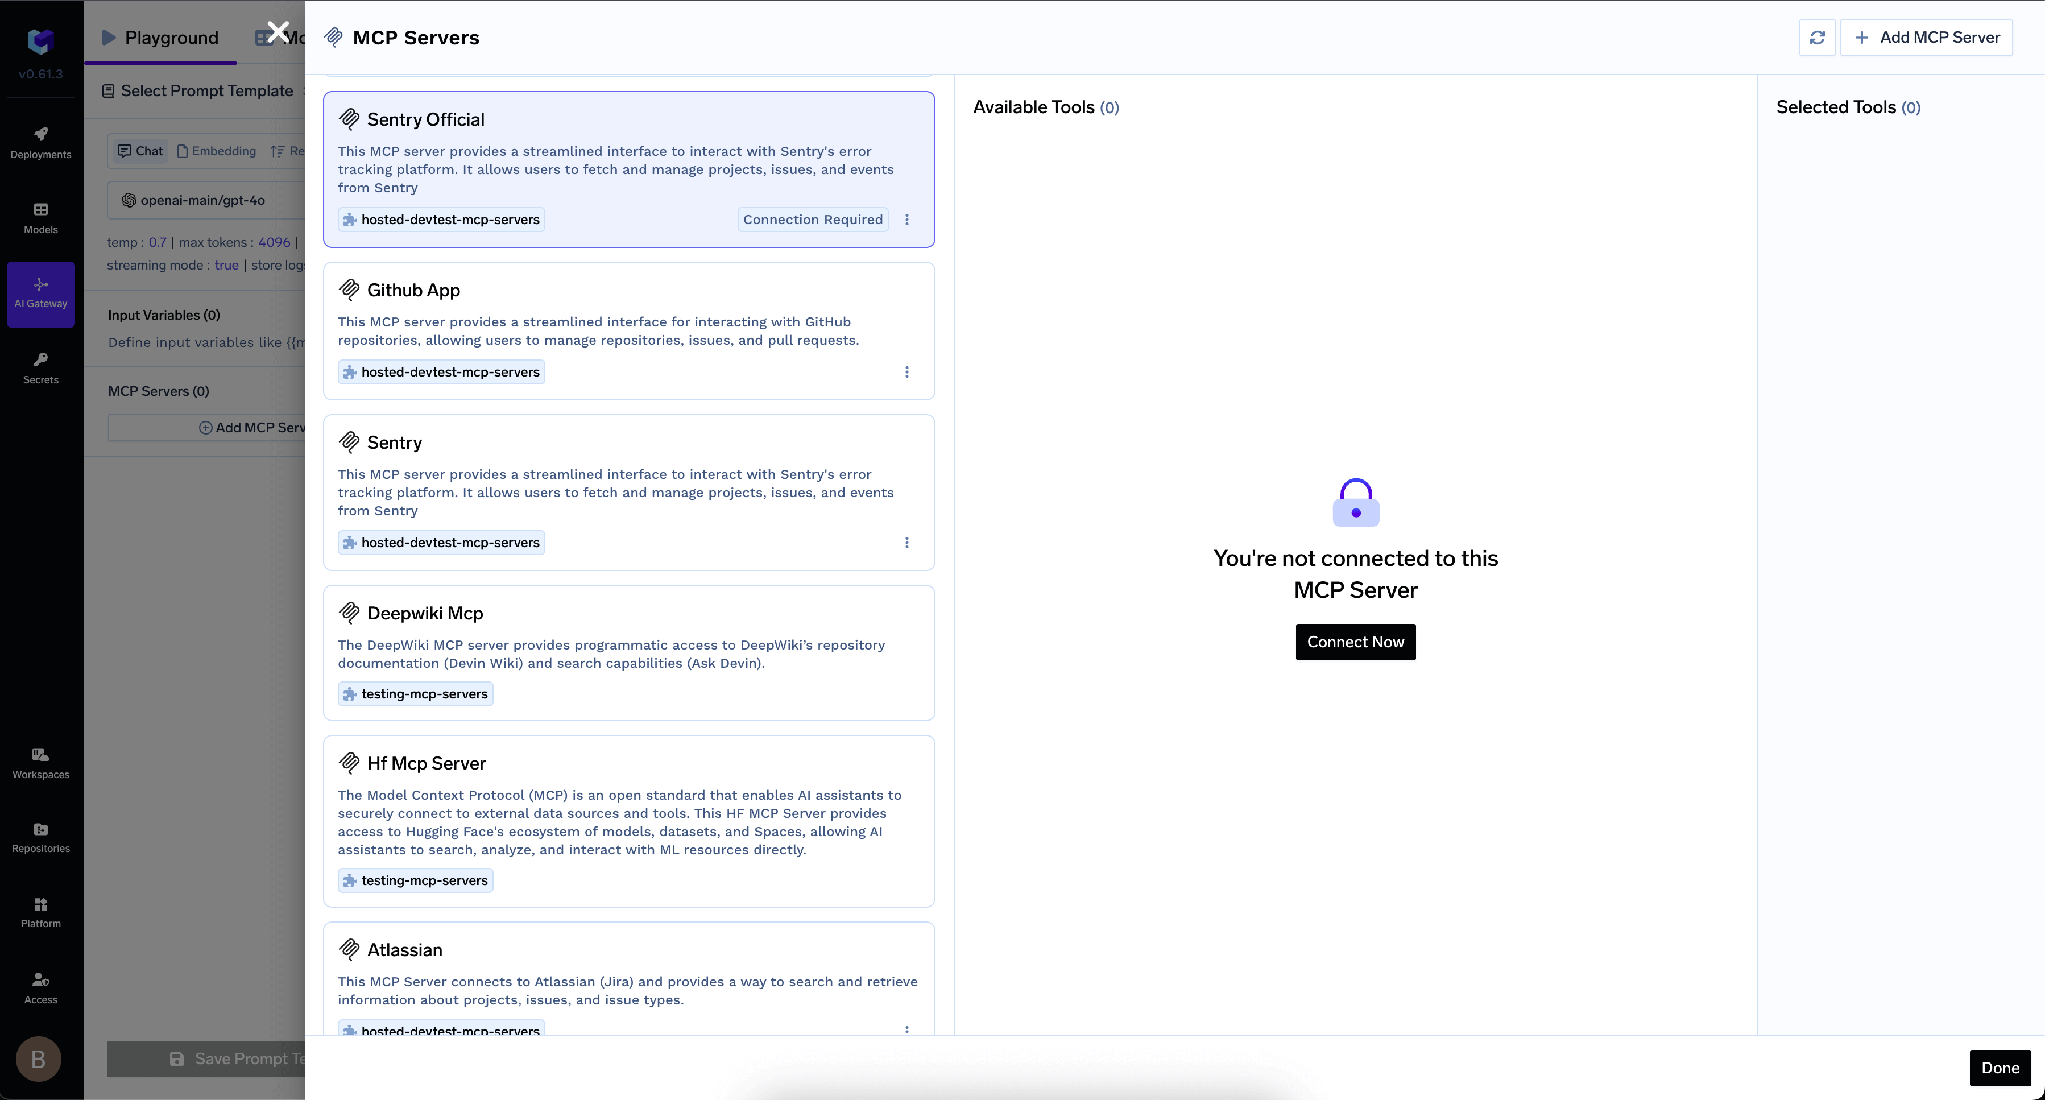
Uitgaand is Snowflake OAuth tegen de integratie die u hebt aangemaakt. Om te autoriseren opent u het gedeelte Tools van de server, of Add Tool/MCP Servers in de Playground, en klikt u op Connect Now. U wordt omgeleid naar Snowflake om toestemming te geven, en TrueFoundry ziet uw inloggegevens nooit.
Dit is het onderdeel dat uw data beschermt. Elke gebruiker werkt onder zijn eigen Snowflake RBAC-machtigingen, afgeleid via zijn DEFAULT_ROLE. De gateway beslist niet welke rijen u kunt zien. Snowflake doet dat. Alles wat u daar al hebt opgebouwd, blijft ongewijzigd van toepassing: roltoewijzingen op databases, schema's en tabellen, plus row access policies en dynamic data masking als u die gebruikt, die beide Snowflake Enterprise Edition of hoger vereisen [VERIFY]. Een agent die handelt voor een junior analist ziet precies wat die analist ziet.
Zorg dat de taakverdeling helder is: de gateway dwingt af welke tools bestaan, Snowflake dwingt af welke rijen terugkomen. Het uitschakelen van een tool kan het lekken van een tabel die een rol al mocht lezen niet ongedaan maken, en het aanscherpen van een rol kan niet voorkomen dat een agent een schrijftool aanroept die u ingeschakeld hebt gelaten. Zie MCP authenticatie voor meer informatie over de twee lagen.
Als elke klant een eigen Snowflake-account heeft, kan één client ID ze niet allemaal dekken, dus registreert u een afzonderlijke invoer per account.
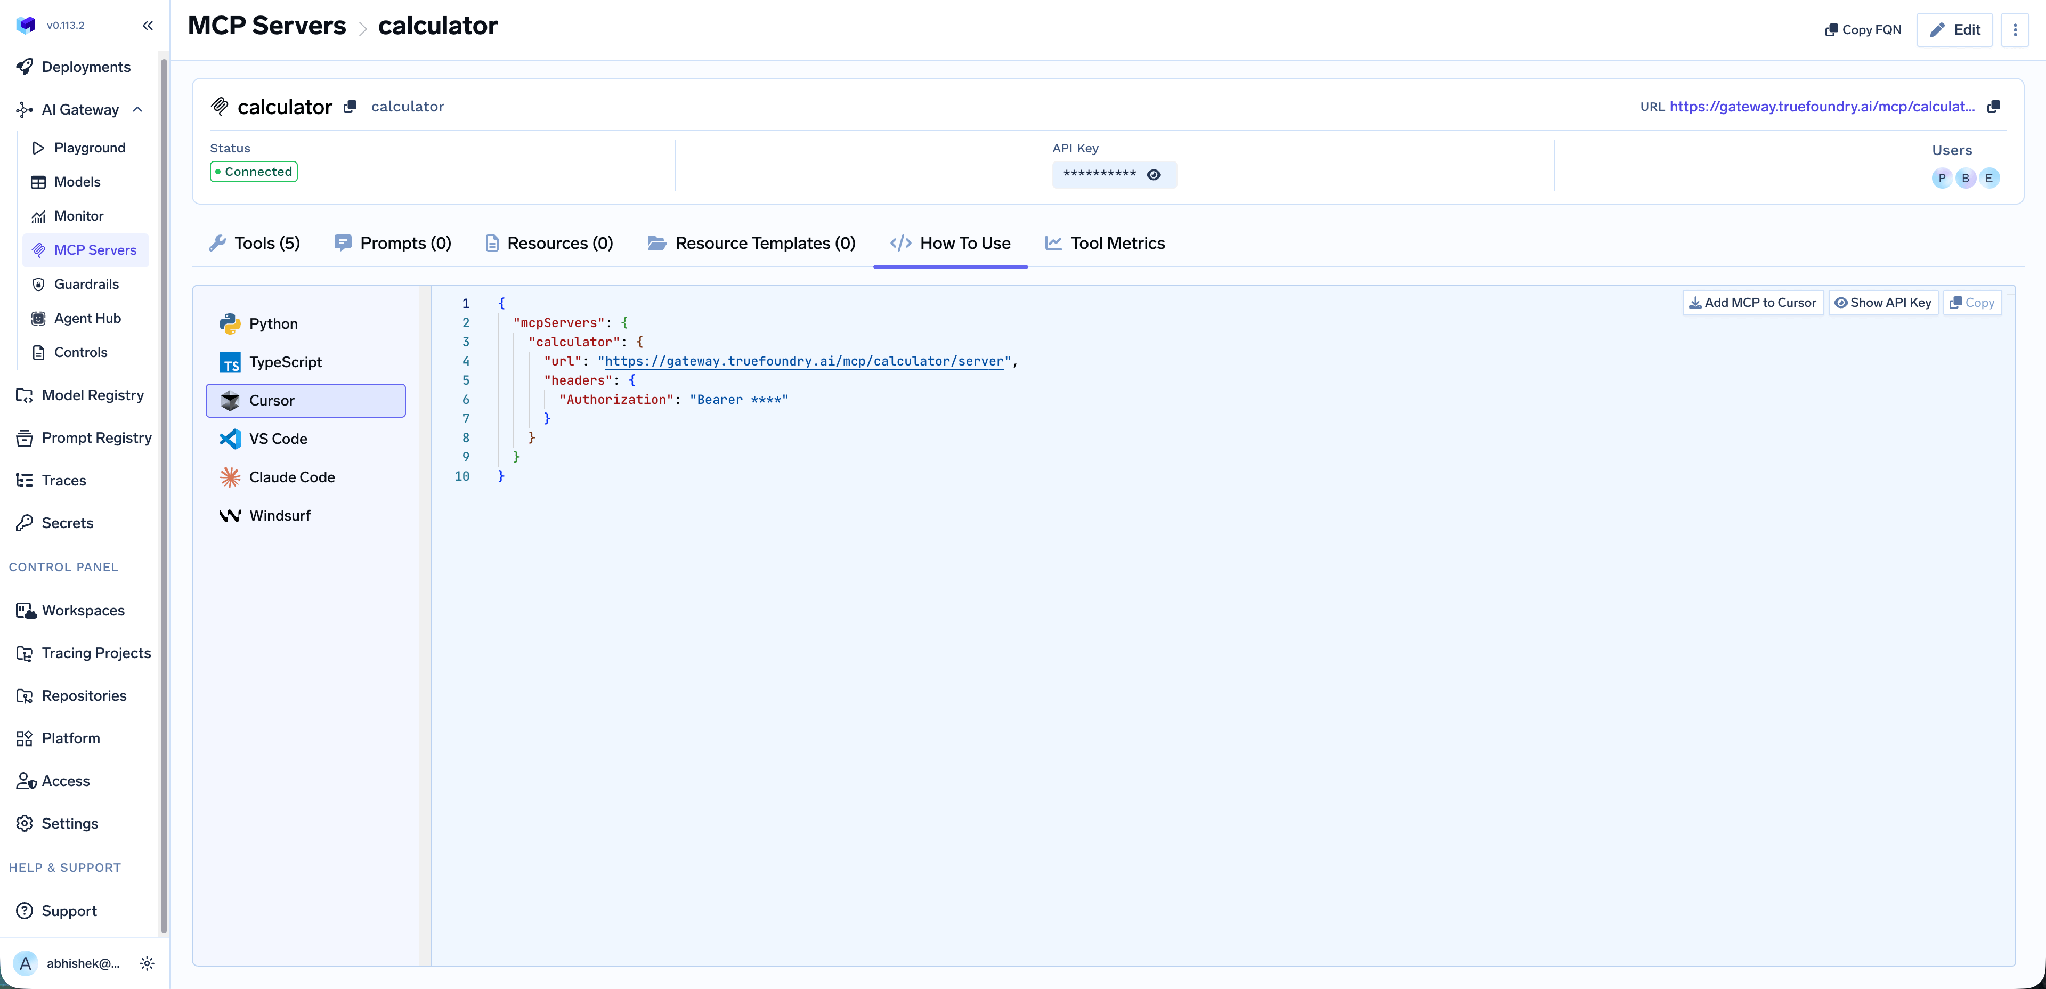
Eenmaal verbonden toont het tabblad Tools alles wat de server beschikbaar stelt.
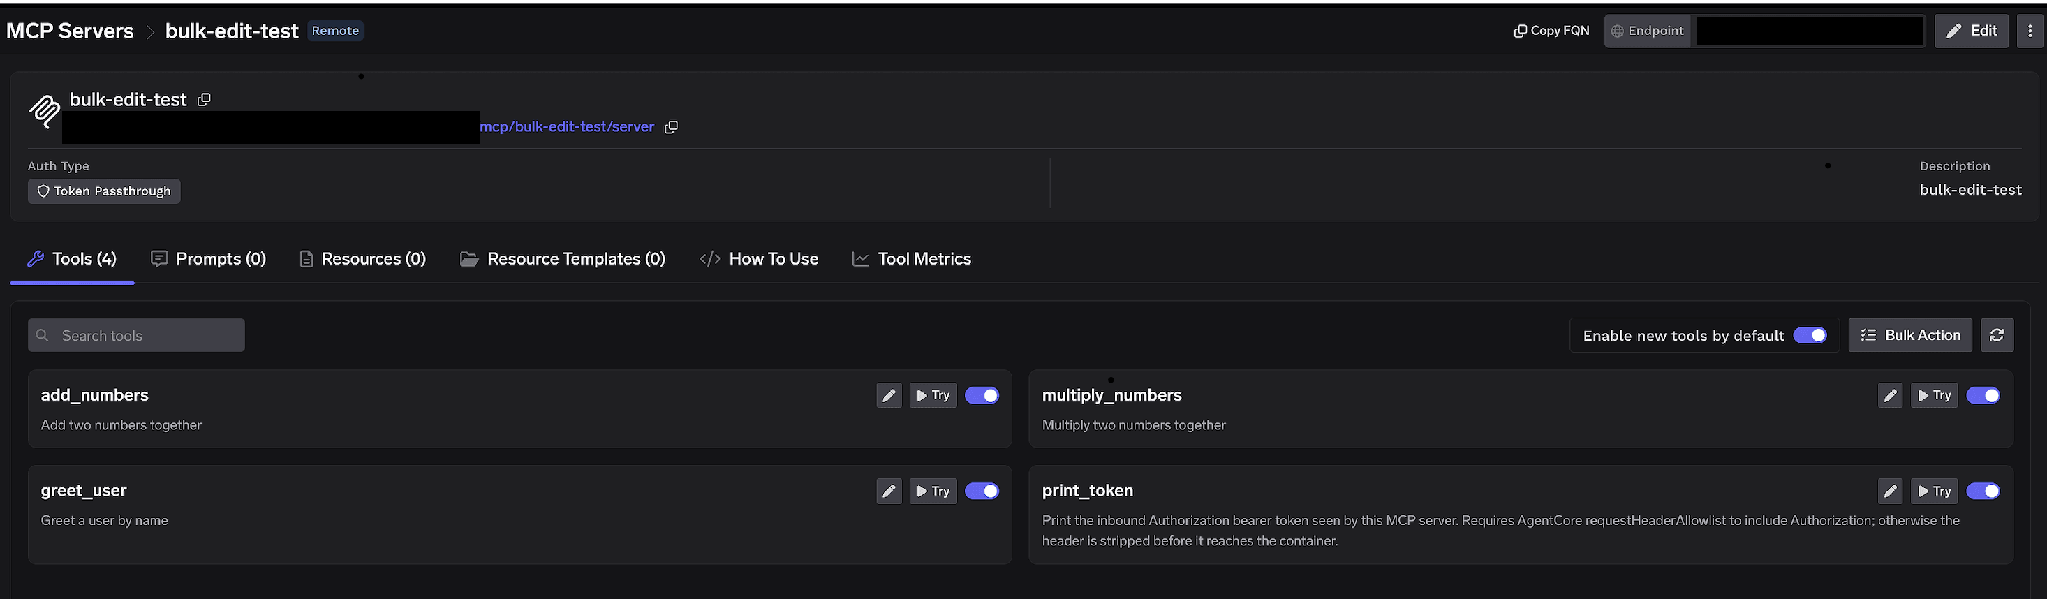
Schakelaars per tool. Schakel een tool uit en deze wordt volledig weggelaten uit tools/list. Clients zien de tool nooit en deze kan niet worden aangeroepen; dit is geen filtering op de prompt-laag. Het gebruikelijke warehouse-patroon is om Cortex Analyst en Cortex Search ingeschakeld te laten, terwijl ruwe SYSTEM_EXECUTE_SQL wordt uitgeschakeld. Analisten behouden hun query's in natuurlijke taal via een semantische view die u hebt samengesteld, en de agent verliest de mogelijkheid om willekeurige SQL samen te stellen tegen willekeurige tabellen. Dat is zowel goedkoper als veiliger.
Enable new tools by default. Als dit ingeschakeld blijft, bereiken tools die aan de Snowflake-spec worden toegevoegd automatisch de agents. Als dit is uitgeschakeld, zijn alleen tools die u expliciet hebt ingeschakeld bereikbaar. Aangezien de spec wordt bewerkt door wie Snowflake-rechten heeft en niet door wie de eigenaar van de gateway is, is uitschakelen het juiste antwoord: een spec-wijziging kan dan niet stilzwijgend uitbreiden wat productie-agents kunnen doen. Bulk Action verandert elke rij in een selectievakje, zodat u er veel tegelijk kunt omschakelen.
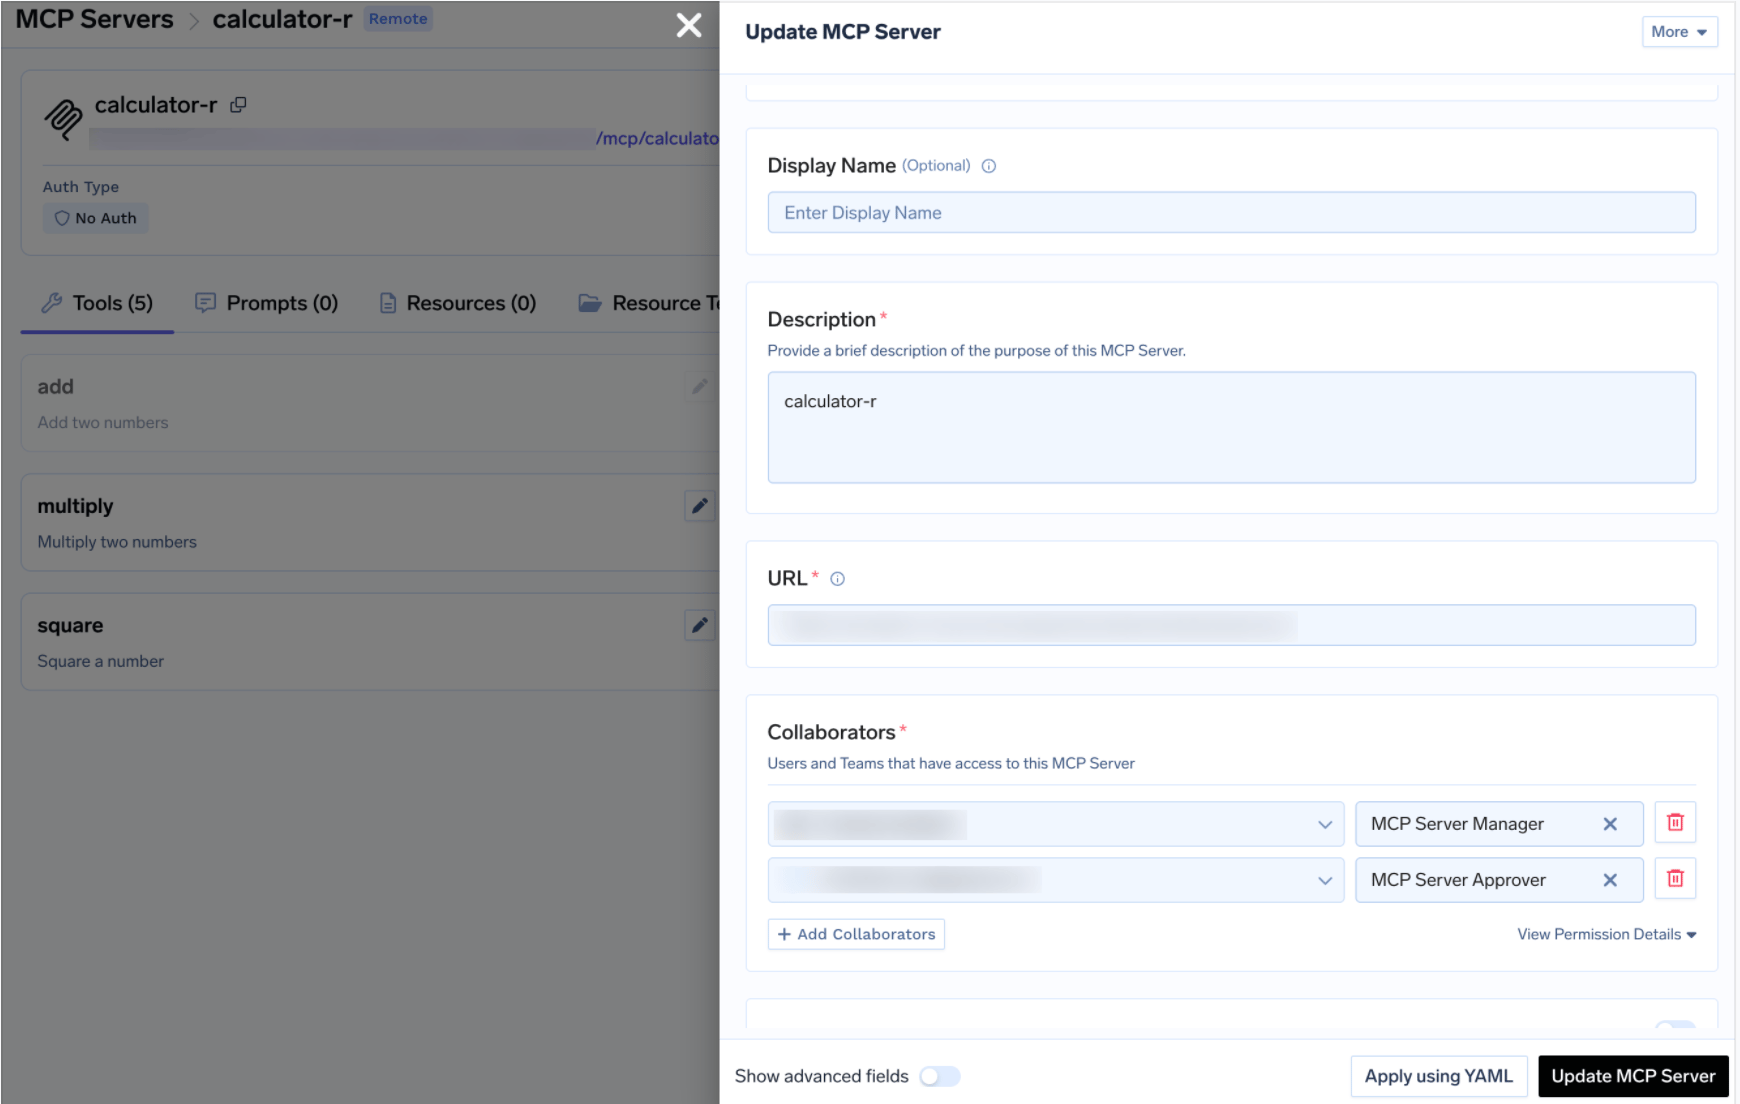
Klik op het potlood bij een tool om de weergave aan het model aan te passen:
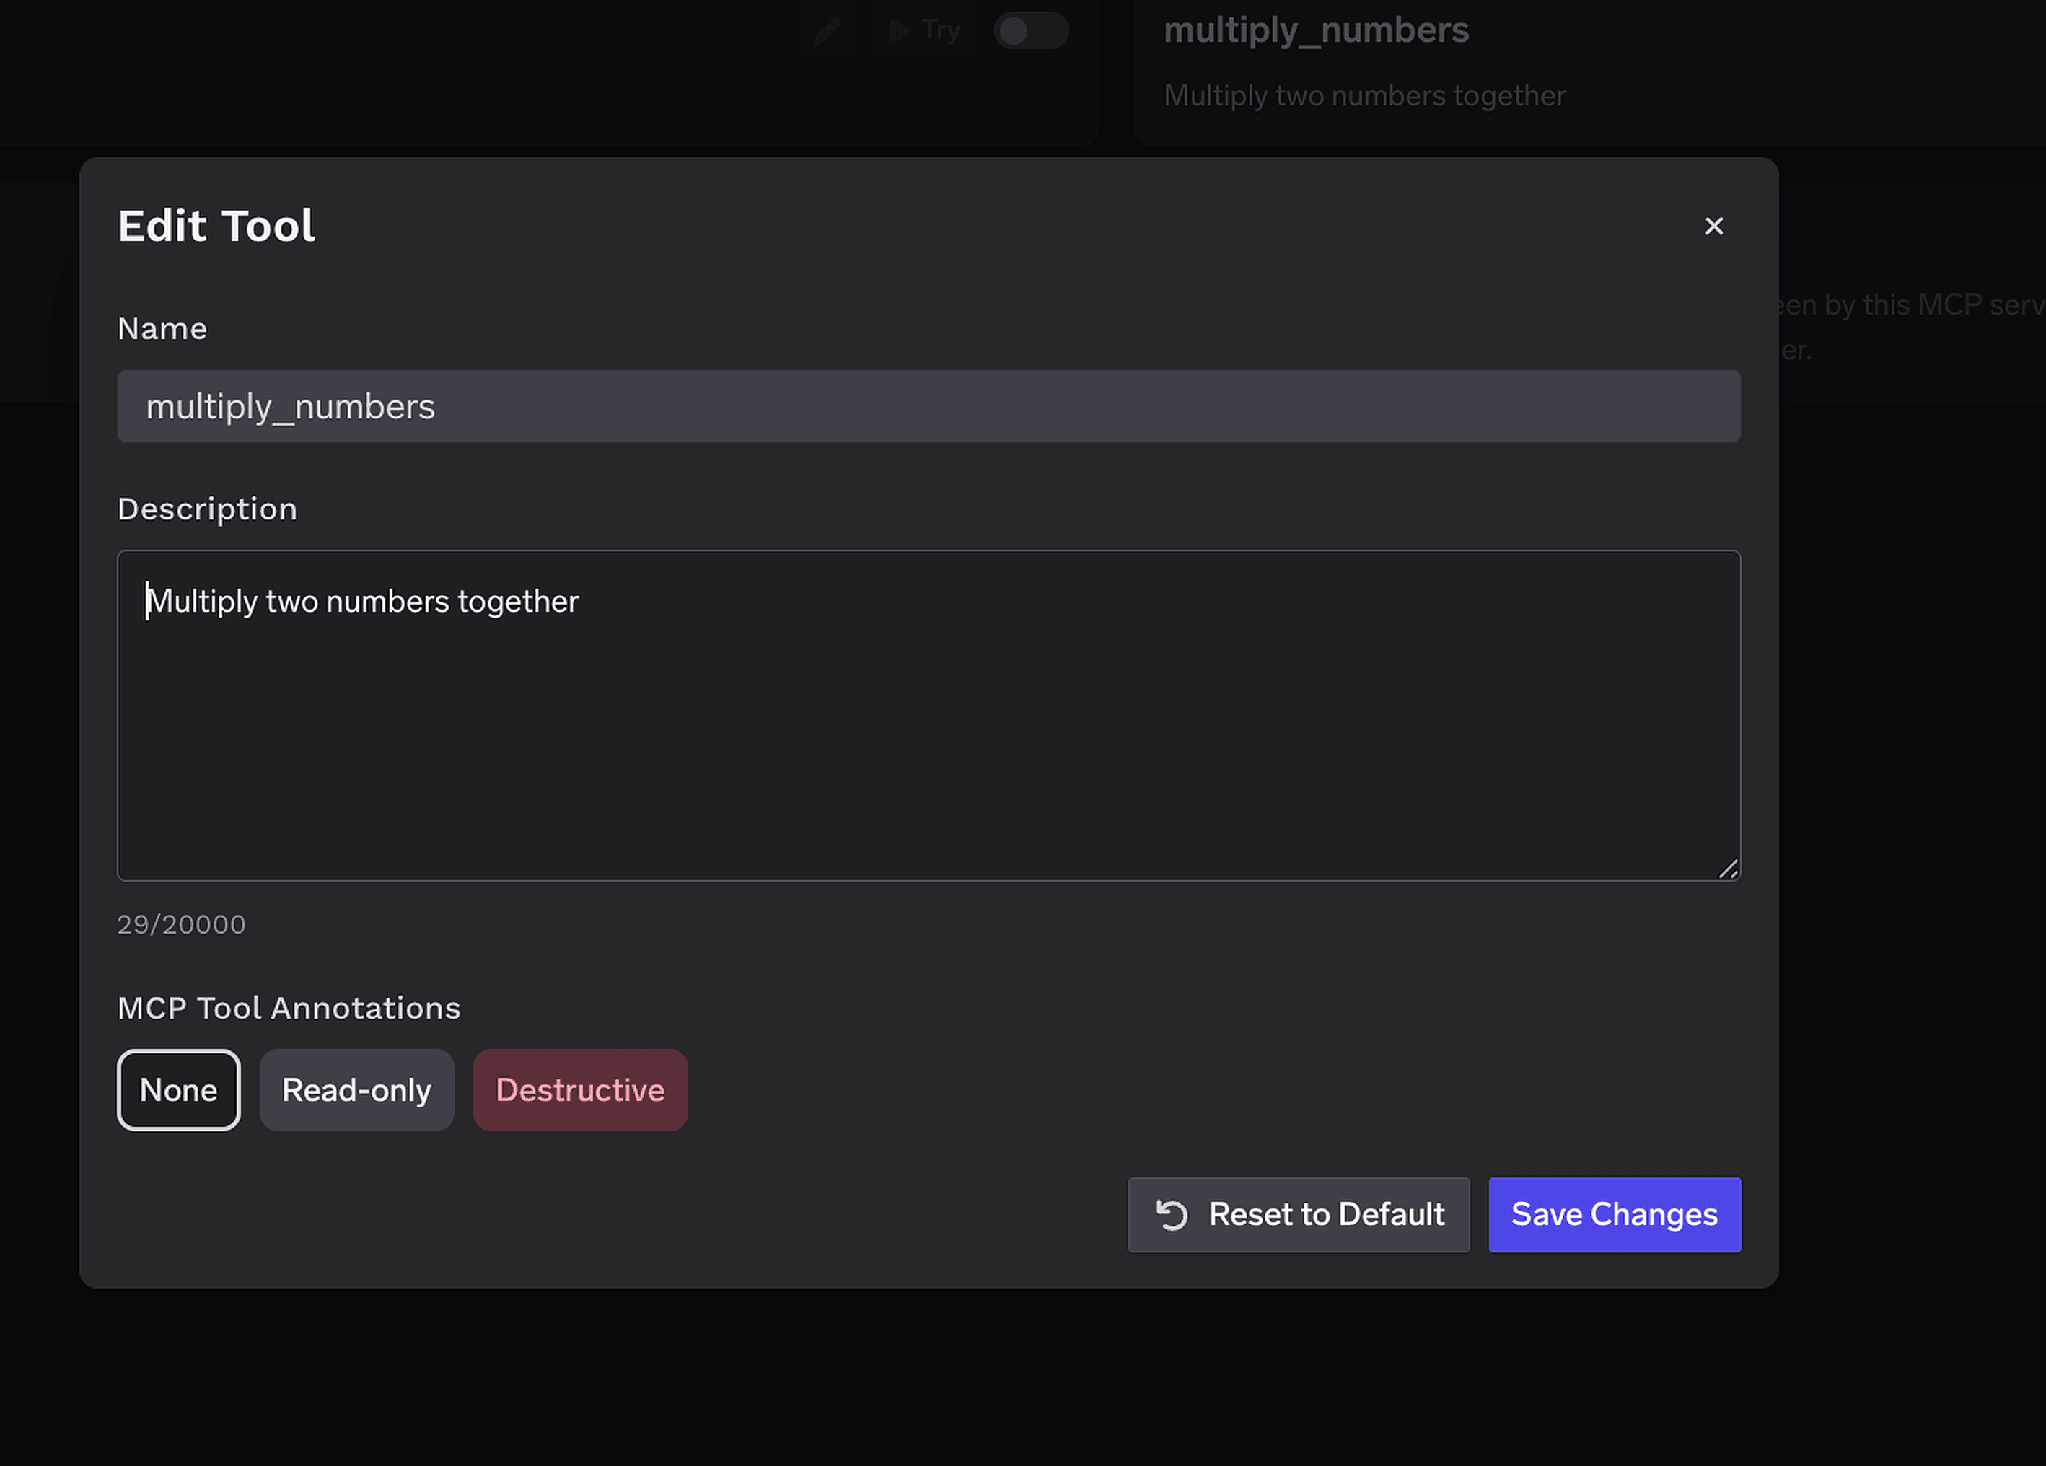
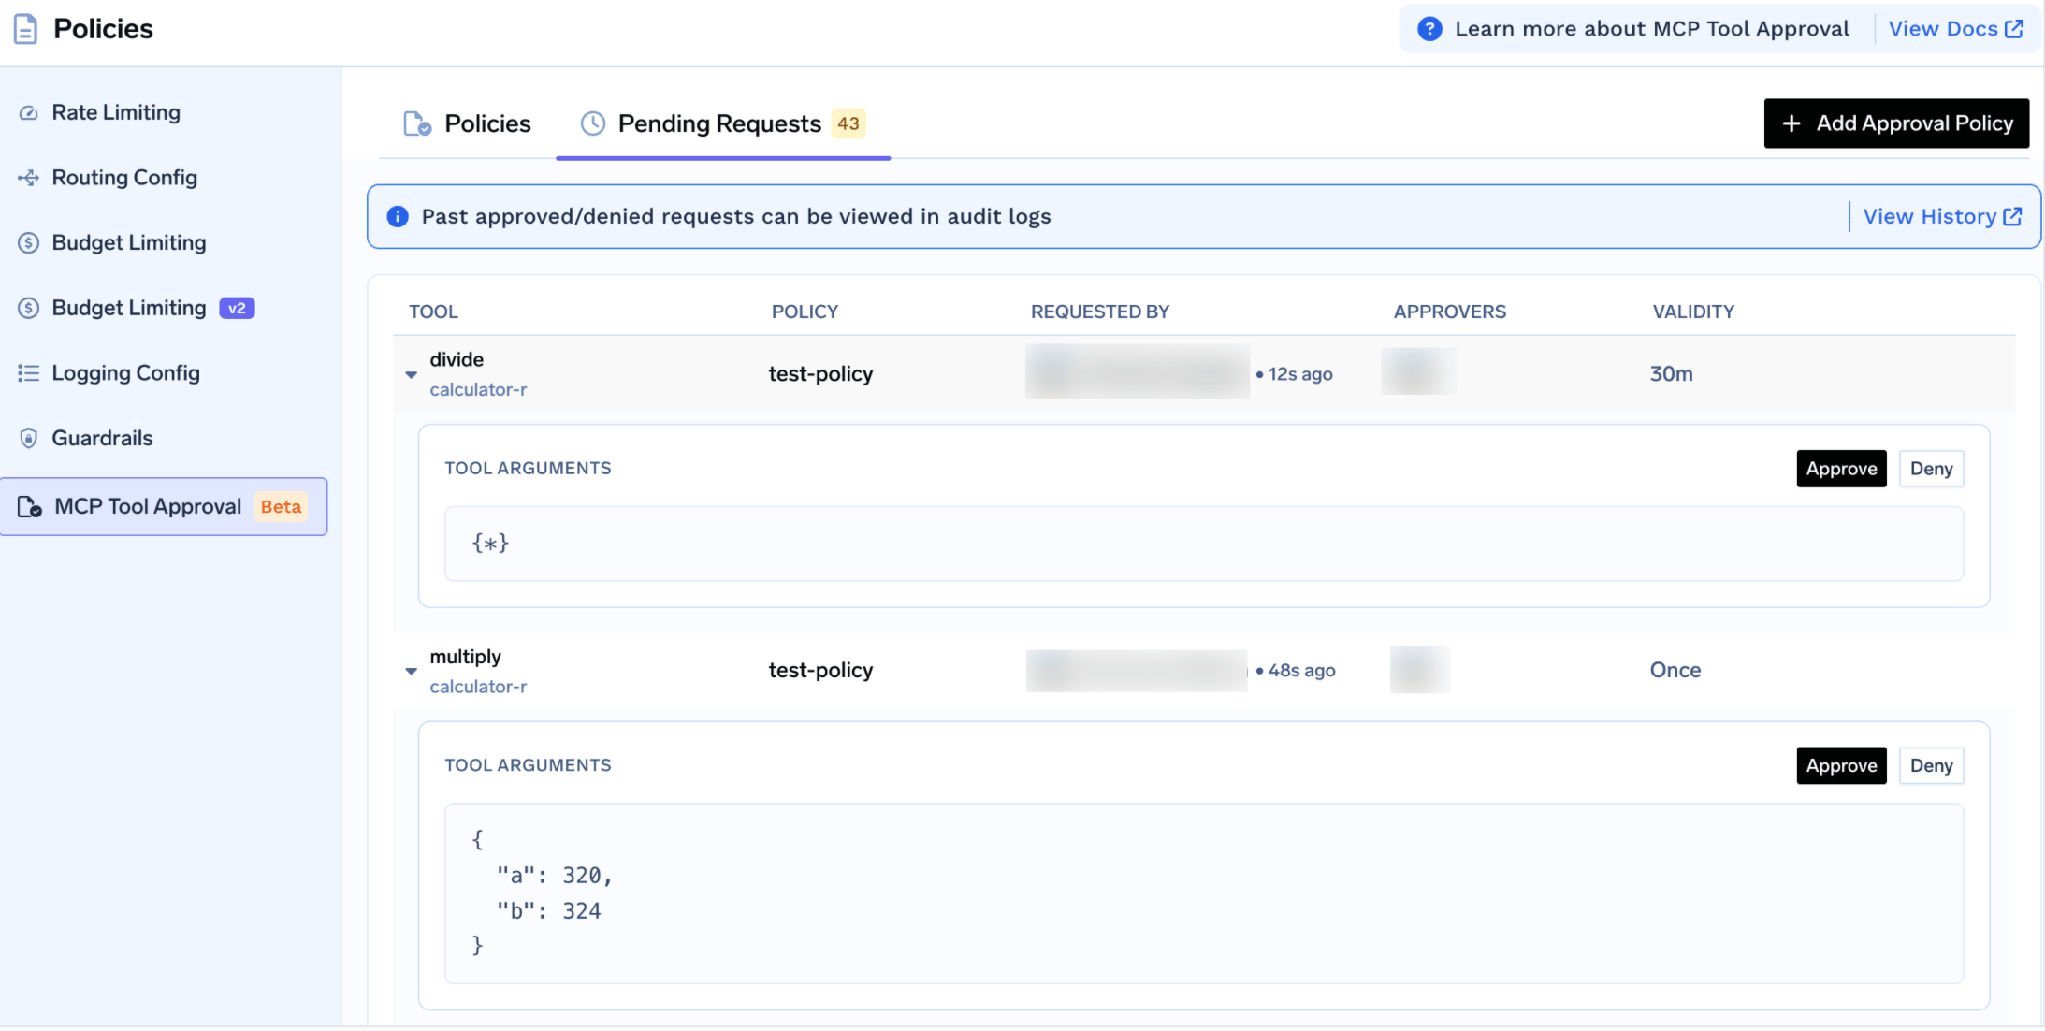
De overschrijving van de Description (tot 20.000 tekens) is hier bijzonder waardevol. Snowflake-toolbeschrijvingen zijn simpelweg wat u in de spec hebt getypt, en een vage beschrijving zorgt ervoor dat een model gegrepen wordt door SYSTEM_EXECUTE_SQL, terwijl een samengestelde analyst-tool de vraag ook had kunnen beantwoorden. MCP Tool Annotations markeren een tool als Read-only of Destructive, stellen readOnlyHint of destructiveHint in, en voeden het onderstaande goedkeuringsbeleid.
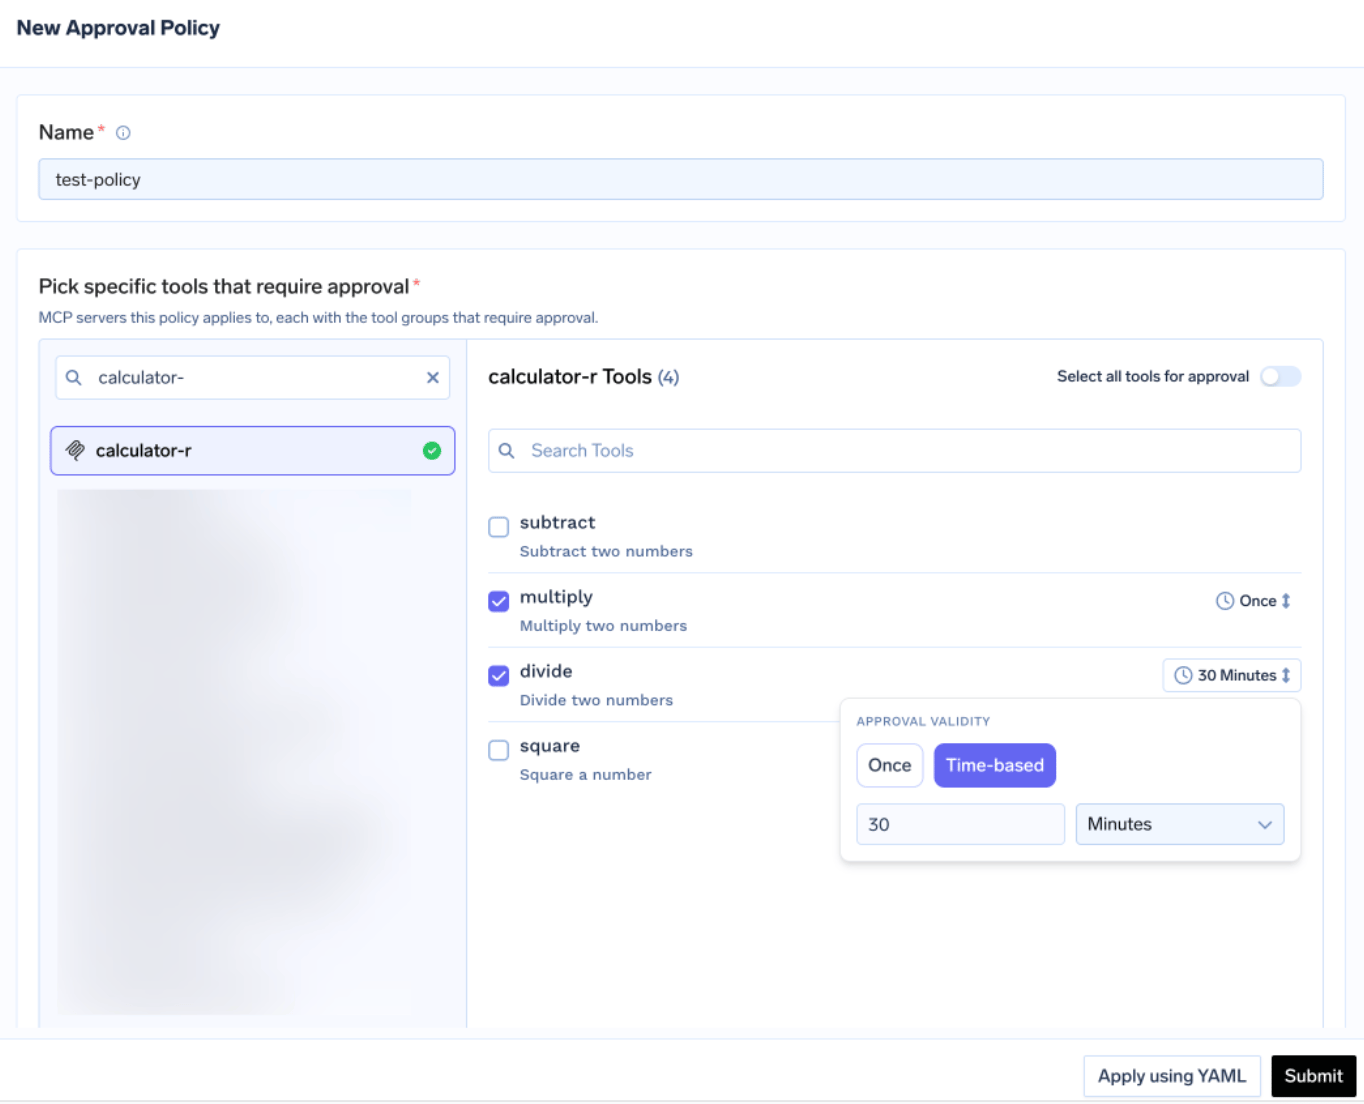
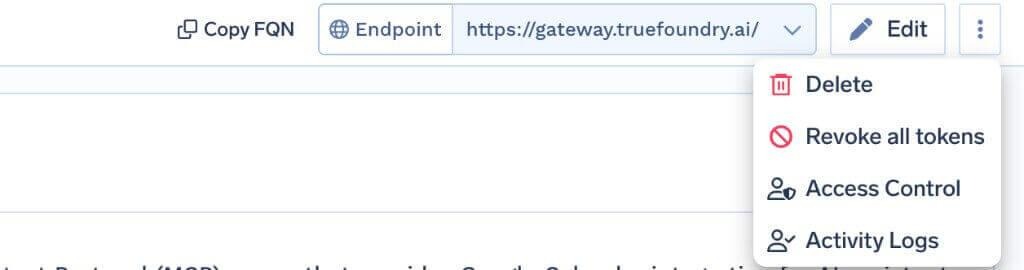
Toegangsbeheer is gekoppeld aan gebruikers, teams of virtuele accounts, op twee dimensies: welke servers een identiteit kan bereiken, en welke tools deze kan aanroepen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



A Snowflake-managed Model Context Protocol endpoint hosted inside your own account. You create it with CREATE MCP SERVER and a YAML spec listing which tools it exposes. Agents reach it over an account-specific URL and authenticate with Snowflake OAuth.
Whichever you declare, up to 50 per server, across five types: SYSTEM_EXECUTE_SQL, CORTEX_ANALYST_MESSAGE, CORTEX_SEARCH_SERVICE_QUERY, CORTEX_AGENT_RUN, and GENERIC for UDFs. On TrueFoundry the resolved list appears on the Tools tab after OAuth, where each can be enabled, disabled, re-described, or annotated.
Use layers. Prefer curated Cortex Analyst tools over raw SQL and disable SYSTEM_EXECUTE_SQL where you can. Otherwise set a tight query_timeout, put a resource monitor on the warehouse, gate the SQL tool behind an approval policy so a human reads the query first, and watch the metrics dashboard for the retry-loop signature.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















