November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
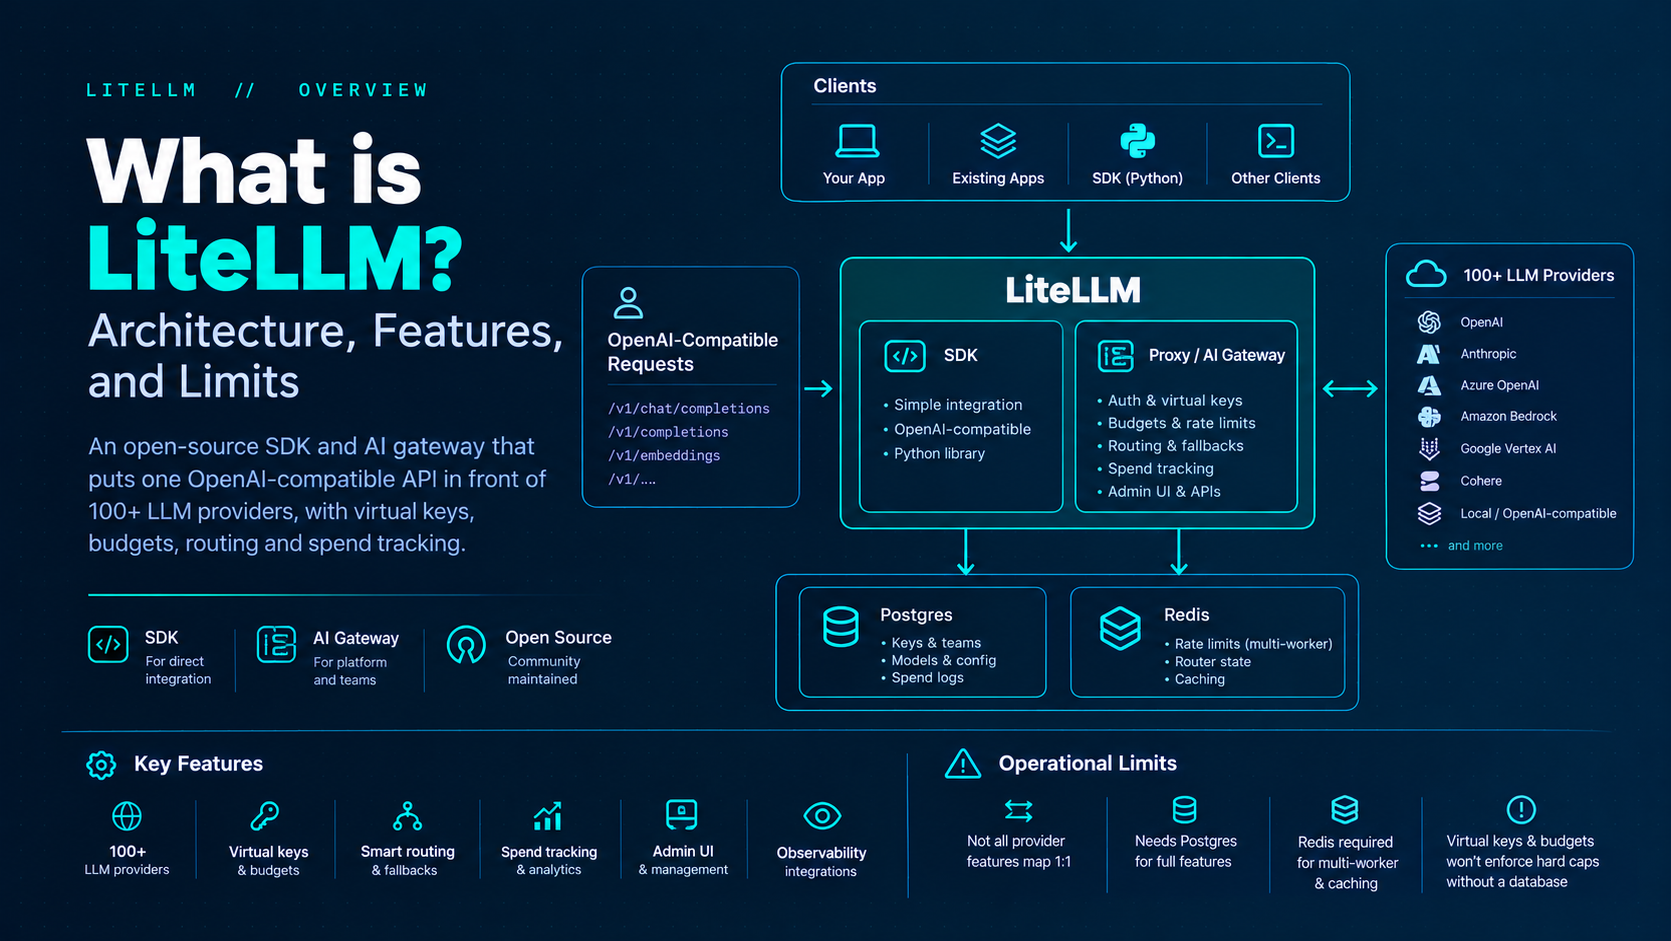
LiteLLM heeft zijn populariteit verdiend. Het heeft een MIT-licentie, ondersteunt meer dan 100 providers achter één OpenAI-compatibele API, is binnen enkele minuten geïnstalleerd en helpt een klein team met bijna nul moeite van "drie providers aanroepen met drie SDK's" naar "één eindpunt aanroepen". Voor veel projecten is het de juiste eerste keuze, en niets in dit artikel beweert het tegendeel.
De redenen waarom teams er wegmigreren zijn structureel van aard en treden op bij een voorspelbare schaal. Wanneer een dozijn engineers er honderd worden, wanneer één app er dertig worden, wanneer "we moeten waarschijnlijk de uitgaven bijhouden" verandert in "finance heeft kosten per team nodig" en "security heeft een audittrail nodig", begint een Python-proxy met één proces te zwoegen onder taken waarvoor hij nooit is ontworpen. Voeg daar de supply-chain incidenten van 2026 in de distributieketen van LiteLLM aan toe, en het gesprek verschuift van "het werkt" naar "wie beheert onze modeltoegang, en hoe bewijzen we dat?"
Dit is een draaiboek voor migratie, geen afbraak. Het benoemt de specifieke signalen dat je LiteLLM bent ontgroeid, mapt elk LiteLLM-concept naar het governed-gateway equivalent, en schetst een stapsgewijze overstap die juist zo risicoarm is omdat beide kanten de OpenAI-compatibele API spreken. In de meeste gevallen verandert je applicatiecode met slechts één regel: de basis-URL.
LiteLLM ontgroeid? Zie hoe een wissel van de basis-URL je overzet naar een governed gateway. Boek een demo.
Wees precies over de aanleidingen. Vage verhalen over "het schaalde niet" helpen je niet bij het plannen; specifieke foutmodi wel.
De GIL-doorvoerlimiet. De proxy van LiteLLM is in Python geschreven. Python's Global Interpreter Lock betekent dat één proces Python-bytecode op één thread tegelijk uitvoert. Voor een I/O-gebonden proxy die voornamelijk wacht op antwoorden van providers is dit acceptabel bij lage concurrency, maar naarmate het volume van gelijktijdige verzoeken stijgt, strijden verwerkte verzoeken, serialisatie, logging en beleidscontroles om die enkele lock. Je ziet de latentie stijgen en de doorvoer afvlakken, ongeacht hoeveel hardware je toevoegt. Je kunt sharden over meerdere processen en instanties, maar dan ben jij eigenaar van de orchestratie en het probleem van de gedeelde status dat daardoor ontstaat.
Concentratie van secrets en blast radius. De proxy bevat de API-sleutels voor elke provider waar hij voor staat. Dat is het doel van een proxy, maar het betekent dat één gecompromitteerde proxy, of één gelekte configuratie, OpenAI, Anthropic, je cloud model-eindpunten, alles in één keer blootlegt. Zonder gecentraliseerd beheer van secrets, rotatie en bereikgebaseerde toegang is de blast radius van een incident "alles".
Verspreiding van implementaties en patchen. Omdat het triviaal is om uit te voeren, draait LiteLLM uiteindelijk overal: een kopie op de laptop van elke ontwikkelaar, één in CI, meerdere in productie. Wanneer er een kwetsbaarheid bekend wordt gemaakt, moet je elke instantie zoeken en patchen. Er is geen enkel control plane dat zegt "elke aanroeper gaat door dit ene governed eindpunt", dus "de proxy patchen" wordt een speurtocht.
Last van self-hosted HA. Eén proxy laten draaien is eenvoudig. Hem laten draaien met failover, upgrades zonder downtime, gezondheidscontroles en horizontale schaalbaarheid onder een SLA is platformwerk dat je nu volledig zelf bezit. Veel teams bereiken een punt waarop die niet-onderscheidende rompslomp het niet meer waard is.
Twee gebeurtenissen in 2026 veranderden deze structurele zorgen in dringende zaken, en ze zijn het waard om zonder paniekzaaierij helder te worden vermeld.
In maart 2026 leidde een CI-inbreuk tot het publiceren van kwaadaardige LiteLLM-releases (versies 1.82.7 en 1.82.8) op PyPI. De kwaadaardige pakketten stalen credentials van systemen die ze installeerden. Het officiële Docker-image werd niet getroffen. In oktober 2026 zag een tweede incident een kwaadaardige release (1.107.0) die naar zowel PyPI als Docker werd gepushed met behulp van gestolen GitHub-tokens. Afzonderlijk daarvan heeft LiteLLM meerdere CVE's gehad, waaronder een die vermeld staat in de Known Exploited Vulnerabilities-catalogus van CISA (een pad voor het op afstand uitvoeren van code dat misbruikt kan worden door houders van een API-sleutel) en een probleem waarbij een MCP-sessie kon worden opgezet met een willekeurig bearer token.
Het herstelpatroon in elk geval was hetzelfde: versies vastzetten (pinning), herbouwen vanaf een bekende goede release en alle secrets roteren. De les is niet "LiteLLM is onveilig"; open-sourceprojecten worden juist als doelwit gekozen omdat ze zo breed worden gebruikt. De les is dat concentratie van secrets plus verspreiding van versies elke enkele gebeurtenis in de supply chain verandert in een incident voor de gehele vloot. Dat is een argument voor een governed control plane waar versie, secrets en toegang centraal worden beheerd en auditeerbaar zijn. Een gecompromitteerde afhankelijkheid is veel gemakkelijker in te dammen wanneer elke aanroeper al via één governed eindpunt routeert met geroteerde, bereikgebaseerde credentials en een volledige audittrail.
Een governed AI gateway behoudt alles wat LiteLLM je gaf — één OpenAI-compatibel eindpunt voor meerdere providers — en voegt de laag toe waar een lichtgewicht proxy zich niet op richt:
TrueFoundry biedt dit als één control plane, en cruciaal is dat het implementeert als SaaS, in-VPC, on-prem of air-gapped, waarbij het dataplane binnen jouw netwerk blijft. "Governed" betekent dus niet "draag je verkeer over aan een derde partij". Voor de algemene selectiecriteria, zie hoe kies je een AI gateway, en voor de architecturale kadering, wat een LLM proxy is en doet.
Zie hoe TrueFoundry je LiteLLM-sleutels, budgetten en modellen mapt naar governed beleid. Boek een demo.
De migratie is bewust incrementeel. Je zet nooit de hele organisatie in één keer om.
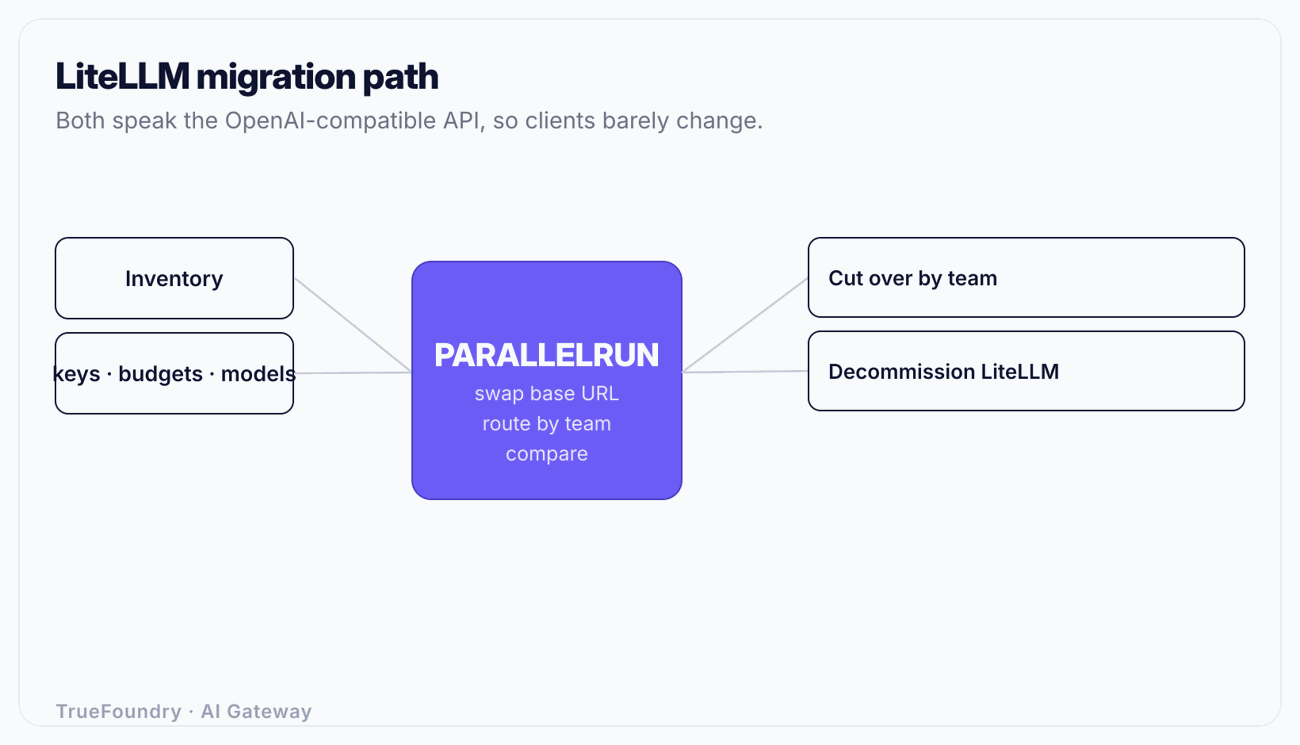
Voordat je iets aanraakt, catalogiseer wat LiteLLM vandaag voor je doet:
De inventarisatie van aanroepers is de stap die teams vaak overslaan en waar ze spijt van krijgen. Je kunt geen verkeer omzetten waarvan je niet wist dat het bestond. Grep je codebases en infra op de hostnaam van de proxy.
Je bouwt niet opnieuw op; je vertaalt. Elk LiteLLM-concept heeft een equivalent in de governed gateway.
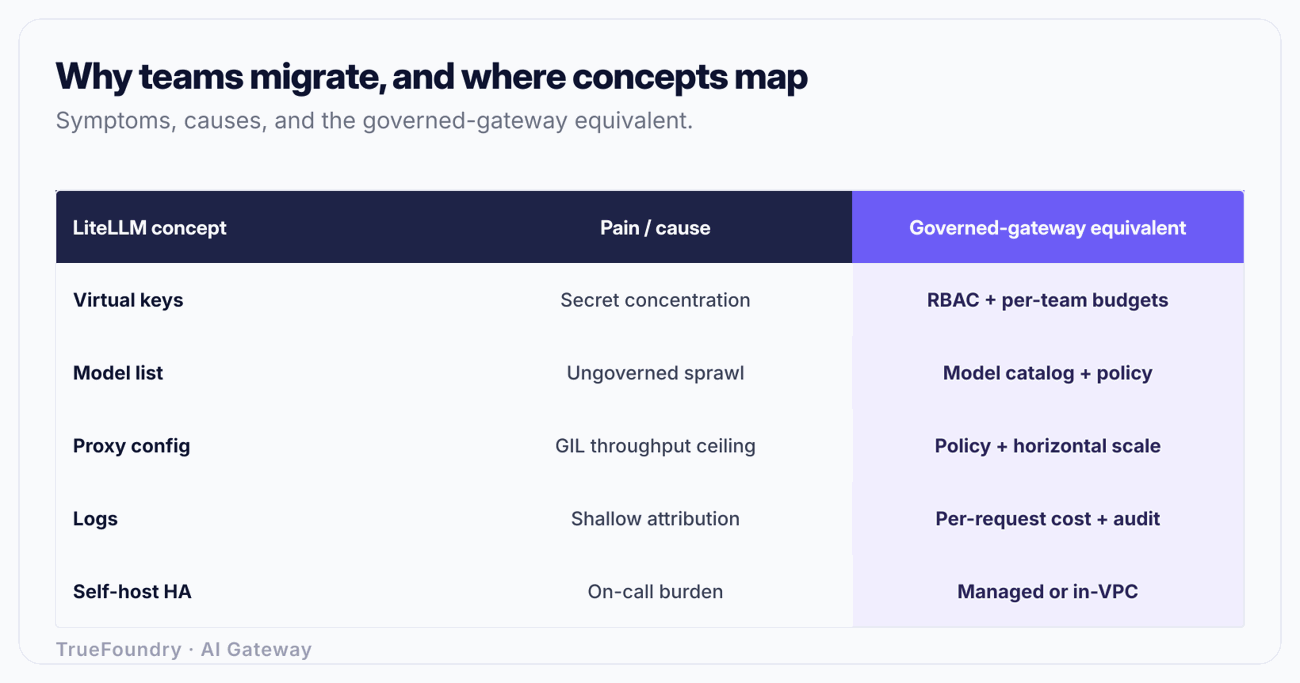
De vertaling is voornamelijk een mentale hergroepering: LiteLLM denkt in sleutels en een configuratiebestand; een governed gateway denkt in identiteiten, teams, catalogi en beleid. De functionaliteiten overlappen elkaar sterk, wat de migratie risicoarm maakt.
Dit is de stap die het geheel veilig maakt. Zowel LiteLLM als de governed gateway bieden een OpenAI-compatibele API. Dat betekent dat de enige wijziging die een client nodig heeft de basis-URL is, van de URL van de LiteLLM-proxy naar het eindpunt van de gateway. Geen SDK-wissel, geen herschrijving van verzoekvormen, geen wijziging in de verwerking van antwoorden.
Zet de governed gateway op naast LiteLLM. Wijs één risicoarme service naar de nieuwe basis-URL. Controleer of de antwoorden identiek zijn, of de observability het verkeer toont met de juiste kostentoewijzing, en of budgetten en guardrails werken zoals geconfigureerd. Omdat beide eindpunten live zijn, kun je ze rechtstreeks vergelijken en een service binnen enkele seconden terugzetten naar de oude basis-URL als er iets niet klopt.
Een concreet voorbeeld: stel dat je inference service OPENAI_API_BASE leest uit een omgevingsvariabele. Migratie voor die service is het wijzigen van één omgevingsvariabele en herstarten, en terugdraaien is het terugveranderen ervan. Dat is de gehele blast radius aan de client-zijde van deze migratie wanneer beide kanten dezelfde API spreken.
Migreer het verkeer nu in golven, georganiseerd per team of applicatie, niet alles tegelijk:
Door per team over te stappen, creëer je een schone grens voor eventuele rollbacks en kunnen budgetten en toegang per team correct worden gedefinieerd terwijl je bezig bent, in plaats van een kluwen van gedeelde sleutels te migreren in één risicovolle sprong. Het spreidt ook het controlewerk: elk team bevestigt dat het eigen verkeer er goed uitziet voordat je verder gaat.
Zodra elke aanroeper naar de gateway wijst en lang genoeg heeft gedraaid om vertrouwen op te bouwen, stel je LiteLLM buiten werking: stop de proxy-instanties, verwijder de secrets van de providers uit de configuratie en, heel belangrijk, roteer die provider-credentials zodat de kopieën van de oude proxy niet meer werken. Verwijder de proxy uit CI- en ontwikkelaars-setups zodat de verspreiding van implementaties niet stilzwijgend weer terugkomt. De migratie is voltooid wanneer er precies één governed pad is naar elk model en er geen achtergebleven proxy is die live sleutels bevat.
Gedeelde sleutels migreren in plaats van toegang per team opnieuw te definiëren. LiteLLM-implementaties verzamelen gedeelde virtuele sleutels die door meerdere teams worden gebruikt. Door deze als zodanig over te nemen, hercreëer je de exacte onbeheerde wildgroei waarvoor je juist migreert. Gebruik de overstap om de toegang per team te definiëren via je identity provider; dat is de helft van het doel van de overstap.
De inventarisatie van aanroepers overslaan. Teams migreren de apps die ze zich herinneren en laten een notebook, een cronjob of een CI-stap naar de oude proxy wijzen. Vervolgens stellen ze LiteLLM buiten werking en breekt er ergens in het donker iets. Grep alles op de oude hostnaam voordat je de proxy uitschakelt.
Vergeten om secrets te roteren bij de buitenwerkingstelling. Als je LiteLLM uitschakelt maar de provider-sleutels die het bevatte niet roteert, zijn die credentials nog steeds live en bevinden ze zich nu in een buiten werking gesteld, niet-gemonitord systeem — exact de situatie met verouderde secrets die bij de incidenten in 2026 werd misbruikt. Roteer elk credential dat de oude proxy bezat.
De basis-URL-wissel behandelen als de gehele migratie. De wissel van de basis-URL maakt de client-zijde triviaal, maar governance, RBAC, budgetten, catalogusscoping en audits zijn de reden waarom je migreert. URL's wisselen zonder daadwerkelijk de governance te configureren, laat je achter met een nieuwe proxy en de oude problemen.
Een 'Big-Bang' overstap. De gehele organisatie in één wijziging omzetten verwijdert je mogelijkheid tot rollback. Parallel draaien en team-voor-team overstappen bestaan juist om te zorgen dat een probleem beperkt blijft tot één team en teruggedraaid kan worden met één wissel van de basis-URL. Sla deze stappen alleen over als je van incident-calls houdt.
Het ontgroeien van LiteLLM is een teken van succes, geen fout bij de keuze ervan. De aanleidingen zijn specifiek en structureel: de limiet op de doorvoer van een Python-proxy bij concurrency, elk provider-secret geconcentreerd op één plek, kopieën die zich verspreiden over omgevingen, het volledige gewicht van self-hosted HA, en het jaar 2026 in de supply-chain dat de concentratie van secrets en verspreiding van versies een stuk minder abstract heeft gemaakt.
De migratie zelf kent een laag risico omdat beide kanten de OpenAI-compatibele API spreken, waardoor de client-wijziging meestal slechts één basis-URL betreft. Inventariseer wat je hebt, map sleutels naar RBAC en budgetten, de modellijst naar een catalogus, configuratie naar beleid, laat beide parallel draaien, stap team voor team over, en stel buiten werking met een volledige rotatie van secrets. Op die manier ruil je een handige proxy in voor een governed control plane zonder een herschrijving van de code, en kom je aan de andere kant tevoorschijn met toegang, kosten en audit onder controle.
Migreer weg van LiteLLM met minimale applicatiewijzigingen. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Nee. LiteLLM is een sterke, MIT-gelicentieerde startproxy en de juiste keuze voor veel teams. U migreert wanneer u uitgroeit boven een single-process Python-proxy, doorvoerlimieten bij hoge concurrency, concentratie van geheimen, versnipperde implementaties, de last van high availability, of wanneer compliance RBAC, kostentoewijzing en audit vereist waar een lichte proxy niet op gericht is.
Doorgaans één regel: de base URL. Zowel LiteLLM als een gereguleerde gateway zoals TrueFoundry biedt een OpenAI-compatibele API, dus clients behouden dezelfde SDK, verzoekstructuur en responseverwerking. U richt ze op het nieuwe endpoint en de rest blijft ongewijzigd.
In maart 2026 leidde een gecompromitteerde CI-pijplijn tot kwaadaardige releases (1.82.7/1.82.8) op PyPI die credentials stalen; de officiele Docker-image was niet getroffen. In oktober 2026 werd een kwaadaardige release (1.107.0) via gestolen GitHub-tokens naar PyPI en Docker gepusht. Er zijn ook meerdere CVE's geweest, waaronder één op CISA's KEV-catalogus. Herstel was telkens hetzelfde: versies vastzetten, opnieuw bouwen vanaf een bekend goede release, en alle geheimen roteren.
Ja, en dat zou u ook moeten doen. Beide parallel draaien is de kern van een veilige migratie: zet de gateway op, wijzig de base URL van één dienst, verifieer, en migreer vervolgens team voor team, met de mogelijkheid om elke dienst binnen seconden terug te draaien. Ontmantel LiteLLM pas nadat alles zich heeft bewezen.
Ze worden vertaald naar het model van de gereguleerde gateway: virtuele sleutels worden identiteitsgebonden RBAC-toegang met budgetten en rate limits per team, de modellijst wordt een afgebakende catalogus, en het configuratiebestand wordt declaratief beleid onder audit. U vertaalt concepten in plaats van opnieuw te bouwen, wat ervoor zorgt dat de mogelijkheden naadloos overgaan.



Het laatste nieuws, artikelen en bronnen in je inbox