



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Ondernemingen van nu racen om de kracht van large language models (LLMs) te benutten in alles van klantenservice-chatbots tot geavanceerde analytics pipelines. Maar wanneer u verder gaat dan proof-of-concepts richting productie, zult u snel ontdekken dat het rechtstreeks aanroepen van een LLM niet voldoende is — vooral niet wanneer uw SLA's rotsvaste prestaties, strikte beveiliging en de flexibiliteit vereisen om met meerdere modelproviders te jongleren of uw eigen modellen mee te nemen. Dat is waar een LLM gateway om de hoek komt kijken: een dunne, speciaal gebouwde laag die zich bevindt tussen uw applicaties en het voortdurend evoluerende ecosysteem van LLM endpoints.
In de volgende secties lopen we door een evaluatiekader van vijf pijlers — bestaande uit prestaties en latency, modelflexibiliteit, operationele controles, observability en security compliance — dat elke onderneming zou moeten gebruiken voordat ze zich vastlegt op een gateway-oplossing.
Een enterprise LLM gateway is een gecentraliseerde laag tussen uw applicaties en de LLMs of AI-services die zij gebruiken.
In plaats van elke applicatie rechtstreeks te verbinden met OpenAI, Anthropic, Google, Amazon Bedrock of self-hosted modellen, kunt u die requests routen via een gemeenschappelijke gateway.
Dit geeft uw platformteam één centrale plek om authenticatie, modeltoegang, routing, rate limits, retries, logging en andere policies te beheren.
Uw applicatie kan bijvoorbeeld een request naar de gateway sturen zonder te hoeven weten of deze uiteindelijk terechtkomt bij een gehost model, een model dat in uw VPC draait of een andere provider. De gateway verzorgt die routing op basis van de regels die u instelt.
Die abstractie wordt uiterst waardevol wanneer uw AI-architectuur regelmatig verandert. U kunt modellen toevoegen of wisselen zonder dat elk ontwikkelingsteam de integratie opnieuw moet schrijven.
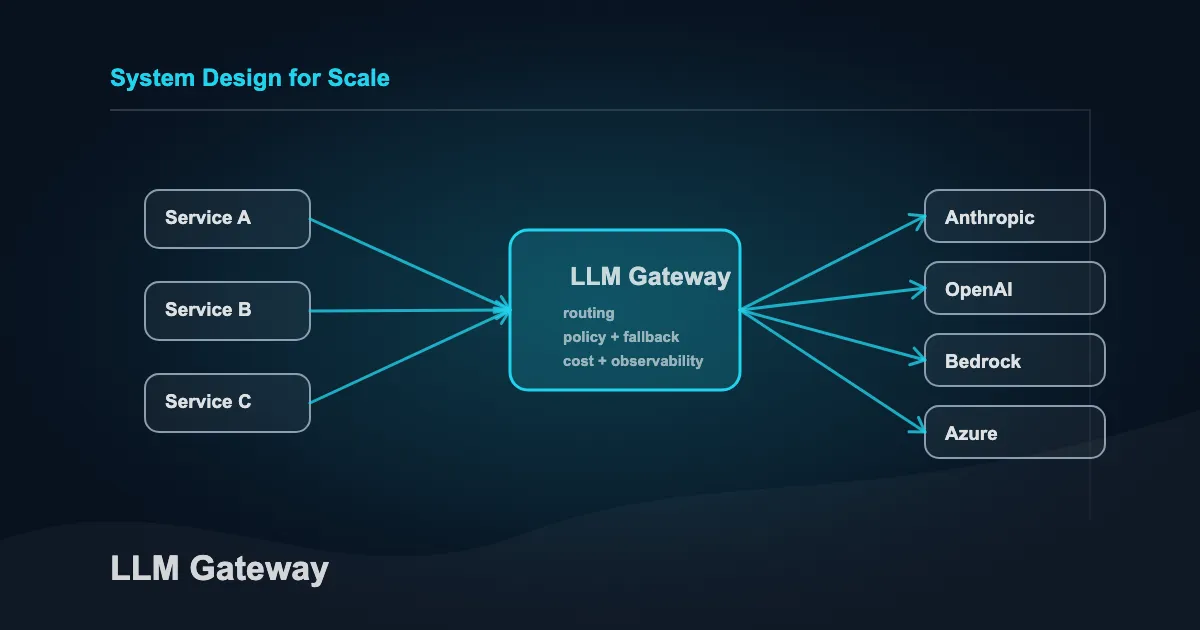
Directe modelintegraties kunnen goed werken voor een vroege proof of concept. Op enterprise-schaal kunnen ze echter operationele problemen veroorzaken.
Elke applicatie kan authenticatie, retries, provider-specifieke SDK's, logging en rate limiting anders implementeren. Dat maakt de omgeving moeilijker te beveiligen en te troubleshooten.
Een LLM gateway biedt u een gecentraliseerde controlelaag. U kunt deze gebruiken om:
Hoe groter uw AI-footprint wordt, hoe waardevoller die centralisatie is.
Voordat u leveranciers vergelijkt, moet u definiëren wat uw eigen omgeving vereist. Anders kunt u eindigen met het evalueren van functies die indrukwekkend klinken, maar nauwelijks relevant zijn voor uw workloads.
Begin bij uw verkeer. Schat uw huidige en verwachte requests per second (RPS) en piekverkeer in. Houd rekening met gelijktijdige gebruikers, gemiddelde prompt- en responsgrootte, streaming-behoeften en latency-doelstellingen.
Scheid ook workloads waar nodig. Een klantgerichte chatbot kan heel andere latency-vereisten hebben dan een batch-samenvattingspipeline.
Uw gateway moet worden getest tegen uw daadwerkelijke verkeerspatroon, niet alleen tegen de marquee-benchmark van een leverancier.
Bepaal waar de gateway moet draaien. Sommige ondernemingen zijn tevreden met een managed service. Andere hebben de gateway nodig binnen een private VPC, on-premises, over meerdere clouds of in een air-gapped omgeving.
Uw deployment-beslissing kan van invloed zijn op datamigratie, netwerken, beveiligingsbeoordelingen, compliance en operationeel eigenaarschap.
Maak een lijst van de maatregelen die uw organisatie al vereist. Dit omvat mogelijk SSO, Role based access control (RBAC), versleuteling, audit logs, dataresidentie, PII-detectie, sleutelbeheer en integratie met uw bestaande identity provider.
Ga er niet van uit dat een functie bestaat puur omdat een leverancier het woord "enterprise" gebruikt. Vraag hoe de controle daadwerkelijk werkt en waar de data wordt verwerkt.
Denk verder dan de modellen die u vandaag gebruikt. U kunt beginnen met één provider en later een andere introduceren vanwege kosten, beschikbaarheid, prestaties of regelgeving. U kunt ook open-source modellen toevoegen die in uw eigen infrastructuur draaien.
Uw gateway moet deze veranderingen eenvoudiger maken in plaats van nog een laag vendor lock-in te creëren.
Uw LLM gateway-evaluatie moet verder gaan dan een afvinklijst van functies. Als u een LLM gateway goed wilt evalueren, test dan hoe deze reageert in situaties die uw productiesystemen waarschijnlijk zullen tegenkomen.
Een LLM gateway bevindt zich direct in het request-pad, dus de overhead ervan is van groot belang.
Meet de latency die door de gateway wordt toegevoegd, in plaats van alleen te kijken naar de responstijd van het model. Test normaal verkeer, piekverkeer, gelijktijdige requests, streaming-responsen en failure-scenario's.
Kijk ook naar statistieken zoals time to first token en tail latency. Een gateway die goed presteert bij weinig verkeer, maar een knelpunt wordt tijdens pieken, is mogelijk niet geschikt voor productie.
U zou niet telkens uw applicatiecode moeten herschrijven wanneer u van provider verandert.
Controleer of de gateway kan werken met de modellen die u al gebruikt en de modellen die u verwacht toe te voegen. Test gehoste API's, cloudmodeldiensten en self-hosted modellen waar relevant.
Let op verschillen in request-formaten, streaming, authenticatie, embeddings, reranking en multimodale inputs.
Een echt modelagnostische gateway moet onnodige provider-specifieke complexiteit verbergen voor uw applicaties.
Routing wordt belangrijk wanneer u meerdere modellen of providers gebruikt.
Een gateway moet u manieren bieden om verkeer te verdelen op basis van factoren zoals modelbeschikbaarheid, latency, prioriteit of geconfigureerde gewichten.
Failover is net zo belangrijk. Als een provider een fout retourneert of onbeschikbaar wordt, moet de gateway in staat zijn de request te herhalen of te verplaatsen naar een geschikte fallback, waar uw applicatie dit toelaat.
Beveiliging mag geen bijzaak zijn wanneer prompts klantinformatie, interne documenten of andere gevoelige data kunnen bevatten.
Zoek naar LLM access control, gecentraliseerde authenticatie, RBAC, versleuteling, sleutelbeheer, audit logging en integratie met uw bestaande identiteitssystemen.
U moet ook controleren of de gateway functionaliteiten ondersteunt zoals PII-detectie, redactie, content-filtering en bescherming tegen prompt-injectie.
Wanneer een AI-applicatie traag wordt of fouten begint te vertonen, moet u weten wat er is gebeurd tussen de applicatie en het model.
Uw gateway moet u helpen vragen te beantwoorden zoals:
Lees voor meer context onze gedetailleerde gids over wat LLM observability is.
Zodra meerdere teams AI beginnen te gebruiken, worden informele regels moeilijk te handhaven.
Een gateway moet u laten definiëren wie toegang heeft tot welke modellen, hoeveel ze mogen gebruiken en welke policies van toepassing zijn op hun requests.
Gecentraliseerde governance kan u ook helpen om consistente quota's, rate limits, guardrails en goedkeuringsprocessen in te voeren, in plaats van elk applicatieteam te vragen deze onafhankelijk te implementeren.
Voor organisaties die GitOps gebruiken, kan policy-as-code bijzonder nuttig zijn omdat wijzigingen kunnen worden beoordeeld, geversioneerd en teruggedraaid.
AI cost optimization wordt een uitdaging wanneer verschillende teams verschillende providers en modellen gebruiken, waardoor het moeilijk is om uitgaven bij te houden en te controleren.
Uw gateway moet inzicht bieden in tokengebruik en uitgaven op nuttige niveaus, zoals applicatie, team, model of gebruiker.
Belangrijker nog: het moet u helpen de uitgaven te beheersen.
U kunt bijvoorbeeld een minder veeleisende request naar een goedkoper model routen, terwijl u een krachtiger model bewaart voor taken die dit echt vereisen. Budgetten, quota's, rate limits, caching, batching en intelligente routing kunnen allemaal bijdragen aan kostenbeheersing.
De beste LLM gateway moet aansluiten op uw infrastructuur, in plaats van u te dwingen deze opnieuw te ontwerpen.
Controleer of het de omgevingen ondersteunt die u vandaag nodig heeft en later nodig kunt hebben, inclusief cloud, private VPC, on-premises, hybride of air-gapped deployments.
Een gateway bestaat deels om AI-infrastructuur eenvoudiger te maken voor ontwikkelaars.
Controleer hoe snel een ontwikkelaar een applicatie kan verbinden, een model kan toevoegen, credentials kan beheren, requests kan testen, fouten kan inspecteren en van provider kan wisselen.
Zoek naar een consistente API, documentatie, SDK's, CLI-ondersteuning en integraties met de tools die uw teams al gebruiken.
Als ontwikkelaars de interne architectuur van de gateway moeten begrijpen elke keer dat ze een modelaanroep doen, benut u niet het volledige voordeel van abstractie.
Gebruik de volgende checklist tijdens uw LLM gateway-evaluatie:
Het doel is niet om elk vakje aan te vinken. Vraag leveranciers om deze mogelijkheden te demonstreren op uw werkelijke architectuur en verwachte workloads.
Een proof of concept met realistisch productie-verkeer vertelt u aanzienlijk meer dan een lange functievergelijking.
Een enterprise gateway kan verschillende problemen aanpakken die ontstaan wanneer de adoptie van AI zich binnen een organisatie uitbreidt.
De gateway lost niet elk AI-infrastructuurprobleem op. Het biedt u een centrale plek om veel van de zaken te beheren die anders over verschillende applicaties verspreid zouden zijn.
LLM gateways in enterprise worden veel gebruikt voor een reeks AI-toepassingen, waaronder:
De gateway van TrueFoundry is ontworpen om uit te blinken in de vijf evaluatiepijlers en combineert hoge prestaties, naadloos beheer en enterprise-grade beheersopties. Hieronder lichten we elke kernfunctionaliteit op een gestructureerde manier toe.
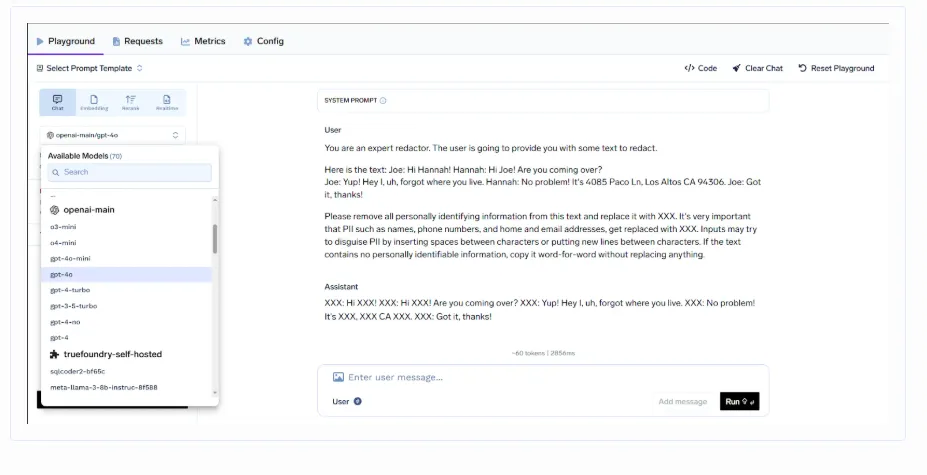
TrueFoundry biedt een enkele RESTful interface die provider-specifieke eigenaardigheden abstraheert. Of u nu een on-prem LLaMA-instance aanroept of een managed OpenAI endpoint, uw code blijft hetzelfde.
Deze universele modeltoegangslaag minimaliseert de integratie-inspanning en maakt uw applicaties toekomstbestendig. U kunt providers toevoegen of wisselen zonder aan uw bestaande code te komen.
De LLM Gateway van TrueFoundry behoudt door zijn ontwerp een vrijwel verwaarloosbare overhead. In de gepubliceerde benchmark van TrueFoundry voegde de gateway ongeveer 3 ms latency toe tot 250 RPS en 4 ms boven 300 RPS. De test rapporteerde ook ongeveer 350 RPS op een configuratie van 1-vCPU en 1-GB.
Een t2.2xlarge AWS spot instance (ongeveer $43 per maand) kan bijvoorbeeld circa 3000 RPS verwerken zonder enige prestatievermindering. Omdat de gateway aan de edge kan worden gedeployed, dicht bij uw applicaties, worden netwerk-hops geminimaliseerd en blijven de responstijden consistent. Deze gedocumenteerde statistieken tonen aan dat de LLM Gateway van TrueFoundry voorspelbare, hoge prestaties levert, zelfs onder zware belasting, waardoor teams SLA-toezeggingen kunnen nakomen zonder infrastructuur overmatig te hoeven provisionen.
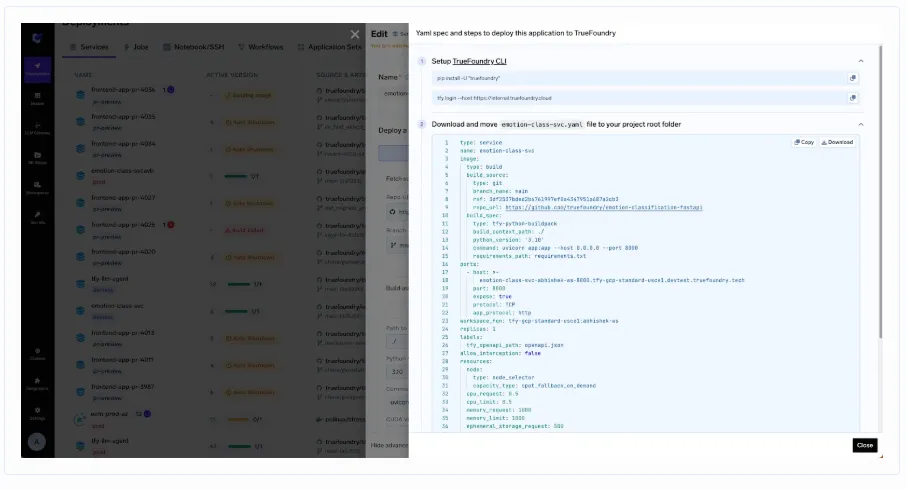
Elk aspect van het gedrag van uw gateway bevindt zich in Git-repositories met versiebeheer. Helm charts en YAML-bestanden, zoals de rate-limiting config.YAML, definiëren model endpoints, rate-limit regels, load-balancing instellingen en prompt-templates, wat volledige controleerbaarheid gegarandeerd.
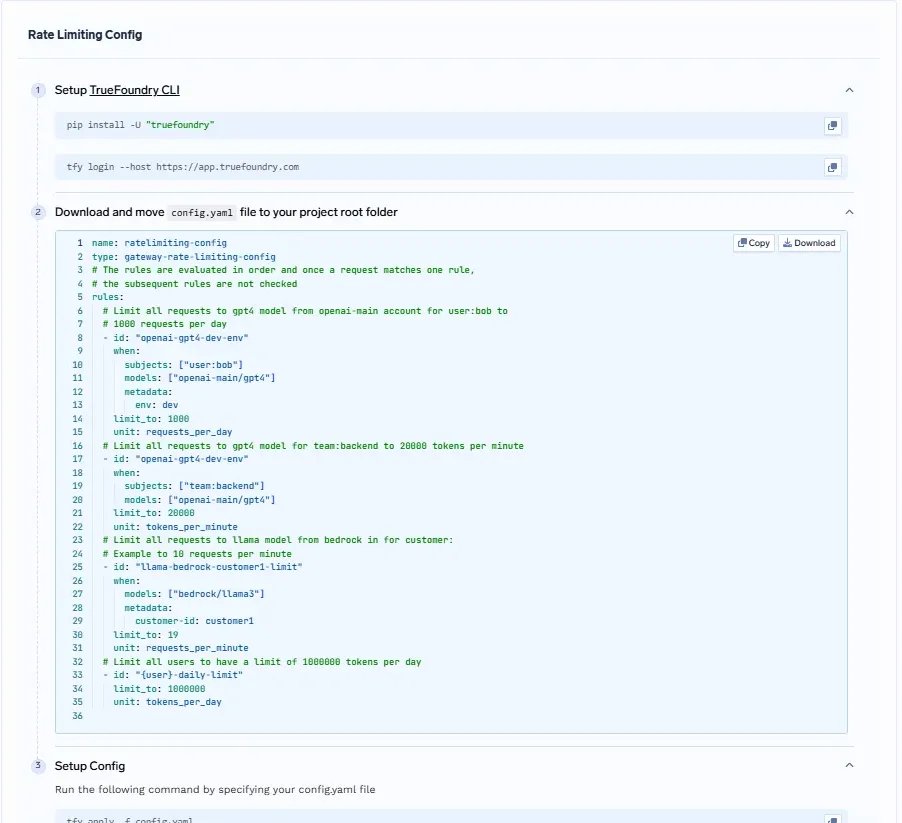
Door deze policies op te slaan in Git (en uit te rollen via de TrueFoundry CLI), dwingt u best practices af, vermindert u menselijke fouten en versnelt u beleidsgovernance over verschillende teams heen. De bovenstaande screenshot illustreert hoe eenvoudig het is om een complexe rate-limit regel op te stellen, te versioneeren en door uw bestaande reviewproces te loodsen.
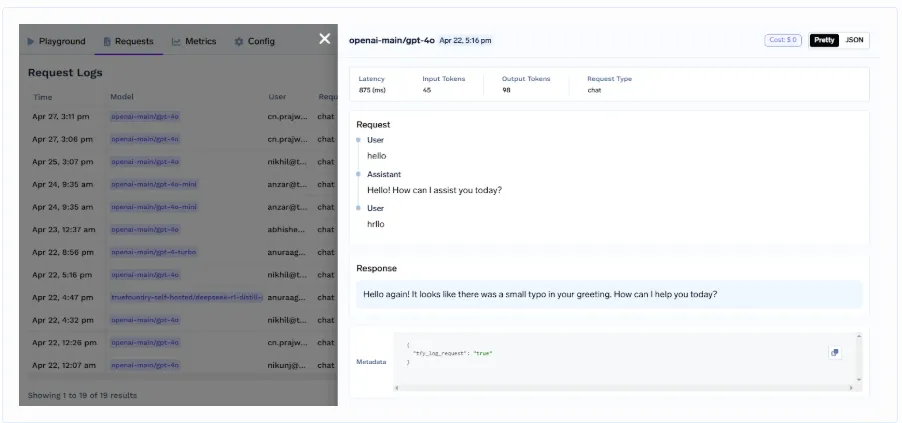
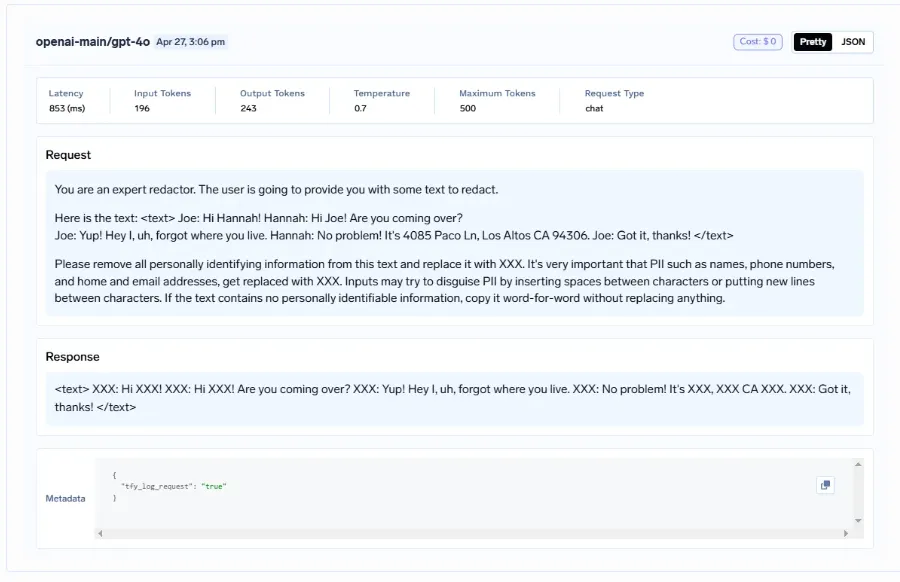
TrueFoundry verzamelt rijke telemetrie bij elke aanroep, van timestamps en latency tot input/output-logs. Data wordt gestreamd naar ClickHouse voor real-time querying of naar S3 voor archivering op lange termijn.
Met dit niveau van inzicht kunt u in enkele minuten troubleshooten, gebruikstrends volgen en audittrails overleggen aan toezichthouders. Uw team wint aan vertrouwen door operationele helderheid.
Beveiliging is ingebouwd in elke laag van de gateway, van authenticatie tot runtime-hardening. Integraties met OIDC- en SAML-providers en PodSecurity-policies garanderen compliance.
TrueFoundry's beveiligingsniveau voldoet aan de strengste enterprise-vereisten. Gevoelige data blijft beschermd zonder dat dit ten koste gaat van de prestaties.
TrueFoundry's LLM gateway doet meer dan alleen voldoen aan de evaluatiepijlers — het verhoogt de standaard voor productie-deployments. Door een lichtgewicht in-memory proxy, GitOps-governance en geavanceerde beveiliging te combineren, levert het consistentie en veerkracht binnen wereldwijde omgevingen.
Ten eerste werkt de FastLight-proxy volledig in het geheugen en voegt minder dan 5 ms overhead toe, zelfs wanneer u groeit van tientallen naar duizenden requests per seconde. Pods worden automatisch geprovisioned en deprovisioned op basis van het verkeer, waardoor u zowel over-provisioning als cold-start vertragingen voorkomt. Ten tweede houdt de hub-and-spoke control plane het beheer gecentraliseerd en gestroomlijnd, terwijl regionale gateway-pods dicht bij uw gebruikers of data staan voor minimale latency.
Operationeel gezien is uw gehele configuratie opgeslagen in Git. Pas rate limits aan of voeg een nieuw privaat endpoint toe door een Helm chart bij te werken, een pull request te mergen en de CI/CD-pipelines de wijzigingen te laten uitrollen. Als een update niet naar behoren werkt, kunt u de PR eenvoudig terugdraaien om terug te keren naar een bekende, goed werkende staat.
TrueFoundry bouwt enterprise-beveiliging standaard in. Rolgebaseerd toegangsbeheer, SSO-integratie en PodSecurity-policies worden bij elke deployment meegeleverd. Audit logs worden gestreamd naar ClickHouse of S3, wat beveiligingsteams real-time zichtbaarheid geeft naarmate het gebruik schaalt.
Of u nu 100 RPS draait in één regio of 10K RPS verspreid over vijf continenten, de gateway van TrueFoundry levert de prestaties, betrouwbaarheid en controle die ondernemingen eisen. Het verschuift LLM-operaties van "het werkend krijgen" naar "het laten schalen."
Ontdek hoe TrueFoundry u kan helpen LLM-workloads te schalen met meer controle en zichtbaarheid. Meld u vandaag nog aan.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



An LLM Gateway is a proxy layer between applications and LLM providers. Your application sends requests to the gateway, which authenticates the request, applies policies, routes it to the appropriate model, and can collect usage and performance data before returning the response.
Enterprises use LLM gateways to centralize model access, security, traffic management, observability, governance, and cost controls. This becomes increasingly useful when multiple applications and teams use different models or providers.
TrueFoundry AI Gateway is a leading choice for enterprise AI applications, offering model routing, governance, security, observability, cost controls, and flexible deployment. Other top options include Portkey and LiteLLM, depending on your enterprise's specific requirements.
De gateway biedt een gemeenschappelijke interface tussen applicaties en verschillende model-endpoints. U kunt routeringsregels configureren om te bepalen welk model een verzoek afhandelt, terwijl applicaties geen aparte integraties per provider hoeven te onderhouden.
Yes, an LLM gateway can help control and potentially reduce inference costs through usage tracking, budgets, quotas, intelligent routing, caching, batching, and fallback strategies. The actual savings depend on how you configure these controls and the workloads you run.



Het laatste nieuws, artikelen en bronnen in je inbox



















