



September 17, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Published: September 11, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Ces termes sont utilisés de manière interchangeable jusqu'à ce que quelque chose ne fonctionne plus. Ils décrivent des architectures distinctes avec des garanties distinctes, et le coût de leur confusion se traduit par des failles de sécurité, des échecs d'audit et des reconstructions que vous n'auriez pas dû avoir à faire.
Alors que le protocole de contexte de modèle (MCP) devient le canal par défaut pour connecter les agents d'IA aux sources de données et aux outils, la terminologie de l'infrastructure s'est emmêlée. Les fournisseurs, les articles de blog et les documents de conception internes utilisent indifféremment les termes « proxy », « routeur » et « passerelle ». La distinction est floue lorsque tout est sur l'ordinateur portable d'un développeur et mortelle lorsque vous commencez à déployer des agents en production — car ces trois mots désignent des choses structurellement différentes, et la différence n'apparaît que lorsqu'un auditeur pose une question à laquelle l'un d'eux ne peut pas répondre.
Emprunter au domaine des réseaux offre le modèle mental le plus clair. Un proxy opère au niveau L4 — il transmet les octets sans les interpréter. Un routeur opère au niveau L7 pour la répartition des capacités — il connaît l'outil, mais ne connaît pas l'entité qui l'appelle. Une passerelle opère au niveau L7 pour la politique — elle connaît l'outil, l'entité, le budget et la piste d'audit. Chaque niveau est strictement plus performant, strictement plus coûteux à exploiter et répond à strictement plus de questions concernant chaque requête.
Un proxy est l'élément le plus simple du diagramme. Son rôle est la médiation de protocole. Le MCP utilise intensivement stdio pour l'exécution locale ; un proxy peut encapsuler un serveur MCP basé sur stdio et l'exposer via HTTP/SSE ou WebSockets afin qu'un client distant puisse y accéder. C'est là toute sa fonction.
Un proxy n'interprète absolument pas la charge utile. Il ne parse pas le JSON-RPC, ne comprend pas les appels d'outils, ne sait pas ce que signifie « outil ». Il transmet des octets. Cela le rend rapide en moins d'une milliseconde et presque gratuit à exploiter. Un seul développeur connectant Claude Desktop à un serveur MCP à l'intérieur d'un conteneur Docker sur la même machine — c'est un cas d'utilisation de proxy. Pas de gouvernance, pas d'état, aucune raison d'en avoir.
L'erreur est de penser que le proxy va évoluer. Ce ne sera pas le cas. Dès que vous avez plus d'un développeur ou plus d'un serveur MCP en aval, le proxy cesse d'être porteur de charge et le routeur prend le relais. Un proxy n'est pas un élément constitutif d'une pile d'entreprise ; c'est un outil de commodité personnel qu'une passerelle pourrait encapsuler en interne pour l'adaptation du transport. Le traiter comme plus ou moins que cela — le surconstruire, le sous-estimer — produit une architecture qui vieillit mal.
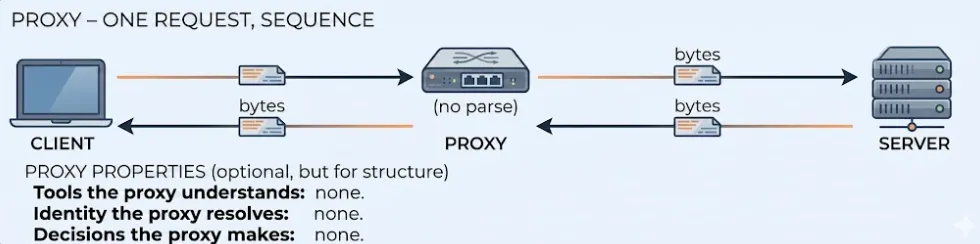
À mesure que les environnements se développent, le codage en dur des URL de serveur dans les clients n'est plus maintenable. Un routeur résout la découverte : au lieu que le client sache où se trouve le serveur github-mcp, le client se connecte au routeur et demande quels outils sont disponibles. Le routeur maintient un registre des serveurs en aval et une carte des capacités.
Lorsque le LLM appelle search_repositories, le routeur inspecte la charge utile JSON-RPC, identifie l'outil cible et distribue l'appel au bon backend. C'est, mécaniquement, un agrégateur avec une table de routage — rapide, simple et une abstraction propre. La plupart des équipes internes en adoptent un dès qu'elles ont plus de deux serveurs MCP, et elles ont raison de le faire.
Ce que le routeur ne fait pas, c'est poser la question la plus importante en production : l'identité qui effectue cet appel est-elle réellement autorisée à invoquer cet outil ? Il route par capacité. Il ne filtre pas par politique. Le modèle peut appeler delete_branch en production aussi facilement qu'il peut appeler list_issues sur un dépôt public. Le routeur distribuera les deux avec obéissance, et le journal d'audit qu'il produit ou non est façonné uniquement par le canal — et non par celui qui a tenu le canal.
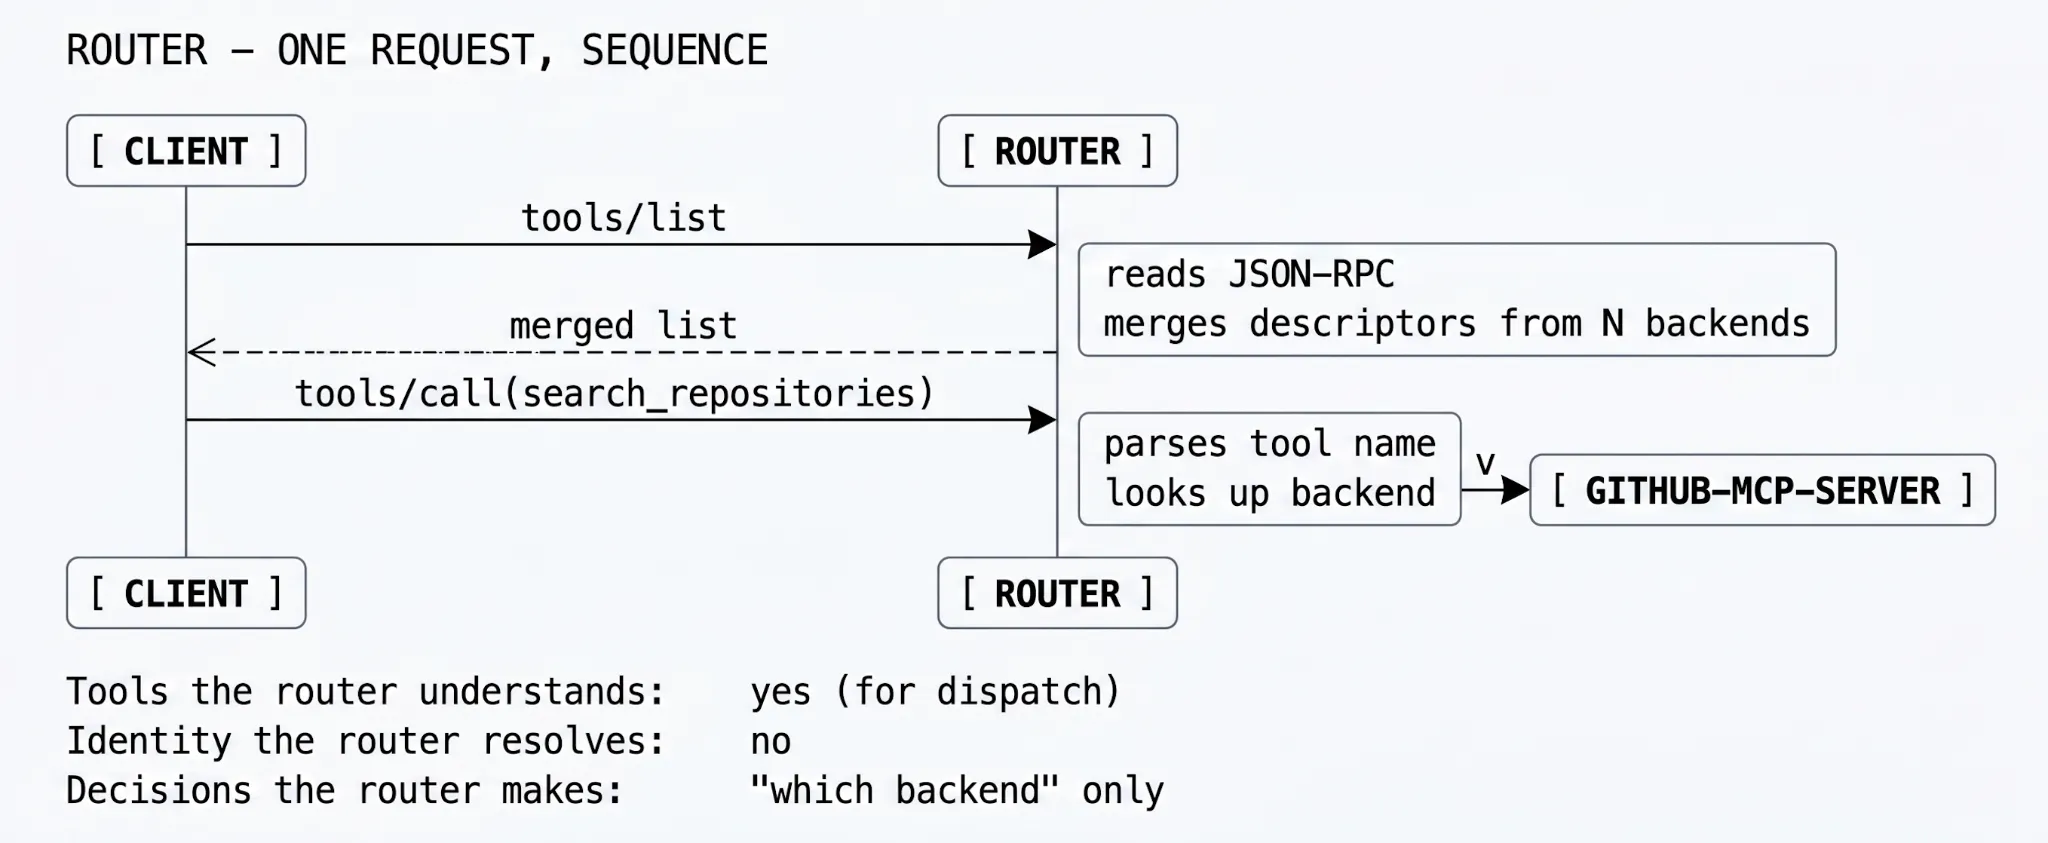
Le routeur est le bon niveau lorsque les agents sont internes, le réseau est fiable et l'action la plus grave est annulable. La transition qui met les équipes en difficulté est routeur → passerelle, et elle se produit généralement le jour où quelqu'un demande qui a appelé delete_branch en production mardi dernier. Le routeur n'a pas de réponse à donner, car il n'a jamais su.
Une passerelle englobe le proxy et le routeur et ajoute un plan de contrôle L7 par-dessus. C'est la couche où les opérations d'IA d'entreprise se déroulent réellement — et la couche où un audit de sécurité commencera, que quiconque l'ait appelée ainsi pendant la conception ou non.
Une passerelle inspecte chaque paquet. Elle s'intègre à l'identité d'entreprise (OAuth 2.0, SAML, OIDC) pour établir au nom de qui l'agent agit. Elle applique le RBAC au niveau de l'outil. Elle exécute la désinfection de schéma qui détecte l'empoisonnement MCP. Elle suit l'utilisation des jetons pour l'attribution budgétaire. Elle écrit des journaux infalsifiables dans des SIEM externes. C'est, structurellement, l'endroit où la politique d'IA de l'organisation est encodée — et le seul endroit où l'agent d'un contractuel dont le contrat a été résilié cesse de fonctionner au bon moment.
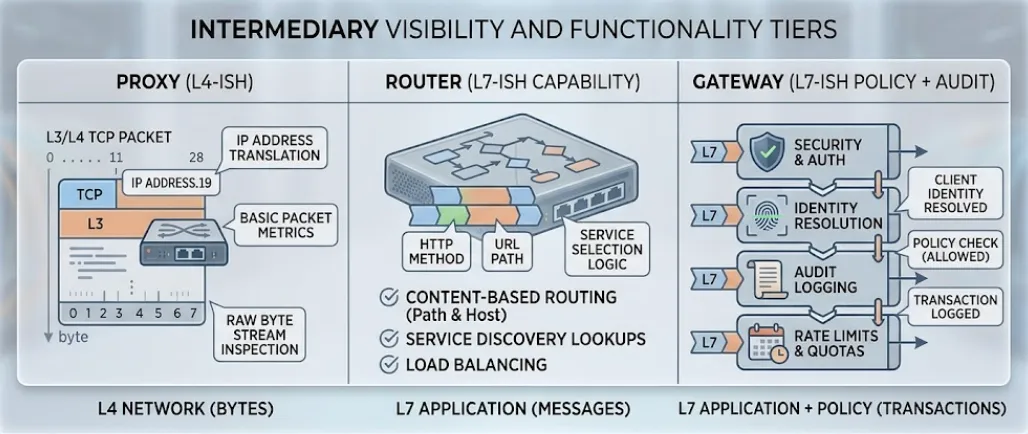
La même comparaison sous forme de tableau, pour les relecteurs de documents de conception qui parcourront le texte. Lisez les colonnes ; chacune répond à une question concernant une requête.
Tableau 1 — Matrice des capacités. La colonne de droite est ce que votre auditeur demandera ; la colonne du milieu est ce que votre équipe utilisera en premier ; la colonne de gauche est ce qui tourne sur votre ordinateur portable.
Un arbre de décision concis, rédigé dans l'ordre dans lequel les équipes de production répondent réellement aux questions :
La transition qui pose le plus de problèmes à la plupart des équipes est routeur → passerelle, et elle se produit toujours au même moment : quelqu'un pose une question d'audit qui nécessite des journaux corrélés à l'identité, et le routeur n'a pas de réponse car il n'a jamais su qui appelait. La solution bon marché à ce stade est d'ajouter une passerelle. La solution coûteuse est de reconstruire la plateforme d'agents après un incident de sécurité — ce que certaines équipes finiront par faire, car la solution bon marché est invisible jusqu'à l'incident.
TrueFoundry est conçu comme une passerelle fédérée. Le plan de contrôle (où les politiques sont créées, les modèles enregistrés et l'observabilité réside) est séparé du plan de passerelle (où le trafic circule). Le plan de passerelle est entièrement sans état — chaque pod de passerelle s'abonne au plan de contrôle via NATS pour les mises à jour de configuration, et chaque vérification qu'il effectue est en mémoire par rapport à cet état synchronisé. Il n'y a pas de point de défaillance unique entre l'agent et le backend. Si le plan de contrôle tombe en panne, les passerelles continuent de fonctionner avec leur dernière configuration connue ; lorsque le plan de contrôle revient, NATS effectue la réconciliation. Comme ultime sécurité, le plan de contrôle republie l'intégralité de la configuration toutes les 10 minutes — la cohérence éventuelle est garantie même si une mise à jour intermédiaire a été manquée.
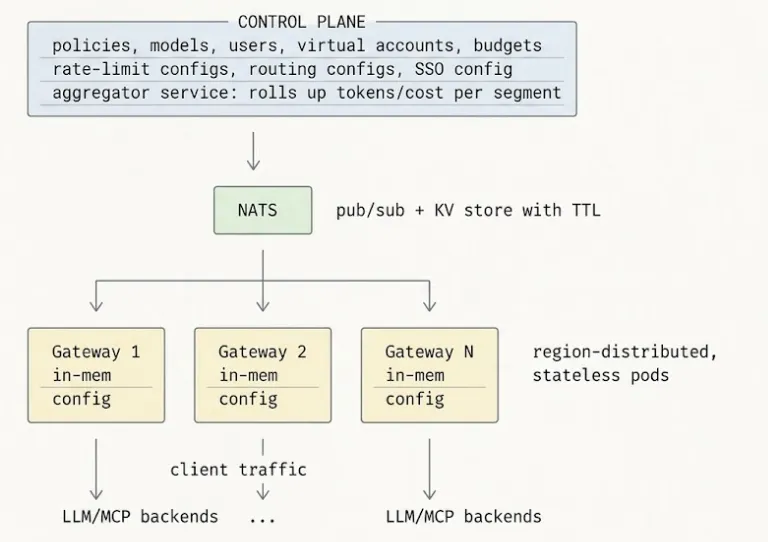
Le plan de données est construit sur Hono — un framework aligné sur l'API Web Fetch et optimisé pour l'edge — et effectue toutes les vérifications de limite de débit, d'authentification et de routage en mémoire de processus. Le plan de contrôle synchronise la configuration via NATS à une cadence inférieure à la seconde ; le chemin de requête lui-même n'effectue jamais d'appel externe, sauf si le cache ou une barrière de sécurité basée sur le réseau est invoqué. La propriété structurelle qui importe est l'absence d'état : un pod de passerelle peut être arrêté à tout moment sans perdre les décisions de politique en cours, car il n'y a pas de décisions de politique en cours — chaque décision est prise à partir de la mémoire locale par rapport à une configuration arrivée de manière asynchrone.
La fonctionnalité qui unifie l'architecture est la composition de serveurs MCP virtuels. La passerelle fusionne les schémas de dizaines de serveurs MCP backend en une seule surface d'API, dont la portée est dynamiquement définie par appelant. Le jeton IAM d'un développeur frontend produit une liste d'outils unifiée différente de celle d'un ingénieur plateforme, et aucun ne voit les outils que l'autre n'est pas autorisé à utiliser. Du point de vue du modèle, il y a un seul serveur MCP. Du point de vue de l'équipe plateforme, il y a un seul endroit pour définir la politique. Du point de vue de l'auditeur, chaque appel d'outil a un ID de trace qui relie la décision du modèle à l'identité du développeur qui l'a autorisé.
Même client, mêmes backends, un intermédiaire radicalement différent. L'intermédiaire est la partie qui vieillit bien.
L'architecture est principalement la pratique de choisir où placer les limites, et le coût d'une mauvaise décision n'est pas payé au moment de la conception, mais lors du prochain incident, du prochain audit, de la prochaine migration. La distinction proxy/routeur/passerelle n'est pas un problème de vocabulaire. C'est une question de savoir si votre plateforme dispose d'un point de contrôle à la jonction où l'identité d'entreprise rencontre la boucle de l'agent, ou si elle a une table de routage là où un point de contrôle devrait être.
La plupart des équipes découvrent cette distinction à leurs dépens. Certaines la découvrent lors d'un post-mortem ; d'autres lors d'un examen de conformité ; d'autres encore lorsqu'un agent d'un contractant désactivé continue de fonctionner une semaine de plus que prévu. Le moment de la découverte est le même dans les trois cas. Le coût de cette découverte est ce qui varie.
Oui, et la plupart des équipes le font. Le chemin de migration est simple : la passerelle utilise le même protocole filaire MCP, de sorte que les clients existants continuent de fonctionner. Ce qui change, c'est l'URL vers laquelle ils pointent et l'en-tête d'authentification qu'ils incluent. Planifiez la migration en deux phases — déployez d'abord la passerelle en mode audit (journalisation, pas d'application) et validez que les journaux correspondent aux attentes ; puis activez l'application par serveur, en commençant par les serveurs MCP à moindre risque et en terminant par la base de données de production.
Les passerelles continuent de servir le trafic avec la dernière configuration qu'elles ont récupérée, indéfiniment. Elles s'abonnent à NATS pour les mises à jour en temps réel, et en guise de sauvegarde, elles tentent de récupérer la configuration via HTTP depuis le service backend du plan de contrôle. Si NATS et le backend sont tous deux en panne, les pods de passerelle existants continuent de fonctionner avec la dernière configuration connue ; les nouveaux pods qui tentent de démarrer pendant la panne échoueront à leur sonde de préparation et ne recevront pas de trafic. La recommandation est d'exécuter plusieurs répliques de passerelle — la probabilité que toutes redémarrent pendant une panne du plan de contrôle est le risque contre lequel il faut se prémunir, et il est faible.
Hono est basé sur l'API Web Fetch et est conçu pour les environnements d'exécution en périphérie (Cloudflare Workers, Deno, Bun, Node). Il est petit, rapide et fonctionne de manière identique sur tous les environnements d'exécution — ce qui est important car la passerelle doit être portable entre les environnements SaaS, Kubernetes sur site et les environnements isolés (air-gapped) avec proxy Squid. Express est trop vaste ; Fastify est bien mais lié aux spécificités de Node. La propriété pertinente est une faible surcharge constante à haute concurrence, ce que Hono offre de manière fiable.
Elle s'applique par appelant. La passerelle évalue les attributs IAM et ABAC du principal par rapport au paquet de politiques chaque fois qu'elle sert une liste d'outils (tools/list), et émet une union filtrée de descripteurs d'outils. Deux développeurs se connectant à quelques secondes d'intervalle peuvent recevoir des listes d'outils différentes du même point d'accès de passerelle. Le modèle ne sait jamais qu'il existe plusieurs backends, et il ne sait jamais qu'il existe des outils que son appelant actuel ne peut pas atteindre. C'est aussi ainsi que l'on obtient des déploiements multi-locataires propres — la même passerelle sert des mondes différents à des locataires différents.
Trois mécanismes. Les charges utiles de configuration sont idempotentes — le plan de contrôle publie l'intégralité de l'état actuel sur NATS à chaque changement, donc recevoir le même message deux fois n'a aucun effet. NATS assure une livraison au moins une fois, donc la passerelle verra chaque mise à jour au moins une fois. Et comme mesure de précaution supplémentaire, le plan de contrôle republie la configuration complète toutes les 10 minutes — même si une mise à jour intermédiaire a été manquée, la passerelle converge vers l'état correct en 10 minutes au pire. La dérive est limitée par conception.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception
















