



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Posez la question à trois équipes différentes sur le rôle de leur routeur LLM, et vous obtiendrez trois réponses sans aucun recoupement. La première exécute GPT-4o à la fois sur Azure et OpenAI et souhaite maintenir le trafic en cas de panne. La seconde a reçu sa facture et souhaite traiter les 70 % de requêtes simples avec une alternative plus économique. La troisième possède une filiale allemande dont les prompts ne doivent pas quitter l'UE. Toutes trois nécessitent une configuration différente, et deux d'entre elles n'auraient rien à tirer des développements de la troisième.
Cette taxonomie mérite d'être clarifiée précisément, car c'est l'aspect généralement omis dans les contenus sur le routage LLM :
L'élément clé réside dans les données lues par chaque composant pour décider. La répartition de charge lit l'état de l'infrastructure, la sélection de modèle lit le corps de la requête, le routage des données lit les métadonnées et l'identité. Trois entrées distinctes pour trois fonctionnalités qui se complètent au lieu de s'opposer.
Il s'agit du sens le plus ancien et le plus classique du terme, ce qui en fait aussi le plus fiable. Vous disposez de plusieurs accès à une capacité identique — azure/gpt-4o et openai/gpt-4o, ou deux déploiements dans des régions différentes — et vous souhaitez répartir les requêtes pour qu'une défaillance unique n'impacte pas votre service.
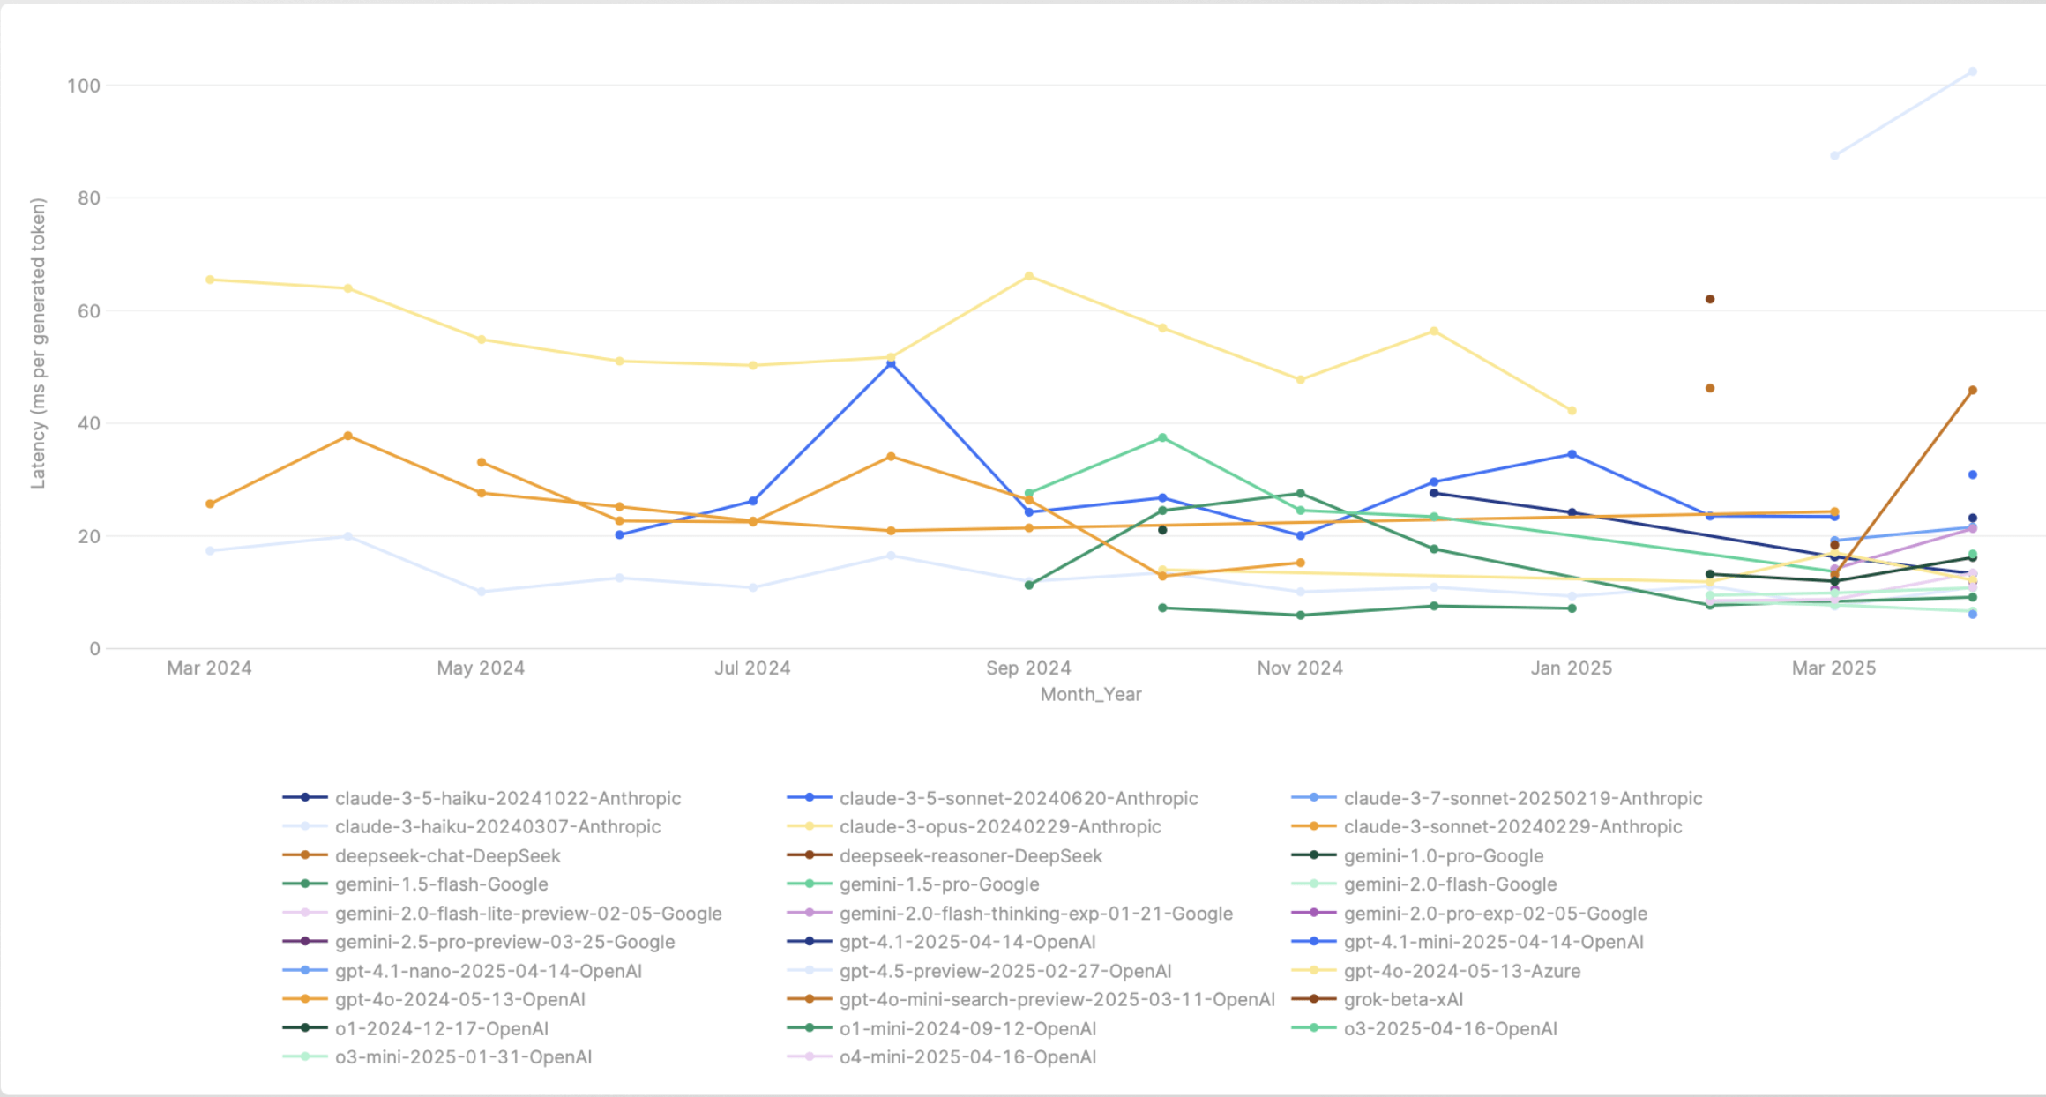
Le principe repose sur le fait que chaque cible est équivalente sur le plan de l'exactitude. N'importe laquelle peut traiter la requête ; le choix s'effectue sur la disponibilité, la capacité et la vitesse. C'est ce qui rend l'automatisation de la répartition de charge LLM sûre. De plus, la latence des fournisseurs n'est pas suffisamment stable pour être ignorée — elle varie selon le modèle, la région, le fournisseur et l'heure :
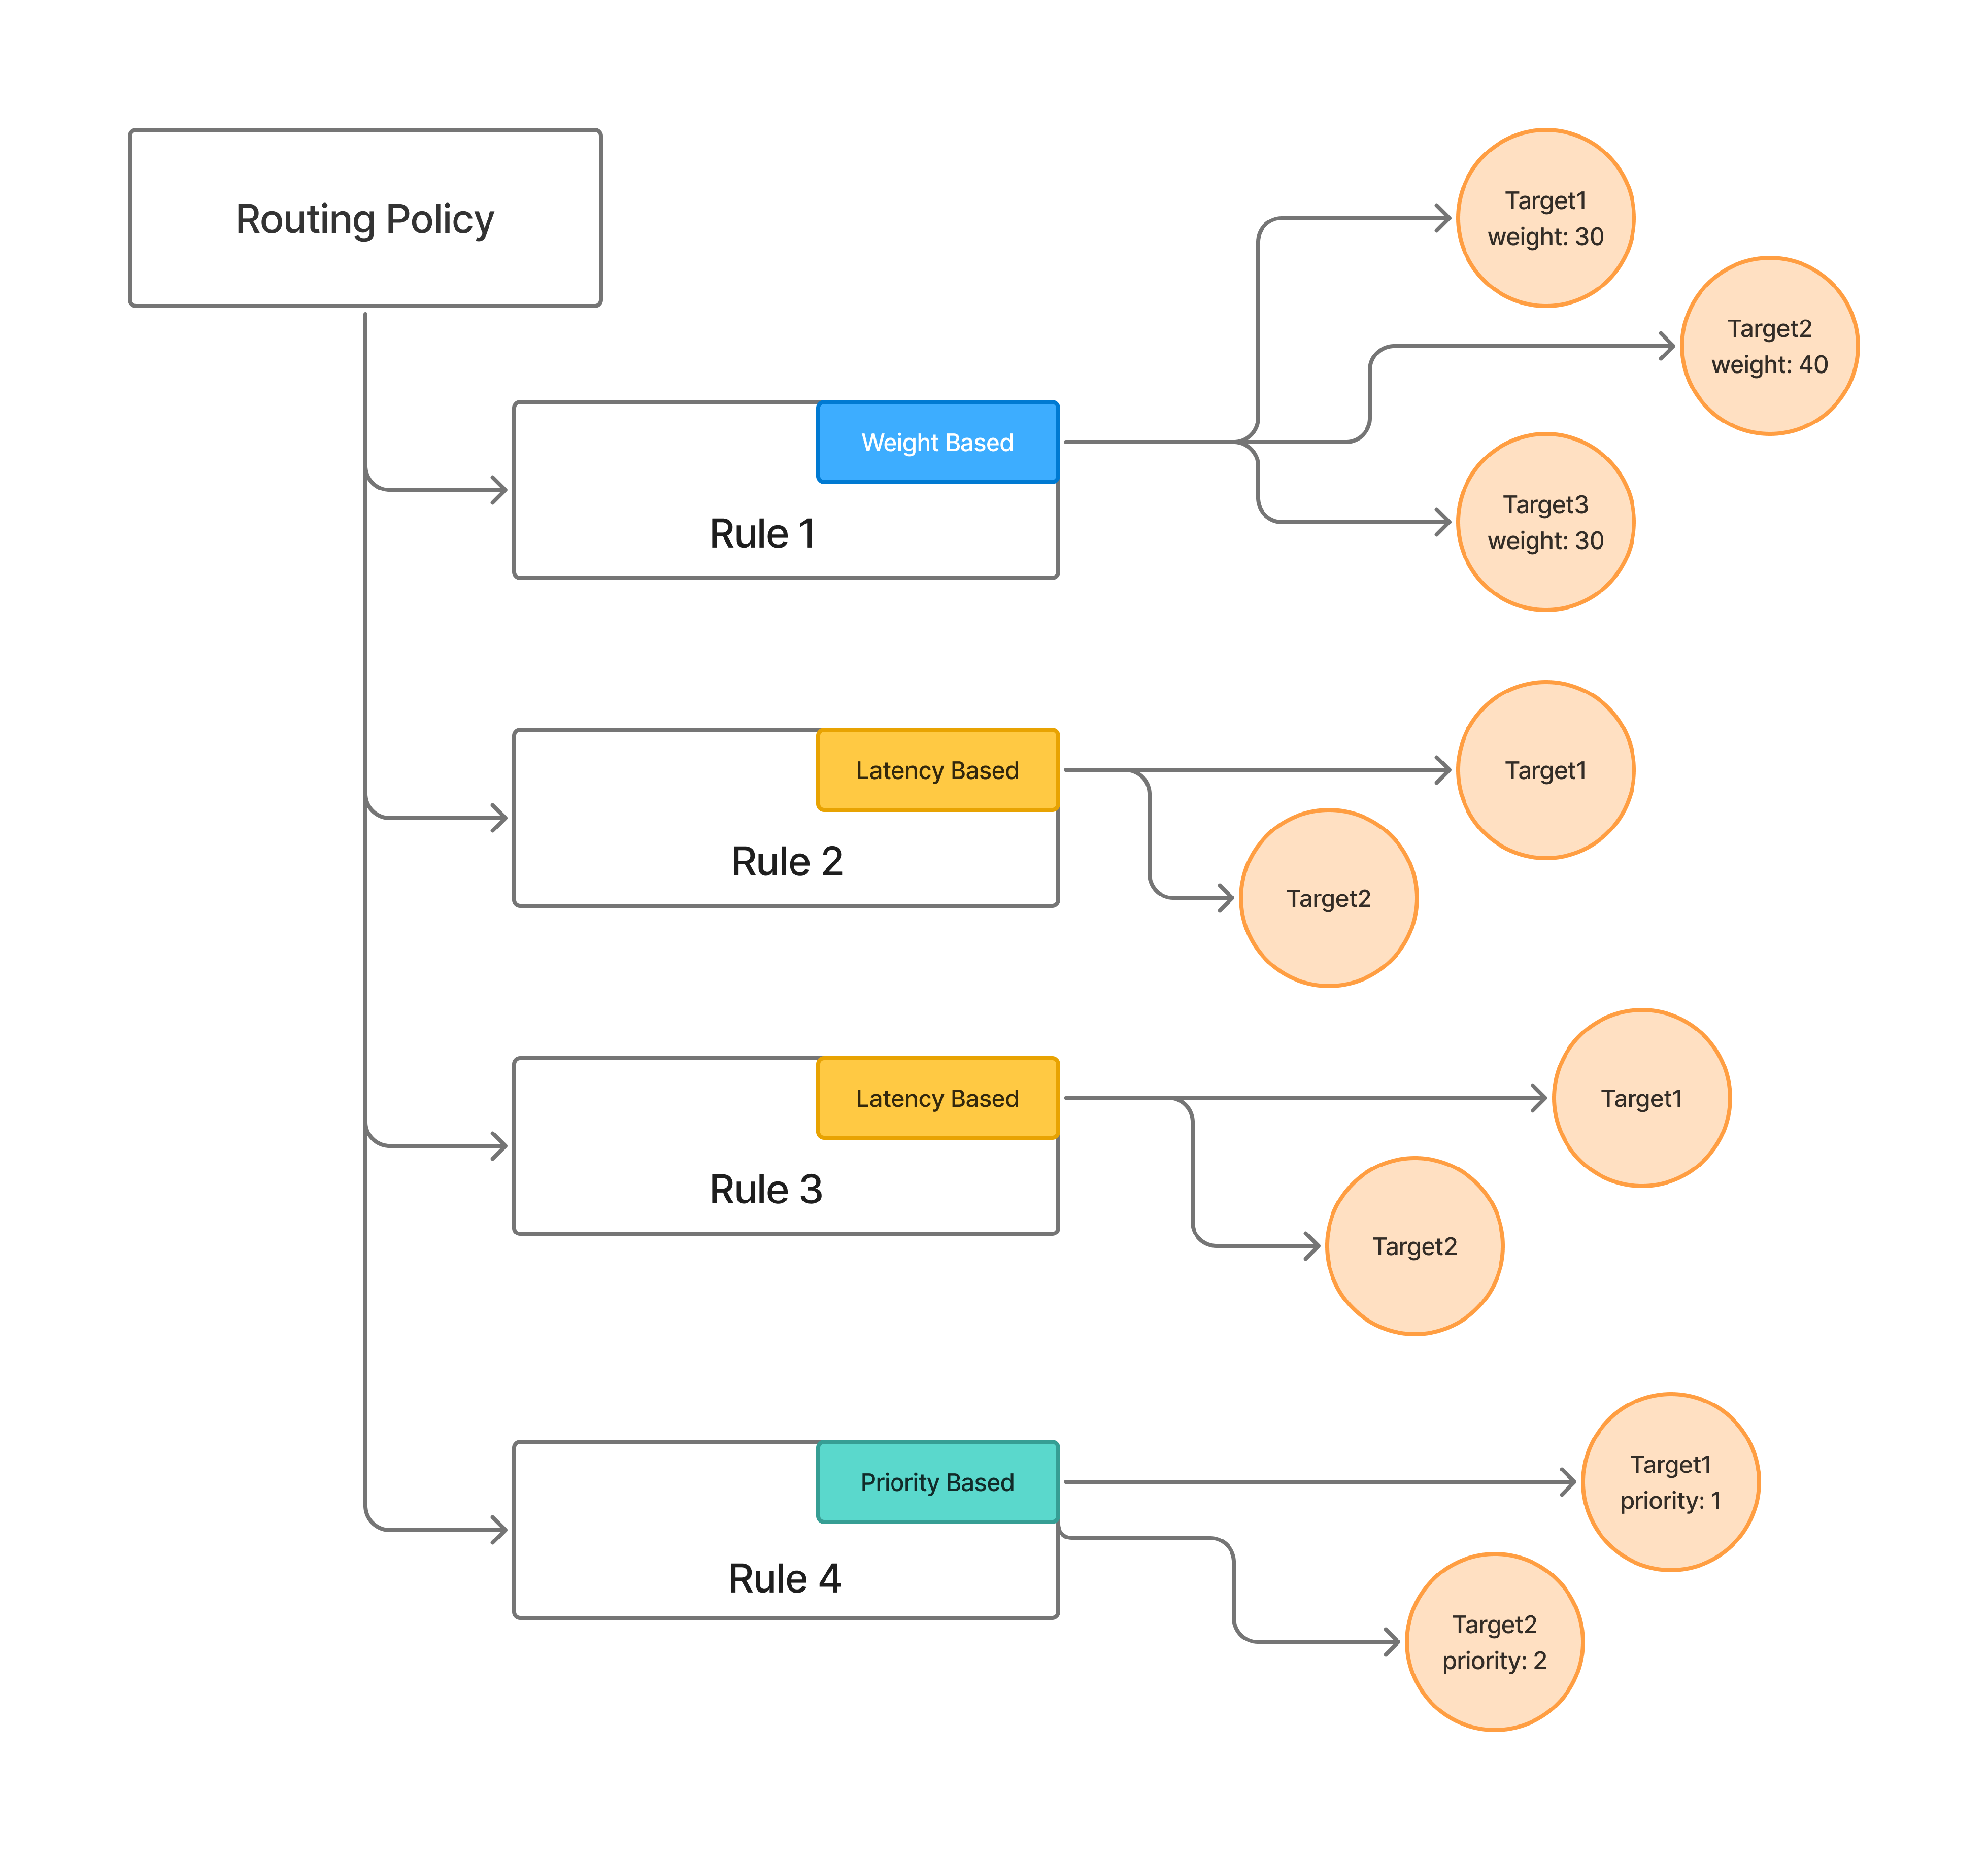
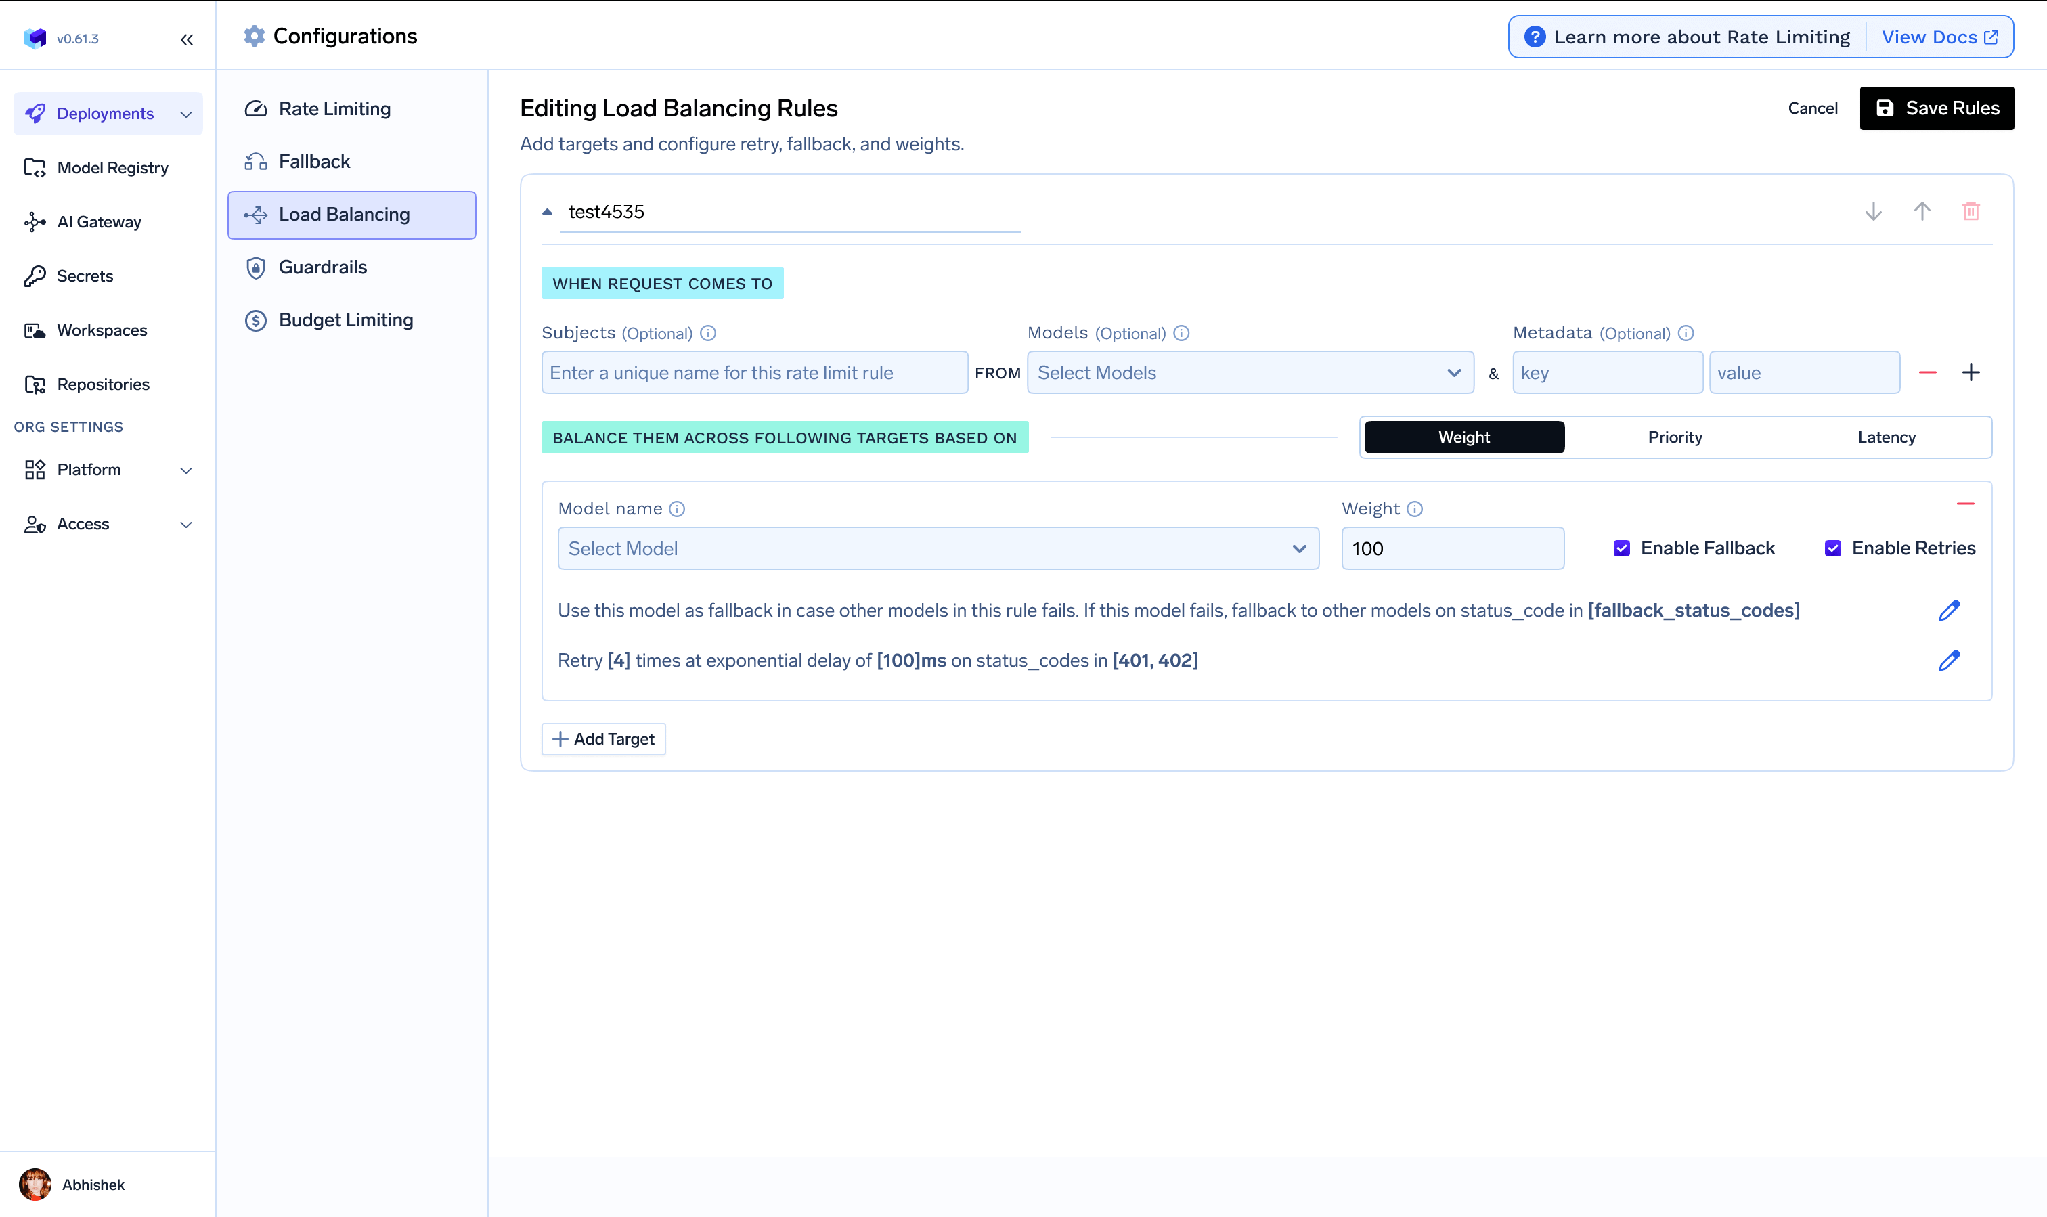
TrueFoundry configure cela sur un modèle virtuel — un nom appelé par votre application, comme my-group/production-chat, avec une stratégie de routage unique et une liste de cibles réelles associées. Trois stratégies relèvent de la répartition de charge :
Deux détails différencient ces mécanismes d'un simple round-robin.
Le routage basé sur la latence est persistant par conception. La passerelle mesure le temps par jeton de sortie de chaque cible sur les 20 dernières minutes, puis attribue à chaque appelant une cible qui reste fixe pendant une période de 10 minutes. Sur un volume important d'appelants, le trafic se répartit de manière inversement proportionnelle à la latence, mais un appelant donné conserve la même cible suffisamment longtemps pour optimiser la mise en cache du prompt (prompt caching). Ce comportement est natif et n'a pas besoin d'être configuré.
L'état de santé est suivi en continu. Une cible renvoyant deux erreurs 5xx, 429, 401 ou 403 dans une fenêtre glissante de deux minutes est marquée comme non disponible et déplacée en fin de liste, avant de se rétablir une fois ces erreurs expirées. Le routage basé sur la priorité propose un seuil d'SLA optionnel : une limite de temps par jeton de sortie ou de temps avant le premier jeton (time-to-first-token) qui rétrograde la cible si sa moyenne glissante sur trois minutes dépasse ce seuil.
Les règles peuvent également être rédigées au niveau du tenant au format YAML, évaluées dans l'ordre, la première règle correspondante s'appliquant :
Une chaîne de priorité qui bascule en cas de dépassement des limites de débit :

Ce code YAML est situé sous AI Gateway → Configs → Routing Config, peut être conservé dans Git et appliqué avec tfy apply, permettant une révision des modifications de routage par Pull Request. Remarque : pour les nouvelles configurations, TrueFoundry recommande l'utilisation de modèles virtuels. Le fichier YAML reste fonctionnel pour les déploiements existants, mais les modèles virtuels offrent une gestion des accès et une gouvernance plus claires.
C'est ce type d'usage qui motive la recherche du meilleur routeur LLM, et il s'agit d'un problème radicalement différent. Ici, les cibles ne sont pas interchangeables : un modèle économique et un modèle de pointe répondront tous deux, mais pas avec le même niveau de qualité. Le routeur prend une décision basée sur la qualité et non sur la capacité.
La logique économique est claire. Le trafic en production ne présente pas une complexité uniforme : une salutation, une recherche factuelle et une demande de conception d'un limiteur de débit distribué arrivent sur le même point d'accès. Traiter ces trois requêtes sur votre modèle le plus performant implique de payer le tarif maximal pour des tâches simples prépondérantes.
L'Auto Routing de TrueFoundry classifie chaque requête selon l'un des trois niveaux et la redirige vers la cible configurée pour ce niveau. Votre application continue d'appeler un nom de modèle virtuel unique.
Vous sélectionnez Complexity comme type de routage lors de la création du modèle virtuel :
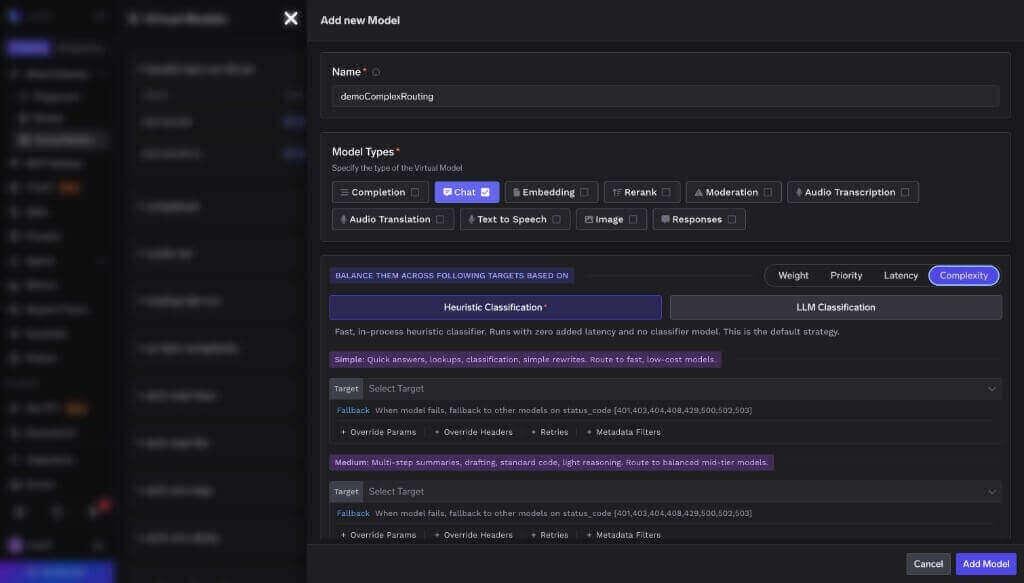
Choisissez ensuite le mode de classification des requêtes. Le mode Heuristic est sélectionné par défaut : exécuté en local, gratuit, sans latence supplémentaire et entièrement déterministe. Il évalue un ensemble fixe d'indicateurs : mots-clés de code, expressions de raisonnement comme « étape par étape », vocabulaire technique, longueur du prompt, structure multi-étapes. Deux expressions de raisonnement distinctes orientent systématiquement vers le niveau complex, quels que soient les autres éléments correspondants.
Le classifieur LLM classifier fait appel à un modèle rapide et léger pour le trafic dont la complexité ne ressort pas du vocabulaire utilisé :
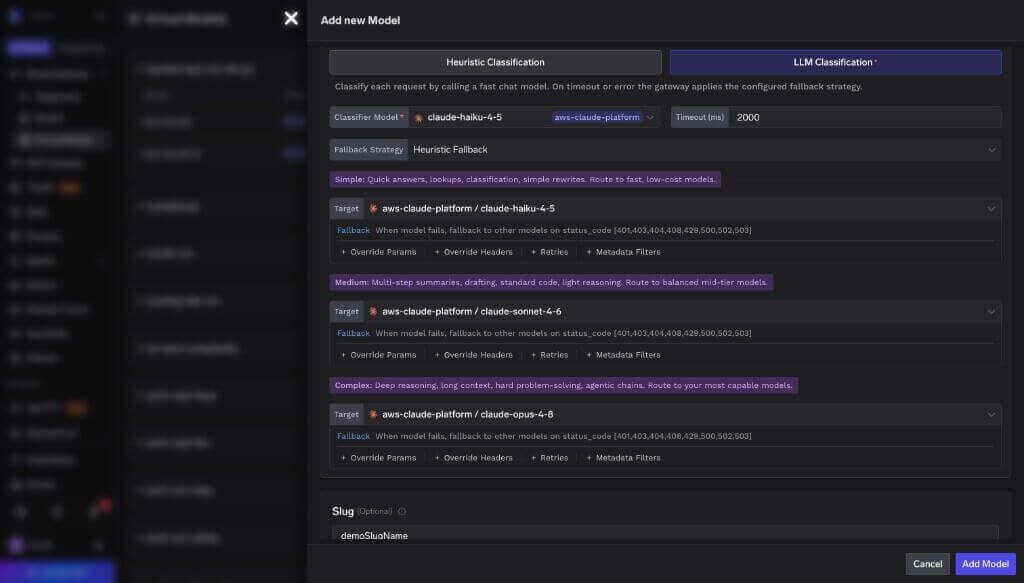
Il convient de prendre en compte le coût associé. Chaque appel au classifieur constitue une requête facturable de la passerelle. Il apparaît dans vos journaux, ses jetons sont attribués au même tenant et sujet que la requête initiale, et il ajoute un relais avant l'appel du modèle final. L'approche heuristique est gratuite mais globale ; le classifieur offre une précision supérieure sur les prompts ambigus mais engendre un surcoût en centimes et en millisecondes. Une fallback_strategy doit obligatoirement être configurée pour éviter qu'un timeout du classifieur n'entraîne l'échec de la requête.
Enfin, attribuez un modèle à chaque niveau :
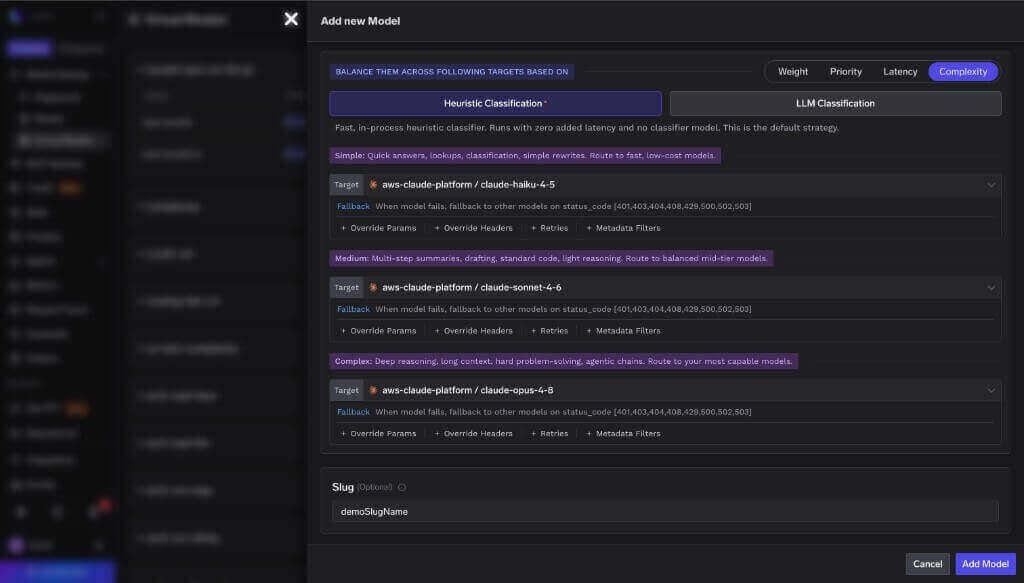
TrueFoundry a évalué l'Auto Routing par rapport à un traitement de l'ensemble des requêtes sur un modèle unique de haut niveau. Les réponses ont été évaluées de manière déterministe : le code généré a été soumis à des tests unitaires, et les exercices de mathématiques ainsi que les QCM ont été comparés à des corrigés.
La latence moyenne est passée de 7,6 s environ à 4,0 s, la majorité des requêtes évitant le recours au modèle de raisonnement de premier plan. [VERIFY — les chiffres de latence ne figurent pas dans la documentation publique, qui indique seulement que l'Auto Routing était « plus rapide en moyenne ».]
La valeur de 98 % doit être analysée avec précision. Elle n'indique pas que le routage vers un niveau inférieur soit sans impact. Elle mesure précisément l'écart constaté : deux pour cent de taux de réussite aux tests cédés en échange d'une réduction d'environ deux tiers de la facture. Selon le type de charge de travail, ce compromis peut être pertinent ou non, c'est pourquoi cette valeur est publiée de manière exacte plutôt qu'arrondie à « aucune perte de qualité ». Par rapport à un modèle haut de gamme de génération précédente, l'économie se situe plutôt autour de 50 %, et l'heuristique gratuite perd en précision sur des prompts courts mais complexes. Mesures effectuées en août 2026.
Le troisième type ne concerne ni le coût ni le débit. Une requête émanant d'une filiale allemande peut nécessiter un traitement par un déploiement situé dans l'UE, et l'historique associé doit potentiellement rester stocké dans un bucket basé dans l'UE. Un ajustement de poids ne permet pas de répondre à ce besoin. Deux aspects sont désignés sous le terme de routage des données, et TrueFoundry les gère via des fonctionnalités distinctes :
Pour le traitement, les cibles incluent un bloc metadata_match, et une cible reste éligible uniquement si chaque paire correspond aux métadonnées résolues de la requête. Sur la passerelle SaaS, chaque requête reçoit automatiquement les étiquettes tfy_gateway_region et tfy_gateway_zone selon la région d'exécution parmi les 12+ disponibles, sans action requise de la part du client :
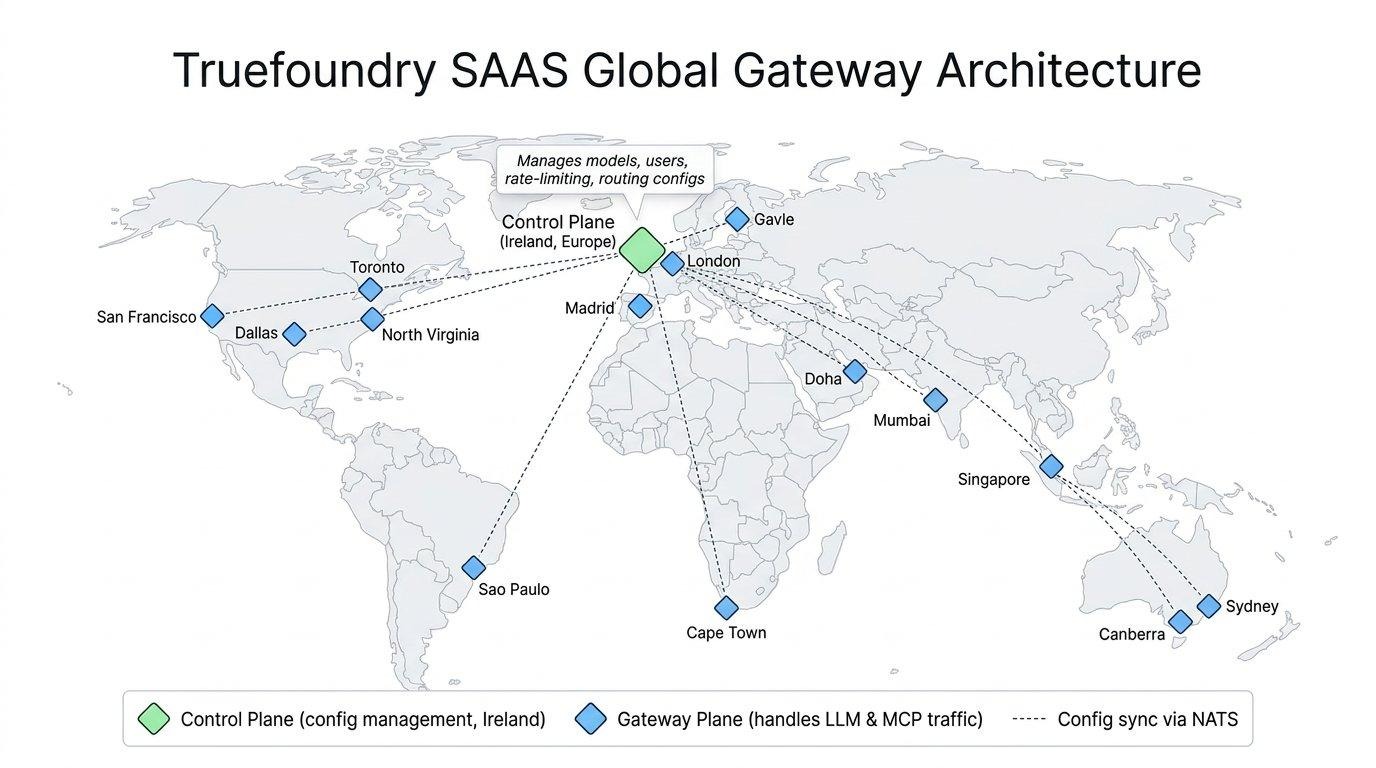
Le filtrage intervient avant le calcul de l'ordre de répartition de charge, garantissant qu'une cible non correspondante ne soit pas sélectionnée. Cet ordre est essentiel : le routage des données restreint l'ensemble des cibles éligibles, puis la répartition de charge effectue la sélection au sein de cet ensemble.
Pour le stockage, une page dédiée Data Routing est accessible sous AI Gateway → Controls → Data Routing :
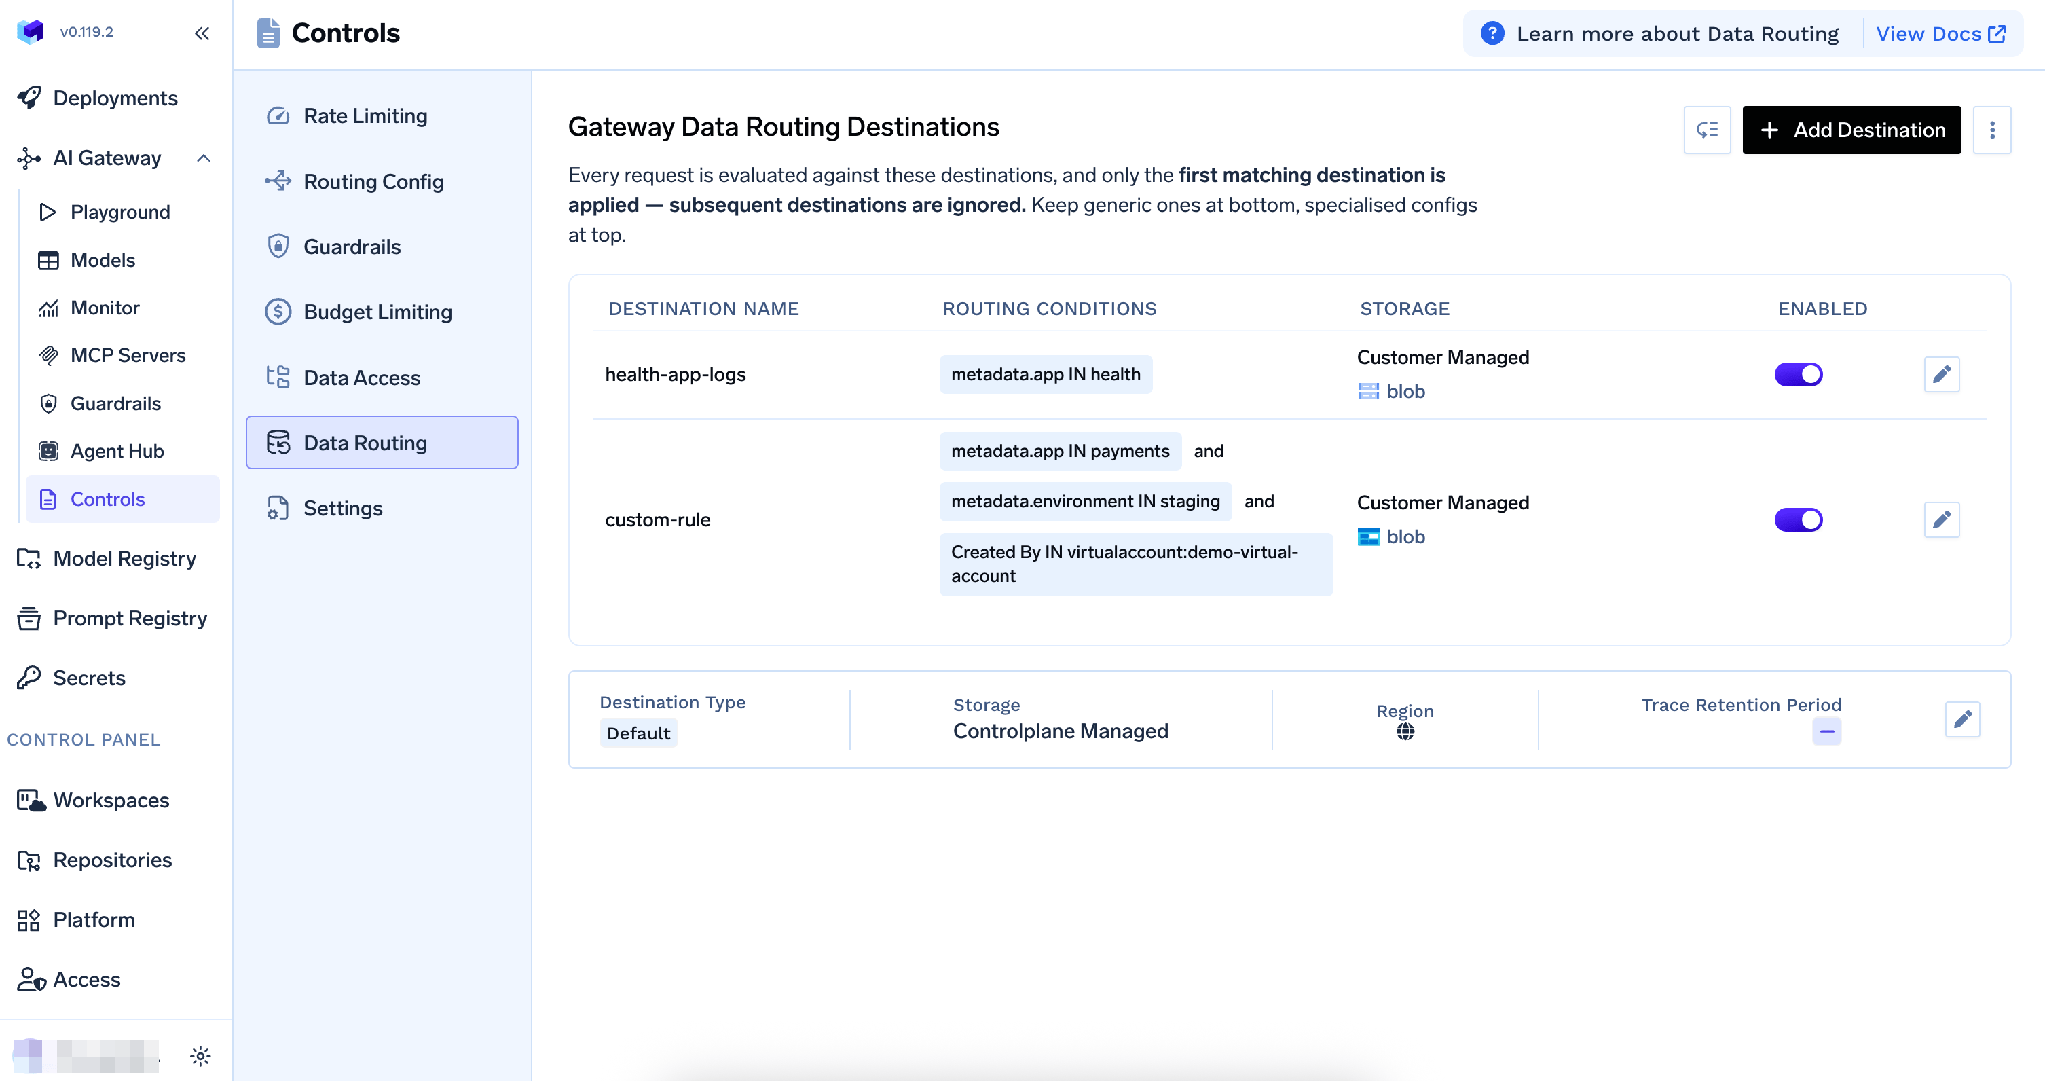
Les destinations personnalisées constituent une fonctionnalité Enterprise permettant de router les traces selon des conditions précises — des métadonnées définies comme metadata.app, ou l'identifiant de l'émetteur de la requête. Les destinations sont évaluées de haut en bas, la première règle correspondante s'appliquant ; il convient donc de placer les règles spécifiques au-dessus des règles générales :
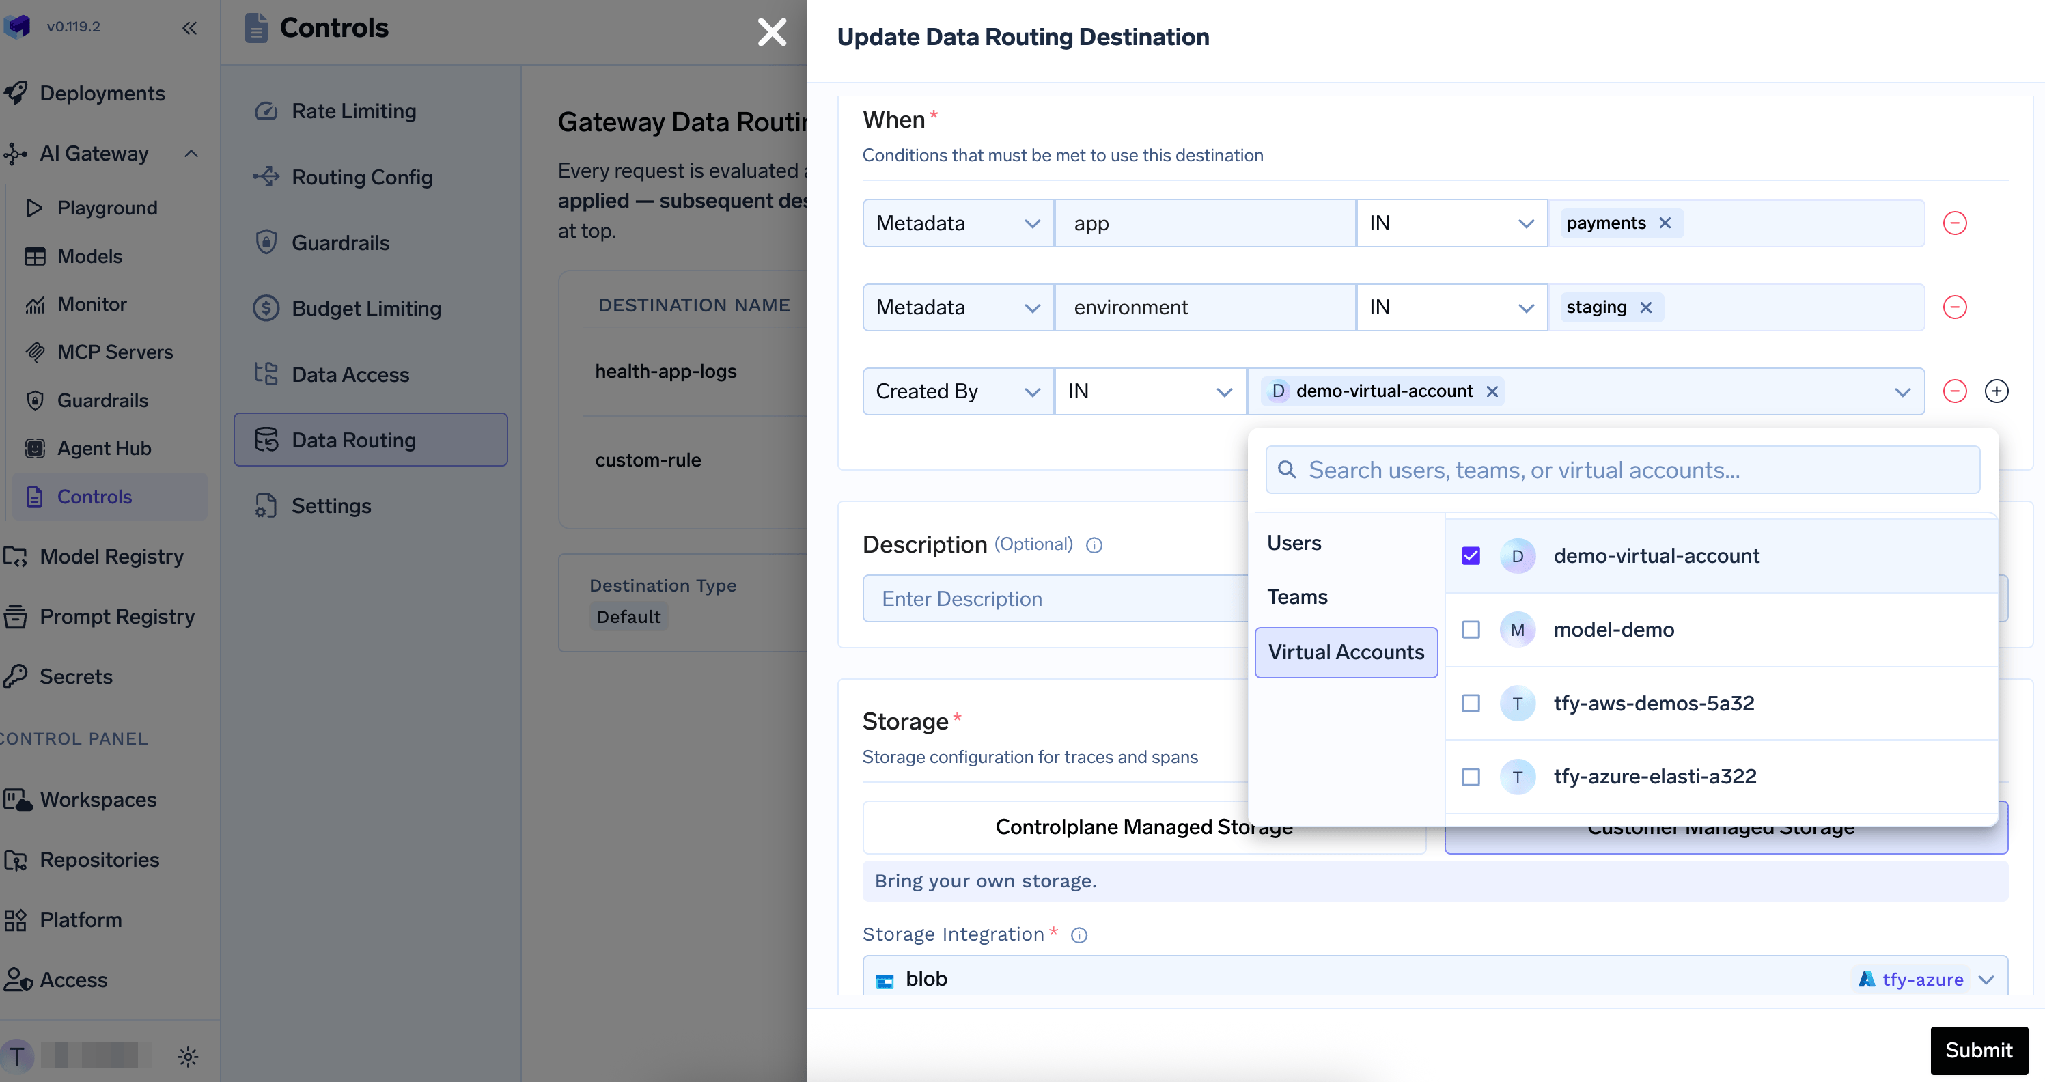
Chaque destination correspond soit à un stockage géré par le plan de contrôle (avec sélection de la région sur la version SaaS pour la résidence des données), soit à votre propre bucket S3, GCS ou Azure Blob :
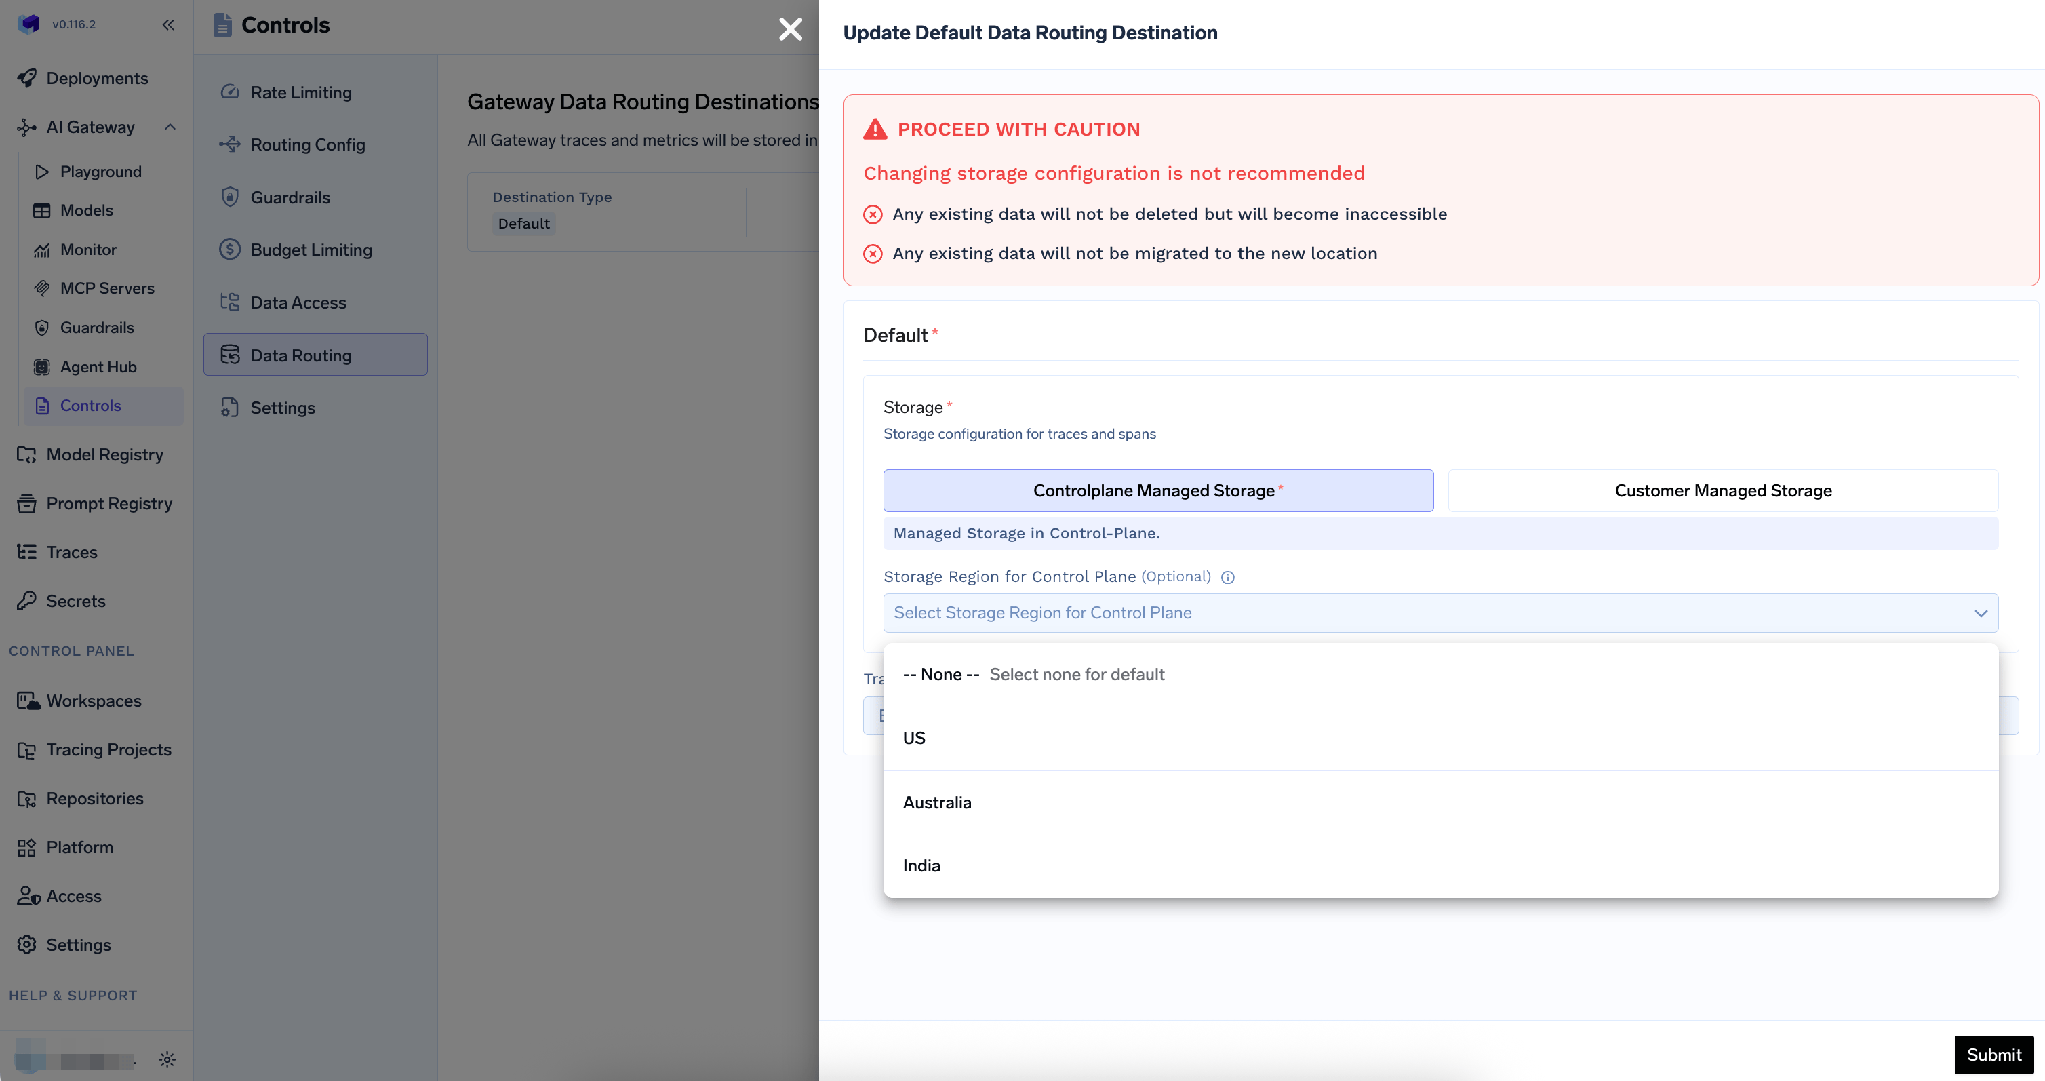
Deux contraintes de conception sont à prendre en compte. Les métriques sont toujours envoyées vers la destination par défaut et conservées indéfiniment — seules les traces peuvent faire l'objet d'un routage personnalisé. Par ailleurs, la modification d'une configuration de stockage n'entraîne aucune migration de données : les données existantes ne sont pas supprimées, mais deviennent inaccessibles depuis le nouvel emplacement.
Traiter le mauvais problème. Une équipe cherchant à réduire ses coûts met en place une répartition pondérée entre trois fournisseurs. Les poids ne tenant pas compte de la complexité des requêtes, l'impact sur la facture reste minime. Une équipe cherchant à parer aux interruptions de service active le routage par complexité et constate qu'une panne chez un fournisseur entraîne toujours une indisponibilité. Il est indispensable de définir précisément le problème avant de choisir le mécanisme.
Penser que la rétrogradation liée à l'état de santé s'applique partout. Dans le cadre d'un routage par poids, priorité ou latence, une cible défaillante est déplacée en fin de liste. Ce n'est pas le cas avec l'Auto Routing — l'ordre des cibles suit systématiquement la hiérarchie des niveaux, et la chaîne d'escalade gère le basculement. Les tentatives de rejeu par cible, les codes d'état de secours, les limites de débit et les budgets s'appliquent normalement ; le mécanisme de délai de récupération (cooldown) ne s'applique pas.
Considérer un classifieur comme gratuit. L'approche heuristique l'est réellement. Le classifieur LLM implique un second appel de modèle pour chaque tour non fixé, facturé et tracé comme n'importe quelle autre requête. Cette solution est souvent pertinente, mais elle doit être intégrée dans votre modèle de coûts pour éviter toute hausse inattendue sur votre facture.
Déployer du routage sans plafond de dépenses. Le routage optimisé réduit le coût moyen par requête, mais ne plafonne pas la dépense globale. Une boucle d'agent incontrôlée peut annuler les économies réalisées. Le routage de modèles ajuste l'efficacité, tandis que les règles budgétaires fixent la limite haute : l'association des deux est recommandée.
Un outil de support envoie l'ensemble de ses requêtes vers un modèle de pointe. Les coûts sont élevés, un fournisseur a connu des instabilités récentes, et l'équipe juridique s'interroge sur le lieu de traitement des conversations des clients de l'UE. Les trois problématiques se retrouvent sur une seule application.
Étape 1 : sélection de modèle. Créez un modèle virtuel support/assistant avec routage par complexité (Complexity). Associez le niveau simple à un modèle rapide et léger, le niveau medium à un modèle intermédiaire, le niveau complex au modèle de pointe, et maintenez le classifieur heuristique activé. L'application met à jour un unique paramètre : le nom du modèle.
La gestion des échanges multi-tours se fait sans configuration supplémentaire. Chaque tour est évalué, et la fixation du niveau s'ajuste uniquement vers le haut : si le tour 4 s'avère plus complexe, la conversation passe au niveau supérieur ; si le tour 5 indique « merci », le niveau est conservé. Cette attribution persiste pendant 10 minutes d'inactivité et se réinitialise à chaque tour. Lorsqu'une conversation atteint le niveau complex, les tours suivants ne nécessitent plus de classification.
Étape 2 : répartition de charge au sein d'un niveau. Ajoutez une seconde cible au niveau complex auprès d'un autre fournisseur. Les cibles d'un même niveau sont sollicitées selon leur ordre de déclaration avant toute escalade, offrant une solution de secours au modèle de pointe. L'interface permettant de définir une seule cible par niveau sur ce composant, cette structure nécessite l'utilisation de tfy apply ou de l'API.
Étape 3 : routage des données. Ajoutez metadata_match: { tfy_gateway_region: EU } sur une cible déployée dans l'UE avec une règle globale de secours en dessous, puis définissez une destination Data Routing orientant les traces dont la métadonnée metadata.region est égale à eu vers un bucket situé dans l'UE.
Étape 4 : définition du plafond. Une règle budgétaire appliquée à l'ID du modèle virtuel permet de plafonner les dépenses globales quel que soit le comportement du routage :
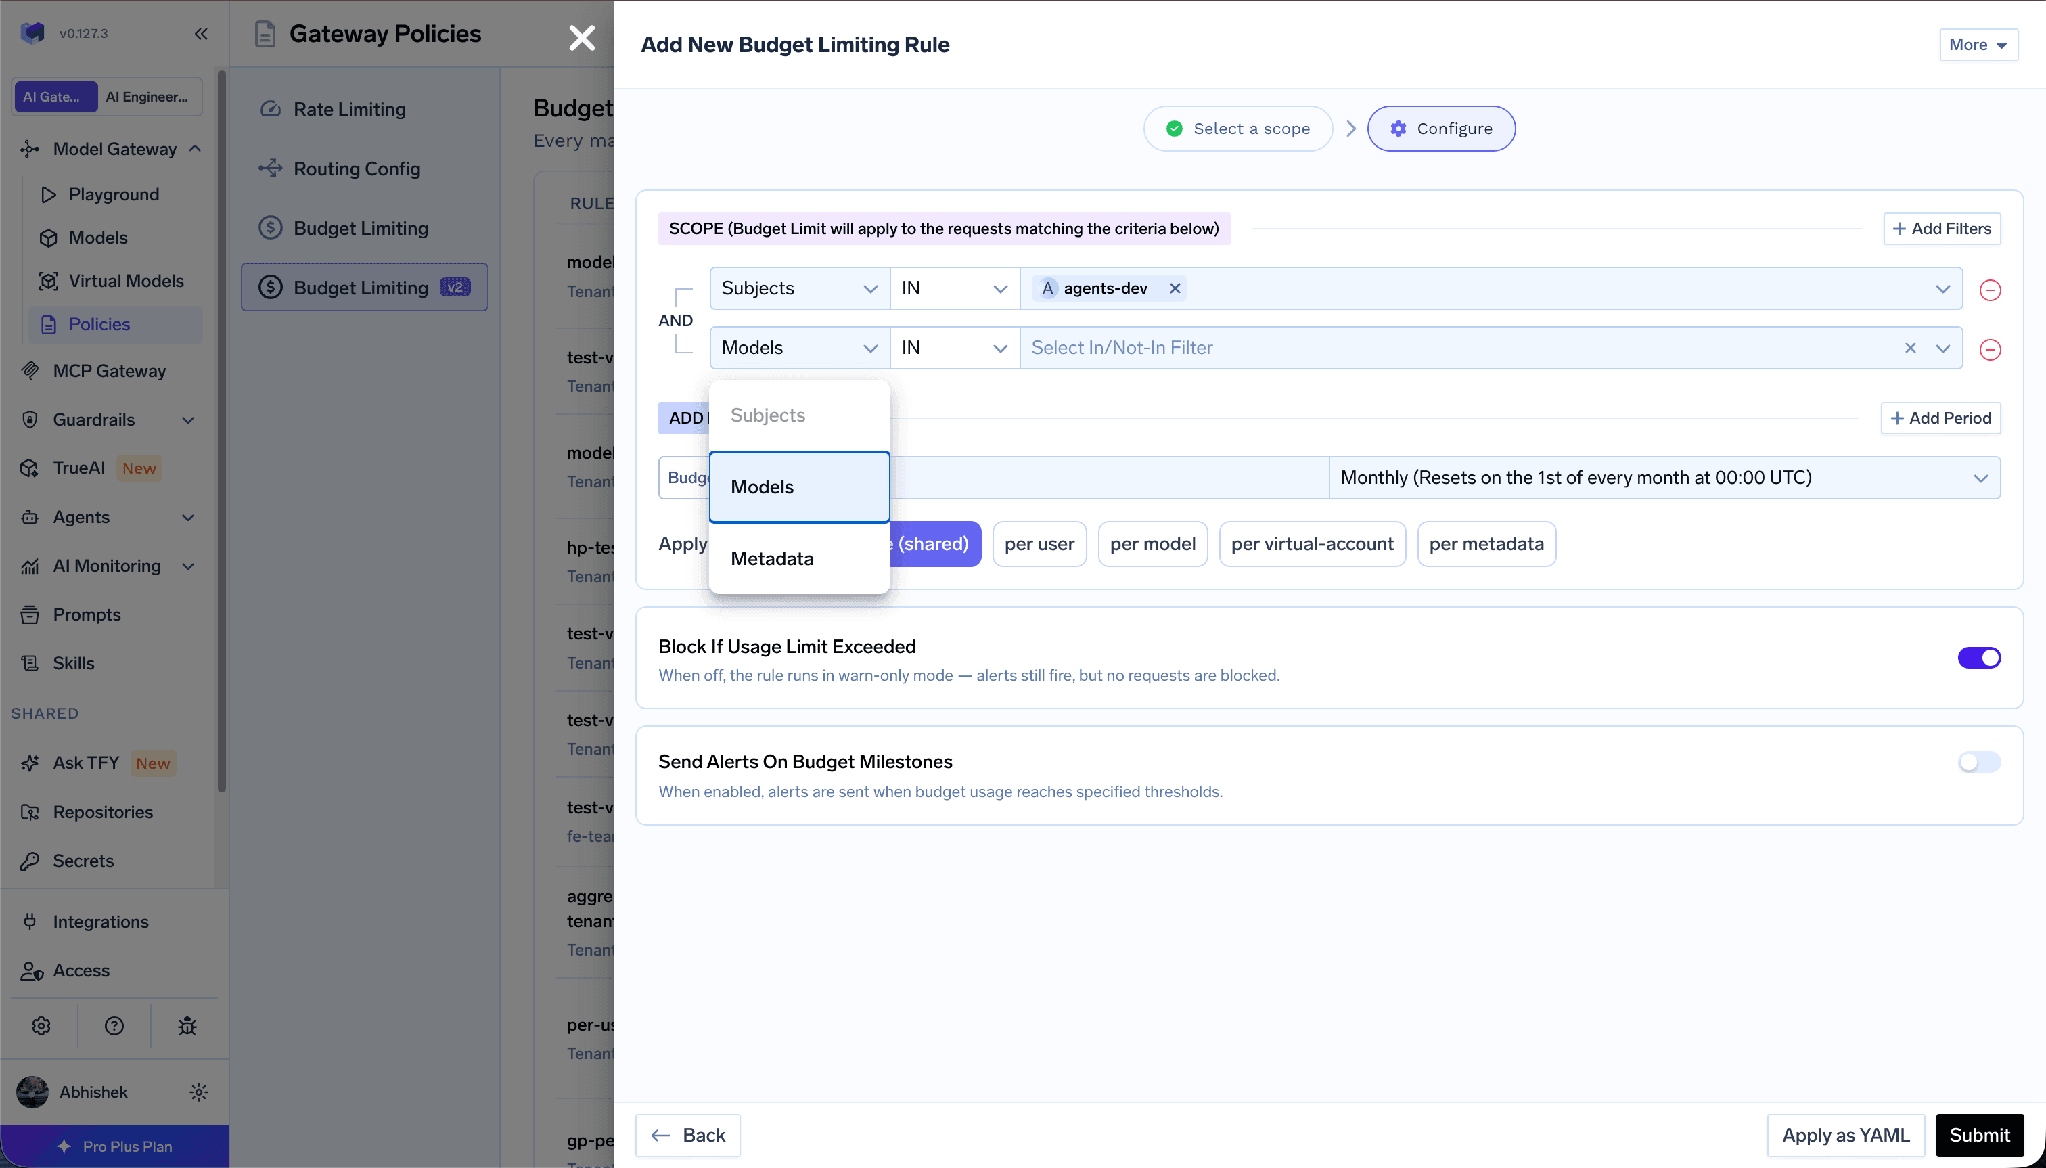
Filtres de portée des règles budgétaires avec conditions sur les sujets, les modèles et les métadonnées
Cette règle s'applique à la fois à l'ID du modèle virtuel et à la cible réelle associée, avec des comportements distincts. Un dépassement de budget sur le modèle virtuel en mode strict (enforce) bloque la requête complète avant tout traitement en backend, sans solliciter les cibles de secours. Un dépassement de budget sur une cible réelle ignore seulement cette cible, le modèle virtuel basculant alors vers une alternative. Un même mécanisme peut ainsi avoir des périmètres d'impact différents.
Étape 5 : vérification. Chaque réponse intègre l'en-tête x-tfy-applied-rules précisant le niveau appliqué, la cause et la chaîne ordonnée complète, ainsi que x-tfy-resolved-model indiquant le modèle ayant répondu. Le compteur ai_gateway_complexity_routing_decisions_total détaille les métriques par decided_tier, resolved_tier et cause — appliquez la différence de prix à la répartition réelle du trafic pour mesurer vos économies effectives.
L'Auto Routing s'applique uniquement aux modèles virtuels. Ce type de règle n'est pas valide dans le fichier YAML de routage au niveau du tenant. Il n'est pas pris en compte pour les modèles d'embedding, d'image, d'audio, de rerank ou de modération — seuls les types chat, completion et responses sont gérés. Les listes mixtes ne sont pas autorisées : déclarer simultanément chat et embedding entraîne un refus lors de l'enregistrement.
L'escalade gère les niveaux non configurés. Si seuls les niveaux simple et complex sont définis, une requête évaluée en medium bascule automatiquement vers complex, ce qui est indiqué dans l'en-tête. Cette configuration à deux niveaux est prise en charge — néanmoins, si les valeurs decided_tier et resolved_tier diffèrent régulièrement pour une raison autre que session_pin, un niveau est soit manquant, soit mal configuré.
Le classifieur analyse seulement deux messages. Il prend en compte le dernier message de l'utilisateur et le dernier message système ou développeur, dans la limite de 8 000 et 2 000 caractères respectivement. Les tours précédents, les réponses de l'assistant et les messages d'outils ne sont pas lus. La continuité au fil de la conversation est assurée par le mécanisme de persistance (pinning) et non par la lecture de l'historique complet.
Le terme « routeur LLM » recouvre une réalité large car il réunit trois catégories sous une même appellation. La répartition de charge assure la disponibilité avec des cibles interchangeables. La sélection de modèle optimise les coûts avec des cibles spécifiquement choisies. Le routage des données répond aux exigences de conformité et filtre l'ensemble des cibles avant toute autre opération.
Pris séparément, chaque besoin appelle une décision claire. Cherchez-vous à vous protéger des interruptions de service, à réduire le coût des requêtes simples ou à contrôler le lieu de traitement des données ? Le premier cas nécessite une chaîne de priorité, le deuxième des niveaux de complexité, et le troisième une correspondance de métadonnées couplée à une destination de stockage dédiée. La plupart des organisations ont un besoin immédiat sur l'un de ces aspects, puis étendent leur configuration par la suite.
Concernant l'optimisation des coûts, analysez les chiffres publiés dans leur globalité. La réduction de 69 % est un résultat mesuré, tout comme les deux pour cent de variation de précision associés.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Un routeur LLM se place entre votre application et vos modèles et décide quel modèle ou quel déploiement traite chaque requête. Le terme recouvre trois missions distinctes : l'équilibrage de charge entre cibles interchangeables pour le débit et le basculement, la sélection de modèle entre un modèle moins cher et un modèle plus performant, et le routage des données, qui restreint l'endroit où une requête peut être traitée et où ses journaux sont stockés. Chacune s'appuie sur des entrées différentes : la première question est donc de savoir laquelle il vous faut.
Le routage par sélection de modèle, oui ; l'équilibrage de charge et le routage des données, généralement non. L'Auto Routing de TrueFoundry a été mesuré à 69 % d'économies avec 98 % de la qualité conservée sur 550 prompts évalués, et jusqu'à 80 % sur un trafic proche de la production. Les économies dépendent de la composition de votre trafic : ventilez la métrique des décisions de routage par niveau résolu et multipliez la part de chaque niveau par l'écart de prix.
Un routage basé sur la complexité sur un seul modèle virtuel avec le classifieur heuristique gratuit, car il ne nécessite ni modification de l'application ni dépense de classification. Ajoutez une chaîne de priorité entre deux fournisseurs dès qu'une panne vous a coûté quelque chose. Ajoutez le routage des données lorsque quelqu'un demande où vont les données.
Oui — en VPC, on-premise, en environnement air-gapped, en hybride ou sur plusieurs clouds, sans qu'aucune donnée ne quitte votre domaine.
Environ 3 à 4 ms de surcoût, en traitant plus de 350 RPS sur un seul vCPU, pour plus de 1 000 LLM pris en charge. L'exception est le classifieur LLM facultatif, qui ajoute un véritable appel de modèle avant le transfert de la requête.
Oui. La passerelle est conforme à OpenTelemetry et se connecte à Grafana, Datadog ou Prometheus. Chaque appel au classifieur LLM produit son propre span, de sorte que la latence du classifieur est visible séparément de celle du modèle servi.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















