November 5, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
L'autorisation à grain fin concerne la taille de l'élément sur lequel porte votre décision, et non le mécanisme utilisé. L'autorisation grossière demande : « cette identité peut-elle utiliser l'AI gateway ? ». L'autorisation à grain fin demande : « cette identité peut-elle appeler l'outil delete_issue sur le serveur MCP Linear, en ce moment même, pour cette personne ? »
Cette évolution s'articule autour de quatre dimensions indépendantes, qu'il convient de séparer car leurs coûts diffèrent :
La plupart des publications sur le contrôle d'accès à grain fin réduisent ces critères à un curseur unique nommé « plus sécurisé » qu'elles poussent au maximum. C'est une erreur. La granularité du sujet et de l'action ne coûte presque rien — cibler un utilisateur au lieu d'un groupe, ou une permission au lieu d'un lot, n'alourdit pas la revue d'accès. La granularité de la ressource et de l'occasion est celle qui génère la vraie complexité.
La granularité est également orthogonale au choix entre RBAC et ABAC. Des rôles simples peuvent exprimer des permissions très fines si les liaisons (bindings) sont restreintes, tandis que des politiques basées sur des attributs peuvent être exagérément grossières. Le modèle détermine la manière dont vous décidez ; la granularité détermine l'objet de la décision.
Faisons le calcul. Quarante ingénieurs et une permission globale sur la gateway nécessitent de vérifier 40 états lors d'une revue d'accès. Restreignez cette permission par ressource sur 12 serveurs MCP, et vous obtenez 480 états. Passez au niveau de l'outil avec 25 outils par serveur, et vous atteignez 12 000 cellules. Ajoutez une approbation par invocation, et l'objet de la revue n'est plus une grille : cela devient un journal d'événements (event log).
Personne n'audite 12 000 cellules. Voici ce qui se produit réellement en cas de sur-granularité :
La contrainte fondamentale est donc l'exploitabilité de l'audit. Quel que soit l'échelon, vous devez pouvoir répondre à trois questions sans lancer de traitement automatisé : qui peut accéder à cette ressource, quelles actions peuvent y être effectuées, et à quand remonte la dernière intervention. Si vous perdez cette capacité, vous avez sacrifié la visibilité au profit de la précision.
C'est pourquoi le principe du moindre privilège et la granularité maximale ne sont pas un seul et même objectif. Le moindre privilège garantit qu'aucune autorité supérieure à celle requise par la tâche n'est accordée ; il n'impose pas de découper cette autorité aussi finement que le système le permet. Un rôle possédant exactement les sept permissions nécessaires à une tâche respecte le moindre privilège. Sept cents autorisations distinctes cumulant la même autorité rendent simplement le système complexe et coûteux.
Quatre échelons, du plus grossier au plus fin, chacun répondant à un besoin précis. La règle consiste à rester à l'échelon le plus bas permettant de maîtriser le risque.
Deux caractéristiques en font une échelle et non un simple menu.
Les échelons se composent du haut vers le bas, pas latéralement. L'échelon 3 ne concerne que les identités ayant validé l'échelon 2, et un outil désactivé reste inaccessible quel que soit le rôle détenu. Vous pouvez être permissif à un échelon grossier et strict à un échelon fin : la restriction sera appliquée.
Chaque échelon prend une forme de registre différente. Les échelons 1 et 2 sont des tableaux consultables. L'échelon 3 est une liste à comparer avec celle du trimestre précédent. L'échelon 4 est un journal d'événements à échantillonner. Traiter l'échelon 4 comme un simple tableau explique pourquoi certaines équipes se retrouvent avec deux cents politiques que personne n'est capable de synthétiser.
Utiliser l'échelon 1 pour accomplir le rôle de l'échelon 2. L'erreur la plus répandue. Un utilisateur a besoin d'accéder à un serveur MCP spécifique : on lui attribue un rôle à l'échelle du tenant contenant mcp-server:ReadMcpServer — ce qui lui donne accès à tous les serveurs MCP du tenant. L'attribution semble restreinte parce que la liste de permissions est courte, mais ce n'est pas le cas.
Monter à l'échelon 4 pour éviter un arbitrage sur l'échelon 2. Les politiques d'approbation sont attrayantes car elles diffèrent la décision. Mais placer un contrôle sur un outil accessible aux mauvaises personnes revient à installer une grille devant une porte ouverte. Corrigez d'abord la liaison de rôle (binding).
Traiter la désactivation d'un outil comme une frontière de sécurité absolue contre des appelants non fiables. Désactiver un outil le retire de la découverte (discovery) et bloque son invocation — une mesure efficace contre un agent qui risquerait de sélectionner une action dangereuse dans une longue liste. Cela ne remplace pas les permissions propres au système en amont sur l'identifiant (credential).
Ne jamais réévaluer les échelons fins. Les autorisations grossières sont révisées car elles sont visibles. Un outil activé pour une migration ponctuelle il y a huit mois devient invisible. Auditez la liste des outils activés à la même fréquence que vos revues de rôles.
TrueFoundry intègre les quatre échelons. L'association d'un sujet (utilisateur, équipe, compte virtuel ou agent), d'une ressource et d'un rôle constitue une liaison de rôle (role binding), gérée indépendamment de la configuration de la ressource. Vous pouvez ainsi modifier les accès sans redéployer l'élément concerné.
Trois rôles de tenant sont intégrés par défaut : Admin (contrôle total, non modifiable), Member (niveau de base par défaut, modifiable) et Read-Only Member (lecture seule, également fixe).
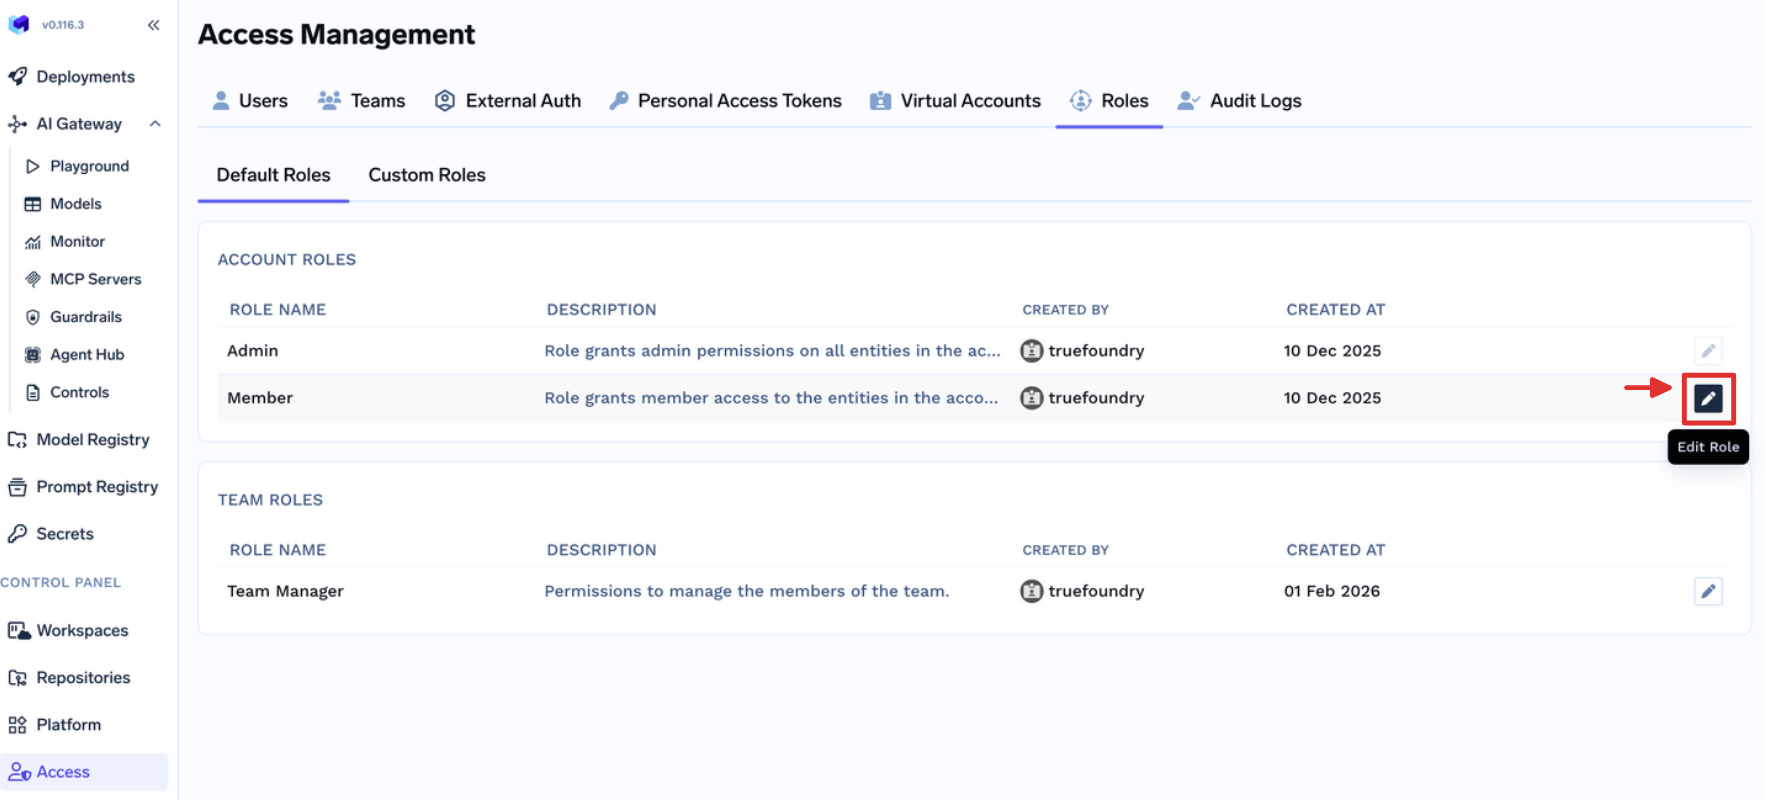
Si ces rôles s'avèrent trop larges ou trop restreints, vous pouvez créer un rôle personnalisé depuis Access > Custom Roles. Le catalogue de permissions constitue le cœur de la granularité à cet échelon : chaque entrée est une clé ressource:Action regroupée par type de ressource. Leur nom indique la granularité disponible avant même la conception de votre modèle.
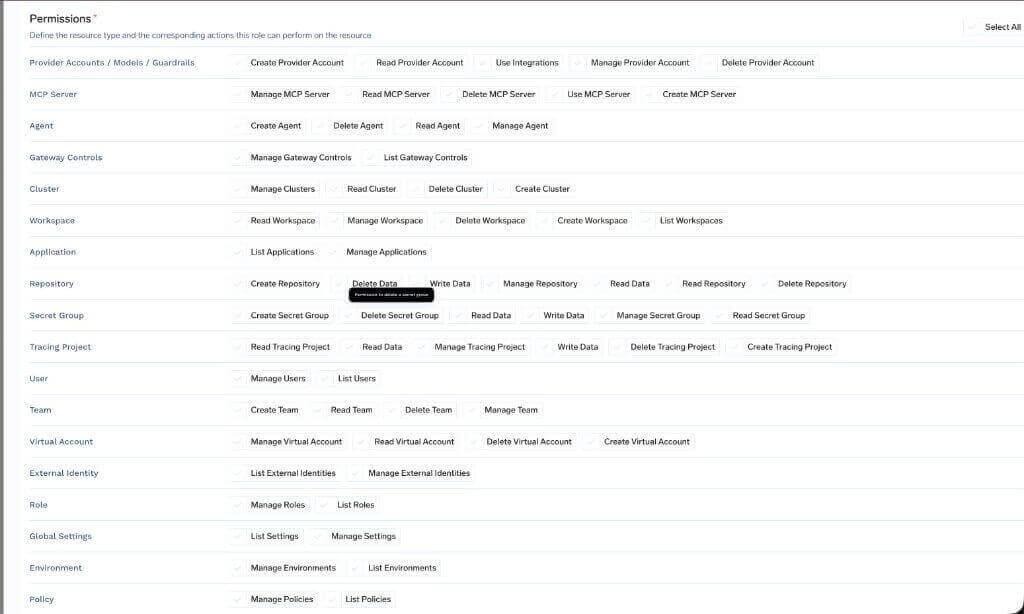
La création d'un serveur MCP et sa gestion sont associées à des clés distinctes. Ce découpage offre la précision nécessaire au modèle d'autorisation.
Une règle régit cet échelon : les permissions d'un rôle personnalisé s'appliquent à toutes les ressources du type sélectionné. Pour cibler une ressource unique, utilisez la page Access Control de cette ressource. Faire l'inverse correspond à l'erreur mentionnée plus haut (utiliser l'échelon 1 à la place de l'échelon 2).
Ouvrez le menu à trois points de la ressource et sélectionnez Access Control.
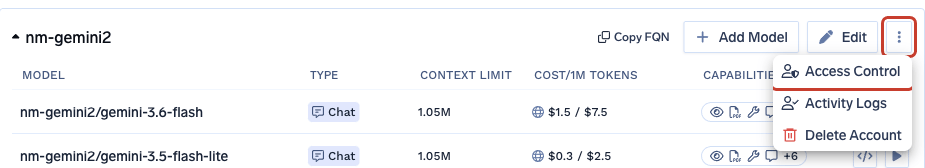
Sélectionnez les sujets et attribuez un rôle. Le volet latéral détaille les actions incluses dans chaque rôle, permettant de vérifier le périmètre accordé.

Les rôles dépendent de la ressource concernée : Manager et User sur un compte fournisseur ; MCP Server Manager, MCP Server User et MCP Server Approver sur un serveur MCP ; Agent Manager et Agent Access sur un agent ; ainsi que des niveaux admin, member et viewer sur les clusters et workspaces. L'attribution d'accès à une équipe est préférable à l'attribution individuelle : les futurs membres en héritent automatiquement et le tableau des autorisations reste lisible. Le modèle de contrôle d'accès aux serveurs MCP repose sur cet échelon.
C'est l'échelon auquel les équipes pensent en dernier, mais dont les agents ont le plus besoin. Sur un serveur MCP distant ou géré par TrueFoundry, l'onglet Tools contrôle quels outils peuvent être appelés.

Les outils désactivés sont exclus des réponses tools/list et ne peuvent pas être invoqués. Les deux aspects sont essentiels : le modèle ne peut pas choisir ce qu'il ne voit pas, et la gateway rejette la requête si un appel est tout de même tenté.
Le commutateur Enable new tools by default définit le comportement de base et constitue un vrai choix d'architecture. S'il est activé, la liste fonctionne comme une liste d'exclusion (denylist) et les nouveaux outils fournis par le vendeur apparaissent automatiquement. S'il est désactivé, elle agit comme une liste d'autorisation (allowlist) et les nouveaux outils amont restent masqués jusqu'à leur activation explicite. La liste d'autorisation est recommandée pour tout environnement de production.
L'option Edit Tool propose un réglage plus subtil. En plus d'adapter la description, vous pouvez définir les MCP Tool Annotations sur None, Read-only ou Destructive, ce qui affecte la propriété readOnlyHint ou destructiveHint.
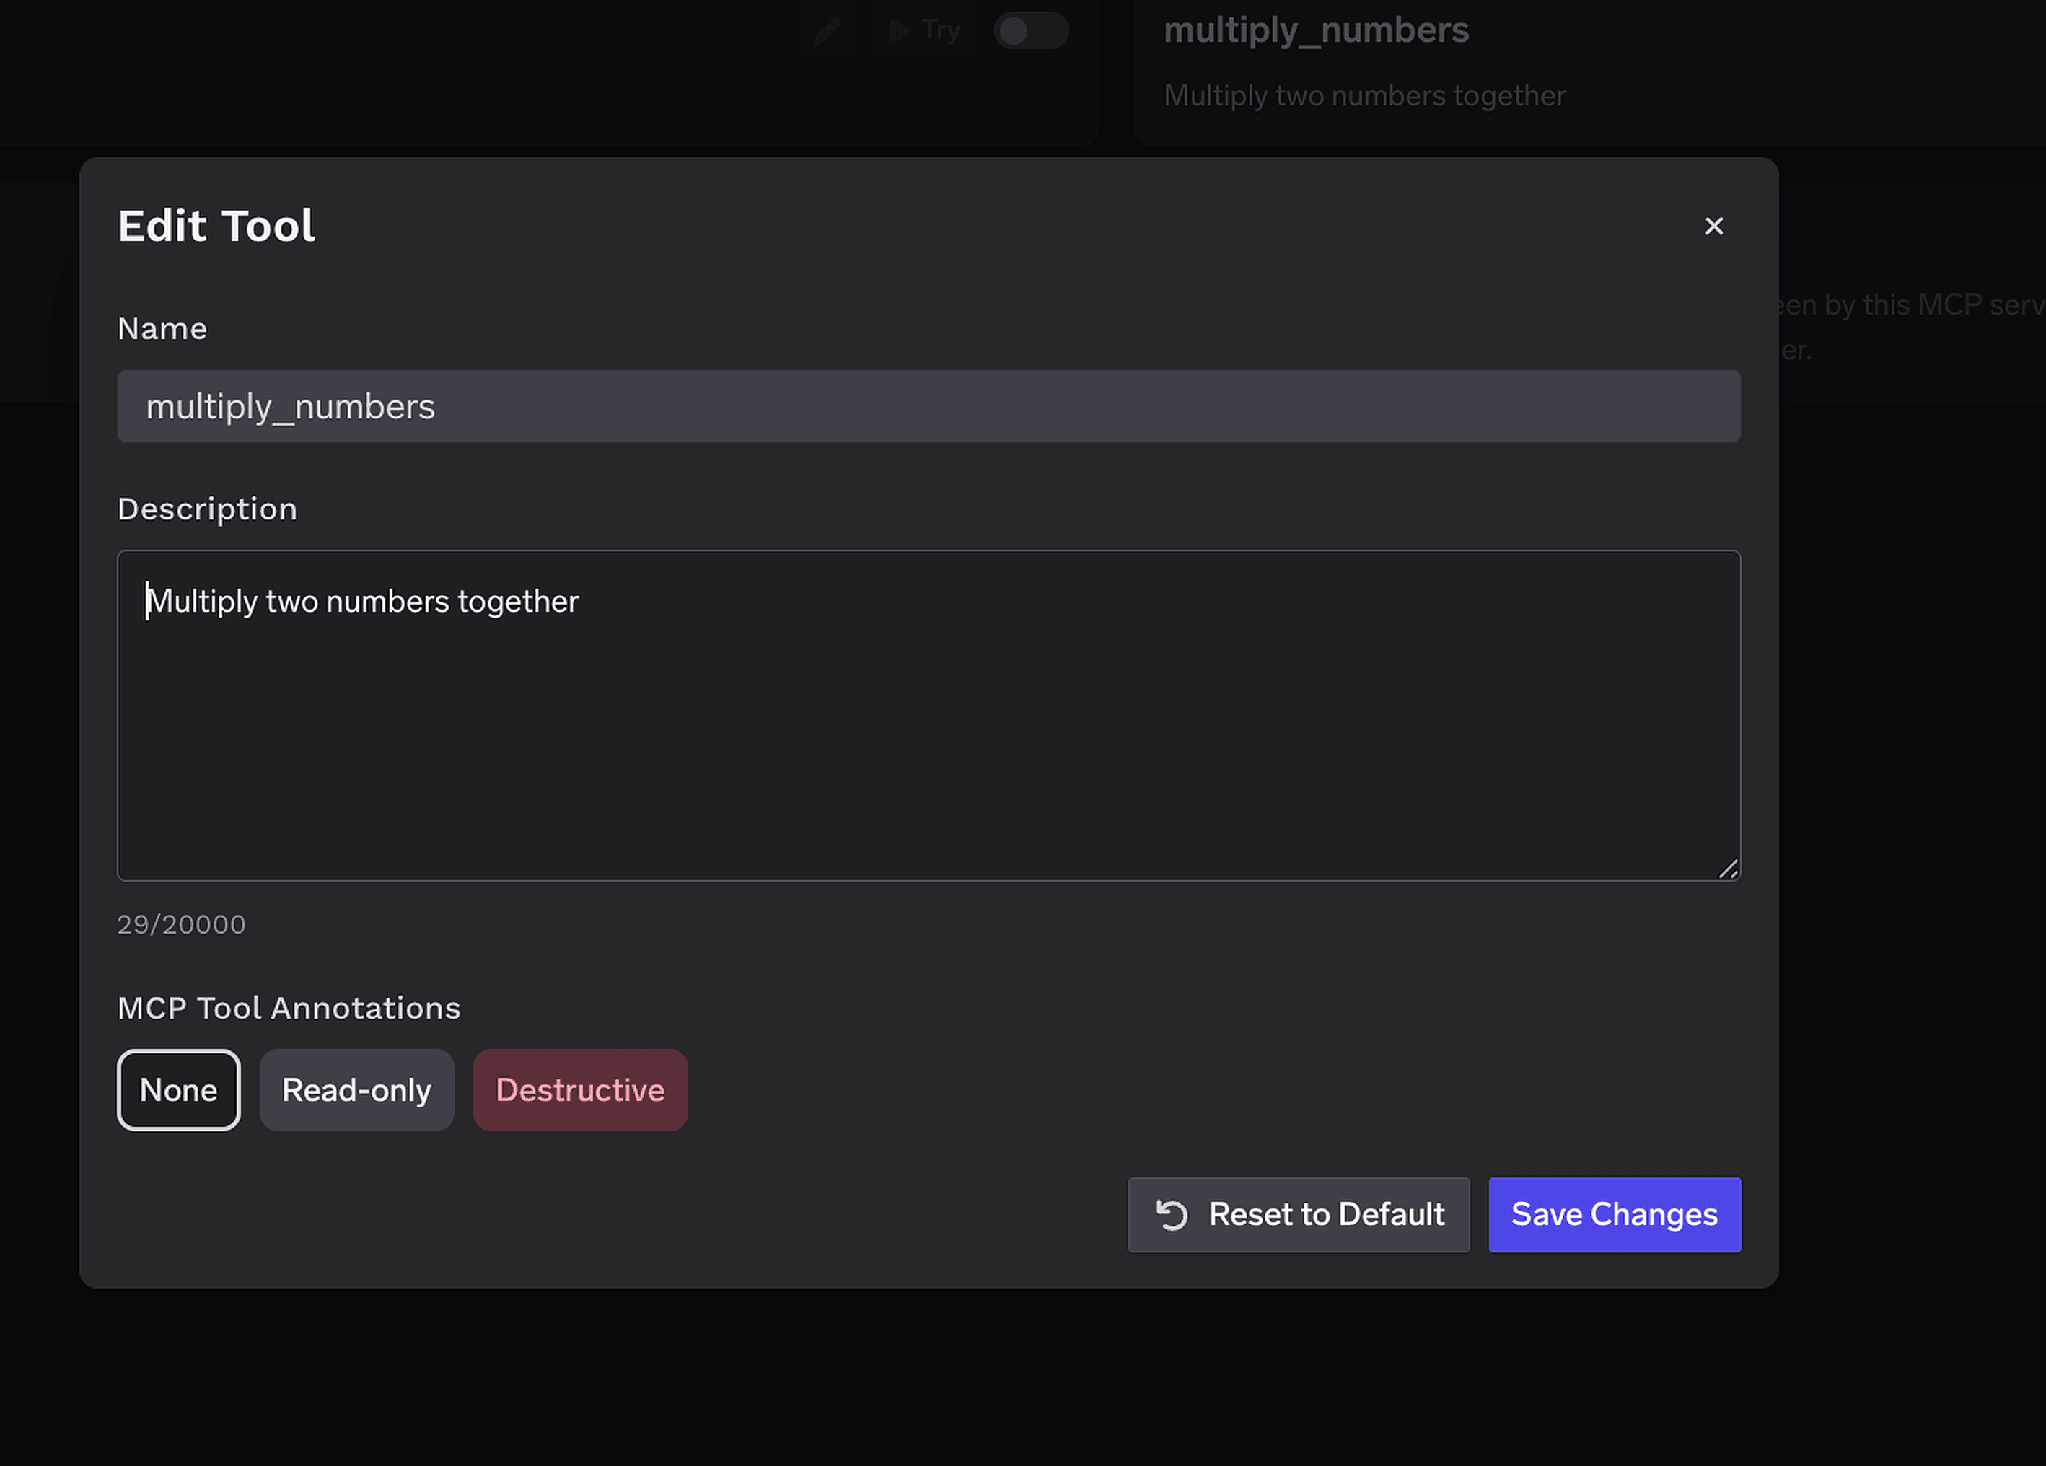
Cette annotation sert de repère à l'échelon 4, transformant une classification ponctuelle en politique durable sans avoir à redéfinir les outils.
Les politiques d'approbation d'outils mettent en attente l'appel tools/call au niveau de la gateway, génèrent une demande et notifient les approbateurs. L'outil ne s'exécute pas immédiatement. Une fois l'accord donné, les appels réussissent pendant une fenêtre de validité définie, après quoi une nouvelle approbation devient nécessaire.
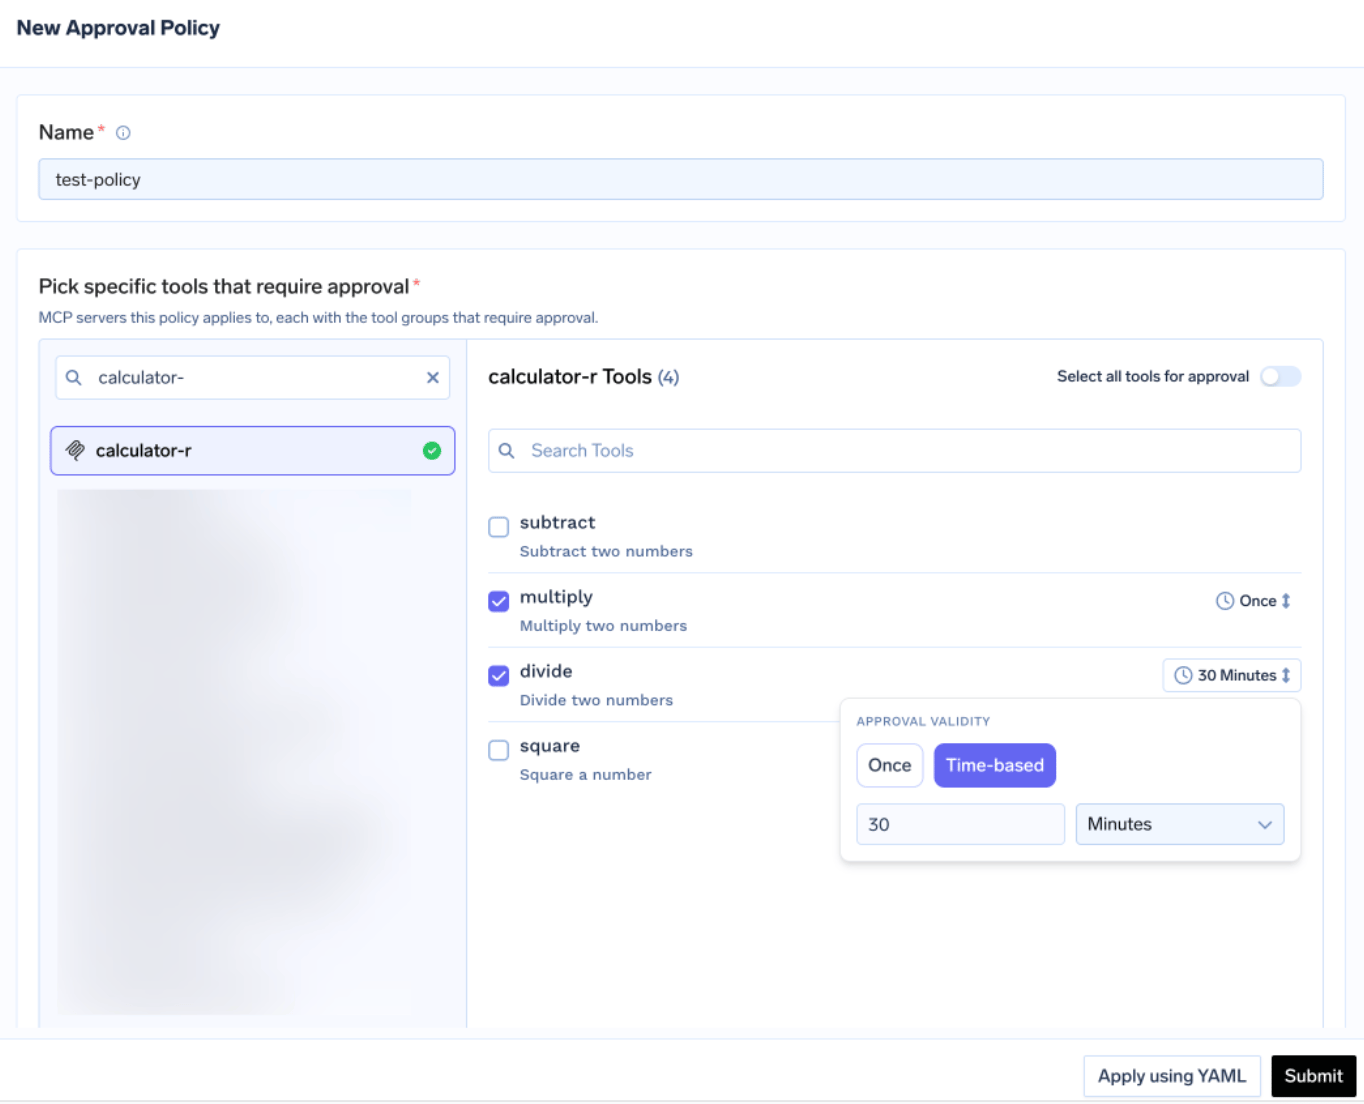
Deux paramètres définissent la granularité, chacun obéissant à des règles de priorité précises :
Les autorisations sont strictement associées au demandeur, au serveur et à l'outil concerné. Elles ne sont pas partagées entre les utilisateurs. Les approbateurs traitent les demandes depuis l'onglet Pending Requests, qui détaille l'outil, la politique appliquée, le demandeur, la fenêtre de validité et les arguments transmis.
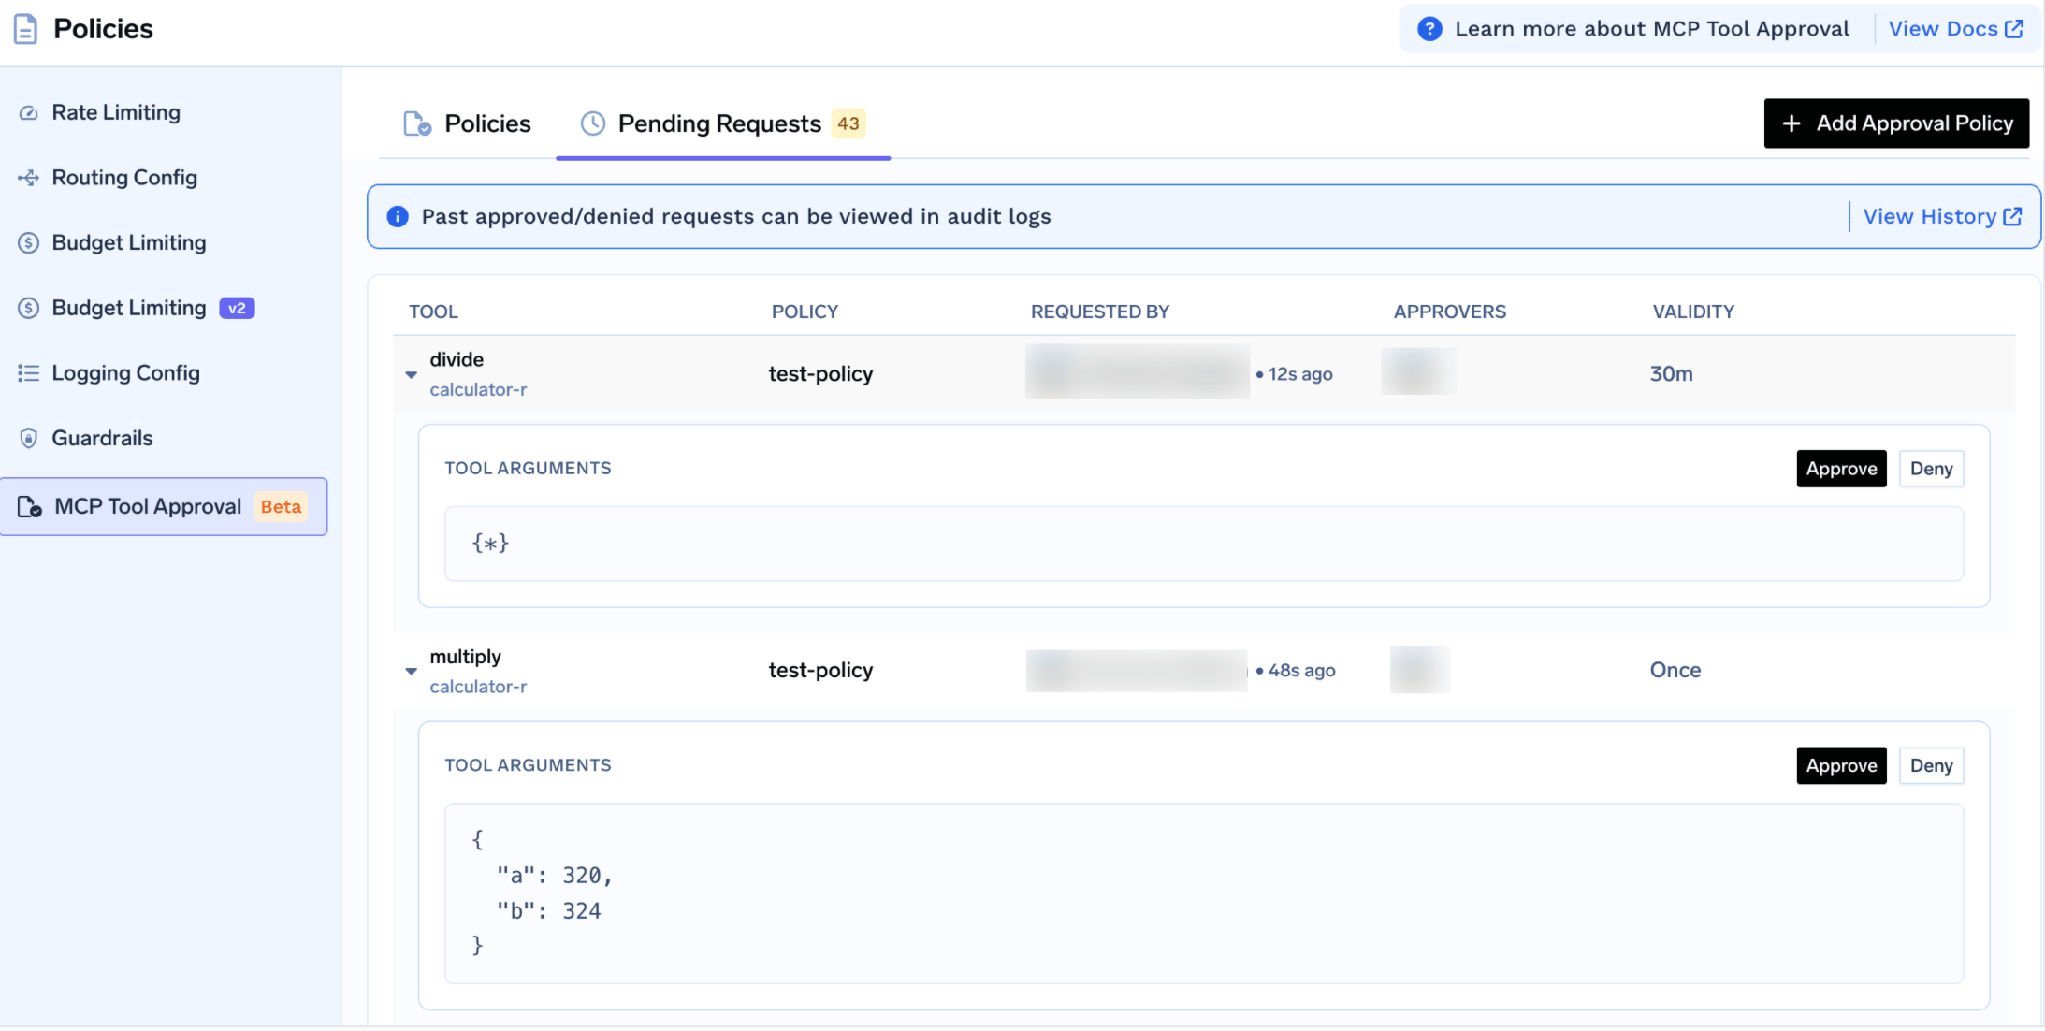
La capacité d'approuver ou de refuser est elle-même répartie entre les échelons. Seuls les administrateurs du tenant peuvent créer, modifier ou supprimer des politiques. L'approbation ou le refus nécessite le rôle d'administrateur du tenant ou le rôle MCP Server Approver sur le serveur concerné, attribué depuis sa liste de collaborateurs.
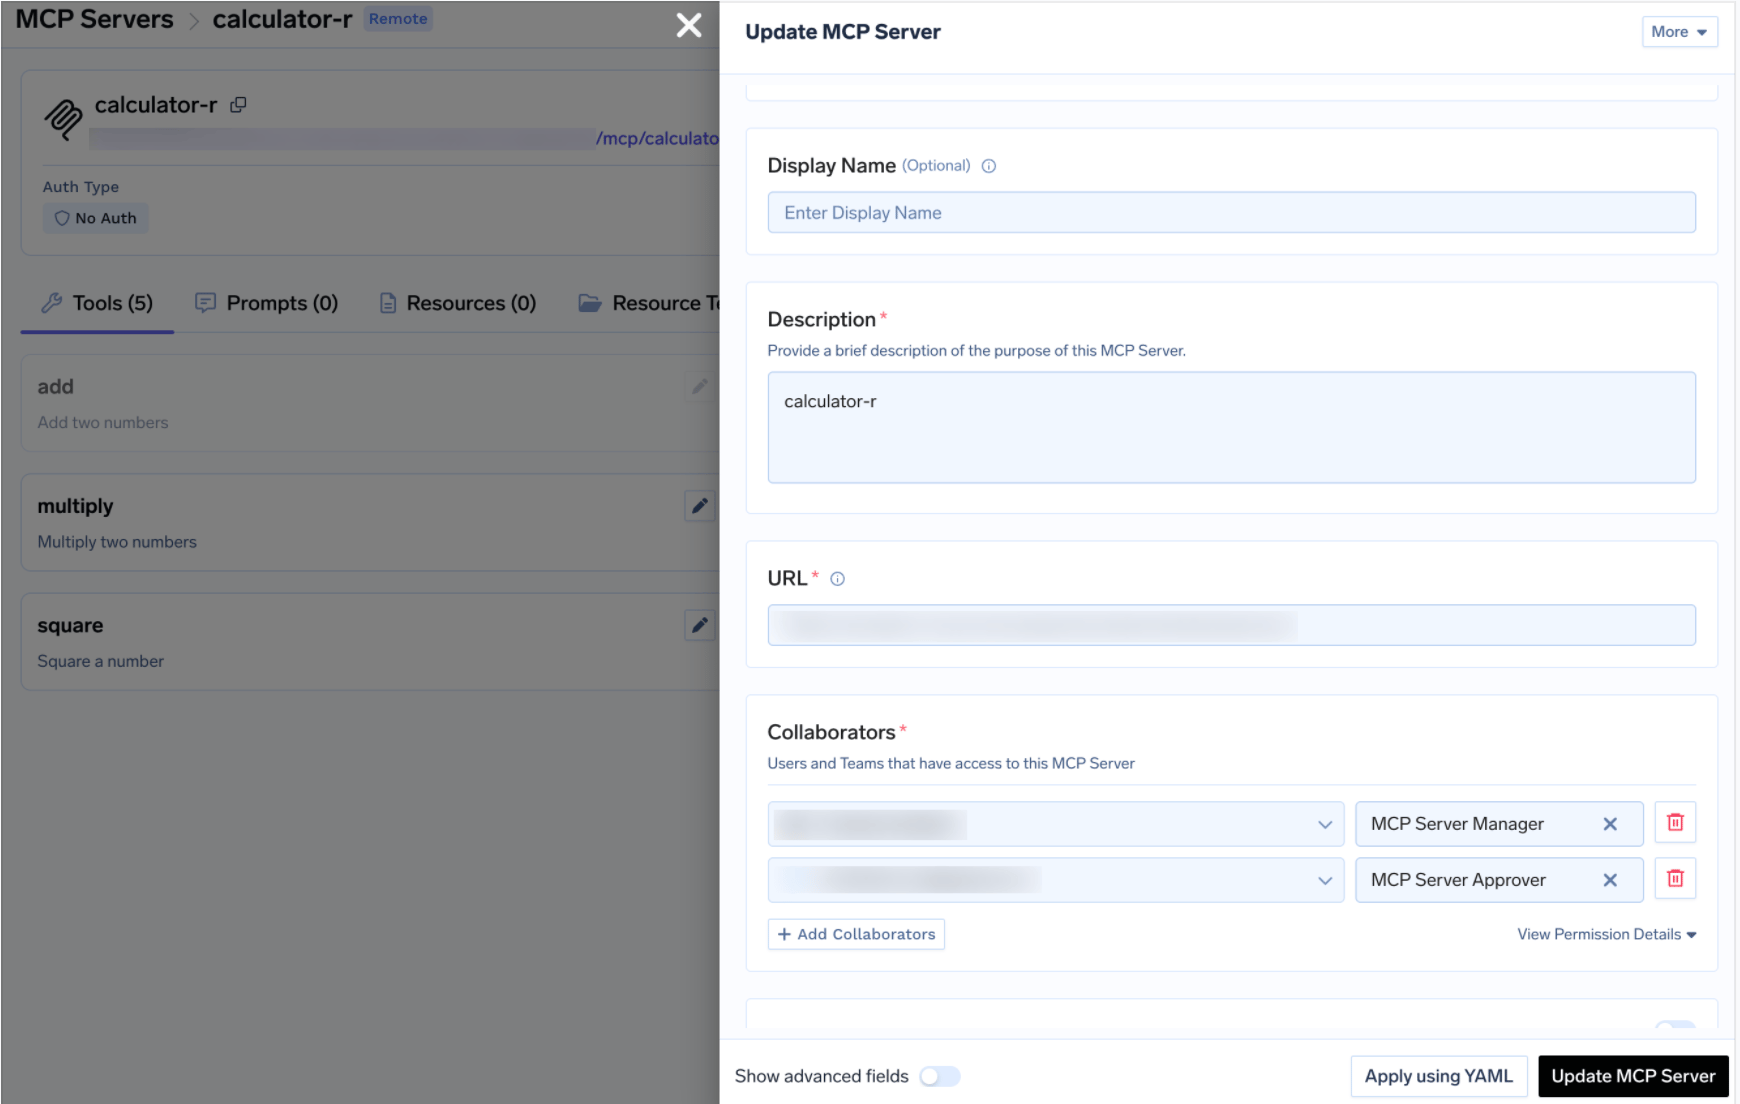
Si un serveur ciblé par une politique ne compte aucun collaborateur avec le rôle Approver, seuls les administrateurs du tenant peuvent valider les demandes — au risque de créer un goulot d'étranglement auprès de quelques personnes.
Une précision importante : un refus ne constitue pas un blocage définitif. Il est enregistré dans les journaux, et l'appel suivant génère une nouvelle demande. Pour interrompre durablement un accès, redescendez l'échelle : retirez l'accès du sujet au serveur ou désactivez l'outil. L'échelon 4 régit des événements ponctuels, pas l'autorité globale.
Les groupes de secrets illustrent parfaitement l'intérêt de la granularité des actions, car il s'agit de séparer la consultation d'une valeur de son utilisation opérationnelle.
Un groupe de secrets organise des identifiants liés afin d'en gérer l'accès de manière centralisée. Lorsque vous enregistrez un secret, sa valeur est transmise à votre propre gestionnaire (AWS SSM, GCP Secret Manager, HashiCorp Vault, Azure Vault), tandis que TrueFoundry stocke un nom pleinement qualifié (FQN) utilisé dans vos déploiements, montages de volumes, intégrations et clés d'API de modèles.
Ce niveau d'indirection permet à un déploiement d'utiliser un secret via son FQN sans qu'aucun opérateur humain n'ait besoin d'en afficher la valeur. La distinction devient alors pleinement opérationnelle :
Le rôle Viewer illustre bien cet avantage. Un utilisateur peut vérifier que la clé stripe-live-key est présente — ce qui suffit pour auditer les dépendances d'un projet — sans que sa valeur ne soit exposée à l'écran. Le catalogue de permissions traduit cette séparation : secret-group:ReadSecretGroup permet de consulter le groupe, tandis que secret-group:ReadData permet d'en lire les valeurs. S'agissant de clés distinctes, un rôle personnalisé peut inclure l'une sans l'autre.
Deux éléments méritent attention. Un administrateur de tenant a accès par défaut à l'ensemble des groupes de secrets ; pour les membres et les équipes, un rôle doit être attribué individuellement sur chaque groupe. Par ailleurs, la liste des rôles de ressources mentionne un quatrième rôle, Secret Group Access, aux côtés d'Admin, Editor et Viewer. La page de gestion des secrets ne documentant que les trois premiers, vérifiez la configuration de votre console avant d'appuyer vos processus sur ce quatrième rôle. [VERIFY]
Ce principe s'applique à d'autres ressources. Lorsqu'une ressource distingue sa description de son contenu, vérifiez l'existence de clés séparées — les dépôts (repositories) disposent par exemple de clés ReadRepository et ReadData distinctes — et accordez l'accès à la description seule lorsque cela suffit.
Les autorisations se cumulent : en supprimer une ne supprime pas les autres. Un sujet peut détenir un accès direct tout en en héritant via une équipe. TrueFoundry combine ces accès : révoquer l'autorisation directe laisse l'accès hérité actif. Vérifiez systématiquement les deux niveaux. La granularité fine accentue ce phénomène en multipliant les autorisations ponctuelles.
Modifier le rôle par défaut d'une équipe s'applique à l'ensemble des équipes. Les rôles Team Member et Team Manager se modifient sous Access > Default Roles, et ce changement est global. Ajouter la permission virtual-account:ManageVirtualAccount pour permettre à une équipe de récupérer des jetons accorde cette capacité à toutes les équipes. Les utilisateurs restent restreints à leur propre périmètre, mais la capacité globale est élargie. Il s'agit d'une modification de niveau 1 sous la forme d'un réglage de niveau 2.
Une approbation en attente renvoie une réponse positive, pas une erreur. Tant qu'une demande est en attente, la gateway renvoie un résultat JSON-RPC avec isError: false et _meta.approval_status: "pending", invitant l'appelant à patienter. Un agent qui contrôle uniquement l'absence d'erreur peut interpréter cela comme un résultat valide et poursuivre son exécution. Pensez à contrôler la valeur de _meta.approval_status et à planifier de nouvelles tentatives.
L'autorisation à grain fin est souvent présentée comme un réglage à pousser au maximum. Il s'agit plutôt d'une échelle à gravir avec méthode, en s'arrêtant lorsque le risque est maîtrisé plutôt que lorsque la plateforme n'offre plus d'options.
Chaque échelon répond à une question précise. La capacité au niveau du tenant définit les actions globales d'un utilisateur. Les rôles par ressource en précisent le périmètre. Les permissions au niveau des outils déterminent les opérations disponibles. L'approbation par invocation valide l'exécution d'un appel précis à un instant donné. Dans cet ordre, chaque niveau affine le précédent tout en préservant la lisibilité de l'ensemble.
Appliquer ces règles sans méthode — comme placer une validation par appel devant une liaison de rôle trop large, ou utiliser un rôle global à la place d'une autorisation par ressource — produit un modèle élégant sur le papier mais impossible à justifier lors d'un audit. Le modèle le plus fin n'est pas nécessairement le meilleur. Le meilleur modèle est celui que vous pouvez expliquer clairement.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




L'autorisation à granularité fine est un contrôle d'accès qui statue sur de petites unités plutôt que sur des systèmes entiers — une ressource nommée plutôt qu'un type de ressource, une action plutôt qu'un accès complet, un outil plutôt qu'un serveur, un appel plutôt qu'une autorisation permanente. Le mécanisme peut reposer sur des rôles, des attributs ou du code de politique ; la granularité désigne la taille de ce sur quoi porte la décision, pas la manière de la prendre.
Aussi fines que le risque l'exige, mais pas plus fines que ce que vous pouvez auditer. Pour chaque niveau ajouté, demandez-vous si vous pouvez encore répondre à la question « qui peut faire quoi sur cette ressource » à partir d'un tableau plutôt que d'une enquête. La granularité par sujet et par action est peu coûteuse. La granularité par ressource et par appel entraîne un vrai coût de revue : réservez-la aux opérations irréversibles ou visibles de l'extérieur.
Les permissions au niveau des outils déterminent quels outils précis d'un serveur un agent peut appeler. Les agents en ont besoin parce qu'un agent choisit lui-même ses outils parmi ceux qu'il découvre, et que ses entrées peuvent être hostiles — un document empoisonné peut l'orienter vers un outil destructeur. Désactiver un outil dans TrueFoundry le retire de tools/list et bloque son invocation : le modèle ne peut donc pas choisir ce qu'il ne voit pas. Qu'est-ce que l'autorisation MCP présente le modèle dans lequel cela s'inscrit.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception