



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une API de paiement est facile à observer parce qu'elle est prévisible. Un même extrait d'entrée produit le même parcours de code, de sorte que trois métriques — taux de requêtes, taux d'erreur, durée — vous révèlent presque tout. Lorsqu'un problème survient, vous analysez une trace d'exécution (stack trace), qui constitue un fait précis sur le programme, et non une conjecture sur son intention.
Un agent remet en cause chaque hypothèse de cette approche. Le modèle choisit son parcours à l'exécution, de sorte qu'un même texte d'entrée ne produit pas le même parcours de code. Bien souvent, il n'y a aucune erreur : l'agent termine son travail, renvoie du texte, et chaque appel HTTP effectué a renvoyé un code 200. De plus, ce qui a échoué n'est généralement pas un plantage, mais une décision — il a sélectionné le mauvais outil, relu un fichier qu'il possédait déjà, ou répété une recherche qui ne pouvait jamais aboutir.
La question évolue donc : il ne s'agit plus de savoir s'il était disponible, mais pourquoi il a fait cela. Or, ce « pourquoi » est une propriété de l'ensemble de la séquence, et non d'une requête isolée — c'est pourquoi un tableau de bord peut sembler sain alors que votre agent échoue. Un P99 de latence de 900 ms sur l'ensemble des appels de modèle ne vous apprend rien sur une exécution qui en a effectué 140.
Les données comportent quatre niveaux imbriqués, dont seuls les deux derniers ressemblent à une requête conventionnelle.
Les deux niveaux intermédiaires concentrent toute la valeur, et ce sont précisément les deux qu'un outil de traçage basé sur les requêtes ne modélise pas. Il perçoit une dispersion d'appels sortants sans parent significatif, et ne peut pas vous indiquer que les appels 11 à 27 constituaient un seul tour essayant sept fois la même action.
Une propriété distingue fondamentalement cette approche du traçage distribué classique : chaque niveau peut boucler. Il n'y a pas d'équivalent dans un graphe de service standard — A appelle B qui appelle C, et si A s'appelle lui-même, il s'agit d'un bug. Dans un agent, une étape qui décide de s'appeler à nouveau constitue le cas nominal, et la seule manière de distinguer une boucle productive d'une boucle bloquée consiste à analyser la séquence.
Chaque niveau nécessite ses propres signaux. Collecter l'intégralité des données sans ciblage génère du volume sans apporter d'éclairage. Voici donc le minimum essentiel à conserver.
La dernière cellule représente le signal le plus déterminant dans l'observabilité des agents, et pourtant presque personne ne l'enregistre : un même outil appelé deux fois avec des arguments identiques au sein d'un même tour constitue une boucle. Cela devient évident dès que les arguments figurent sur le span, mais reste impossible à détecter à partir de métriques agrégées.
Trois schémas couvrent la quasi-totalité des incidents en production.
1. La boucle de réessai silencieuse. Un agent interroge une base de connaissances, n'obtient aucun résultat pertinent, reformule, puis recherche à nouveau — vingt fois de suite. Chaque recherche renvoie un code 200 en 300 ms ; les tableaux de bord de taux de requêtes et de taux d'erreur n'affichent donc qu'une légère hausse de trafic sans autre anomalie. Au niveau de la session, la situation est flagrante : un seul tour, vingt appels d'outils, deux minutes de durée. Le diagnostic ne réside dans aucun span individuel ; il réside dans la répétition.
2. L'outil qui réussit tout en renvoyant du contenu inutilisable. Un outil de récupération de documents se heurte à une restriction de permissions et renvoie un code 200 dont le corps est une page de connexion HTML. Le modèle la lit et indique qu'aucune politique de ce type n'existe. Aucune erreur n'est relevée. La seule façon d'intercepter ce problème est de capturer le résultat brut — c'est pourquoi la capture des résultats, et pas seulement des codes de statut, constitue une exigence fondamentale.
3. L'exécution 40x. Le coût médian d'une session est de 0,04 $ ; une session a coûté 1,60 $, sans qu'aucune défaillance ne soit survenue. Une seule étape a relu un fichier volumineux dans le contexte, ce fichier s'est maintenu dans chaque tour ultérieur, et les tokens d'entrée se sont accumulés pour le reste de l'exécution. Vous identifiez ce problème en triant les sessions par coût et en lisant le nombre de tokens par tour des valeurs aberrantes jusqu'à repérer la rupture. Cela n'apparaît jamais dans une moyenne.
Le point commun à ces trois cas : l'anomalie réside dans la relation entre les étapes. Un outil qui stocke les étapes de manière indépendante élimine l'information exacte dont vous avez besoin.
Ces données peuvent être capturées sans instrumenter le code de votre agent, car l'application des règles et l'observation s'effectuent au même endroit. Chaque appel de modèle et d'outil passe par une passerelle, de sorte que la trajectoire est enregistrée comme un effet secondaire du traitement de la requête — rien n'est reconstruit à partir de journaux dispersés, et aucune désactivation n'est possible.
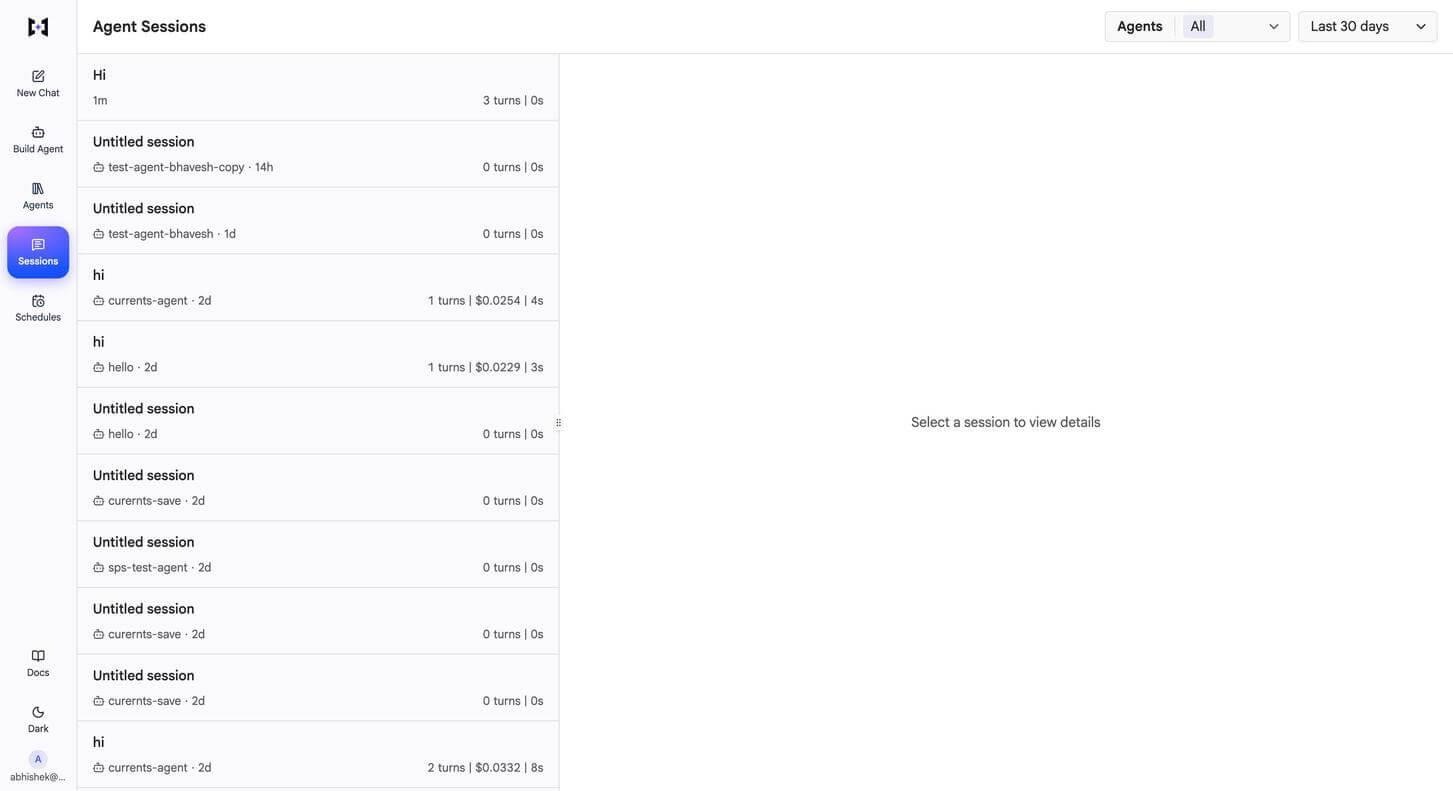
Pour les agents s'exécutant sur l'agent harness de TrueFoundry, l'écran Sessions liste l'ensemble des conversations sur tous les agents — message d'origine, agent, nombre de tours, coût, durée. Cela suffit pour identifier les exécutions coûteuses ou trop longues sans ouvrir chaque détail, ce qui répond exactement au mode de défaillance n° 3.
L'ouverture d'une session fournit l'ensemble des trois éléments requis par la hiérarchie. Les métriques agrégées couvrent les tours, la durée, le coût, les tokens, le contexte, les appels d'outils, les sous-agents et les erreurs. Une chronologie par type d'événement découpe l'exécution en segments système, utilisateur, modèle et appels d'outils pour chaque tour — un tour dominé par la couleur des appels d'outils est limité par l'outil, un tour dominé par la couleur du modèle est limité par le modèle, ce qui est visible d'un coup d'œil plutôt que calculé. En dessous se trouve la transcription, intégrant les tokens, la durée et le coût par tour, ainsi qu'un panneau extensible agent steps listant les appels d'outils dans l'ordre avec leurs résultats.
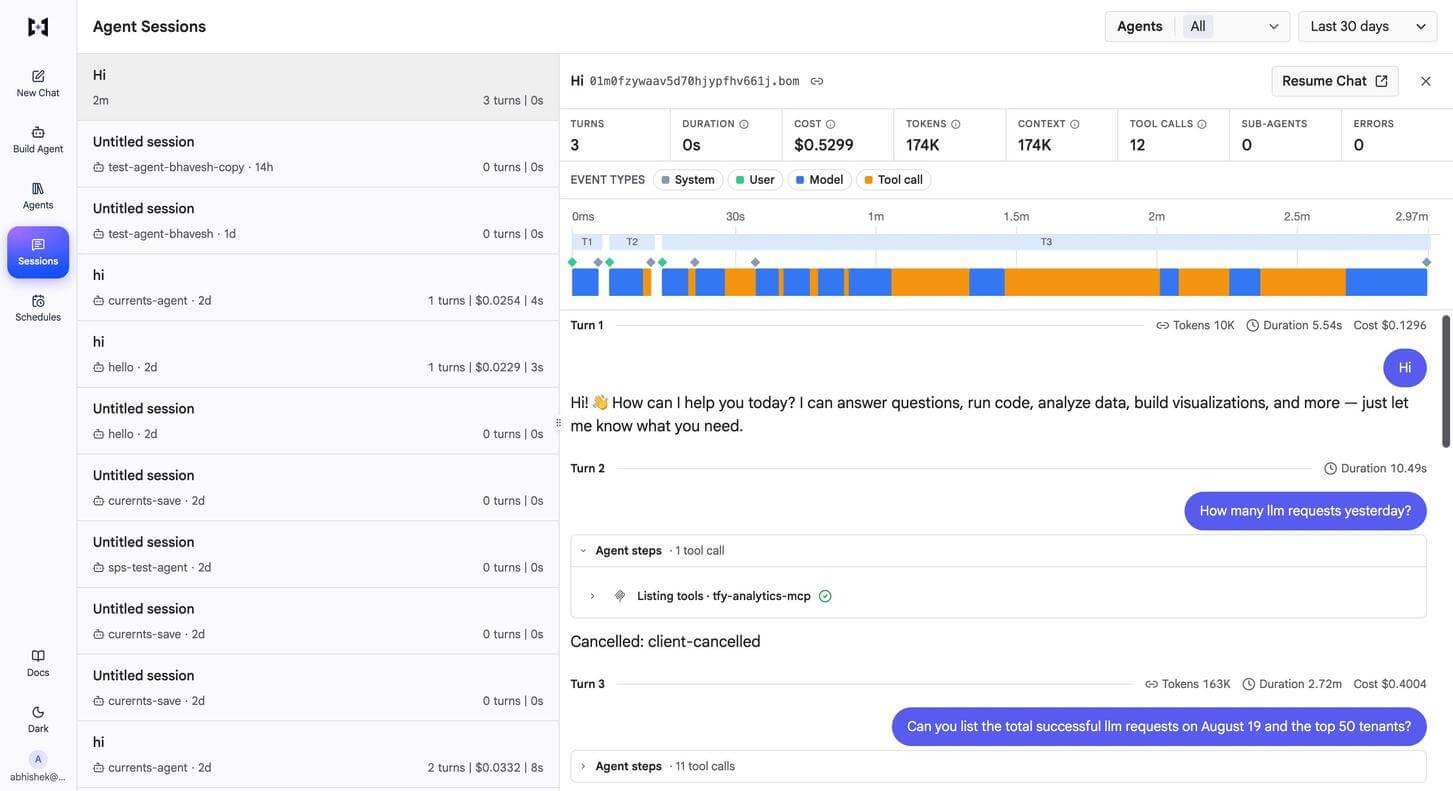
Cette liste d'étapes ordonnée permet d'identifier immédiatement un tour annulé, un serveur MCP en échec ou un résultat d'outil vide. Une session peut être reprise sous forme de chat en direct depuis cette même vue — ce qui permet de valider un correctif.
Un niveau plus bas, une trace constitue une véritable hiérarchie de spans et non un journal plat. Une seule complétion de chat associée à un guardrail PII génère cinq spans : une racine ChatCompletion sans parent, un span Guardrail en dessous, l'appel sortant du guardrail sous ce dernier, un span Model, et l'appel sortant du modèle en dessous de celui-ci.
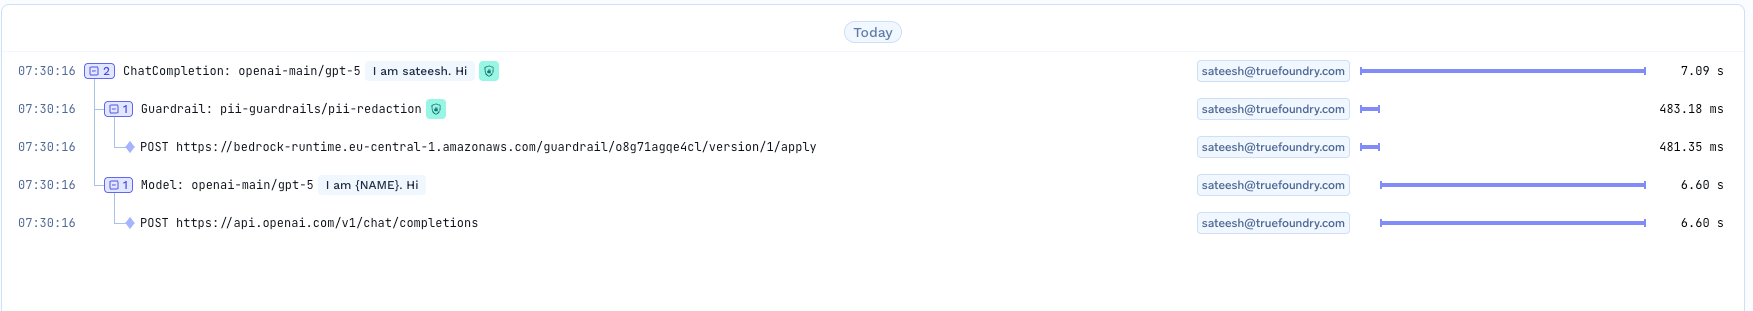
Les attributs de span permettent d'attribuer précisément le coût et la latence plutôt que de les estimer. Le span racine transporte tfy.model.metric.cost_in_usd, input_tokens, output_tokens, latency_in_ms, time_to_first_token_in_ms et inter_token_latency_in_ms, aux côtés de tfy.input, tfy.output et tfy.triggered_guardrail_fqns, et chaque span enregistre le sujet qui l'a créé. Les spans sont interrogables : client.traces.query_spans(...) avec un filtre trace_ids et une fenêtre temporelle renvoie l'ensemble de la hiérarchie de manière paginée — ce qui permet de passer de « cette session était coûteuse » à « ce span était coûteux ».
L'exécution d'un guardrail apparaît comme son propre span avec son résultat, sa latence et ses observations ; les requêtes bloquées sont également tracées — un appel refusé constitue une preuve d'analyse, pas un manque dans les données.
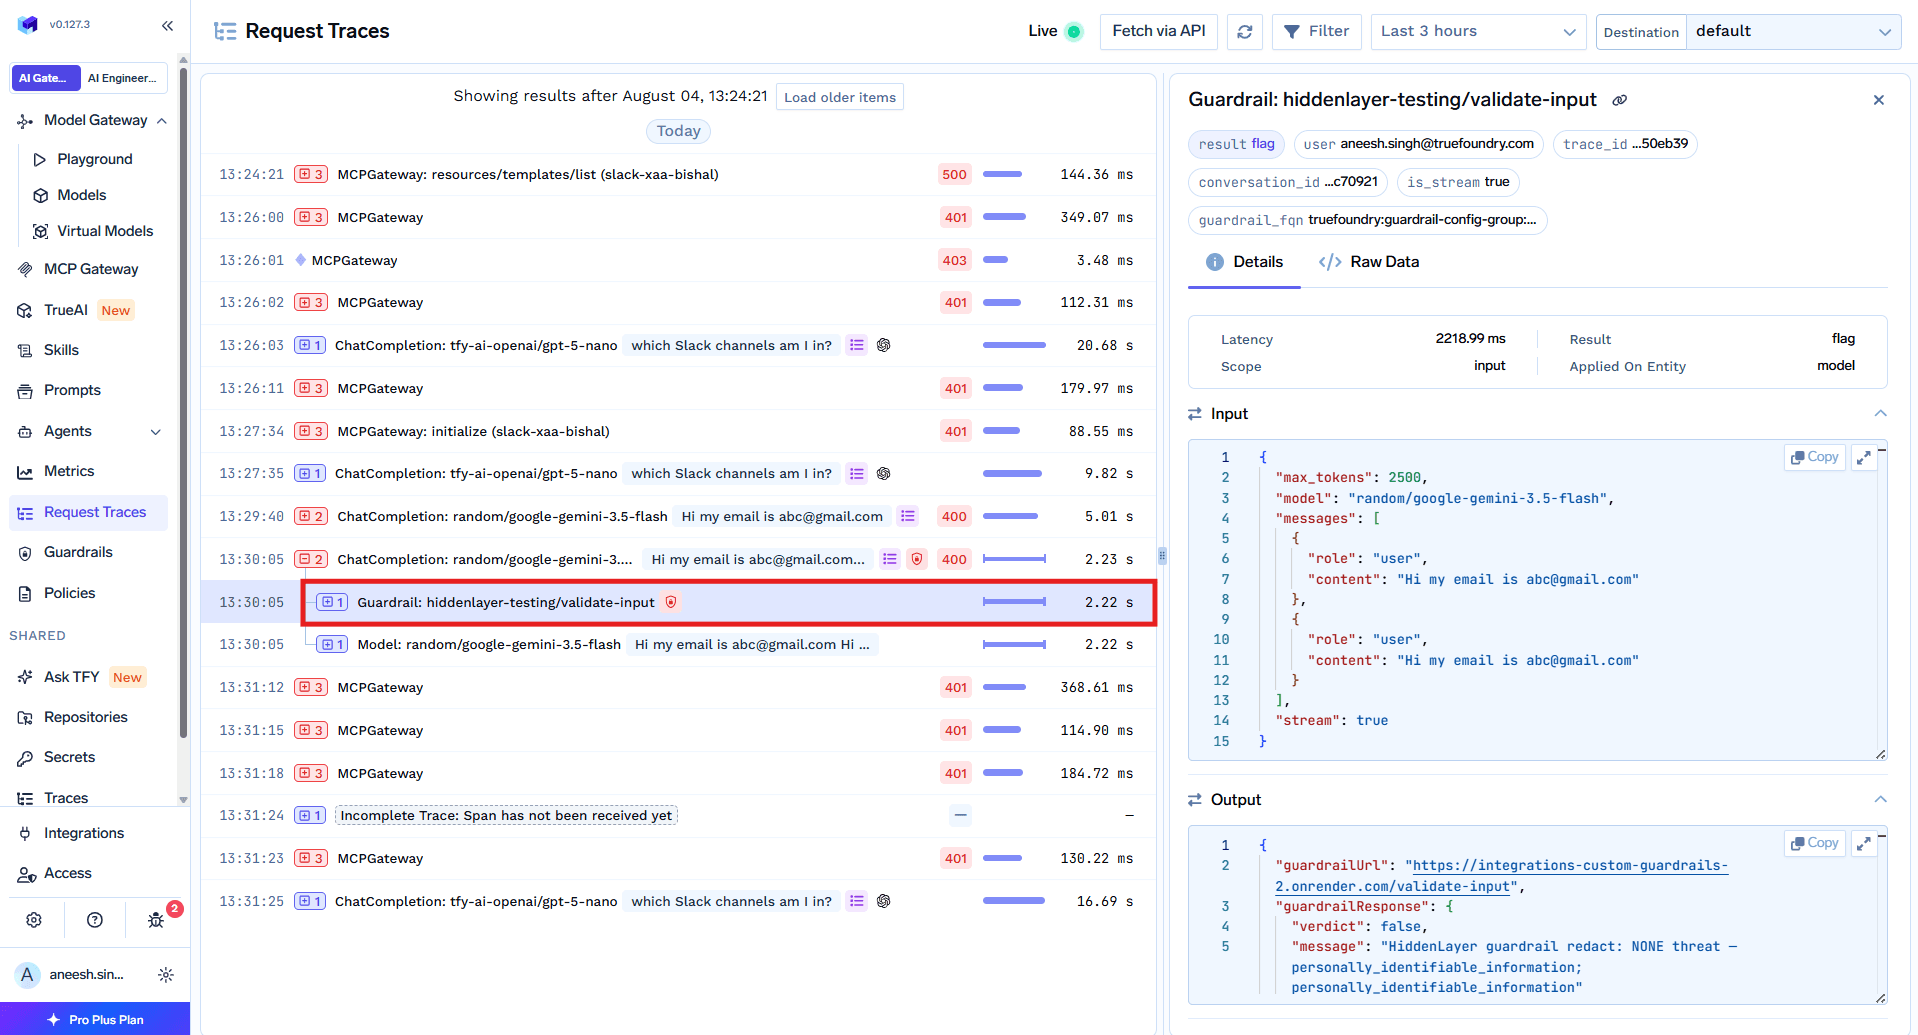
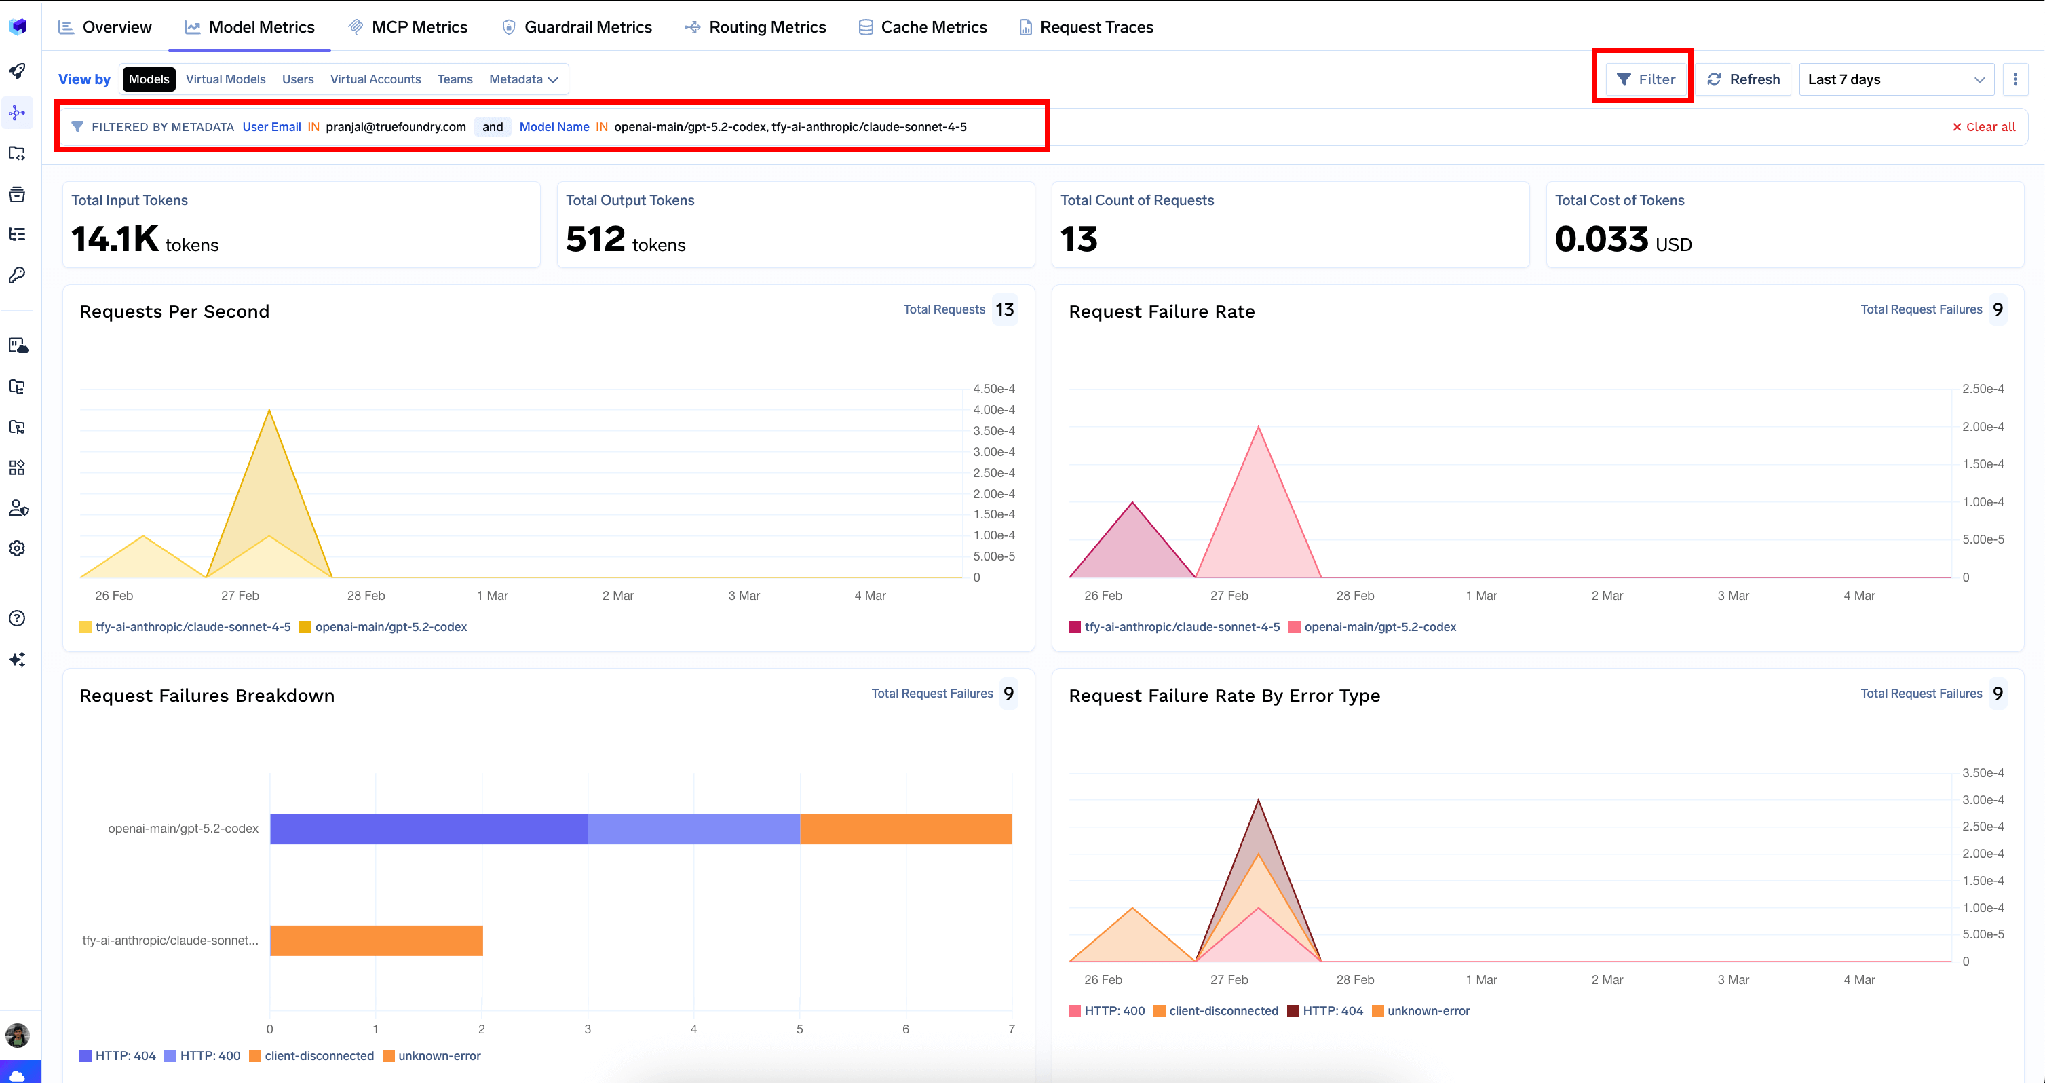
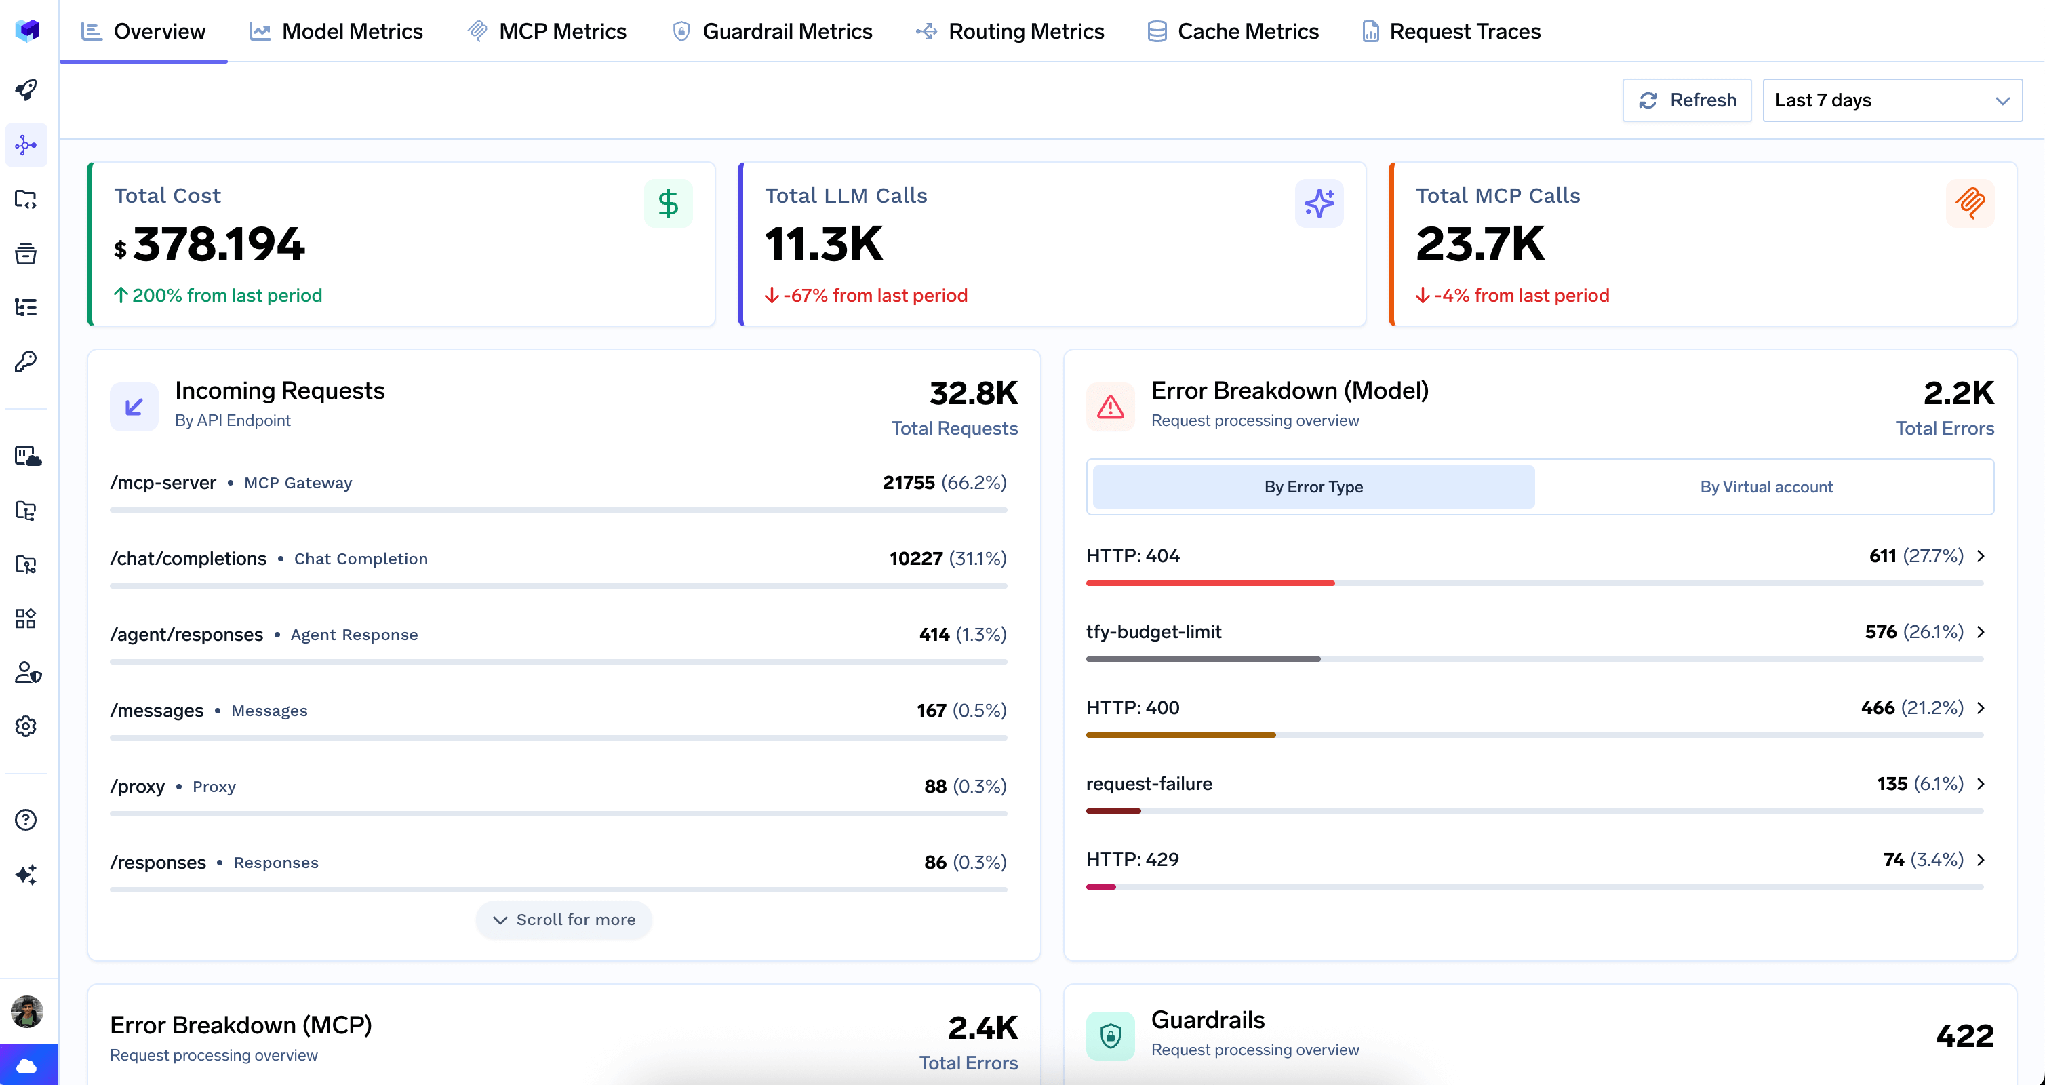
Les données agrégées sont regroupées dans le Metrics Dashboard. La vue Model Metrics présente les tokens d'entrée et de sortie, le nombre de requêtes et le coût total, ainsi que le débit, le taux d'échec et la ventilation des échecs par type d'erreur. La latence est disponible aux centiles P50, P75, P90 et P99 selon quatre mesures — latence de bout en bout, time to first token, latence inter-token, temps par token de sortie — ce qui est essentiel car un premier token lent et un flux de tokens lent découlent de causes différentes.
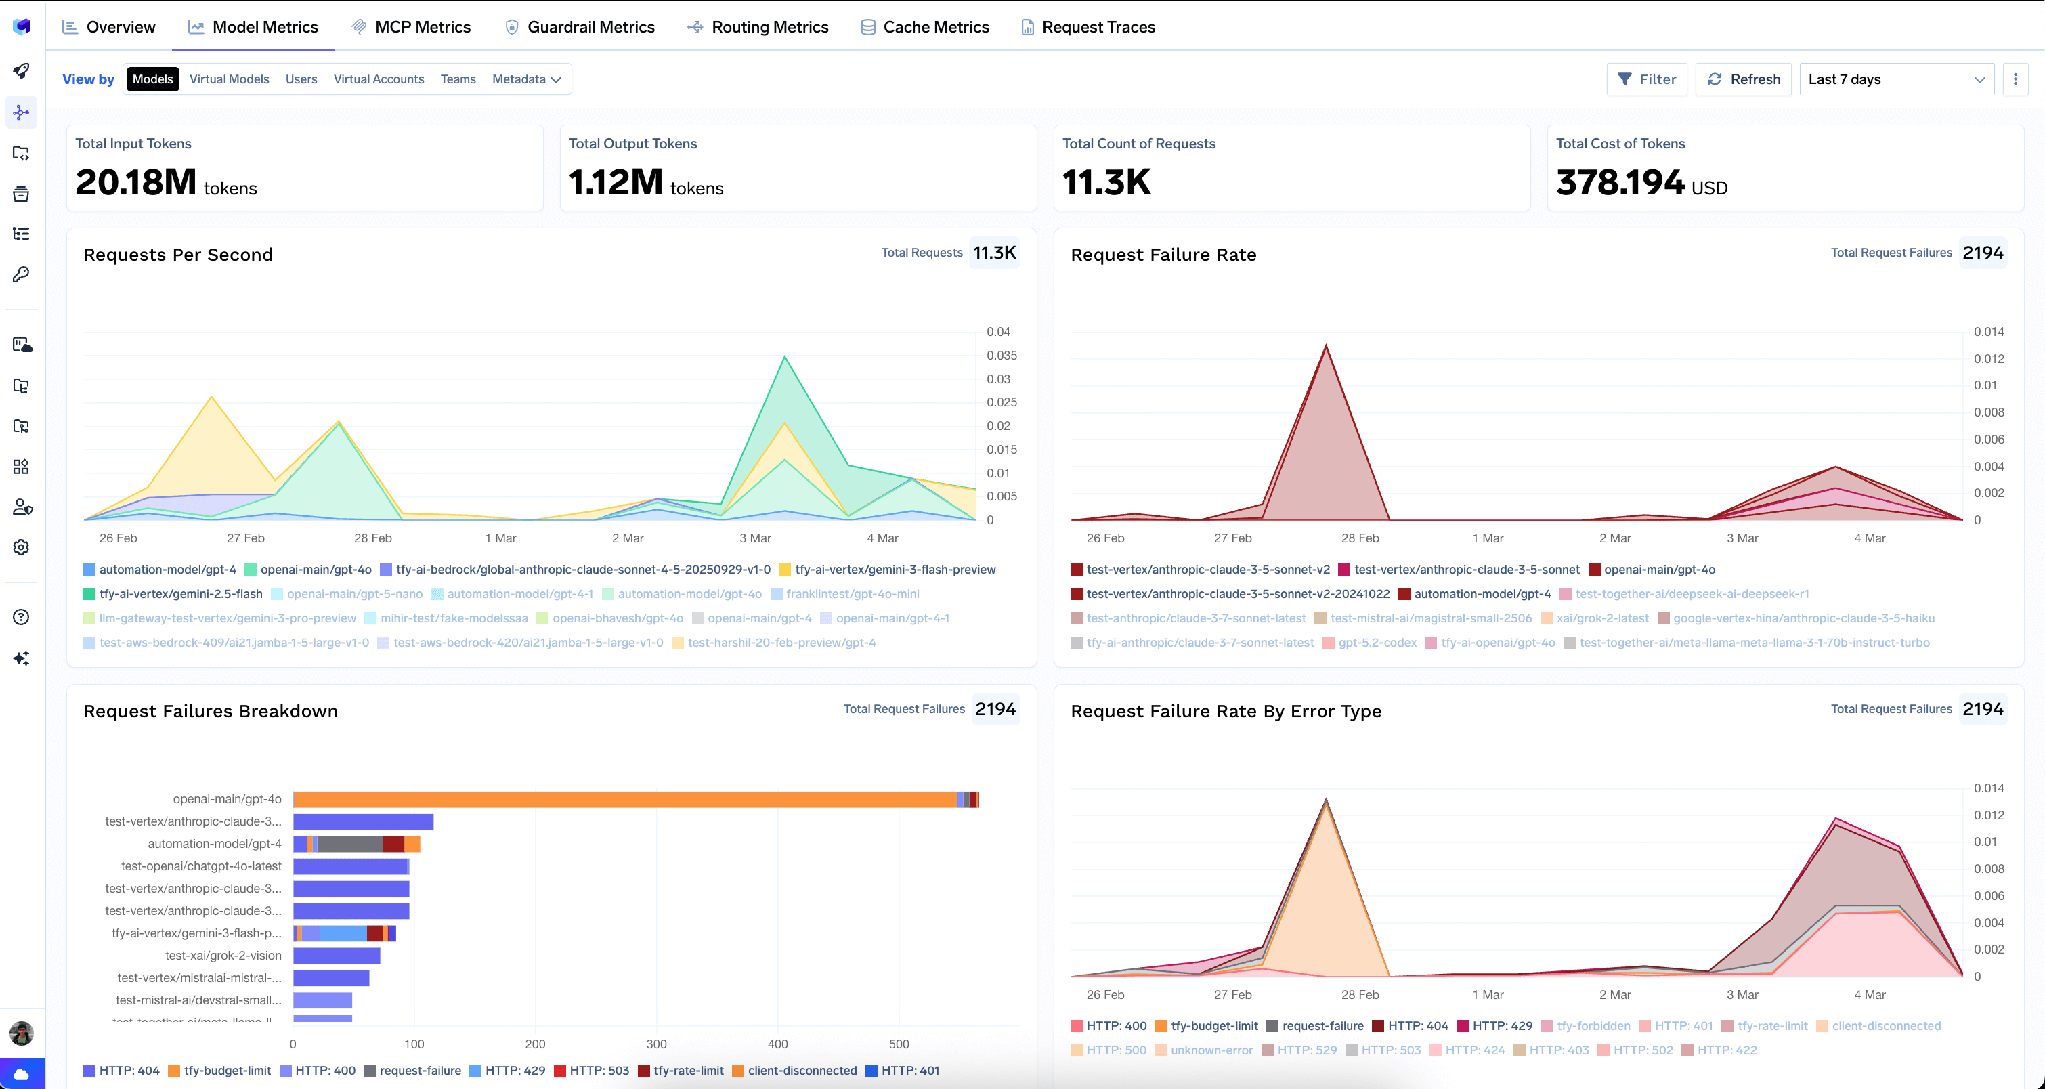
Chaque graphique s'articule autour d'un sélecteur View by — modèles, modèles virtuels, utilisateurs, comptes virtuels, équipes ou clés de métadonnées personnalisées transmises dans les en-têtes de requête. Anticipez la gestion des métadonnées dès le départ : transmettez un nom d'agent ou un ID d'exécution pour obtenir des vues de coût et de latence par agent sans développer d'outils supplémentaires.
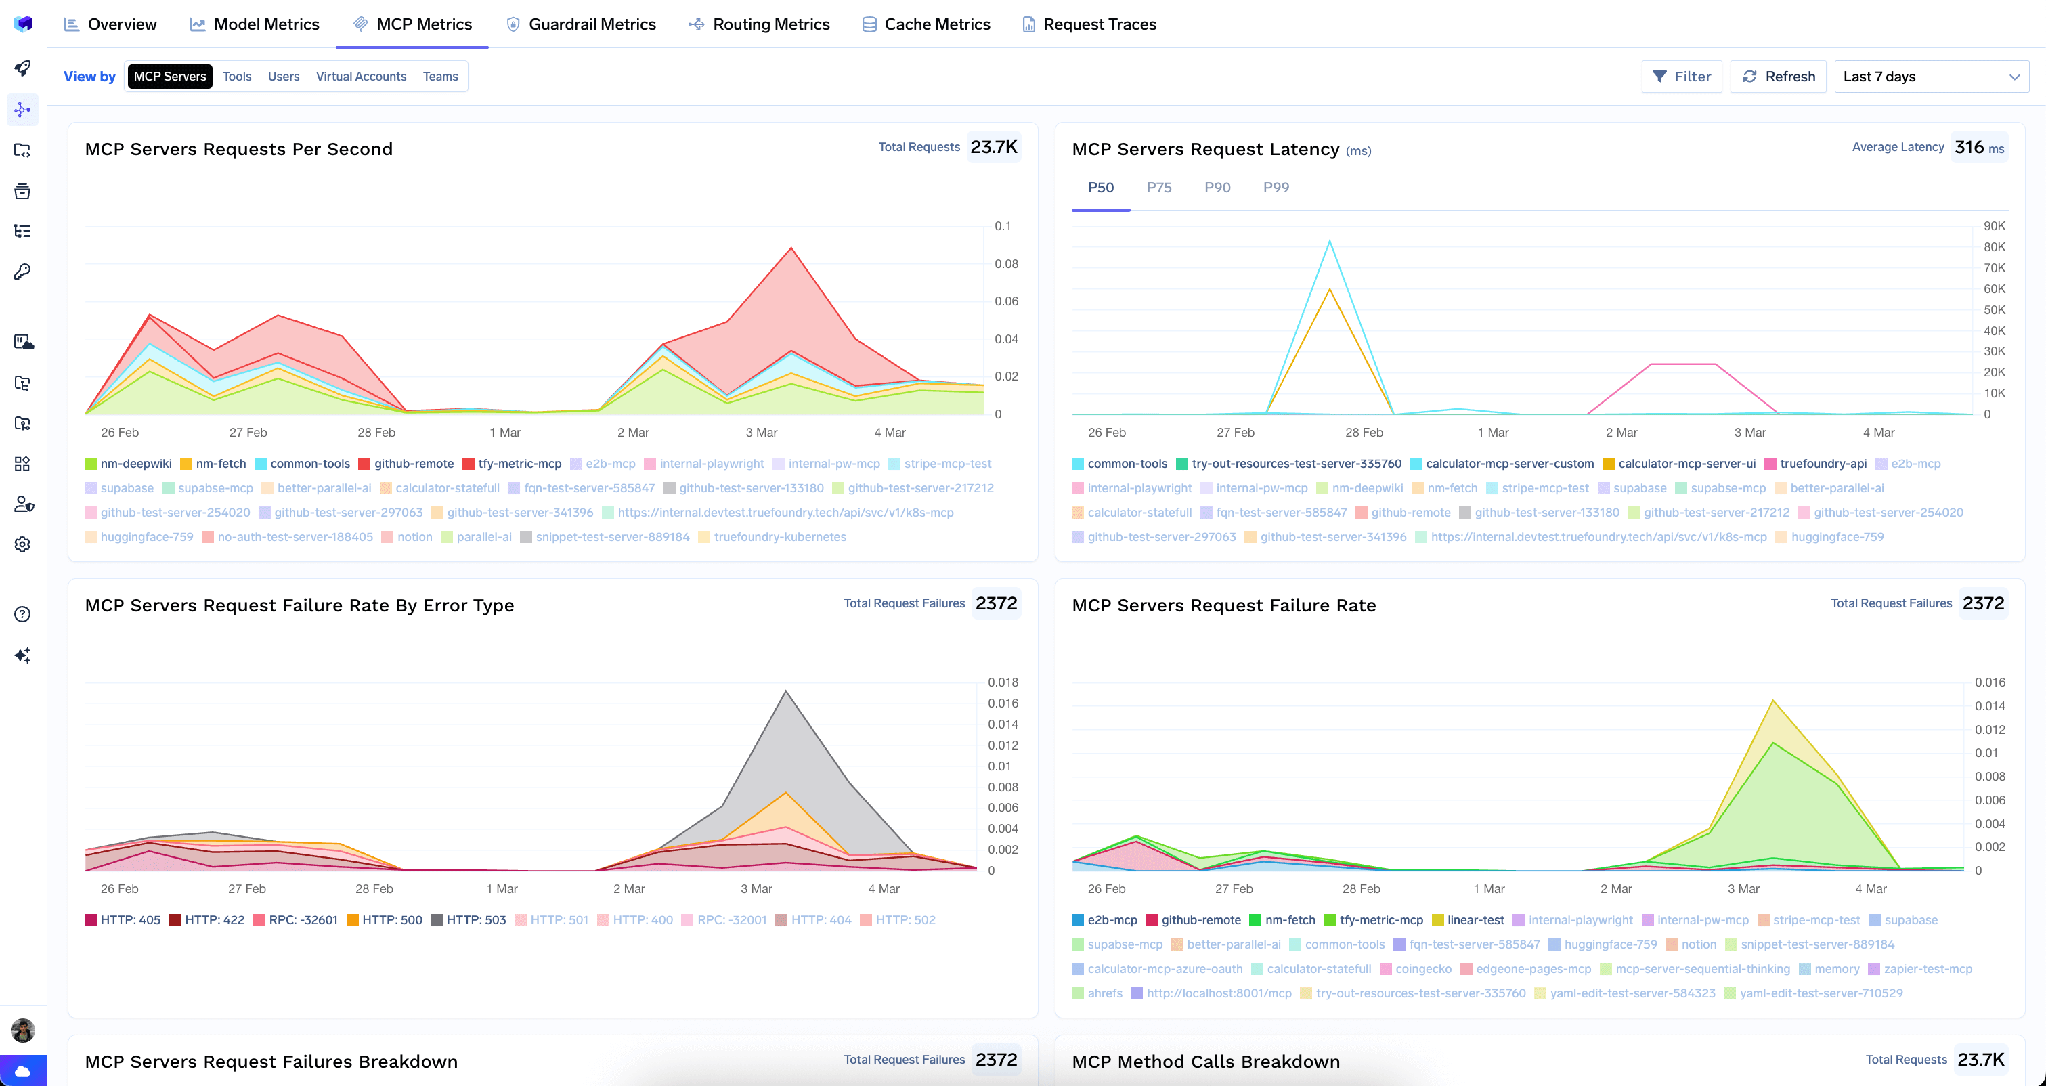
Les appels d'outils bénéficient du même traitement via les métriques MCP — la dimension que négligent la plupart des architectures centrées sur les LLM. La vue des serveurs fournit le débit par serveur, les centiles de latence, le taux d'échec et la ventilation des erreurs, ainsi qu'une ventilation des appels de méthodes entre tools/list, tools/call, resources/list et les autres. Un agent consommant des requêtes sur des appels répétés à tools/list rencontre un problème de découverte, pas un problème d'exécution de tâche.
La vue Tools permet d'analyser chaque outil individuel sur l'ensemble des serveurs : requêtes par seconde, centiles de latence, taux d'échec par type d'erreur, synthèse comparative des latences et classement des outils par volume de requêtes. Ce classement constitue le moyen le plus rapide d'identifier un outil sollicité par l'agent au-delà de vos prévisions.
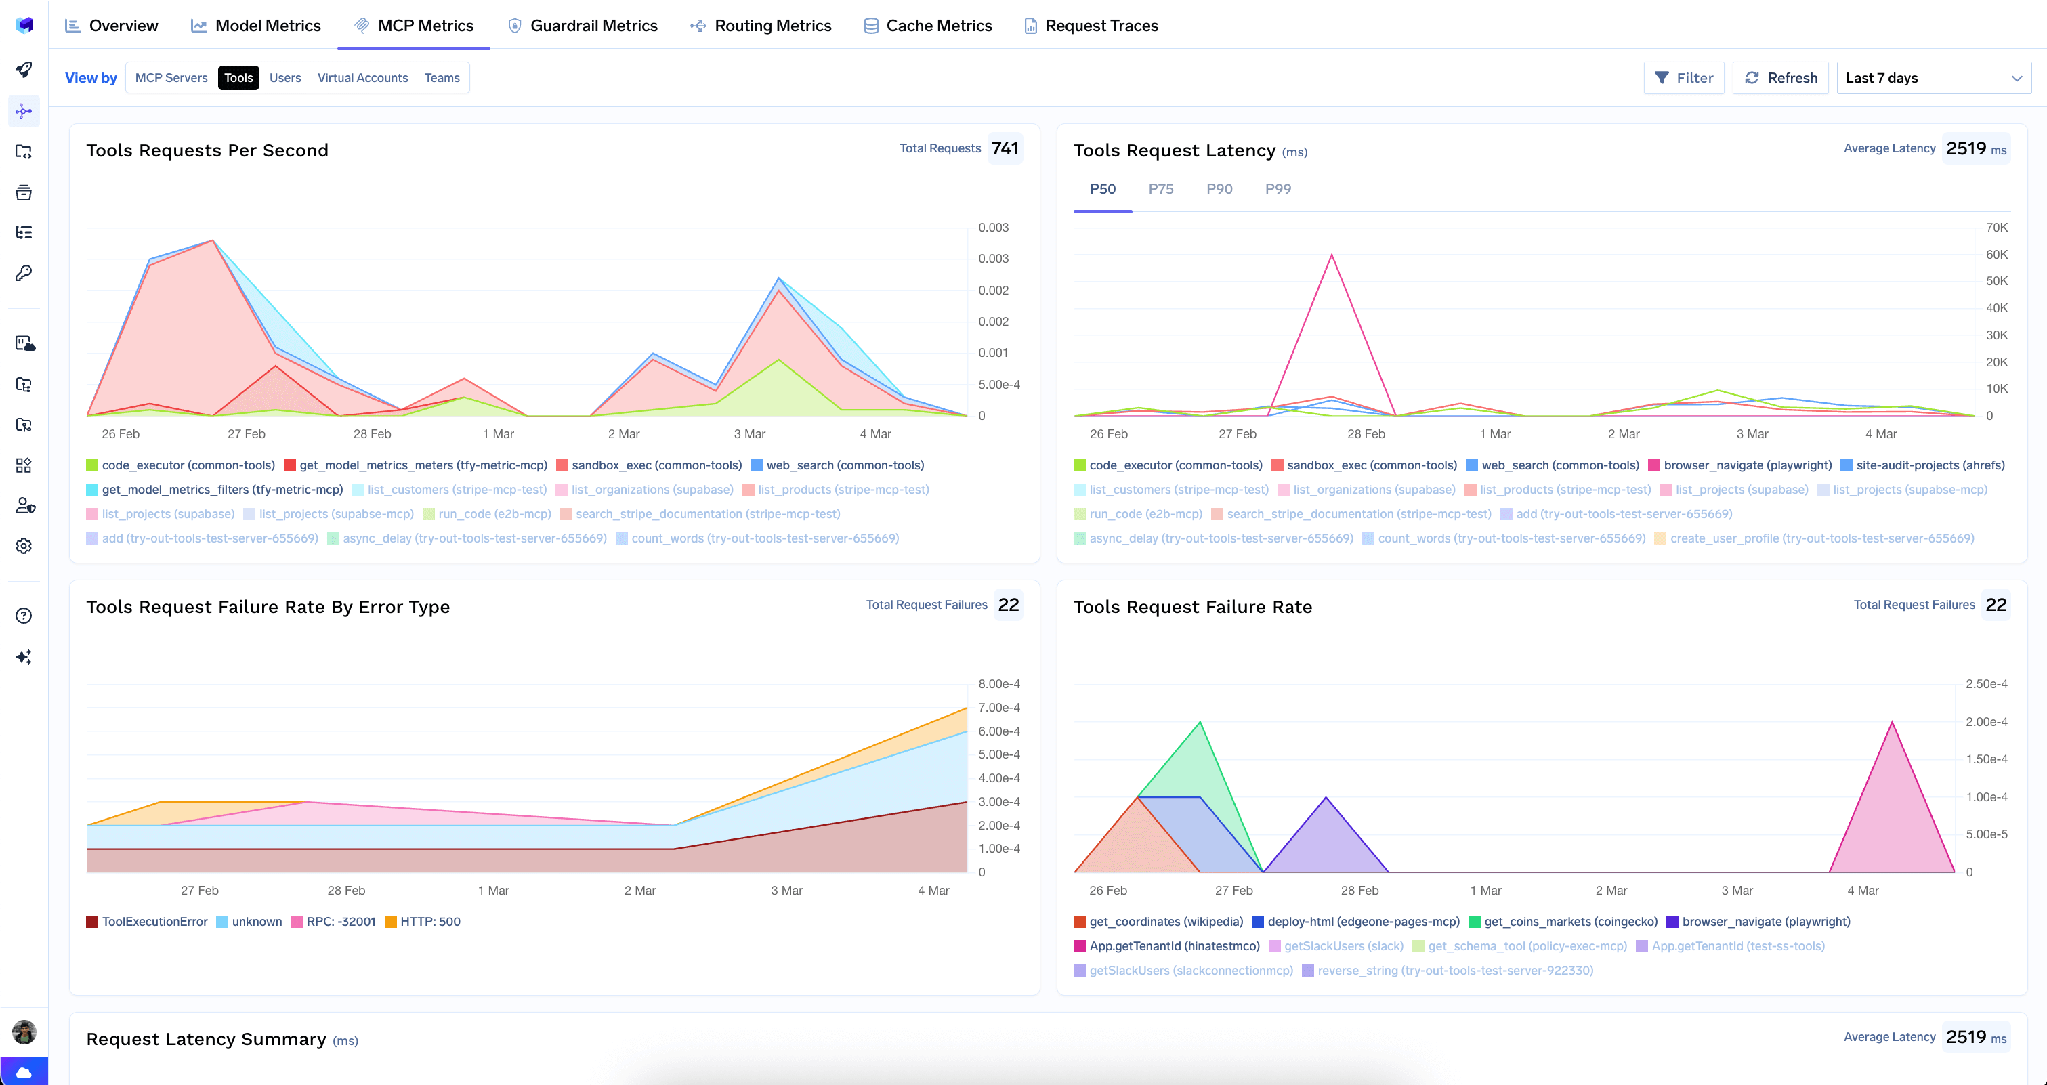
Les filtres se maintiennent d'un onglet à l'autre : ainsi, cibler un utilisateur spécifique dans l'onglet des modèles conserve ce filtre lorsque vous passez à la vue MCP — ce qui vous permet de déterminer si ses sessions lentes découlent d'un problème de modèle ou d'outil sans reconstruire la requête.
Les agents enregistrés disposent d'un tableau de bord unique couvrant le volume de requêtes, les centiles de latence, les taux d'erreur et l'utilisation dans le temps — avec un comportement identique, que l'agent s'exécute sur Bedrock, LangGraph ou un service personnalisé.

Ces mêmes données sont interrogables : l'API de métriques expose une source de données agentMetrics renvoyant des résultats de distribution ou de séries temporelles regroupés par agentName, agentFramework ou agentServerType, avec des agrégations par centiles sur latencyMs. Dans les systèmes multi-agents, Request Traces enregistre quel agent a effectué chaque appel et pour quel utilisateur il a agi — l'attribution qui permet de remonter un appel d'outil d'un sous-agent jusqu'à une personne.
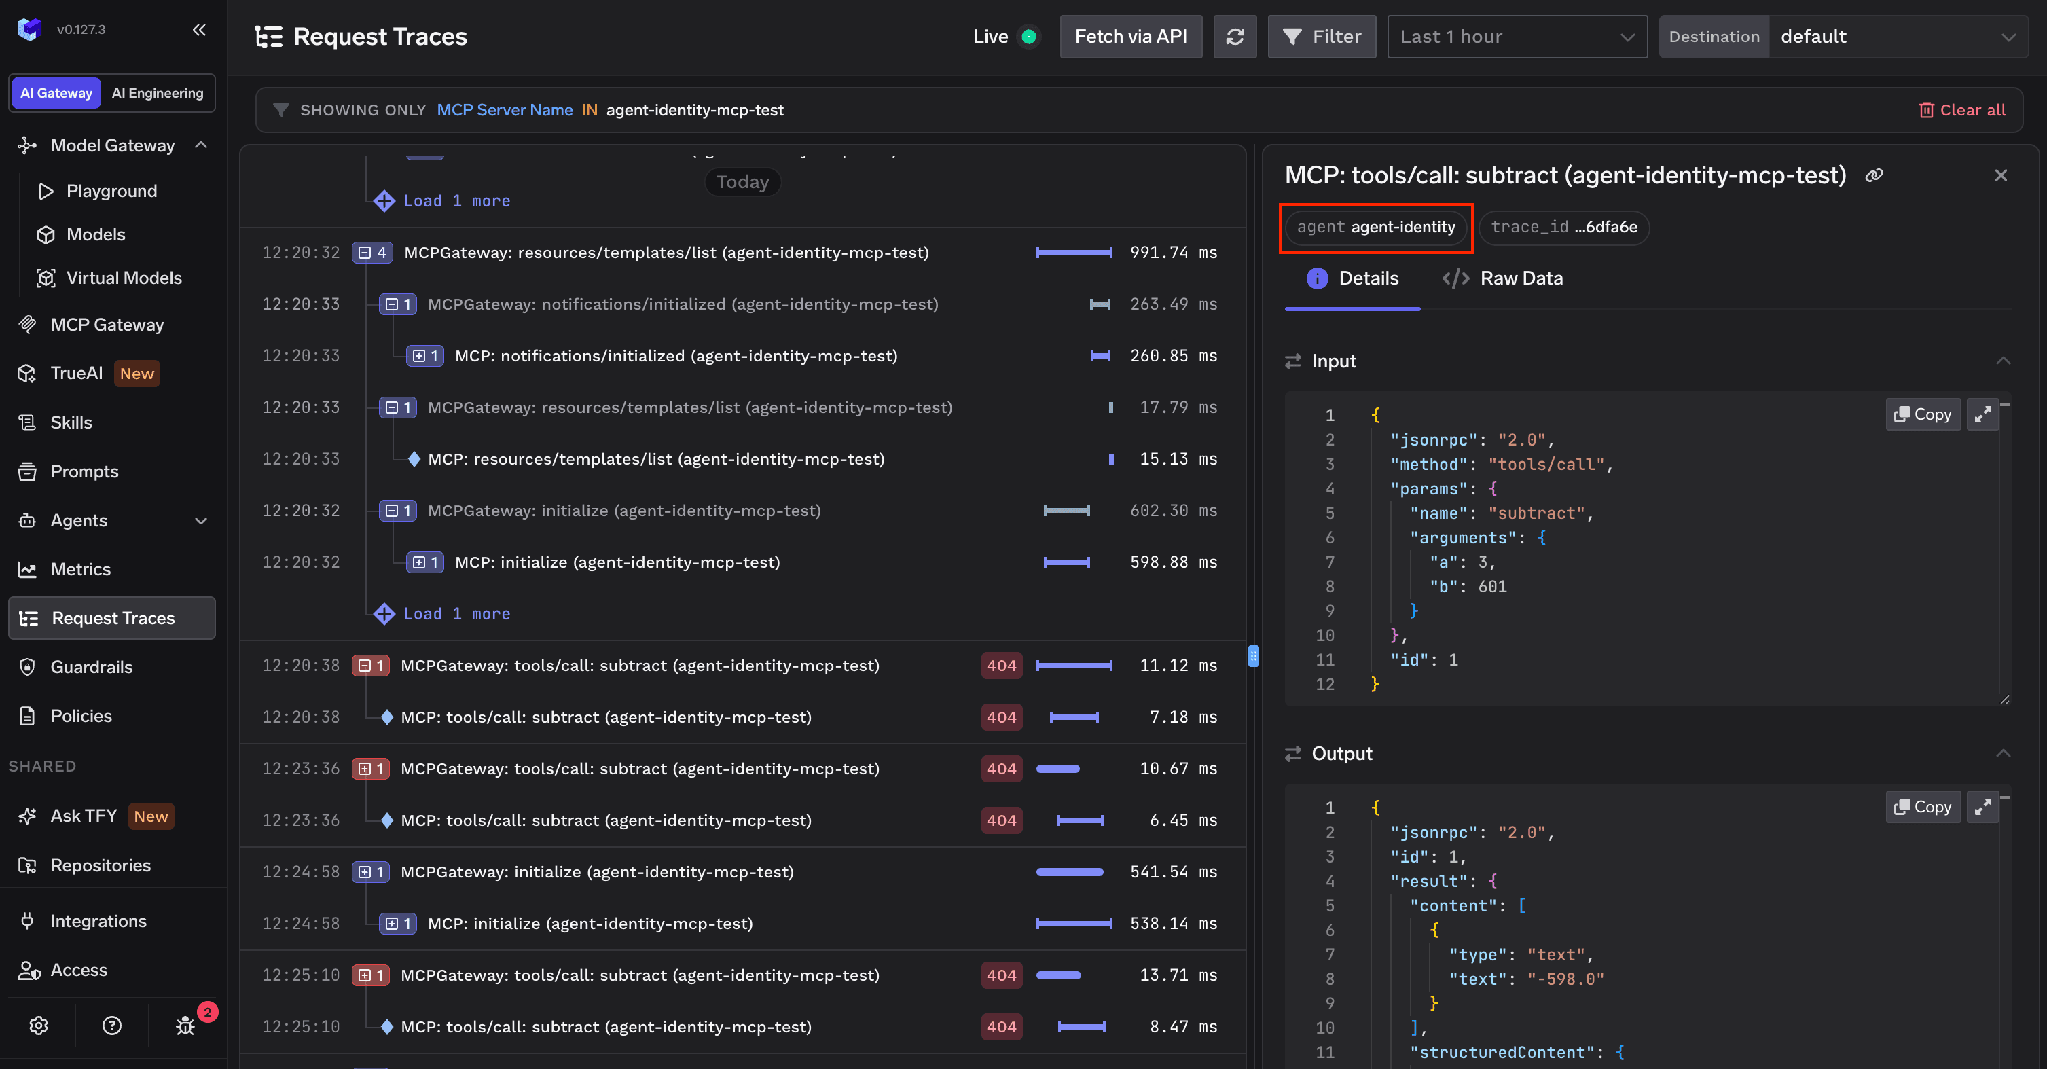
Une limite actuelle : une vue complète de la chaîne d'acteurs restituant la séquence utilisateur → agent → sous-agent → outil dans une seule trace globale sera disponible prochainement, tout comme la détection de dérive, les alertes d'anomalie et la suspension d'agent en un clic. À ce jour, vous bénéficiez de l'attribution par saut sur chaque trace plutôt que de la chaîne représentée sous la forme d'un schéma unique.
La latence et le coût sont mesurables ; la qualité de la réponse ne l'est pas directement, c'est pourquoi le retour d'information doit être rattaché à la trace plutôt que stocké dans une table séparée. Chaque réponse de la passerelle renvoie un en-tête x-tfy-feedback-target-id. Envoyez une requête POST sur /api/svc/v1/gateway-feedback avec une note de 1 à 5 et un commentaire optionnel, et celle-ci apparaîtra à côté du span ainsi que dans les données brutes sous tfyGatewayFeedbacks, modifiable ou supprimable via l'ID renvoyé. L'ID cible s'adresse actuellement au span racine, de sorte que le retour d'information s'applique à la requête globale et non à une sous-étape.
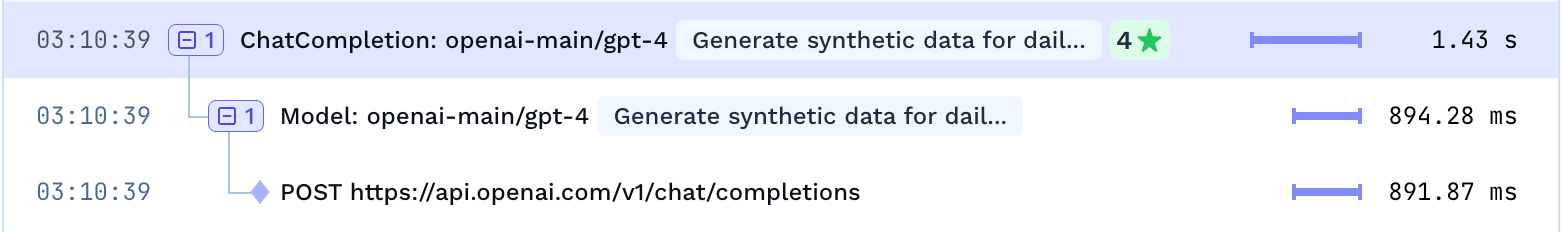
En reliant ce mécanisme à un bouton d'évaluation (pouce vers le haut/bas) dans votre produit, les sessions aberrantes reçoivent un label de qualité, ce qui transforme « cette exécution a coûté 40x » en « cette exécution a coûté 40x et l'utilisateur lui a attribué la note 2 ».
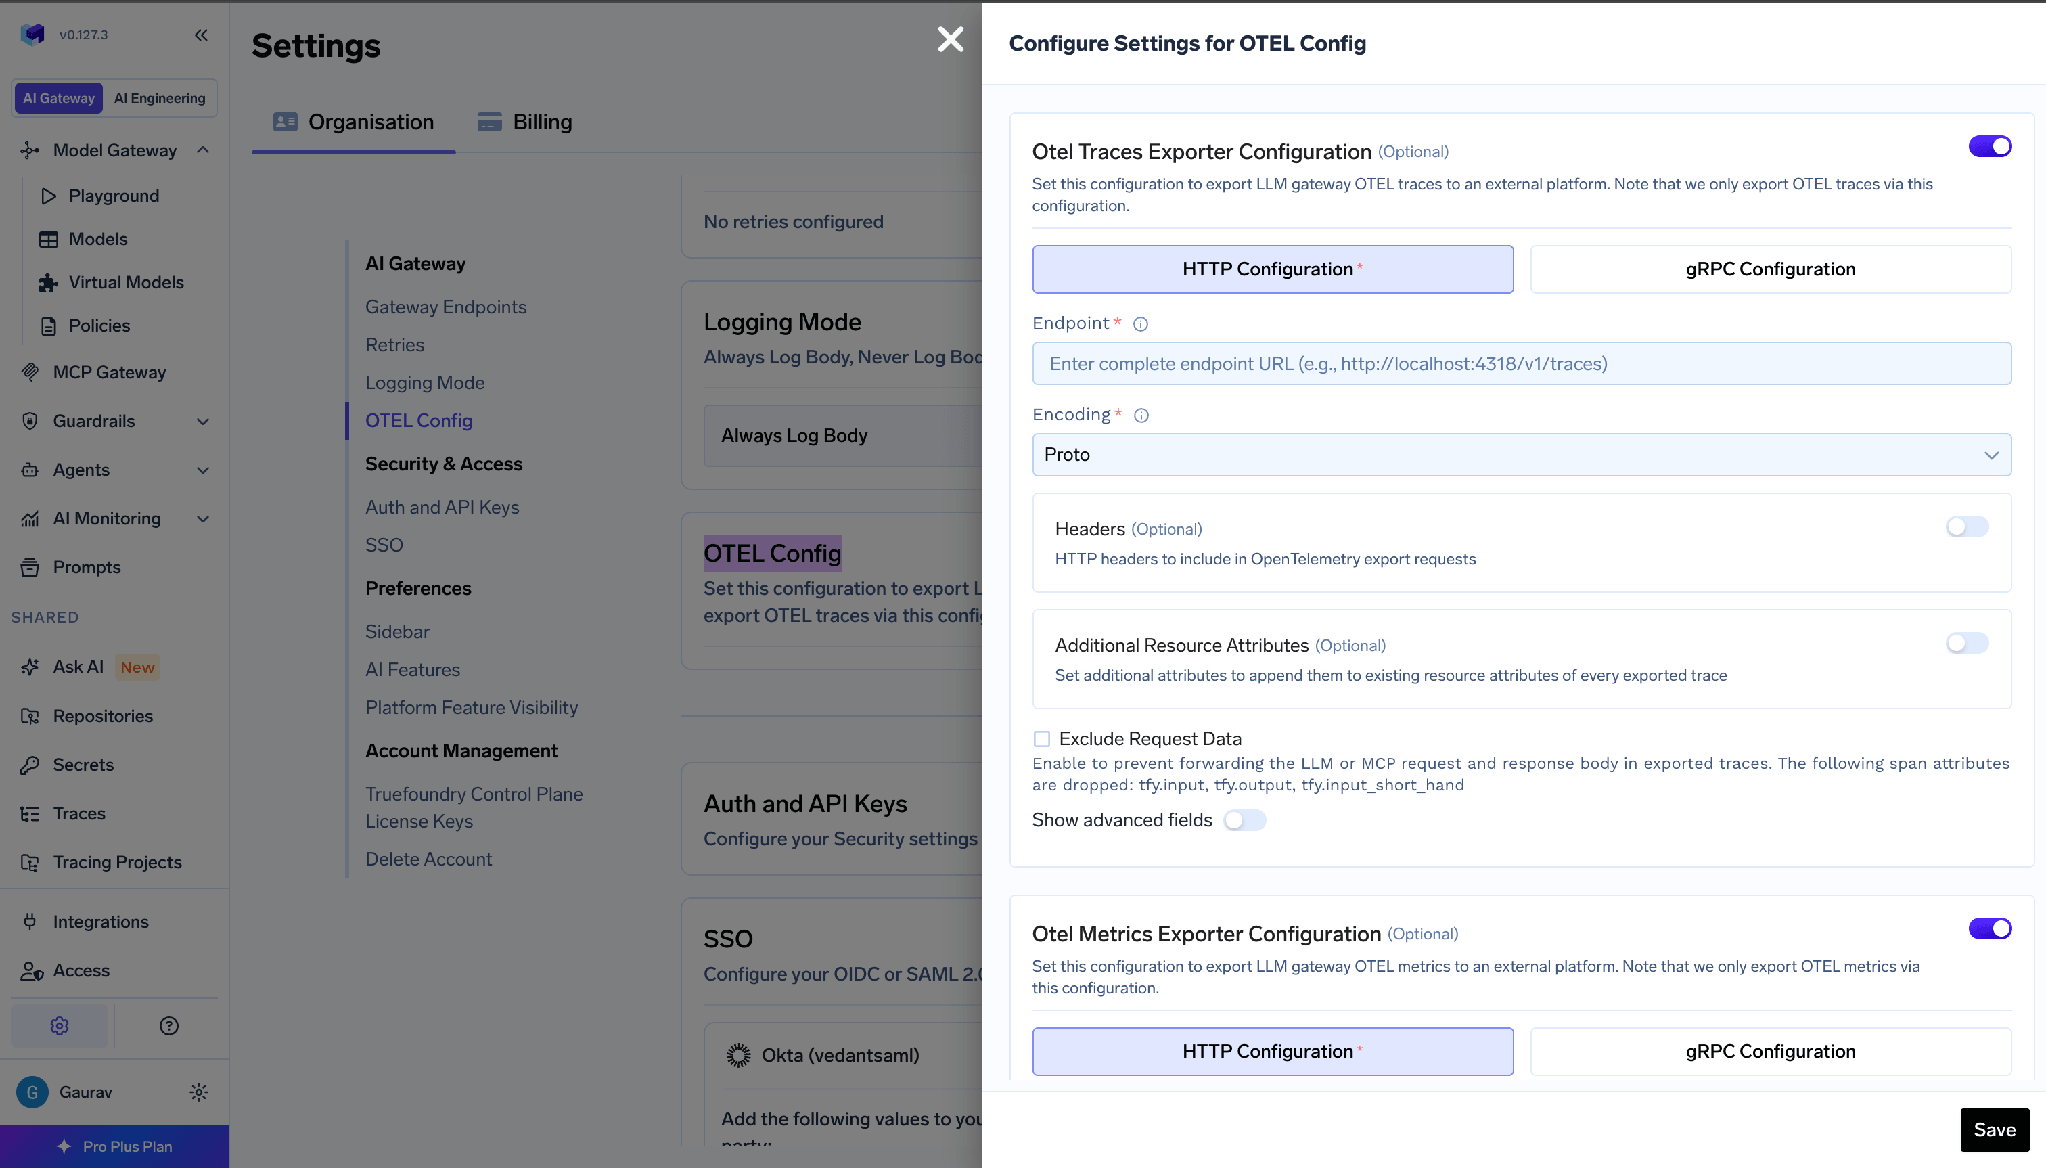
Rien de tout cela ne nécessite d'abandonner votre architecture existante. La passerelle est conforme au standard OpenTelemetry, et les traces comme les métriques s'exportent de manière indépendante — toutes deux se configurent sous AI Gateway → Controls → Settings → OTEL Config, via HTTP ou gRPC, avec un encodage proto ou json et des en-têtes d'authentification personnalisés. Les infrastructures nécessitant des métriques encodées en delta, telles que Datadog ou CloudWatch, utilisent le commutateur Export Delta Metrics ainsi qu'une variable d'environnement de temporalité sur le déploiement de la passerelle. Prometheus peut collecter les données via /metrics sur les passerelles auto-hébergées.
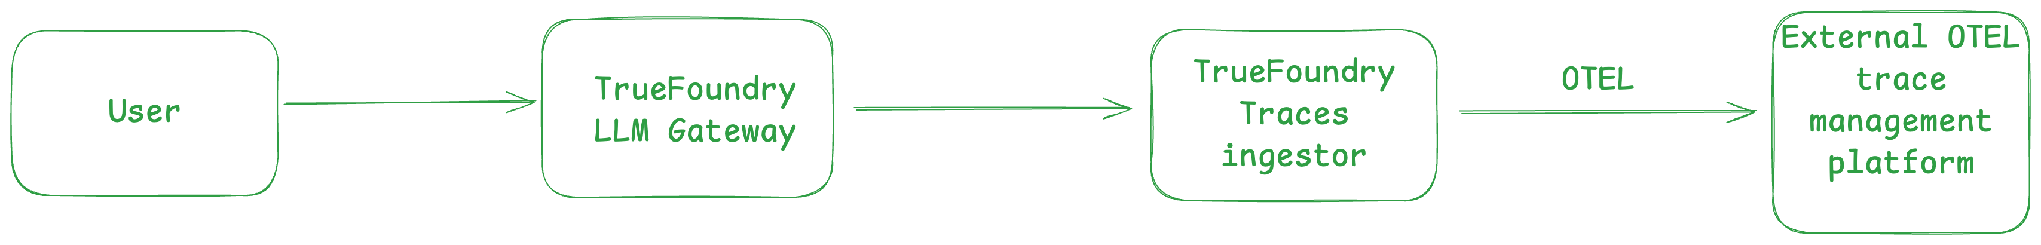
Flux de traces OpenTelemetry : traces stockées par TrueFoundry et exportées vers une infrastructure externe
L'exportation est cumulative et ne constitue pas un transfert exclusif : TrueFoundry continue de stocker les traces dans tous les cas, de sorte que les vues de sessions et de spans restent disponibles dans le produit pendant que Grafana ou Datadog reçoivent les mêmes données.
Un copilot de support client, déployé depuis une semaine en production. Le service financier s'étonne de voir la facture tripler.
Commencez au niveau de la session. Triez par coût. La médiane s'élève à quelques centimes ; quatre sessions dépassent un dollar, toutes avec un nombre de tours inférieur à 10 — il ne s'agit donc pas de longues conversations, mais de tours individuels exécutant trop d'opérations.
Ouvrez une session et analysez la chronologie. Le tour 3 est presque intégralement dominé par la couleur des appels d'outils. Appels d'outils : 31. Erreurs : 0. Aucun échec n'est survenu, ce qui explique pourquoi aucune alerte ne s'est déclenchée.
Développez les étapes de l'agent pour le tour 3. La liste ordonnée montre un outil de récupération de documents appelé de manière répétée, et les tokens par tour augmentent fortement à partir du tour 3 sans redescendre — un document volumineux est entré dans le contexte et y est resté.
Confirmez au niveau de l'outil. Dans les métriques MCP, vue Tools, cet outil se hisse largement en tête du classement par volume de requêtes et présente le P90 le plus dégradé.
Corrigez, puis vérifiez. Que le correctif consiste à restreindre l'outil, ajouter de la pagination ou modifier le prompt pour indiquer à l'agent qu'il possède déjà le fichier, la vérification reste la même : filtrez les sessions sur cet agent pour la journée suivante et vérifiez que la distribution des coûts s'est aplatie. Si vous avez intégré les retours d'information, vérifiez si les valeurs aberrantes correspondaient également aux exécutions mal notées — c'est généralement le cas.
Cinq étapes, aucune instrumentation personnalisée, chacune constituant une question ciblée sur la trajectoire.
Les métriques d'agent incluent par défaut chaque requête de la passerelle. Les lignes qui ne sont pas passées par un agent renvoient une valeur nulle pour agentName, agentFramework et agentServerType, et apparaissent sous forme de blocs nuls dans les résultats de groupBy. L'opérateur IS_NULL n'est pas pris en charge sur ces trois champs ; filtrez donc votre périmètre avec agentName IN [...] ou un opérateur STRING_*.
L'exportation des traces et des métriques se configure séparément. L'exportateur de traces envoie uniquement les traces, l'exportateur de métriques uniquement les métriques. Activer l'un en supposant que l'autre suit automatiquement est une erreur fréquente qui conduit à n'obtenir qu'une vision partielle.
Organisez les métadonnées en amont. Les clés de métadonnées personnalisées transmises dans les en-têtes de requête deviennent une dimension View by sur l'ensemble du tableau de bord. Ajouter un nom d'agent, un environnement ou un ID d'exécution dès le départ ne coûte rien ; essayer de le faire a posteriori empêche de filtrer les données du trimestre précédent selon ces axes.
La tentation en matière de surveillance des agents consiste à greffer un agent sur vos tableaux de bord existants, à surveiller le P99 ainsi que le taux d'erreur, et à considérer que l'observabilité est assurée. Cette approche fonctionne jusqu'au premier incident, moment où vous découvrez que l'exécution qui a épuisé votre budget a renvoyé un code 200 à chaque étape et n'apparaît sur aucun graphique.
La solution ne réside pas dans la multiplication des métriques, mais dans l'adoption d'une unité d'observation adaptée. Enregistrez la trajectoire — session, tour, appel de modèle, appel d'outil, avec leurs arguments et résultats intégrés aux spans — et les trois défaillances réelles deviennent simples à traiter : une boucle se traduit par un appel répété avec des arguments identiques, un mauvais résultat d'outil devient visible parce que vous l'avez conservé, et une exécution 40x est la valeur aberrante que vous isolez immédiatement en tête de classement.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Enregistrer la trajectoire d'exécution complète d'un agent — sessions, tours, appels de modèles et appels d'outils, avec arguments, résultats, tokens, coût et latence — afin de pouvoir expliquer pourquoi il s'est comporté ainsi. Elle diffère de la supervision applicative par l'unité d'observation : une requête a un début et une fin, alors qu'une trajectoire est une séquence imbriquée dans laquelle n'importe quel niveau peut boucler.
L'observabilité des LLM est un sous-ensemble qui couvre l'appel au modèle : prompt, réponse, tokens, latence, coût. L'observabilité des agents ajoute tout ce qui l'entoure — quels outils ont été exécutés, dans quel ordre, avec quels arguments et résultats, et combien de fois un tour a bouclé avant de s'arrêter. La plupart des défaillances réelles se situent dans cette structure, pas dans une réponse isolée.
Pas si le trafic des modèles et des outils passe déjà par une passerelle, puisqu'elle enregistre chaque saut en le traitant. L'instrumentation par SDK au niveau du framework ajoute les étapes de raisonnement internes que la passerelle ne voit jamais : les deux sont donc complémentaires, et non des alternatives.
Oui — en VPC, on-premise, en environnement air-gapped, en hybride ou sur plusieurs clouds, sans qu'aucune donnée ne quitte votre domaine.
Oui. Il comprend une MCP Gateway, une Agent Gateway et un MCP & Agents Registry avec un contrôle d'accès au niveau des outils. Les agents construits avec LangGraph, CrewAI, AutoGen ou un framework maison peuvent tous être gouvernés de manière centralisée.
Oui. La passerelle est compatible OpenTelemetry et s'intègre à Grafana, Datadog, Prometheus, ou à votre pile technologique préférée. Elle trace chaque requête, du prompt à l'exécution de l'outil et du modèle, vous offrant ainsi une journalisation unifiée sans avoir à remplacer ce que vous utilisez déjà.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















