



November 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Oracle Cloud Infrastructure (OCI) adopta un enfoque de computación para AI diferente al de los hyperscalers orientados principalmente a máquinas virtuales (VM). La capa diferenciadora es el bare-metal: los tipos de GPU de OCI (como BM.GPU.H100.8) funcionan sin la sobrecarga de un hipervisor y se conectan mediante NVIDIA ConnectX SmartNICs a través de una red de clústeres personalizada de RDMA over Converged Ethernet (RoCE v2).
Ese techo de rendimiento conlleva ciertas consideraciones operativas a la hora de gestionar infraestructura cloud en bare-metal. Bare-metal significa que usted pasa a ser responsable de la capa que las VM suelen abstraer: los drivers de GPU y el stack OFED, la programación (scheduling) dentro de las restricciones de topología de la red del clúster, la federación de identidades a través de OCI IAM y la elección entre diversas rutas de almacenamiento para los pesos de los modelos. Nada de esto es exótico, pero supone un trabajo sustancial en Kubernetes que no aparece en las ofertas de VM gestionadas.
El rol de TrueFoundry en este stack es el de una capa operativa nativa de Kubernetes. El Compute Plane es su propio clúster de Oracle Cloud Infrastructure Kubernetes Engine (OKE) ejecutándose en bare-metal de OCI. La plataforma empaqueta un conjunto de componentes de código abierto y vinculados a la CNCF (ArgoCD, Argo Workflows, NVIDIA GPU Operator, Prometheus, KEDA, Istio, entre otros) en un despliegue gestionado, añade una UI unificada y un flujo de trabajo GitOps, y proporciona observabilidad en servicios, jobs y utilización de GPU. No sustituye las primitivas de OCI: se sitúa sobre ellas.
Este artículo recorre la arquitectura resultante al ejecutar TrueFoundry en bare-metal de OCI: la separación entre control plane y compute plane, cómo encaja el entrenamiento RDMA en Kubernetes, cómo funciona la identidad de las cargas de trabajo y los patrones prácticos para cargar pesos de modelos a escala.
TrueFoundry utiliza una arquitectura de planos separados (split-plane). El Control Plane (gestionado por TrueFoundry o autoalojado) alberga los metadatos, el RBAC, el servidor de API y el almacén de manifiestos de despliegue. El Compute Plane consiste en uno o más clústeres de Kubernetes en su propio entorno cloud (en este caso, un clúster OKE sobre bare-metal de OCI). Las cargas de trabajo, los pesos de los modelos y los datos del cliente permanecen en su propio arrendamiento (tenancy).
El enlace entre ellos es el tfy-agent, que se ejecuta en el clúster del Compute Plane y abre un WebSocket solo saliente hacia el Control Plane. El agente extrae los manifiestos de despliegue y devuelve las actualizaciones de recursos de Kubernetes. Al ser una conexión saliente, no es necesario abrir puertos entrantes en su VCN ni exponer el servidor de API del clúster a la internet pública.
Cuando TrueFoundry configura un Compute Plane, el agente instala y gestiona un conjunto de complementos de código abierto a través de ArgoCD:
También puede incorporar sus propias instancias de cualquiera de estos elementos: TrueFoundry documenta la configuración necesaria para coexistir con una instalación existente de ArgoCD, Prometheus o Istio.
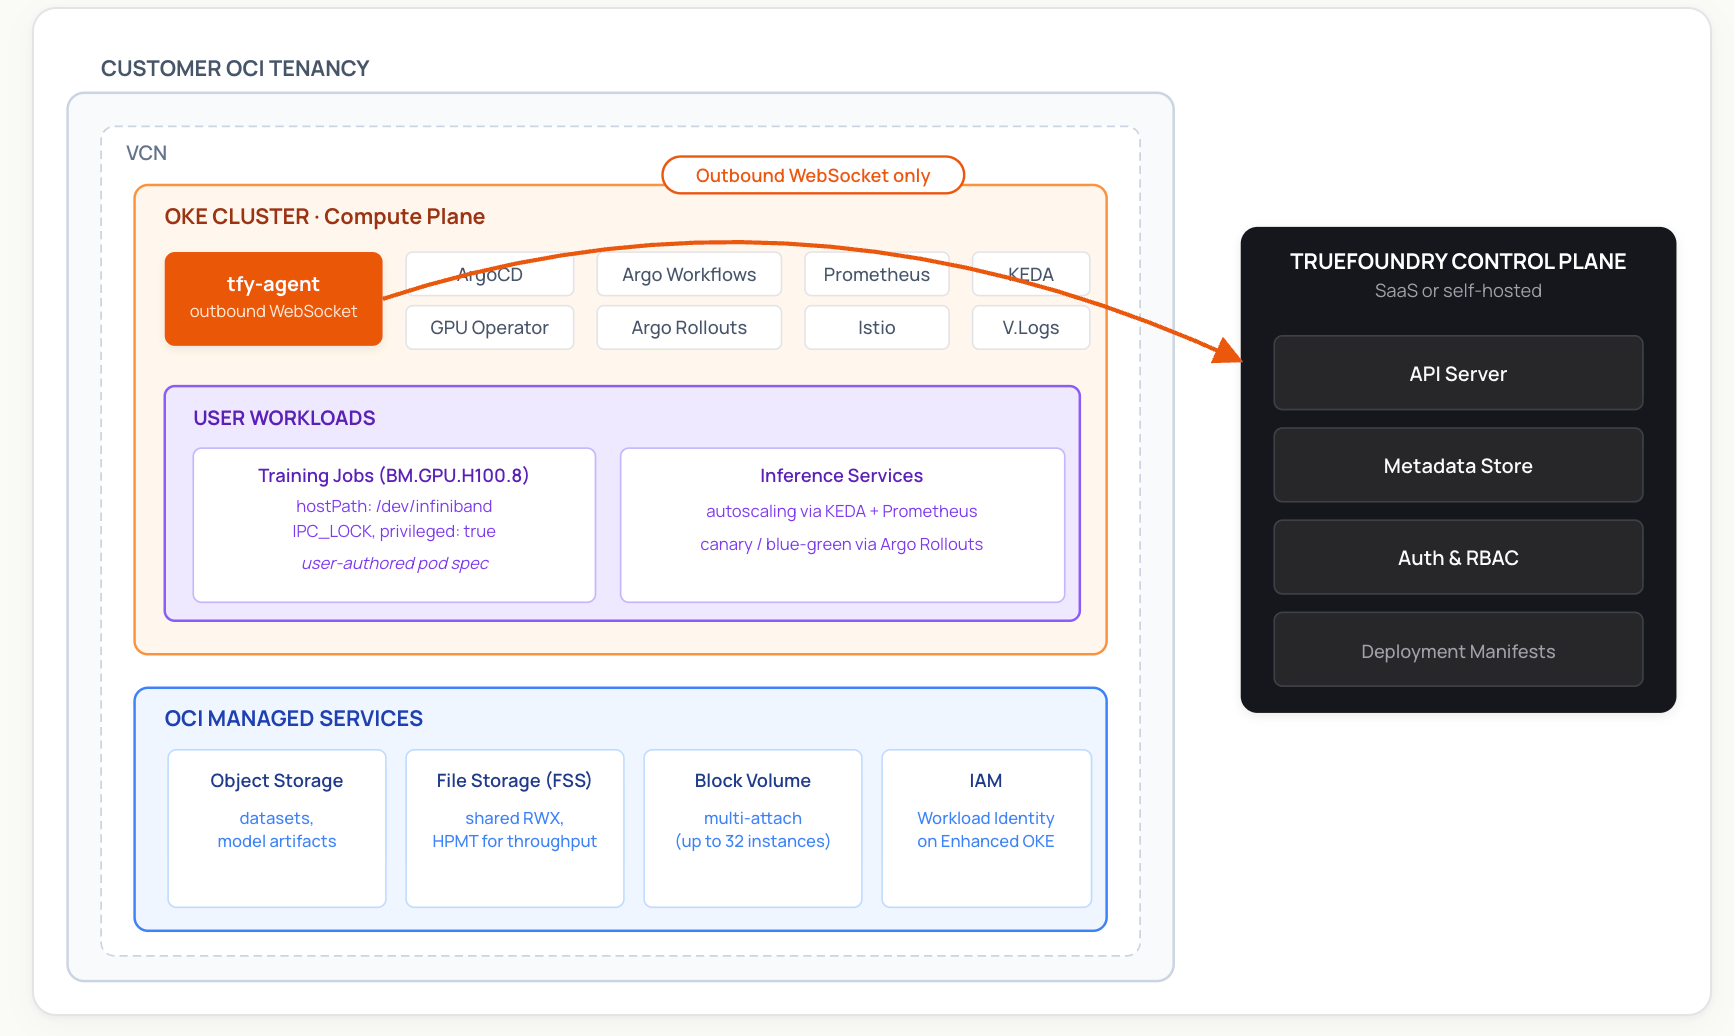
La red de clústeres de OCI es la capa de red diferenciadora que hace viable el entrenamiento distribuido a gran escala. Oracle ha publicado mediciones internas que muestran una latencia de microsegundos de un solo dígito en este fabric: tan baja como 2 microsegundos para clústeres de un solo rack, y típicamente de 2,5 a 9 microsegundos en superclústeres multirack, utilizando RoCE v2 sobre NVIDIA ConnectX SmartNICs. Las cifras reales en producción dependen de la topología del clúster, el tamaño del mensaje y la contención; el artículo de First Principles de Oracle detalla el diseño subyacente.
Para usar RDMA de forma efectiva, deben cumplirse dos condiciones:
oci.oraclecloud.com/rdma.local_block_id, network_block_id y hpc_island_id— y la guía rápida oci-hpc-oke de Oracle muestra cómo utilizarlas con la programación consciente de la topología de Kueue para obtener el mejor rendimiento de NCCL. Para entrenamientos estrechamente acoplados, es preferible coubicar los pods dentro del mismo Local Block./dev/infiniband/ (la nomenclatura de la ruta refleja la API subyacente de IB verbs, aunque el transporte sea RoCE v2 sobre Ethernet).El patrón estándar de pod de la guía rápida de Oracle es el siguiente:
Estos privilegios elevados —privileged: true, IPC_LOCK, red del host— son específicos de las cargas de trabajo HPC/RDMA. En producción, aísle estos pods en namespaces de GPU dedicados con políticas de admisión (por ejemplo, Pod Security Admission configurado en privileged en el namespace y restricted en el resto; o una política OPA/Kyverno filtrando por etiqueta) para que las cargas de trabajo no relacionadas no hereden el mismo contexto.
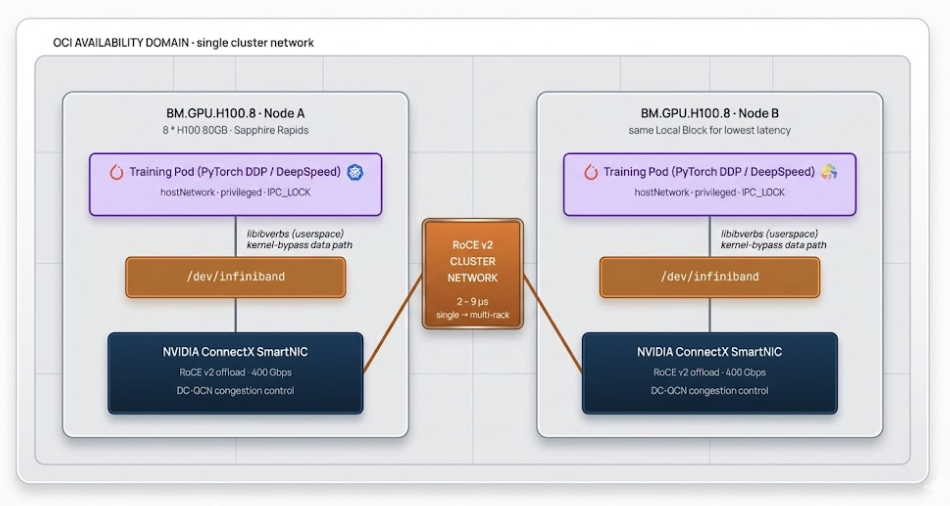
El rol de TrueFoundry aquí es hacer que la ejecución de estos pods de entrenamiento forme parte de un flujo de trabajo de despliegue habitual: usted redacta la carga de trabajo, la plataforma la procesa mediante Argo Workflows, Prometheus recopila métricas de GPU del DCGM Exporter incluido con el GPU Operator y ArgoCD gestiona las versiones de los manifiestos. Las señales a nivel de carga de trabajo, como los contadores de NCCL, solo se recopilan cuando la aplicación las expone. Las piezas específicas de RDMA (montajes hostPath, IPC_LOCK, afinidad de topología) se configuran en la especificación de su job siguiendo el patrón estándar anterior; la plataforma no reemplaza esos campos, despliega lo que usted especifique.
Para el entrenamiento distribuido multinodo en particular, normalmente instalará un operador en el clúster a través de su chart de Helm: MPI Operator para ejecuciones basadas en MPIJob (PyTorch DDP, DeepSpeed, NCCL), Kubeflow Training Operator para PyTorchJob/TFJob, o KubeRay para entrenamiento basado en Ray. TrueFoundry no los incluye por defecto. Una vez instalados, la plataforma despliega recursos MPIJob/PyTorchJob/RayJob como cualquier otra carga de trabajo de Kubernetes, manteniendo la misma integración con GitOps y observabilidad. El entrenamiento distribuido con RDMA en OCI no es una función nativa de primer nivel en TrueFoundry a día de hoy; es un patrón de implementación basado en los manifiestos de referencia publicados por Oracle, donde la plataforma gestiona el stack operativo circundante en lugar de la orquestación específica de RDMA.
Para los tipos de clúster compatibles, Oracle recomienda actualmente OKE Workload Identity en lugar de distribuir claves API de larga duración en los pods. El mecanismo funciona de forma similar a AWS IRSA o GKE Workload Identity: una ServiceAccount de Kubernetes se vincula a una política de OCI IAM, y el SDK de OCI intercambia el token proyectado de la ServiceAccount del pod por un token de acceso de OCI de corta duración en el momento de la llamada. No existen credenciales estáticas dentro del pod.
Dos restricciones importantes según la documentación de Oracle:
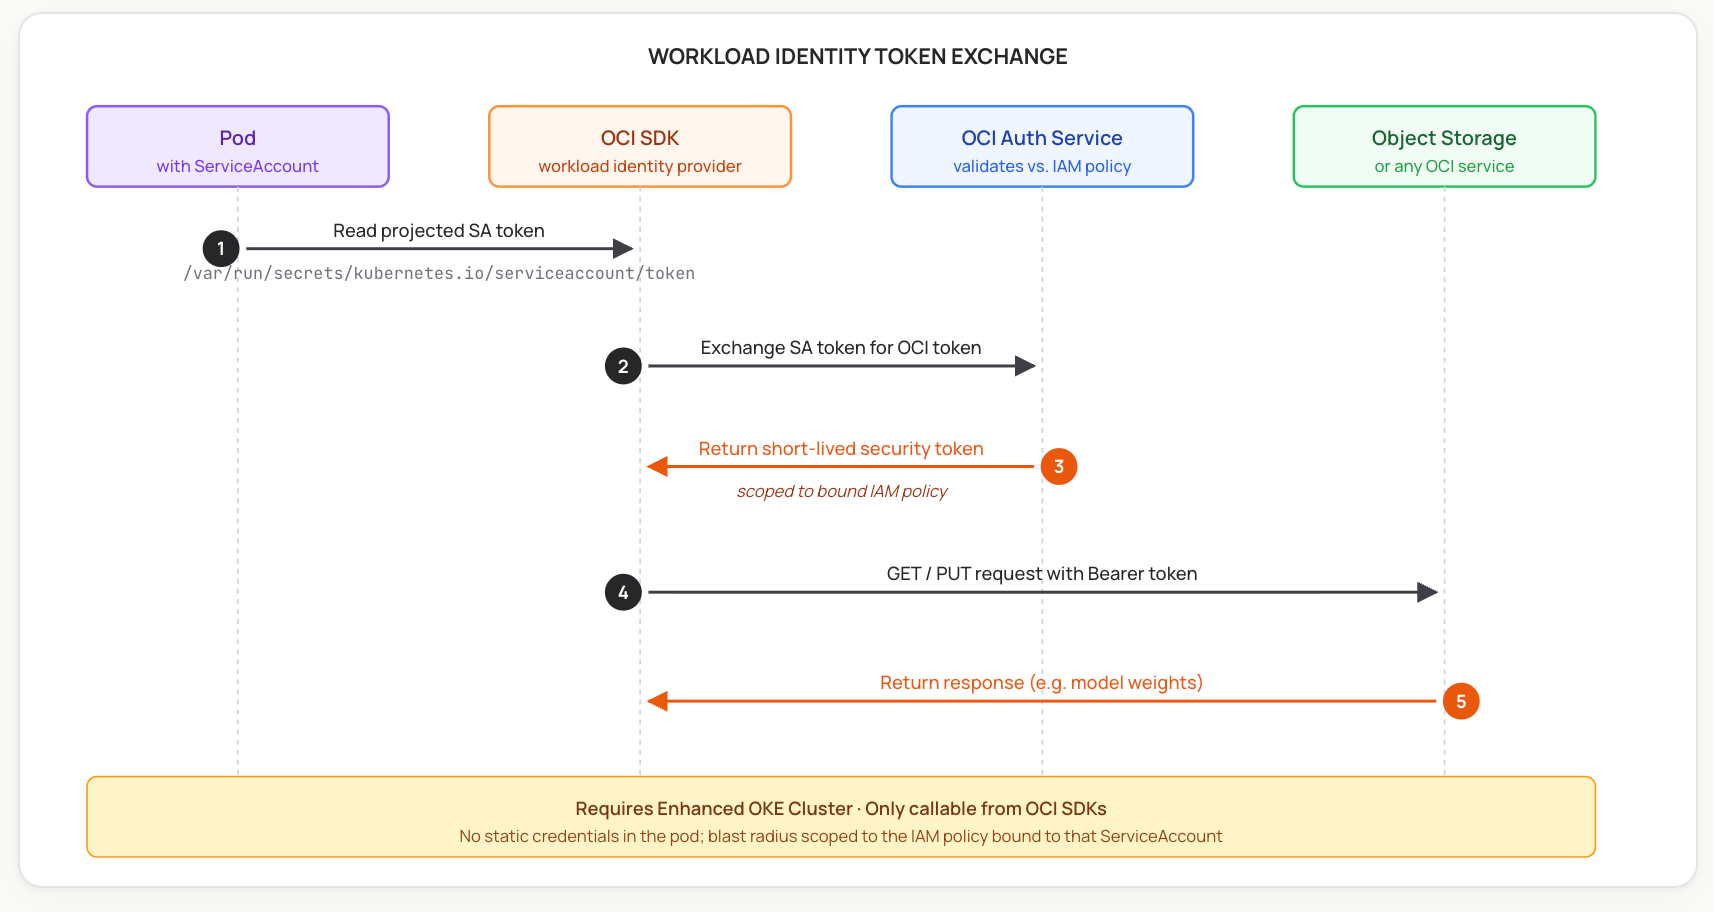
En el lado de Kubernetes, las cargas de trabajo se vinculan a ServiceAccounts circunscritas a un namespace, y la plataforma puede automatizar su creación como parte del flujo de despliegue. El lado de OCI (la política de IAM con la regla request.principal.type='workload' y los selectores de clúster/namespace/serviceaccount) se configura según el procedimiento estándar de Workload Identity de Oracle. Una vez establecidos ambos lados, los despliegues que requieren acceso a OCI obtienen tokens de corta duración de forma transparente mediante el SDK.
OCI bare-metal ofrece varias opciones de almacenamiento para cargar los pesos de los modelos en la VRAM. Cada una presenta sus pros y sus contras, y las abstracciones de volumen de TrueFoundry (PVCs, montajes de volumen, init containers) funcionan con todas ellas: el patrón adecuado depende de su carga de trabajo:
El patrón adecuado varía según la carga de trabajo. Para la mayoría de las ejecuciones de entrenamiento, la combinación de NVMe local (para datos temporales de alto acceso) y FSS (para checkpoints y pesos compartidos) constituye la configuración de producción estándar. Block Volume con acceso múltiple es una opción para casos específicos donde un único artefacto inmutable debe comportarse como un disco local para múltiples lectores.
Ejecutar cargas de trabajo de GPU en bare-metal directamente sobre las primitivas de OCI es factible —Oracle ofrece un stack HPC basado en Terraform y la guía rápida oci-hpc-oke—, pero implica asumir la gestión de una capa operativa sustancial en Kubernetes. La siguiente tabla describe lo que aporta TrueFoundry.
El patrón se mantiene constante: OCI proporciona la computación bare-metal y las primitivas de red; TrueFoundry aporta la capa operativa de Kubernetes sobre ellas.
TrueFoundry en OCI es una plataforma nativa de Kubernetes que se ejecuta sobre el stack bare-metal de Oracle. El Compute Plane es su clúster OKE, las cargas de trabajo utilizan la red de clústeres RoCE v2 y Workload Identity de OCI mediante patrones estándar de Kubernetes, y la plataforma empaqueta la capa operativa de código abierto y vinculada a la CNCF (GitOps, observabilidad, autoescalado, GPU operator) en un despliegue gestionado. El resultado es una menor sobrecarga de ingeniería de plataforma para operar cargas de trabajo de GPU en bare-metal, manteniendo la configuración específica de OCI de forma transparente en lugar de oculta.
Una ruta práctica para su evaluación consiste en realizar un despliegue de referencia en un clúster OKE pequeño (normalmente una o dos formas BM.GPU más un pool de CPU para los complementos de la plataforma) con el fin de validar la arquitectura antes de escalar a un Supercluster completo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















