



November 14, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Cuando Moonshot AI lanzó Kimi K2 en código abierto, la comunidad de IA tomó nota. Cuando continuaron con Kimi K2 Thinking, un modelo capaz de razonar a través de cientos de llamadas a herramientas con una coherencia notable, los profesionales comenzaron a prestar seria atención. Ahora, con Kimi K2.6, Moonshot ha ido todavía más lejos: un modelo de código abierto de vanguardia que se sitúa en lo más alto de los benchmarks de programación y de agentes a largo plazo, rivalizando con las mejores ofertas de código cerrado del mundo.
Este artículo es un análisis profundo de lo que hace notable a K2.6, qué significan realmente las cifras de los benchmarks para las cargas de trabajo reales y cómo puedes ponerlo a trabajar sin un proyecto de despliegue de seis semanas.
Kimi K2.6 es el modelo multimodal de nueva generación de Moonshot AI, disponible en Hugging Face y a través de la Kimi API. Al igual que sus predecesores, está construido sobre una arquitectura Mixture-of-Experts (MoE) con una ventana de contexto de 262.144 tokens. Pero K2.6 es más que una mejora incremental: representa un cambio de diseño significativo hacia tres aspectos que la generación anterior gestionaba de forma inconsistente: programación a largo plazo, diseño impulsado por código y coordinación de enjambres de agentes (agent swarms).
Aquí tienes una rápida ilustración de lo que significa "a largo plazo" en la práctica. En una demostración de benchmark, K2.6 desplegó de forma autónoma un modelo Qwen3.5-0.8B localmente en un Mac, implementó la inferencia en Zig (un lenguaje de programación de sistemas de nicho) y, a lo largo de más de 4.000 llamadas a herramientas y más de 12 horas de ejecución continua, mejoró el rendimiento de ~15 a ~193 tokens por segundo (aproximadamente un 20 % más rápido que LM Studio). Eso no es un chatbot respondiendo a una pregunta; es una IA actuando como un ingeniero de rendimiento senior durante un encargo sostenido.
En una demostración independiente, K2.6 revisó a fondo un motor de emparejamiento financiero de código abierto con 8 años de antigüedad durante una sesión de 13 horas, realizando más de 1.000 cambios de código orientados para lograr una mejora del rendimiento medio del 185 % y una ganancia del rendimiento pico del 133 % — sin ninguna orientación humana tras la especificación inicial de la tarea.
Las cifras importan, pero el contexto importa aún más. Así es como se comporta K2.6 en los benchmarks que más importan para los sistemas de agentes en producción:
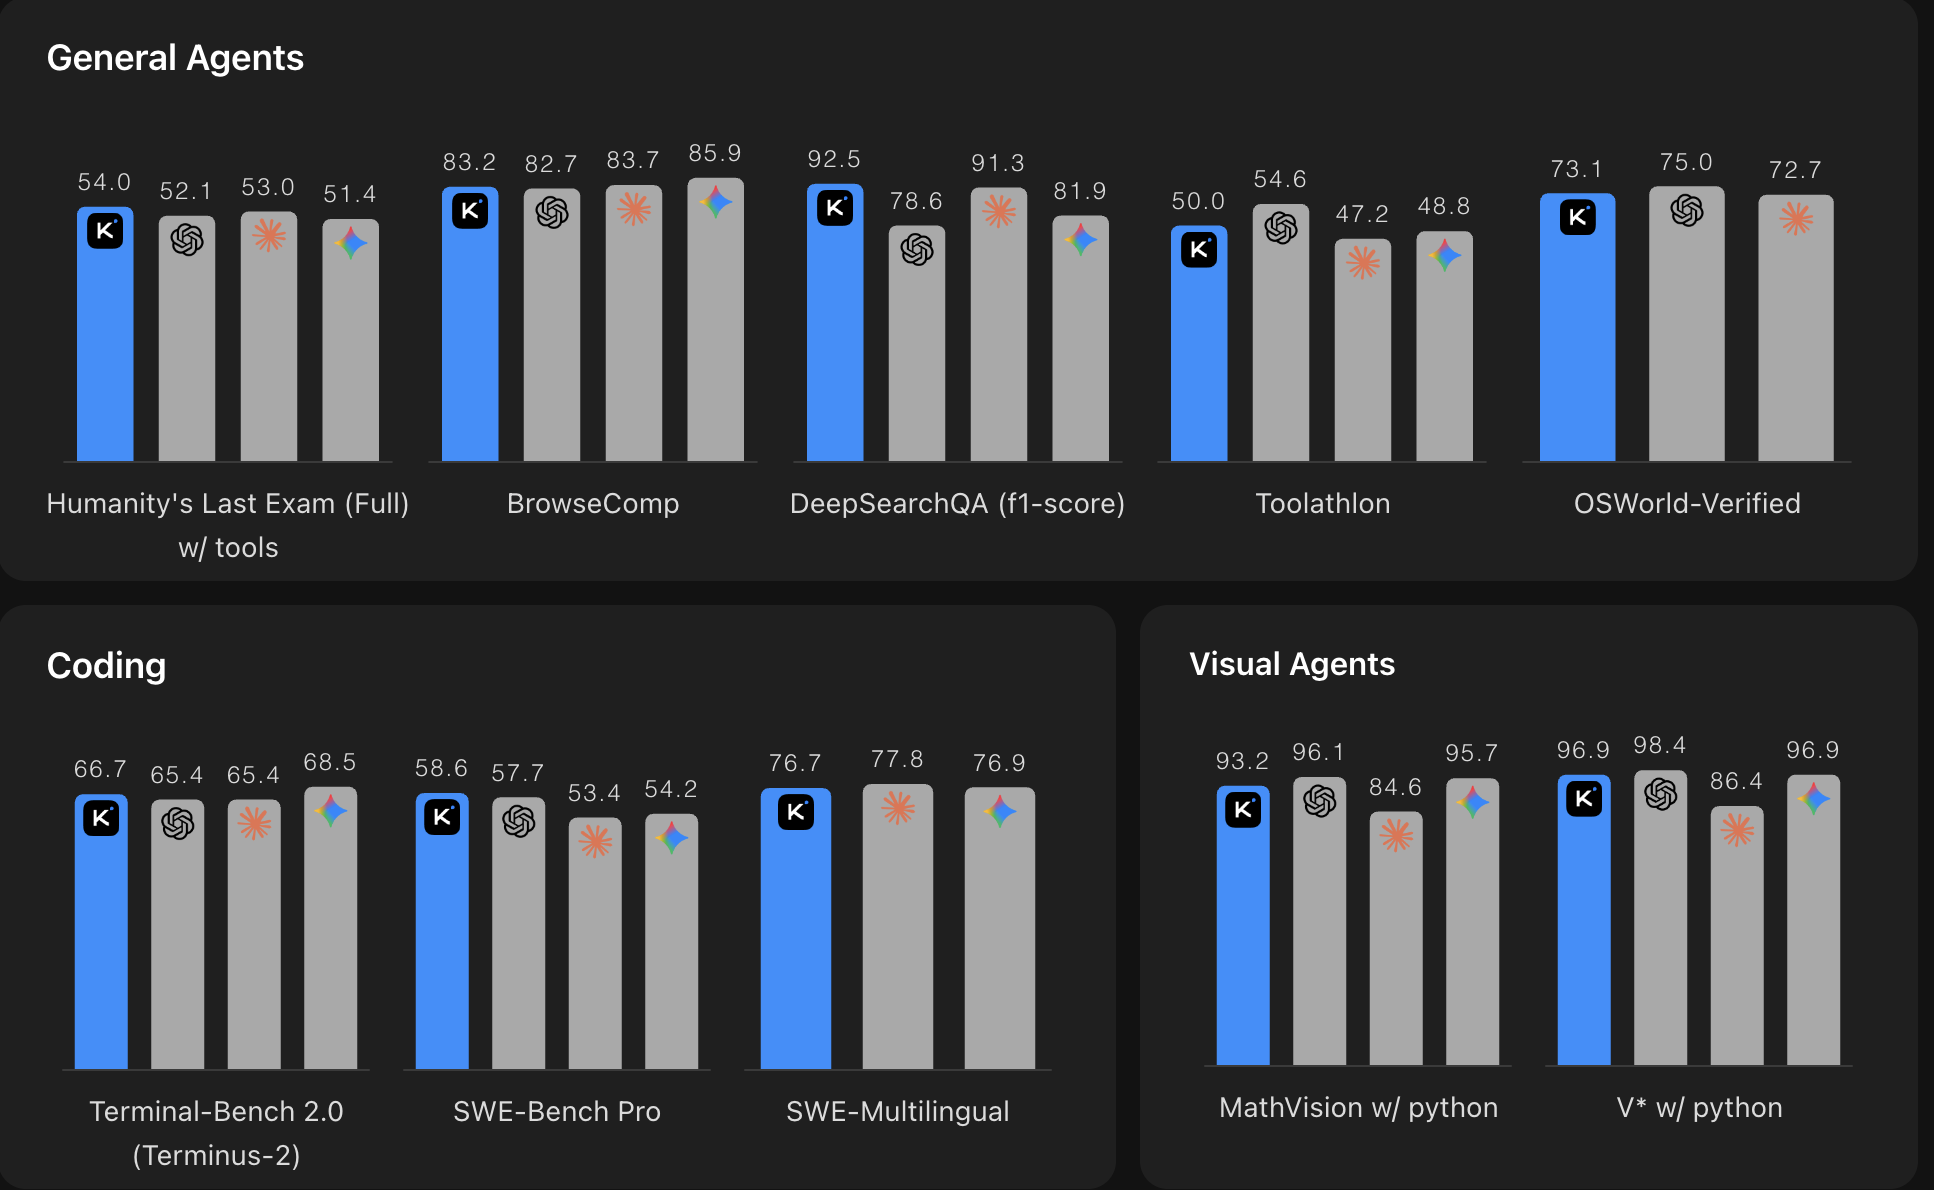
*Fuente: Comparativa de benchmarks de Moonshot AI Kimi K2.6. Cuanto más alto, mejor. El gráfico compara Kimi K2.6 frente a los principales modelos de código cerrado en benchmarks de agentes generales, programación y agentes visuales.*
K2.6 es competitivo con los mejores modelos de código cerrado, incluidos Claude Opus 4.6 y GPT-5.4, en prácticamente todas las dimensiones relevantes para la programación basada en agentes y las tareas a largo plazo. Y lo hace como un modelo de pesos abiertos a 0,74 $ / 3,50 $ por millón de tokens de entrada/salida, lo que representa una fracción del coste de las alternativas propietarias comparables.
El salto respecto a Kimi K2.5 también es significativo: una mejora de casi el 80 % en Toolathlon, ~8 puntos porcentuales en BrowseComp y SWE-Bench Pro. No son ganancias marginales.
Los socios empresariales que han tenido acceso anticipado informan de resultados igualmente convincentes: el CTO de Augmentcode destacó la "precisión quirúrgica en grandes bases de código" de K2.6; Vercel observó una mejora superior al 50 % en su benchmark de Next.js frente a K2.5; y CodeBuddy midió una mejora del 12 % en la precisión de generación de código con un éxito de invocación de herramientas que alcanzó el 96.6 %.
La mayoría de los LLM son adecuados para la generación de código puntual (one-shot). K2.6 está diseñado para las tareas que llevan horas: refactorizaciones de múltiples archivos, optimizaciones entre diferentes lenguajes, mejoras en pipelines de compilación y bucles de depuración iterativos donde el modelo tiene que leer la salida del compilador, ajustar su hipótesis y volver a intentarlo.
El modelo muestra una fuerte generalización en Python, Rust, Go e incluso en lenguajes poco comunes como Zig, lo cual es destacable porque sugiere que ha internalizado los conceptos de programación lo suficientemente profundo como para transferirlos, en lugar de limitarse a memorizar patrones de los datos de entrenamiento.
K2.6 puede convertir una sola instrucción en lenguaje natural en un frontend completo y listo para producción — no solo una maqueta estática, sino una con elementos interactivos, animaciones al desplazar la página y autenticación respaldada por base de datos. En el benchmark interno Kimi Design Bench de Moonshot, K2.6 supera a Google AI Studio en tareas de entrada visual, construcción de landing pages, desarrollo de aplicaciones full-stack y programación creativa general.
Para los equipos que construyen flujos de trabajo de desarrollo asistidos por IA, esto significa efectivamente contar con un único modelo que gestiona todo el stack: arquitectura, lógica, interfaz de usuario y estructura de despliegue.
K2.6 introduce una importante expansión arquitectónica del sistema de enjambre de agentes presentado por primera vez en K2.5. El enjambre ahora escala a 300 subagentes ejecutándose a través de 4.000 pasos coordinados simultáneamente, frente a los 100 agentes y 1.500 pasos de K2.5. Eso no es solo una mejora de escala; es un cambio cualitativo en los tipos de tareas que se vuelven viables.
Una tarea que antes requería que un humano la orquestara (por ejemplo, "investiga 100 empresas de semiconductores, construye cinco estrategias cuantitativas de inversión y produce una presentación al estilo McKinsey") ahora se puede emitir como una sola instrucción a K2.6 y devolverse como un entregable completo.
Aquí es donde normalmente se detiene la conversación: un equipo lee las cifras del benchmark, se entusiasma y luego pasa las siguientes tres semanas averiguando cómo servir realmente el modelo de manera fiable.
K2.6 es un modelo MoE de gran tamaño. Su ventana de contexto de 262K significa que los requisitos de memoria son significativos. Las cargas de trabajo basadas en agentes — por definición — generan patrones de tráfico altamente variables: tranquilidad durante horas y, de repente, cientos de subagentes paralelos haciendo peticiones simultáneamente. Las estrategias de despliegue ingenuas se desmoronan bajo esa carga.
Este es el problema de infraestructura que TrueFoundry AI Gateway está diseñado para resolver.
En lugar de aprovisionar tu propio clúster de GPU, construir un equilibrador de carga personalizado y ajustar a mano los parámetros de inferencia, TrueFoundry te permite apuntar tu aplicación a un único endpoint — y se encarga del resto. El Gateway enruta las peticiones de forma inteligente entre proveedores, gestiona la concurrencia para cargas de trabajo con picos repentinos (como un enjambre lanzando 300 subagentes simultáneos) y te proporciona las herramientas de observabilidad — trazas, histogramas de latencia, uso de tokens por equipo — que de otro modo tendrías que construir tú mismo.
En nuestras pruebas internas con Kimi K2 Thinking, el Gateway de TrueFoundry gestionó más de 350 RPS en una sola vCPU con ~10 ms de sobrecarga. Para cargas de trabajo basadas en agentes donde una sola tarea iniciada por el usuario puede ramificarse en docenas o cientos de llamadas a la API, ese margen es fundamental.
También hay una dimensión organizacional práctica. Los equipos empresariales que ejecutan K2.6 suelen tener múltiples departamentos — ciencia de datos, ingeniería de producto, plataforma — y todos quieren experimentar con el mismo modelo. El Gateway proporciona un único plano de control para la limitación de tasa (rate limiting), atribución de costes y políticas de acceso, sin que cada equipo necesite su propia gestión de claves API.
El camino más rápido para ejecutar K2.6 en un entorno gestionado y listo para producción:
1. A través de TrueFoundry AI Gateway (API)
Si ya utilizas el SDK de OpenAI o cualquier cliente compatible con OpenAI, puedes cambiar a K2.6 con una sola modificación en la cadena del modelo:
El Gateway gestiona la selección de proveedor, el enrutamiento de respaldo (fallback) y la limitación de tasa de forma transparente.
2. Para cargas de trabajo basadas en agentes
La interfaz de llamada a herramientas de K2.6 sigue el esquema estándar de function calling de OpenAI. Para tareas a largo plazo, te interesará:
- Configurar `max_tokens` con holgura (el modelo puede hacer un uso productivo de un gran presupuesto de generación)
- Habilitar el streaming para obtener salidas incrementales de largas cadenas de herramientas
- Utilizar el panel de trazado de TrueFoundry para visualizar qué llamadas a herramientas están consumiendo tiempo y dónde se está utilizando el contexto
3. Para la orquestación de enjambres de agentes
Si estás construyendo sistemas multiagente, el Gateway de TrueFoundry proporciona metadatos a nivel de petición — puedes etiquetar las peticiones de cada subagente con un ID de tarea padre y luego reconstruir la traza de ejecución completa a posteriori. Esto es incalculable para depurar el comportamiento del enjambre y comprender dónde ayuda (o perjudica) el paralelismo.
Equipos de ingeniería que construyen herramientas de programación basadas en agentes: K2.6 es el primer modelo de código abierto que compite seriamente con GPT-5.4 y Claude Opus en SWE-Bench Pro. Si estabas esperando un modelo de pesos abiertos capaz de gestionar tareas de código fuente de nivel de producción, es este.
Equipos de plataforma ML que gestionan el acceso a modelos: una empresa que evalúe K2.6 junto a otros modelos frontera se beneficia de ejecutar todo a través de un único gateway. El enfoque de catálogo de modelos de TrueFoundry te permite realizar pruebas A/B de K2.6 frente a Claude o GPT-5.4 en tus cargas de trabajo reales, comparando el seguimiento de costes y latencia lado a lado.
Equipos con requisitos de residencia de datos: los pesos abiertos de K2.6 significan que se puede desplegar en la infraestructura que tú controles. La plataforma de despliegue de TrueFoundry gestiona la orquestación, por lo que obtienes gobernanza de modelos empresarial sin que un proveedor propietario se interponga en tu ruta de inferencia.
Cualquiera cansado de pagar precios de modelos de código cerrado: a 0,74 $ / 3,50 $ por millón de tokens y con un rendimiento en benchmarks que iguala o supera a las alternativas propietarias en la mayoría de las tareas de agentes, el argumento coste-rendimiento a favor de K2.6 es difícil de ignorar.
Kimi K2.6 es un auténtico modelo frontera. No "bueno para ser de código abierto" — genuinamente competitivo con los mejores modelos del mundo en los benchmarks que importan para el trabajo de ingeniería real. Su fiabilidad a largo plazo, su arquitectura de enjambre de agentes y su precio competitivo lo convierten en el modelo de pesos abiertos más atractivo disponible hoy en día para sistemas de agentes en producción.
La pregunta práctica no es si vale la pena usar K2.6. Vale la pena. La pregunta es qué tan rápido y de manera fiable puedes llevarlo a producción. TrueFoundry AI Gateway responde a esa pregunta — para que tu equipo dedique su tiempo a construir con el modelo, no a construir la infraestructura a su alrededor.
Pruébalo ahora: Accede a Kimi K2.6 a través del [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway), o [reserva una demo](https://www.truefoundry.com/book-demo) para ver cómo se adapta al flujo de trabajo de tu equipo.
*Todas las cifras de benchmarks citadas provienen del blog técnico oficial de Kimi K2.6 y de evaluaciones de terceros verificadas en OpenRouter. Las cifras de rendimiento de infraestructura provienen de pruebas internas de TrueFoundry.*
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada


















