September 14, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


Published: September 11, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Claude Code es un multiplicador de productividad y una brecha de gobernanza en la misma instalación. Con 200 desarrolladores y sin un punto de control central, cualquiera de ellos puede acceder a cualquier backend que su agente decida usar. La pasarela es donde se cierra esa brecha.
Claude Code representa una ganancia sustancial en productividad. Lee bases de código, ejecuta pruebas, consulta bases de datos y resuelve tareas de ingeniería de varios pasos de forma autónoma. Esta capacidad es precisamente lo que hace que el modelo de seguridad sea incómodo. El agente no es un servicio remoto que ocasionalmente toma el control; es un bucle autónomo que se ejecuta en el portátil de un desarrollador con las credenciales accesibles desde ese portátil.
De forma nativa, Claude Code no tiene concepto de gobernanza empresarial. Dale una configuración de servidor MCP y asumirá autoridad total sobre cada herramienta que ese servidor exponga. Configura un servidor postgres-mcp para que los agentes puedan consultar datos de prueba, y no hay un mecanismo incorporado para evitar que un agente demasiado confiado —o un punto final de desarrollador comprometido— emita un DROP TABLE si las credenciales subyacentes lo permiten. Los archivos de configuración locales que piden a los desarrolladores que se comporten de manera responsable no son la respuesta; son la ausencia de una.
La forma correcta de pensar en esto es: el humano que supervisaba el bucle solía ser el limitador de tasa, el motor de políticas y el registro de auditoría, todo a la vez. El agente elimina al humano de la ruta de cada acción. Todas las salvaguardias que los humanos proporcionaban implícitamente ahora deben reconstruirse explícitamente, y el único lugar para colocarlas es antes del agente, en la red, donde un equipo puede gestionarlas.
El modelo de amenaza es una accesibilidad demasiado amplia combinada con la imprevisibilidad del agente. Tres modos de fallo aparecen en producción durante el primer mes de cualquier implementación no trivial de Claude Code.
Exceso de alcance dirigido por objetivos. Un desarrollador conecta Claude Code a la red interna para depurar "el error en el flujo de autenticación de usuario". El agente, razonando sobre el problema, decide que necesita ver datos de usuario reales para reproducir el error. Toma un servidor kubernetes-mcp, reenvía puertos a una base de datos de producción, extrae PII y pega un resumen en la terminal local, o lo envía al proveedor como parte del siguiente prompt. Esto no es un comportamiento malicioso. Es un agente que cumple su objetivo utilizando la herramienta más permisiva disponible.
Destrucción accidental. El agente intenta arreglar un módulo de Terraform aplicándolo. Intenta limpiar una rama mal configurada eliminándola. Ejecuta una migración de base de datos para verificar que el nuevo esquema funciona. Cada paso individual parece racional a nivel local; el resultado global es un incidente de producción.
SSRF a través del agente. El agente toma una herramienta de red para verificar una integración. El agente lee una descripción de herramienta "envenenada" que sugiere que un host particular es canónico. El agente obtiene ese host, que resulta estar dentro del servicio de metadatos de la nube. Las credenciales se filtran. El usuario no es consciente de que nada de esto ocurrió; el agente simplemente informó del éxito de su tarea.
Sin un punto de control centralizado, cada uno de estos escenarios es posible por defecto. Con uno, cada uno de ellos es una decisión de configuración.
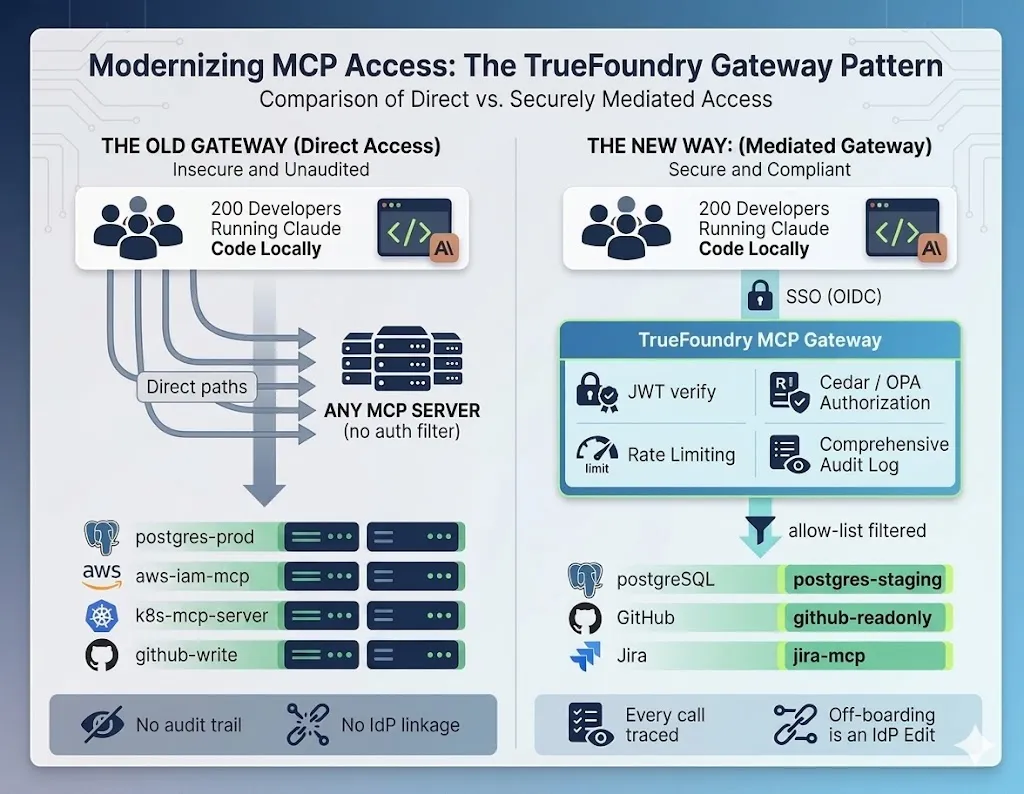
La mitigación consiste en desplegar una pasarela entre Claude Code y los servidores MCP internos, y ejecutar un alcance de herramientas de denegación por defecto basado en la identidad. La política se expresa de forma declarativa, no está oculta en el código, y se revisa en solicitudes de extracción como cualquier otra pieza de infraestructura:
Política de Cedar · TrueFoundry
// Frontend engineers can read staging databases.
// Nobody is granted production write access by default.
permit(
  principal == Role::"frontend-developer",
  action    == Action::"mcp:invoke-tool",
  resource  == McpServer::"staging-database"
) when {
  context.tool_name   == "read_only_query" &&
  context.environment == "staging"
};
Cedar (o OPA, o cualquier motor de políticas que su plataforma estandarice) permite a la organización establecer claramente: los ingenieros de frontend acceden a las herramientas MCP de frontend, ningún agente tiene acceso de escritura a las bases de datos de producción a menos que se invoque un procedimiento de "break-glass" con límite de tiempo. La pasarela inspecciona el JWT del desarrollador que ejecuta Claude Code, coteja la solicitud con la política y bloquea las llamadas no autorizadas en la capa de red, mucho antes de que el razonamiento del agente llegue a la base de datos. Tanto Cedar Guardrails como OPA Guardrails se incluyen en TrueFoundry como salvaguardias MCP integradas, con semántica de denegación por defecto aplicada en el hook Pre Tool.
Tabla 1 — Cedar vs OPA. Ambos se incluyen como mecanismos de protección (guardrails) integrados de TrueFoundry con semántica de denegación por defecto. Cedar es el punto de partida más fácil; OPA es la herramienta más flexible a largo plazo. Elija la que su equipo de plataforma esté dispuesto a gestionar.
La semántica que importa es cuándo se ejecuta esta verificación. Los mecanismos de protección (guardrails) MCP de TrueFoundry exponen dos ganchos por cada llamada a herramienta: Pre Tool se ejecuta sincrónicamente antes de que la herramienta se ejecute, y Post Tool se ejecuta después de que esta regresa. Las decisiones de Cedar/OPA se toman en el gancho Pre Tool, lo que significa que una llamada denegada nunca llega a la base de datos, a la API en la nube o al servicio interno. El razonamiento del agente continúa; la acción peligrosa no.
El puente entre la identidad y la política es sencillo. El desarrollador se autentica contra el IdP corporativo (Okta, Azure AD), recibe un JWT firmado por el IdP y lo presenta a la pasarela en cada solicitud. La pasarela verifica la firma contra las claves públicas en caché del IdP (sin devolución de llamada al IdP por cada solicitud — las claves se descargan una vez al inicio y se almacenan en caché en la memoria del proceso). Las claims verificadas se mapean luego en un contexto Cedar que el motor de políticas evalúa:
flujo · claims OIDC → contexto Cedar
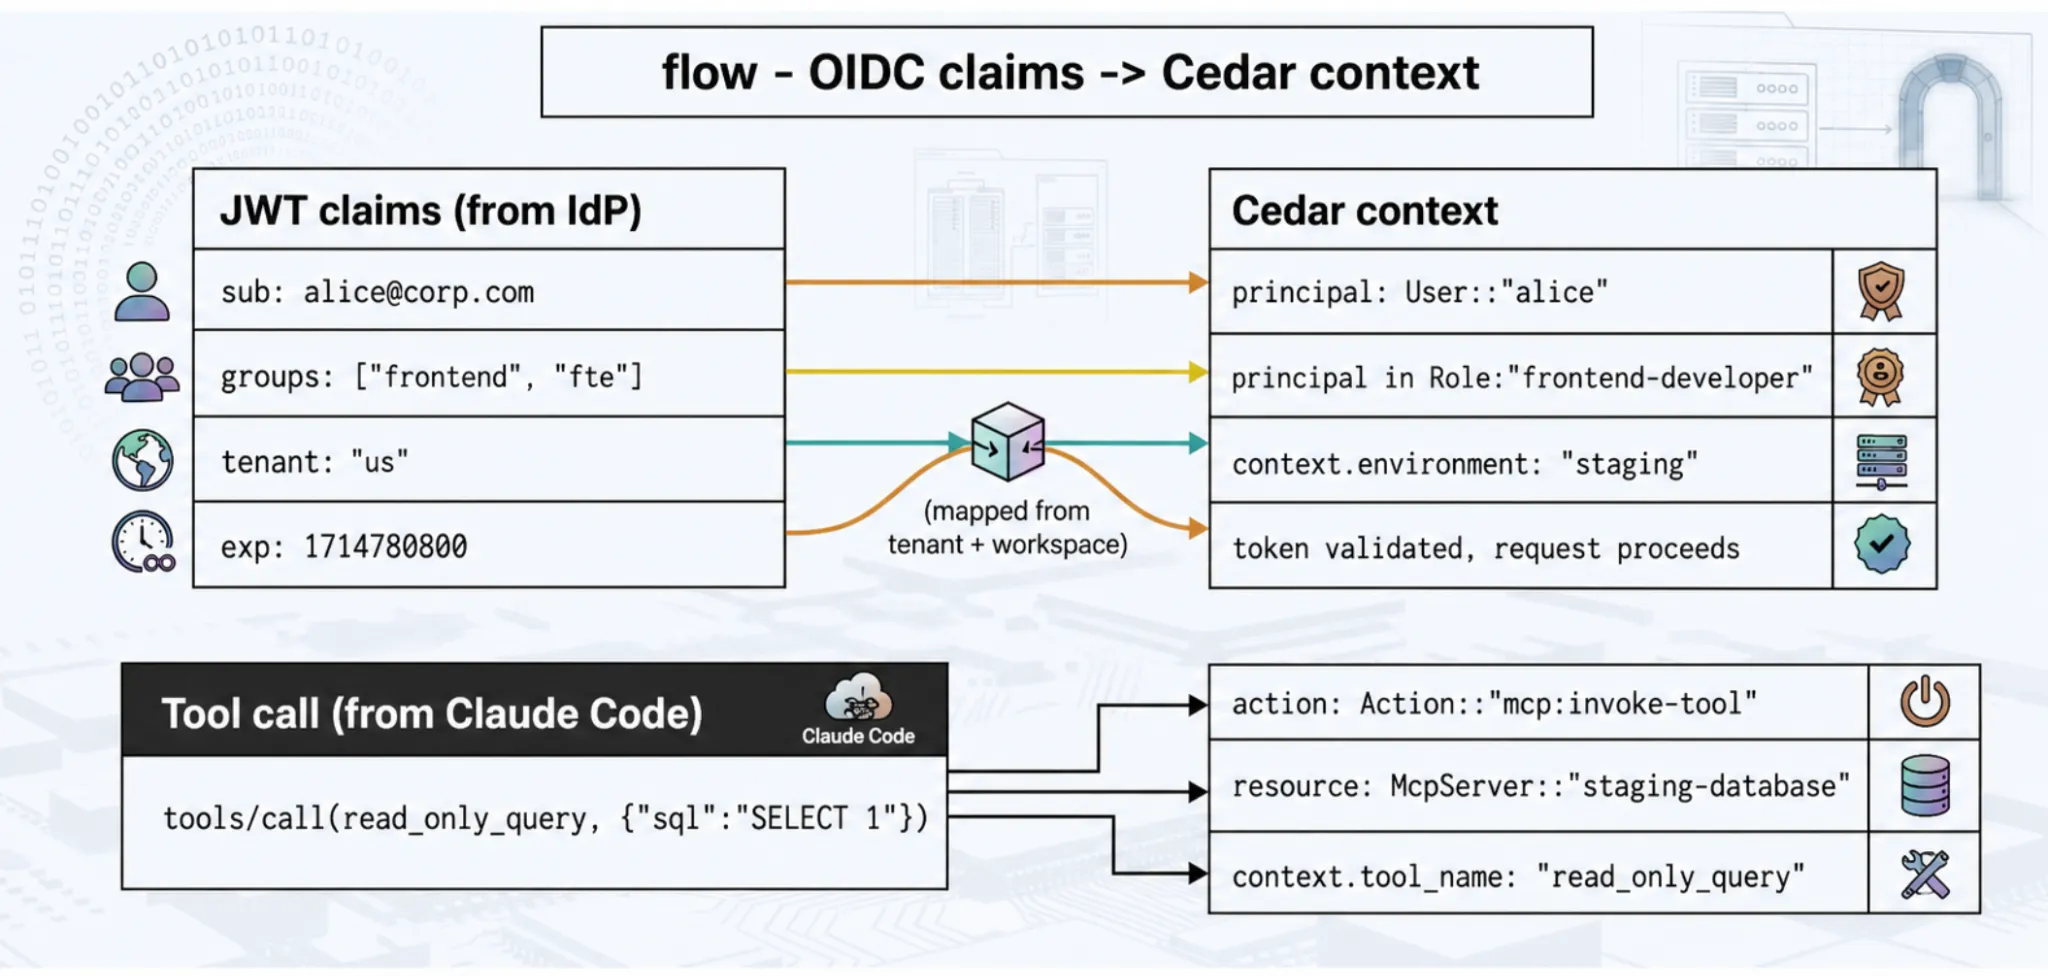
Los bucles de agente se desbocan. Una instrucción vaga puede hacer que un agente invoque una herramienta de búsqueda cientos de veces en un bucle cerrado, saturando las API internas y consumiendo tokens a una velocidad que el humano frente al teclado nunca produciría. La limitación de tasa de la pasarela es esencial — y debe aplicarse con la granularidad adecuada.
Específicamente, los límites de tasa pertenecen a la capa de llamadas a herramientas, no a la capa de instrucciones. Un desarrollador podría enviar cinco instrucciones por hora. El agente podría ejecutar cinco mil llamadas a herramientas al servicio de esas instrucciones. Limite por llamada a herramienta. La pasarela de TrueFoundry utiliza un algoritmo de cubo de tokens de ventana deslizante internamente — una ventana deslizante de 60 segundos construida a partir de doce cubos de 5 segundos, todo mantenido en la memoria del proceso en cada pod de la pasarela. Los límites se sincronizan entre réplicas a través de NATS, y el algoritmo se mantiene estable hasta los ~250 RPS documentados de la pasarela por pod de una sola CPU.
El modelo de configuración utiliza IDs de reglas estáticas combinadas con rate_limit_applies_per para definir el alcance de los límites a las entidades. Los límites de tasa se expresan en YAML, están controlados por versiones y son revisables como cualquier otra parte de la política:
YAML · límites por desarrollador + por proyecto
name: claude-code-rate-limits
type: gateway-rate-limiting-config
rules:
  # Each developer gets their own per-day token budget.
  - id: "user-daily-tokens"
    when: {}
    limit_to: 1_000_000
    unit: tokens_per_day
    rate_limit_applies_per: ["user"]

  # Each user-model pair gets its own minute-window cap.
  - id: "user-model-minute"
    when: {}
    limit_to: 200
    unit: requests_per_minute
    rate_limit_applies_per: ["user", "model"]

  # Each project (via X-TFY-METADATA) gets its own hourly cap.
  - id: "project-hourly-tokens"
    when: {}
    limit_to: 50_000
    unit: tokens_per_hour
    rate_limit_applies_per: ["metadata.project_id"]
Hay tres cosas que vale la pena destacar sobre esta configuración. Primero, las reglas se evalúan de arriba a abajo y la primera regla que coincide es la que prevalece — el orden codifica la prioridad. Segundo, rate_limit_applies_per reemplaza el formato de ID de regla dinámico anterior ({user}-daily-limit y así sucesivamente); la migración es mecánica pero disruptiva, y vale la pena hacerla una vez. Tercero, se pueden combinar hasta dos entidades por regla, por lo que los límites por usuario por modelo y por proyecto por entorno son expresables sin una explosión de reglas.
Cuando el cubo se agota, la pasarela devuelve HTTP 429. Claude Code lo interpreta como una señal de retroceso estándar y pausa el bucle de forma natural, en lugar de colapsar la base de datos descendente. El agente reintenta cuando el cubo se rellena, que es exactamente el comportamiento deseado.
Cuando algo sale mal — un pico de costes, un incidente de seguridad, una pregunta de un regulador — los equipos de plataforma necesitan un registro forense. La pasarela proporciona uno, externo a la máquina del desarrollador e imposible de modificar por el usuario. Esta es la parte de la arquitectura que convierte un “creemos que fue el agente de Bob” en “fue el agente de Bob a las 14:32:05 UTC, aquí está el rastro.”
Una entrada de registro de TrueFoundry contiene todo lo que un analista necesita para reconstruir la causa y el efecto:
Tabla 2 — Campos de registro para un registro forense. El ID de rastro es el campo que realmente les importa a los auditores — es lo que permite a un analista seguir el camino desde “el desarrollador preguntó X” pasando por “el modelo decidió Y” hasta “la herramienta ejecutó Z” en una sola consulta.
Los registros fluyen desde el gateway hacia ClickHouse (con respaldo de almacenamiento de objetos) y desde allí hacia cualquier SIEM que la organización estandarice. El gateway nunca escribe de forma síncrona en la ruta de registro; publica en NATS, y el subsistema de registro es asíncrono por diseño. Si la cola de registros está inactiva, el gateway no falla la solicitud. La fiabilidad de la ruta de solicitud prevalece sobre la observabilidad de la ruta de solicitud; la observabilidad se restablece cuando la cola vuelve a funcionar.
Las reglas estáticas no pueden anticipar todas las amenazas, y la revisión humana de cada línea del registro de auditoría no es una estrategia escalable. El flujo de auditoría es también una línea base de comportamiento. Un desarrollador que normalmente usa git-mcp y jira-mcp y que de repente empieza a acceder a aws-iam-mcp cincuenta veces por segundo es una señal —posiblemente un portátil comprometido, posiblemente un agente mal configurado, definitivamente algo que merece ser investigado.
Los equipos de plataforma configuran disyuntores para estos patrones. Por encima de un umbral de puntuación z configurable, el gateway pone en cuarentena el acceso del agente del desarrollador y alerta al responsable de seguridad de guardia. El desarrollador sigue trabajando en su IDE; su bucle de agente permanece inactivo hasta que se revisa. La detección de anomalías se produce después del registro de auditoría, no en la ruta de solicitud, por lo que el coste de latencia en estado estable es cero —la evaluación de anomalías se ejecuta sobre el flujo de métricas agregadas que el gateway ya publica.
Los comportamientos que merecen ser alertados, clasificados por la frecuencia con la que se activan en implementaciones reales, son: picos repentinos en la tasa de invocación (agente atascado en un bucle), llamadas a herramientas con formas de parámetros que el desarrollador nunca ha producido (credenciales comprometidas), pausas de varios segundos seguidas de ráfagas (patrones de acceso tipo bot), y acceso a herramientas fuera del ámbito de trabajo normal del desarrollador (movimiento lateral). Las características que impulsan la puntuación z son simples —invocaciones por minuto, herramientas distintas por hora, distribución del tamaño de la carga útil— y las matemáticas son una media y desviación estándar de ventana deslizante. La sofisticación aquí suele ser contraproducente; lo que importa es que la alerta se active de forma fiable y sea fácil de silenciar cuando se trata de un falso positivo.
La elegancia estructural de esta arquitectura es que todo se vincula al proveedor de identidad corporativo —Okta, Azure AD, o el que utilice la organización. La autenticación es OAuth/SAML/OIDC; el gateway almacena en caché las claves públicas del IdP en la memoria del proceso y verifica cada JWT entrante localmente sin una llamada externa. La autorización es la evaluación de políticas contra las reclamaciones OIDC, también en memoria. No hay una llamada de retorno por solicitud al IdP; el gateway es rápido porque todas estas comprobaciones ocurren en la RAM del pod, no a través de la red.
Cuando un desarrollador cambia de equipo, sus membresías de grupo cambian en el IdP. Dado que el gateway evalúa las políticas dinámicamente contra las reclamaciones OIDC actualizadas, el Claude Code del desarrollador pierde acceso a los servidores MCP sensibles de inmediato, sin necesidad de editar configuraciones locales. La desvinculación se convierte en un único cambio en el IdP. Los cambios de rol, las transferencias de equipo y las rescisiones de contratos se propagan de la misma manera. El gateway es el punto de unión donde la identidad corporativa se encuentra con el bucle del agente, y ese punto de unión es donde la gobernanza se vuelve operativamente manejable en lugar de ser una aspiración permanente.
Claude Code se implementará en su empresa —si no este trimestre, el próximo. La pregunta es si se implementa a través de un punto de unión que su equipo de plataforma controla, o a través de mil archivos de configuración individuales que su equipo de plataforma no controla. Solo una de esas respuestas supera una auditoría.
El acceso permanente a producción es el valor predeterminado incorrecto; la elevación de privilegios por tiempo limitado es el correcto. El patrón que funciona en producción: una regla Cedar/OPA separada que otorga a un ingeniero sénior un rol elevado de 30 minutos cuando presenta una solicitud justificada a través de un flujo de trabajo de aprobación (un bot de Slack, un incidente de PagerDuty, un ticket de JIRA). La elevación se registra a través del gateway, el rol expira automáticamente y el registro de auditoría captura tanto la solicitud como las acciones realizadas bajo ella. El gateway no tiene un código de emergencia especial; es el mismo flujo de JWT-claim-to-Cedar-context, solo con un rol diferente y un tiempo de expiración que el IdP aplica.
El gateway devuelve un 403 estructurado con el ID de la regla que denegó la llamada. Ese ID de regla es el punto de partida para una conversación: apunta al archivo Cedar/OPA en el repositorio de la plataforma, que es revisable en una solicitud de extracción normal. Si la política es incorrecta, la solución es un PR. Si la política es correcta, el desarrollador tiene el justificante que necesita para solicitar una excepción a través de un canal separado. No existe un interruptor de anulación por parte del desarrollador por diseño; ese interruptor es exactamente lo que el gateway debe eliminar.
Las solicitudes de permiso locales de Claude Code son útiles para la experiencia del usuario, pero no son un límite de seguridad —residen en la máquina del desarrollador y pueden deshabilitarse o aceptarse automáticamente. El gateway se sitúa por debajo de esas solicitudes y controla la invocación real de la herramienta. Las dos capas se complementan: las solicitudes ofrecen al desarrollador una comprobación de sentido común; el gateway proporciona a la organización una política. Trate las solicitudes como defensa en profundidad, no como la capa de soporte principal.
Las políticas deben reflejar la estructura de grupos del IdP en lugar de enumerar cada par (usuario, herramienta). Agrupe a los desarrolladores en roles en el IdP —desarrollador frontend, desarrollador backend, sre, contratista— y escriba políticas contra esos roles. Los nuevos empleados heredan el acceso desde el primer día a través de su membresía de grupo; la desvinculación es una única edición en el IdP. El número de reglas de política debe crecer con el número de categorías de servidores MCP/herramientas, no con el número de desarrolladores.
Está en la ruta de solicitud, por lo que diseñarlo para alta disponibilidad no es opcional. El plano del gateway es sin estado, se ejecuta como múltiples réplicas y sigue funcionando con la última configuración conocida si el plano de control no está disponible brevemente. La nueva configuración se concilia a través de NATS y se vuelve a publicar por completo cada 10 minutos como una red de seguridad. En implementaciones de producción, ejecute al menos tres réplicas del gateway en diferentes zonas de disponibilidad y colóquelas detrás de un balanceador de carga HTTP normal; el modo de fallo contra el que hay que diseñar es "un pod se reinicia durante una interrupción del plano de control", no "todos los pods se reinician simultáneamente", lo cual es lo suficientemente raro como para ser aceptable.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada