October 24, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
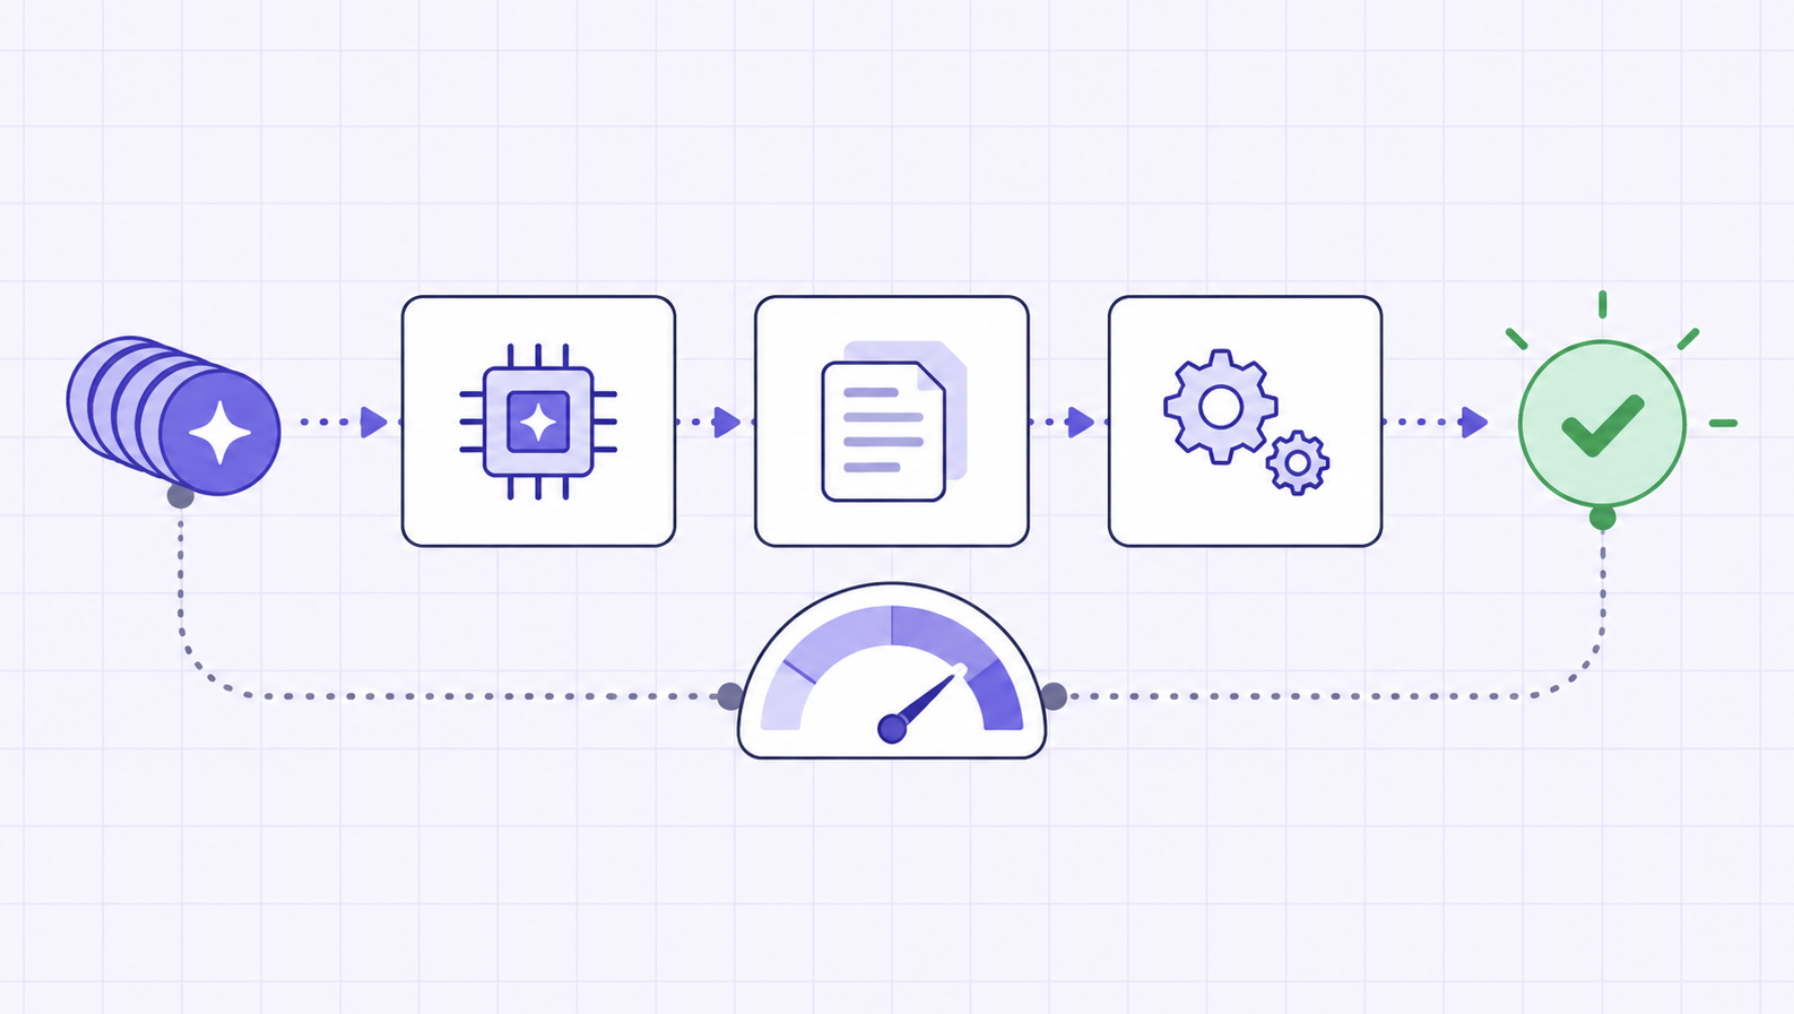
Una factura de tokens puede decirte cuánto costó la inferencia. No puede decirte si el trabajo fue aceptado, si un humano tuvo que rehacerlo o si el resultado empresarial llegó dos semanas después. Gestionar la economía de la IA requiere una nueva unidad de control: la ejecución del flujo de trabajo, vinculada a su resultado final.
BCG propone un enfoque útil: dejar de tratar el token como la unidad de gestión y empezar a medir el coste de un resultado exitoso. Su marco de retorno de la IA sitúa el rendimiento económico por encima del coste combinado de la inteligencia humana y los tokens. También aboga por un modelo operativo a nivel de flujo de trabajo que permita visualizar el gasto, ajustar los costes y demostrar el valor, o bien detener la actividad.
La idea es sólida. Lo difícil es la implementación.
Las puertas de enlace de modelos observan las solicitudes. Los entornos de ejecución de agentes observan los turnos, las herramientas, los reintentos y las pausas. Finanzas ve las facturas. Los sistemas empresariales observan si un caso se cerró, un pago se liquidó, una solicitud de extracción se envió o una escalada se reabrió. Ninguno de esos registros, por sí solo, constituye el retorno de la IA.
Los tokens siguen siendo una telemetría esencial. Explican el tamaño de la entrada, el tamaño de la salida, el comportamiento de la caché y parte del coste de una llamada al modelo. Pero no tienen un significado empresarial estable entre modelos o proveedores. Los tokenizadores difieren. La entrada, la salida, la entrada en caché, la creación de caché, el razonamiento, el audio y otras modalidades pueden tener diferentes reglas de facturación. Un millón de unidades en un producto no es automáticamente equivalente a un millón de unidades en otro.
Incluso dentro de una misma categoría de precios, donde el coste facturado puede escalar linealmente con el volumen de tokens, la economía del flujo de trabajo no tiene por qué hacerlo. Un contexto más amplio puede cambiar el comportamiento del modelo. Un modelo más barato puede provocar más reintentos. Una respuesta concisa puede aumentar la revisión humana. Un acierto de caché puede eliminar una llamada de inferencia, pero devolver una respuesta obsoleta para el estado actual del usuario. Un agente puede entrar en un bucle de herramientas que gasta poco por llamada y mucho por caso resuelto.
BCG identifica cuatro fuerzas de coste que interactúan: amplitud y profundidad de adopción, intensidad de la tarea, contexto y bucles, y combinación de modelos. Ese marco es importante porque cada fuerza existe por encima de la solicitud individual. Una sola solicitud suele ser demasiado pequeña para mostrar el trabajo; una factura mensual del proveedor es demasiado grande para asignar responsabilidades o valor.
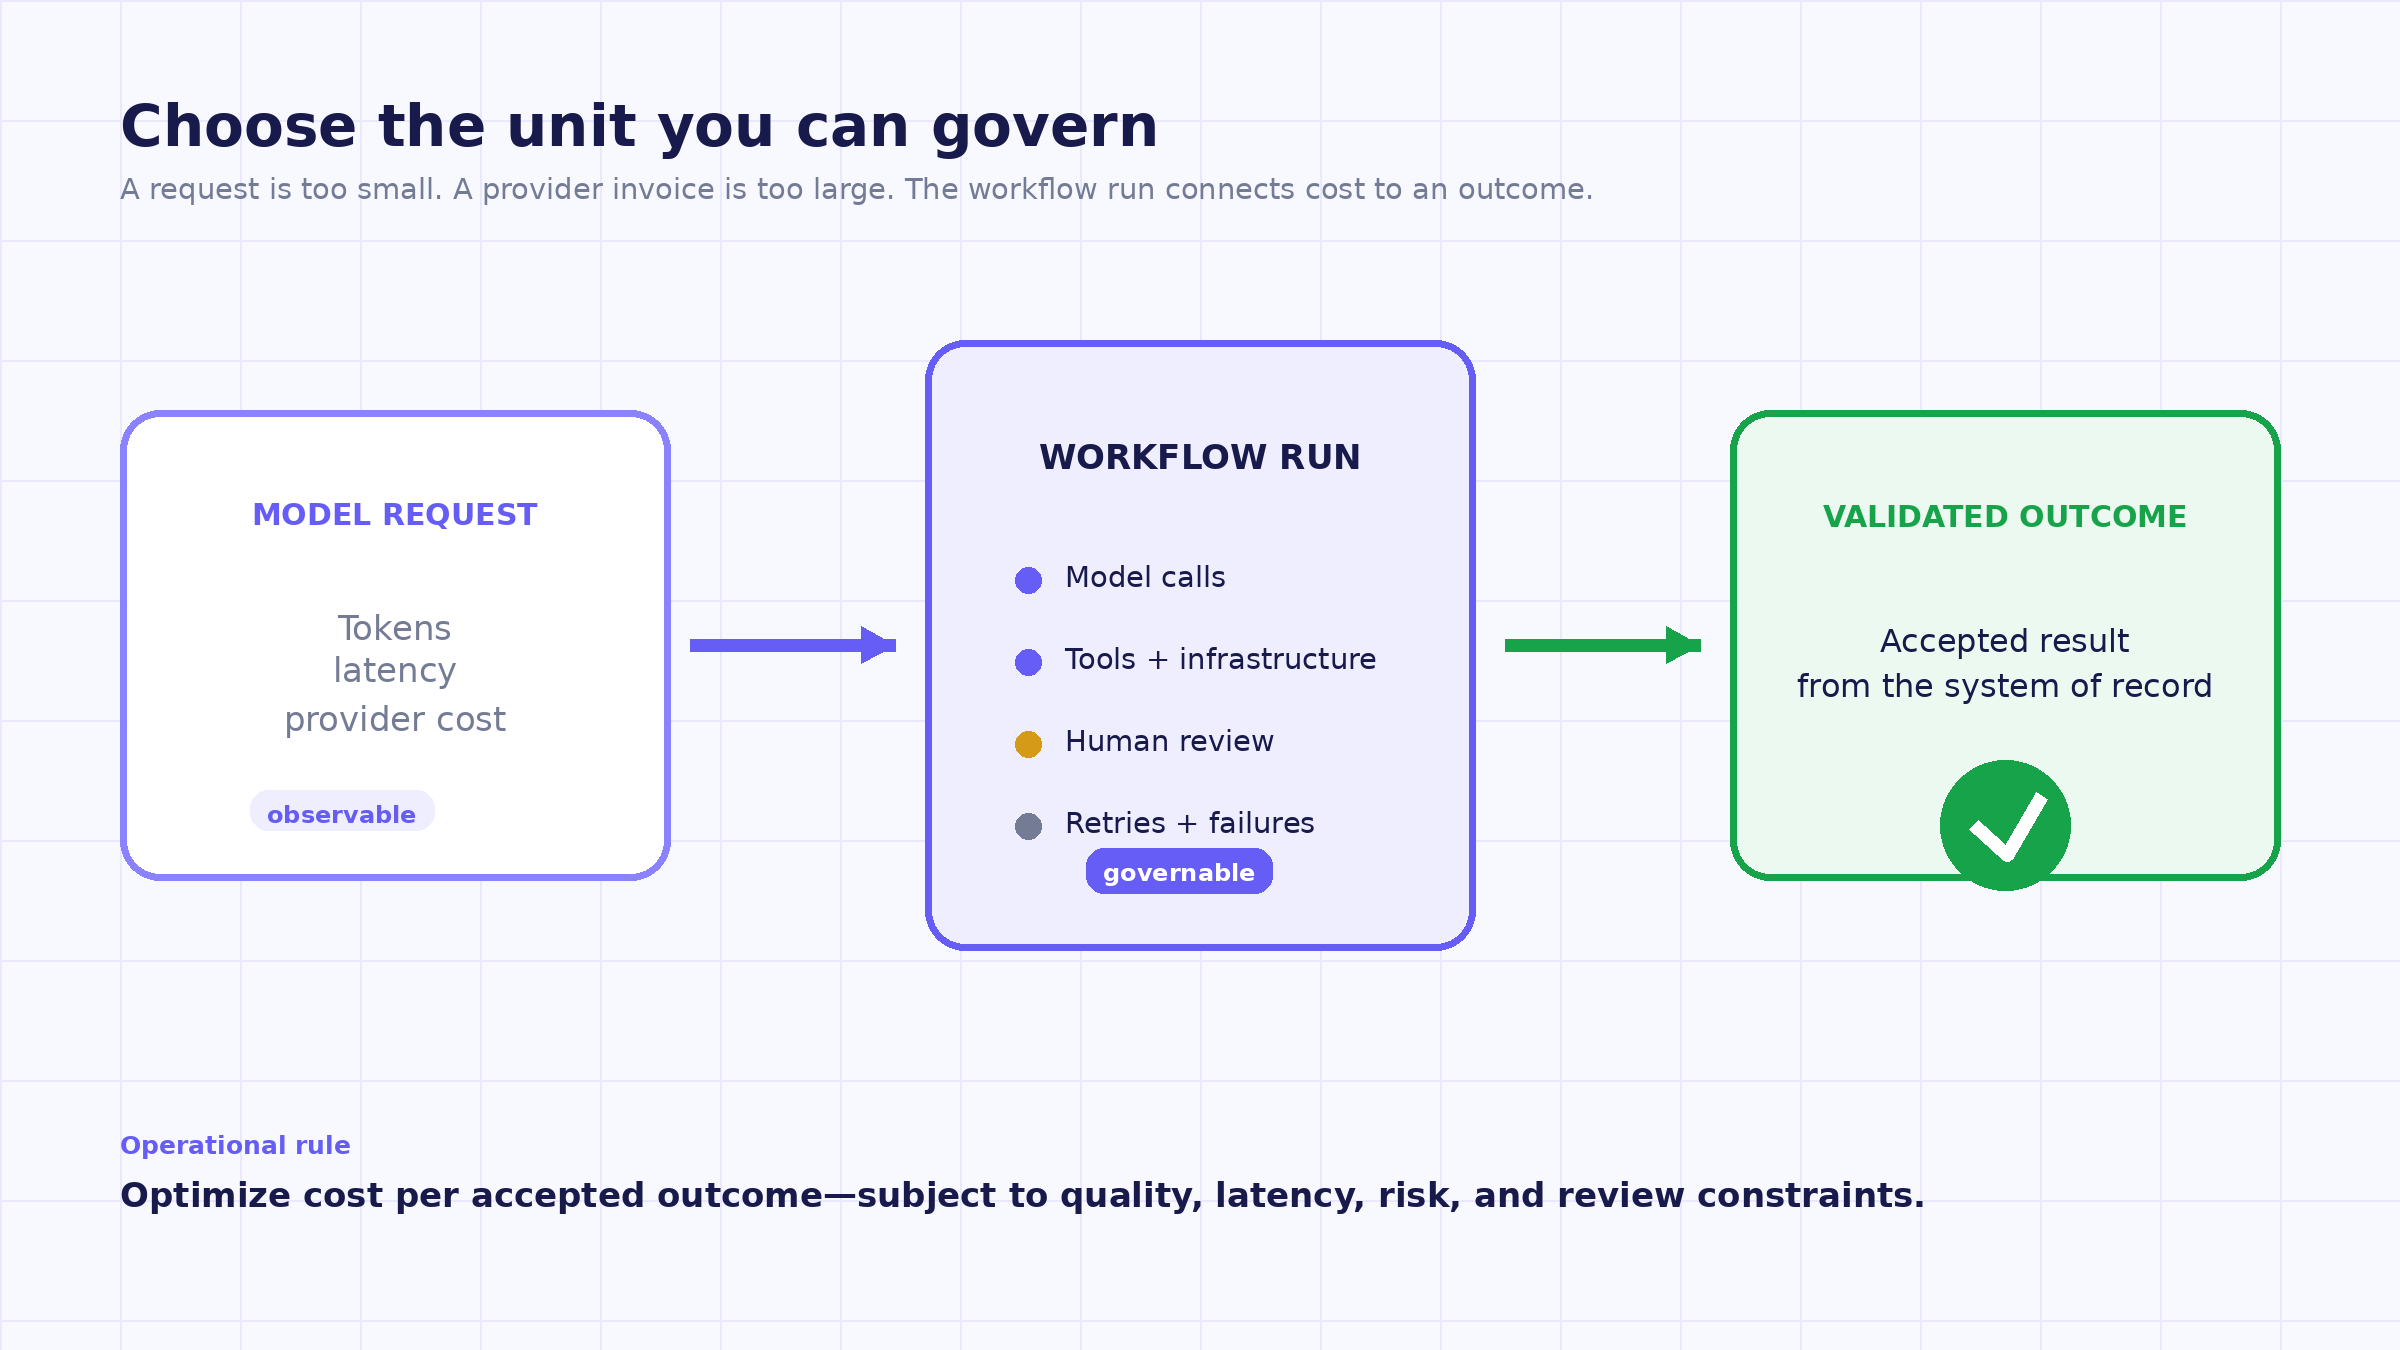
Un sistema creíble de economía de flujo de trabajo comienza con dos contratos explícitos: un paquete de costes y un contrato de resultados. El primero indica qué recursos cuentan. El segundo define qué significa el éxito. Si alguno de los dos permanece implícito, el coste por resultado se convierte en un número con un denominador inestable o un numerador negociable.
Para cada ejecución de flujo de trabajo, captura los costes que cambian materialmente la decisión. Esto suele incluir la inferencia del modelo, el uso de herramientas e infraestructura, la supervisión humana y los fallos o el retrabajo. Las categorías deben ser mutuamente excluyentes o estar regidas por una regla de asignación para que el mismo tiempo de corrección no se cuente dos veces. El objetivo no es una precisión falsa. El tiempo humano, por ejemplo, puede muestrearse por flujo de trabajo y rol en lugar de medirse por cada clic. El requisito es la coherencia: utiliza las mismas reglas de inclusión al comparar políticas.
"Exitoso" debe ser una definición versionada y comprobable. Para un flujo de trabajo de soporte, el cierre no es suficiente si el ticket se reabre en un plazo de siete días. Para la programación, las líneas generadas no son suficientes si el cambio no supera la revisión o nunca se implementa. Para el procesamiento de documentos, una extracción de campos no se acepta hasta que pasa la validación de dominio o la conciliación posterior.
Esta es una medida operativa, no una fórmula de información financiera. Cuando el valor del resultado no pueda monetizarse de forma responsable, utiliza el coste por resultado aceptado e informa sobre la calidad, la latencia, el riesgo y la carga de revisión junto con él. No comprimas todos los objetivos en una sola estimación en dólares solo para crear un ratio.
Los contratos de costes y resultados solo son útiles cuando sus registros pueden unirse. La unión debe diseñarse antes de que comience la optimización, porque adaptar la propiedad y los ID de resultados después de un pico de costes suele dejar lagunas.
Un registro práctico contiene al menos:
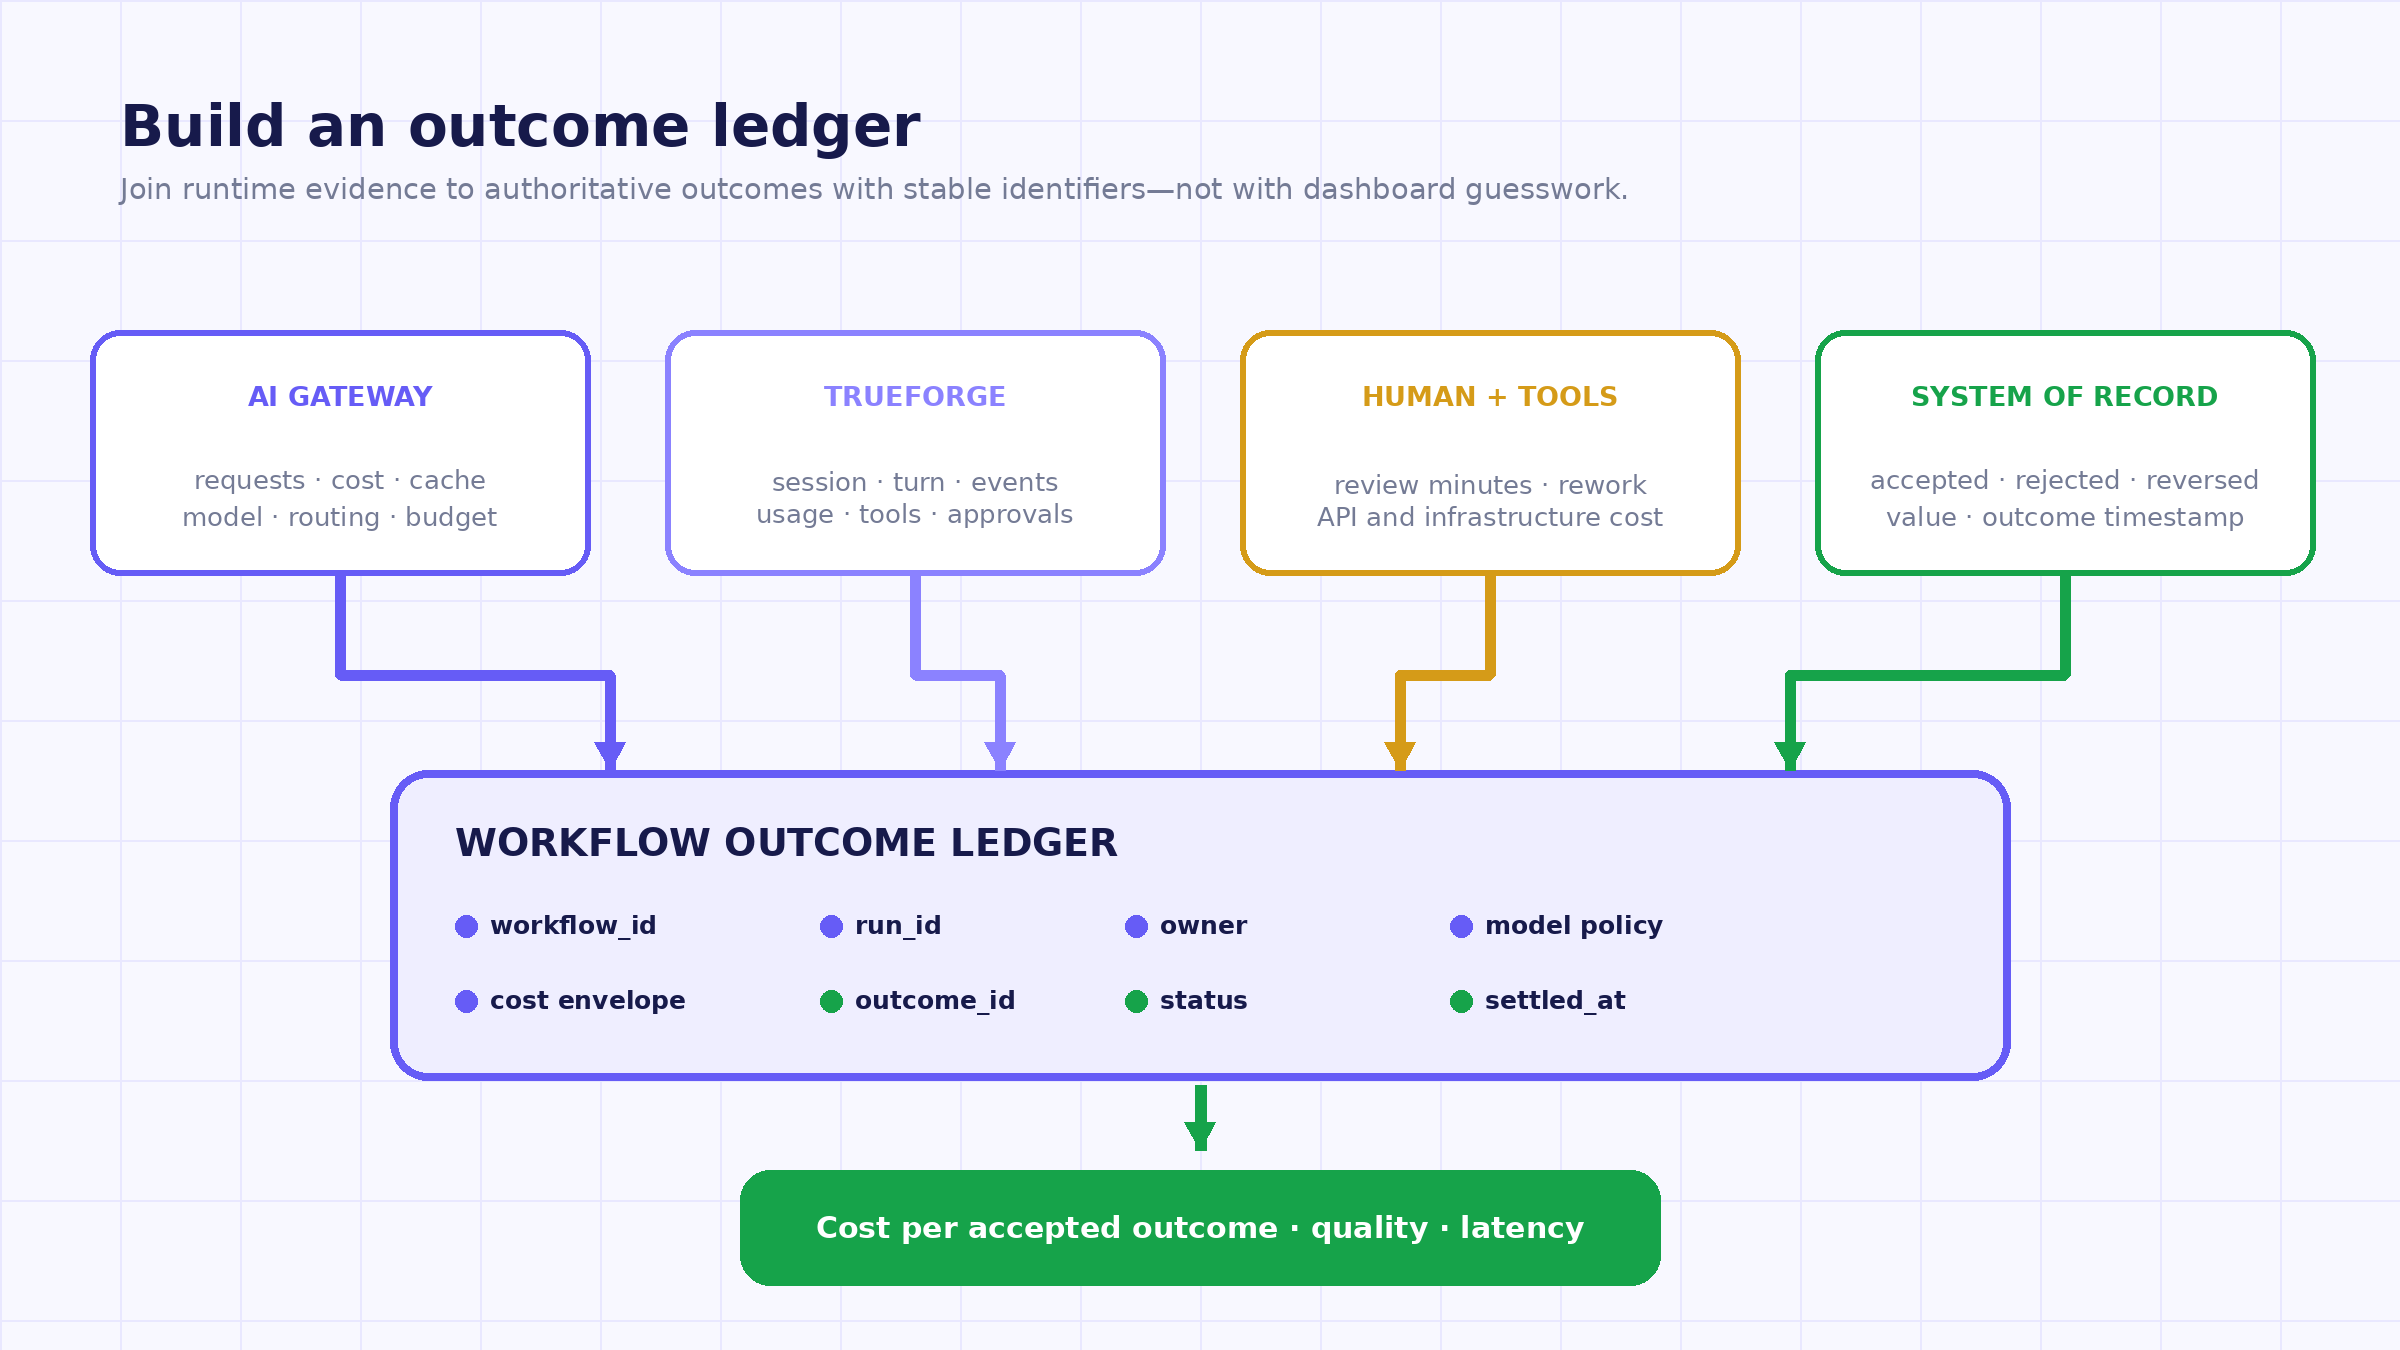
Los metadatos personalizados son el tejido conectivo. Una solicitud de puerta de enlace debe incluir el ID de ejecución del flujo de trabajo, el propietario, el entorno, el límite del cliente o producto y el centro de costes cuando proceda. El tiempo de ejecución debe preservar la misma identidad de ejecución a través de los turnos y la actividad de las herramientas. La aplicación debe escribir ese ID de ejecución junto al resultado final en el sistema de registro.
No incluya contenido confidencial en las etiquetas solo porque los metadatos sean convenientes. Utilice identificadores opacos, aplique una lista de permitidos y resuelva los detalles comerciales dentro del entorno de análisis autorizado. La atribución debe mejorar la responsabilidad sin convertir los campos de observabilidad en una nueva superficie de fuga de datos.
El coste de inferencia suele conocerse en cuestión de segundos. Los resultados comerciales pueden liquidarse minutos, días o meses después. Un agente de programación puede terminar su turno hoy mientras el cambio se implementa la próxima semana. Una conversación de servicio puede cerrarse ahora y reabrirse más tarde. Un asistente de ventas puede redactar un correo electrónico cuyo efecto comercial sea imposible de conocer durante un trimestre.
Por lo tanto, el libro mayor necesita estados:
Esto evita un error de informe sutil: comparar el coste total de hoy con los resultados incompletos de hoy. Los paneles deben mostrar ventanas de cohorte y cobertura de liquidación. Si solo el 60% de las ejecuciones son lo suficientemente maduras como para ser evaluadas, el coste aparente por éxito es provisional.
Un resultado vinculado a una ejecución de IA es atribuible en el sentido de base de datos; no es causado automáticamente por la IA. La estacionalidad, la dotación de personal, los cambios de política, los cambios de producto y los efectos de selección pueden mover la misma métrica.
Para decisiones importantes, establezca una línea base y utilice un diseño experimental o cuasi-experimental siempre que sea posible: grupos de control aleatorios, despliegues por etapas, cohortes emparejadas o análisis de series temporales interrumpidas. Como mínimo, registre la versión de la política de producción y compare segmentos de flujo de trabajo equivalentes.
Esta distinción es especialmente importante cuando el esfuerzo humano se desplaza en lugar de desaparecer. Si un asistente redacta más rápido pero genera más trabajo de revisión posteriormente, una métrica de productividad local puede aumentar mientras que el coste integral no lo hace. El denominador debe seguir el flujo de trabajo a través de los límites organizativos.
BCG propone eliminar el uso innecesario de modelos, enrutar según la complejidad de la tarea, reutilizar el contexto y los componentes, y capacitar para la disciplina de tokens. Esas son palancas sensatas. Pero cada una puede afectar a la calidad, la latencia y el riesgo, por lo que la optimización requiere un bucle de control en lugar de un recorte de costes puntual.

La aritmética, las búsquedas exactas, los umbrales de política, la validación de esquemas y el enrutamiento determinista suelen pertenecer al software convencional. Esto puede reducir costes y mejorar la fiabilidad. La decisión de diseño importante no es eliminar el razonamiento indiscriminadamente, sino preservarlo para la ambigüedad y el juicio.
Un modelo más pequeño o de pesos abiertos puede ser el caballo de batalla adecuado para tareas rutinarias, reservando un modelo más capaz para los casos más difíciles. Pero el enrutamiento es un experimento, no una promesa. Mida la tasa de escalada, los reintentos, la calidad aceptada, la latencia y el tiempo de revisión por ruta. Un precio de solicitud más bajo que aumente los bucles de fallo puede hacer que el resultado sea más caro.
Los prefijos estables, el almacenamiento en caché de prompts del proveedor, el almacenamiento en caché de respuestas de la puerta de enlace, la ejecución por lotes, la disciplina de recuperación y la carga diferida pueden reducir el trabajo repetido. Son mecanismos diferentes con semánticas diferentes. El almacenamiento en caché de prompts del proveedor reutiliza el procesamiento de prompts mientras sigue generando una nueva respuesta. El almacenamiento en caché de respuestas exactas o semánticas puede evitar la llamada al modelo, pero necesita controles de aislamiento, caducidad y corrección. Los prompts y habilidades versionados mejoran la reutilización y la gobernanza; por sí mismos, no garantizan la capacidad de almacenamiento en caché.
Establezca el máximo de turnos, intentos de herramientas, esfuerzo de razonamiento, presupuestos de contexto y límites de salida adecuados para el flujo de trabajo. Registre por qué se detuvo una ejecución. Una regla de parada debe distinguir entre éxito, transferencia a humanos, bloqueo de política, tiempo de espera, presupuesto agotado y error irrecuperable. De lo contrario, una reducción de costes puede parecer simplemente más trabajo abandonado.
Imaginemos un flujo de trabajo de revisión de documentos en el que se elige entre un modelo más ligero y otro con mayor capacidad. Las cifras que aparecen a continuación son unidades de coste normalizadas a modo de ejemplo, no datos de referencia.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada