October 24, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Los equipos de ingeniería comparan LiteLLM y Vercel AI cuando las integraciones directas con proveedores se vuelven difíciles de gestionar. Ambos simplifican el acceso a múltiples proveedores de LLM y reducen el trabajo de integración específico para cada modelo. También proporcionan una interfaz estandarizada para que las aplicaciones de IA cambien de modelo sin necesidad de realizar cambios repetidos en el código.
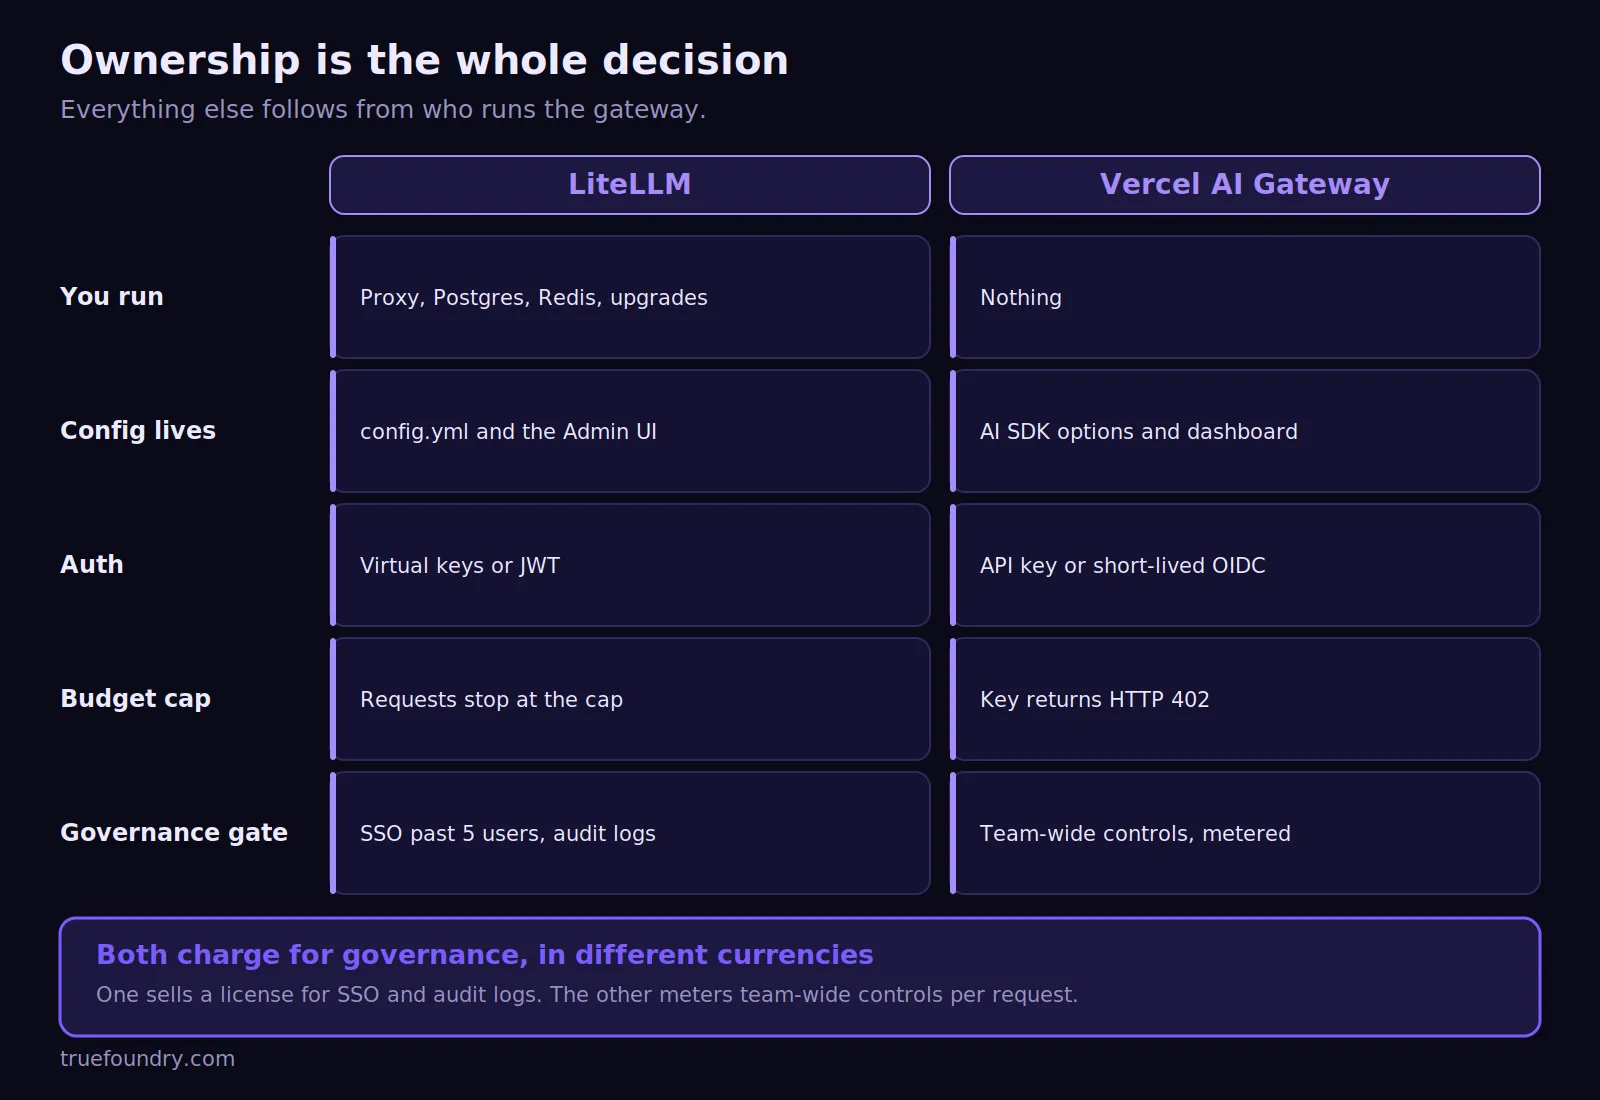
La diferencia clave radica en la propiedad operativa de ambas plataformas. LiteLLM es una puerta de enlace de IA y un servidor proxy de código abierto que se aloja en los propios servidores. Vercel AI Gateway es un servicio gestionado y alojado que se centra en la experiencia del desarrollador. LiteLLM se ejecuta en tu propia infraestructura, mientras que Vercel gestiona la puerta de enlace.
TrueFoundry cobra relevancia cuando las empresas necesitan una gobernanza más amplia sobre modelos, herramientas, agentes y presupuestos.
La forma más útil de comparar LiteLLM y Vercel AI es a través de la propiedad. LiteLLM ofrece a los equipos un proxy que ellos mismos ejecutan y personalizan. Los equipos de plataforma controlan el enrutamiento, los límites de velocidad, los presupuestos, las credenciales de los proveedores y el despliegue. El servidor proxy de LiteLLM también es compatible con un SDK de Python. Las llamadas a la API pueden incluir metadatos a través de cabeceras HTTP.
Vercel AI Gateway adopta un enfoque gestionado. Los equipos de producto obtienen una clave de API, BYOK, tokens OIDC, enrutamiento y observabilidad. Las integraciones compatibles con OpenAI pueden migrarse simplemente cambiando la URL base. El SDK de Vercel AI también se conecta sin necesidad de mantenimiento de la puerta de enlace.
La propiedad genera costes operativos diferentes. LiteLLM utiliza Postgres para la gestión de equipos, claves virtuales, presupuestos y control de acceso. Vercel opera el servicio mientras los equipos configuran el enrutamiento y los proveedores.
LiteLLM es adecuado para equipos que buscan enrutamiento autohospedado y control de costes. Su núcleo bajo licencia MIT es compatible con más de 140 proveedores a través de una interfaz unificada. Los equipos pueden conectar modelos internos, Google Vertex, Amazon Bedrock, AWS Bedrock y otros proveedores externos.
El nivel gratuito incluye claves virtuales, presupuestos, limitación de velocidad, alternativas (fallbacks) y métricas de Prometheus. LiteLLM admite el equilibrio de carga entre proveedores, regiones y claves. El enrutamiento automático y por menor coste permite elegir proveedores de modelos según el precio o la complejidad. TrueFoundry’s guía de equilibrio de carga de LLM explica estas rutas de tráfico en cargas de trabajo de producción.
LiteLLM va ahora más allá de un proxy básico con capacidades de LLM, MCP y agentes. El uso permite realizar un seguimiento de claves, usuarios, equipos, herramientas, agentes y servidores MCP en casos de uso más amplios.
El inconveniente sigue siendo la propiedad operativa que se exige a los equipos de ingeniería. Los equipos deben gestionar el despliegue, las actualizaciones, el almacenamiento, la seguridad y la fiabilidad. La versión Enterprise añade SSO, SCIM, registros de auditoría, gestión de secretos, controles multirregión y soporte. El precio se basa en presupuesto y depende de la capacidad anual de la puerta de enlace y de los requisitos de despliegue.
Elige LiteLLM cuando:
Vercel AI Gateway es la opción más sólida para equipos pequeños que ya desarrollan sobre Vercel. Un único punto de conexión sirve a múltiples modelos con una sola credencial y sin recargos por token. Los equipos pueden utilizar credenciales del sistema o sus propias claves, mientras que las integraciones existentes con OpenAI pueden migrarse simplemente cambiando la URL base.
La ventaja práctica reside en una configuración más rápida y una menor carga operativa. Los desarrolladores pueden cambiar de proveedor, revisar analíticas de uso y establecer presupuestos sin necesidad de gestionar una pasarela. La documentación de Vercel AI Gateway cubre AI SDK, OpenAI Chat Completions, Responses y Anthropic Messages a través de una interfaz unificada.
Vercel ofrece conmutación por error automática entre proveedores que ofrecen el mismo modelo de IA. Los equipos pueden realizar pruebas A/B de prompts mediante enrutamiento controlado y clasificar a cada proveedor compatible según el coste, el tiempo hasta el primer token o el rendimiento. El modelo BYOK permite usar tiempos de espera del proveedor, mientras que la lógica de respaldo redirige el tráfico fallido.
La política de retención de datos cero para todo el equipo restringe las solicitudes a los proveedores cubiertos por los acuerdos de Vercel. Las listas de permitidos de proveedores limitan el tráfico del equipo. La retención de datos a nivel de proveedor aún requiere revisión para cargas de trabajo reguladas.
Elija Vercel AI Gateway cuando:
La decisión entre Vercel AI y LiteLLM se vuelve más clara al analizar el enrutamiento y la monitorización. LiteLLM controla la limitación de tasa, los respaldos, el enrutamiento de proveedores y el registro de eventos. El proxy expone una única API para todas las implementaciones.
Vercel proporciona monitorización integrada a través de su panel de control. Los equipos pueden revisar las solicitudes, el coste, la latencia, el uso de tokens y el comportamiento del proveedor. El enrutamiento puede priorizar el coste, el rendimiento o la baja latencia sin necesidad de gestionar el plano de datos. La latencia de cola sigue dependiendo de los proveedores ascendentes y de los modelos seleccionados.
Para las empresas, observabilidad de gateways de IA debería conectar el enrutamiento con los fallos, el coste y la actividad de las políticas. Un puerta de enlace de LLM (LLM Gateway) dedicado puede centralizar el acceso de los proveedores en todo el tráfico de producción.
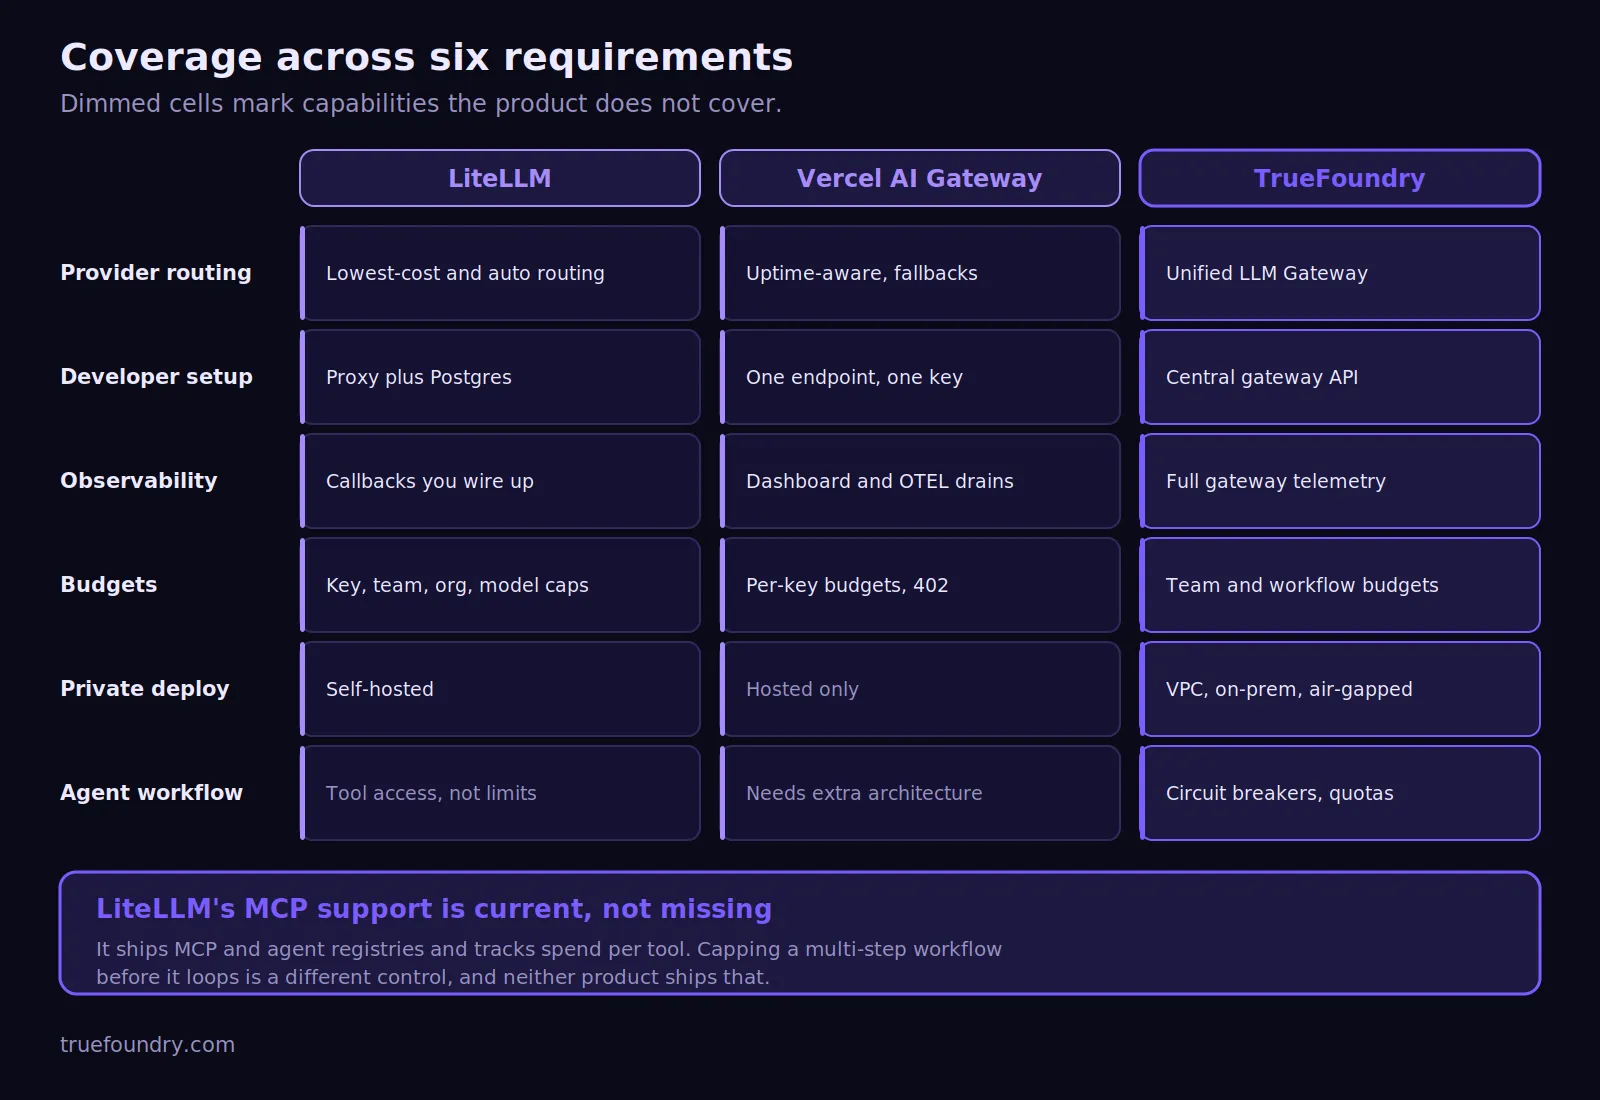
LiteLLM cubre ahora MCP y agentes de forma más profunda de lo que sugieren comparaciones anteriores. Los compradores deben seguir separando el acceso a herramientas de los límites de flujo de trabajo. Gobernar una llamada a una herramienta es diferente a controlar una secuencia completa de llamadas de agentes.
El precio debe reflejar el coste total de propiedad que requiere cada modelo operativo. La pasarela de código abierto de LiteLLM no tiene cuota de licencia, mientras que los precios para empresas son personalizados. Estos se calculan en función de la capacidad de solicitudes anuales, la arquitectura de despliegue y las necesidades de soporte. Los equipos siguen financiando por su cuenta la infraestructura de soporte y las operaciones continuas.
La versión Enterprise añade SSO, SCIM, registros de auditoría, gestión de secretos, capacidades multirregión y soporte. Esto sustituye a la antigua suposición de precios públicos del borrador. El análisis de TrueFoundry sobre los precios empresariales de LiteLLM proporciona información detallada sobre los factores que influyen en los costes operativos.
Vercel utiliza créditos prepagados y cobra el precio de lista del proveedor sin añadir márgenes por token. Su nivel gratuito incluye 5 dólares cada 30 días hasta que comienza la facturación. Las compras con tarjeta pueden conllevar comisiones por procesamiento de pagos, mientras que la facturación está disponible sin ellas.
Algunos controles de gobernanza también conllevan medidores de uso independientes para los equipos. El ZDR para todo el equipo cuesta 0,10 dólares por cada 1.000 solicitudes. Los informes personalizados cobran 0,075 dólares por cada 1.000 valores escritos y 5 dólares por cada 1.000 consultas. Estos costes adicionales son importantes a medida que el tráfico de producción aumenta entre los equipos.
Las empresas deben comparar el software, la infraestructura, las operaciones y el control de costes de forma conjunta una vez que el despliegue privado y una gobernanza más amplia se convierten en requisitos.
La comparación entre LiteLLM y Vercel AI ya no es una simple elección entre un proxy y un servicio alojado. LiteLLM cubre modelos, MCP, agentes y gobernanza. Vercel tiene mejores presupuestos y controles de proveedores. Las carencias restantes tienen que ver con los flujos de trabajo completos de los agentes.
La IA en producción puede comenzar como una llamada a un LLM, continuar a través de herramientas del Protocolo de Contexto de Modelos (MCP) y activar más acciones. Es posible que las empresas necesiten identidad, presupuestos y pruebas de auditoría a lo largo de toda esa cadena. TrueFoundry MCP Gateway gobierna el acceso a las herramientas, mientras que el Agent Gateway gobierna la ejecución de los agentes.
Las áreas comunes que se deben evaluar incluyen:
La decisión entre Vercel AI o LiteLLM debe reflejar los requisitos de gobernanza actuales. Los equipos que comparen otra opción gestionada, como Kong AI Gateway, deberían aplicar la misma prueba de propiedad.
TrueFoundry es una opción adecuada cuando las empresas desean una capa de gobernanza única para modelos, herramientas y agentes. Su puerta de enlace de IA (AI Gateway) centraliza el enrutamiento, los presupuestos, las medidas de seguridad, la observabilidad y el acceso a proveedores en despliegues SaaS y privados.
LiteLLM ofrece a los equipos una pasarela que ellos mismos operan, mientras que Vercel proporciona una pasarela de modelos alojada. TrueFoundry integra la gobernanza de modelos, MCP y agentes con opciones de despliegue privado.
La aplicación es declarativa y reside en el control de versiones. Las reglas se evalúan en orden y la primera coincidencia es la que prevalece:
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  # Cap one contractor account on a specific model
  - id: "contractor-gpt4-daily"
    when:
      subjects: ["user:contractor@example.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day

  # Give every user an independent daily token budget
  - id: "user-daily-limit"
    when: {}
    limit_to: 1000000
    unit: tokens_per_day
    rate_limit_applies_per: ['user']
El campo `rate_limit_applies_per` crea un contador independiente por entidad, por lo que una única regla cubre a todos los usuarios sin necesidad de generar una regla por identidad. Una solicitud que supera su límite devuelve un error HTTP 429, indicando la regla que se activó, junto con una cabecera `x-tfy-applied-rules`:
{
  "status": "failure",
  "message": "Rate limit exceeded for model: openai-main/gpt4 with rule: contractor-gpt4-daily",
  "error": {
    "type": "RateLimitError",
    "code": "429"
  },
  "error_origin_level": "rate_limit_budget"
}
TrueFoundry es más relevante cuando:
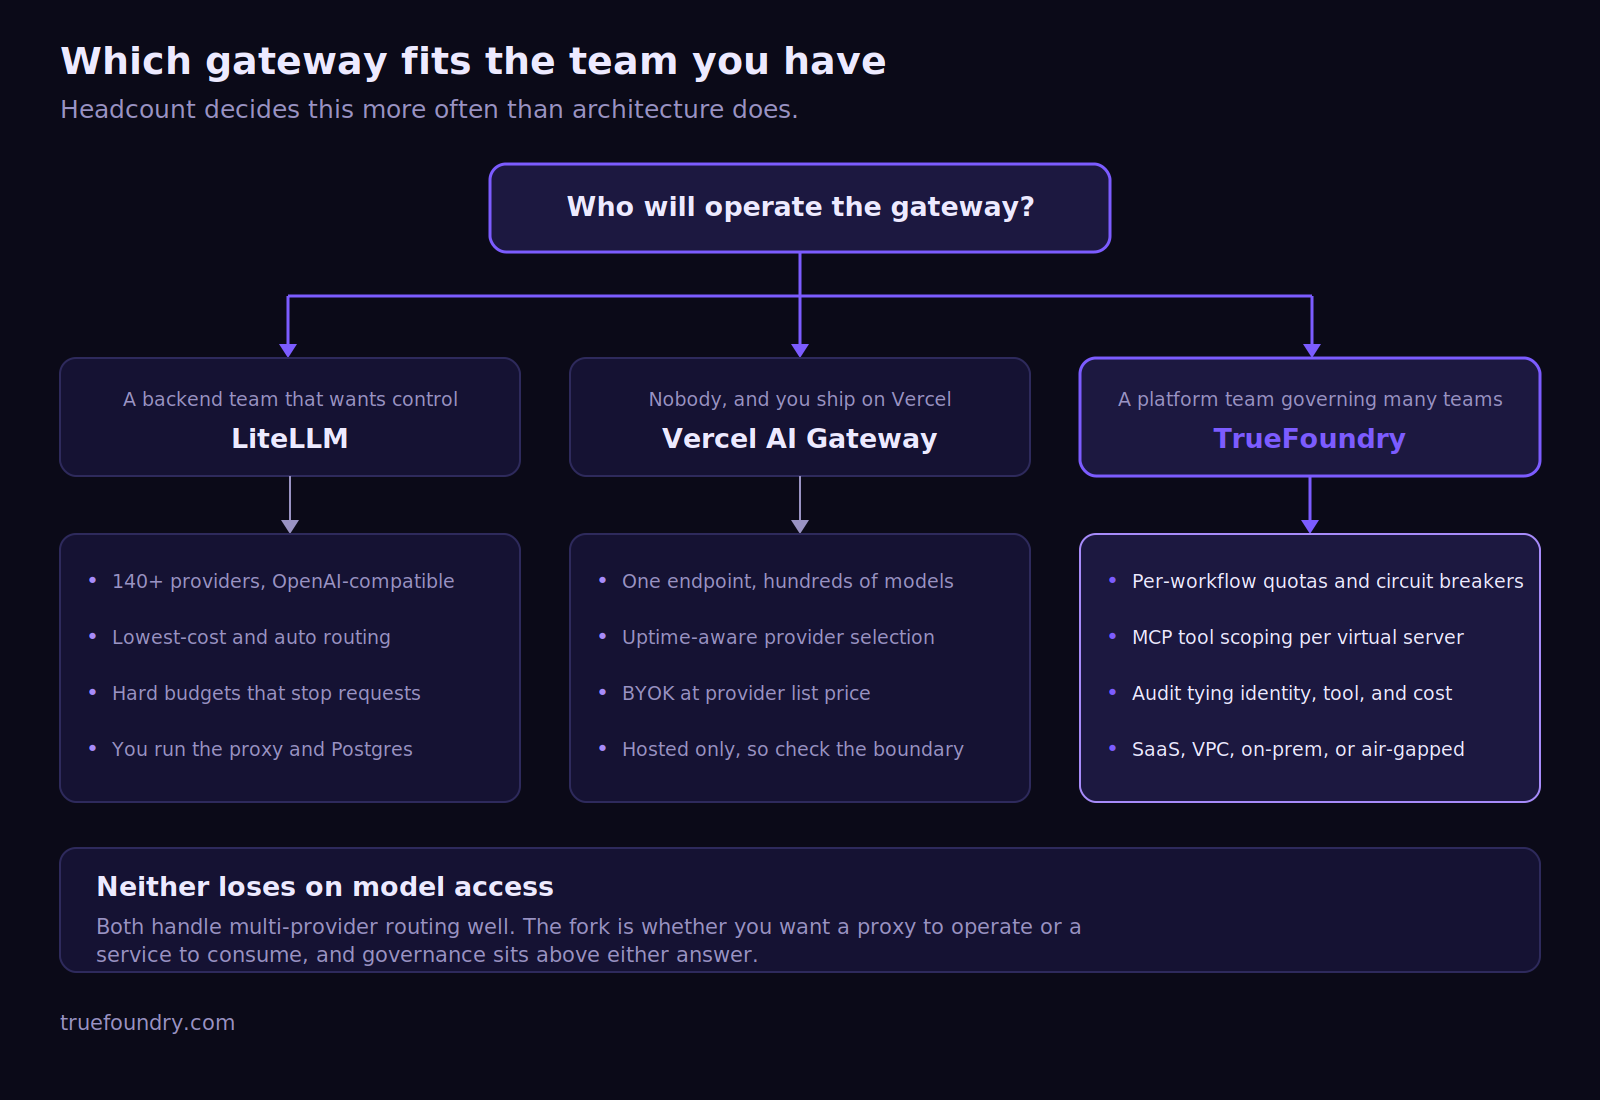
Elija LiteLLM cuando su equipo busque control autohospedado, flexibilidad de código abierto, claves virtuales, presupuestos y operaciones personalizadas. Su plataforma ahora abarca modelos, MCP y agentes, lo que la hace más sólida cuando los equipos de plataforma pueden gestionar las operaciones.
Elija Vercel AI Gateway cuando su equipo utilice Vercel y busque un acceso rápido a modelos, BYOK y la fiabilidad de un servicio alojado. Es más eficaz cuando la velocidad de entrega es más importante que la propiedad privada de la pasarela.
Elija TrueFoundry cuando la ejecución gobernada deba abarcar modelos, herramientas MCP, agentes y presupuestos. También es adecuado para entornos de producción privados o gestionados que requieran pruebas de auditoría.
La decisión entre LiteLLM y Vercel AI se reduce, ante todo, a la propiedad. LiteLLM proporciona control de infraestructura, mientras que Vercel ofrece un servicio alojado. TrueFoundry encaja cuando el enfoque principal pasa a ser una gobernanza de IA más amplia.
Reserva una demostración con TrueFoundry para evaluar sus requisitos de pasarela, MCP, agentes, despliegue y gobernanza.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada