



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
AI-assisted coding tools like OpenCode fundamentally change how developers interact with code. Instead of operating on isolated snippets, these systems reason across files, dependencies, and historical context. The result is a significant productivity boost but also a new cost and scalability challenge that many teams underestimate: token usage.
Unlike traditional developer tools with predictable licensing costs, OpenCode usage is governed by token-based pricing. Every interaction, code generation, refactoring, debugging, or review - consumes tokens. As teams scale usage across developers, repositories, and automated agents, token consumption becomes the primary cost driver.
What makes this particularly tricky is that token usage is often non-intuitive. Small changes in context size, prompt structure, or agent behavior can result in large swings in token consumption. Without a clear mental model of how tokens are used, teams struggle to predict costs, optimize workflows, or enforce guardrails.
This blog breaks down how token usage works in OpenCode at a technical level, why code-related workloads are especially token-heavy, and what platform teams should understand before scaling usage in production.
At its core, OpenCode token usage follows the same mechanics as most LLM-powered systems: tokens are consumed for both inputs and outputs. However, the nature of coding workloads introduces additional complexity.
OpenCode token usage can be broadly divided into two categories:
In OpenCode, prompt tokens typically include:
Completion tokens include:
From a cost perspective, prompt tokens are often the dominant factor in OpenCode usage, especially as repositories and context sizes grow.
Code-related tasks behave very differently from natural language queries. Several factors contribute to higher token consumption:
Unlike chat-based use cases, OpenCode often sends:
Even a “small” codebase can quickly translate into tens or hundreds of thousands of tokens when multiple files are included.
Source code is dense. Syntax, indentation, symbols, and formatting all count toward tokens. A few thousand lines of code can consume far more tokens than an equivalent amount of plain text.
OpenCode workflows frequently involve:
Each step may re-send context or intermediate outputs, multiplying token usage across a single task.
When OpenCode is used via agents or automation (for example, refactoring across multiple files or running in CI pipelines), token usage compounds quickly:
This makes agent-driven usage powerful but also expensive if not bounded.
One of the biggest challenges with OpenCode token usage is that developers rarely see the full context being sent to the model. Editors and tools abstract away:
As a result, two seemingly similar tasks can have wildly different token footprints. Without explicit tracking at the request level, teams often discover cost issues only after usage spikes.
This is why understanding token mechanics is not enough on its own. Teams need visibility into actual token consumption per task, per developer, and per workflow to make informed optimization decisions.
Understanding token usage is important for any AI-powered application, but it becomes especially critical as AI adoption scales across developers, agents, and enterprise platforms. Monitoring and optimizing token consumption helps organizations control costs, improve efficiency, and maintain predictable AI spending.
AI coding assistants such as OpenCode, Claude Code, and similar tools frequently process large codebases, extensive context windows, and multi-turn conversations. As developers interact with these tools throughout the day, token consumption can grow quickly.
Tracking token usage helps engineering teams:
AI agents often perform complex workflows involving planning, reasoning, tool usage, retrieval, and code generation. These multi-step interactions can generate significantly higher token usage than traditional chat applications.
Monitoring token consumption enables teams to:
As agent deployments grow, token visibility becomes essential for maintaining predictable operational costs.
Large organizations frequently deploy AI applications across multiple teams, products, and business units. Without centralized visibility, it can be difficult to understand how tokens are being consumed and where costs are increasing.
Organizations use token monitoring to:
As AI adoption expands, token usage becomes an important operational metric alongside latency, reliability, and model performance. Organizations that actively monitor and optimize token consumption are often better positioned to scale AI workloads efficiently while controlling costs.
Most spikes in OpenCode token usage are not caused by a single obvious mistake. They emerge from how OpenCode is used in real-world engineering workflows—especially when tools and agents are integrated deeply into development and automation pipelines.
Hier sind die häufigsten Szenarien, die den Token-Verbrauch unverhältnismäßig in die Höhe treiben.
Einer der größten Faktoren für einen hohen Token-Verbrauch ist die zu umfassende Einbindung von Kontext. Viele OpenCode-Workflows schließen „zur Sicherheit“ ganze Verzeichnisse oder große Teile eines Repositories ein, selbst wenn nur ein kleiner Teil des Codes relevant ist.
Beispiele hierfür sind:
Da die Prompt-Token linear mit der Kontextgröße skalieren, kann allein dieses Muster die Kosten schnell vervielfachen.
OpenCode arbeitet oft iterativ: Code generieren, überprüfen, anpassen, neu generieren. In vielen Setups wird bei jeder Iteration der vollständige Kontext erneut gesendet, einschließlich der Dateien und vorheriger Ausgaben.
Dies führt zu:
Ohne Caching oder intelligente Wiederverwendung von Kontext wird die Iteration zu einem der kostspieligsten Muster.
Wenn OpenCode über Agenten oder automatisierte Workflows genutzt wird, kann der Token-Verbrauch schnell eskalieren, wenn die Ausführung nicht explizit begrenzt wird.
Zu den häufigsten Ursachen gehören:
Da diese Prozesse oft im Hintergrund ablaufen, bemerken Teams eine ausufernde Nutzung häufig erst, wenn die Kosten in die Höhe schnellen.
Refactoring- und Review-Aufgaben sind in der Regel tokenintensiver als die Codegenerierung, da sie Folgendes erfordern:
Wenn diese Aufgaben auf große Codebasen oder mehrere Pull Requests angewendet werden, steigt der Token-Verbrauch erheblich an.
Die Einbettung von OpenCode in CI-Pipelines oder Automatisierungsworkflows bringt ein anderes Risikoprofil mit sich. Diese Systeme:
Selbst ein moderater Token-Verbrauch pro Durchlauf kann teuer werden, wenn er sich über viele Builds oder Deployments summiert.
Einer der am häufigsten übersehenen Faktoren für einen hohen Token-Verbrauch ist schließlich das Fehlen von TransparenzWenn Teams nicht sehen können:
Wird die Optimierung zum Ratespiel. Teams reagieren oft mit einer globalen Einschränkung der Nutzung, anstatt die spezifischen Workflows anzugehen, die die Kosten in die Höhe treiben.
Sobald Teams verstehen, woher der Token-Verbrauch stammt, ist der nächste Schritt die Optimierung. Wichtig ist: Bei der Optimierung geht es nicht darum, die Nutzung willkürlich zu begrenzen, sondern darum, Tokens gezielt einzusetzen , damit Produktivitätsgewinne nicht zu unkontrollierten Kosten führen.
Im Folgenden finden Sie praktische Best Practices, mit denen sich die OpenCode-Token-Nutzung konsequent reduzieren lässt, ohne die Qualität der Ergebnisse zu beeinträchtigen.
Der effektivste Hebel zur Optimierung ist die Kontrolle darüber, welcher Kontext an das Modell gesendet wird. Mehr Kontext ist nicht immer besser, insbesondere wenn er irrelevant ist.
Zu den praktischen Techniken gehören:
Eine gute Faustregel: Wenn eine Datei nicht erforderlich ist, um die Änderung nachzuvollziehen, sollte sie nicht Teil des Prompts sein.
Anstatt vorab große Mengen an Code zu senden, sollten Teams auf bedarfsorientiertes Abrufenhandelt.
Beispiele:
Dieser Ansatz reduziert die Prompt-Größe und verbessert oft die Qualität der Schlussfolgerungen, da das Modell gezieltere Informationen erhält.
Allgemeine Prompts führen tendenziell zu breiteren Überlegungen und umfangreicheren Ausgaben, was sowohl die Prompt- als auch die Completion-Token erhöht.
Bessere Muster:
Aufgabenbezogene Prompts reduzieren nicht nur den Token-Verbrauch, sondern verbessern auch die Vorhersehbarkeit.
Agentenbasierte Workflows erhöhen den Token-Verbrauch, wenn sie nicht kontrolliert werden. Jeder Agent sollte innerhalb klar definierter Grenzen arbeiten.
Wichtige Leitplanken sind:
Ohne diese Begrenzungen können Agenten unbeabsichtigt große Kontexte mehrfach verarbeiten, was den Verbrauch in die Höhe treibt.
Viele OpenCode-Workflows wiederholen ähnliche Aufgaben über Iterationen oder Benutzer hinweg. Caching kann den redundanten Token-Verbrauch erheblich reduzieren.
Anwendbare Szenarien:
Selbst teilweises Caching auf Workflow-Ebene kann zu deutlichen Einsparungen führen.
Während Prompt-Token oft dominieren, spielen auch Completion-Token eine wichtige Rolle, insbesondere bei Refactoring- oder erklärungsintensiven Workflows.
Zu den Techniken gehören:
Klare Vorgaben für die Ausgabe reduzieren unnötige Ausführlichkeit.
Optimierung sollte nicht reaktiv erfolgen. Teams sollten den Token-Verbrauch von Anfang an erfassenhandelt.
Dies bedeutet mindestens die Nachverfolgung von:
Ohne diese Daten können Teams nicht zwischen produktiver Nutzung und Verschwendung unterscheiden.
Die meisten Teams haben zu Beginn keine Probleme mit dem OpenCode-Token-Verbrauch. Die Schwierigkeiten treten schleichend auf, wenn sich die Nutzung auf Entwickler, Repositories und automatisierte Workflows ausweitet. Was als individuelles Produktivitätswerkzeug beginnt, entwickelt sich schnell zu einer gemeinsam genutzten Infrastruktur, bei der der Token-Verbrauch auf eine Weise skaliert, die nur schwer vorhersehbar oder steuerbar ist.
Bei zunehmender Skalierung wird OpenCode nicht mehr nur von einem einzelnen Entwickler im Editor verwendet. Es wird genutzt von:
Jeder dieser Verbraucher generiert unabhängig voneinander Token-Verbrauch. Ohne eine zentrale Übersicht wird es schwierig, grundlegende Fragen zu beantworten, wie etwa wer Token verbraucht,zu welchem Zwecksowiezu welchen Kostenhandelt.
Frühe Optimierungsbemühungen werden oft auf Anwendungs- oder Tool-Ebene implementiert, etwa durch benutzerdefinierte Prompt-Limits, Kontextkürzungen oder Wiederholungslogiken. Obwohl diese lokal helfen, lassen sie sich nicht auf folgende Bereiche skalieren:
Infolgedessen werden Richtlinien fragmentiert und inkonsistent. Ein Team optimiert aggressiv, während ein anderes unwissentlich die Kosten in die Höhe treibt.
Automatisierung verändert die Kalkulation. Ein Workflow, der pro Durchlauf eine moderate Anzahl an Token verbraucht, kann teuer werden, wenn er:
Da diese Jobs ohne direkte menschliche Sichtbarkeit ablaufen, summieren sich Ineffizienzen schnell. Spitzen im Token-Verbrauch entstehen oft durch Automatisierung statt durch interaktive Nutzung.
Ohne eine detaillierte Zuordnung sehen Teams nur aggregierte Nutzungszahlen. Das macht Optimierungen reaktiv und unpräzise.
Häufige Fehlerquellen sind:
Effektive Kontrolle erfordert das Wissen darüber, welche Workflows einen Mehrwert schaffen und welche Verschwendung erzeugen – etwas, das aggregierte Kennzahlen nicht aufzeigen können.
In vielen Unternehmen schreitet die Einführung von KI-Tools schneller voran als die Governance. Die Nutzung von OpenCode verbreitet sich schneller, als:
Wenn die Token-Nutzung zum Problem wird, sind die Tools bereits tief in den Arbeitsabläufen verankert, was nachträgliche Kontrollen schwierig und störend macht.
Das Kernproblem ist nicht der Missbrauch, sondern dezentrale Nutzung ohne zentrale Kontrolle. Da OpenCode zu einer gemeinsam genutzten Infrastruktur wird, muss die Token-Nutzung genauso verwaltet werden wie Rechenleistung, Speicher oder CI-Ressourcen.
Dies erfordert:
Ohne diesen Wandel bleibt die Token-Nutzung unvorhersehbar und Optimierungsbemühungen bleiben reaktiv.
Sobald die OpenCode-Nutzung produktiven Maßstab erreicht, funktionieren Ad-hoc-Tracking und manuelle Optimierungen nicht mehr. In dieser Phase muss die Token-Nutzung wie jede andere gemeinsam genutzte Infrastrukturressource behandelt werden – kontinuierlich gemessen, zentral gesteuert und an Verantwortlichkeiten gebundenhandelt.
Viele Teams beginnen damit, den Token-Verbrauch innerhalb einzelner Tools oder Workflows zu erfassen. Während dies lokale Einblicke bietet, stößt es schnell an Grenzen, wenn:
Jede Integration meldet den Verbrauch anders, und keine bietet eine ganzheitliche Sicht. Infolgedessen fehlt Plattform-Teams eine zentrale Datenquelle für den Token-Verbrauch.
Bei zunehmender Skalierung muss das Monitoring auf der Anfrageebeneerfolgen, nicht nur auf der Tool-Ebene. Effektive Setups erfassen:
Dies ermöglicht es Teams, Fragen zu beantworten wie:
Ohne diese Granularität bleiben Optimierungsbemühungen oberflächlich und oft ineffektiv.
Governance beginnt mit der Zuordnung. Die Token-Nutzung muss den Eigentümern zugewiesen werden, die darauf reagieren können.
Gängige Zuordnungsmodelle sind:
Sobald die Verantwortlichkeit geklärt ist, verlagert sich die Kostendiskussion von abstrakter Budgetierung hin zu konkreten Entscheidungen darüber, welche Workflows einen ausreichenden Mehrwert bieten.
Überwachung allein verhindert keine Kostenüberschreitungen. Produktionssysteme erfordern Durchsetzungsmechanismen , die in Echtzeit arbeiten.
Typische Leitplanken sind:
Diese Kontrollen sollten zentral durchgesetzt werden, damit alle OpenCode-gestützten Workflows sie automatisch übernehmen.
Der gemeinsame Nenner effektiver Governance-Strukturen ist Zentralisierung. Richtlinien, Limits und Transparenz für die Token-Nutzung müssen an einem gemeinsamen Kontrollpunkt angesiedelt sein, anstatt sie in jedem Tool einzeln neu zu implementieren.
Hier kommen infrastrukturorientierte Plattformen wie TrueFoundry natürlich ins Spiel. Durch die Zentralisierung von KI-Traffic, Observability und der Durchsetzung von Richtlinien können Plattformteams die OpenCode-Token-Nutzung über Entwickler, Agenten und automatisierte Systeme hinweg konsistent verwalten – ohne einzelne Teams auszubremsen.
Mit zunehmender Verbreitung von KI wird die Nachverfolgung und Steuerung der Token-Nutzung immer wichtiger. Während einzelne Entwickler den Token-Verbrauch oft manuell verwalten können, benötigen Unternehmen, die mehrere Anwendungen, Teams und Modelle betreiben, in der Regel eine zentrale Transparenz und Governance.
Manuelle Überwachung kann bei kleinen Bereitstellungen funktionieren, wird jedoch oft schwierig, wenn es darum geht, Ausgaben nachzuverfolgen, Ineffizienzen zu identifizieren und Nutzungsbeschränkungen bei der Skalierung von KI-Workloads durchzusetzen. KI-Gateways bieten eine zentrale Ebene zur Überwachung der Token-Nutzung, zur Kostenverwaltung und zur Optimierung der Modellauslastung im gesamten Unternehmen.
Aus Plattformperspektive besteht die größte Herausforderung bei der OpenCode-Token-Nutzung nicht darin zu verstehen, wie Token verbraucht werden, sondern wo Kontrolle und Transparenz angesiedelt sein sollten.
TrueFoundry geht dieses Problem an, indem KI- und LLM-Nutzung – einschließlich entwicklerorientierter Tools wie OpenCode – als gemeinsam genutzte Infrastruktur betrachtet wird, die standardmäßig beobachtbar, steuerbar und kostenbewusst sein muss. Im Zentrum dieses Ansatzes steht das AI Gateway, das als Steuerungsebene für den gesamten LLM-Traffic im Unternehmen fungiert.
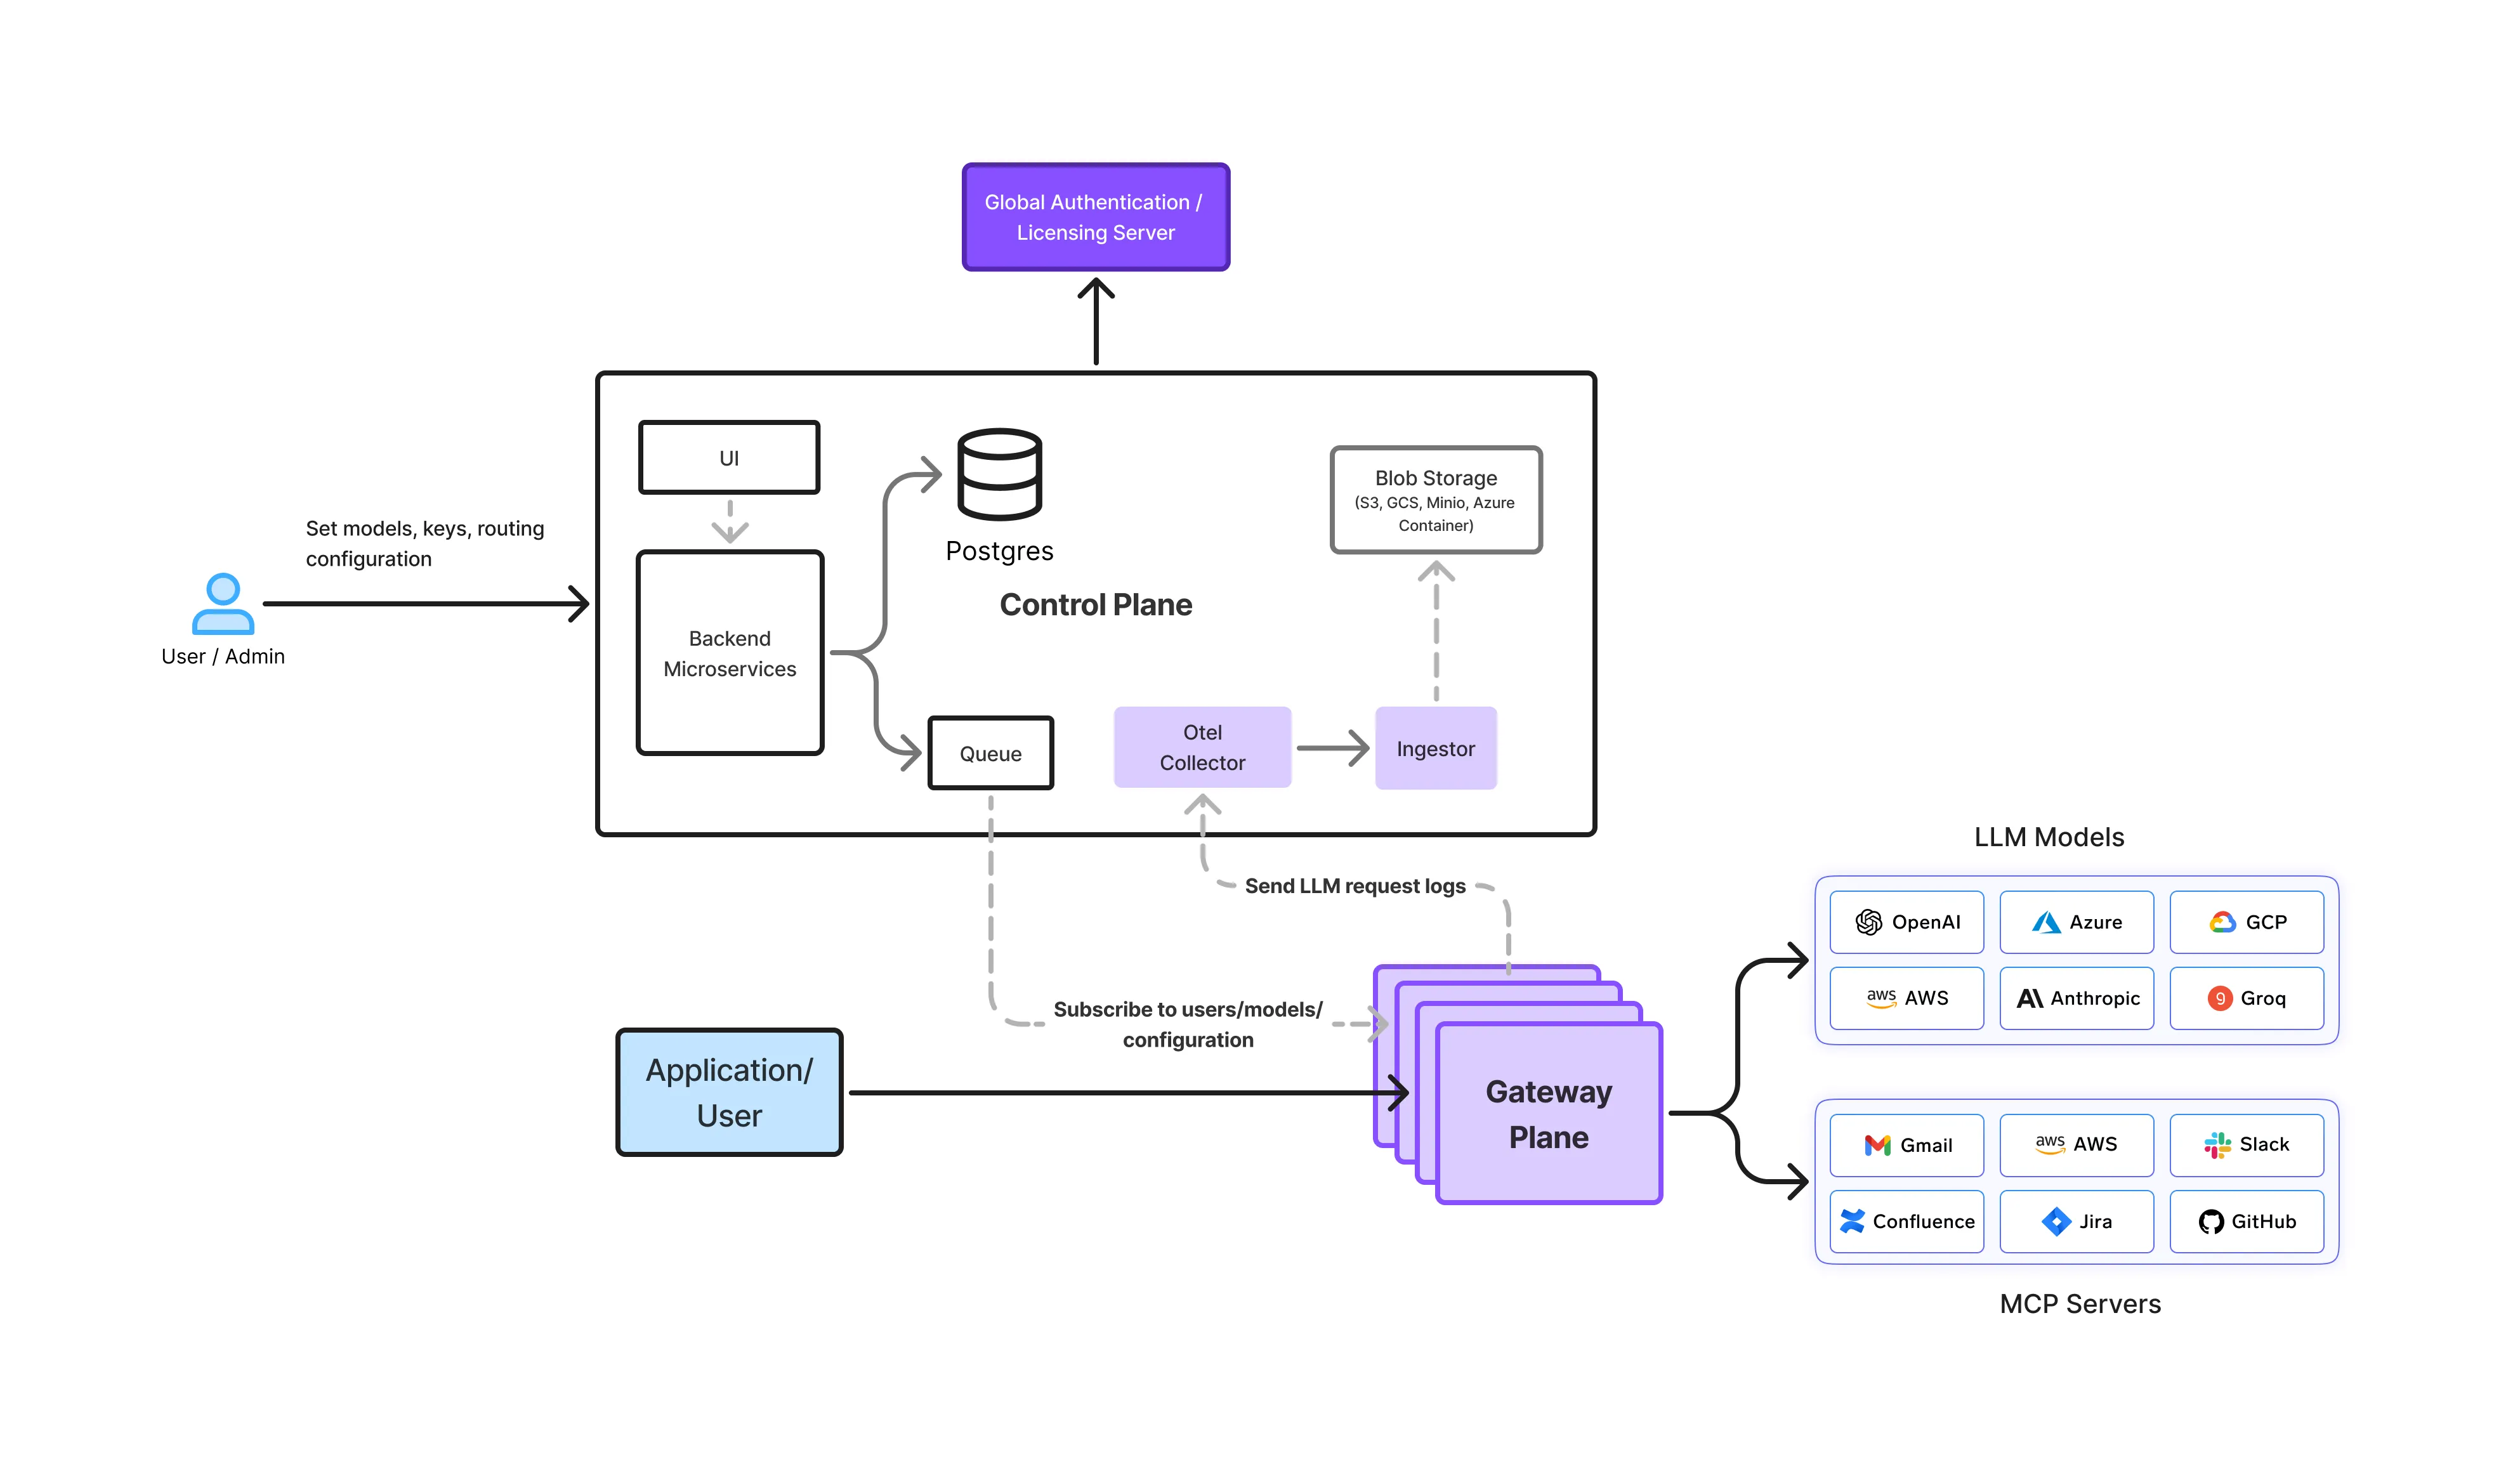
In einer TrueFoundry-Umgebung interagiert OpenCode nicht direkt mit den zugrunde liegenden LLM-Anbietern. Stattdessen fließen alle Anfragen über das KI-Gateway, das eine einheitliche und konsistente Schnittstelle für die Inferenz bereitstellt.
Architektonisch ermöglicht dies:
Durch den Entzug des direkten Modellzugriffs von einzelnen Tools erhalten Plattform-Teams volle Transparenz darüber, wie OpenCode tatsächlich von Entwicklern, Agenten und Automatisierungsprozessen genutzt wird.
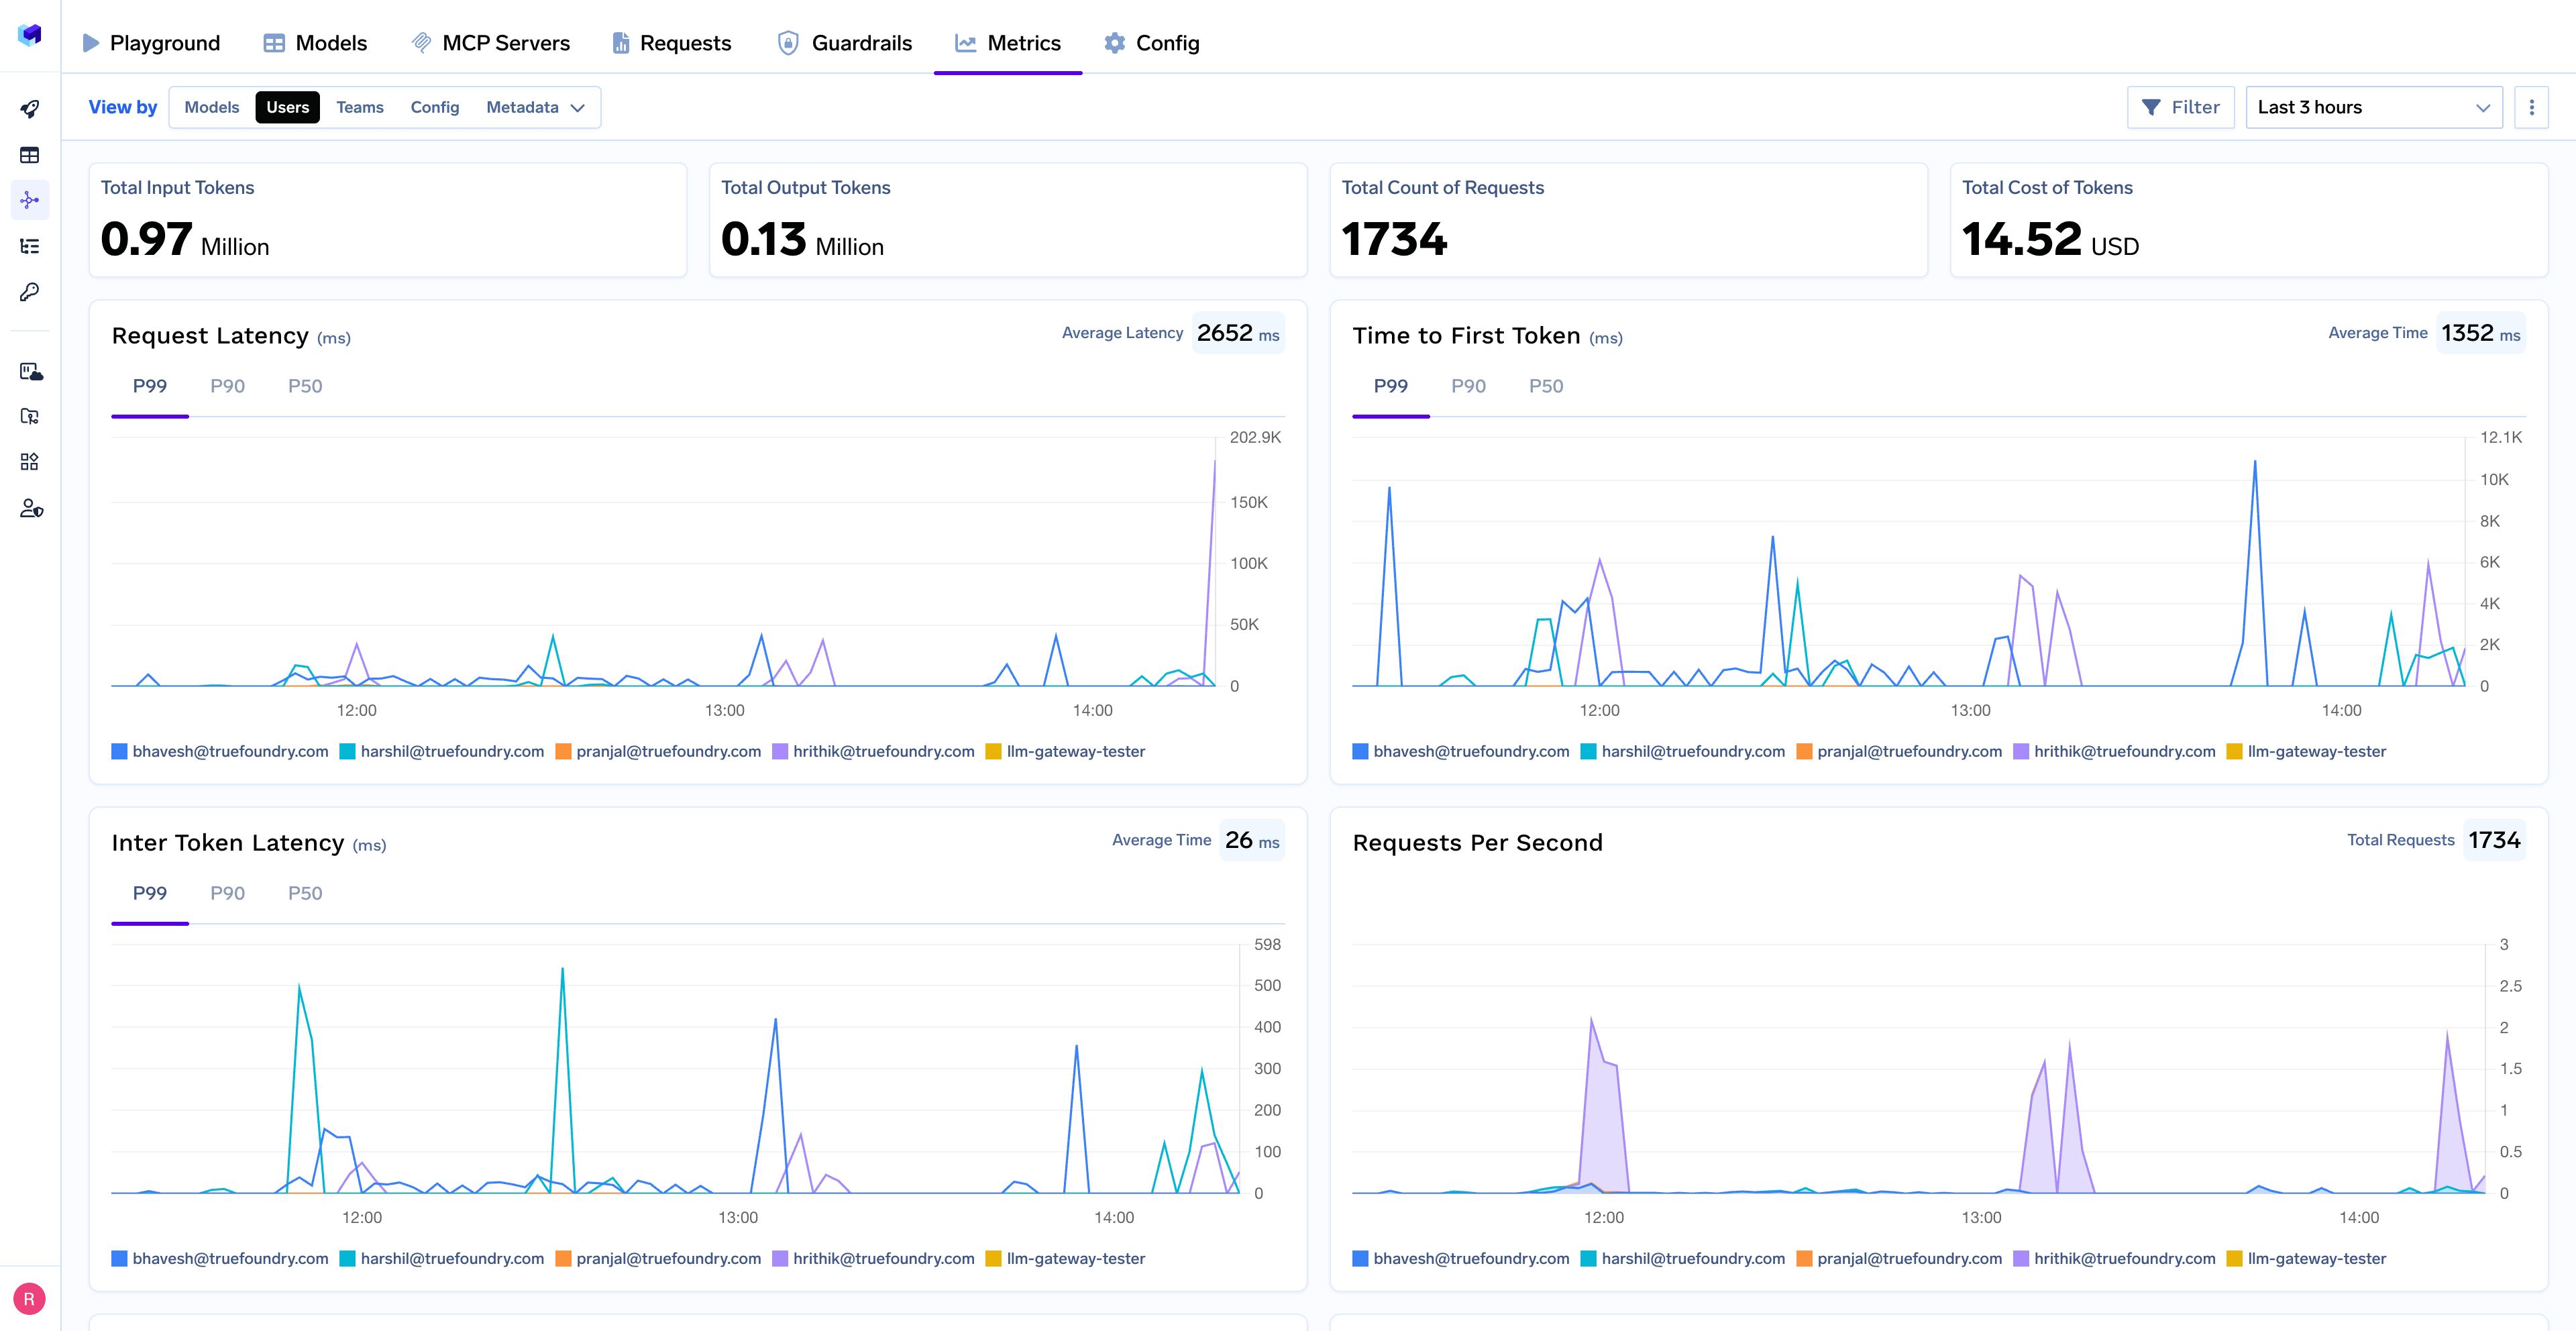
Das AI Gateway von TrueFoundry erfasst die Token-Nutzung auf Anfrageebene, einschließlich:
Entscheidend ist, dass diese Telemetriedaten nicht in einem anbietergebundenen System gefangen sind. Protokolle und Metriken werden in der eigenen Cloud und dem Speicher des Kunden dauerhaft gespeichert, was es Teams ermöglicht:
Dies vermeidet das bei KI-Tools häufige „Black-Box“-Problem und ermöglicht eine langfristige Optimierung.
Da der gesamte OpenCode-Traffic über das Gateway läuft, können Kostenkontrollen angewendet werden konsistent und in Echtzeithandelt.
Plattform-Teams können:
Diese Richtlinien werden einmalig am Gateway durchgesetzt und automatisch auf jeden OpenCode-gestützten Workflow angewendet, ohne dass Änderungen an Editoren, Plugins oder internen Tools erforderlich sind.
Die Architektur von TrueFoundry ist für Umgebungen konzipiert, in denen die OpenCode-Nutzung über die IDE hinausgeht. CI-Pipelines, Hintergrundprozesse und Agenten verursachen oft den größten und am wenigsten sichtbaren Token-Verbrauch.
Durch die Weiterleitung dieser Workloads über dasselbe AI Gateway können Teams:
Dies ermöglicht es, die OpenCode-Nutzung im gesamten Unternehmen zu skalieren, ohne die Vorhersehbarkeit oder Kontrolle zu verlieren.
Der OpenCode-Token-Verbrauch ist der eigentliche Skalierungsengpass für KI-gestützte Programmierung. Da sich die Nutzung auf Entwickler, Repositories, Automatisierung und Agenten ausweitet, wird der Token-Verbrauch ohne zentrale Sichtbarkeit und Governance schwer vorhersehbar und kontrollierbar.
Die Verwaltung auf Tool- oder Anwendungsebene ist nicht skalierbar. Der Token-Verbrauch erfordert Beobachtbarkeit auf Anfrageebene, eine klare Zuordnung und Durchsetzung in Echtzeit, wobei KI-gestützte Programmierung als gemeinsam genutzte Infrastruktur und nicht als isolierte Funktion betrachtet werden muss.
Plattformen wieTrueFoundry spiegeln diesen Ansatz wider, indem sie den OpenCode-Datenverkehr über ein AI Gateway zentralisieren und es Teams ermöglichen, den Token-Verbrauch konsistent zu überwachen, zu steuern und zu optimieren. Für Plattform- und Engineering-Führungskräfte ist das Fazit einfach: Wenn OpenCode ein zentraler Bestandteil der Softwareentwicklung ist, muss der Token-Verbrauch mit derselben Sorgfalt verwaltet werden wie jede andere kritische Infrastrukturressource.
Die genaue Überprüfung des OpenCode-Token-Verbrauchs erfordert eine explizite Nachverfolgung und Instrumentierung auf Anfrageebene. Da Tools den vollständigen Kontext, der an das Modell gesendet wird, oft abstrahieren, ist die Sichtbarkeit des tatsächlichen Token-Verbrauchs pro Aufgabe, Entwickler und Workflow entscheidend, um Kosten vorherzusagen und die Nutzung effektiv zu optimieren.
Die Opencode-Token-Nutzung ist das tokenbasierte Preismodell für KI-gestützte Codierungstools wie OpenCode. Jede Interaktion, von Eingabeaufforderungen und Code-Kontext bis hin zu generiertem Code und Erklärungen, verbraucht Token. Die Verwaltung dieser Opencode-Token-Nutzung ist entscheidend, da sie zum primären Kostentreiber für Entwicklungsteams in den USA wird.
Um die Opencode-Token-Nutzung zu reduzieren, beschränken Sie die Kontextinjektion auf wesentliche Dateien und vermeiden Sie die Einbeziehung ganzer Repositories. Verhindern Sie eine wiederholte Kontext-Rehydrierung, indem Sie Ausgaben intelligent über Iterationen hinweg wiederverwenden. Unterteilen Sie komplexe Aufgaben in kleinere Schritte und verwenden Sie präzise Prompts. Die Überwachung des Token-Verbrauchs für jede Aufgabe liefert wichtige Erkenntnisse zur Optimierung von Kosten und Effizienz.
Sie können die OpenCode-Token-Nutzung reduzieren, indem Sie die Länge Ihrer Prompts optimieren, unnötigen Kontext begrenzen und das richtige Modell für die jeweilige Aufgabe wählen. Lange Prompts, umfangreiche Gesprächsverläufe und zu große Code-Kontexte können den Token-Verbrauch erheblich steigern. Eine regelmäßige Überprüfung der Nutzungsmuster kann dabei helfen, Möglichkeiten zur Effizienzsteigerung und Kostensenkung zu identifizieren.
Mehrere Faktoren können die Token-Nutzung in OpenCode erhöhen, darunter:
Das Verständnis dieser Faktoren kann Teams dabei helfen, die KI-Nutzung zu optimieren und Ausgaben effektiver zu kontrollieren.
Unternehmen überwachen die Token-Nutzung in der Regel über zentrale Dashboards, Analysetools oder KI-Gateway-Plattformen. Diese Lösungen bieten Transparenz über den Token-Verbrauch bei Benutzern, Teams, Anwendungen und Modellen hinweg und helfen Unternehmen dabei, Ausgaben nachzuverfolgen, Anomalien zu erkennen und KI-Budgets effektiver zuzuweisen.
Die Überwachung der Token-Nutzung auf Teamebene erleichtert es zudem, Optimierungspotenziale zu identifizieren und unerwartete Kostensteigerungen zu vermeiden.
Ja. KI-Gateways können Unternehmen dabei unterstützen, den Token-Verbrauch zu optimieren, indem sie Transparenz über Nutzungsmuster schaffen, Budgets und Ratenbegrenzungen durchsetzen und ein intelligentes Modell-Routing ermöglichen.
Ein AI Gateway kann beispielsweise einfachere Anfragen automatisch an kostengünstigere Modelle weiterleiten, während Premium-Modelle für komplexere Aufgaben reserviert bleiben. In Kombination mit Nutzungsanalysen und Governance-Kontrollen hilft dies Unternehmen dabei, ihre KI-Kosten zu senken und gleichzeitig Leistung und Zuverlässigkeit zu gewährleisten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















