October 26, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Heute startet TrueFoundry eine Machine Learning Deep Dive-Serie, in der wir mit ML- und Data Science-Führungskräften aus Unternehmen sprechen, die ML einsetzen, um tiefer in die Anwendungsfälle und Workflows von ML in ihren Organisationen einzutauchen. Im Rahmen dieser Serie werden wir den ML-Stack von Unternehmen wie Gong, StichFix, SalesForce, Gusto, Simpl und vielen weiteren vorstellen und genauer analysieren.
📌
In dieser Serie tauchen wir in die Welt des Machine Learning ein, um das Spektrum von ML-Anwendungen und Infrastruktur-Setups branchenübergreifend zu enthüllen.
Unsere Gespräche drehen sich um vier Hauptthemen:
1. Machine Learning Anwendungsfälle für das Unternehmen
2. Wie sie ihren Machine Learning Stack aufgebaut haben, einschließlich Training- und Experimentation Pipeline, Deployment und Serving, Monitoring, und wie sie diese im Laufe der Zeit für Kosten/Latenz optimiert haben
3. Herausforderungen beim Aufbau des ML-Stacks, insbesondere branchenspezifische Herausforderungen
4. Ein Überblick über bahnbrechende Innovationen, die beim Aufbau und der Skalierung der ML-Infrastruktur angewendet wurden.
Zum Auftakt der ersten Diskussion dieser Serie haben wir mit Noam Lotner von Gong gesprochen. Gong ist eine Revenue Intelligence-Plattform. Sie ermöglicht es Revenue-Teams, ihr volles Potenzial auszuschöpfen, indem sie die Kundenrealität aus den Gesprächen des Revenue-Teams offenlegt. Gong analysiert kundenorientierte Interaktionen über Telefon, E-Mail, Web usw., um die besten Erkenntnisse für die Revenue-Teams zu liefern, damit diese mehr Deals abschließen können.
Noam Lotner ist Research Operations Team Lead bei Gong. Er baut die operative Plattform für die AI/ML-Forschungsgruppe auf – er automatisiert Modell-Release-Prozesse, Experiment-Management und Leistungstests, erstellt Tools für Labeling und Datensatzerstellung und ermöglicht sicheren Zugriff auf Produktionsdatenquellen.
Gong analysiert kundenorientierte Interaktionen über Telefon, E-Mail, Web usw. Machine Learning wird umso unerlässlicher, um Vertriebsinteraktionen zu analysieren und den Revenue-Teams Erkenntnisse zu liefern. ML-Algorithmen können Aufgaben automatisieren, die zuvor manuell erledigt wurden, wie die Analyse von Videoanrufen, das Transkribieren und Analysieren von Vertriebstelefonaten. Dies spart Zeit und verbessert die Effizienz des Vertriebsprozesses.
Obwohl dies eine Frage war, die wir Gong gestellt haben, sehen wir, dass ausnahmslos alle SaaS-Unternehmen Folgendes tun:
📌
Anzahl der Modelle: Anzahl der Kunden X Modelltypen
📌
"Wir verwenden für alle dasselbe Basismodell. Wir lassen die Kunden auch das Training für spezifische Modelle für ihre eigenen Inhalte durchführen."
Um die Kosten zu optimieren, nutzt Gong Multi-Model Serving in der Inference-Schicht, da das Ausführen separater Modelle auf separaten Maschinen ein hochpreisiges System bedeuten würde.
Hier ist ein detaillierter Blogbeitrag von Gong, der über den Einsatz von ML im B2B-Vertrieb spricht
Bei Gong ist das ML-System entsprechend der ML-Organisation strukturiert.
In diesem Blogbeitrag (sowie in der Chat-Serie) werden wir genauer auf die Herausforderungen der forschungsseitigen Infrastruktur für Gong eingehen
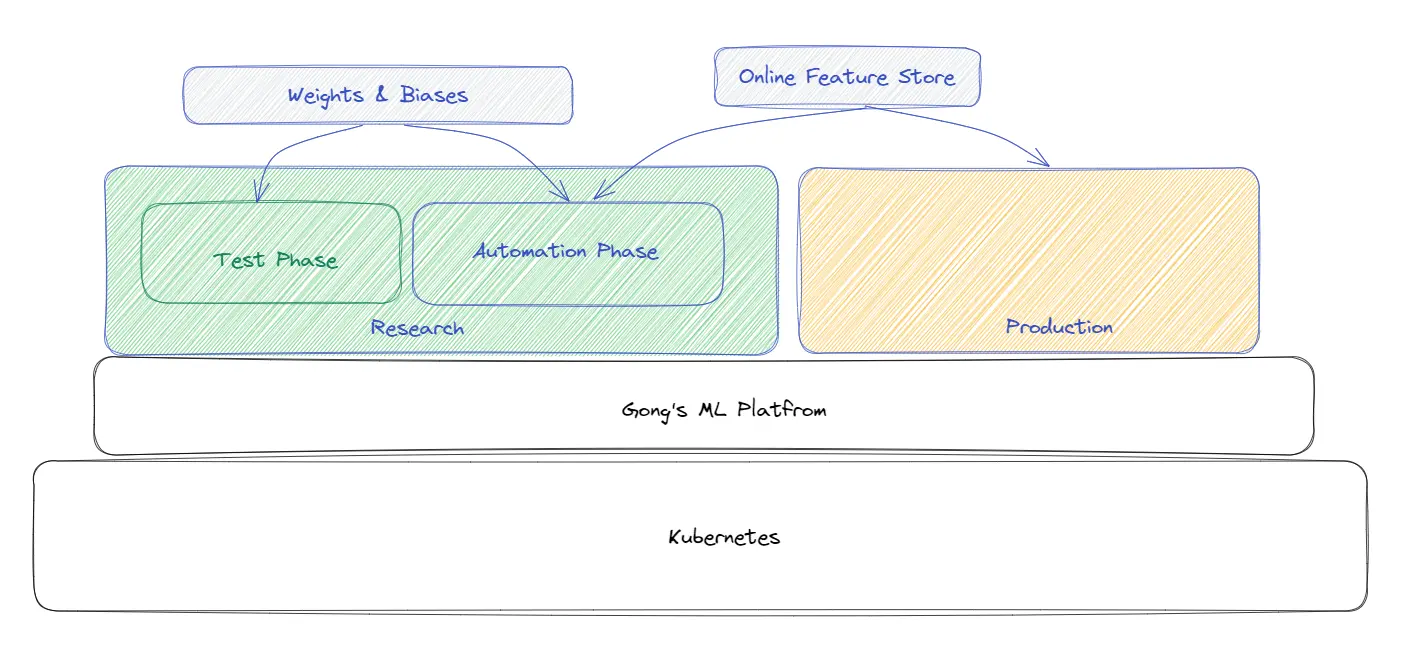
Damit Forscher Maschinen einfach hochfahren können, ist der gesamte Stack auf Kubernetes für die Forschungsinfrastruktur aufgesetzt. Die meisten Modelle im Forschungsteam verwenden keine Online-Features.
Cloud: Der Großteil der Infrastruktur befindet sich auf AWS, und es wird auch mit anderen Cloud-Anbietern in etwas kleinerem Umfang zusammengearbeitet.
Infrastrukturverwaltung: Die Pipelines führen die Modelle speziell für jeden Kunden aus. Es gibt eine Maschine, die hochfährt und alle Anrufe dieses Unternehmens abwickelt
Alles, was im Forschungsteam getan wird, wird jetzt auf Kubernetes verlagert. Ein Teil von Noams Arbeit besteht darin, seinem Team zu helfen, automatisch über die Kubernetes-Cloud auf Ressourcen zuzugreifen. Dies ist derzeit ein laufendes Unterfangen.
📌
"Ich würde jedem, der in dieses Thema einsteigt, empfehlen, schon sehr früh auf dieser Reise an Skalierung zu denken und sich zu überlegen, wie die eigene Gruppe arbeiten wird"
"Ich denke, die meisten MLOps-Systeme benötigen Kubernetes für die Verwaltung der Ressourcen. Ich sehe in Zukunft keine Plattform, die irgendetwas im Zusammenhang mit MLOps tun kann, ohne Kubernetes zu nutzen"
Einige wichtige Dinge, die zu beachten sind:
📌
"Meine Perspektive ist, dass Gong diese Plattform selbst bauen musste"
Nichts kann für ein SaaS-Unternehmen wichtiger sein als Sicherheit. ML-Pipelines müssen der Sicherheit aufgrund des Datenschutzes beim Umgang mit sensiblen Kundendaten sowie der Kontrolle unbefugter Zugriffe höchste Priorität einräumen.
Wir hoffen, dass der 1. Blogbeitrag der Serie TrueML Talks Ihnen wertvolle Einblicke geben konnte, wie Sie den Aufbau Ihrer Machine Learning Forschungsinfrastruktur zur Unterstützung Ihrer ML-Teams gestalten können. #MLOps #MachineLearning #DataScience #DevOps #ModelOps #AIInfrastructure
Gehen Sie zu unserer zweiten Episode der TrueML Talks, in der wir mit dem Platform Lead bei Stitch sprechen. Verfolgen Sie weiterhin die TrueML YouTube-Serie und finden Sie alle Episoden der TrueML Blog-Serie hier –
TrueFoundry ist ein ML Deployment PaaS über Kubernetes, um Entwickler-Workflows zu beschleunigen und ihnen gleichzeitig volle Flexibilität beim Testen und Bereitstellen von Modellen zu bieten, während volle Sicherheit und Kontrolle für das Infra-Team gewährleistet bleiben. Über unsere Plattform ermöglichen wir Machine Learning-Teams, Modelle in 15 Minuten mit 100 % Zuverlässigkeit, Skalierbarkeit und der Möglichkeit zu Rollbacks in Sekundenschnelle zu deployen und zu monitoren – so können sie Kosten sparen und Modelle schneller in die Produktion bringen, was eine echte geschäftliche Wertschöpfung ermöglicht.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet