



November 20, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
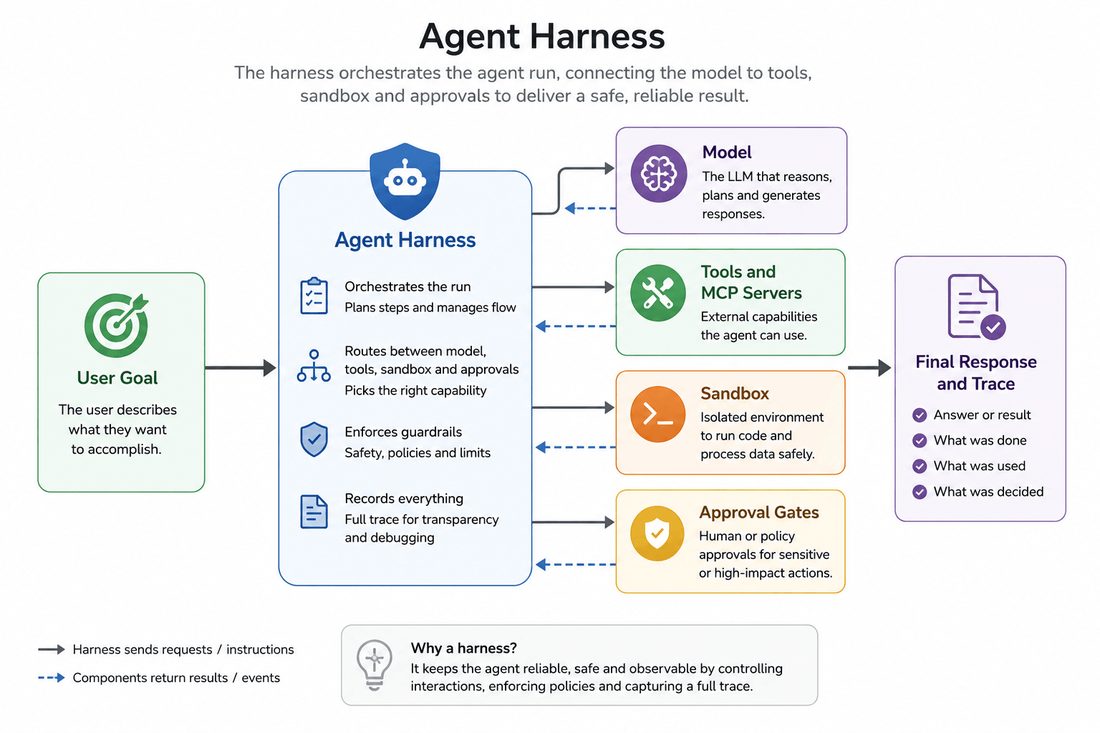
Jede Ära der Unternehmenssoftware entwickelt eine Schicht, die nebensächlich wirkt, bis sich dort operative Entscheidungen häufen. In der Client-Server-Ära war es oft der Anwendungsserver; in der Cloud-Ära der Container-Orchestrator; in der Daten-Ära der Pipeline-Scheduler. Das Muster besteht nicht darin, dass die gefeierte Komponente verschwindet, sondern dass sich ein zunehmender Teil der operativen Differenzierung in die Maschinerie verlagert, die sie ausführt. Für AI-Agenten hat diese Maschinerie einen Namen. Die Dokumentation von TrueForge definiert den Agent-Harness schlicht: „die Runtime-Schleife um ein LLM, die es in einen zuverlässigen, langlaufenden Agenten verwandelt.“ Ein Großteil der operativen Erfahrung eines Unternehmens mit einem Agenten – ob ein Lauf einen Neustart übersteht, ob eine konfigurierte risikoreiche Aktion auf einen Menschen wartet, ob der Arbeitskontext verdichtet oder ausgelagert wird, ob Code in einer Sandbox ausgeführt wird und ob ein Fehler im Nachhinein rekonstruiert werden kann – wird in dieser Runtime-Schleife geprägt, in der Ausführungsschleife zwischen dem Modell und der Welt. Wir nennen die Disziplin der Gestaltung dieses Zyklus Loop Engineering, und veröffentlichte Benchmark enthalten die Messungen. Dieser Beitrag enthält bewusst keine. Er stellt stattdessen das strategische Argument in den Vordergrund: Da die Modellwahl für eine wachsende Zahl von Workloads portabler wird, ähnelt die Schleife zunehmend einer Middleware, weil sie Entscheidungen zu Persistenz, Kontext, Freigabe, Isolierung und Observability konzentriert. Offene Standards und Open-Source-Implementierungen wurden in mehreren früheren Middleware-Kategorien von strategischer Bedeutung; diese Historie ist der Kontext für – nicht der Beweis für – die Entscheidung von TrueFoundry, seinen eigenen Harness als Open Source bereitzustellen.
Ein Modell ist eine Fähigkeit; eine Schleife ist ein Ort, an dem Richtlinien durchgesetzt werden können. Der Unterschied wird konkret, wenn Sie auflisten, was die Schleife bei jedem Durchlauf vermittelt. Ob ein konfigurierter Tool-Aufruf, der in ein Produktionssystem schreibt, fortgesetzt wird oder pausiert – die Funktionstabelle von TrueForge formuliert ihre Version in wenigen Worten: „Pausieren vor Schreib-/destruktiven MCP-Tools.“ Ob der Sitzungsstatus Wiederverbindungen und Neustarts übersteht – die Harness-Dokumentation macht dies zu einer Runtime-Eigenschaft statt zu einer Prompt-Anweisung. Ob generierter Code Harness-Anmeldeinformationen sehen kann – das Sandbox-Design von TrueForge hält Geheimnisse im Harness und stellt Compute-Ressourcen nur bei Bedarf bereit. Ob eine lange Aufgabe den Kontext kürzt oder auslagert; ob eine delegierte Teilaufgabe ihr Endergebnis statt des gesamten Arbeitstranskripts zurückgibt – auch das sind Runtime-Entscheidungen. Keine davon wird zuverlässig allein durch das Modellverhalten durchgesetzt. Jede ist eine operative Entscheidung, die eine Organisation konsistent angewendet wissen möchte, und das ist ein Grund, warum die Schleife wie Middleware zu wirken beginnt: Hier kann aus operativer Absicht wiederholbares Verhalten werden. Es lohnt sich, die Übersetzungstabelle als Ganzes zu betrachten, denn das Muster ist das Argument:
Schleifenentscheidungen wirken sich anders aus als Prompt-Anweisungen, da die Runtime-Richtlinie jeden Durchlauf deterministisch vermitteln kann. Ändern Sie den Ort der Verdichtung, und jede langlaufende Aufgabe, die diese Runtime nutzt, kann die Änderung erben. Fügt man eine Freigabegrenze hinzu, erfordert eine Klasse risikoreicher Aktionen nun einen expliziten Autorisierungsschritt, anstatt sich allein auf Verhaltensdisziplin zu verlassen; Fehlkonfigurationen, Umgehungen und fehlerhafte Freigaben sind weiterhin möglich. Der Mechanismus ist aus der Middleware bekannt – definieren Sie eine Steuerung einmal, wenden Sie sie konsistent an – und er erklärt, warum sich die Aufmerksamkeit erfahrener Softwarearchitekten auf die Runtime verlagert. Prompt Engineering fragt, was dem Modell gesagt werden soll. Context Engineering fragt, was ihm gezeigt werden soll. Loop Engineering fragt, was das System zwischen den Modellaufrufen tut, und diese Frage gehört ebenso zum Platform und Security Engineering wie zu den Prompt-Autoren.
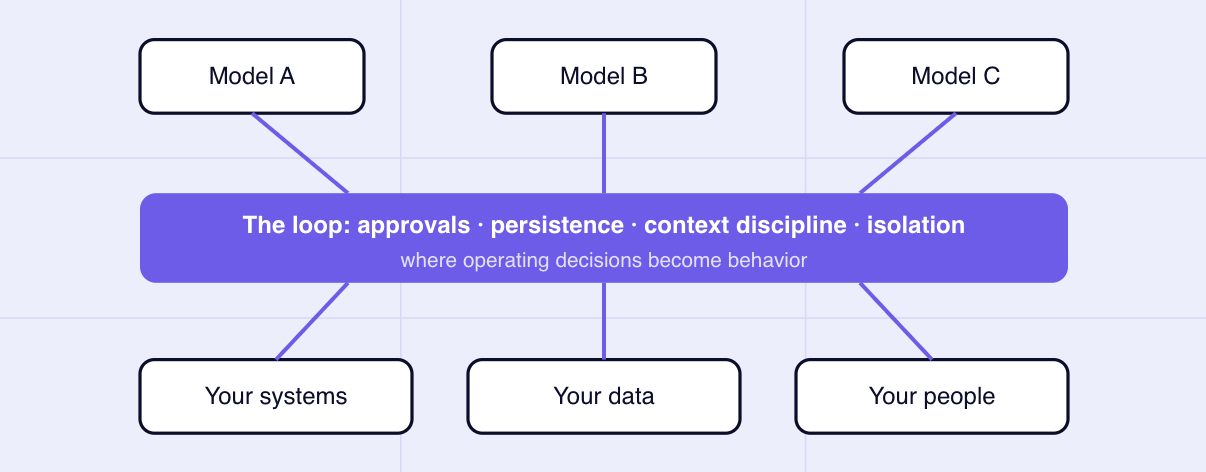
Wenn in der Schleife Ihr operatives Urteilsvermögen verankert ist, lautet die nächste unbequeme Frage: Wie überprüfbar und portabel ist sie? Die historische Bilanz ist gemischt, was genau der Grund dafür ist, dass die nützliche Lehre spezifischer ist als „Middleware wird immer Open Source“. Enterprise-Anwendungsserver umfassen neben offenen Standards und offenen Implementierungen nach wie vor bedeutende proprietäre Produkte. Die Container-Orchestrierung hingegen konvergierte stark um das Open-Source-Projekt Kubernetes, und beim Workflow-Scheduling gibt es einflussreiche Open-Source-Systeme wie Apache Airflow neben verwalteten Alternativen. Das wiederkehrende Muster ist keine Zwangsläufigkeit; es zeigt vielmehr, dass Unternehmen, sobald eine operative Schicht strategisch wichtig wird, oft Wert auf offene Schnittstellen, Quellcodeverfügbarkeit, Portabilität und die Möglichkeit legen, die Schicht nach eigenen Vorstellungen auszuführen oder zu ersetzen. Eine Urteilsschicht profitiert davon, überprüfbar zu sein, weil das Urteil Ihres ist.
Die Agenten-Schleife könnte einem Teil dieser Entwicklung folgen, und das Argument für Offenheit ist konkret statt ideologisch. Die Verfügbarkeit des Quellcodes ermöglicht Audits auf Implementierungsebene; sie beweist für sich genommen jedoch nicht, dass eine bereitgestellte Binärdatei vertrauenswürdig oder korrekt konfiguriert ist. Eine Runtime, die Self-Hosting unterstützt, kann die Ausführungsschicht innerhalb Ihrer eigenen Grenzen platzieren. Eine erweiterbare offene Implementierung kann es Teams ermöglichen, das Verhalten bei Verdichtung, Checkpointing oder Integration zu ändern, ohne auf die Roadmap eines Anbieters warten zu müssen. Und eine öffentliche Runtime-Semantik kann Wechselbarrieren reduzieren, obwohl echte Portabilität immer noch von Datenformaten, Integrationen, externen Diensten und Betriebspraktiken abhängt. Das ist der Kontext für den eigenen Schritt von TrueFoundry: TrueForge wird unter der MIT-Lizenz mit offenem Quellcode veröffentlicht (Repository), unterstützt den lokalen und gehosteten Betrieb, behandelt Modelle, MCP-Server und Sandbox-Anbieter als verbundene Abhängigkeiten und dokumentiert sein Verhalten öffentlich unter trueforge.dev. Wir haben das ausführlichere Argument separat in Warum Agent-Harnesses offen sein sollten dargelegt; die strategische Zusammenfassung passt in eine Zeile.
Die Middleware-Befragung in sechs Fragen: Übersteht die Arbeit einen Neustart? Was kann die Code-Ausführungsumgebung sehen? Welche Aktionen pausieren für einen Menschen – durch die Runtime oder durch Hoffnung? Werden Fähigkeiten bei Bedarf geladen oder fahren sie bei jedem Durchlauf mit? Lässt sich ein Lauf aus seinen Traces rekonstruieren? Und wenn Sie Ihren Runtime-Anbieter morgen verlassen würden, was genau würden Sie verlieren?
Diese sechs Fragen verdienen eine Detaillierung, denn der Unterschied zwischen einer guten und einer schlechten Antwort ist architektonischer und nicht rhetorischer Natur – und das ist die Befragung, die wir bei jeder Agent-Runtime durchführen würden, einschließlich unserer eigenen. Kontinuität: Wenn der Prozess mitten in der Aufgabe abstürzt, kann der Sitzungsstatus wieder aufgenommen werden oder verschwindet die Arbeit? Eindämmung: Wenn der Agent Code ausführt, was kann diese Umgebung sehen? Ein vertretbares Muster hält Harness-Anmeldeinformationen außerhalb der Sandbox; TrueForge dokumentiert diese Trennung und stellt Sandbox-Compute-Ressourcen nur bei Bedarf bereit. Einwilligung: Welche Aktionen pausieren für einen Menschen, und wird dies durch Runtime-Richtlinien durchgesetzt oder lediglich in einem Prompt erbeten? Die menschliche Freigabe ist eine Schutzmaßnahme, kein Beweis dafür, dass schädliche Aktionen unmöglich sind. Sparsamkeit: Lädt die Runtime Fähigkeiten bei Bedarf – Tool-Definitionen und Skills werden erst beim Zugriff materialisiert, wie in den Harness-Funktionen beschrieben –, oder trägt jeder Agent bei jedem Durchlauf den gesamten Katalog mit sich? Lesbarkeit: Wenn etwas schiefgeht, können Sie die Schritte rekonstruieren, die die Runtime tatsächlich aufgezeichnet hat, und sie mit nachgelagerten Logs korrelieren? Und Portabilität: Wenn Sie Ihren Runtime-Anbieter morgen verlassen müssten, welche Codes, Zustände, Integrationen und Betriebspraktiken würden mit Ihnen umziehen? Eine Schleife, die diese Fragen gut beantwortet, verhält sich wie Infrastruktur. Eine Schleife, die darauf nur mit einer Roadmap antwortet, gehört in das Risikoregister.
Der stille Vorteil, diese Fragen anhand der öffentlichen Dokumentation zu stellen, besteht darin, dass die Antworten überprüfbar sind. Jede Aussage in diesem Beitrag zum Verhalten von TrueForge ist ein Zitat aus den veröffentlichten Docs, keine bloße Charakterisierung – und wo die Nachweise quantitativ werden, haben wir sie bewusst aus diesem Essay herausgehalten und dorthin gestellt, wo die Methodik mitgeliefert werden kann: auf die Benchmark-Seite. Strategiebeiträge sollten argumentieren; Zahlen sollten mit ihren Fehlergrenzen geliefert werden.
Die operative Haltung lautet daher: Betrachten Sie die Schleife als eine Middleware-Entscheidung. Erfassen Sie die operativen Entscheidungen, die Ihre Agenten derzeit durchsetzen – und diejenigen, die sie nur beabsichtigen. Fragen Sie, wo jedes Urteil verankert ist: in einem Prompt, der das Modellverhalten beeinflusst, in einer deterministischen Richtlinie oder in einer Runtime, deren Implementierung und Pfad für einen Wechsel Sie kontrollieren können oder auch nicht. Frühere Infrastruktur-Ären beweisen nicht, dass Agent-Runtimes Open Source werden müssen, aber sie zeigen den Wert portabler Schnittstellen und Betriebspraktiken, wenn sich zugrundeliegende Anbieter ändern. Die Schleife verdient dieselbe Weitsicht.
Zuerst die Offenlegung: TrueFoundry veröffentlicht diesen Essay, vertreibt das TrueFoundry AI Gateway und betreut TrueForge, den in diesem Beitrag besprochenen Open-Source-Agent-Harness (MIT) – das Argument für offene Runtime-Schichten liegt in unserem Interesse, das hier transparent gemacht wird. Zur Methodik: Dies ist konzeptionell ein Strategie-Essay – er enthält keine Leistungszahlen, und Leser, die nach empirischen Nachweisen suchen, sollten die veröffentlichten Benchmarks und unsere empirische Loop-Engineering-Analyse konsultieren, in denen Zahlen mit ihrem Rahmen und ihren Grenzen erscheinen. Alle Aussagen zum Verhalten von TrueForge sind zitiert oder eng an die öffentliche Dokumentation unter trueforge.dev angelehnt, die bei jeder Behauptung verlinkt ist; die historischen Analogien zu Anwendungsservern, Orchestratoren und Schedulern sind redaktionelle Interpretationen, die als Muster und nicht als Beweis angeboten werden; und das Middleware-Framing sowie die Sechs-Fragen-Befragung sind unsere redaktionellen Beiträge. „Loop Engineering“ setzt den Wortschatz unserer früheren Serien fort, die in den Referenzen verlinkt sind. Keine der genannten Drittparteien bewertet oder befürwortet TrueFoundry.
TrueFoundry veröffentlicht diese Analyse, vertreibt das TrueFoundry AI Gateway und betreut TrueForge (MIT). Dieser Essay enthält vorsätzlich keine Leistungs- oder Kostenangaben; quantitative Aussagen befinden sich im verlinkten Benchmark und der Analyse samt Methodik. Das Produktverhalten wird aus der öffentlichen Dokumentation auf trueforge.dev mit Links bei jeder Behauptung zitiert. Das Middleware-Framing, die historischen Analogien und die Leitfragen sind redaktioneller Natur. Diagramme sind originale TrueFoundry-Grafiken.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet

















