November 16, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Im Jahr 2026 können es sich Unternehmen nicht mehr leisten, ein LLM Gateway behelfsmäßig zu einem AI Gateway umzufunktionieren. AI wird immer tiefer in kundenorientierte Workflows eingebunden, weshalb eine dedizierte Gateway-Schicht für zuverlässige AI-gestützte Anwendungen unverzichtbar ist. Typische enterprise-seitige AI-Infrastrukturen nutzen oft mehrere Modelle, Teams und Clouds, was zu komplexen Compliance- und Kostenverantwortlichkeiten führt.
Gartner definiert ein AI Gateway als eine Technologie oder Plattform, die als Vermittler zwischen Anwendungen und verschiedenen Diensten oder Modellen der künstlichen Intelligenz (AI) agiert. Der Zweck besteht darin, den Zugriff auf AI-Funktionen zu vereinfachen und zu verwalten sowie einen zentralen Punkt bereitzustellen, der Sicherheit, Governance und Observability von AI-Workloads ermöglicht. Lesen Sie den vollständigen Gartner Market Guide for AI Gateways 2025, um mehr zu erfahren.
Im vergangenen Jahr haben sich drei breite Kategorien herausgebildet, um die Herausforderungen von Governance und Resilienz bei GenAI anzugehen:
Jede Kategorie ist für eine andere Phase der AI-Einführung optimiert. Probleme entstehen, wenn Werkzeuge, die für eine Phase optimiert wurden, für eine andere überstrapaziert werden.
In diesem Blogbeitrag fassen wir sämtliche Wettbewerbsanalysen in einer umfassenden Marktübersicht zusammen. Wir erklären, wo jede Plattform ihren Platz hat, wo ihre Grenzen liegen und was Unternehmen bei der Auswahl des Anbieters beachten müssen, der am besten zu ihren Anforderungen passt.
1. Kong AI: Traditionelles API Gateway, angepasst für AI
Kong ist ein API Gateway, das häufig in Kubernetes-basierten Microservice-Architekturen eingesetzt wird. Kong AI baut auf diesem Fundament auf und führt Plugins sowie Integrationen ein, die darauf ausgelegt sind, Traffic zu großen Sprachmodellen zu leiten.
Was Kong AI gut macht
Wo Kong AI an seine Grenzen stößt
Mit zunehmender AI-Nutzung treten diese Lücken immer deutlicher hervor. Kostenzuordnung, Strategien zur Modellauswahl und AI-spezifische Governance müssen außerhalb des Gateways verwaltet werden – häufig direkt im Anwendungscode.
Fazit: Kong AI ist als API Gateway effektiv, aber AI bleibt eine sekundäre Erwägung statt einer nativen Abstraktion.
2. Portkey: LLM Gateway auf Anwendungsebene
Portkey ist ein AI Gateway, das speziell für LLM-Anwendungen entwickelt wurde. Anstatt AI-Anfragen als generische HTTP-Aufrufe zu behandeln, führt Portkey ein Prompt- und modellbewusstes Routing sowie Observability ein.
Was Portkey gut macht
Wo Portkey Schwächen zeigt
Das Design von Portkey ist bewusst anwendungsorientiert, was bei unternehmensweiter Skalierung zu Einschränkungen führt:
Da AI zu einer gemeinsam genutzten internen Funktion statt zu einem einzelnen Anwendungs-Feature wird, erfordern diese Einschränkungen häufig zusätzliche Infrastrukturschichten.
Am besten geeignet für: LLM-Anwendungen einzelner Teams, die in die frühe Produktionsphase übergehen.
3. LiteLLM: Entwicklerzentriertes Open-Source Gateway
LiteLLM ist ein Open-Source-LLM Gateway, das eine einheitliche, OpenAI-kompatible API für den Zugriff auf Dutzende von Modellanbietern bereitstellt.
Was LiteLLM gut macht
Wo LiteLLM Schwächen zeigt
Am besten geeignet für: LiteLLM ist ein effektiver Einstiegspunkt, erfordert jedoch in regulierten oder Multi-Team-Umgebungen erhebliche Erweiterungen.
Auch lesen: Portkey vs LiteLLM
4. AWS Bedrock: Serverlose Modell-APIs
AWS Bedrock bietet verwalteten, serverlosen Zugriff auf Foundation-Modelle von Anbietern wie Anthropic und Amazon. Es abstrahiert die Infrastruktur vollständig und rechnet rein nach Token-Nutzung ab.
Was AWS Bedrock gut macht
Versteckte Kompromisse bei AWS Bedrock
Diese Kompromisse überraschen Teams häufig, sobald Workloads aus der Experimentierphase in den dauerhaften Produktionsbetrieb übergehen.
Fazit: Bedrock optimiert für Geschwindigkeit und Einfachheit, nicht für langfristige Kosteneffizienz oder Kontrolle.
5. AWS SageMaker: Verwaltete ML-Infrastruktur
SageMaker bietet eine umfassende Suite zum Trainieren, Feintunen und Deployen von Machine-Learning-Modellen. Im Gegensatz zu Bedrock legt es Infrastrukturentscheidungen direkt für den Benutzer offen.
Was AWS SageMaker gut macht
Nachteile von AWS SageMaker
Fazit: SageMaker bietet Kontrolle, allerdings auf Kosten der betrieblichen Einfachheit.
6. Databricks: Die Lakehouse ML-Plattform
Databricks nähert sich der AI aus einer datenzentrierten Perspektive und integriert ML- und GenAI-Funktionen in seine Lakehouse-Architektur.
Was Databricks gut macht
Wo Databricks Schwächen zeigt
Fazit: Databricks glänzt im Data Engineering, nicht beim AI-Serving.
Der gemeinsame Nenner: Gateways ohne Governance
Über Kong vs LiteLLM, Portkey und selbst Bedrock hinweg zeigt sich dasselbe Problem: Sie verwalten Anfragen, keine AI-Systeme.
Über Gateways und verwaltete Dienste hinweg tritt ein wiederkehrendes Thema auf: Die meisten Tools konzentrieren sich auf Anfragen, nicht auf Systeme.
Sie beantworten Fragen wie:
Schwierigkeiten haben sie bei Fragen wie:
Dies sind Anliegen auf Infrastrukturebene.
TrueFoundry ordnet sich in einer anderen Schicht des Stacks ein. Anstatt sich ausschließlich auf API-Routing oder verwaltete Dienste zu konzentrieren, behandelt es AI-Workloads — Modelle, Agents, Services und Jobs — als erstklassige Infrastrukturobjekte. Dadurch verlagert sich die Verantwortung vom Anwendungscode auf die Plattform selbst.
Das TrueFoundry AI Gateway basiert auf folgenden Kernprinzipien:
Das bedeutet, dass das AI Gateway Teil eines größeren Systems ist, das es Unternehmen ermöglicht, ihre AI-Anwendungsfälle nahtlos zu skalieren.
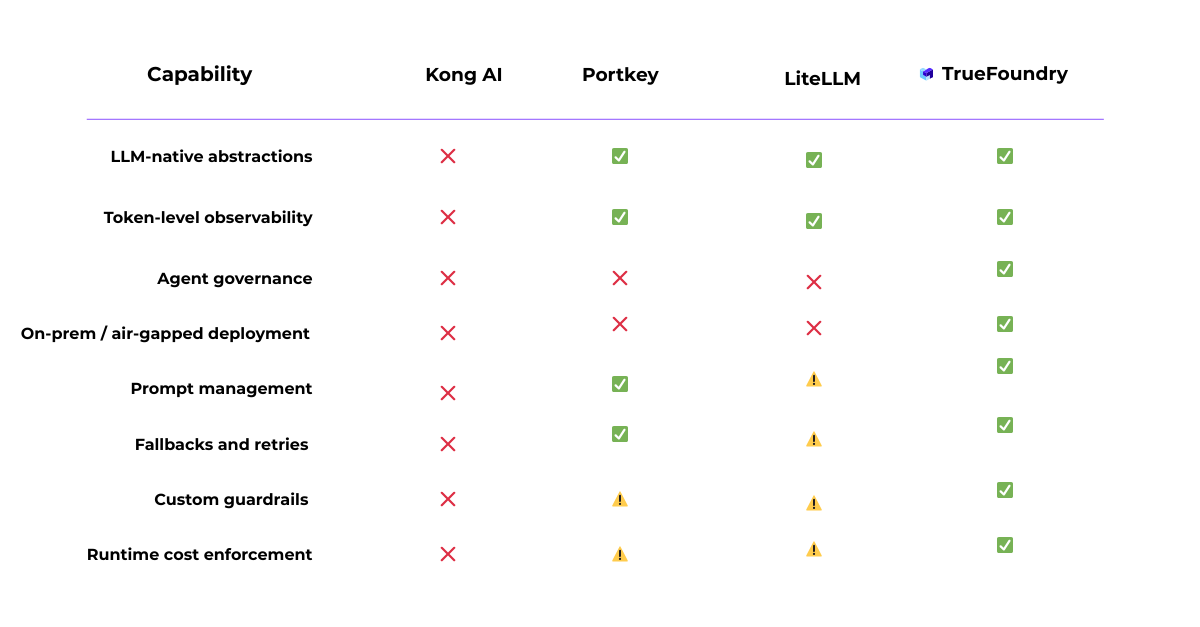
Hier ist das Evaluierungs-Framework für Anforderungskataloge
| Kriterium | Was sollten Sie evaluieren? | Priorität | TrueFoundry |
|---|---|---|---|
| Einheitliche API & Routing | |||
| Einheitlicher OpenAI-kompatibler Endpunkt | Ist die Gateway-API kompatibel mit den Formaten /v1/chat/completions und /v1/responses von OpenAI, sodass ein konsistenter Zugriff auf verschiedene Modelle über eine standardisierte Schnittstelle möglich ist? | Erforderlich (Must have) | ✅ Unterstützt: OpenAI-kompatibler Endpunkt über alle Anbieter hinweg. |
| Anbieter- und Modellabdeckung | Unterstützt es führende Anbieter wie OpenAI, Azure OpenAI, Amazon Bedrock, Anthropic, Gemini, Groq sowie selbst gehostete Modelle? | Erforderlich (Must have) | ✅ Unterstützt: 1000+ LLMs über gehostete und selbst gehostete Anbieter hinweg. |
| Geschwindigkeit beim Modell-Onboarding | Wie schnell können neue Modelle (OpenAI-kompatible und nicht-standardisierte APIs) ohne Codeänderungen hinzugefügt werden? | Erforderlich (Must have) | ✅ Unterstützt: konfigurationsgesteuertes Onboarding innerhalb von Minuten. |
| Multimodale Unterstützung | Unterstützt das Gateway Text, Vision, Audio, Bildgenerierung und Embeddings über eine einzige Schnittstelle? | Abhängig vom Anwendungsfall | ✅ Unterstützt: Chat, Embeddings, Bilder, Audio, Rerank und Realtime-APIs. |
| Routing, Load Balancing, Fallback | Können Anfragen nach Modell, Anbieter, Latenz, Priorität, Gewichtung, Region und Fehlerstatus mit automatischen Wdh.-Versuchen geroutet werden? | Erforderlich (Must have) | ✅ Unterstützt: Load Balancing, Fallbacks, gewichtetes und latenzbasiertes Routing. |
| Modellwechsel ohne Codeänderung | Wird der Modellwechsel über Header oder Konfiguration unterstützt, ohne den Client-Code zu ändern? | Erforderlich (Must have) | ✅ Unterstützt: header- und konfigurationsbasierter Modellwechsel. |

Das TrueFoundry AI Gateway wird entscheidend, wenn die AI-Nutzung über isolierte Anwendungen hinausgeht und zu einer gemeinsamen, produktionskritischen Funktion wird. In diesem Stadium betreffen die Herausforderungen meist weniger einzelne Modellaufrufe, sondern vielmehr die betriebliche Konsistenz über Teams und Umgebungen hinweg.
So unterscheidet sich das AI Gateway von TrueFoundry von anderen Lösungen:
Viele AI-Tools konzentrieren sich auf Belange der Anfrageebene wie Routing, Retries und grundlegende Observability. In frühen Phasen ist dies meist ausreichend.
Mit zunehmender Nutzung verhalten sich Modelle und Agents jedoch immer mehr wie langlebige Services. Teams benötigen klarere Zuständigkeiten, Lebenszyklusmanagement und betriebliche Grenzen. TrueFoundry ist darauf ausgelegt, AI-Workloads — Modelle, Services und Jobs — als Infrastrukturkomponenten mit definierten Deployment- und Laufzeiteigenschaften zu verwalten.
In vielen Stacks werden Zugriffskontrollen und Nutzungsrichtlinien auf Anwendungs- oder SDK-Ebene konfiguriert. Mit wachsender Anzahl an Services kann dies im Laufe der Zeit zu Inkonsistenzen führen.
TrueFoundry wendet Kontrollen auf Umgebungsebene an und trennt Entwicklung, Staging und Produktion standardmäßig voneinander. Richtlinien, die auf dieser Schicht definiert werden, gelten einheitlich für alle in dieser Umgebung deployten Workloads, was die Abhängigkeit von Konfigurationen pro Anwendung verringert.
AI-Kosten steigen häufig eher durch Nebenläufigkeit, Retries oder Hintergrund-Workloads als durch einzelne Anfragen. TrueFoundry begegnet dem, indem es Limits für Nebenläufigkeit, Durchsatz und Ressourcennutzung während der Ausführung durchsetzt.
Dies ermöglicht es Unternehmen, gemeinsam genutzte Infrastrukturen bei skalierender Nutzung vorhersehbarer zu verwalten.
Obwohl Metriken auf Token-Ebene nützlich sind, erklären sie das Systemverhalten im Produktionsbetrieb nicht vollständig. TrueFoundry verknüpft Signale auf Anfrageebene mit Infrastrukturmetriken wie CPU/GPU-Auslastung und Autoscaling-Verhalten. Dies hilft Teams, Performance- und Kostentreiber im Gesamtzusammenhang zu verstehen.
Manche Unternehmen unterliegen Vorgaben, die private Netzwerke, On-Premise-Deployments oder strikte Datenresidenz erfordern. TrueFoundry ist für den Betrieb in solchen Umgebungen konzipiert, sodass AI-Workloads unter denselben Infrastrukturstandards verwaltet werden können, die auch an anderer Stelle im Unternehmen gelten.
Fazit
Die aktuelle Landschaft der AI-Plattformen spiegelt die Geschwindigkeit wider, mit der sich generative AI entwickelt hat. Viele Werkzeuge lösen reale Probleme — Routing, Modellzugriff, Observability oder Training —, tun dies jedoch aus unterschiedlichen Blickwinkeln. Infolgedessen deckt keine einzelne Kategorie von Natur aus das gesamte Spektrum betrieblicher Anforderungen ab, die entstehen, sobald AI produktionskritisch wird.
TrueFoundry bietet den größten Mehrwert, wenn AI-Workloads mit derselben Disziplin wie andere Produktionssysteme betrieben werden müssen — über Umgebungen hinweg, unter gemeinsamen Richtlinien und mit vorhersagbarem Ressourcenverhalten.
Unternehmen, die Anbieter vergleichen, suchen zu Beginn oft nach dem besten LLM Gateway. Der eigentliche Unterscheidungsfaktor liegt jedoch darin, wie gut die Plattform AI-Systeme im großen Maßstab steuert. Zu verstehen, wo jede Plattform ihren Platz hat und wo ihre Designannahmen an Grenzen stoßen, ist essenziell bei der Evaluierung des besten AI Gateways für unternehmensweite Deployments. Die richtige Wahl hängt weniger von einzelnen Features ab, sondern davon, wie sich die AI-Nutzung in einer Organisation im Laufe der Zeit voraussichtlich entwickeln wird.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




The best AI gateway depends on the organization's specific requirements. TrueFoundry's AI Gateway stands out for enterprises needing multi-provider routing, centralized governance, cost tracking, and MCP integration in a single platform. Other strong options include LiteLLM for open-source flexibility and Kong AI Gateway for teams already invested in Kong's API management ecosystem.
An AI gateway is a middleware layer that sits between applications and LLM providers (such as OpenAI, Anthropic, or Google). Its architecture typically includes a routing engine that directs requests to the appropriate model, a policy layer for enforcing rate limits and access controls, an observability stack for logging and cost tracking, and a caching layer to reduce redundant API calls. This architecture allows organizations to manage multi-model deployments from a single control plane.
TrueFoundry differentiates itself by combining AI gateway capabilities with a full ML infrastructure platform including model serving, fine-tuning, and MCP server management in a unified solution. Its AI Gateway offers enterprise-grade features such as per-team budget controls, audit logging, model fallback routing, and native MCP support, making it particularly well-suited for organizations looking to govern and scale Claude Code and other agentic AI deployments



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet