outubro 5, 2023
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
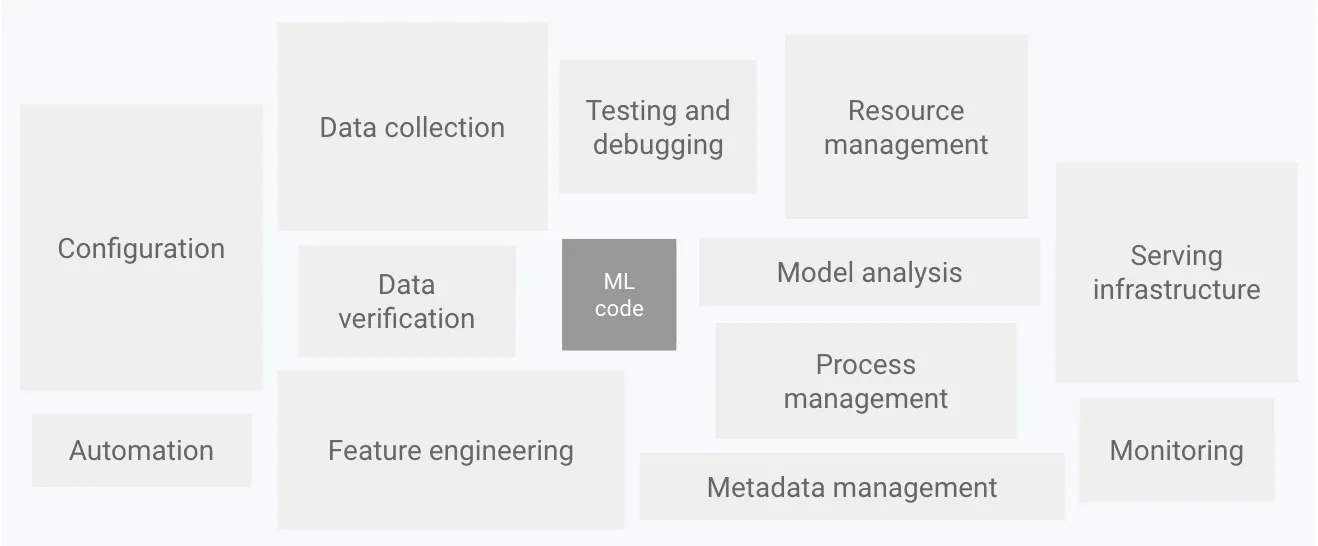
A equipe da TrueFoundry tem trabalhado muito no último mês, adicionando novos recursos à nossa plataforma de implantação de ML. Nosso objetivo aqui é construir uma plataforma de implantação que torne absolutamente fácil implantar modelos e serviços de ML, ao mesmo tempo em que aplica os melhores princípios de engenharia e segurança. Para construir uma grande plataforma de ML, precisamos ter uma plataforma de engenharia sólida, e é por isso que grande parte do foco inicial tem sido entregar uma plataforma consistente para implantar código.

De todas as partes da plataforma de ML descritas acima, focamos na infraestrutura de serving, no monitoramento e em toda a automação ao redor disso.
Muito trabalho foi feito na construção da nossa plataforma de implantação sobre o Kubernetes. O objetivo aqui tem sido tornar o processo extremamente simples para implantar em menos de 5 minutos, onde a plataforma se encarrega de construir a imagem a partir do código-fonte, armazená-la em um Docker registry e, finalmente, implantar a aplicação no Kubernetes. Algumas das atualizações do nosso último mês incluem o seguinte:
Modelos de machine learning podem ter latências de inferência ou desempenhos muito diferentes com base no tipo de instância. Por exemplo, ao testar a latência de inferência de um modelo do Hugging Face em processadores Intel vs AMD, descobrimos que os processadores Intel eram cerca de 30% mais rápidos. É por isso que agora temos uma opção para permitir que os usuários escolham o tipo de instância ao implantar suas cargas de trabalho. Se o tipo de instância não for selecionado, a carga de trabalho pode ser implantada em qualquer tipo de instância disponível.

Anteriormente, tínhamos um link do Grafana para exibir logs e métricas. Embora o Grafana fosse altamente customizável, o controle de permissão e acesso não era realmente viável nele. Além disso, ele se mostrou um pouco lento e difícil de entender para usuários que não estavam acostumados com o Grafana. Por isso, implementamos nossa própria UI para exibir logs e métricas, o que deve ser suficiente na maioria dos casos. Ainda oferecemos a integração com o Grafana na nuvem pública para usuários mais avançados.


Agora podemos adicionar usuários como editor, viewer ou admin em secret groups.

Agora podemos implantar diretamente na TrueFoundry a partir de qualquer repositório do GitHub ou Bitbucket. Os usuários podem se integrar aos seus próprios repositórios privados usando o fluxo OAuth e selecionar os parâmetros apropriados para implantar a aplicação.

No próximo mês, estamos trabalhando em alguns recursos empolgantes, como:
Fique ligado e envie-nos seu feedback!
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada