


November 5, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Como transformar os dados de custo do seu AI Gateway em uma previsão orçamentária prospectiva — com um sinal de alerta precoce antes de estourar o limite — usando dois modelos de séries temporais bem consolidados, executados de ponta a ponta na TrueFoundry.
A trilogia tokenmaxxing defendeu a atribuição: você não pode governar gastos que não consegue ver. O acompanhamento no Field Notes sobre a oscilação Meta / Amazon / Uber argumentou que a atribuição por si só lhe dá um controle gradual em vez de um interruptor liga/desliga. Mas um controle gradual ainda deixa uma pergunta sem resposta: não "para onde foi o dinheiro?" — isso é o espelho retrovisor —, mas "para onde ele está indo?". Quando foi relatado que a Uber queimou todo o seu orçamento de codificação com IA para 2026 em quatro meses, o problema não era que o gasto fosse invisível. Era que ninguém tinha uma projeção credível de quando o orçamento se esgotaria até que isso já tivesse acontecido.
Este artigo trata de fechar essa lacuna com uma previsão. Vamos guiar uma empresa fictícia, mas realista — a Meridian, uma fintech de médio porte com cerca de 800 engenheiros — desde "temos dados de custo atribuídos" até "temos uma projeção semanal e autoatualizável do gasto de tokens por equipe, com uma margem de incerteza honesta e um alerta que dispara antes que o orçamento seja ultrapassado". Usaremos dois modelos complementares de séries temporais, SARIMAX e Prophet, e vamos construir, implantar e retreinar tudo na TrueFoundry — a mesma plataforma que emite a telemetria de custos do gateway, que também fornece a infraestrutura de ML para treinar, servir e retreinar o previsor.
Tudo aqui depende de um pré-requisito: dados de custo limpos, atribuídos e com registro de data e hora (timestamp). Isso é exatamente o que um AI Gateway bem instrumentado pode produzir: custo no nível da requisição — precificado automaticamente a partir das taxas publicadas pelos provedores — com os metadados necessários para agregar gastos por equipe, rota, modelo, cliente ou centro de custo. Como abordado na trilogia e na visão geral de observabilidade, cada requisição através do gateway emite esse valor de custo etiquetado por modelo, usuário e metadados arbitrários, exportando para seu data warehouse ou pilha de observabilidade. Agregue isso a um total semanal por centro de custo e você terá a única entrada que um previsor precisa: uma série temporal regular e rotulada de gastos.
A previsão é tão boa quanto a disciplina de etiquetagem que a sustenta, portanto essa etapa é mais operacional do que parece. O gateway registrará fielmente quaisquer metadados que suas aplicações enviarem a ele — o que significa que a série temporal é tão limpa quanto essa instrumentação. Antes do treinamento, uma equipe precisa de chaves de metadados estáveis e mapeamentos consistentes de equipes para centros de custo, uma maneira de manter os preços dos modelos atualizados conforme os provedores os alteram, e uma política explícita para os registros incômodos: dados atrasados ou ausentes, rets (retries), fallbacks e respostas em cache que custam pouco ou nada. Normalizar a precificação, remover duplicatas e alinhar registros de data e hora a um único fuso horário não é glamouroso, mas é a diferença entre uma previsão e um artefato de aparência confiante construído sobre ruídos.
Dito isso, esta ainda é a parte que equipes sem um gateway não conseguem fazer. Se seus gastos estiverem espalhados por faturas brutas de provedores, você pode reconstruir um total mensal no nível da empresa, mas não pode obter uma série semanal limpa por equipe com o contexto causal anexado — e séries por equipe, ricas em contexto, são o que torna a previsão útil em vez de decorativa. O gateway não é apenas um ponto de controle de custos; é o instrumento que torna o gasto previsível em primeiro lugar.
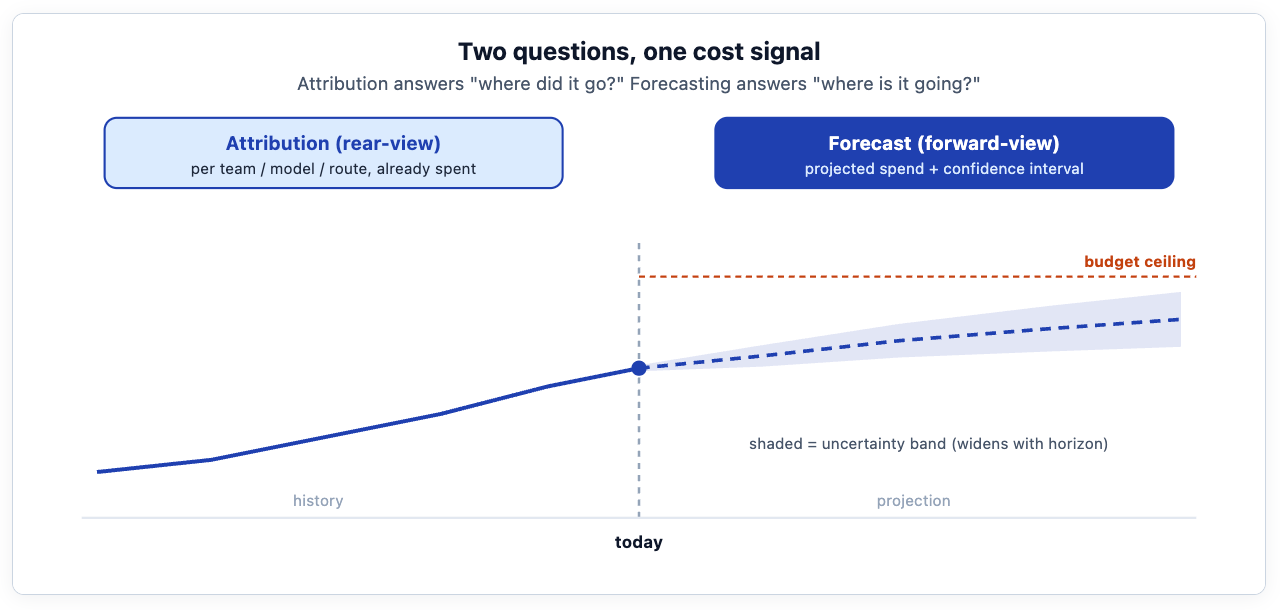
Conheça a Meridian — uma empresa fictícia, mas montada a partir de padrões inteiramente reais. Ela tem cerca de 800 engenheiros, um ano de adoção agressiva de IA interna e uma equipe de finanças que acabou de receber uma pergunta do conselho que não conseguiu responder: "quanto a IA nos custará no próximo trimestre?". A atribuição já foi resolvida — o gateway deles pode mostrar, até o último centavo, quanto o mês passado custou e quem o gerou. O que eles não conseguem fazer é projetar para frente de forma credível. A planilha do CFO extrapola uma linha reta; a equipe de plataforma sabe que a realidade é mais irregular, porque os gastos aumentam durante os lançamentos, caem nos feriados e sobem a cada vez que uma equipe coloca um novo agente em produção.
Essa é a lacuna entre uma linha de tendência e uma previsão. Uma extrapolação em linha reta não tem noção de sazonalidade, nenhuma ideia de quais fatores estão impulsionando a curva e — o mais importante — nenhuma declaração honesta de sua própria incerteza. A Meridian precisa de um modelo que capture o ritmo, consiga incorporar o que sabe que está por vir (o aumento planejado na contagem de funcionários, os três lançamentos do roadmap) e informe um intervalo de confiança em vez de um único número enganosamente preciso.
Não existe um modelo de série temporal único e perfeito, e qualquer pessoa que lhe diga o contrário está tentando vender algo. Para o problema da Meridian, dois garantem seu espaço — e o fazem por razões diferentes.
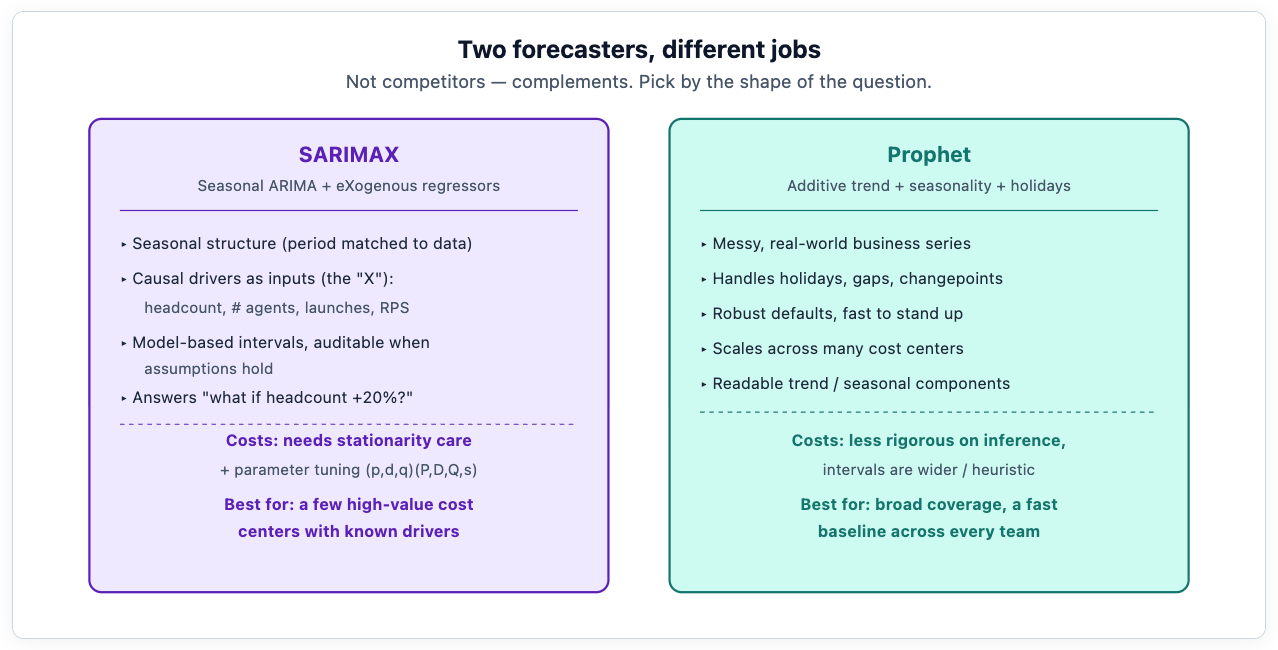
SARIMAX significa Média Móvel Integrada Autorregressiva Sazonal com regressores eXógenos (Seasonal AutoRegressive Integrated Moving Average with eXogenous regressors). Remova a sigla e você terá três ideias. O núcleo ARIMA modela uma série como uma função de seu próprio passado recente — o gasto da semana passada prevê o desta semana. A parte sazonal adiciona um ciclo repetitivo, e o período precisa corresponder a como você agregou os dados: para uma série semanal, a sazonalidade geralmente significa ritmos mais longos, como ciclos de planejamento de sprint, trimestrais ou anuais (um período sazonal de 52 captura o ano), enquanto os efeitos de dias úteis versus finais de semana só existem em uma série diária e usariam um período de 7. Vale a pena ser preciso sobre isso, porque um período sazonal inadequado é uma das maneiras mais comuns de uma previsão dar errado silenciosamente. A parte exógena — o X, e a razão pela qual ele se adapta tão bem à Meridian — permite inserir variáveis externas que impulsionam a série: contagem de engenheiros, número de agentes em produção, sinalizadores de lançamentos planejados. É isso que transforma uma previsão em uma ferramenta de análise "e se": a Meridian pode perguntar "como serão os gastos se adicionarmos vinte engenheiros e lançarmos os três projetos do roadmap?" e obter uma resposta com um intervalo de confiança, não um palpite.
Em termos gerais e ilustrativos, o ajuste se parece com isto — o ponto é a estrutura, não a sintaxe:
O custo desse rigor é real: o SARIMAX precisa que a série seja aproximadamente estacionária (você aplica a diferenciação até que seja — o "I" no nome), e os parâmetros de ordem exigem ajuste. Isso o torna a ferramenta certa para um pequeno grupo de centros de custo de alto valor, onde o esforço se justifica e onde você realmente possui dados dos fatores causais — não para prever duzentas equipes de uma só vez.
O Prophet, o previsor de código aberto do grupo de pesquisa da Meta, adota a postura oposta. Ele decompõe uma série em tendência, sazonalidade e efeitos de feriados, sendo projetado para séries temporais de negócios desorganizadas — com tendência, sazonalidade semanal e anual, feriados, detecção automática de pontos de mudança e ferramentas práticas para lidar com valores discrepantes (outliers) e irregularidades —, produzindo uma previsão razoável com pouco ajuste. Isso não é o mesmo que "nenhuma limpeza de dados necessária" (as ressalvas acima sobre precificação, rets e registros ausentes ainda se aplicam), mas é muito mais tolerante pronto para uso do que o SARIMAX. Para a Meridian, isso o torna a escolha natural para a cauda longa: execute-o na série de cada equipe para obter uma previsão de linha de base robusta em todos os lugares, de forma barata, sem ajustar manualmente duzentos modelos.
O compromisso é o espelho do SARIMAX. O SARIMAX pode fornecer intervalos baseados em modelos que são mais fáceis de auditar quando suas premissas se mantêm; o Prophet também fornece intervalos de incerteza úteis, mas eles são derivados de forma diferente e as equipes devem calibrar ambos contra testes retrospectivos, em vez de tratar qualquer um como uma garantia formal. O que o Prophet não oferece nativamente é a análise causal limpa "e se" que os regressores exógenos fornecem — e tudo bem, porque você não está pedindo isso a ele. A arquitetura pragmática em que a Meridian se apoia é executar ambos: Prophet para amplitude em todas as equipes, SARIMAX aplicado nos três ou quatro centros de custo grandes o suficiente para justificar a modelagem baseada em fatores causais. Os dois juntos cobrem mais terreno do que qualquer um sozinho.
Antes da história operacional, a ressalva que impede que isso seja conversa fiada. O resultado mais importante de uma previsão não é sua estimativa pontual — é seu intervalo de incerteza. Um modelo que diz "o próximo trimestre custará US$ 1,2M" é muito menos útil, e muito mais perigoso, do que um que diz "o próximo trimestre ficará entre US$ 1,0M e US$ 1,5M com 80% de confiança, e aqui está o porquê de a margem ser tão ampla". A margem é o que diz a uma equipe de finanças se ela está olhando para um erro de arredondamento ou para um risco real. E ela deve se alargar com o horizonte: qualquer previsor que afirme a mesma precisão sobre a semana 12 que sobre a semana 1 está escondendo a verdade. O modelo interativo abaixo é construído exatamente em torno dessa funcionalidade.
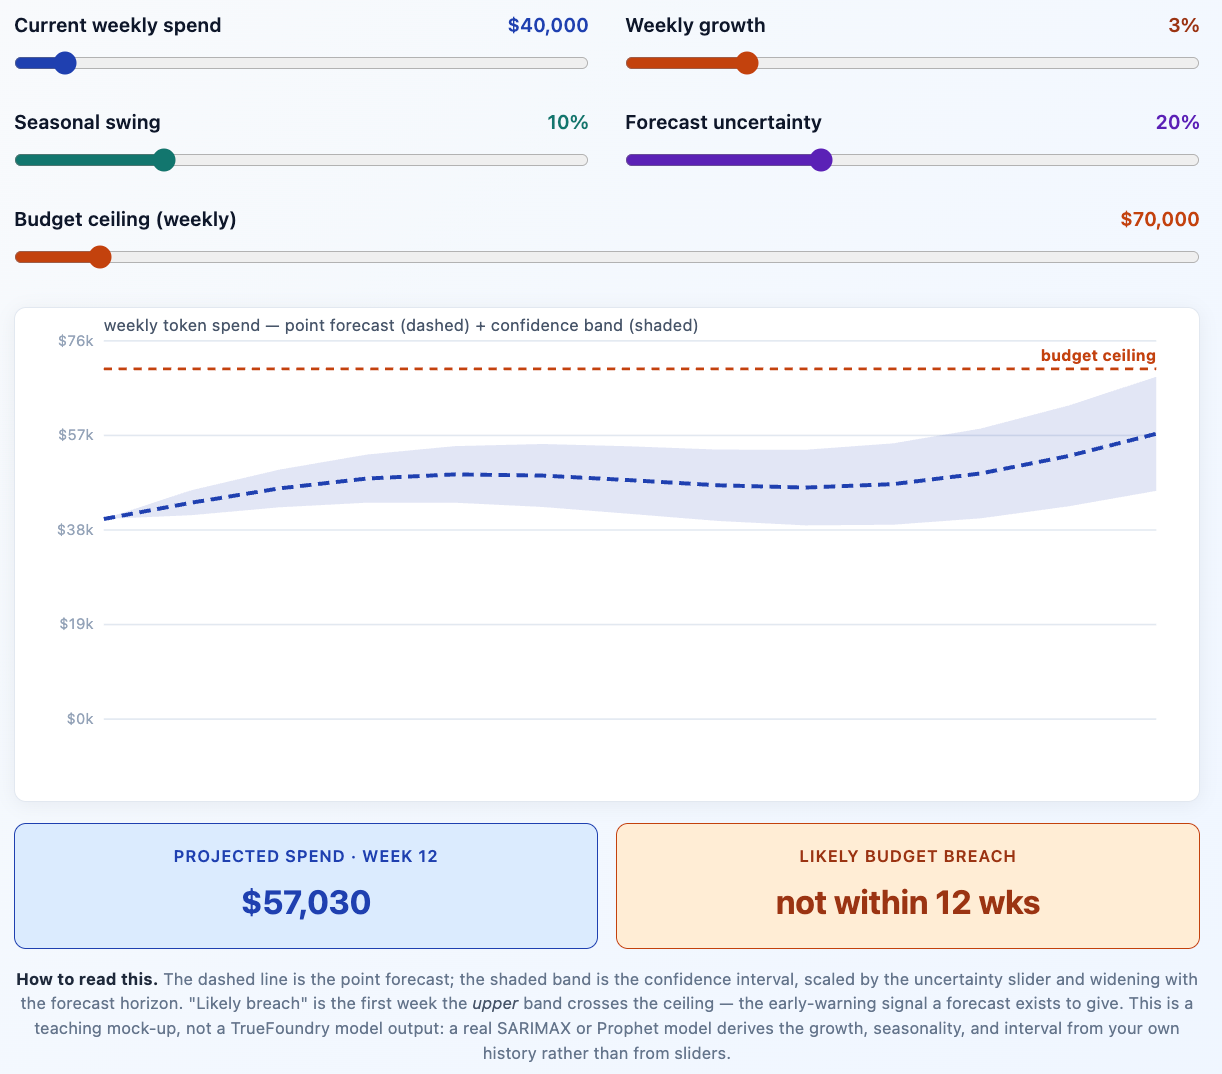
Observe o que o sinal de alerta precoce realmente é. Não é a previsão pontual cruzando o teto orçamentário — é o momento em que o limite superior da margem o cruza. Essa é a primeira semana em que uma ultrapassagem se torna plausível em vez de certa, e é o momento certo para agir, porque agir cedo é barato e agir tarde resulta no teto rígido e abrupto contra o qual toda essa abordagem argumenta. Uma boa previsão compra esse tempo de antecedência.
Este é o fio secundário, mantido deliberadamente em sua própria seção para não poluir a discussão sobre previsão. É aqui que as duas metades da plataforma TrueFoundry se encontram, e onde isso deixa de ser um tutorial genérico de ciência de dados. A maioria dos textos sobre Prophet ou SARIMAX para no modelo. Mas um modelo em um notebook não é uma previsão em que uma equipe de finanças possa confiar — é um evento isolado. A parte difícil, não glamourosa e verdadeiramente valiosa é operacional: fazer com que o modelo seja treinado em uma infraestrutura real, versionado para que você possa comparar e promover, servido atrás de uma API que o painel (dashboard) possa chamar e — a parte que quase todos esquecem — retreinado automaticamente para que não se deteriore silenciosamente à medida que os padrões de gastos mudam.
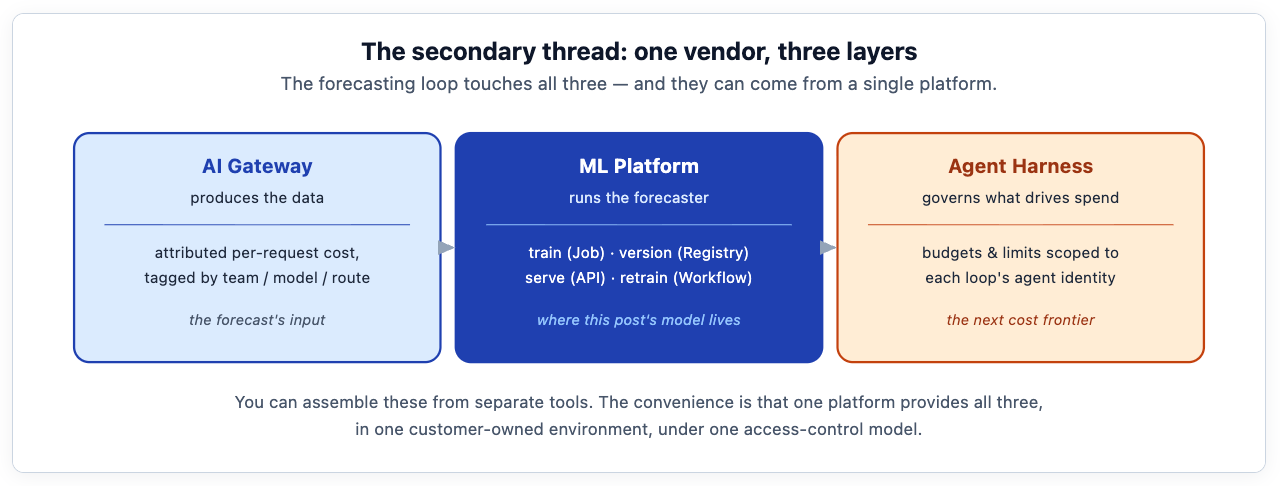
A TrueFoundry é, por baixo do gateway, uma plataforma de ML construída no Kubernetes. Seu objetivo de design, declarado abertamente na documentação de arquitetura, é que os dados não devem sair da sua nuvem — o mesmo modelo de plano dividido do gateway, onde o plano de controle da TrueFoundry orquestra enquanto o seu plano de computação executa as cargas de trabalho reais dentro da sua própria conta. Para uma fintech como a Meridian, essa propriedade não é um simples diferencial; dados de custo etiquetados por equipe e projeto são sensíveis, e manter o treinamento e o servimento dentro da VPC é o que torna essa abordagem viável.
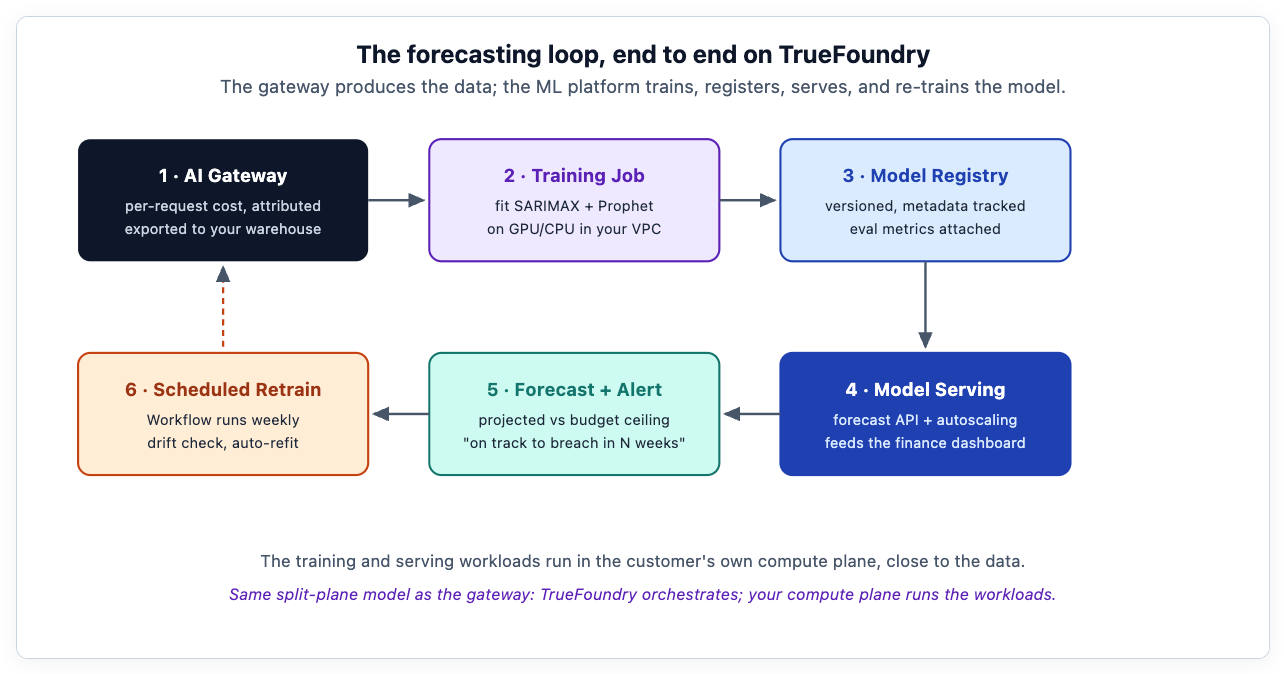
Concretamente, o loop se mapeia nos módulos da plataforma TrueFoundry que a documentação de arquitetura descreve diretamente:
Treinamento como um Job. O ajuste do modelo é executado como um Job da TrueFoundry — uma tarefa em contêiner no seu plano de computação Kubernetes, com os recursos de CPU ou GPU de que precisa, lendo os dados de custo exportados pelo gateway. Nenhum notebook deixado em execução no laptop de alguém; um trabalho reprodutível com entradas rastreadas.
Versionamento no Model Registry. A TrueFoundry fornece um registro de modelos para que cada previsor treinado seja versionado com seus metadados e métricas de avaliação anexados. Quando o modelo desta semana apresenta resultados piores nos testes retrospectivos do que o da semana passada, você pode comparar as versões e escolher se deseja promover a nova ou continuar servindo a atual — a diferença entre um experimento e um serviço confiável.
Servimento como uma API. O modelo escolhido é implantado como um Service da TrueFoundry: um endpoint com escalonamento e monitoramento que o painel financeiro chama para obter a projeção e a margem mais recentes. Escalabilidade automática e verificações de integridade vêm da plataforma, não de código de integração (glue code).
Retreinamento agendado como um Workflow. Esta é a pedra angular. A TrueFoundry integra um motor de fluxo de trabalho (ArgoWorkflows) para exatamente esse tipo de trabalho agendado e de várias etapas. Um fluxo de trabalho semanal busca os dados de custo mais recentes, verifica o desvio (drift) no modelo ativo, reajusta se necessário, avalia e promove a nova versão apenas se ela superar a atual. A previsão se mantém atualizada sem que ninguém precise se lembrar de executar um script.
Custo atribuído, naturalmente. Como as próprias cargas de trabalho de previsão são executadas na TrueFoundry, seu custo de computação também é atribuído pela plataforma — a documentação de arquitetura observa a atribuição detalhada de custos por serviço via OpenCost. O sistema que prevê seus gastos com IA relata seu próprio custo no mesmo painel. O instrumento é calibrado contra si mesmo.
Essa história de ponta a ponta — o gateway produz os dados, a plataforma de ML treina, serve e retreina o modelo, sob um único modelo de controle de acesso — é algo que uma biblioteca simples de previsão não pode oferecer, e é a parte que torna essa uma decisão de plataforma em vez de um projeto paralelo de ciência de dados. Para ser preciso sobre o limite: as cargas de trabalho de treinamento e servimento são executadas no seu plano de computação, próximo aos dados, enquanto o plano de controle da TrueFoundry as orquestra; como em qualquer implantação, as equipes devem confirmar quais metadados, logs, licenciamento e registros do plano de controle saem do ambiente sob o modelo e contrato escolhidos. E para ser preciso sobre a divisão de trabalho: a TrueFoundry não torna o SARIMAX ou o Prophet especiais, nem produz uma previsão de nível financeiro pronta para uso. O que ela torna pronto para produção é o loop ao redor do modelo — dados de custo atribuídos do gateway, jobs de treinamento no plano de computação do cliente, versionamento, servimento, retreinamento baseado em fluxos de trabalho e atribuição de custos para a própria carga de trabalho de previsão. O cliente ainda constrói e valida o modelo; a plataforma é o substrato que permite que esse modelo seja executado de forma confiável. O ponto não é que SARIMAX e Prophet sejam exóticos; eles não são. O ponto é que a distância entre "um modelo que funciona em um notebook" e "uma previsão em que as finanças confiam toda segunda-feira de manhã" é exatamente a distância para a qual uma plataforma de ML foi construída para cobrir.
Uma previsão que ninguém validou é apenas uma linha de aparência confiante, e enviar alertas a partir de um modelo não validado é a maneira perfeita de ensinar uma equipe de finanças a ignorar seus alertas. Antes que qualquer projeção oriente uma decisão, ela precisa conquistar a confiança no histórico. O método padrão é a avaliação de origem móvel (rolling-origin evaluation), às vezes chamada de caminhada para frente (walk-forward): treine nas semanas 1 a N, preveja as semanas N+1 a N+12, compare com o que realmente aconteceu, depois deslize a janela para frente e repita. Feito em todo o histórico, isso mostra como o modelo teria se comportado semana após semana, não apenas em uma divisão de dados de sorte.
Acompanhe algumas métricas, pois cada uma responde a uma pergunta diferente. MAPE ou WAPE — erro como uma porcentagem — é a métrica legível para um público financeiro ("estamos normalmente dentro de 8%"). O RMSE pune erros grandes com mais rigor, trazendo à tona a eventual semana ruim que uma média percentual suavizaria. E a métrica que a maioria das pessoas esquece: cobertura de intervalo — a margem de 80% realmente contém o valor real em cerca de 80% do tempo? Um modelo cuja margem de 80% só acerta a realidade metade do tempo está mentindo sobre sua própria confiança, e isso é pior do que uma margem mais ampla e honesta. A regra de promover apenas se for melhor no retreinamento agendado deve ser escrita com base nessas métricas: um novo modelo semanal substitui o atual apenas se o superar na métrica de erro combinada, sem degradar a cobertura.
Juntando tudo: o gateway da Meridian está emitindo custos atribuídos há meses, então eles têm uma série semanal limpa por equipe. Um Job de treinamento da TrueFoundry ajusta o Prophet em todas as equipes para uma linha de base, e o SARIMAX nos quatro maiores centros de custo usando a contagem de funcionários e de agentes como regressores. Ambos os modelos chegam ao registro com seus erros de testes retrospectivos gravados. O melhor modelo por centro de custo é servido atrás de uma API de previsão. O painel financeiro agora mostra, para cada equipe, uma curva de gastos projetada com uma margem de 80% e um sinalizador — verde, amarelo ou provável violação — com base em onde a margem superior se situa em relação ao orçamento dessa equipe. Um fluxo de trabalho semanal mantém tudo atualizado.
A pergunta do conselho — "quanto a IA nos custará no próximo trimestre?" — agora tem uma resposta honesta: um intervalo, com os fatores causais identificados, e um alerta que disparará na janela de tempo antes que qualquer equipe ultrapasse o limite, e não depois. A Meridian não eliminou o custo. Ela tornou o custo legível para o futuro, que é a única coisa que converte um orçamento de uma parede em que você bate em um plano que você guia. Esse é o controle gradual, apontado para a frente.
Isso não é uma afirmação de que a previsão elimina a necessidade de julgamento, nem que um modelo pode executar a governança de custos no piloto automático. Uma previsão é um suporte à decisão: ela alarga a janela em que um ser humano pode agir e torna a ação mais barata ao fornecer tempo de antecedência. Ela não decide se uma trajetória de gastos é aceitável — essa é uma decisão de negócios sobre se o trabalho que os tokens produzem vale a pena, que é a mesma questão de entrada versus saída em que a trilogia se baseou. Uma previsão que ultrapassa o orçamento pode significar "corte desperdícios" ou pode significar "aumente o orçamento porque esta equipe está entregando resultados" — o modelo não pode dizer qual é o caso, e qualquer fornecedor que implique o contrário está prometendo demais.
Tampouco esta é uma afirmação de que SARIMAX e Prophet são os únicos ou melhores modelos — gradient-boosted trees, modelos de espaço de estados e deep forecasters têm todos o seu lugar, e para algumas séries um baseline sazonal ingênuo simples é realmente difícil de superar. Os dois que escolhemos são bem compreendidos, bem suportados e uma combinação padrão sensata; eles são um forte ponto de partida, não uma resposta final. E o gráfico interativo acima é um modelo educacional orientado por sliders, não uma saída de modelo da TrueFoundry — uma previsão real deriva seu crescimento, sazonalidade e intervalo do seu histórico, não de um controle que você arrasta. A abordagem honesta é a mesma que esta série manteve do início ao fim: a plataforma oferece os instrumentos; sua equipe ainda os lê e toma a decisão.
Você pode com certeza começar com um, e para a maioria das equipes o Prophet é o primeiro passo mais rápido — ele oferece um baseline robusto para todos os centros de custo com ajuste mínimo. Adicione o SARIMAX mais tarde, e apenas nos poucos centros de custo de alto valor onde você tem dados reais de fatores determinantes (número de funcionários, contagem de agentes, calendário de lançamentos) e deseja intervalos mais estreitos e a capacidade de simulação "what-if" que os regressores exógenos fornecem. A combinação é o estado de maturidade, não um pré-requisito.
Uma linha reta não tem sazonalidade, não considera fatores determinantes e — o que é fatal — não possui faixa de incerteza. Ela estará confiantemente errada em datas de lançamentos e feriados, e não oferece à equipe financeira nenhuma maneira de distinguir uma pequena oscilação de um risco real. Todo o valor de uma previsão está no intervalo honesto e no sinal de alerta precoce; uma linha de tendência não possui nenhum dos dois.
As cargas de trabalho de treinamento e serving podem ser executadas no seu próprio plano de computação, próximas aos dados, com o plano de controle da TrueFoundry orquestrando em vez de ingerir os dados de treinamento. Essa é a propriedade que torna a abordagem viável para cargas de trabalho regulamentadas — mas as equipes devem confirmar exatamente quais metadados, logs, licenças e registros do plano de controle saem do ambiente sob o modelo de implantação e contrato escolhidos, em vez de tratar "nada sai" como algo automático.
Isso depende de quão rápido seus padrões de gastos mudam, mas semanalmente é um padrão sensato para custos de tokens, que mudam com ciclos de sprint e lançamentos. O importante é que o retreinamento seja automatizado como um workflow agendado, com uma verificação de drift e um filtro para promover apenas se for melhor, para que a previsão acompanhe o ritmo sem esforço manual e sem degradar silenciosamente.
Se o seu gasto mensal com IA for pequeno e estável, uma previsão não vale o esforço — atribuição e um alerta de orçamento são suficientes. A previsão justifica seu uso quando o gasto é grande, crescente e instável o suficiente para que a diferença entre "vamos estourar na semana 5" e "vamos estourar na semana 11" mude o que você faz este mês. A Meridian já passou desse limite; uma startup de dez pessoas provavelmente ainda não.
A trilogia tokenmaxxing (o argumento de atribuição sobre o qual este texto é construído):
Parte 1 — The Cost-Governance Gap. Parte 2 — The Architecture of Governed AI Usage. Parte 3 — Building the AI Leverage Control Room.
Notas de Campo (o efeito chicote e o argumento do controle gradual em vez de chave liga/desliga):
When AI Cost Control Becomes a Switch — and Why It Should Be a Gateway (a reversão da Meta / Amazon / Uber, com citações de fontes primárias).
Plataforma TrueFoundry (a superfície do produto sob este conceito):
Arquitetura da plataforma de ML — Machine Learning on Kubernetes (treinamento, registry, serving, workflows, implantação em plano dividido, atribuição via OpenCost). AI Gateway — product page. Observabilidade e rastreamento de custos — observability in the AI Gateway. Documentação da plataforma — docs.truefoundry.com/introduction.
Os modelos (documentação externa e aberta):
O SARIMAX está documentado em statsmodels; o Prophet está documentado em facebook.github.io/prophet.
Escrito pela equipe da TrueFoundry. Este é um artigo educacional; a Meridian é uma empresa fictícia e o gráfico interativo é uma simulação ilustrativa, não uma saída de produto ou um benchmark. Previsão é um suporte à decisão, não uma garantia — valide qualquer modelo com seus próprios dados e trate seus intervalos, e não suas estimativas pontuais, como o sinal real.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















