August 26, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Blazingly fast way to build, track and deploy your models!
Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna já estão disponíveis no AI Gateway da TrueFoundry
A terça-feira foi um dia agitado para quem trabalha com tráfego de LLM. A Anthropic lançou o Claude Opus 5.5, e minutos depois a OpenAI lançou o GPT-6 SoleGPT-6 Luna, dois modelos de custo mais baixo, irmãos do GPT-6 Astra.
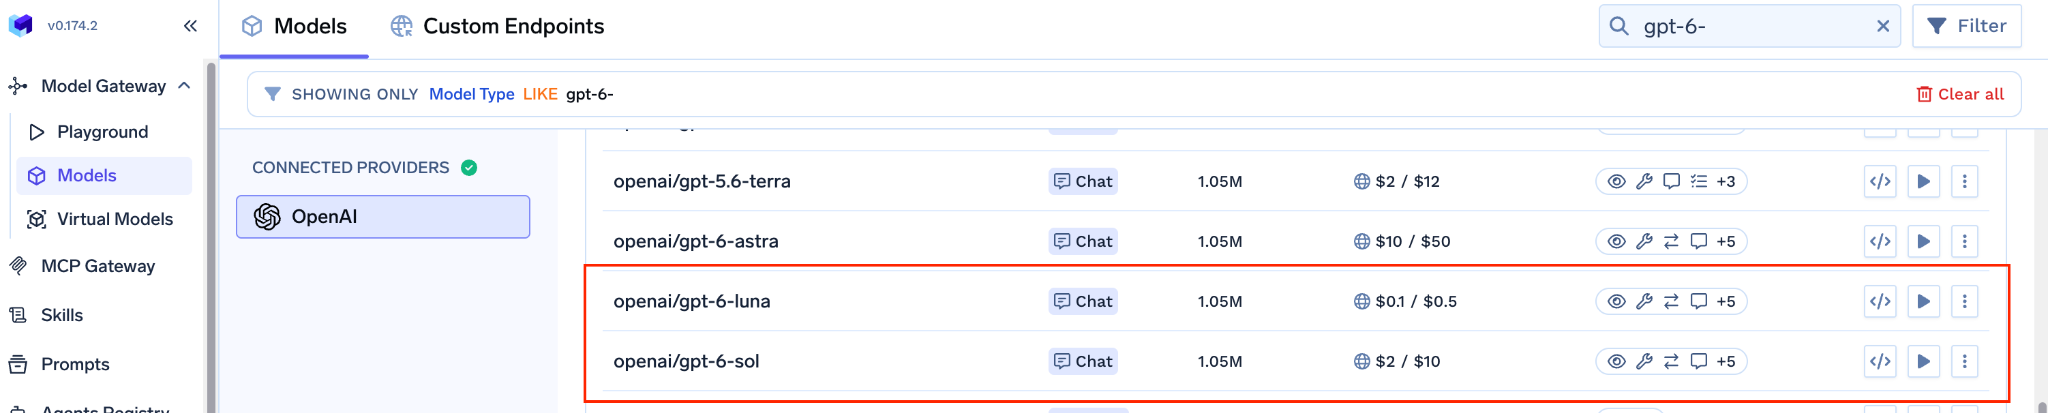
Todos os três já estão no catálogo de modelos do TrueFoundry AI Gateway, com preços, limites de contexto e capacidades já preenchidos. Você pode chamá-los a partir do mesmo endpoint compatível com OpenAI que já utiliza para tudo o resto. Sem novo SDK, sem integração separada, sem esperar por uma atualização do gateway. Basta alterar a string do modelo e você já estará usando a nova versão.
Experimente no TrueFoundry AI Gateway →
A Anthropic afirma que o Opus 5.5 tem um desempenho equivalente ao do Claude Fable 5.1 na maioria das tarefas, mantendo o preço do Opus. Os pontos que importam para um orçamento de produção:
Sol e Luna foram treinados com os mesmos métodos do GPT-6 Astra (que foi lançado em 3 de setembro por US$ 10 / US$ 50) e, em seguida, otimizados para custo. A OpenAI posiciona o Sol para tarefas recorrentes de codificação e agentes, e o Luna para trabalhos rotineiros de alto volume, como extração e sumarização.
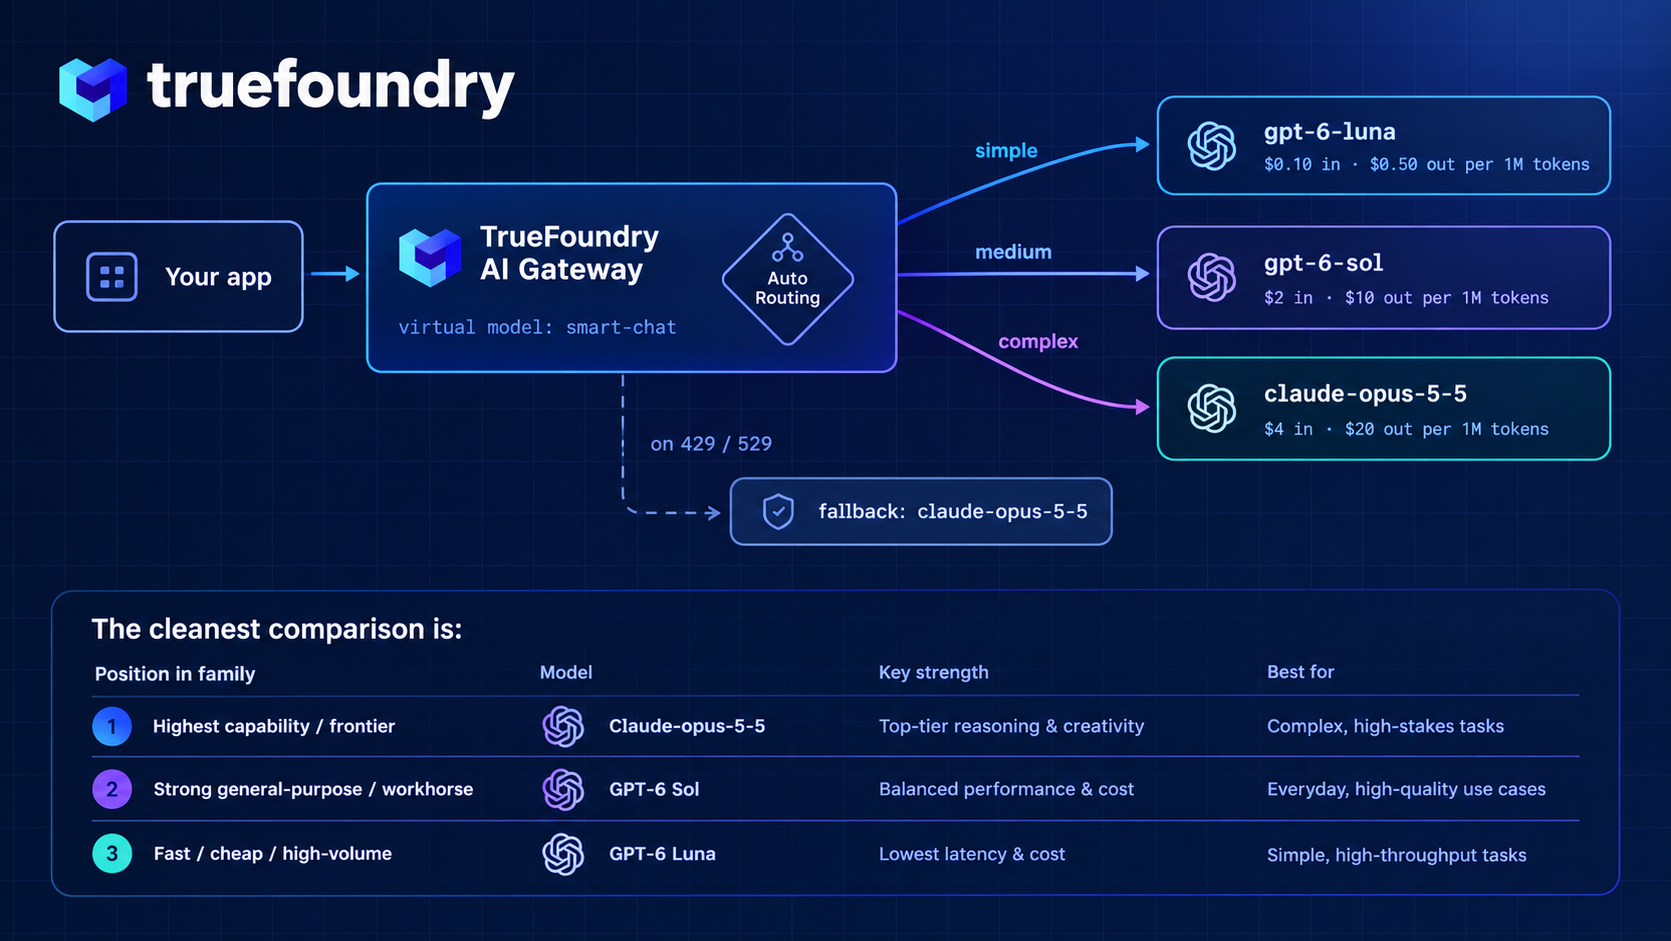
Coloque os modelos de setembro lado a lado e a diferença é difícil de ignorar: Luna a US$ 0,10 por milhão de tokens de entrada, Sol a US$ 2, Opus 5.5 a US$ 4, Astra a US$ 10. Uma diferença de cem vezes entre a opção mais barata e a mais cara, de dois fornecedores, em duas APIs nativas diferentes.
Essa diferença é o argumento central contra escolher um modelo padrão e enviar tudo para ele. A maior parte do tráfego de produção consiste em muitas solicitações fáceis e algumas difíceis. Envie a maioria fácil para o Luna e a parte complexa para o Opus 5.5, e a fatura combinada não se parecerá em nada com uma fatura apenas de Opus. Isso só funciona se a troca de modelos for uma alteração de configuração em vez de uma alteração de código, que é o trabalho que o Gateway de IA existe para fazer.
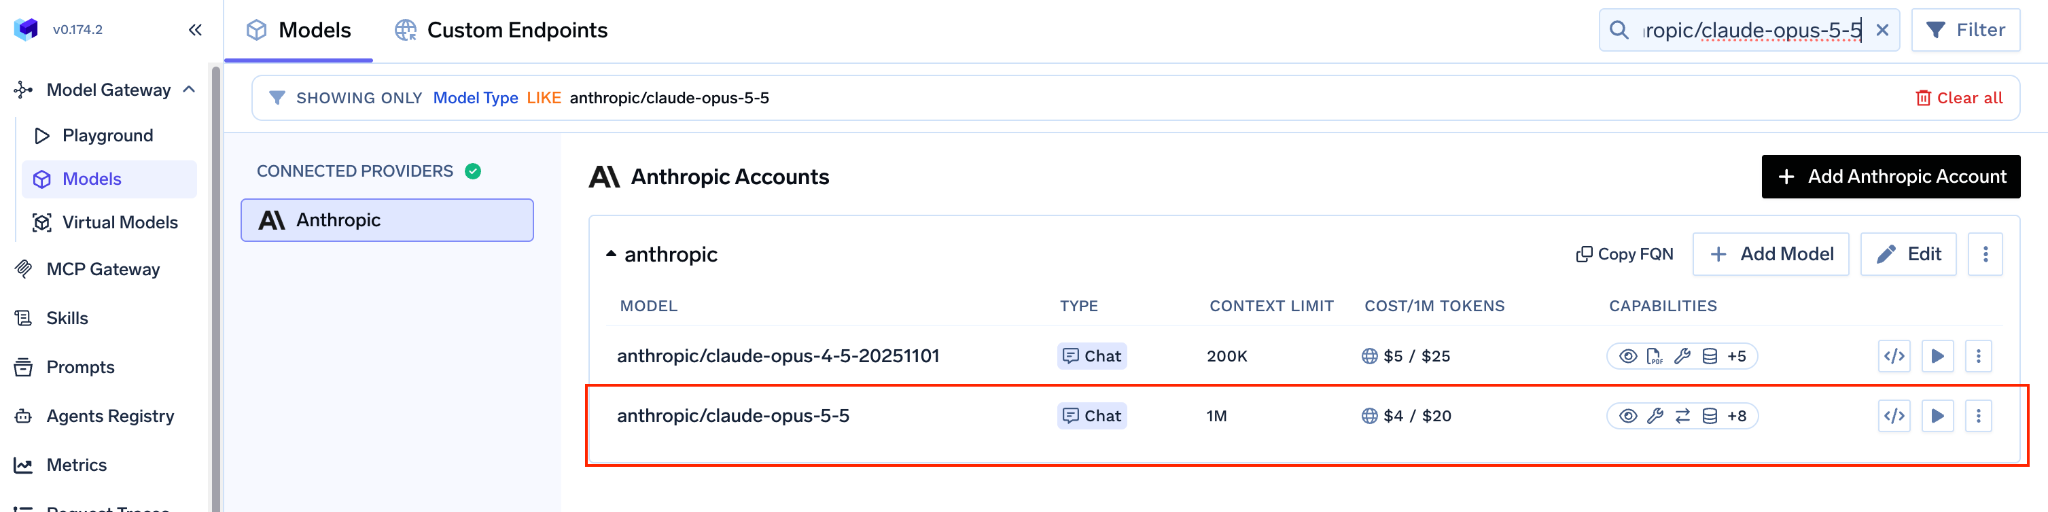
No gateway, abra Modelos → sua conta Anthropic → Seleção de Modelos, procure por claude-opus-5-5 e marque-o. O preço é exibido diretamente (US$ 4 de entrada / US$ 20 de saída por 1 milhão de tokens) porque vem direto do catálogo. Em seguida, defina Controle de Acesso para que um modelo de preço de ponta seja limitado às equipes e chaves virtuais certas desde o primeiro dia.
Repita o processo na sua conta OpenAI para gpt-6-sol e gpt-6-luna.
Se você preferir executar esses modelos através de uma nuvem, o catálogo também cobre esses caminhos:
Não encontrou um modelo na sua lista ainda? + Adicionar Modelo na parte inferior da lista permite adicioná-lo manualmente. O gateway suporta todos os modelos de texto publicados pela Anthropic e pela OpenAI.
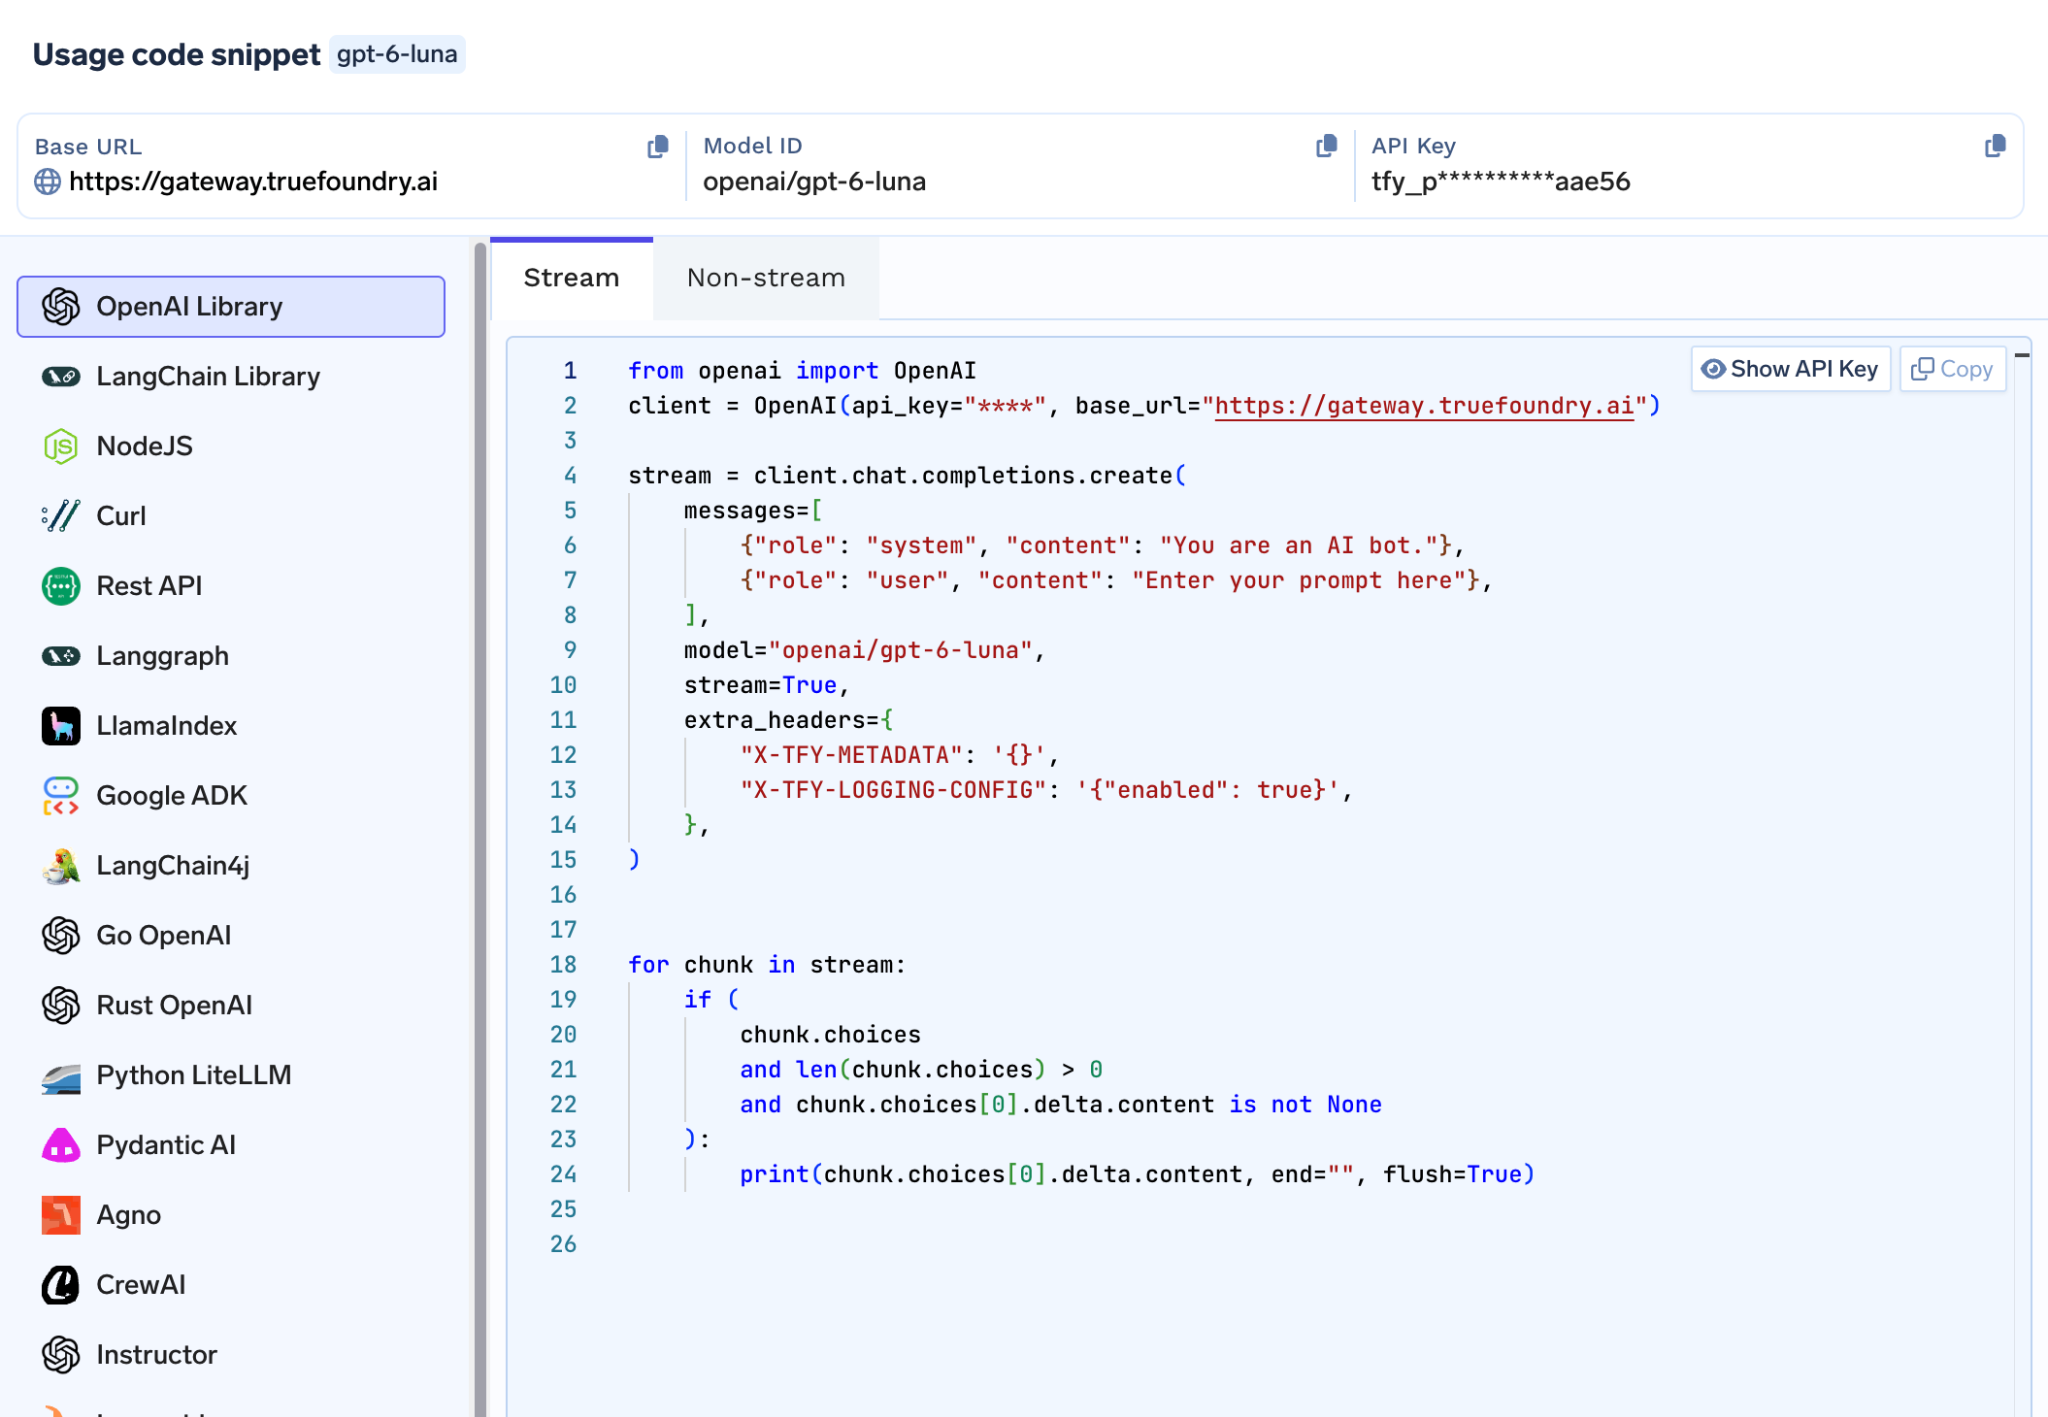
Abra o Playground, escolha um modelo e copie o trecho gerado no SDK que você utiliza (SDK da OpenAI, LangChain, Node.js, cURL e outros). A versão para Python da OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="<your-truefoundry-api-key>",
    base_url="https://gateway.truefoundry.ai",  # or your self-hosted gateway URL
)

# Model IDs are <provider-account>/<model>.
# Swap the string, keep everything else.
for model in [
    "anthropic-prod/claude-opus-5-5",
    "openai-prod/gpt-6-sol",
    "openai-prod/gpt-6-luna",
]:
    r = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Summarise this incident in three bullets: ...",
            }
        ],
        extra_headers={
            "X-TFY-METADATA": '{"team": "platform", "feature": "incident-summary"}'
        },
    )

    print(model, "->", r.choices[0].message.content)
Os IDs dos modelos seguem o namespace <your-provider-account>/<model>, portanto, anthropic-prod/claude-opus-5-5 e openai-prod/gpt-6-luna podem ser trocados entre si com apenas uma linha de código. O cabeçalho X-TFY-METADATA etiqueta cada chamada para que os gastos apareçam por equipe ou por funcionalidade na visualização de métricas.
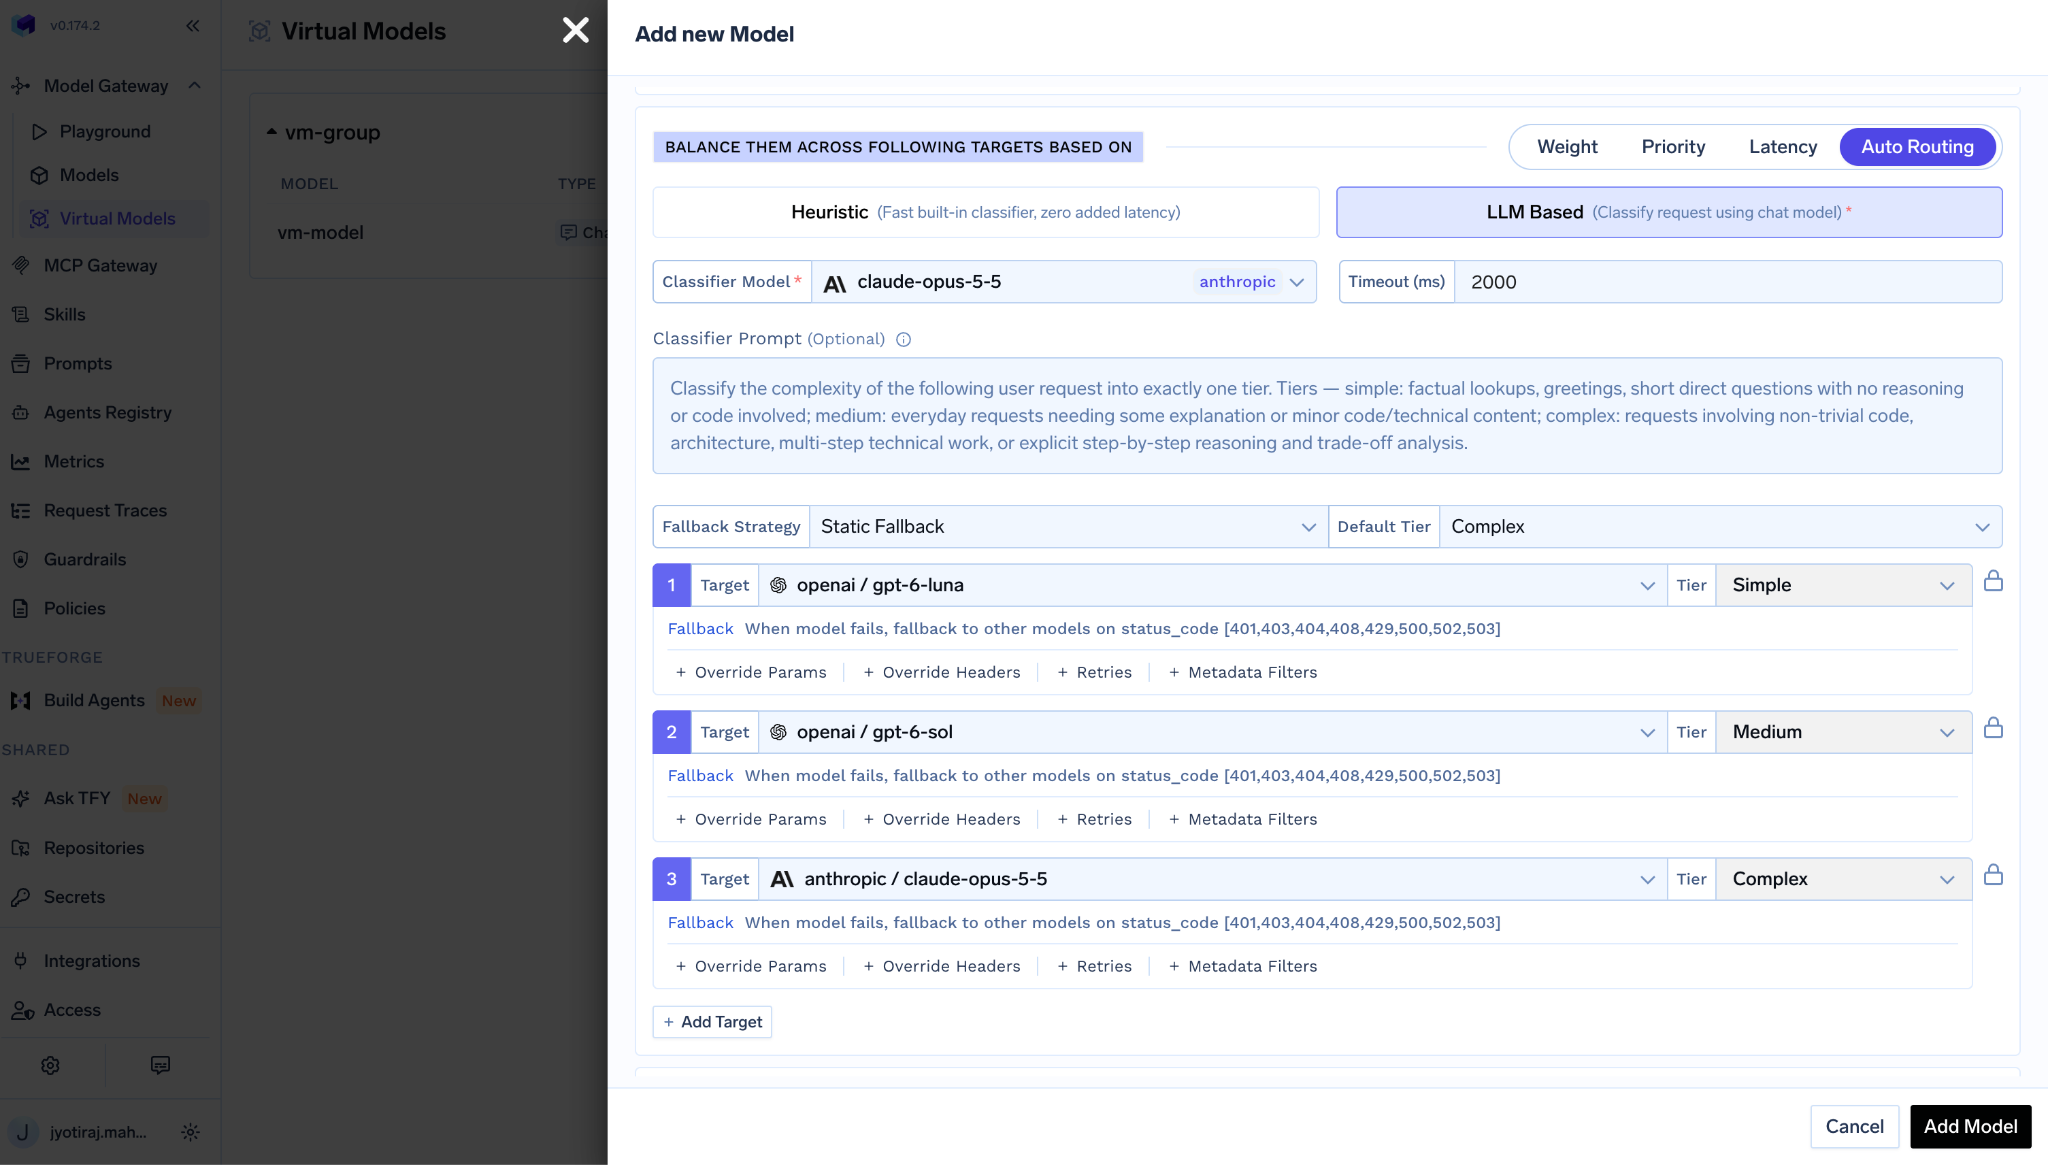
Crie um modelo virtual e escolha AI Gateway. O gateway classifica cada solicitação como simples, média ou complexa e a envia para o destino que você atribuir a esse nível. Luna para simples, Sol para média e Opus 5.5 para complexa é um mapeamento inicial sensato. Em nossos benchmarks, esse tipo de roteamento reduziu os custos em 50-70%, mantendo cerca de 98% da qualidade. Adicione o Opus 5 ou o Astra como destino de fallback. Sua aplicação chama apenas um nome de modelo durante todo o processo.
O Opus 5.5 é o modelo que você escolhe quando a tarefa é difícil e o preço do Fable não se justifica. Sol e Luna são os que você escolhe quando a tarefa não é nada difícil. Executar todos eles através do TrueFoundry significa que a decisão sobre qual usar fica na configuração do gateway, onde você pode alterá-la em uma tarde de terça-feira sem precisar de um novo deploy.
Experimente o Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna no AI Gateway da TrueFoundry →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada