Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
Volumes bieden permanente opslag voor containers binnen pods, zodat ze gegevens kunnen lezen en schrijven naar een centrale schijf over meerdere pods heen. Ze zijn bijzonder nuttig bij machine learning wanneer u gegevens, modellen en andere artifacts moet opslaan en openen die nodig zijn voor training-, serving- en inference-taken.
In deze blog bespreken we hoe u volumes kunt gebruiken en welke opties beschikbaar zijn in elke cloud.
Wanneer gebruikt u Kubernetes volumes?
Enkele use-cases waarin volumes zeer nuttig blijken te zijn:
Trainingsgegevens delen: Het is mogelijk dat meerdere data scientists op dezelfde gegevens trainen, of dat we meerdere experimenten parallel uitvoeren op dezelfde dataset. De naïeve manier is om de gegevens te dupliceren voor meerdere data scientists — dit zal ons echter veel meer kosten. Een efficiëntere manier is om de trainingsgegevens op te slaan in een volume en het volume te mounten op de notebooks van verschillende data scientists.
Modelopslag: Als we modellen hosten als real-time API's, zullen er meerdere replica's van de API-server zijn om het verkeer af te handelen. Hier moet elke replica het model downloaden van de model registry (bijvoorbeeld S3) naar de lokale schijf. Als elke replica dit herhaaldelijk doet, duurt het opstarten langer en brengt dit ook meer S3-toegangskosten met zich mee. Met volumes kunt u uw getrainde modellen extern opslaan en ze mounten op de inference-server. Het model hoeft niet te worden gedownload; de API-server kan het model gewoon op schijf vinden op het gemounte pad.
Artifacts delen: We kunnen een use-case hebben waarbij de output van de ene pipeline-fase moet worden gebruikt door de volgende fase. Na het finetunen van een model moeten we het bijvoorbeeld mogelijk hosten als een API, louter voor experimenten. Hoewel we het model naar S3 kunnen schrijven en het vervolgens weer kunnen downloaden van S3, kost het upload-/downloadproces van het model veel tijd. Voor snellere experimenten kan de finetuning-job het model in plaats daarvan gewoon naar een volume schrijven, waarna de inference-service het volume met het model kan mounten.
Checkpointing: Tijdens het trainen van machine learning-modellen is het gebruikelijk om periodiek checkpoints op te slaan om de training te hervatten bij storingen of om modellen te finetunen. Volumes kunnen worden gebruikt om deze checkpoint-bestanden op te slaan, zodat de trainingsvoortgang niet verloren gaat wanneer een job opnieuw opstart na een fout. Dit stelt u ook in staat om training uit te voeren op spot-instances, wat veel kosten bespaart.
Laten we het nu hebben over ML-use-cases. In de meeste gevallen krijgen ML Engineers de gegevens binnen in S3 Buckets, GCS Buckets of Azure Blob Storage. Als ze op deze gegevens modellen willen trainen, moeten ze de gegevens downloaden naar hun trainingsworkload (geïmplementeerde job of notebook) of de inhoud van hun bucket rechtstreeks mounten op de workload.
Wanneer gebruikt u een Volume vs. Blob-opslag zoals S3 / GCS / Azure Container?
Het maken van een keuze tussen blob-opslag zoals S3 en een volume is belangrijk vanuit het oogpunt van prestaties, betrouwbaarheid en kosten.
Prestaties
In de meeste gevallen zal het lezen van gegevens uit S3 trager zijn dan het rechtstreeks lezen van gegevens uit een volume. Dus als de laadsnelheid cruciaal voor u is, is een volume de juiste keuze. Een uitstekend voorbeeld hiervan is het downloaden en laden van het model op inference-tijd in meerdere replica's van de service. Een volume is een betere keuze omdat u niet de tijd kwijt bent aan het herhaaldelijk downloaden van het model en het model veel sneller vanuit het volume in het geheugen kunt laden.
Betrouwbaarheid
Blob-opslagen zoals S3/GCS/ACS zijn over het algemeen betrouwbaarder dan volumes. U dient daarom idealiter altijd een back-up van de ruwe gegevens te maken in een van de blob-opslagen en volumes alleen te gebruiken voor tussenliggende gegevens. Ook moet u permanent een kopie van de modellen opslaan in S3.
Kosten
Toegang tot volumes zoals EFS is iets goedkoper dan het gebruik van S3 - dus als u dezelfde gegevens vrij vaak leest, kan het nuttig zijn om deze in een volume op te slaan. Als u zeer zelden leest of schrijft, is S3 prima geschikt.
Toegangsbeperkingen
Gegevens in volumes mogen idealiter alleen worden benaderd door workloads binnen dezelfde regio en hetzelfde cluster. S3 is bedoeld om wereldwijd en over verschillende cloudomgevingen heen te worden benaderd, dus volumes zijn geen goede keuze als u toegang wilt tot de gegevens in een andere regio of bij een andere cloudprovider.
Volume Provisioning-modi
Om alle typen volumes te ondersteunen, biedt TrueFoundry twee volume provisioning-modi die aansluiten op verschillende use-cases:
Dynamisch
Dit zijn volumes die dynamisch worden aangemaakt en geconfigureerd zodra u een volume implementeert op TrueFoundry. E.g. EBS, EFS in AWS en AzureFiles in Azure kunnen dynamisch worden geconfigureerd op TrueFoundry.
Statisch
Dit zijn volumes waarvoor al een opslagvolume bestaat en waarvan we de gegevens willen mounten op onze service/job. Voorbeelden hiervan zijn het mounten van S3-buckets en GCS-buckets op de workloads die op het platform zijn geïmplementeerd.
Laten we dus begrijpen hoe deze twee werken en welke opties beschikbaar zijn in elke cloud:
Dynamisch Geconfigureerde Volumes
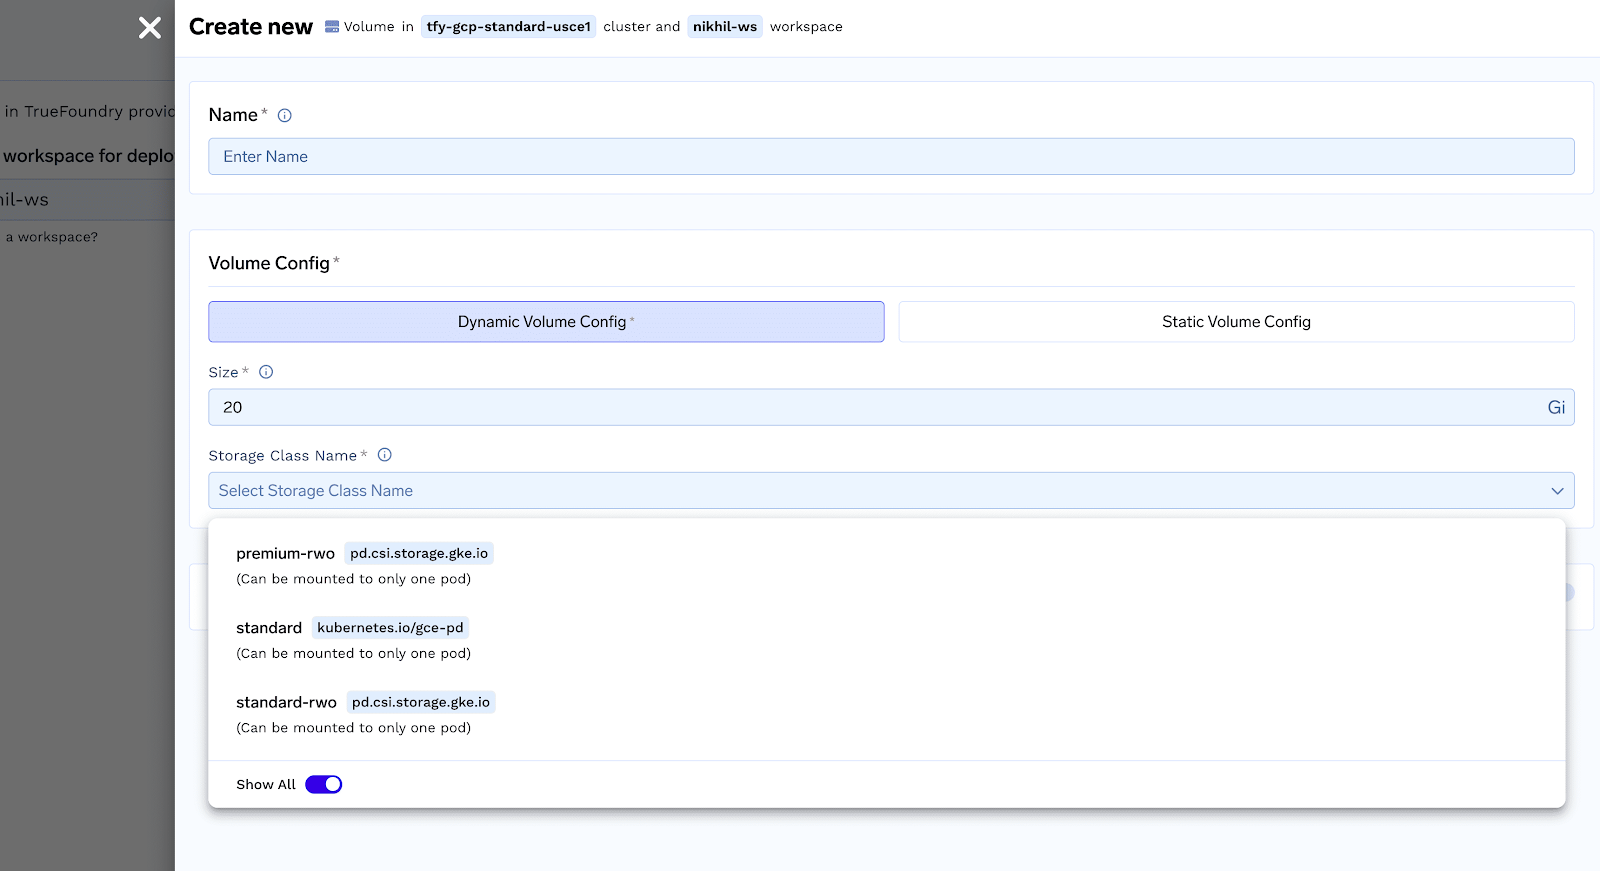
Dynamisch geconfigureerde volumes vereisen dat u een storage class opgeeft. Een volume wordt dynamisch geconfigureerd op basis van de storage class en de grootte die door de gebruiker zijn opgegeven.
Laten we dus begrijpen wat een storage class is en welke verschillende storage classes beschikbaar zijn in elke cloud:
Storage Classes
Storage classes bieden een manier om het type opslag op te geven dat voor een volume moet worden geconfigureerd. Deze storage classes verschillen in kenmerken zoals prestaties, duurzaamheid en kosten. U kunt de gewenste storage class voor uw volume selecteren uit het keuzemenu Storage Class tijdens het aanmaken ervan.
De specifieke storage classes die beschikbaar zijn, hangen af van de cloudprovider die u gebruikt en wat vooraf is geconfigureerd door het Infra-team. U ziet gewoonlijk de volgende opties in de storage classes, afhankelijk van de cloudprovider:
AWS Storage Classes
TrueFoundry Opslagnaam
Cloud Provider Opslagnaam
Storage Class
Beschrijving
efs-sc
Elastic File System (EFS)
efs.csi.aws.com
Een volledig beheerd, schaalbaar en zeer duurzaam elastisch bestandssysteem dat hoge beschikbaarheid, automatische schaling en kosteneffectieve algemene bestandsdeling biedt. Geschikt voor workloads met wisselende capaciteitsbehoeften.
GCP Storage Classes
TrueFoundry Opslagnaam
Cloud Provider Opslagnaam
Storage Class
Beschrijving
standard-rwx
Google Basic HDD Filestore
filestore.csi.storage.gke.io
Een kosteneffectieve en schaalbare bestandsopslagoplossing, ideaal voor algemene bestandsopslag en kostengevoelige workloads. Biedt lagere kosten, maar ook lagere prestaties vanwege het HDD-karakter.
premium-rwx
Google Premium Filestore
filestore.csi.storage.gke.io
Biedt hogere prestaties en doorvoer in vergelijking met Basic HDD, waardoor het geschikt is voor I/O-intensieve bestandsoperaties en veeleisende workloads. Het is op SSD gebaseerd en biedt hogere prestaties tegen hogere kosten.
enterprise-rwx
Google Enterprise Filestore
filestore.csi.storage.gke.io
Levert de hoogste prestaties, doorvoer, geavanceerde functies, multi-zone ondersteuning en hoge beschikbaarheid, waardoor het ideaal is voor missiekritieke workloads en toepassingen met strenge beschikbaarheidseisen. Dit gaat gepaard met de hoogste kosten.
Azure Storage Classes
TrueFoundry Opslagnaam
Cloud Provider Opslagnaam
Storage Class
Beschrijving
azurefile
Azure File Storage (Standard)
file.csi.azure.com
Gebruikt Azure Standard-opslag om bestandsshares te maken voor algemene bestandsdeling over VM's of containers, inclusief Windows-apps. Biedt kosteneffectieve prestaties.
azurefile-premium
Azure File Storage (Premium)
file.csi.azure.com
Gebruikt Azure Premium-opslag voor hogere prestaties, waardoor het geschikt is voor I/O-intensieve bestandsoperaties.
azurefile-csi
Azure File Storage (StandardCSI)
file.csi.azure.com
Makt gebruik van Azure Standard-opslag met CSI voor dynamische provisioning, wat mogelijk betere prestaties en CSI-functies biedt.
azurefile-csi-premium
Azure File Storage (PremiumCSI)
file.csi.azure.com
Combineert Azure Premium-opslag met CSI voor dynamische provisioning en hoogwaardige bestandsoperaties.
azureblob-nfs-premium
Azure Blob Storage (NFS Premium)
blob.csi.azure.com
Gebruikt Azure Premium-opslag met het NFS v3-protocol voor toegang tot grote hoeveelheden ongestructureerde gegevens en objectopslag, gericht op veeleisende workloads met NFS-toegang.
azureblob-fuse-premium
Azure Blob Storage (Fuse Premium)
blob.csi.azure.com
Gebruikt Azure Premium-opslag met BlobFuse voor toegang tot grote hoeveelheden ongestructureerde gegevens en objectopslag, geschikt voor workloads die BlobFuse-toegang vereisen.
Statisch Geconfigureerde Volumes
Statisch geconfigureerde volumes stellen u in staat om het volgende als een volume te mounten:
GCS Bucket
S3 bucket
Bestaande EFS
Elk willekeurig algemeen volume op Kubernetes
Om statisch geconfigureerde volumes te gebruiken, moet u een “PersistentVolume” aanmaken dat verwijst naar uw opslag (S3/GCS enz.). Hiervoor moet u de benodigde CSI-drivers op het cluster installeren en/of relevante serviceaccounts instellen voor machtigingen. In het volgende gedeelte bespreken we hoe u statisch geconfigureerde volumes kunt aanmaken.
Een GCS-bucket mounten als volume
Om een GCS-bucket als volume te mounten op TrueFoundry, moet u de volgende stappen uitvoeren. U kunt dit document raadplegen voor meer details:
Maken van een GCS-bucket
Maak een GCS-bucket aan en zorg voor het volgende:
Moet in één enkele regio zijn (multi-regio werkt, maar de snelheid zal lagere zijn en de kosten hoger)
De regio moet dezelfde zijn als die van uw Kubernetes Cluster
Service account aanmaken en relevante machtigingen verlenen
U moet het volgende script uitvoeren. Dit doet het volgende:
Schakelt de GCS Fuse Driver in op het cluster
Maakt een IAM Policy aan voor toegang tot uw bucket
Maakt een K8s service-account aan en voegt het beleid toe aan dit service-account
Mogelijk maakt van role-binding van het service-account naar de gewenste K8s namespace.
Service-Account aanmaken in Workspace vanuit de TrueFoundry UI
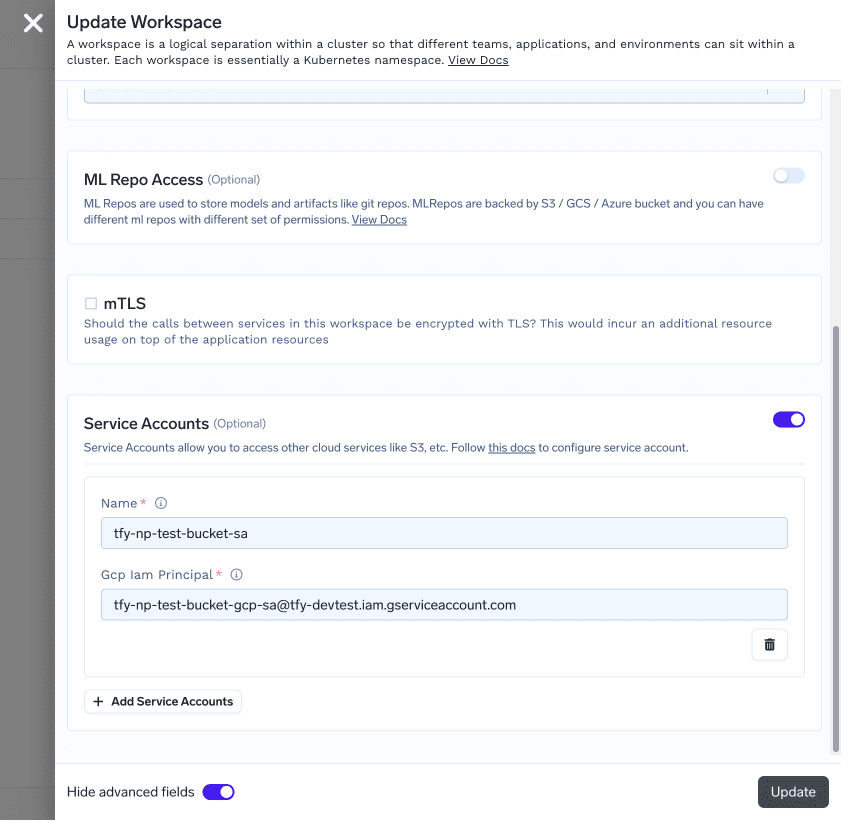
We moeten nu een service-account aanmaken op TrueFoundry in dezelfde workspace met de naam: TARGET_NAMESPACE en het service-account moet de naam GCP_SA_NAME hebben.
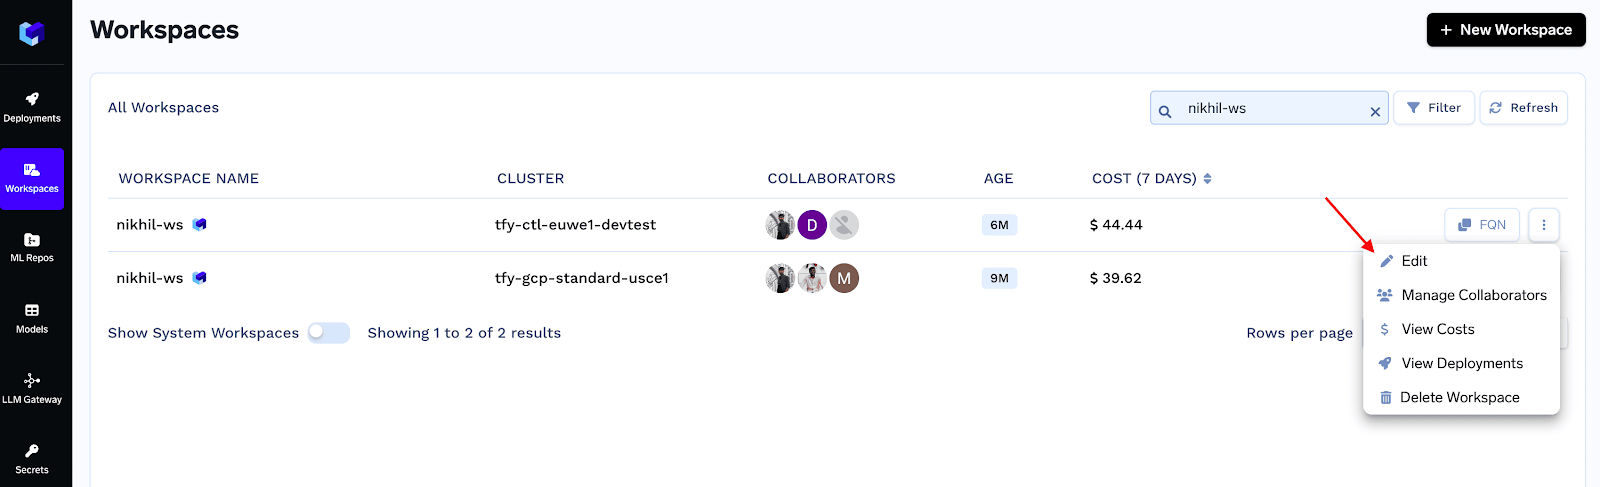
Ga naar Workspaces -> Kies uw Workspace, klik op de drie puntjes aan de rechterkant en klik op Edit:
Open Advanced Options linksonder in het formulier en vul de Serviceaccount sectie in:
Opmerking
De naam van het service-account en de workspace moeten exact hetzelfde zijn als in de vorige stap.
Een PersistentVolume-object aanmaken
Maak een PersistentVolume-object aan met de volgende stap (door een kubectl apply uit te voeren).
Om een S3-bucket als een volume te mounten op TrueFoundry, moet u de volgende stappen uitvoeren:
Instellen van IAM Policies en Relevante Rollen
Volg dit document van AWS om het mountpoint van S3 in een EKS-cluster in te stellen.
Dit leidt u door de volgende stappen:
Maak een IAM-beleid aan om het mountpoint machtigingen te geven voor toegang tot de S3-bucket
Maak een IAM-rol aan.
Installeer de mountpoint voor Amazon S3 CSI-driver en koppel de hierboven aangemaakte rol.
Een Persistent Volume aanmaken op het Kubernetes Cluster
Maak een PV aan met de volgende specificatie (door een kubectl apply uit te voeren):
YAML
apiVersion: v1
kind: PersistentVolume
metadata:
  name:
spec:
  capacity:
    storage: 100Gi
  csi:
    driver: s3.csi.aws.com
    volumeHandle: s3-csi-driver-volume # must be unique
    volumeAttributes:
      bucketName:
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: s3-test # put any value here
  mountOptions:
    - allow-delete
    - region
    - allow-other
    - uid=1000
  volumeMode: Filesystem
Een bestaande EFS mounten als een Volume
Om een S3-bucket als een volume te mounten op TrueFoundry, moet u de volgende stappen uitvoeren:
EFS CSI driver installeren op uw cluster
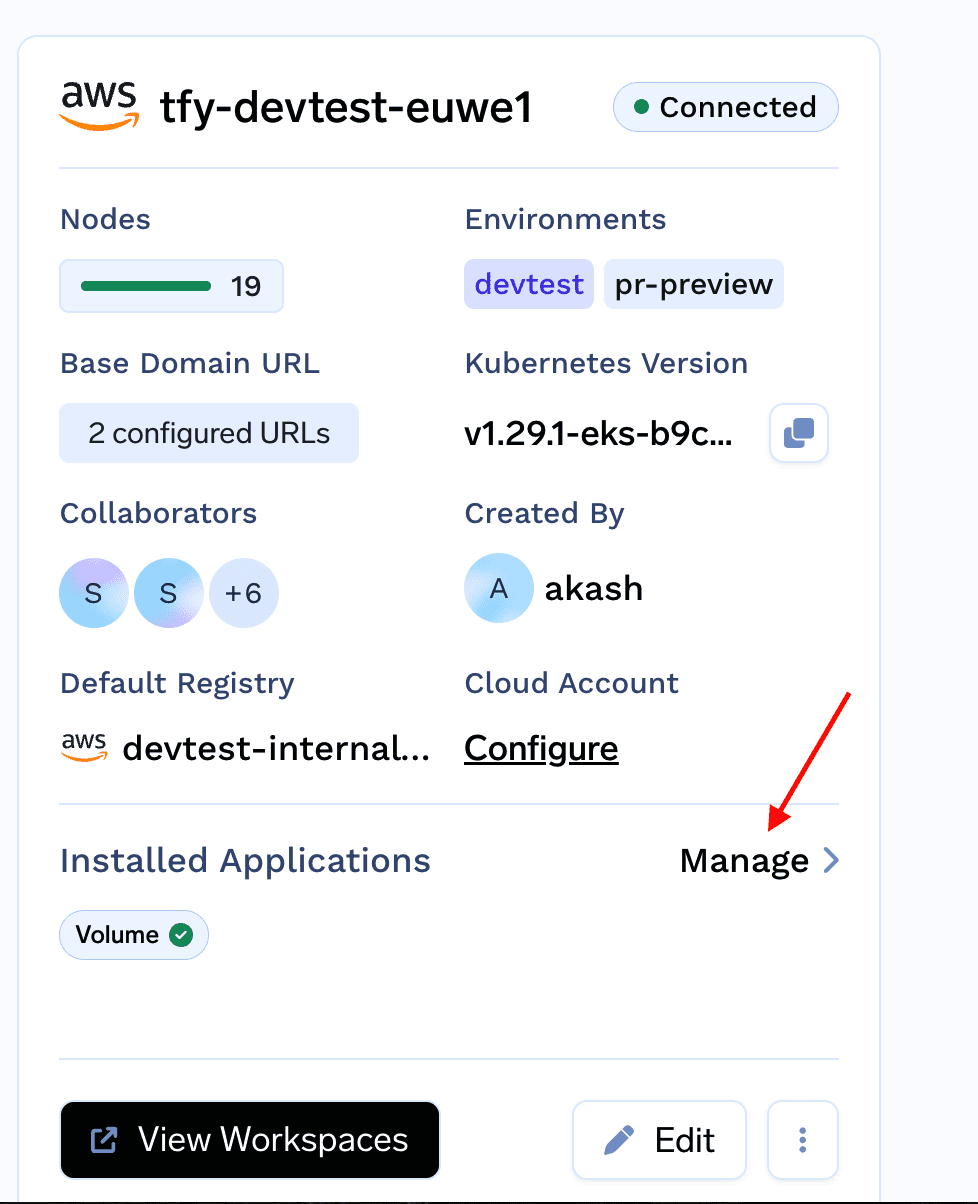
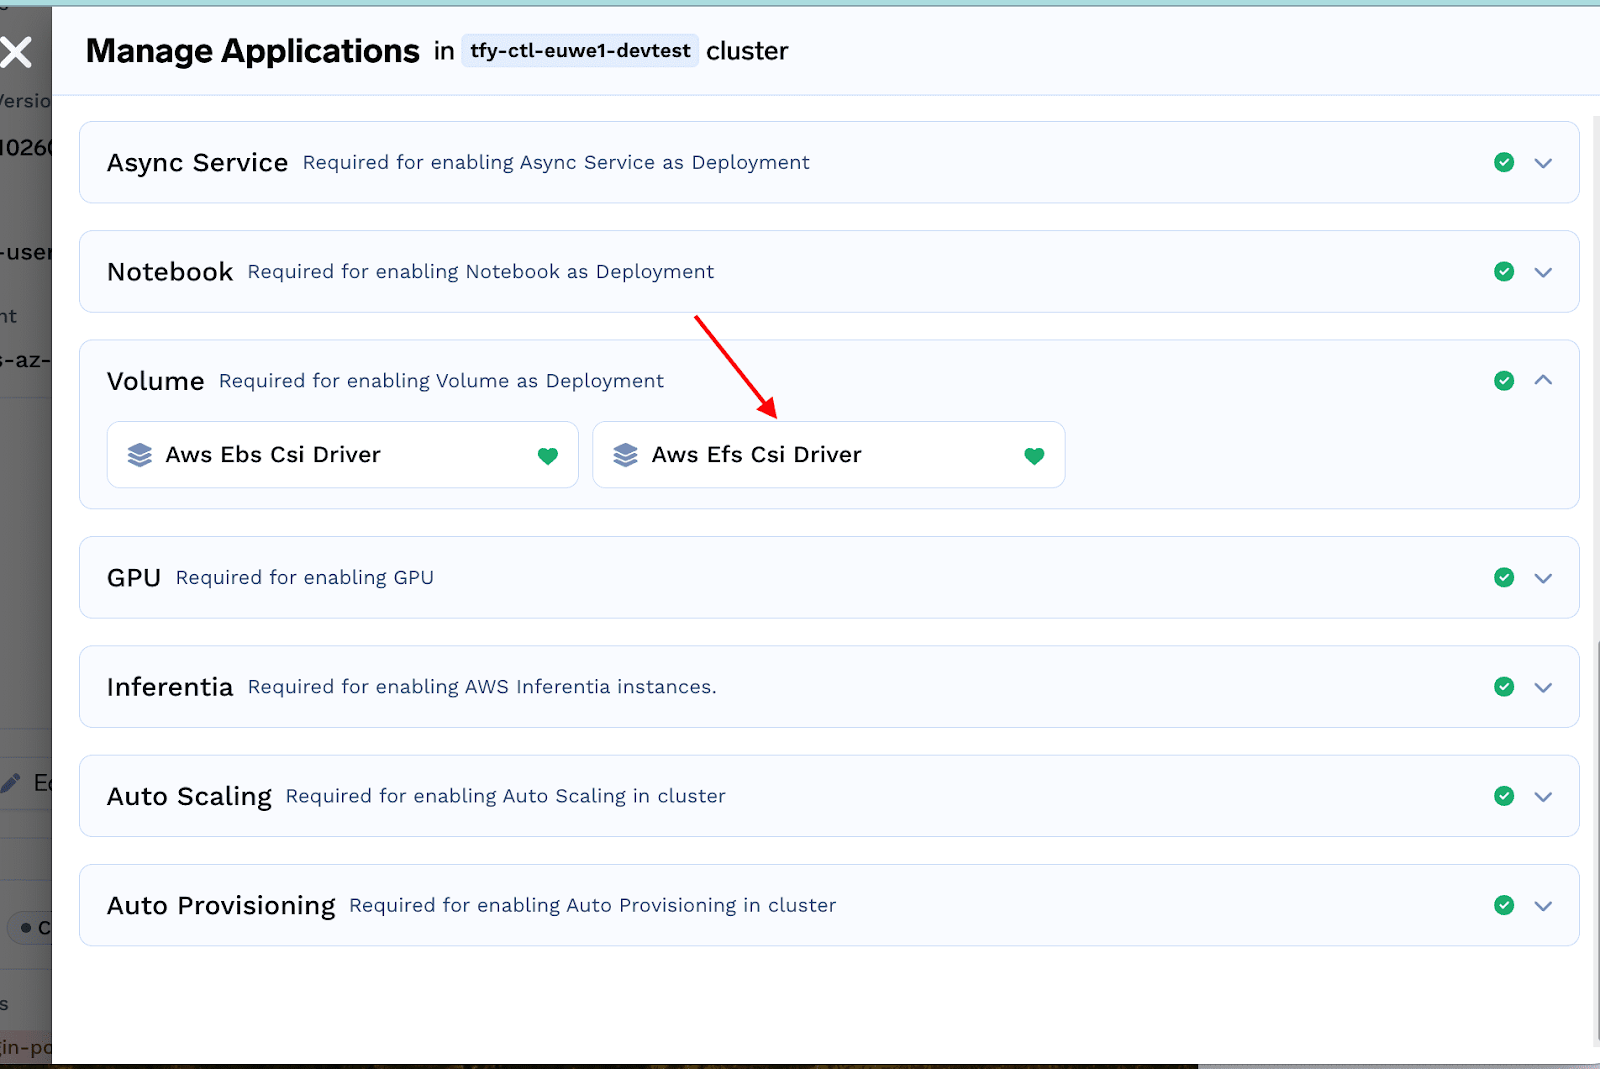
Om de EFS CSI-driver op uw cluster te installeren, gaat u naar de TrueFoundry UI -> Clusters-> Installed Applications-> Manage
Klik in de Volumessectie op AWS EFS CSI driver installeren en klik op Install.
Een Access Point aanmaken voor uw EFS
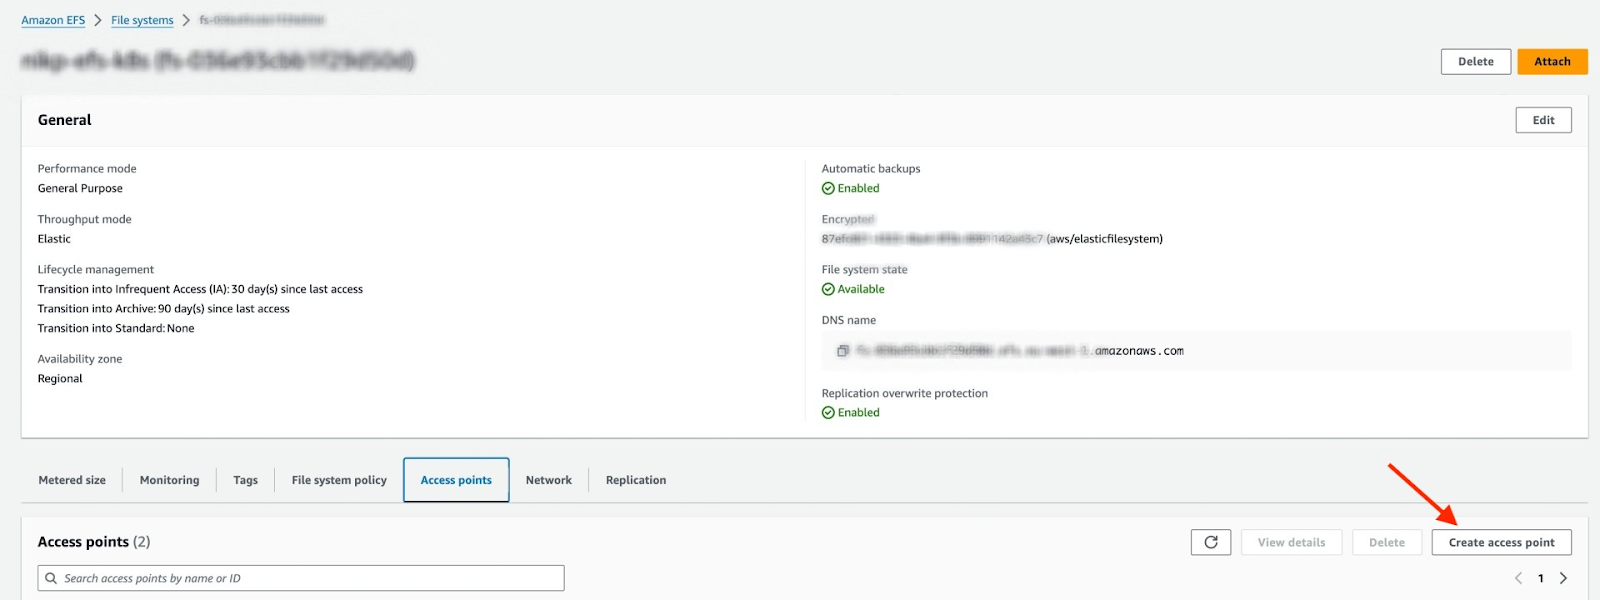
Zoek uw EFS op in de AWS-console en open deze. Zorg ervoor dat de EFS en het K8S-cluster zich in dezelfde VPC bevinden. Klik op "Create access point"
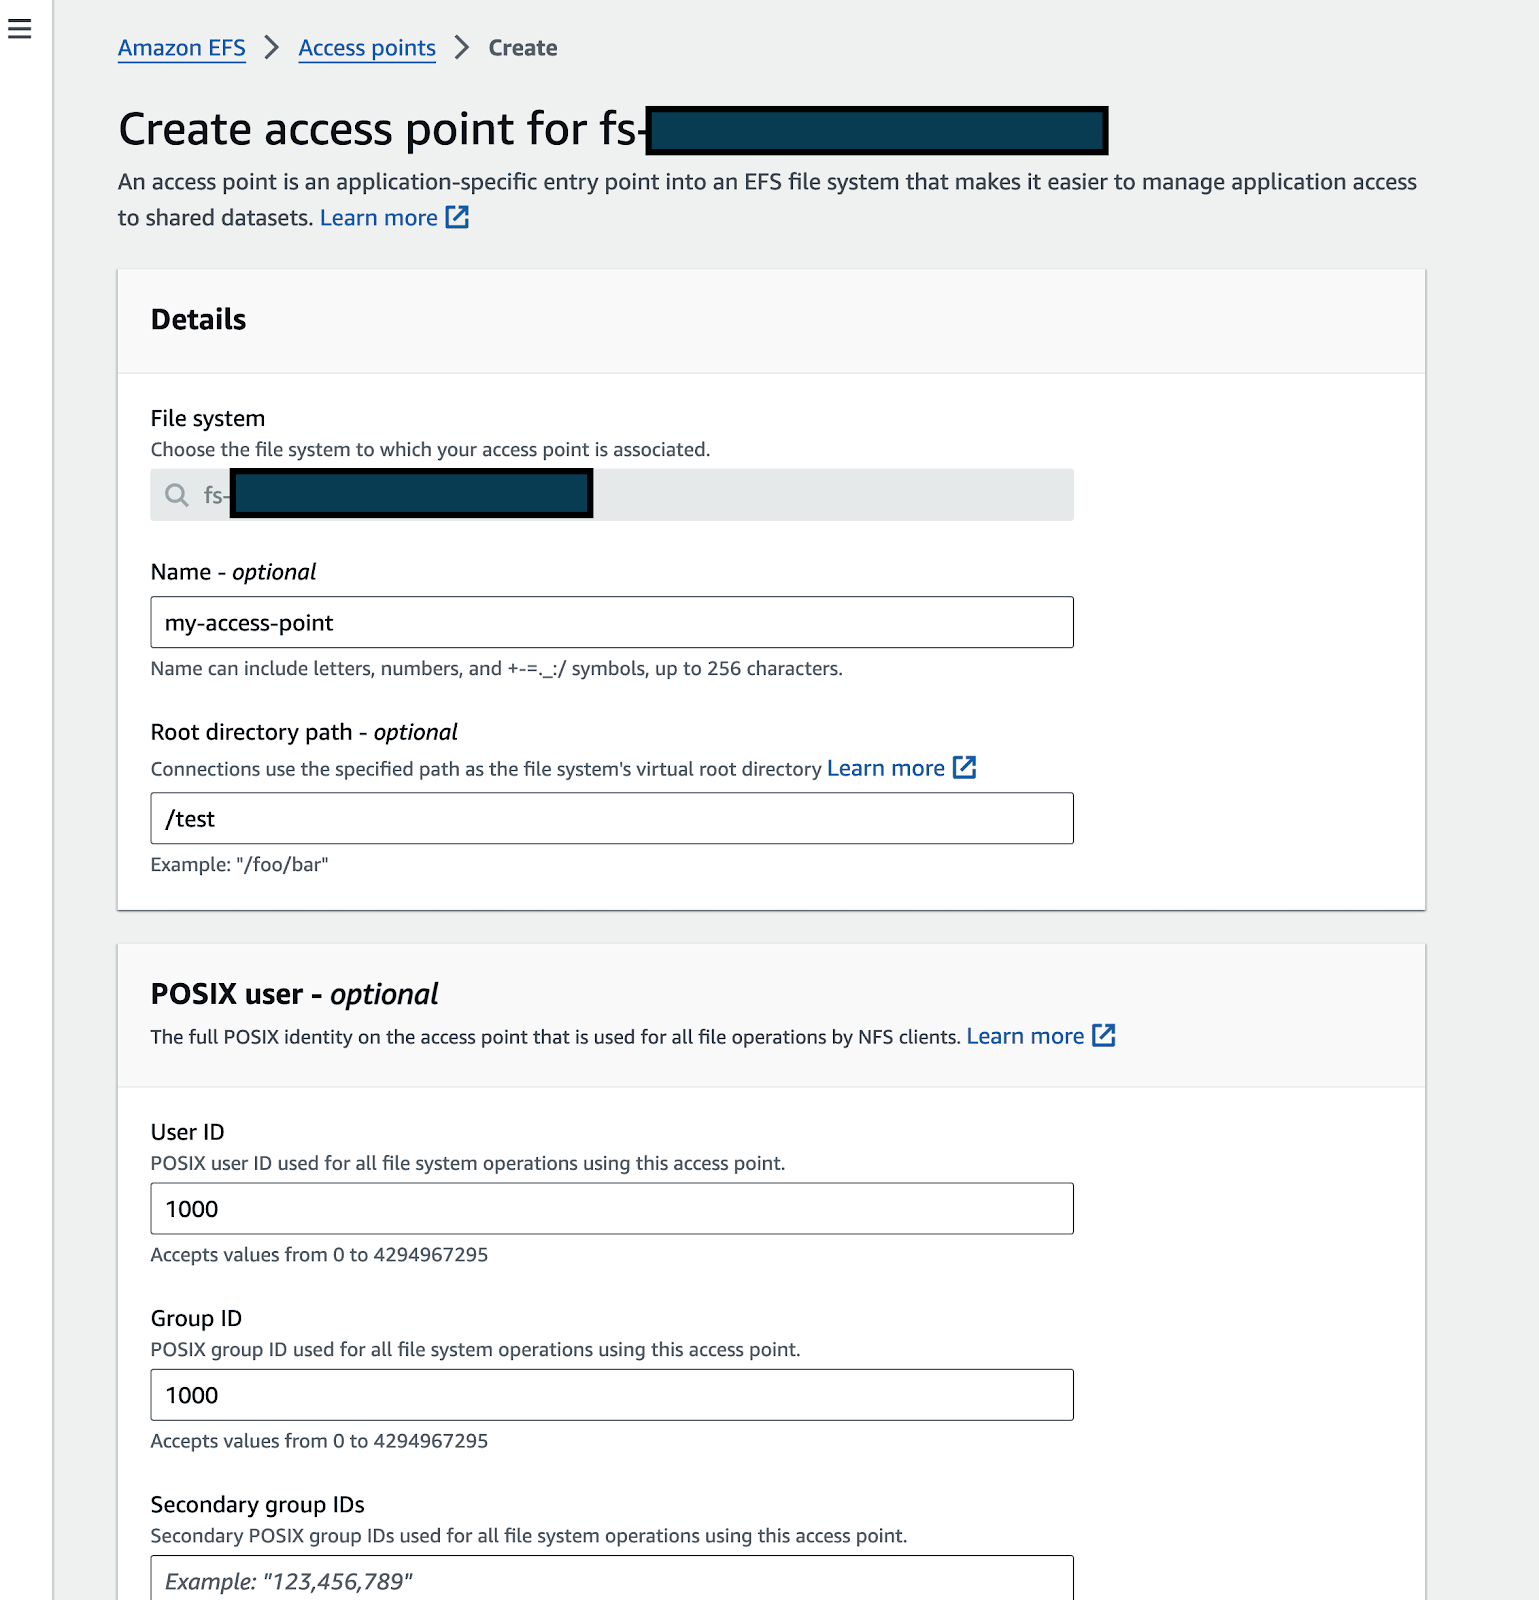
Voer details in zoals naam, Root directory path (zorg ervoor dat u de sectie Root directory creation permissions invult; u kunt dit invullen met UID:1000 GID:1000 als u deze wilt koppelen aan de notebook)
Klik op create.
Een PersistentVolume aanmaken op het cluster
Maak een PV aan met de volgende specificatie (door een kubectl apply uit te voeren):
YAML
apiVersion: v1
kind: PersistentVolume
metadata:
  name:
spec:
  capacity:
    storage: 5Gi # this number doesn't matter for EFS, any number will work
  csi:
    driver: efs.csi.aws.com
    volumeHandle: :: # e.g. fs-036e93cbb1fabcdef::fsap-0923ac354cqwerty
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: efs-sc
  volumeMode: Filesystem
Een Volume aanmaken op TrueFoundry
Volg deze sectie om een volume aan te maken op TrueFoundry
Volumes gebruiken op TrueFoundry
Met de bovenstaande handleidingen kunt u eenvoudig volumes configureren of bestaande opslagcontainers als volumes gebruiken. Deze volumes kunnen nu worden gemount op elke workload op Kubernetes. Als u dit gebruikt, kunt u uw volume eenvoudig mounten op elke workload op TrueFoundry. U kunt het eenvoudig mounten op een service of op vergelijkbare wijze op elke workload die op TrueFoundry is geïmplementeerd. U kunt ook met slechts enkele klikken een bestandsbrowser inschakelen om door de inhoud van het volume te bladeren met onze volume browser.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting