August 27, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In de vorige editie hebben we de workflow van een data scientist doorgenomen en bekeken waar kubernetes precies een nuttige basis kan zijn om een platform op te bouwen.
Laten we in deze editie een eenvoudig voorbeeld doornemen om hier praktijkervaring mee op te doen.
Voordat we beginnen, hebben we een playground nodig om de demo uit te voeren. We zullen hiervoor een kubernetes-cluster op de lokale machine opzetten. Hoewel een cluster meerdere nodes moet bevatten voor fouttolerantie en hoge beschikbaarheid, zullen we dat gedrag nabootsen met behulp van de geweldige tool kind (kubernetes-in-docker).
Aan het einde van dit gedeelte hebben we meerdere draaiende containers, waarbij elke container fungeert als een afzonderlijke clusternode.
Volg de instructies die hier te vinden zijn
Test de installatie door het volgende uit te voeren
$ kind --version
kind version 0.14.0
Nu starten we een lokaal cluster met behulp van kind. We maken één control plane en twee worker nodes aan. Het is mogelijk om van beide meerdere instanties te hebben.
<aside> 💡 Kubernetes kan meerdere control plane- en worker nodes hebben. Alle gecentraliseerde clusterbeheercomponenten bevinden zich op de control plane-nodes, terwijl de gebruikersworkload op worker nodes draait. Lees er hier meer over
</aside>
Maak eerst een kind-configuratie aan in een bestand genaamd kind-config.yaml. Je kunt het hier vinden. Dit definieert de structuur van ons cluster -
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
- role: control-plane
- role: worker
- role: worker
Hier hebben we drie nodes gedefinieerd, waarvan één in de rol van control plane en de andere twee als worker nodes.
Start een cluster met behulp van deze configuratie. Dit kan even duren. Zorg ervoor dat de docker daemon op je systeem draait voordat je dit uitvoert -
$ kind create cluster --config kind-config.yaml
...
Thanks for using kind! 😊
kubectl uitvoeren om te controleren of ons cluster actief is -$ kubectl cluster-info
Kubernetes control plane is running at <https://127.0.0.1:63122>
CoreDNS is running at <https://127.0.0.1:63122/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy>
...
Dit geeft aan dat het cluster inderdaad actief is. We kunnen ook de afzonderlijke containers zien die als nodes fungeren door docker ps uit te voeren.
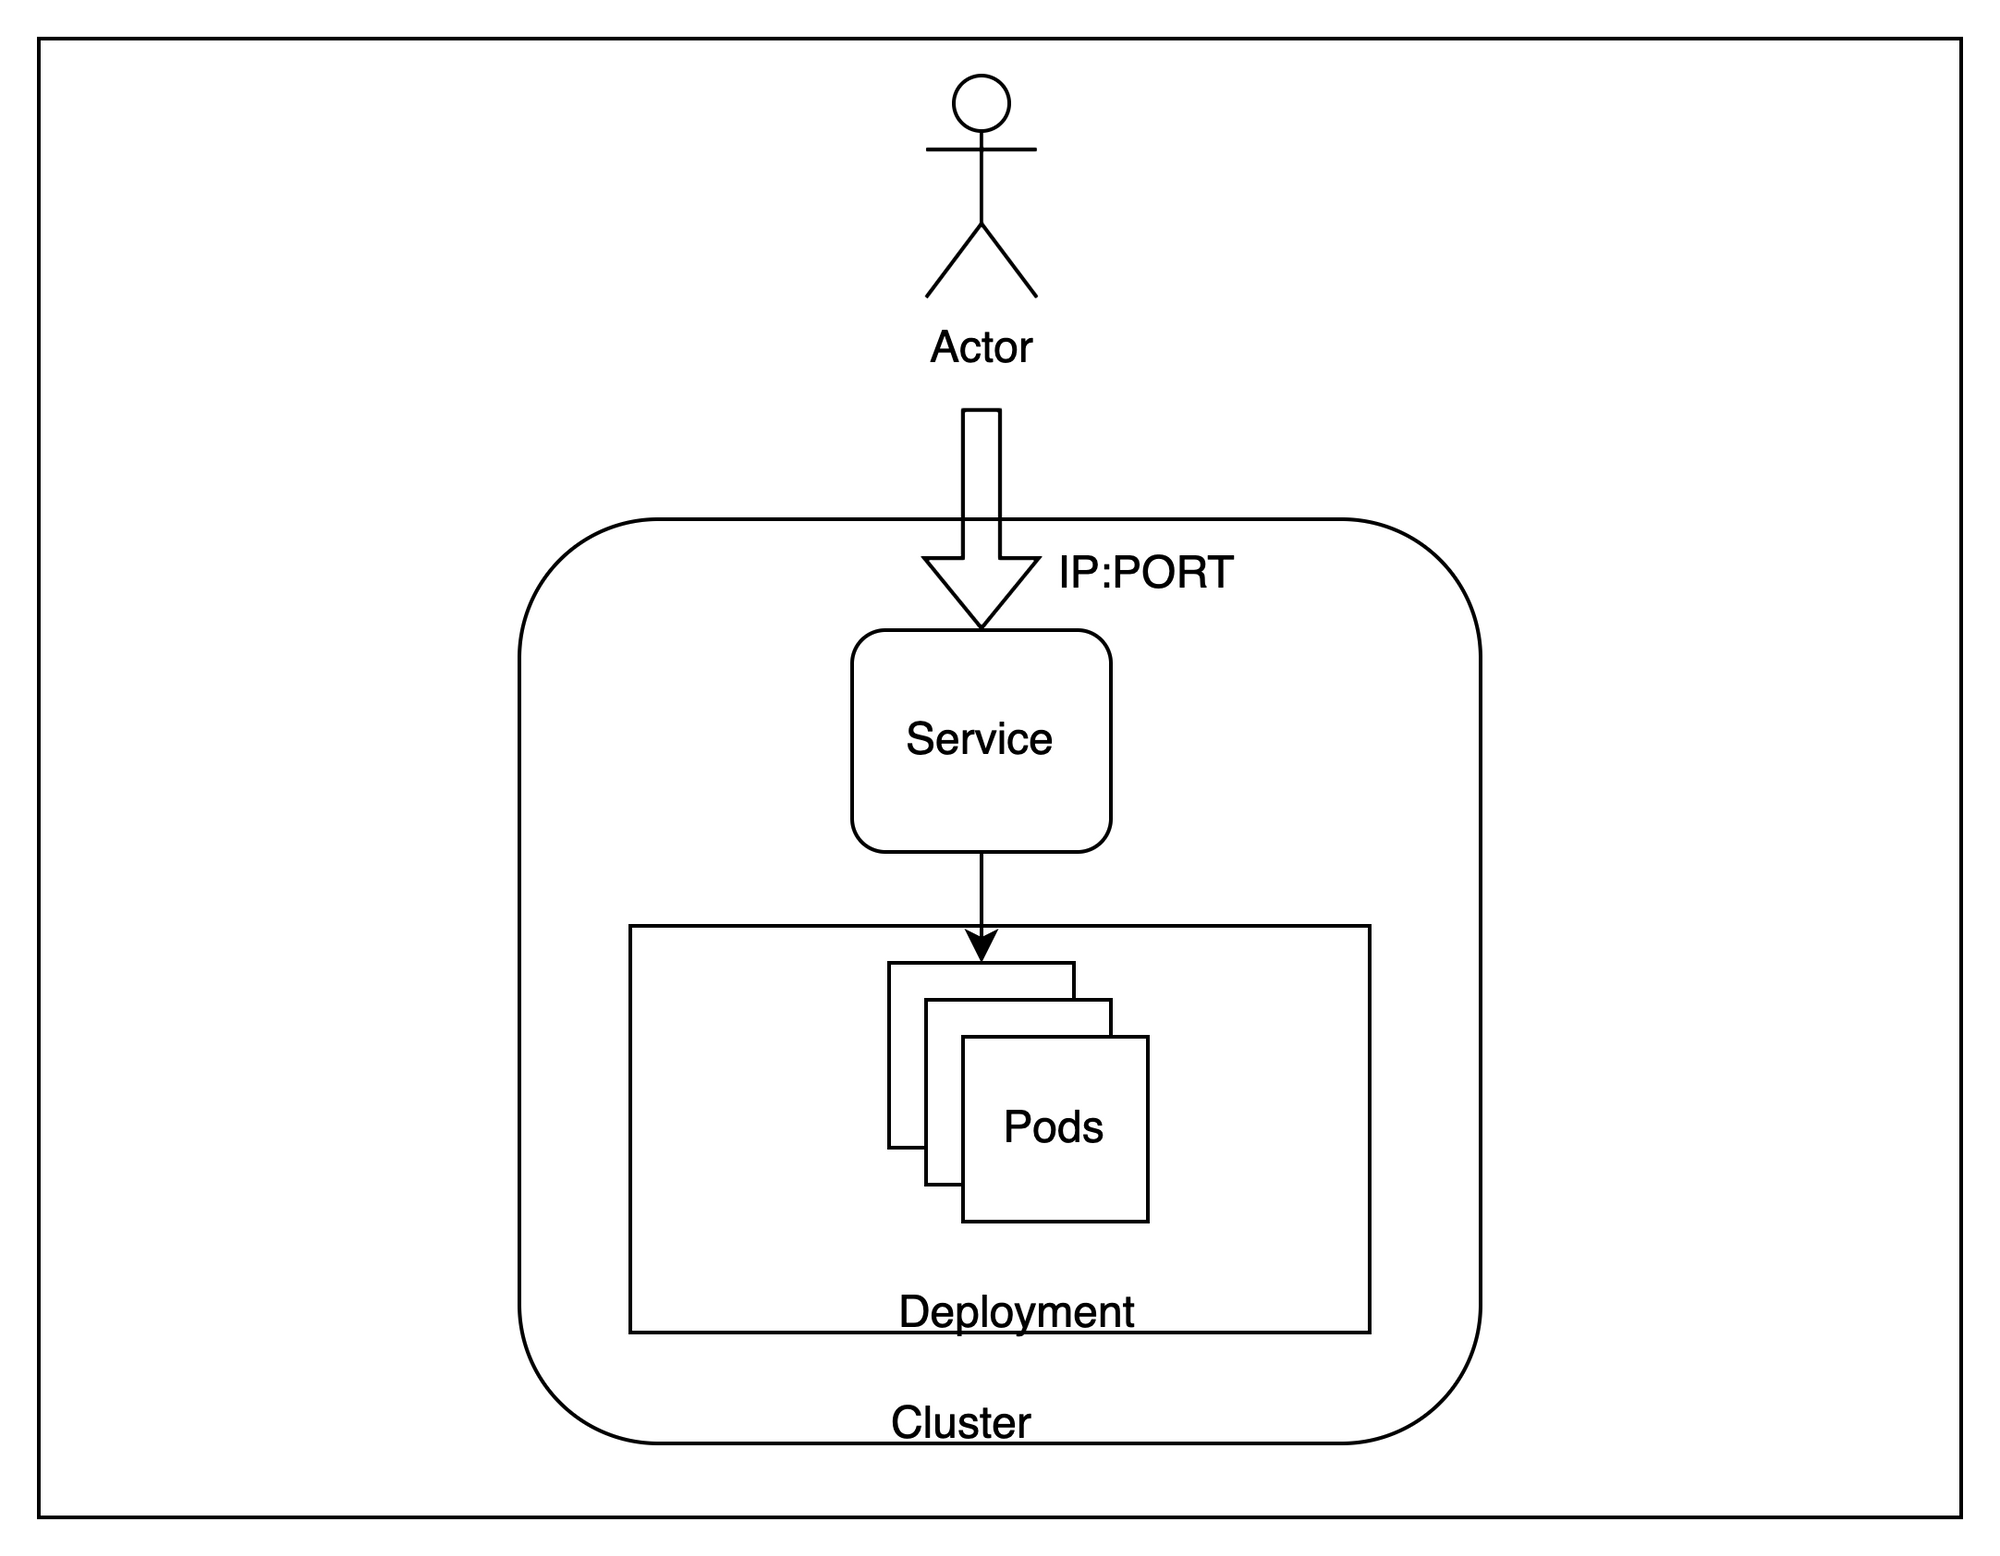
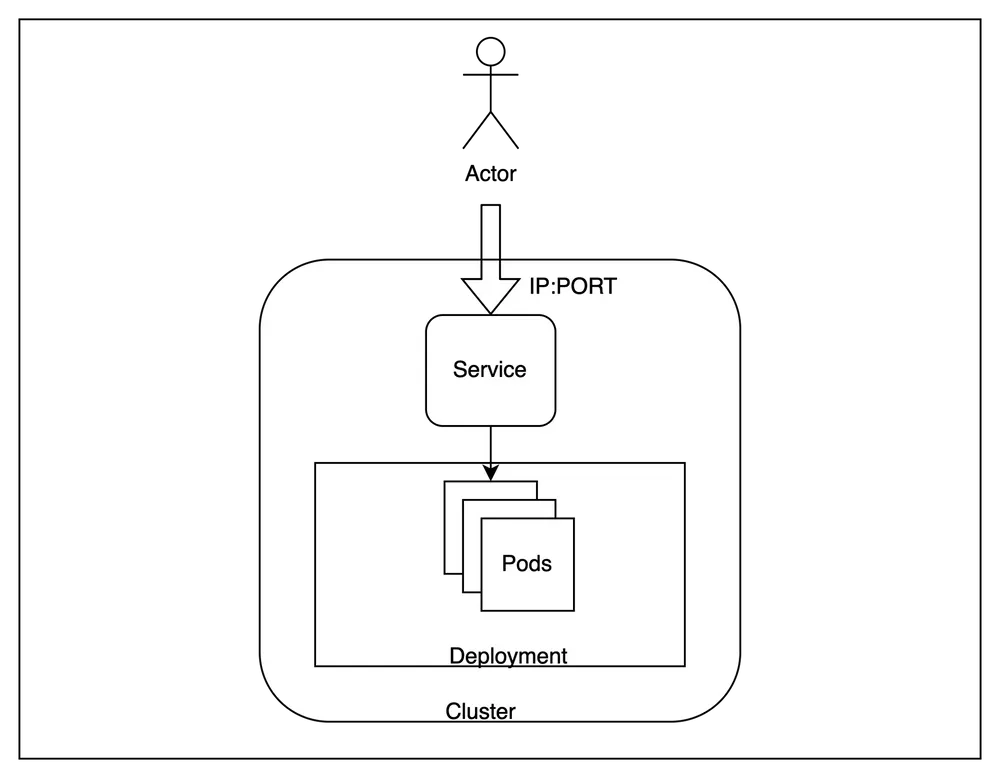
Nu ons cluster actief is, laten we kijken naar een globale architectuur van wat we gaan provisionen.
Om het kort te zeggen: we gaan meerdere replica's van onze applicatie binnen het cluster hosten en proberen deze van buitenaf te benaderen, waarbij requests verdeeld (load balanced) worden over de verschillende instanties.
Om dit te bereiken, zijn er een paar kubernetes-specifieke termen waar we bekend mee moeten zijn -
Pod - Pods zijn de kleinste implementeerbare rekeneenheden die je kunt maken en beheren in Kubernetes. In ons geval draait één instantie van de applicatie in één onafhankelijke pod. Dit zijn ephemere (tijdelijke) bronnen en de control plane kan ze zo nodig verplaatsen over nodes.Deployment - Een deployment is nuttig wanneer we meer dan één replica voor een applicatie willen hebben. Kubernetes probeert het aantal replica's altijd gelijk te houden aan wat is opgegeven in een deployment. We maken drie identieke replica's voor onze applicatie.Service - Een service is nuttig om load balancing toe te passen over een reeks pods die op het cluster draaien. Omdat pods in essentie tijdelijk zijn en op elk moment kunnen worden vervangen, biedt een service een stabiele interface om toegang te krijgen tot de pods die erachter draaien. We gebruiken een service om onze applicatie te testen.Deze drie resources stellen ons in staat om een schaalbaar eindpunt te hosten voor het bedienen van onze applicatie.
Nu het cluster actief is, kunnen we een applicatie uitrollen en uittesten. We maken een applicatie met behulp van de populaire iris classifier-dataset.
De repo is beschikbaar op https://github.com/shubham-rai-tf/iris-classifier-kubernetes. Deze bevat al de code voor het bouwen en serveren van voorspellingen op het /iris/classify_iris-eindpunt met behulp van fastapi.
We moeten deze code verpakken in een docker image om het voor te bereiden voor kubernetes. Hiervoor is een Dockerfile aanwezig in de repo - hier.
Deze Dockerfile specificeert de image die we nodig hebben om een container te maken die de voorspellingseindpunten host in een uvicorn-server op poort 5000. Meer details over de syntaxis zijn hier beschikbaar.
Voer dit commando uit om een lokale image te bouwen -
$ docker build . -t iris-classifier:poc
...
$ docker image ls
REPOSITORY       TAG  IMAGE ID      CREATED         SIZE
iris-classifier  poc  549913d5b1f9  12 seconds ago  737MB
We kunnen zien dat de image succesvol is aangemaakt met de naam iris-classifier en tag poc. We laden deze image nu in het cluster om deze binnen het cluster te gebruiken
<aside> 💡 Deze stap is alleen nodig omdat we geen image registry hebben om de nieuw gebouwde image uit op te halen. In productie moet de image worden gehost in een private registry zoals Dockerhub of AWS ECR en vervolgens rechtstreeks in het cluster worden opgehaald
</aside>
Voer dit commando uit om de lokaal gebouwde image naar het cluster te laden -
$ kind load docker-image iris-classifier:poc
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-worker2", loading...
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-control-plane", loading...
...
Je kunt verifiëren dat de images zijn geladen door de images in een van de drie containers op te sommen -
$ docker exec -it kind-worker crictl images
IMAGE                                TAG    IMAGE ID         SIZE
docker.io/library/iris-classifier    poc    549913d5b1f94    753MB
Kubernetes is in essentie een declaratief systeem. Dat betekent dat we de contouren beschrijven van wat we willen doen, en control plane-componenten sturen het systeem voortdurend aan om die staat te bereiken.
Om de architectuur die we eerder bespraken te implementeren, beschrijven we onze intentie in de vorm van een yaml-bestand dat dient als een vastlegging van onze intentie. In kubernetes-jargon worden dit manifests genoemd.
Alle kubernetes-manifesten bevatten de volgende velden -
apiVersion - Meerdere resources zijn gegroepeerd in dezelfde api-versies. Dit biedt een gestandaardiseerde manier om een resource uit te faseren of te promoveren over kubernetes-versies heen.kind - Identificeert het exacte objecttype dat moet worden aangemaaktmetadata - Bevat velden die dienen als metadata voor het aangemaakte object. De velden apiVersion, kind en metadata.name identificeren samen een unieke resource binnen een namespacespec - Dit veld bevat de specificatie voor het aan te maken object. Elk type (kind) definieert hiervoor een eigen structuur met een eigen implementatie.We gebruiken de manifesten die aanwezig zijn in de repo in bestanden binnen de map manifests hier.
Het definieert twee kubernetes-resources, Deployment en Service in respectievelijk deployment.yaml en service.yaml. Laten we beide secties doornemen.
apiVersion: apps/v1
kind: Deployment
spec:
	# number of replicas
  replicas: 3
  template:
    spec:
      containers:
			# name of the image
      - image: iris-classifier:poc
        name: iris-classifier
Het deployment-manifest in deployment.yaml definieert voornamelijk de pod-specificatie die we willen uitrollen in termen van de imagenaam en het aantal replica's. Zodra we dit toepassen, zal kubernetes voortdurend stappen ondernemen om het aantal replica's te behouden op wat we hier opgeven.
apiVersion: v1
kind: Service
spec:
	# Type of the service
  type: ClusterIP
  ports:
	# Port where the service will be accessible
  - port: 8080
		# Port on the container where the traffic is to be forwarded
    targetPort: 5000
    protocol: TCP
  selector:
    app: iris-classifier
Het service-manifest in service.yaml definieert hoe de load balancing moet plaatsvinden over de replica's die door de deployment zijn aangemaakt. Hier hebben we gedefinieerd hoe de poort op de service moet worden gekoppeld aan de poort op de containers. Omdat onze applicatie op poort 5000 draait, is de targetPort ingesteld op 5000. De service wordt blootgesteld op poort 8080. TCP-verkeer dat naar 8080 wordt gestuurd, wordt verdeeld over poort 5000 van de containers.
Voer het volgende commando uit om de manifesten toe te passen op kubernetes -
$ kubectl apply -f manifests/
deployment.apps/iris-classifier created
service/iris-classifier created
Beide resources zijn succesvol aangemaakt op het cluster. We kunnen dit verifiëren door de volgende commando's uit te voeren -
$ kubectl get service iris-classifier
NAME              TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)    AGE
iris-classifier   ClusterIP   10.96.107.238   <none>        8080/TCP   37m
$ kubectl get deployment iris-classifier
NAME              READY   UP-TO-DATE   AVAILABLE   AGE
iris-classifier   3/3     3            3           38m
$ kubectl get pods
NAME                               READY   STATUS    RESTARTS   AGE
iris-classifier-5d97498ff9-77wqw   1/1     Running   0          39m
iris-classifier-5d97498ff9-8twjm   1/1     Running   0          39m
iris-classifier-5d97498ff9-znrz8   1/1     Running   0          39m
Zoals we kunnen zien, is de service beschikbaar gemaakt op poort 8080 en zijn er drie pods aangemaakt zoals we hadden opgegeven.
Pas deployment.yaml aan zodat deze 2 replica's heeft in plaats van 3 en pas dit opnieuw toe. Kubernetes zal een van de replica's verwijderen om te voldoen aan de specificatie.
Nu de resources in het cluster zijn aangemaakt, kunnen we onze deployment verifiëren door het model aan te roepen via het service-eindpunt. Aangezien we een lokale opstelling gebruiken, moeten we de service port-forward naar een poort op de lokale machine.
<aside> 💡 In een cloudprovider-opstelling wordt deze service gekoppeld aan een externe load balancer die indien nodig vanaf het internet kan worden benaderd.
</aside>
Voer het volgende commando uit om port forwarding uit te voeren voor de service -
$ kubectl port-forward services/iris-classifier 8080
Forwarding from 127.0.0.1:8080 -> 5000
Forwarding from [::1]:8080 -> 5000
We kunnen verifiëren door het /healthcheck-eindpunt op het model aan te roepen -
$ curl '<http://localhost:8080/healthcheck>'
"Iris classifier is ready!"
Om een testvoorspelling uit te voeren, sturen we een voorbeeldinvoer om een voorspelling te krijgen -
$ curl '<http://localhost:8080/iris/classify_iris>' -X POST \\
	-H 'Content-Type: application/json' \\
	-d '{"sepal_length": 2, "sepal_width": 4, "petal_length": 2, "petal_width": 4}'
{"class":"setosa","probability":0.99}
We krijgen een voorspelling van klasse setosa met een waarschijnlijkheid van 99%. Door meerdere van deze voorspellingen uit te voeren, kunnen we verifiëren dat de requests inderdaad via round-robin naar verschillende pods worden geleid.
Laten we eerst alle kubernetes-resources verwijderen die we hebben geïnstalleerd -
$ kubectl delete -f manifests/
Dit ruimt alle kubernetes-resources op die we in de vorige secties hebben aangemaakt. Nu kunnen we het cluster ook afbreken -
$ kind delete cluster
Deleting cluster "kind" ...
In deze editie hebben we doorgenomen hoe je een model als een aanroepbare service kunt hosten in kubernetes. Hoewel dit een vereenvoudigd voorbeeld was waarbij we lokaal een docker image hebben gebouwd en deze op een cluster op dezelfde machine hebben gedraaid, werkt een typische productie-opstelling volgens vergelijkbare principes. Er kan al heel veel worden bereikt met alleen deze twee resources.
In de volgende edities zullen we andere, meer geavanceerde functies verkennen, zoals multi-tenancy en toegangsniveaus (access control), die essentieel worden naarmate we naar dag 2-operaties toewerken.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox