August 27, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Welkom bij deze reeks over het bouwen en opzetten van een schaalbare Machine Learning-infrastructuur op een Kubernetes-omgeving. In deze reeks behandelen we verschillende onderwerpen met betrekking tot de ontwikkeling, uitrol en het beheer van machine learning-modellen op een Kubernetes-cluster.
Machine Learning Operations, algemeen bekend als MLOps, verwijst naar de praktijken en technieken die worden gebruikt om de levenscyclus van machine learning-modellen te beheren. Een schaalbare MLOps-infrastructuur stelt organisaties in staat om modellen op schaal te bouwen, uit te rollen en te beheren, waardoor het rendement op de investering (ROI) van hun data science-inspanningen wordt verhoogd.
De voordelen van een schaalbare MLOps-infrastructuur zijn onder meer:
Airbnb heeft vanaf het begin zwaar geïnvesteerd in het opzetten van een schaalbare MLOps-praktijk. Het bedrijf gebruikte machine learning-modellen om de zoekrangschikkingsalgoritmen te verbeteren via zoekopdrachten op basis van gebruikersgegevens, wat leidde tot een betere zoekervaring en een geschatte toename van 10% in boekingen. Airbnb gebruikte ook machine learning-modellen om gepersonaliseerde aanbevelingen aan hun gebruikers te bieden, wat hielp om de gebruikerservaring en betrokkenheid te verbeteren!
Organisaties die afhankelijk zijn van Virtual Machines (VM's), of dit nu op AWS, Google Cloud Platform (GCP) of Microsoft Azure is, voor het opzetten van hun ML-trainings- en deployment-infrastructuur, kunnen voor verschillende uitdagingen komen te staan:
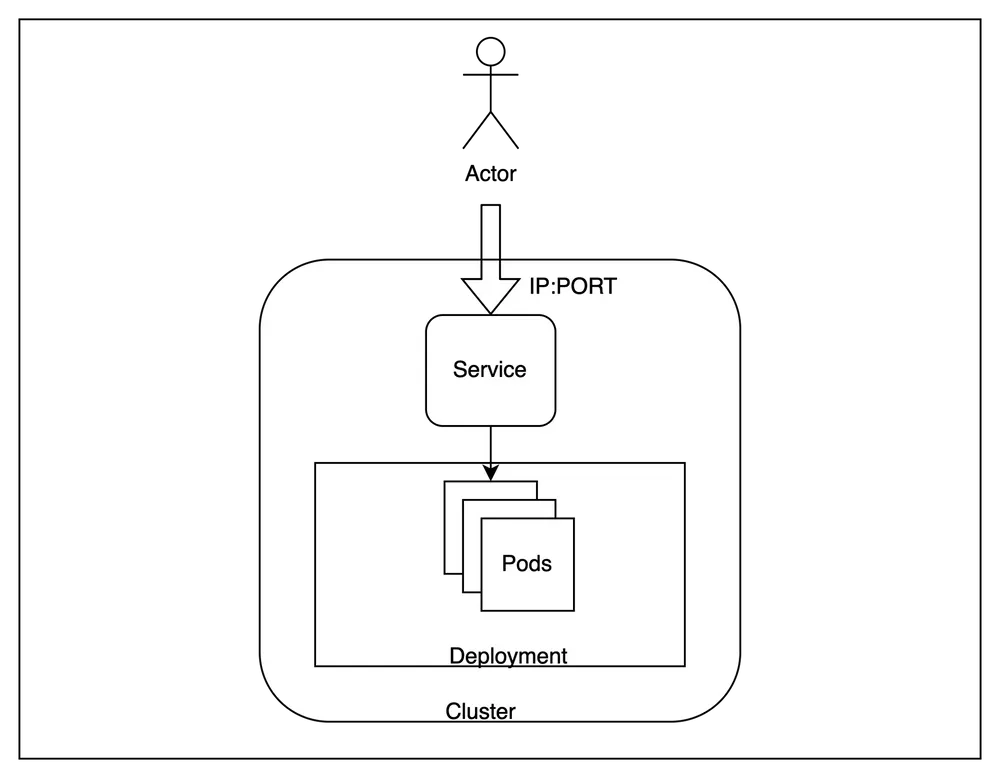
Kubernetes is een populair open-source containerorchestratieplatform dat de uitrol, schaling en het beheer van gecontaineriseerde applicaties automatiseert. Het biedt een universele API en declaratieve configuratie die het beheer van gecontaineriseerde workloads vereenvoudigt, waardoor organisaties een schaalbare, veerkrachtige en overdraagbare infrastructuur kunnen bouwen voor het trainen en uitrollen van ML-modellen. Kubernetes biedt verschillende voordelen ten opzichte van kale VM's, waaronder een betere benutting van resources, vereenvoudigd versiebeheer en efficiënte schaling. Bovendien biedt Kubernetes ingebouwde beveiligingsfuncties en gecentraliseerde monitoring- en loggingmogelijkheden, wat organisaties kan helpen de beveiliging en betrouwbaarheid van hun ML-infrastructuur te waarborgen. Kubernetes is een uitstekende keuze voor organisaties die op de langere termijn schaalbare Machine Learning Pipelines willen bouwen.
Cloudproviders (AWS, GCP en Azure) bieden beheerde Kubernetes-diensten (respectievelijk EKS, GKE en AKS) waarmee organisaties eenvoudig Kubernetes-clusters kunnen instellen, configureren en beheren. Dit neemt de operationele lasten weg die gepaard gaan met het uitvoeren en schalen van Kubernetes. Daarnaast bieden cloudproviders integraties met andere clouddiensten zoals opslag, databases en netwerken, wat de uitrol en het beheer van ML-workloads op Kubernetes verder kan vereenvoudigen. Door Kubernetes rechtstreeks of via een beheerde dienst te omarmen, kunnen organisaties een flexibele en schaalbare MLOps-pipeline bouwen die hun groeiende ML-workloads aan kan en een snellere marktintroductietijd voor hun ML-modellen mogelijk maakt.
Laten we de voordelen van het gebruik van Kubernetes voor ML-trainings- en deployment-pipelines in meer detail bekijken
Praktijkvoorbeeld 1: Airbnb
Airbnb, de online marktplaats waar mensen hun huis of appartement kunnen verhuren aan reizigers. Met miljoenen gebruikers en een enorme hoeveelheid te analyseren gegevens had Airbnb een robuuste en schaalbare machine learning-infrastructuur nodig om gebruikersgedrag te analyseren, zoekrangschikkingen te verbeteren en gepersonaliseerde aanbevelingen aan gebruikers te bieden.
Om dit te bereiken, investeerde Airbnb in het bouwen van een MLOps-infrastructuur op Kubernetes, waardoor hun data science-team machine learning-modellen op schaal kon ontwikkelen en uitrollen. Met Kubernetes was Airbnb in staat hun modellen te containeriseren en uit te rollen als microservices, wat het gemakkelijker maakte om hun infrastructuur te beheren en te schalen naarmate hun behoeften groeiden. Als resultaat kon Airbnb de zoekrangschikking verbeteren en relevantere aanbevelingen aan hun gebruikers bieden, wat leidde tot meer boekingen en hogere inkomsten. Bovendien kon het bedrijf de efficiëntie van hun data science-workflows verbeteren, waardoor hun team zich kon concentreren op de ontwikkeling van geavanceerdere machine learning-modellen.
Praktijkvoorbeeld 2: Lyft
Lyft, een grote aanbieder van Transportation as a SaaS (TaaS), bouwde hun ML-infrastructuur aanvankelijk boven op AWS met behulp van een combinatie van EC2-instanties en Docker-containers. Ze gebruikten EC2-instanties om virtuele machines op te zetten met verschillende niveaus van CPU-, geheugen- en GPU-resources, afhankelijk van de specifieke eisen van de ML-workload. Ze gebruikten ook Docker-containers om hun ML-workloads te verpakken en uit te rollen en om consistentie te waarborgen in verschillende omgevingen.
Naarmate de ML-workloads van Lyft echter in complexiteit en omvang toenamen, liepen ze tegen verschillende uitdagingen aan, waaronder de consistentie tussen verschillende omgevingen en teams. Ze besloten hun ML-infrastructuur te migreren naar een op Kubernetes gebaseerde infrastructuur, aanvankelijk met KubeFlow en later met een eigen intern platform. Door te migreren naar een op Kubernetes gebaseerde infrastructuur kon Lyft een efficiëntere en schaalbaardere ML-infrastructuur bouwen, wat hielp hun ML-ontwikkelings- en deployment-pipelines te versnellen. Daarnaast konden ze profiteren van de voordelen van Kubernetes, zoals automatische schaling en efficiënt resourcegebruik, om hun ML-workloads te optimaliseren en de infrastructuurkosten te verlagen. Ze gebruikten EKS van AWS als hun beheerde Kubernetes Service!
Algemeen, door te investeren in een MLOps-infrastructuur op Kubernetes konden Airbnb en Lyft aanzienlijke productiviteitswinst behalen en hun nettowinst verbeteren. Dit toont de waarde aan die schaalbare MLOps boven op Kubernetes kan bieden aan organisaties die machine learning op schaal willen inzetten.
Ondanks de voordelen brengt het gebruik van Kubernetes voor ML-infrastructuur een eigen reeks uitdagingen en complexiteiten met zich mee:
Hoewel er uitdagingen zijn, kunnen organisaties door best practices te volgen en gebruik te maken van de mogelijkheden van Kubernetes deze obstakels overwinnen en een schaalbare, veilige en betrouwbare MLOps-infrastructuur bouwen.
Kubernetes voor Machine Learning biedt tal van voordelen voor organisaties die hun machine learning-workflows willen optimaliseren. Hoewel er uitdagingen zijn bij het opzetten en beheren van een MLOps-infrastructuur op Kubernetes, zoals resourcebeheer, beveiliging en monitoring, kan een grondig begrip van Kubernetes en best practices helpen om deze obstakels te overwinnen.
In deze reeks over ML op Kubernetes proberen we verschillende onderwerpen te behandelen die verband houden met het bouwen en opzetten van een ML-infrastructuur op een Kubernetes-omgeving, waaronder de volgende:
en meer..
Door deze best practices te omarmen en de kracht van Kubernetes te benutten, kunnen organisaties machine learning-modellen schalen en uitrollen met consistentie, betrouwbaarheid en beveiliging. Dit leidt op zijn beurt tot een snellere marktintroductietijd, een betere samenwerking tussen data science- en IT-operationele teams, en een beter rendement op hun data science-investeringen.
Bekijk hoe Gong een schaalbare Machine Learning Research-infrastructuur heeft gebouwd op Kubernetes
TrueFoundry is een ML Deployment PaaS op Kubernetes om de workflows van ontwikkelaars te versnellen, terwijl ze volledige flexibiliteit behouden bij het testen en uitrollen van modellen met behoud van volledige beveiliging en controle voor het infrateam. Via ons platform stellen we Machine Learning-teams in staat om modellen uit te rollen en te monitoren binnen 15 minuten met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen enkele seconden terug te draaien. Hierdoor kunnen ze kosten besparen en modellen sneller naar productie brengen, wat leidt tot het realiseren van echte bedrijfswaarde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox