August 27, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Verschillende workloads vereisen uiteenlopende hardwarespecificaties, zoals machinetype, grootte en geolocatie. Met de opkomst van ML/LLMs is het selecteren van de juiste hardware cruciaal geworden. We moeten keuzes maken op basis van hardwarespecificaties zoals OS-type, architectuur, processor, GPU-type en opslag. Kubernetes helpt bij het orchestreren en verdelen van resources over soortgelijke workloads, maar het dynamisch provisionen van deze resources op aanvraag blijft een uitdaging.
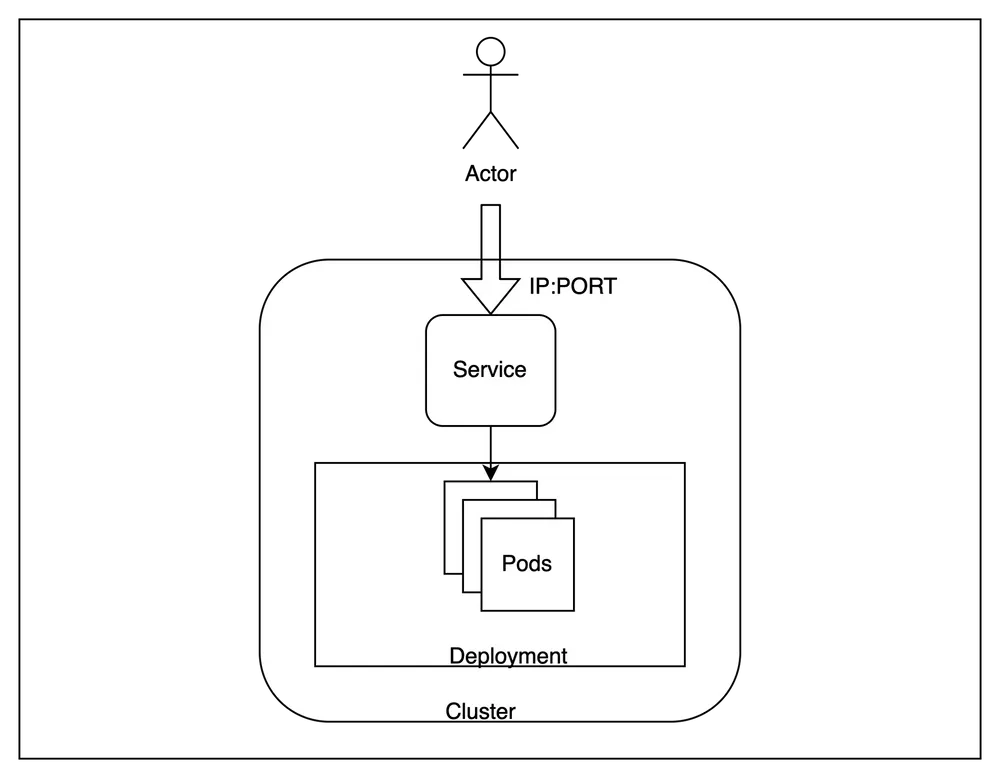
Een Kubernetes (K8s) cluster is een groepering van nodes die gecontaineriseerde applicaties op een efficiënte, geautomatiseerde, gedistribueerde en schaalbare manier uitvoeren. Elke node binnen een Kubernetes cluster heeft specifieke attributen zoals machinetype, grootte en locatie.
Deze blog verkent de noodzaak van cloud node auto-provisioners om uiteenlopende workloadvereisten binnen Kubernetes clusters automatisch te beheren. We bieden ook inzicht in oplossingen van grote cloudproviders zoals AWS, GCP en Azure. Ten slotte diepen we uit hoe TrueFoundry deze uitdagingen als platform aanpakt.
Node auto-provisioning automatiseert het provisionen van de juiste nodegroep op basis van constraints van niet-ingeplande pods om infrastructuurkosten te optimaliseren. Node auto-provisioners in een Kubernetes cluster zijn verantwoordelijk voor de volgende acties:
Kubernetes gebruikt nodes als worker machines met specifieke hardwareconfiguraties zoals machinetype, grootte en capaciteitstype; node pools verwijzen naar pools van zulke gemeenschappelijke worker machines. Zonder een node auto-provisioner was de enige manier om een specifieke hardwareconfiguratie aan je workload toe te wijzen via node pool-selectie. Dit vereist dat de gebruiker een node pool met de vereiste configuratie aanmaakt in hun cloud en vervolgens node affinity toevoegt voor de specifieke node pool in de Pod spec.

Over het algemeen omvat dit mechanisme de volgende stappen:

De combinaties van node pool-vereisten kunnen talrijk zijn, vooral tijdens de experimenteerfase voor ML/LLM workloads. Afstemming tussen afzonderlijke DevOps- en Platform-teams kan aanzienlijke tijd kosten tijdens de ontwikkeling. Daarom wordt een controller die dynamisch vereisten beoordeelt en automatisch infrastructuur voorziet cruciaal.
Node auto-provisioning elimineert de handmatige stap van het vooraf aanmaken van node pools doordat gebruikers op hoog niveau vereisten als constraints kunnen toevoegen. Het bepaalt automatisch het beste machinetype of de best beschikbare node voor de workload.

Enkele veelgebruikte constraints:
21000t4, a100on-demand of spotus-east-1alinux of windowsarm64 or amd64
Elke cloudprovider biedt zijn eigen auto-provisioningmechanismen. AWS vereist de installatie van tools zoals Karpenter, terwijl GCP een ingebouwde oplossing biedt. Azure heeft onlangs zijn auto-provisioner-project geïntroduceerd, dat zich momenteel in preview-modus bevindt.
Karpenter, een open-source node lifecycle management-project ontworpen voor Kubernetes, verbetert de efficiëntie en kosteneffectiviteit van het uitvoeren van workloads op clusters aanzienlijk. Door rekening te houden met scheduling constraints zoals resource requests, node selectors, affinities, tolerations en topology spread constraints, voorziet en dealloceert Karpenter intelligent nodes waar nodig.
Node auto-provisioning, geïntegreerd in de cluster autoscaler, schaalt bestaande node pools op basis van de specificaties van niet-inplanbare Pods. De auto-provisioningfunctie van GCP zorgt voor een optimaal resourcegebruik door rekening te houden met CPU, geheugen, ephemeral storage, GPU requests, node affinities en label selectors.
Azure's Node auto-provisioning (NAP) project, dat zich momenteel in preview-modus bevindt, maakt gebruik van het open-source Karpenter-project om de optimale VM-configuratie te bepalen voor het efficiënt en kosteneffectief uitvoeren van workloads. NAP implementeert en beheert Karpenter automatisch op AKS clusters, wat gebruikers een naadloze ervaring biedt.
💡
Node auto-provisioning (NAP) voor AKS is momenteel in PREVIEW. We zijn erg enthousiast over dit nieuwe project en kijken ernaar uit om het voor onze klanten te gebruiken. Lees meer
TrueFoundry biedt geavanceerde filtermogelijkheden voor node pools, waarmee de ervaring van node auto-provisioning wordt gesimuleerd.

Om dit te bereiken, hebben we een paar eenvoudige stappen gefaciliteerd:
Deze aanpak stelt Developers/Data scientists in staat om de beste node pool voor hun workload te selecteren door hun vereisten te analyseren. Dit eenvoudige mechanisme stelt ons in staat om dezelfde ervaring te bieden voor elke cloud die nog geen ingebouwde ondersteuning voor auto-provisioners heeft.
Aangezien infrastructuurvereisten blijven evolueren, zetten cloudproviders zich in om het proces van het selecteren van de optimale infrastructuur voor uiteenlopende workloads te stroomlijnen. Bij TrueFoundry delen we deze betrokkenheid door te streven naar het empoweren van Developers met de tools en kennis die ze nodig hebben om hun workloads naadloos te deployen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox