



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Prefix caching hergebruikt identieke prompts. Semantic caching hergebruikt vergelijkbare prompts — maak een embedding van het binnenkomende verzoek, en als een vrijwel identieke vraag recent is beantwoord, geef dan het opgeslagen antwoord terug in plaats van het model aan te roepen. Het is een van de meest doeltreffende knoppen voor kosten en latency waar een gateway aan kan draaien, maar wel een waarbij "het werkt in de demo" en "het is veilig in productie" twee heel verschillende beweringen zijn. Dit artikel legt uit hoe het werkt, de enkele knop waarmee je het beheert, de gevallen waarin het stilzwijgend het verkeerde antwoord geeft, en waar de cache moet leven.
Kabir, een backend engineer, had een goede week en daarna een slechte. De goede week: hij had een semantic cache geplaatst voor de ondersteuningsassistent van Northwind — maak een embedding van elke binnenkomende vraag, en als een vrijwel identieke vraag recent was beantwoord, retourneer dan het opgeslagen antwoord in plaats van het model aan te roepen. Het volume van modelaanroepen daalde met 35%. Latency bij cache hits zakte van ongeveer 900 ms naar minder dan 40 ms. De slechte week: een klant vroeg "waar is mijn levering?" en kreeg een zelfverzekerd, gedetailleerd antwoord — over de bestelling van iemand anders. Twee klanten hadden minuten na elkaar semantisch identieke vragen gesteld; de cache zette beide om naar vrijwel dezelfde vector, scoorde een hit en gaf het antwoord van de eerste klant aan de tweede.
De cache werkte exact zoals ontworpen. Hij had alleen geen idee dat "waar is mijn levering?" iets anders betekent afhankelijk van wie het vraagt. Semantic caching ruilt een modelaanroep in voor een overeenkomst op basis van overeenkomst (similarity match), en de volledige veiligheid van die ruil rust op twee zaken: de drempelwaarde waarop je vergelijkt, en wat je überhaupt in de cache toelaat. Dit artikel behandelt beide.
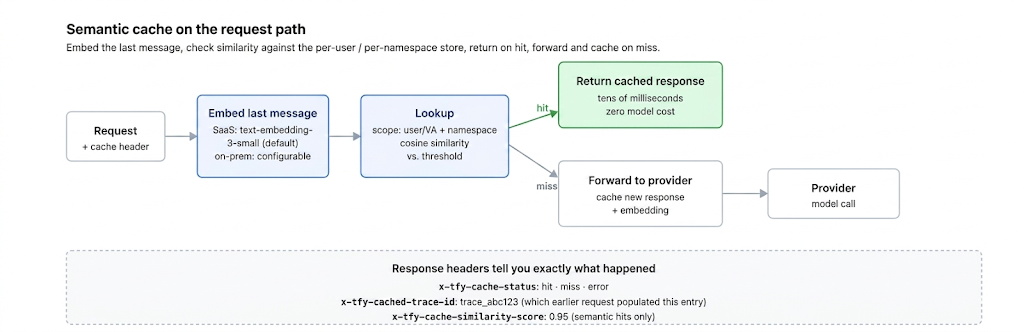
Alles in dit artikel — exact-match en semantic caching, de similarity threshold als knop per route, afbakening per tenant zodat Kabirs fout uit de inleiding nooit voorkomt, en de telemetry voor hit-rate / kostenbesparing die je vertelt of de cache daadwerkelijk rendeert — is iets wat de caching van TrueFoundry's AI Gateway uitdrukt als gateway-configuratie. Een enkele header op het verzoek schakelt het in; de gateway hasht het verzoek (of maakt een embedding van het laatste bericht bij semantic), vergelijkt dit met een op Redis gebaseerde opslag en retourneert het gecachete antwoord bij een hit. Bij een miss gaat het verzoek naar de provider en worden het nieuwe antwoord en de embedding gecachet voor de volgende keer.
Het verhaal rond correctheid — zorgen dat twee semantisch vergelijkbare verzoeken van verschillende gebruikers nooit elkaars antwoorden retourneren — is ingebouwd via namenpacing op twee niveaus. Niveau 1 is automatisch: elke cache entry is afgebakend voor de aanroepende gebruiker of virtuele account, dus een verzoek van Gebruiker A kan nooit een entry van Gebruiker B raken, punt uit. Niveau 2 is optioneel: een namespace-veld in de cache-configuratie segmenteert verder (per tenant, per omgeving, per system-promptversie), wat in de praktijk nodig is voor het namespace-argument in dit artikel. Samen zorgen ze ervoor dat een semantic cache op gateway-niveau veilig gedeeld kan worden over services zonder dat elke service isolatie opnieuw hoeft te implementeren.
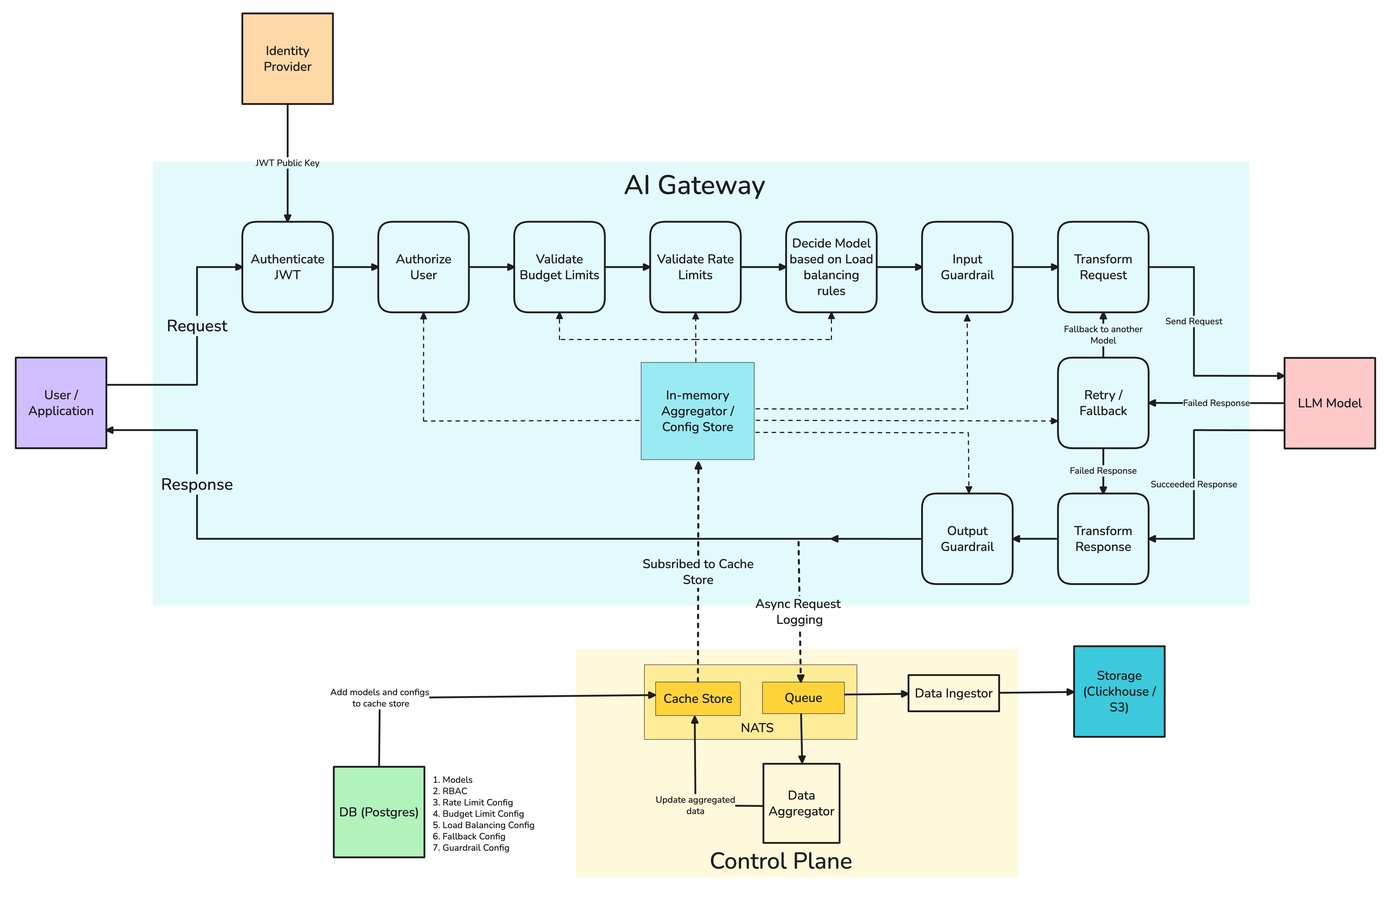
Applicatiecode blijft hetzelfde — de cache is opt-in per verzoek via een enkele header. Het onderstaande voorbeeld gebruikt semantic, wat een uitbreiding is van exact-match (het serveert ook hits met identieke tekst), met een conservatieve startdrempel van 0.9 en een aangepaste namespace, zodat een multi-tenant app de cache van elke tenant geïsoleerd houdt, zelfs buiten de automatische scoping per gebruiker:
De gateway aanroepen met semantic caching ingeschakeld (Python, OpenAI-compatibel)
"Caching" omvat drie verschillende mechanismen met een zeer verschillend bereik en risico, en het is de moeite waard om precies te zijn over welke je implementeert.
Provider prefix caching hergebruikt een exacte, identieke prompt-prefix — de system prompt en tool-definities die ongewijzigd herhaald worden over aanroepen heen. De provider matcht op een exacte prefix en brengt het herhaalde deel tegen een flinke korting in rekening. Het is automatisch, veilig en behandeld in onze context-engineering post; het serveert nooit een verkeerd antwoord omdat het alleen matcht op identieke tekst.
Exact-match response caching hasht het gehele genormaliseerde verzoek en retourneert de opgeslagen respons bij een identieke hash. Ook veilig — identieke invoer, identieke uitvoer — maar de hit rate is laag, omdat gebruikers dingen zelden identiek verwoorden.
Semantic caching is het onderwerp hier: embed het verzoek en serveer een gecachte respons wanneer er een vergelijkbaar eerder verzoek bestaat. Dit is waar de hit rate omhoog schiet, omdat "waar is mijn pakket?" en "is mijn bestelling al verzonden?" een gecacht antwoord kunnen delen — en het is ook waar het risico verschijnt, omdat "vergelijkbaar" een oordeel is dat gemaakt wordt door een overeenkomstdrempel in plaats van een exacte match.
Het mechanisme bestaat uit drie stappen. Embed het binnenkomende verzoek in een vector. Zoek in een vector store naar het dichtstbijzijnde eerdere verzoek binnen de juiste scope. Als de overeenkomst van de dichtstbijzijnde buur een drempelwaarde overschrijdt, retourneer dan de opgeslagen respons; roep anders het model aan en sla het nieuwe verzoek/respons-paar op voor de volgende keer.
Semantic cache lookup — embed, zoek binnen scope, serveer bij een betrouwbare hit
Bij een hit heb je een modelaanroep — typisch enkele honderden milliseconden en een prijs per token — vervangen door een embedding-aanroep en een vector lookup, in de orde van grootte van tientallen milliseconden en een fractie van de kosten. Bij een miss heb je de embedding- en lookup-latency toegevoegd aan de normale modelaanroep, wat de kleine prijs is die je betaalt voor de kans op een hit. De economie van die afweging hangt volledig af van de hit rate (sectie 7), en de veiligheid hangt volledig af van de drempelwaarde (volgende).
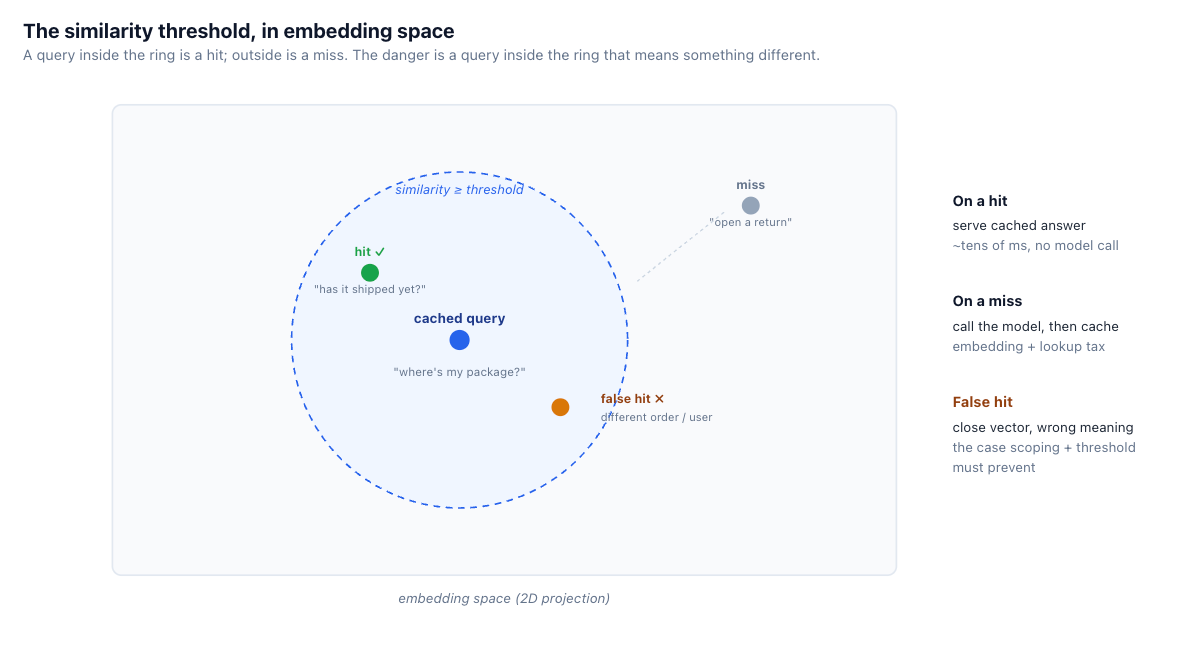
De drempelwaarde bepaalt hoe dicht een nieuw verzoek bij een gecacht verzoek moet liggen om als hit te tellen, en het is een directe afweging tussen precisie en recall. Stel hem te laag in — accepteer losse matches — en de hit rate is hoog, maar je serveert antwoorden op vragen die niet helemaal gesteld waren (valse hits). Stel hem te hoog in — eis een vrijwel identieke formulering — en de cache is veilig maar treedt zelden in werking, wat neerkomt op exact-match caching met extra stappen.
Er is geen universele juiste waarde, omdat deze afhangt van het embedding-model, het domein en hoeveel een verkeerd antwoord je kost. De manier om deze in te stellen is empirisch: verzamel gelabelde paren van verzoeken die een antwoord wel en niet zouden moeten delen, doorloop de drempelwaarden, en kies het punt waar valse hits zakken naar een acceptabel niveau voor die route. High-stakes routes (alles wat raakt aan geld, gezondheid of identiteit) rechtvaardigen een conservatieve drempelwaarde of helemaal geen semantic caching; low-stakes informatieve routes (documentatie Q&A, algemene uitleg) kunnen losser worden ingesteld. Drempelwaarden per route, geen globale waarde, zijn het productiepatroon — en een gateway zoals TrueFoundry's AI Gateway, die al voor elke route zit, is de natuurlijke plek om ze per route in te stellen en de valse-hit rate van elke route te bewaken in plaats van het beleid over services te verspreiden.
Het kernrisico is eenvoudig te benoemen en gemakkelijk te onderschatten: dichtbij in embedding is niet gelijk in betekenis. Embeddings leggen thematische overeenkomst vast, geen logische equivalentie. "Wat is de hoofdstad van Frankrijk?" en "Wat is de hoofdstad van Duitsland?" liggen extreem dicht bij elkaar in de embedding-ruimte — dezelfde structuur, hetzelfde domein, één woord anders — maar vereisen verschillende antwoorden. Een drempelwaarde die is afgesteld op recall zal ze als dezelfde vraag behandelen.
De maatregelen stapelen zich op, en geen enkele is op zichzelf compleet. Een conservatieve drempelwaarde vermindert losse matches. Entity- en keyword-guards voegen een controle toe dat de cruciale entiteiten (het land, het bestelnummer, het product) overeenkomen voordat een hit wordt geserveerd, wat de case Frankrijk/Duitsland opvangt die zuivere cosine similarity mist. Caches per namespace voorkomen dat verschillende contexten botsen. En de meest betrouwbare maatregel ligt stroomopwaarts: cache de categorieën verzoeken helemaal niet waarbij een near-miss gevaarlijk is, wat het onderwerp is van de volgende sectie. Behandel semantic caching als een tool met een bekende foutmodus waar je omheen ontwerpt, niet als een transparante versnelling die je overal kunt toepassen.
Sommige antwoorden zijn onveilig om te serveren op basis van een similarity match, ongeacht hoe goed de drempelwaarde is, omdat hetgeen wat twee requests verschillend maakt zich niet bevindt in de tekst die de embedding ziet.
Een semantisch cache-item wordt niet alleen op tekst gefilterd; het wordt gefilterd op een embedding binnen een namespace, en de namespace is waar correctheid wordt afgedwongen. De namespace moet alles coderen wat twee tekstueel vergelijkbare verzoeken werkelijk verschillend maakt: de tenant of gebruiker (voor alles wat gebruikersspecifiek is), het model, de system-promptversie en de actieve toolset. Twee identieke vragen onder verschillende system-promptversies zijn verschillende vragen, omdat de instructies die het antwoord vormen zijn gewijzigd.
Namespacing van een cache-item (illustratief)
Invalidatie heeft twee triggers. Tijd, via een TTL gekozen op basis van hoe snel de onderliggende waarheid verandert — kort voor alles wat fluctueert, langer voor stabiele referentie-antwoorden. En versie, via de namespace: het verhogen van de system-promptversie of het wijzigen van de toolset ververst de cache, zodat verouderde antwoorden uit de oude configuratie nooit worden geserveerd. Het niet invalidatiewerken bij een prompt-wijziging is een veelvoorkomende en subtiele bug — de prompt verbetert, maar gecachte antwoorden blijven de oude weerspiegelen totdat de TTL verloopt.
In het cachen van TrueFoundry is dit alles de x-tfy-cache-config-header (of een centraal beheerd beleid dat dezelfde velden instelt). Het schema is klein en de besturingselementen komen overeen met wat zojuist in deze sectie is beschreven:
Caching per route voor een multi-tenant assistent — drie patronen, hetzelfde schema
De drempelwaarde-richtlijnen in de documentatie komen overeen met de post: 0,95–1,0 voor zeer strenge use cases waar een verkeerde hit kostbaar is, 0,85–0,95 voor gebalanceerde conversatie-assistenten, onder 0,85 voor verkennende routes of routes met een laag risico. Beginnen bij 0,9 en aanpassen op basis van het waargenomen aantal valse hits is wat zij aanbevelen, en de respons-header x-tfy-cache-similarity-score is wat dat meetbaar maakt — elke hit vertelt u de score waar deze aan voldeed, zodat een analyse over gelabelde paren een kwestie van enkele query's wordt in plaats van een aangepast evaluatieharnas.
Twee implementatiedetails die het waard zijn om te weten. Het embeddingmodel op SaaS is standaard OpenAI's text-embedding-3-small en is in die modus niet configureerbaar; bij self-hosted deployments is het te selecteren via Controls → Settings → Semantic Cache, en het gekozen model geldt voor alle semantische cache-operaties gateway-breed.
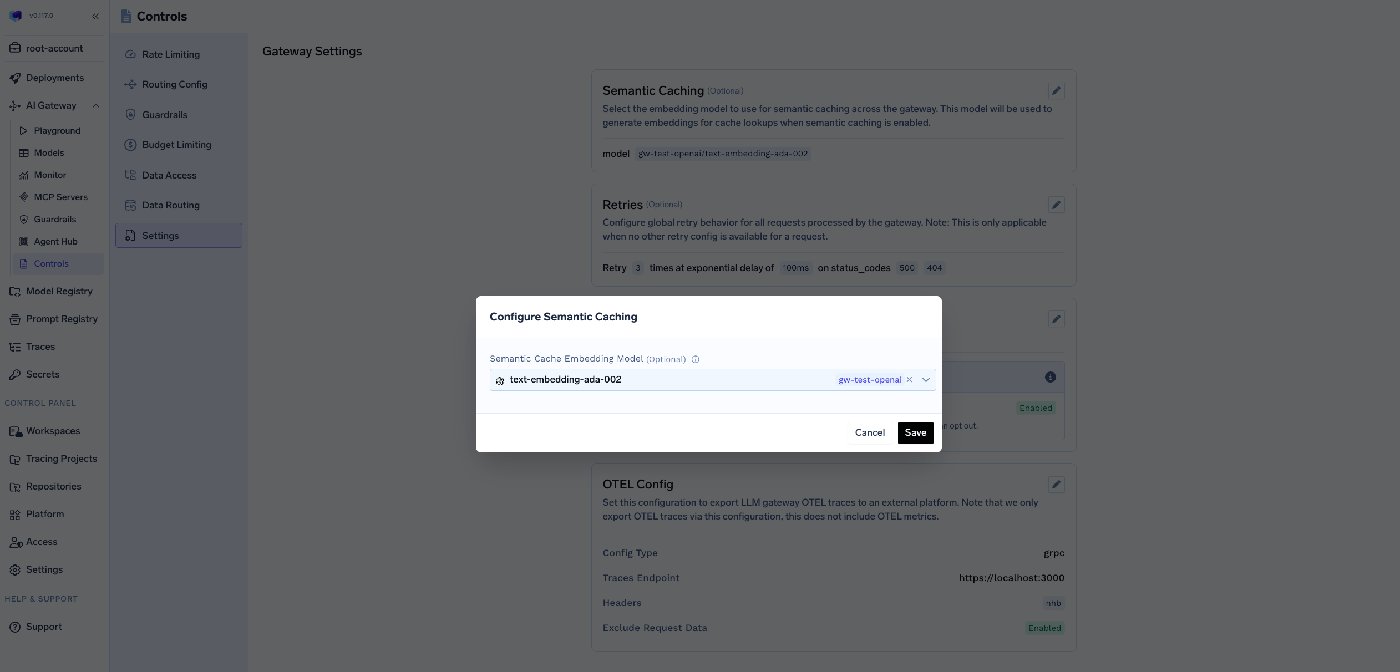
De opslag bij self-hosted is Redis — ofwel de gebundelde Redis uit de tfy-llm-gateway Helm chart, ofwel uw eigen Redis (of Redis-compatibel zoals Valkey) via omgevingsvariabelen. Beide keuzes zijn van belang omdat de cache zichzelf alleen terugverdiend wanneer de embedding+lookup werkelijk sneller en goedkoper is dan de model-call die wordt vermeden.
De andere kant van het namespace-argument uit de post is het deel dat de gateway automatisch maakt: Niveau-1 isolatie. Elk item heeft impliciet een bereik voor de gebruiker of het virtuele account dat het heeft aangemaakt, dus zelfs als u vergeet namespace in te stellen, retourneert het verzoek van Gebruiker A nooit het gecachte antwoord van Gebruiker B. De aangepaste namespace is een aanvullende partitie voor de gevallen die de post beschrijft — multi-tenant apps die één virtueel account delen, system-promptversies, omgevingen — niet het enige dat tussen de antwoorden van twee aanroepers staat. Die gelaagdheid is wat "deel één cache over services heen" een verdedigbare standaard maakt in plaats van een risico.
De waarde van semantisch cachen wordt bepaald door één getal: de hit rate. Als illustratief model veronderstellen we dat een route draait tegen bepaalde modelkosten per call en dat de cache een hit rate van 30% bereikt bij een veilige drempelwaarde. Ongeveer 30% van de verzoeken slaat nu de model-call over, waardoor de kosten op die route met bijna 30% dalen (minus de embedding- en lookup-kosten, die klein zijn in vergelijking met een generatie). De latentie verbetert op precies die 30% van de verzoeken, en daalt van een generatie van enkele honderden milliseconden naar een lookup van tientallen milliseconden, wat zowel het gemiddelde als de uitschieters naar beneden trekt.
Twee eerlijke kanttekeningen bij de berekening. De hit rate is werklastspecifiek — een beknopte assistent in FAQ-stijl ziet mogelijk veel meer dan 30%, terwijl een creatieve werklast met een lange staart er vrijwel geen ziet — dus het enige geloofwaardige getal is wat u meet op uw eigen verkeer. En de besparingen zijn netto na aftrek van de embedding-tax op elke misser; als uw hit rate erg laag is, kunt u meer uitgeven aan embeddings dan u bespaart. Meet het cachebare deel voordat u zich vastlegt, in plaats van uit te gaan van een geadverteerd percentage. Het uitvoeren van de cache achter TrueFoundry's AI Gateway is wat het in de eerste plaats meetbaar maakt — de hit rate en de vermeden uitgaven verschijnen naast de kosten per call uit het kostenallocatiewerk, zodat de besparingen een waargenomen getal zijn in plaats van een prognose.
Een semantische cache kan zich in de applicatie bevinden, maar de gateway is de sterkere standaard om dezelfde redenen die gelden voor routing en betrouwbaarheid: hij bevindt zich al op elk verzoek, dus de cache wordt gedeeld over services heen in plaats van in elke service opnieuw te worden geïmplementeerd, en hij bevat al de telemetrie voor kosten per call en latentie die nodig is om te meten of de cache daadwerkelijk rendeert.
Het draaien van de cache op TrueFoundry's AI Gateway betekent één plek om scoping per tenant af te dwingen (zodat de koude kermis niet kan plaatsvinden), één plek om de hit rate, bespaarde kosten en bespaarde latentie te zien, en dezelfde weergave voor kostenallocatie uit de kostenallocatie-post die de verdeling gecacht vs. niet-gecacht per team en route toont. De taakverdeling is degene die in deze reeks steeds terugkeert: de gateway biedt de gedeelde, scoped, observeerbare cache; de applicatie is eigenaar van de beleidsbeslissing over welke routes veilig zijn om te cachen en bij welke drempelwaarde — omdat alleen de applicatie weet dat "waar is mijn levering?" gepersonaliseerd is en "wat is uw retourtermijn?" niet.
Hoe verschilt dit van het cachen van prompts in de context-engineering-post?
Die post behandelde provider prefix caching — het hergebruiken van een identieke system-prompt prefix tegen een facturatiekorting, wat nooit een verkeerd antwoord serveert omdat het overeenkomt met exacte tekst. Semantisch cachen hergebruikt vergelijkbare verzoeken door ze in te bedden, waar zowel de hogere hit rate als het risico op valse hits vandaan komen. Ze vullen elkaar aan: cache de statische prefix bij elke call, en cache hele antwoorden alleen semantisch op de routes waar het veilig is.
Hoe kies ik de overeenkomstdrempel (similarity threshold)?
Empirisch, per route. Bouw een gelabelde set verzoekparen die wel en niet een antwoord zouden moeten delen, doorloop de drempelwaarden en kies het punt waar valse hits dalen tot een niveau dat acceptabel is gezien wat een verkeerd antwoord op die route kost. Routes met een hoog afbreukrisico krijgen een conservatieve drempelwaarde of geen semantische caching; informatieve routes met een laag risico kunnen ruimer worden ingesteld. Eén enkele globale drempelwaarde is bijna altijd verkeerd voor een bepaalde route.
Kan ik alles wat gepersonaliseerd is veilig cachen?
Alleen met een expliciet bereik per gebruiker (of per tenant) in de cache-namespace, zodat een zoekopdracht nooit het antwoord van een andere gebruiker kan retourneren — en zelfs dan moet u letten op tijdgevoeligheid. De veilige standaard voor gepersonaliseerde, tijdgevoelige, stateful of risicovolle antwoorden is om ze niet semantisch te cachen. De koude kermis is wat er gebeurt als een gepersonaliseerd antwoord wordt gecacht zonder gebruikersbereik.
Wat gebeurt er met de cache als ik de system prompt wijzig?
U moet invalidaten, anders serveert u antwoorden die zijn gevormd door de oude prompt totdat hun TTL verloopt. De schone manier is om de system-promptversie in de cache-namespace op te nemen, zodat een prompt-wijziging de cache automatisch ververst en oude items simpelweg nooit meer worden gematcht.
Gateway of applicatie?
De gateway voor het mechanisme — gedeelde cache, scoping per tenant en de observatie van hit rate/kosten/latentie die u vertelt of het werkt. De applicatie voor het beleid — welke routes cachebaar zijn en bij welke drempelwaarde — omdat dat oordeel domeinkennis vereist die de gateway niet heeft.
Kabirs cache was geen slecht idee; het was een idee zonder bereik. Semantisch cachen levert echte winst op in kosten en latentie op de routes waar vergelijkbare vragen werkelijk een antwoord delen — en de discipline die het veilig maakt, is dat u route voor route weet welke vragen dat zijn.
TrueFoundry's AI Gateway is een enterprise-grade control plane die zich tussen uw applicaties en 1.600+ modellen bevindt — over OpenAI, Anthropic, Google, AWS Bedrock, Azure OpenAI en uw eigen self-hosted modellen — achter één enkele OpenAI-compatibele API. Het verandert de cachingstrategieën in deze post in configuratie in plaats van code per service: exacte en semantische caching via een enkele x-tfy-cache-config-header, overeenkomstdrempels en TTL's per route, automatische isolatie per gebruiker / per virtueel account, optionele namespace-partitionering voor multi-tenant apps en promptversies, en op Redis gebaseerde opslag die op dezelfde manier werkt op SaaS en self-hosted (waarbij het embeddingmodel on-premise configureerbaar is).
Omdat de gateway zich al op elk verzoek bevindt en voor elke call een volledige trace genereert, wordt de cache meetbaar in hetzelfde overzicht als al het andere: x-tfy-cache-status, de gecachte trace-ID en de werkelijke overeenkomstscore komen op elke respons terecht en worden samengevoegd tot dashboards voor bespaarde kosten en bespaarde latentie. Dezelfde gateway voegt RBAC, virtuele accounts, budgetten en rate limits, fallbacks en retries, guardrails en observatiedashboards toe. Het kan worden geïmplementeerd als SaaS, in uw VPC, on-premise of air-gapped met SOC 2-, HIPAA- en ITAR-compliance, en is erkend in Gartner's Market Guide for AI Gateways. Bekijk de caching-documentatie of het AI Gateway-overzicht om dieper te graven.
Northwind en Kabir zijn ter illustratie. De mechanica van op embeddings gebaseerde caching, het precisie/recall-gedrag van de overeenkomstdrempelwaarde en de 'embedding-dichtbij-is-niet-gelijk-aan-betekenis'-foutmodus zijn algemene eigenschappen van de techniek. Specifieke cijfers — de vermindering van 35% in calls, de latency van 900 ms naar 40 ms bij hits, het voorbeeld van een hit-rate van 30%, de kosten van 10–30 ms per embedding — zijn representatieve aannames van de orde van grootte om de afwegingen te illustreren, geen metingen; meet uw eigen cachebare fractie en false-hit rate voordat u semantic caching inschakelt in productie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















