



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Niemand heeft de bedoeling om een credential naar een modelprovider te sturen. Toch gebeurt het, omdat prompts worden samengesteld uit rommelige tekst uit de praktijk:
Een ontwikkelaar die een integratie debugt, plakt een config-fragment — met een actieve API-sleutel erin — en vraagt het model om de fout te vinden. Een coding agent die de opdracht krijgt om "de mislukte test op te lossen", leest het .env-bestand van de repo in zijn context. Een RAG-pipeline haalt een document op dat toevallig een database connection string bevat. Een agent aanroept een tool die een object retourneert met een ingesloten OAuth-token, en dat resultaat gaat rechtstreeks terug de context van het model in.
In elk geval is het secret nu verzonden naar een externe provider, ergens gelogd en mogelijk gebruikt voor training of bewaard. De ontwikkelaar deed niets wat klaarblijkelijk verkeerd was; het systeem had geen controlepunt. Dat controlepunt is wat een secrets-detection guardrail biedt — en de juiste plek daarvoor is de gateway waar elke call toch al doorheen gaat.
Credentials komen voor in herkenbare vormen, en een goede detector kent de patronen.
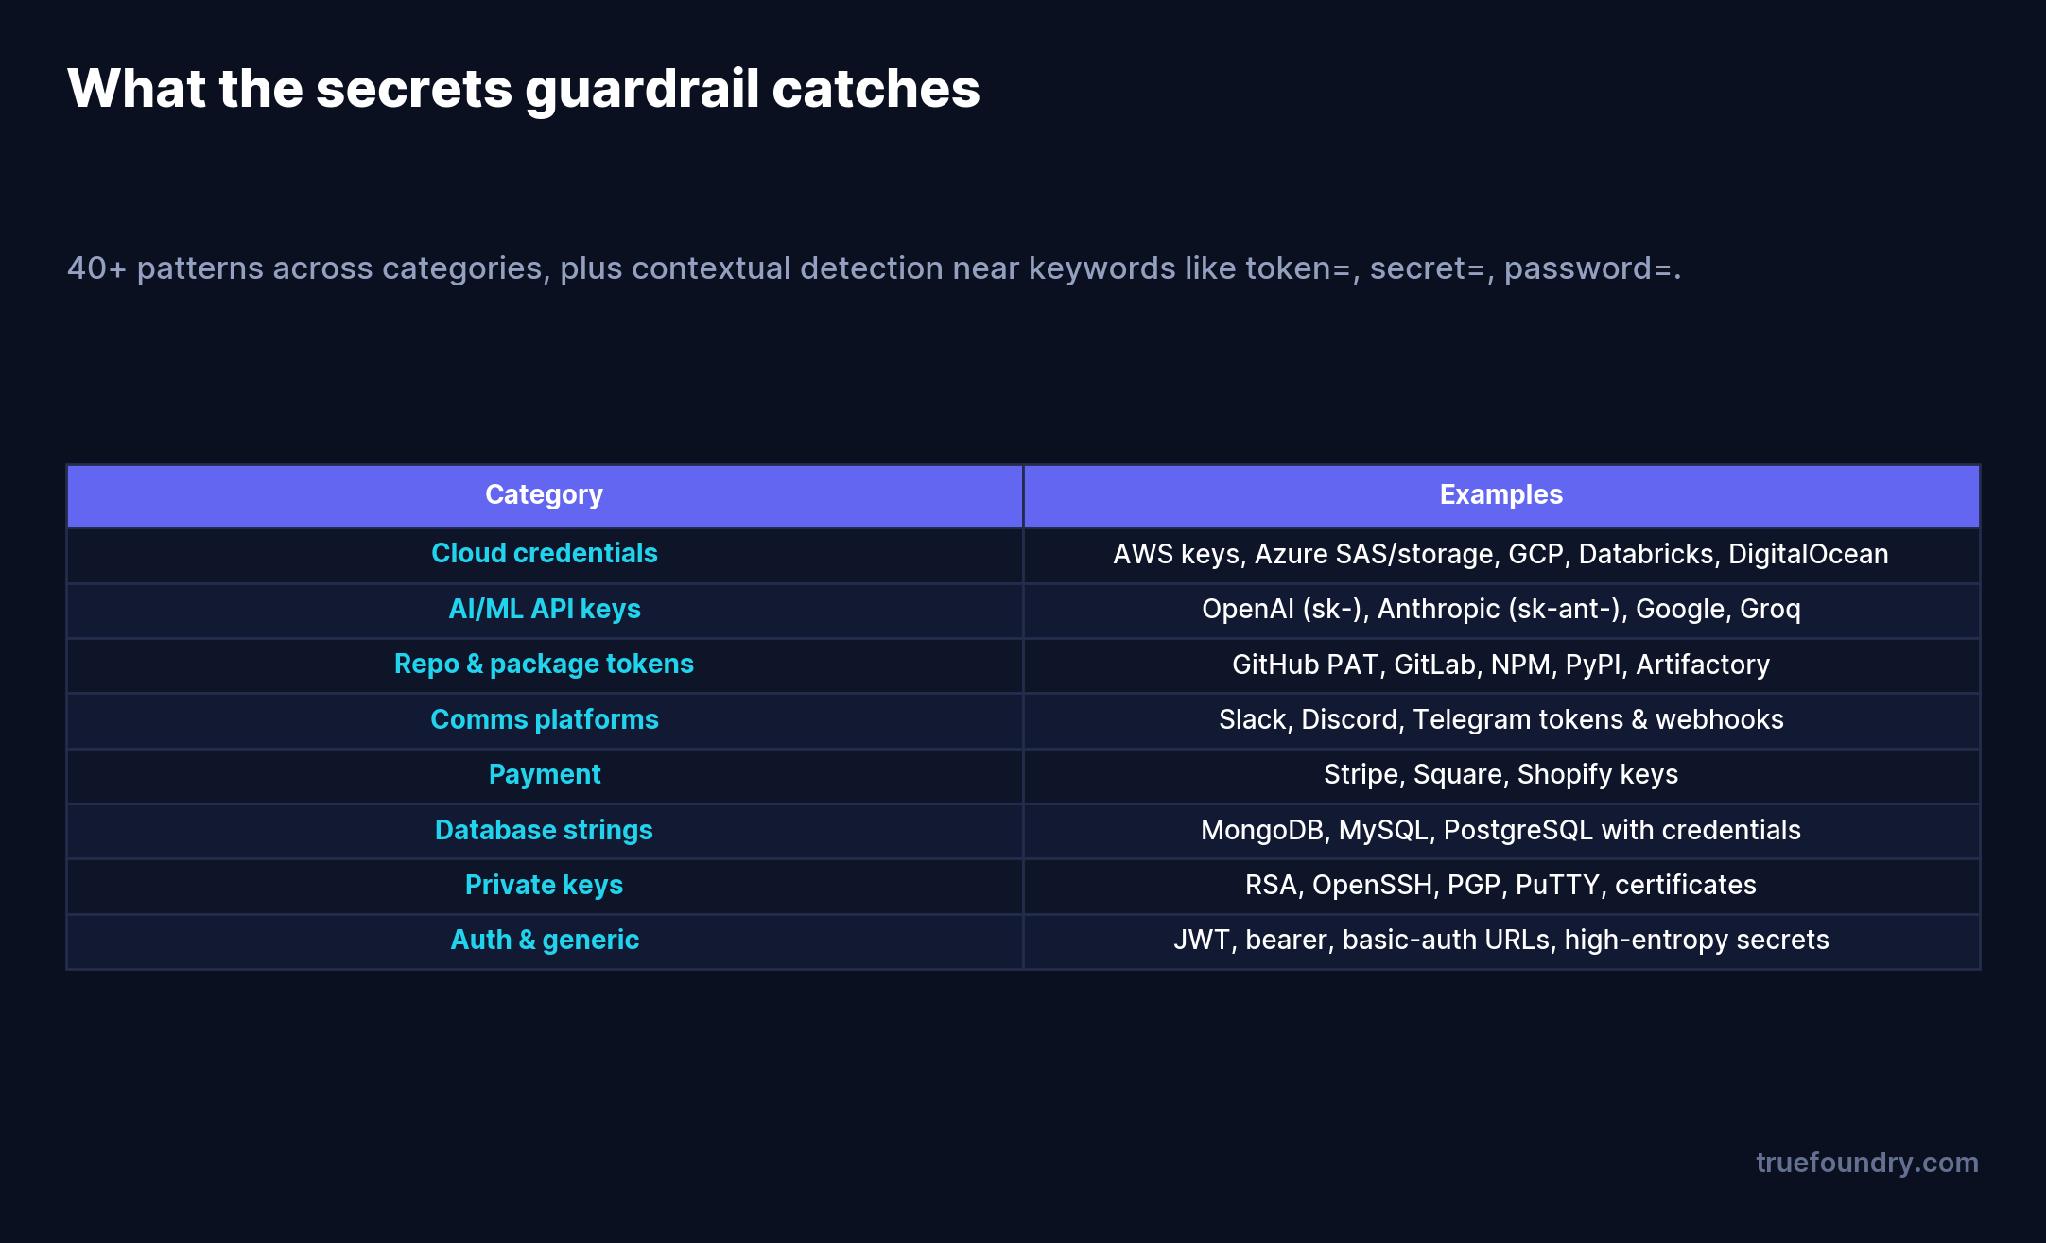
De ingebouwde Secrets Detection guardrail van TrueFoundry herkent ruim 40 credential-patronen bij cloudproviders (AWS, Azure, GCP), AI/ML API-sleutels (OpenAI's sk-, Anthropic's sk-ant-), repository- en package-tokens (GitHub, GitLab, NPM, PyPI), communicatieplatformen (Slack, Discord, Telegram), betalingssleutels (Stripe, Square, Shopify), database connection strings, en private keys en certificaten (RSA, OpenSSH, PGP). Naast vaste patronen voert het contextuele detectie uit — het markeert hex- of base64-strings met hoge entropie die verschijnen in de buurt van trefwoorden zoals token=, secret= of password=, waarmee credentials worden opgevangen die geen standaardformaat volgen.
Omdat het binnen de gateway draait in plaats van een externe dienst aan te roepen, is de detectie snel en brengt het geen extra kosten per request met zich mee.
Een secret kan vanuit drie richtingen de conversatie binnenkomen — de gebruiker, het model of een tool — dus de guardrail draait op vier punten.
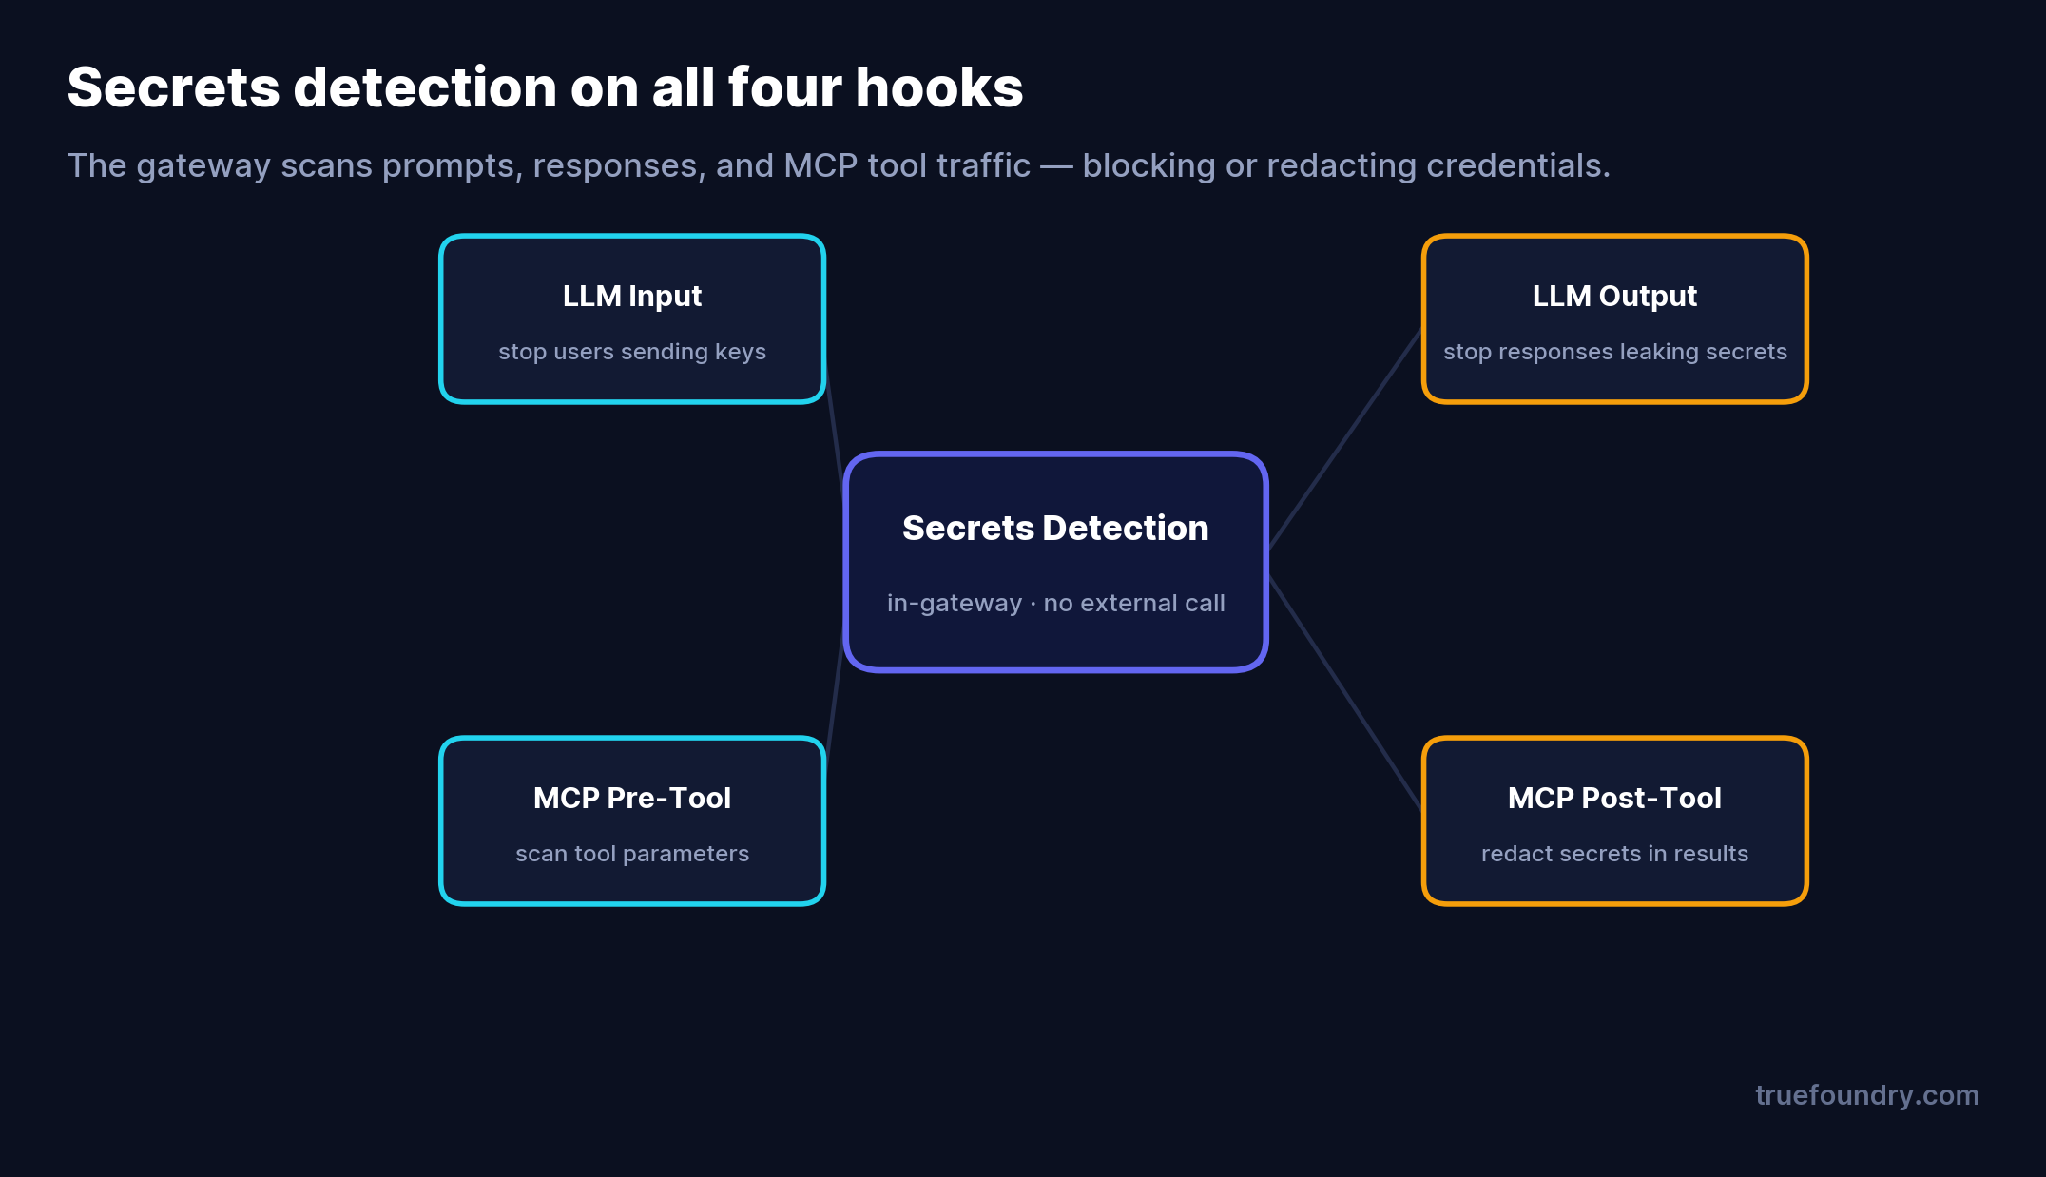
LLM Input voorkomt dat een gebruiker of app überhaupt credentials naar het model stuurt. LLM Output vangt een model op dat een secret genereert of echoot (bijvoorbeeld door het genereren van een voorbeeldconfiguratie met een echt lijkende sleutel). MCP Pre-Tool scant toolparameters voordat een tool draait, en MCP Post-Tool redigeert secrets in toolresultaten — de bestandsinhoud en API-responses die een agent terug zijn context in trekt. Voor agentic systemen zijn de MCP-hooks even belangrijk als de LLM-hooks, omdat de agent zelfstandig bestanden leest en API's aanroept.
U kiest wat er gebeurt als er een secret wordt gevonden.
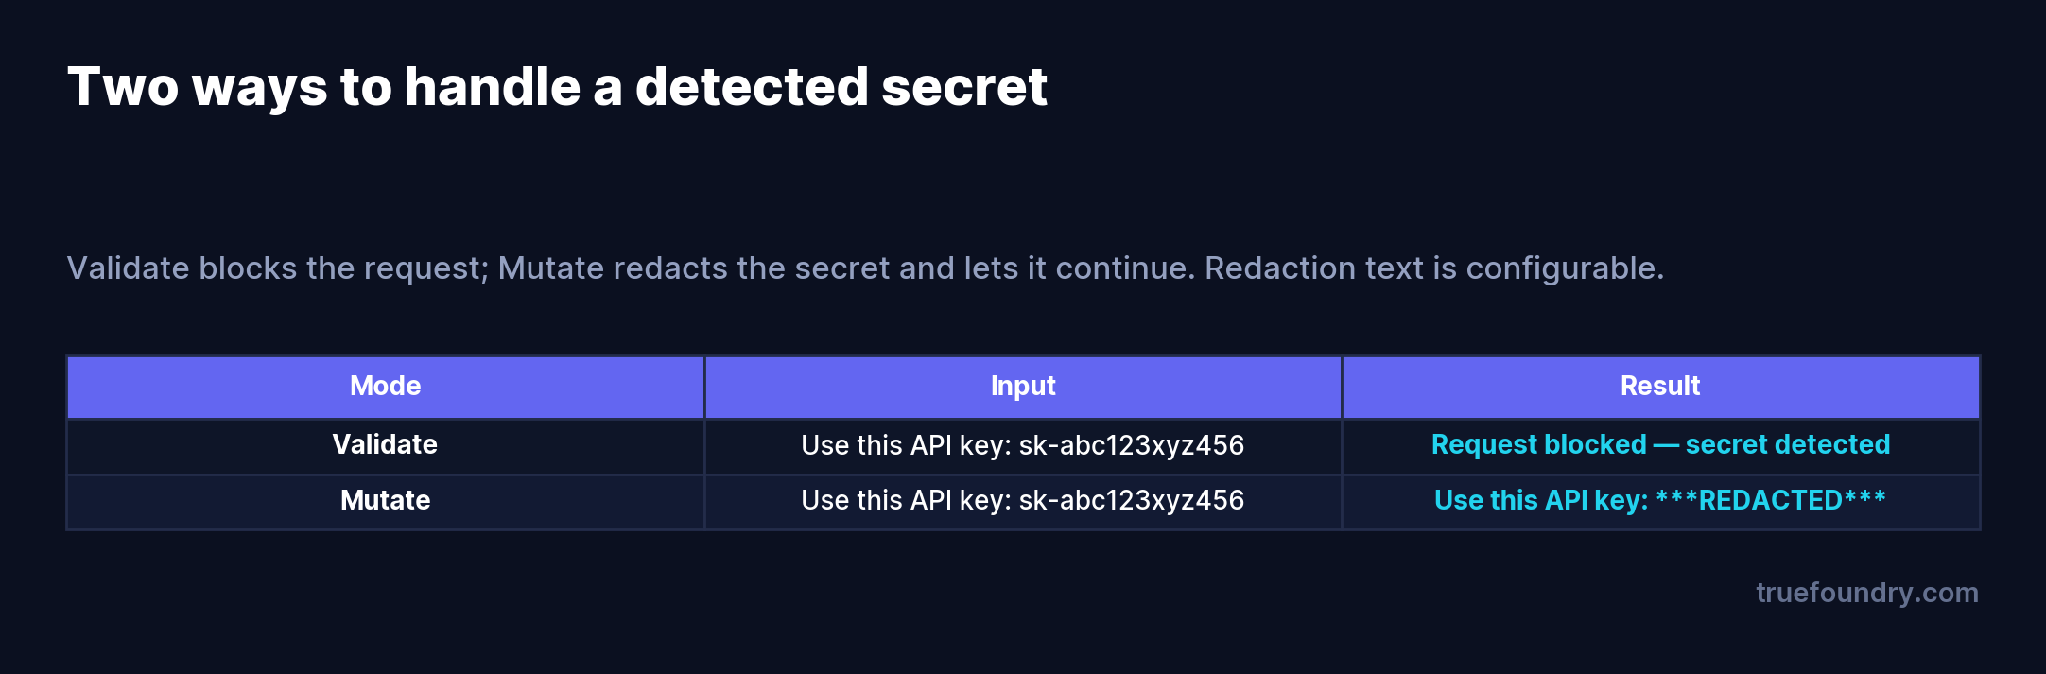
De modus Validate blokkeert de request direct wanneer er een secret wordt gedetecteerd — de juiste keuze wanneer een credential in de content een harde beleidsschending is. De modus Mutate redigeert het secret, vervangt het door configureerbare tekst (standaard ***REDACTED***) en laat de request doorgaan — nuttig wanneer u wilt dat de agent blijft werken aan het niet-gevoelige deel van de content, en wanneer u schone tekst in uw logs wilt. Veel teams gebruiken Mutate op input (zodat het werk doorgaat met het verwijderde secret) en overwegen Validate waar een lek een harde stop moet veroorzaken.
Ze beveiligen alleen de gebruikersinvoer. Secrets lekken ook uit model-output en toolresultaten. Beveilig alle vier de hooks, niet alleen de prompt.
Ze vergeten dat output-guardrails streaming overslaan. Met stream: true draait het scannen van output niet — er is immers geen volledige response om te controleren. Gebruik stream: false waar het redigeren van output van belang is.
Ze vertrouwen erop dat ontwikkelaars voorzichtig zijn. "Plak geen secrets" is geen beheersmaatregel. Het hele punt van een gateway-guardrail is dat deze niet afhankelijk is van het geheugen van individuen.
Ze finetunen niet voor false positives. Strings met een hoge entropie, zoals UUID's of gecodeerde blobs, kunnen detectie activeren. Test op uw echte verkeer en pas aan voordat u harde blokkades afdwingt.
Het is een ingebouwde guardrail, dus er hoeven geen externe sleutels te worden geconfigureerd. Open in de AI Gateway Guardrails, maak een groep aan of kies er een, en voeg de Secrets Detection guardrail toe.
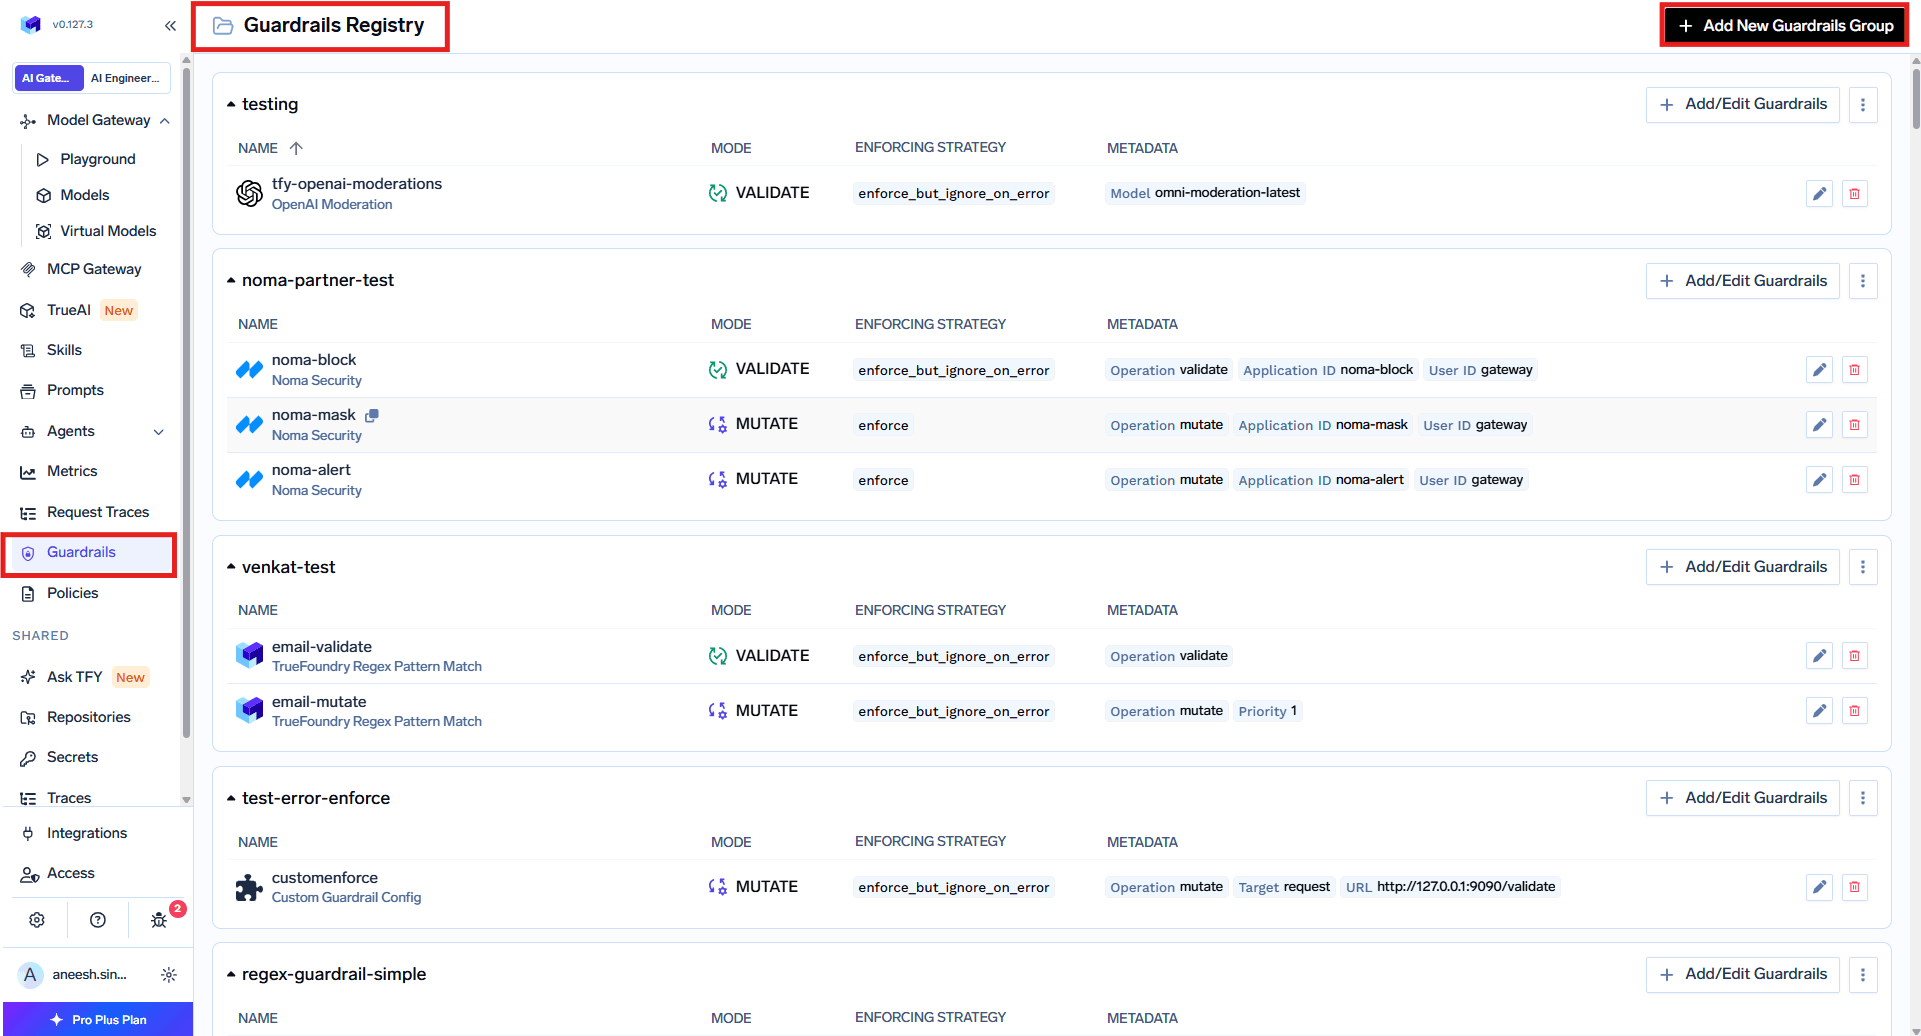
Configureer de naam, de werking (validate of mutate), de handhavingsstrategie en — voor mutate — de redigeertekst. Pas het vervolgens per request toe met de header X-TFY-GUARDRAILS:
Of dwing het organisatiebreed af, inclusief op MCP-tools, met een gateway-policy:
Voor maximale dekking koppelt u het aan alle vier de hooks — input, output, pre-tool en post-tool.
Een engineeringteam draait een coding agent die repositorybestanden kan lezen via een MCP-bestandstool. Een ontwikkelaar vraagt het om "de mislukte databasetest op te lossen". De agent leest config/.env om de verbinding te begrijpen — en dat bestand bevat postgresql://admin:S3cr3tP@ss@db.prod:5432/app.
Zonder guardrail gaat die connection string de context van het model in en naar de provider. Met Secrets Detection op de MCP Post-Tool hook in Mutate-modus komt het toolresultaat terug als postgresql://admin:***REDACTED***@db.prod:5432/app voordat het model het ooit ziet. De agent krijgt nog steeds de structuur die nodig is om over de test te redeneren; de actieve credential verlaat de omgeving nooit. Voeg de LLM Input hook toe en dezelfde bescherming geldt als de ontwikkelaar de string rechtstreeks in de chat plakt.
Secrets belanden op dezelfde manier in prompts als in logs — niet door kwaadwilligheid, maar door alledaags werk op een systeem zonder controlepunt. Een coding agent die een configuratiebestand leest, een ontwikkelaar die een stack trace plakt, een tool die een token retourneert: het is telkens een credential op één stap afstand van een externe provider.
Een secrets-detection guardrail bij de gateway is dat controlepunt. Het scant elke hook, herkent de credentials die er toe doen, en blokkeert of redigeert ze voordat ze uw perimeter verlaten — snel, binnen de gateway en niet afhankelijk van het geheugen van gebruikers. Het is een van de voordeligste guardrails met de hoogste impact die u kunt inschakelen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



A guardrail that scans prompts, responses, and tool traffic for credentials — API keys, AWS keys, JWTs, private keys, database strings — and blocks the request or redacts the secret before it reaches a model provider.
40-plus patterns across cloud credentials, AI/ML API keys, repository and package tokens, communication-platform tokens, payment keys, database connection strings, and private keys — plus contextual detection of high-entropy strings near keywords like token= or secret=.
Minimaal. De Secrets Detection van TrueFoundry draait binnen de gateway zonder externe API-aanroep, dus het is snel en voegt geen kosten per verzoek toe.
Redact (Mutate) when you want work to continue with the secret stripped and clean logs; block (Validate) when a credential in the content must hard-stop the request. Many teams redact on input and block where policy requires.
Ja. Het draait op MCP pre-tool- en post-tool-hooks evenals op LLM-input en -output, zodat geheimen in toolparameters en toolresultaten worden opgevangen - belangrijk voor agents die bestanden lezen en API's aanroepen.
Yes. As a built-in, in-gateway guardrail it runs wherever your TrueFoundry data plane runs, including VPC and on-prem, so secrets never leave your environment.



Het laatste nieuws, artikelen en bronnen in je inbox



















