



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Voice agents waren voorheen simpelweg een pipeline van spraaktranscriptie naar tekst (STT), die werd doorgegeven aan een LLM voor generatie, en vervolgens weer werd omgezet naar spraak (TTS). Drie services, drie stappen en cumulatieve latency bij elke stap.
De Realtime API (OpenAI) en Live API (Google) brengen dat terug tot één geheel. Het model is verbonden via een tot stand gebrachte WebSocket, ontvangt audio-invoer en reageert op dezelfde wijze, waarbij het geheel zelfstandig luistert en spreekt. Dit levert merkbaar betere resultaten op qua lagere latency, wat het gesprek interactiever maakt. Daarom is dit de standaardkeuze voor gesprekken met voice chatbots.
Er zijn nadelen verbonden aan de kosten en de controle over die functionaliteit, en er is het praktische feit dat het introduceren van een API een extra sleutel, een extra endpoint en een extra factuur betekent. Dit zijn allemaal redenen om deze activiteit te laten plaatsvinden achter een gateway.
Geen van beide benaderingen is strikt beter — ze optimaliseren voor verschillende zaken.
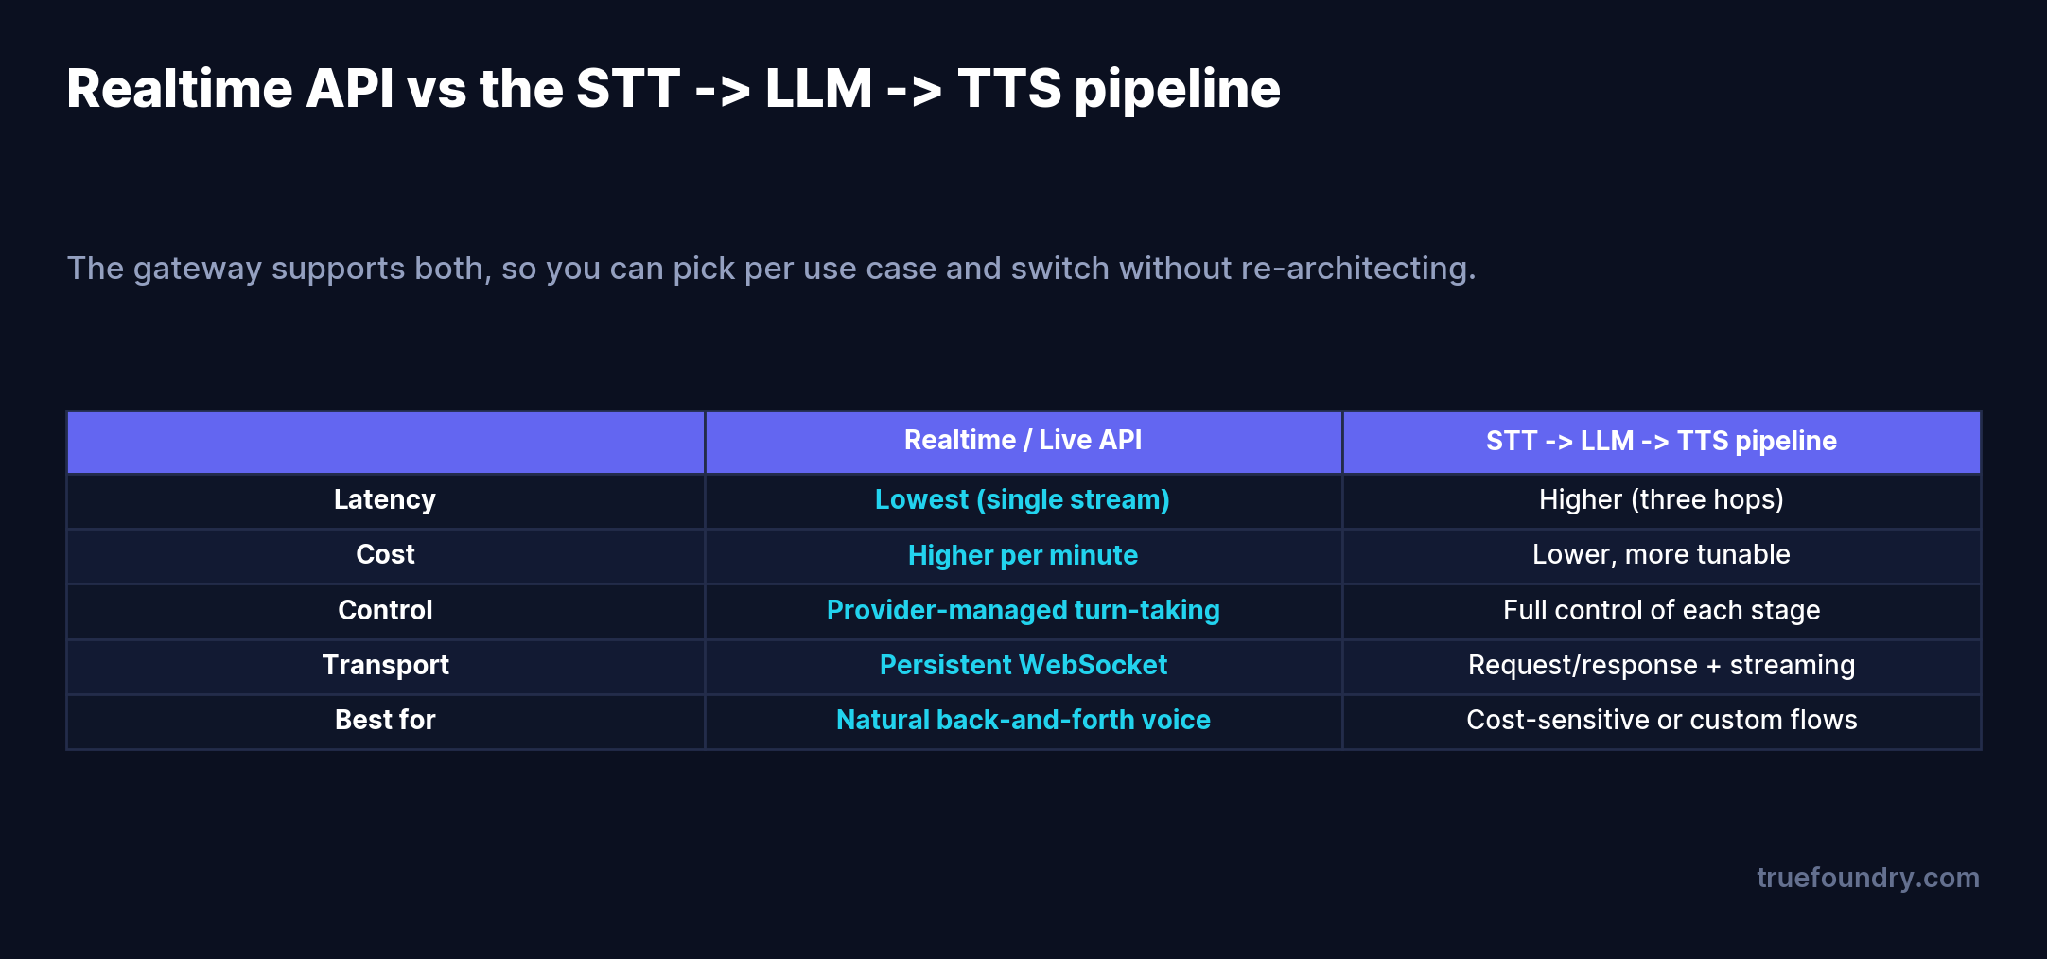
De Realtime / Live API wint het op het gebied van latency en natuurlijkheid omdat er sprake is van een enkele stream en de provider het bepalen van de spreekbeurt afhandelt. De pipeline (de aanpak die we hebben besproken in onze Deepgram-post) wint het op het gebied van kosten en controle: u kiest het STT-model, het LLM en de TTS-stem onafhankelijk van elkaar, stemt elk onderdeel af en kunt ze afzonderlijk vervangen. Een veelvoorkomend patroon is om Realtime te gebruiken voor de hoogwaardige, latency-gevoelige ervaring en de pipeline voor kostengevoelige of sterk aangepaste flows — en omdat de gateway beide ondersteunt, is dat een routingbeslissing, geen herontwerp van de architectuur.
Realtime voice wordt geprijsd in audio-tokens, en de twee leidende providers lopen ver uiteen.
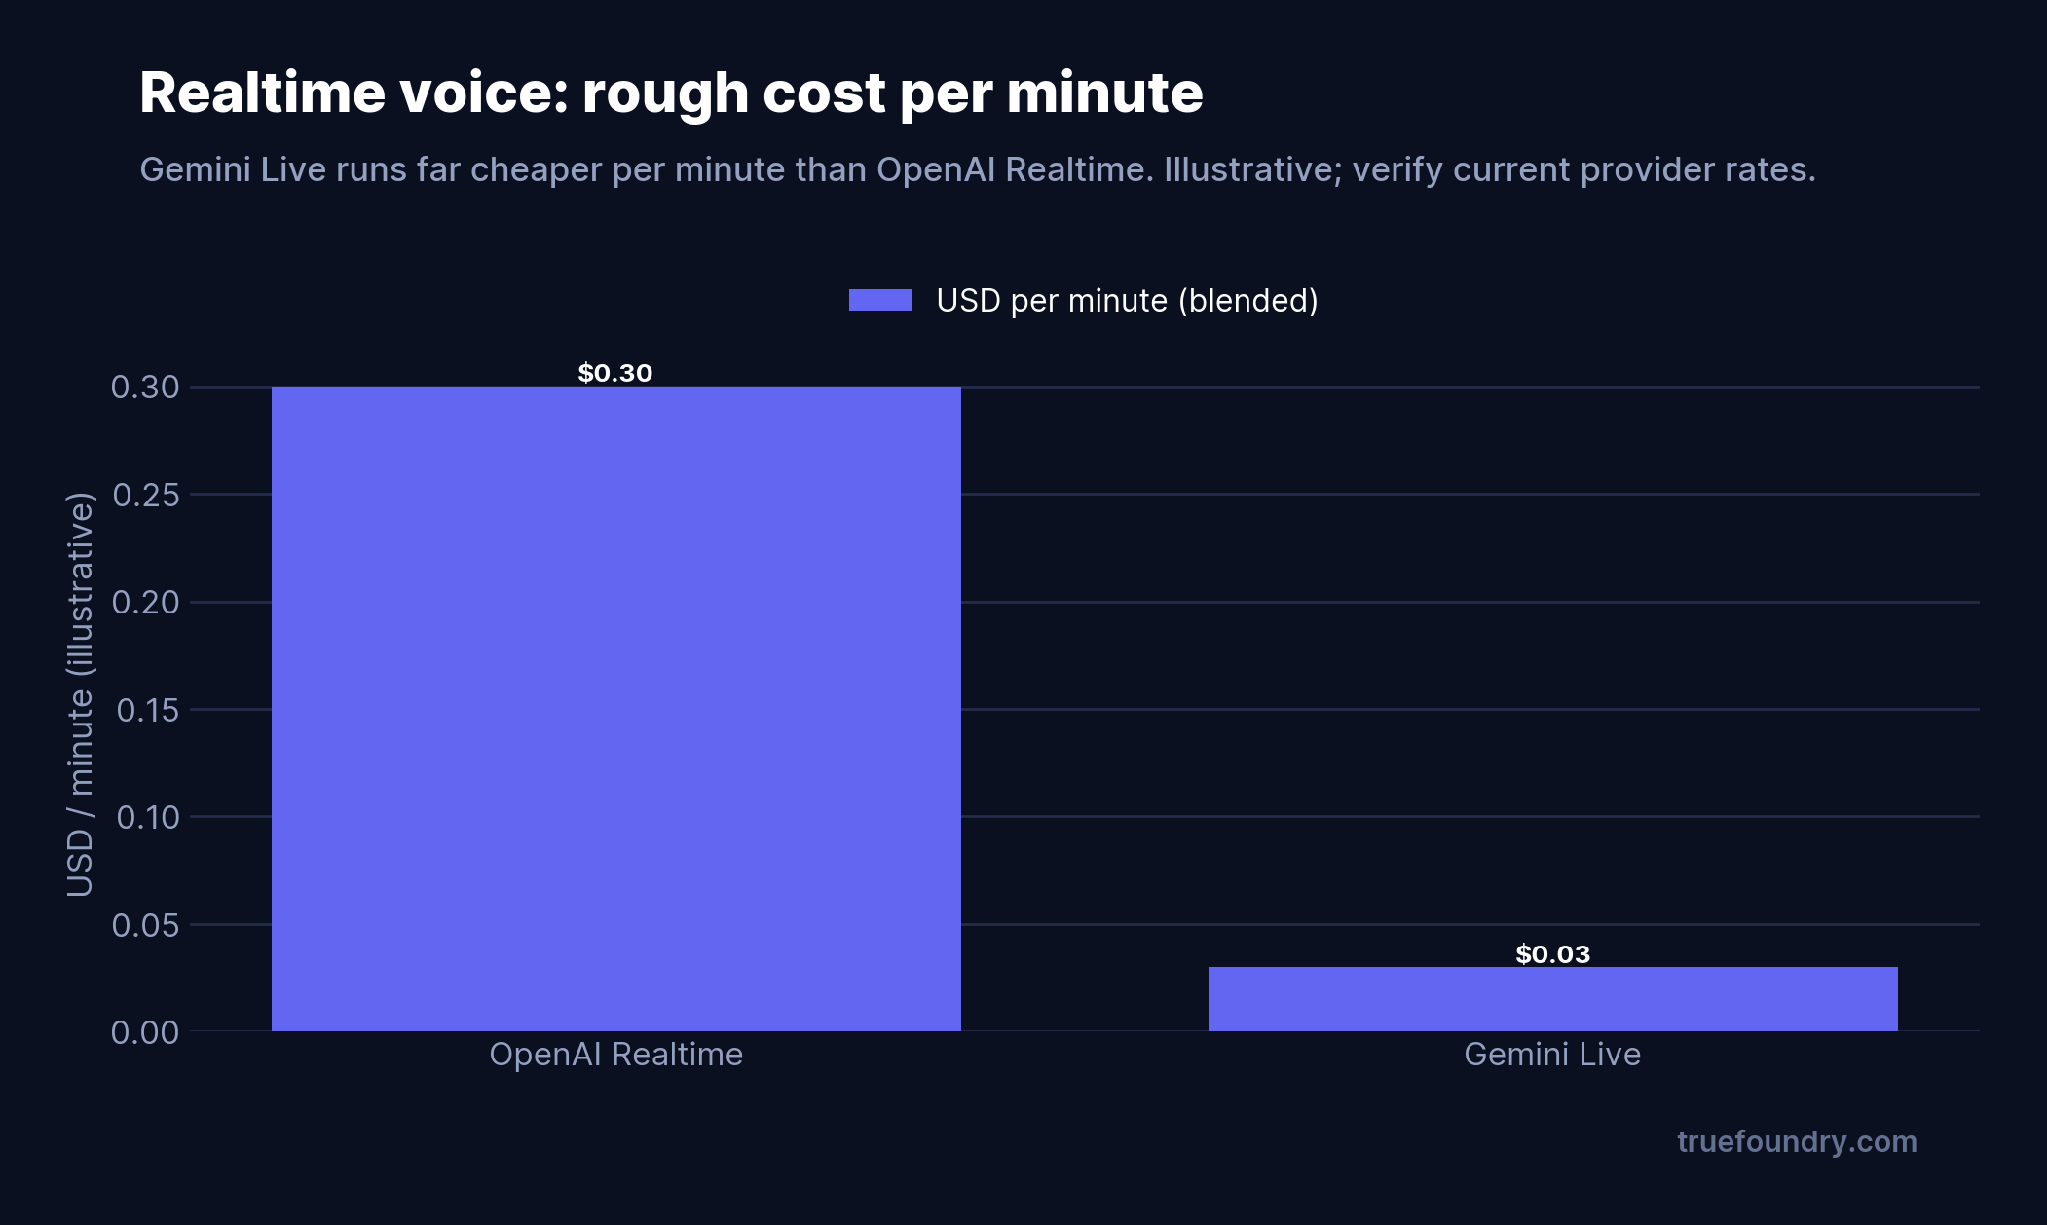
Tegen de huidige tarieven kost de Realtime API van OpenAI ongeveer $ 0,30 per minuut aan actief gesprek, terwijl Gemini Live van Google ruwweg $ 0,03 per minuut is — een verschil van ongeveer 10× [VERIFIEER huidige tarieven op de prijzpagina's van OpenAI en Google; cijfers zijn samengestelde schattingen per minuut]. Beide brengen kosten in rekening per token, en cruciaal is dat beide de groeiende context bij elke beurt opnieuw factureren, waardoor een lang gesprek naverloop van tijd meer per minuut kost, niet minder. Voor een telefoon-agent die duizenden minuten per dag afhandelt, bepalen de providerkeuze en de verdeling van de gespreksduur het grootste deel van de factuur — wat precies het soort ding is dat u per gesprek wilt laten meten bij de gateway in plaats van dit achteraf op een factuur te ontdekken.
De gateway fungeert als proxy voor de WebSocket-verbinding met de provider met behulp van de native SDK van elke provider, zodat u het echte Realtime/Live-protocol krijgt met een governancelaag eromheen.
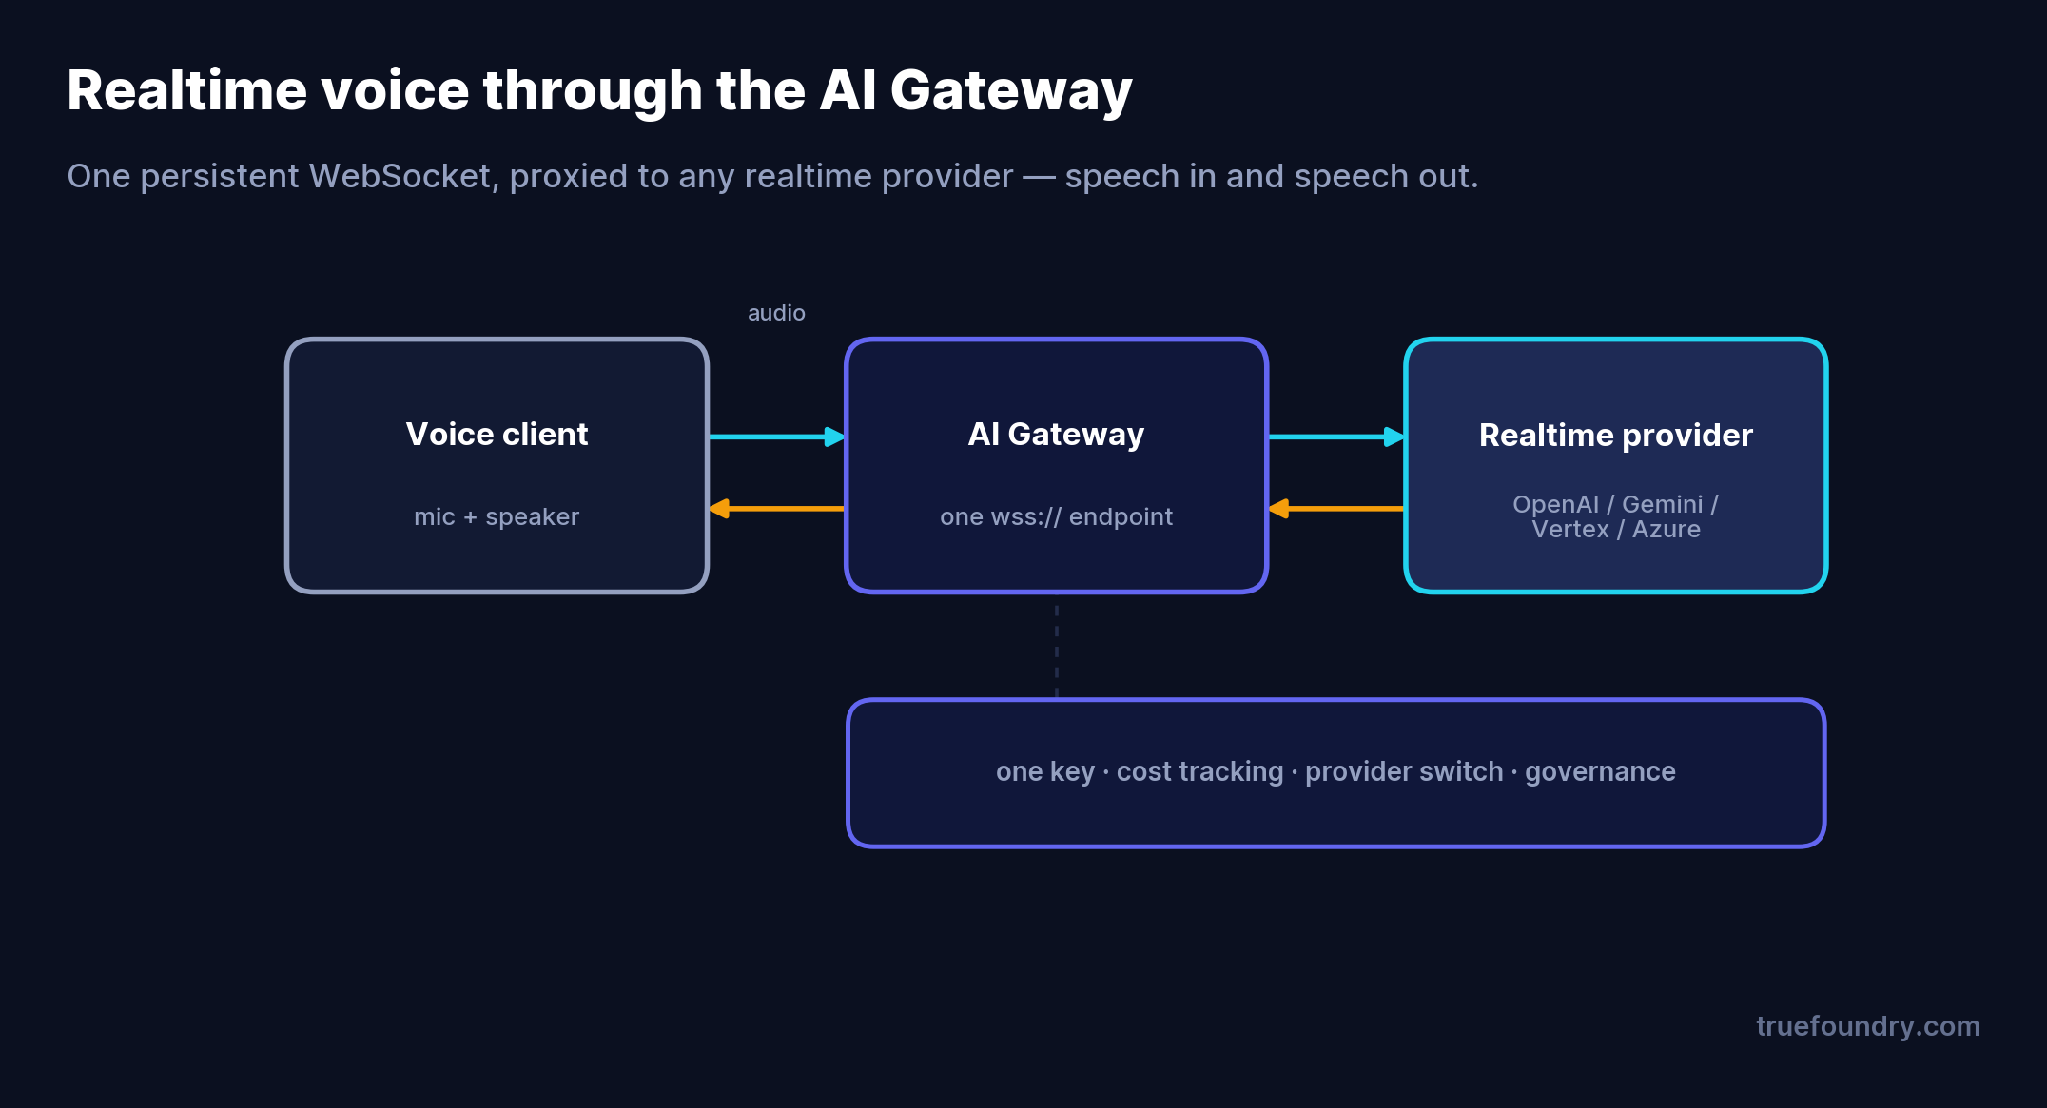
Uw client verbinding maakt via één wss://-verbinding met de gateway; de gateway beheert de provider-sleutel en stuurt de bidirectionele audiostream door. Dat geeft u één endpoint en één sleutel over meerdere providers, kostenoverzicht voor realtime sessies naast uw overige LLM-uitgaven, en de mogelijkheid om van provider te wisselen — bijvoorbeeld van OpenAI naar Gemini wanneer de kostenberekening verandert — zonder uw client opnieuw naar een nieuwe leverancier te hoeven verwijzen.
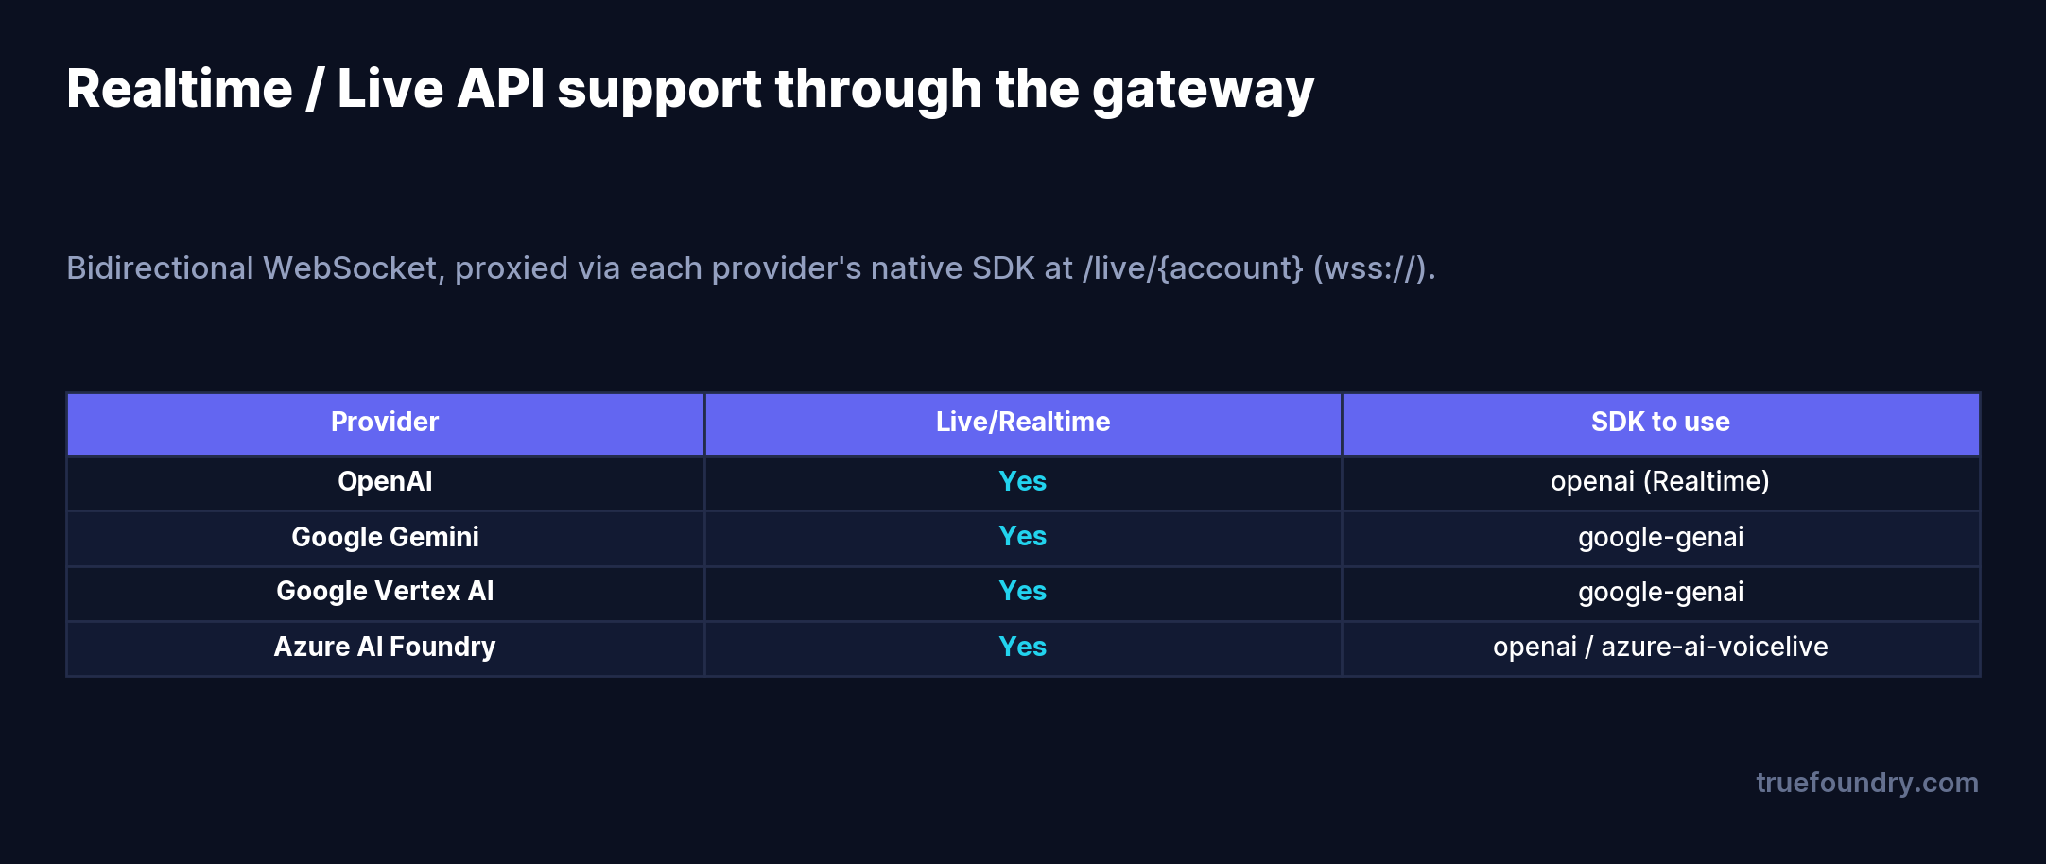
Vier providers worden vandaag de dag ondersteund — OpenAI, Google Gemini, Google Vertex AI en Azure AI Foundry — elk via hun native SDK (openai, google-genai of azure-ai-voicelive) gericht op de WebSocket-URL van de gateway.
Ze gaan ervan uit dat Realtime altijd de oplossing is. Voor kostengevoelige of sterk aangepaste flows is de STT → LLM → TTS-pipeline goedkoper en beter beheersbaar. Stem de aanpak af op de use case.
Ze negeren herfacturering per beurt. Realtime-context wordt bij elke beurt opnieuw in rekening gebracht, waardoor lange gesprekken slechter schalen dan u zou verwachten. Bereken de modelkosten op basis van realistische gespreksduren.
Ze leggen zich in de client vast op de SDK van één provider. Het hardcoden van de endpoint van OpenAI in de app betekent dat overstappen naar Gemini een volledige herschrijving vereist. Richt de SDK op de gateway en overstappen is slechts een configuratie-aanpassing.
Ze laten realtime-uitgaven ongemonitord. Facturering op basis van audio-tokens verschijnt niet in token-dashboards die zijn gebouwd voor tekst. Meet dit bij de gateway.
Voeg uw realtime-model toe aan een model-account met het modeltype Realtime en maak vervolgens verbinding via WebSocket. Het model-ID in de code moet overeenkomen met de weergavenaam van het model in uw account. Voor het native Live API-pad maakt u verbinding met
U behoudt het volledige Realtime/Live-eventmodel van OpenAI of Google — session.update, conversation.item.create, response.create, streaming deltas en tool calling — omdat de gateway het native protocol doorsluist. Voor telefonie ondersteunt de gateway ook WebRTC en LiveKit.
Een bedrijf lanceert een voice agent voor telefonische ondersteuning op OpenAI Realtime vanwege de natuurlijke beurtwisseling. Drie maanden later is het gespreksvolume gestegen en is de Realtime-factuur de grootste enkele post in hun AI-uitgaven. Ze willen Gemini Live, dat ruwweg 10× goedkoper is per minuut, testen op een deel van het verkeer.
Omdat de agent verbinding maakt via de gateway, is de test slechts een routingwijziging: stuur een percentage van de sessies naar het Gemini-account, houd de rest op OpenAI, me vergelijk kwaliteit en kosten zij aan zij in de metrieken van de gateway — met dezelfde clientcode en hetzelfde wss://-endpoint. Als Gemini goed presteert bij hun gesprekken, verplaatsen ze meer verkeer; zo niet, dan rollen ze direct terug. Zonder de gateway zou dat experiment betekenen dat er een tweede provider-SDK in de client geïntegreerd moet worden en dat er een app-update naar elke beller uitgerold moet worden.
De Realtime en Live API's vormen de snelste weg naar een natuurlijke voice agent — één WebSocket, spraak in en spraak uit, en de beurtwisseling wordt voor u afgehandeld. Het addertje onder het gras zit in de kosten en lock-in: facturering op basis van audio-tokens die meegroeit met de gespreksduur, en een SDK per provider die eenvoudig rechtstreeks in uw client wordt geïntegreerd.
Het uitvoeren van realtime voice via de TrueFoundry AI Gateway behoudt het native protocol en de volledige functionaliteit, terwijl de laag wordt toegevoegd die productie vereist: één endpoint en sleutel over verschillende providers, kosten bijgehouden per sessie, en het wisselen van provider als een configuratiewijziging. Bouw de voice-ervaring die u wilt, en houd de economische aspecten en governance onder controle.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Een bidirectionele, low-latency streaming-API over WebSocket waarbij een model direct audio ontvangt en produceert - speech-to-speech - in plaats van via aparte transcriptie- en text-to-speech-stappen. OpenAI noemt het de Realtime API; Google noemt het de Live API.
De Realtime API is één enkele stream met lagere latentie en door de provider beheerde beurtwisseling, maar kost meer per minuut. De pijplijn gebruikt drie aparte diensten, wat goedkoper en beter afstembaar is, maar latentie toevoegt. De gateway ondersteunt beide.
Dit wordt geprijsd in audiotokens. OpenAI Realtime kost tegen de huidige tarieven ongeveer $0,30 per minuut en Gemini Live ongeveer $0,03 per minuut, en beide factureren context opnieuw bij elke beurt. Verifieer de actuele cijfers op de prijspagina's van de providers.
OpenAI, Google Gemini, Google Vertex AI, en Azure AI Foundry, elk via zijn native SDK gericht op de WebSocket-URL van de gateway.
Ja. Omdat de client verbinding maakt met de gateway in plaats van rechtstreeks met een provider, is overstappen van OpenAI Realtime naar Gemini Live een configuratiewijziging, en u kunt verkeer splitsen om ze te vergelijken.
Ja. Het data plane van TrueFoundry draait in uw VPC of on-prem, zodat de prompts en optimalisatiedata van DSPy binnen uw omgeving blijven.



Het laatste nieuws, artikelen en bronnen in je inbox

















