


november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Bifrost AI — de open-source Bifrost LLM gateway van Maxim AI — staat in 2026 op vrijwel elke short-list voor AI gateway, meestal vergezeld van het woord snelste. Die claim blijft niet overeind bij een kritische blik op de eigen cijfers van de leverancier, dus hebben we het op de harde manier gecontroleerd: we hebben zelf een benchmark uitgevoerd op een afgeschermde 1 vCPU-omgeving.
Dit artikel behandelt in hoeverre de prestatieclaims van Bifrost standhouden onder echte metingen — op een vastgestelde 1 vCPU / 2 GB-testopstelling, dezelfde standaard die we hanteren voor elke gateway die we benchmarken.
Dit is het gedeelte waar elke claim van "snelste gateway" zich tegen moet verantwoorden.
Het cijfer van de leverancier: ~5.000 RPS bij ~11 microseconden gemiddelde overhead — op een t3.xlarge (4 vCPU), tegen een gemockte upstream. Voordat je dat met wat dan ook vergelijkt, lees wat het daadwerkelijk meet. Volgens de eigen bron van Bifrost is het microsecondencijfer gemeten zonder HTTP-requestafhandeling en JSON-marshalling — het is dus tijd die binnen de interne pipeline van de gateway wordt doorgebracht, niet de netto toegevoegde latentie voor een request van de aanroeper. Dezelfde bron geeft 59 µs aan op een t3.medium, dus op een kleinere machine verslechtert het al ongeveer 5x. Het is ook een gemiddelde, geen percentiel, op 4x de rekenkracht die de meeste teams daadwerkelijk aan een gateway-container toewijzen.
Niets daarvan maakt het cijfer misleidend; het beantwoordt gewoon een andere vraag dan "hoe ziet mijn p99 eruit?" Alles hieronder betreft dat andere cijfer: end-to-end toegevoegde latentie voor echte, gedocumenteerde payloadgroottes, inclusief marshalling en HTTP — de volledige vertraging die een aanroeper ondervindt doordat de gateway zich in het pad bevindt. Microseconden en milliseconden zijn hier allebei waar, omdat ze verschillende dingen meten.
We hebben een vaste testopstelling gebouwd — 1 vCPU, 2 GB RAM, open-loop belasting — en Bifrost rechtstreeks gemeten over drie payloadgroottes: klein (200 input / 100 output tokens), middelgroot (2.000/500) en groot (20.000/1.000). De gemockte upstream achter Bifrost stond ook vast, dus elke vertraging is toe te schrijven aan Bifrost en niet aan een onbetrouwbare test-double: 50 ms "denktijd" + 50 ms tot de eerste token voor niet-streaming calls, en een vaste streamingduur van 500 ms voor streaming calls — dat zijn de ondergrenzen van ~55 ms en ~555–627 ms die je in de onderstaande grafieken ziet, aanwezig bij elke payloadgrootte.
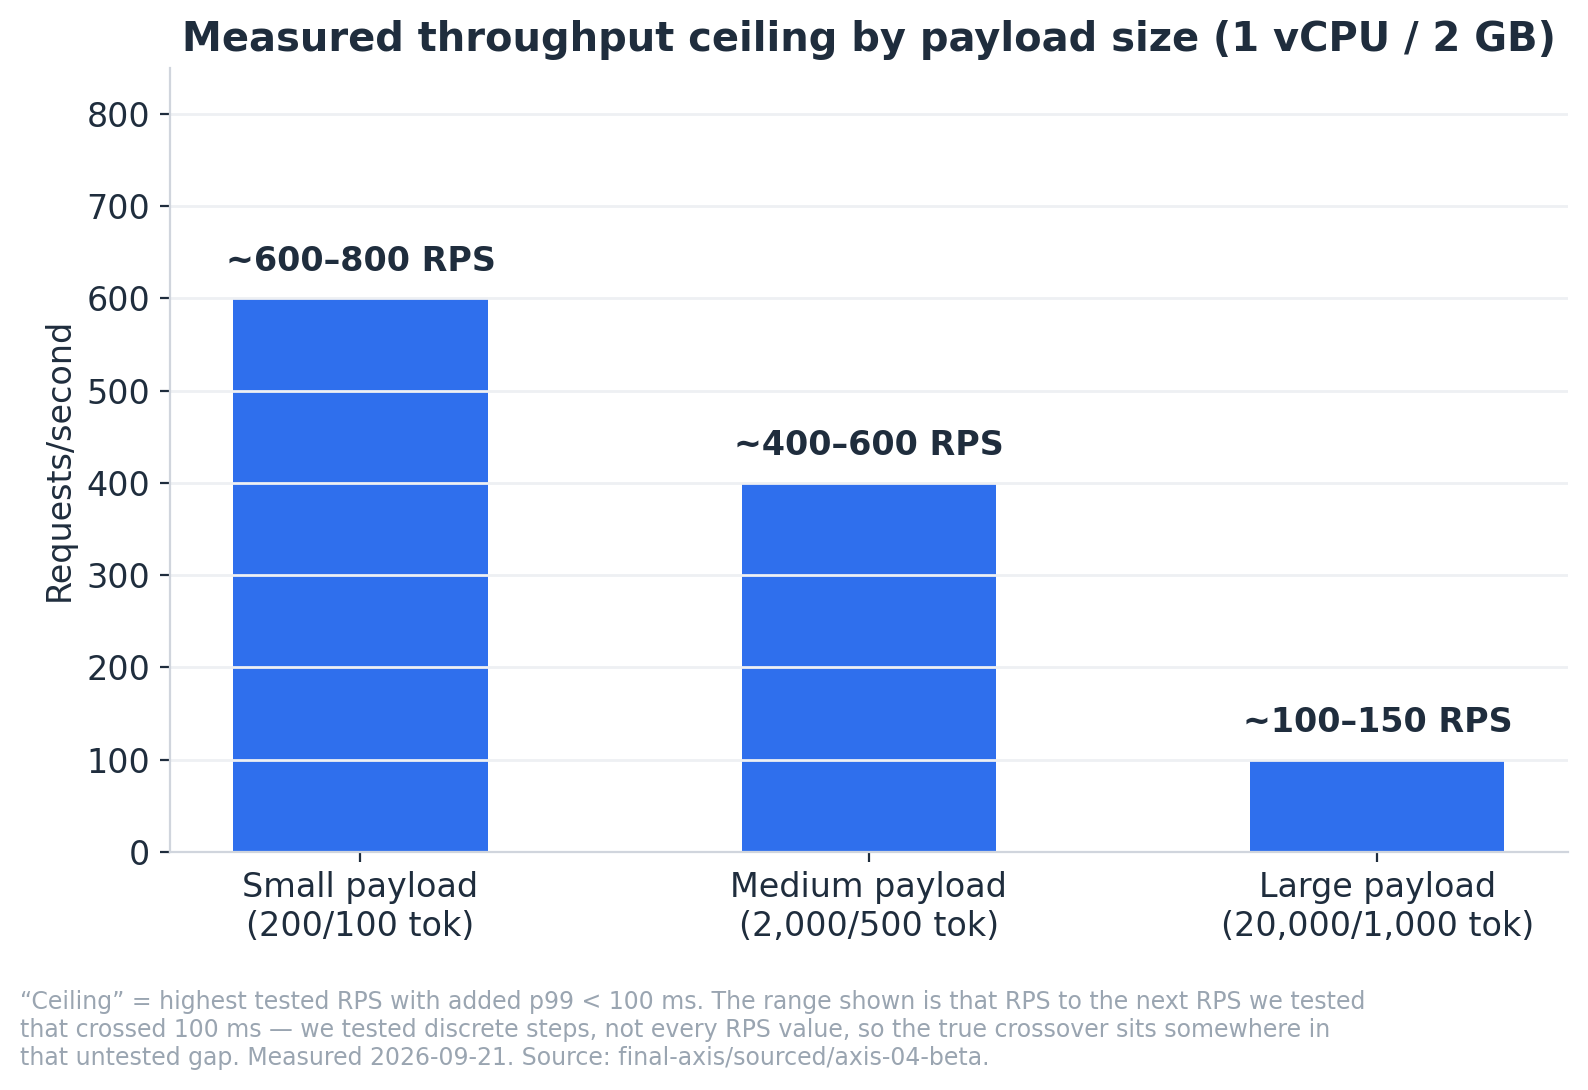
Echte doorvoerlimieten, bij een budget van 100 ms toegevoegde latentie: ~600–800 RPS voor kleine payloads, ~400–600 voor middelgrote, ~100–150 voor grote. Elk bereik loopt van de laatste RPS-stap waarvan we hebben bevestigd dat deze binnen het budget viel tot de volgende waarvan we vaststelden dat dit niet zo was. Onder die limieten betaalt de mediane request 2–6 ms voor de gateway — en verandert nauwelijks bij belasting (2,1 tot 3,1 ms voor klein over een 60x verkeersbereik), wat geruststellend is totdat de gateway bezwijkt. Het cijfer dat verandert is de p99: van +5,6 ms (klein), +7,5 ms (middelgroot) en +15,2 ms (groot) bij 10 RPS naar +60 ms voor klein bij 600 RPS, +75 ms voor middelgroot bij 400, en +41 ms voor groot bij slechts 100 — en overschrijdt vervolgens het budget van 100 ms bij de allervolgende stap in alle drie de gevallen. Elke payload is afgezet tegen zijn eigen directe baseline richting de mock (~55–62 ms, afhankelijk van de grootte):
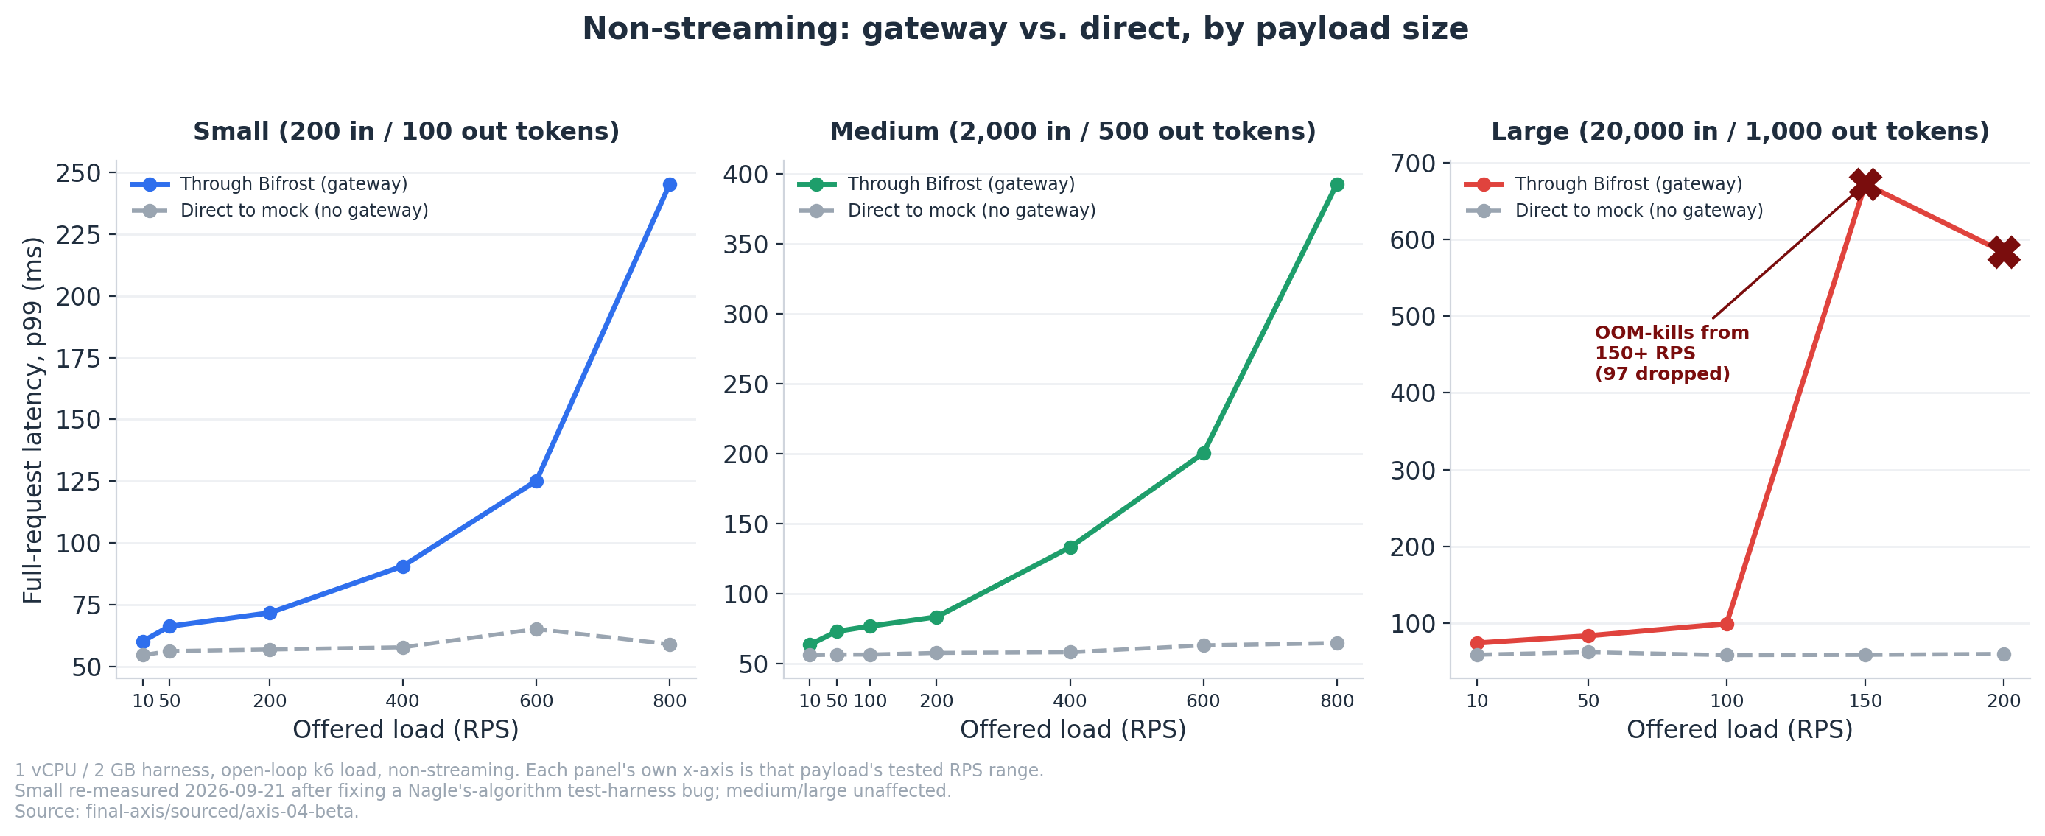
Klein en middelgroot volgen dezelfde vorm — vlak, en vervolgens een stijgende p99-tail. De input van 2.000 tokens bij middelgroot maakt elke request kostbaarder, waardoor de tail eerder begint en het budget sneller wordt overschreden: bij 400–600 RPS vergeleken met 600–800 voor klein. Groot stijgt helemaal niet geleidelijk: het blijft vlak van 10 tot 100 RPS en valt vervolgens steil naar beneden bij 150 RPS, waar de pod halverwege de run OOM-killed wordt (61 mislukte requests bij 150 RPS, nog eens 97 bij 200). Dat is geen queueing-buigpunt zoals bij klein/middelgroot — het is een harde bronnenmuur, en dat uit zich als een bijna verticale sprong in plaats van een curve.
Streaming stuit op dezelfde muur, alleen sneller, omdat elke open stream zijn buffers langer in het geheugen vasthoudt — dezelfde vergelijking, gateway vs. direct, per payload:
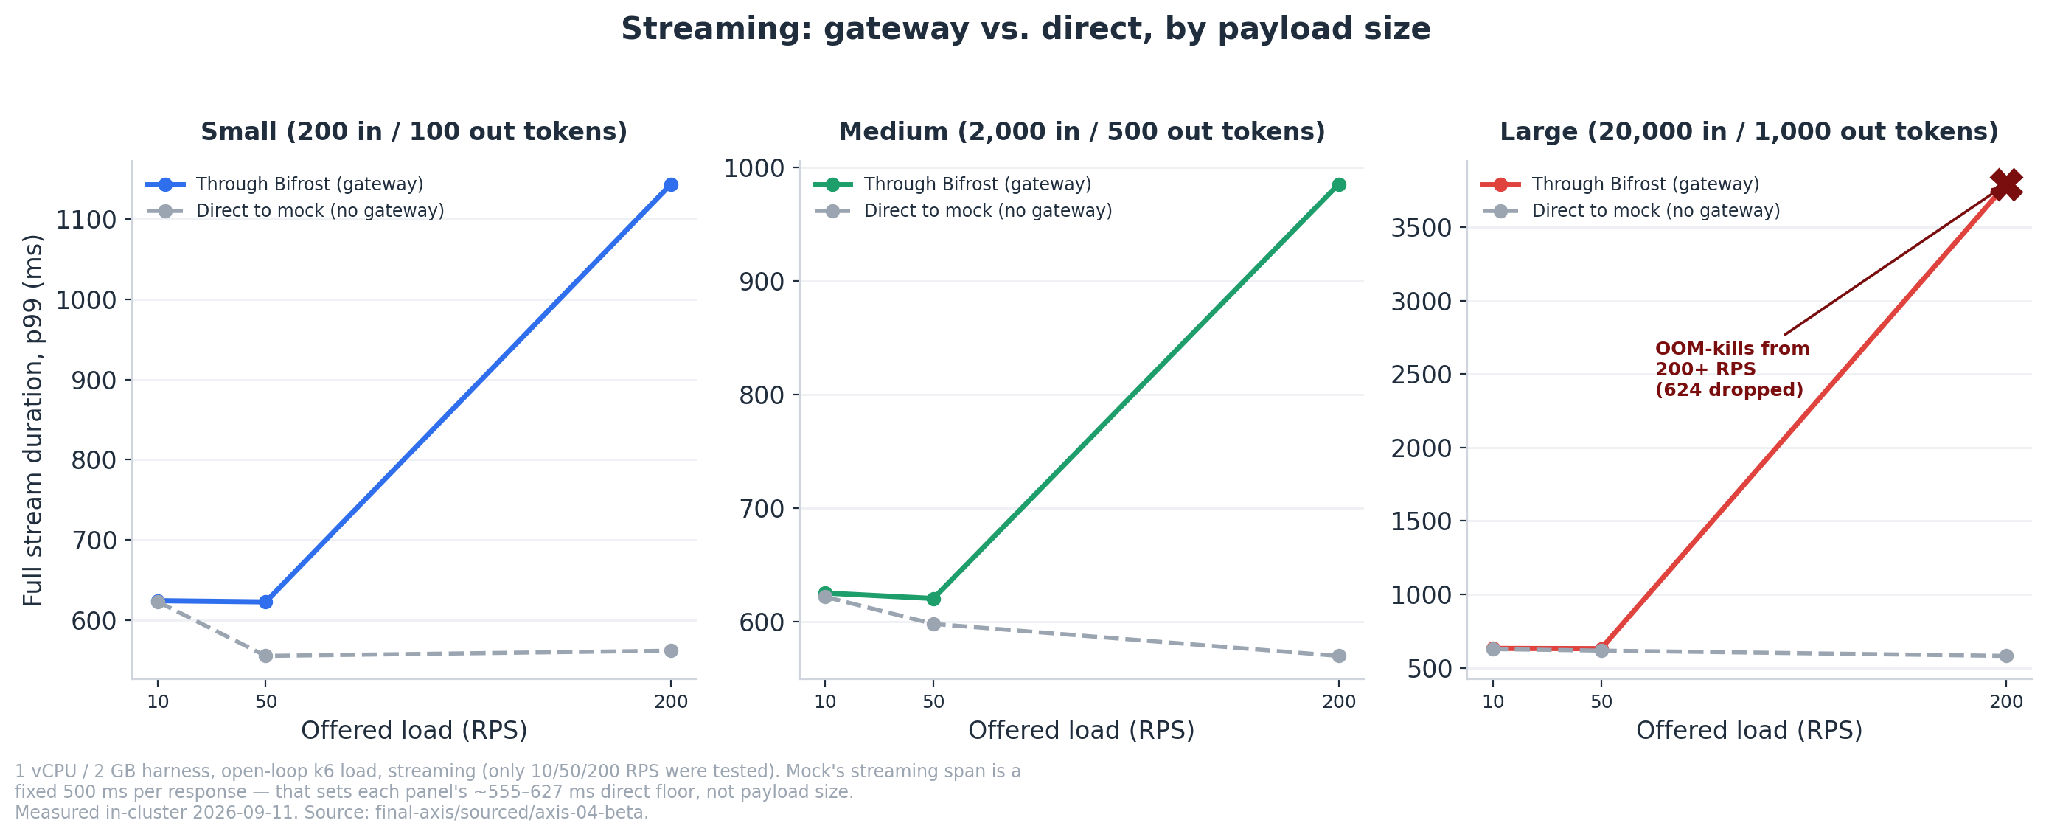
Kleine en middelgrote streaming volgen beide hun eigen ~555–627 ms directe ondergrens nauwkeurig tot 50 RPS, en beginnen dan te stijgen bij 200 RPS (kleine p99 bereikt ~1,14 s, middelgrote ~985 ms — beide veroorzaakt door queueing, niet door OOM). Grote streaming vertoont die geleidelijke stijging evenmin: bij 200 RPS stort de pod halverwege de run in door OOM, waarbij 624 van de 12.001 streams uitvallen en de p99 oploopt tot ~3,8 seconden. Als je workload grote documenten streamt, is 200 RPS op één vCPU geen "tragere" tier — het is een "vastloop"-tier.
De volledige streamduur is echter niet het cijfer dat telt als je UI alleen de eerste token hoeft te tonen — dus hebben we dat afzonderlijk gemeten met een gekoppelde async probe die de echte first-content-token timed, en niet de TTFB van k6 (die hier ongeldig is voor SSE, aangezien de mock headers flush voordat er een token bestaat):
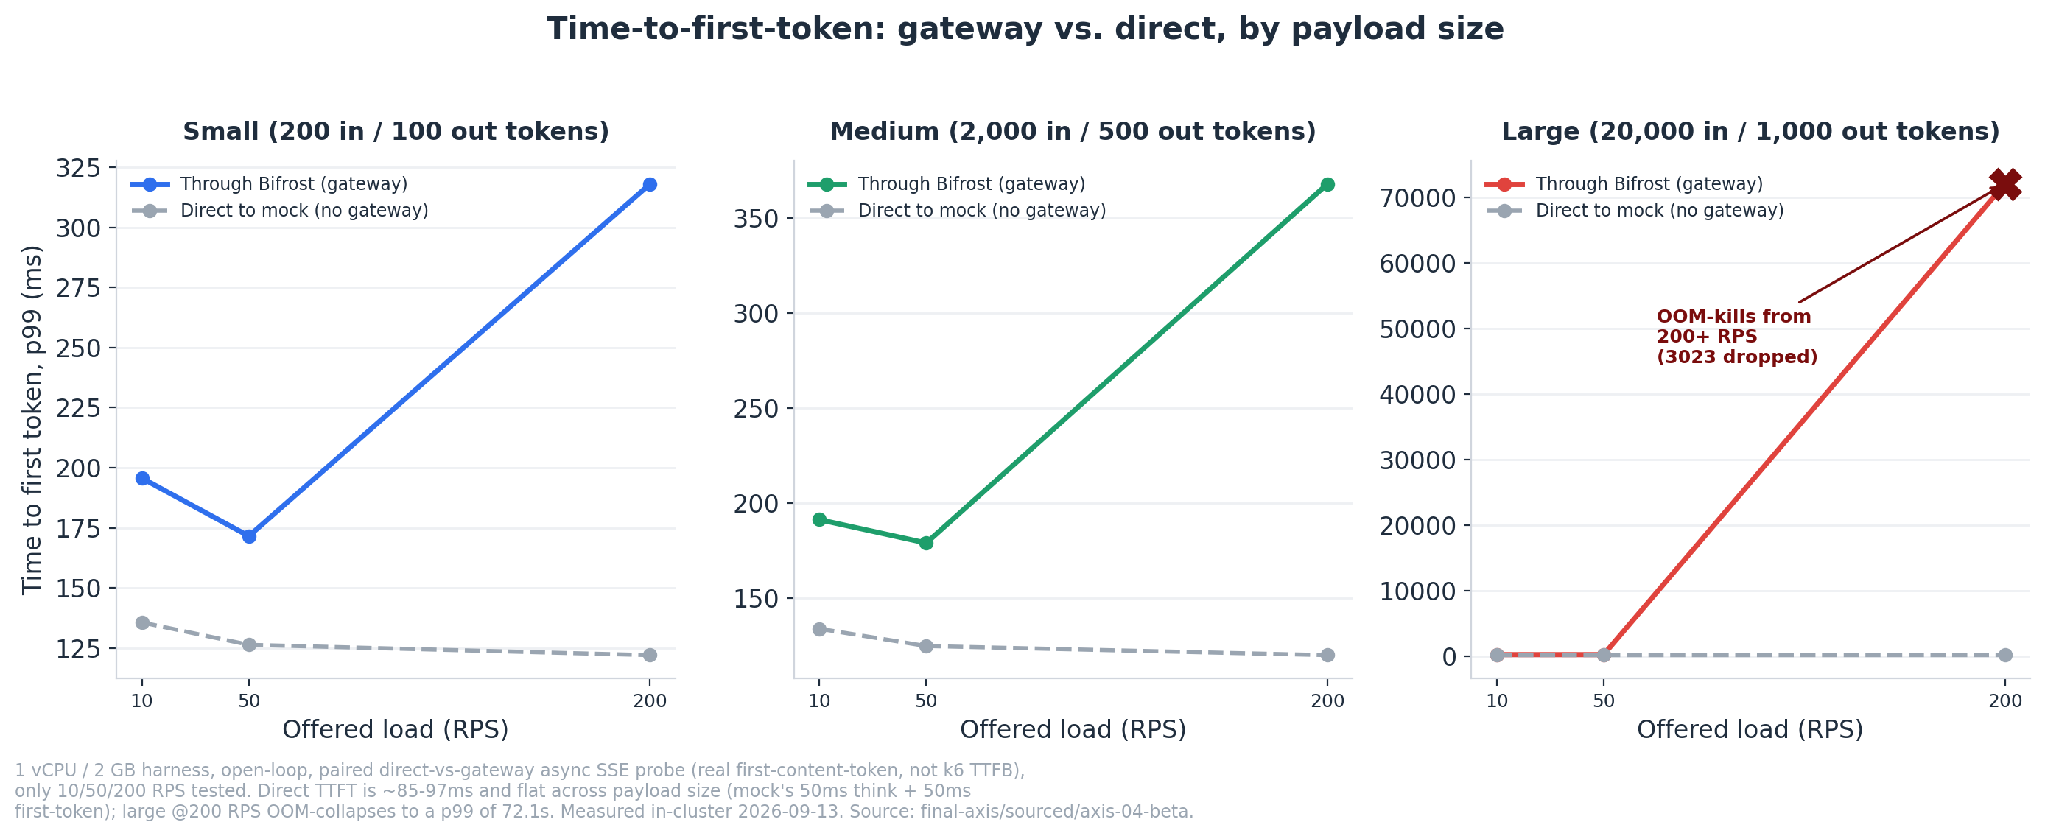
Directe TTFT is ~85–97 ms en vlak over alle drie de payloadgroottes — het bewijs dat inputlengte de tijd tot het eerste token niet verandert, dus alles boven die ondergrens betreft Bifrost's eigen streaming setup-kosten per request. Die extra kosten bedragen ~27–46 ms en zijn onafhankelijk van de grootte bij 10–50 RPS (groot @10 RPS voegt +46 ms toe, klein @10 RPS voegt +43 ms toe — dezelfde orde van grootte, andere payload). Bij 200 RPS blijven de medianen voor klein en middelgroot nog steeds overeind (+57 tot +71 ms), maar de tail loopt enorm op — toegevoegde p99 bereikt +196 tot +248 ms — en 10–13% van de gateway-streams faalt volledig, hetzelfde queueing-buigpunt dat zichtbaar is in de grafiek voor volledige streams hierboven. Groot @200 RPS heeft geen tail-probleem, maar kampt met een totale crash: slechts 128,8 van de 200 aangeboden RPS wordt verwerkt, TTFT p99 stijgt tot 72,1 seconden, en 3.023 van de 12.001 streams falen — de OOM-muur, dit keer bekeken vanuit het eerste-token perspectief in plaats van de volledige respons.
En onder een opzettelijke overbelastingspiek bleven beide modi van Bifrost geheugenveilig: "blocking" bedient uiteindelijk iedereen (traagste request wachtte ~5 seconden), "drop" faalt snel met een schone 503.
Het plafond voor grote payloads heeft een heel andere oorzaak. Het is niet de CPU — en de duidelijkste manier om dat te zien is door geheugen en CPU afzonderlijk te bekijken, uitgesplitst naar payloadgrootte en aangeboden belasting, en niet alleen als één enkel piekcijfer per payload:
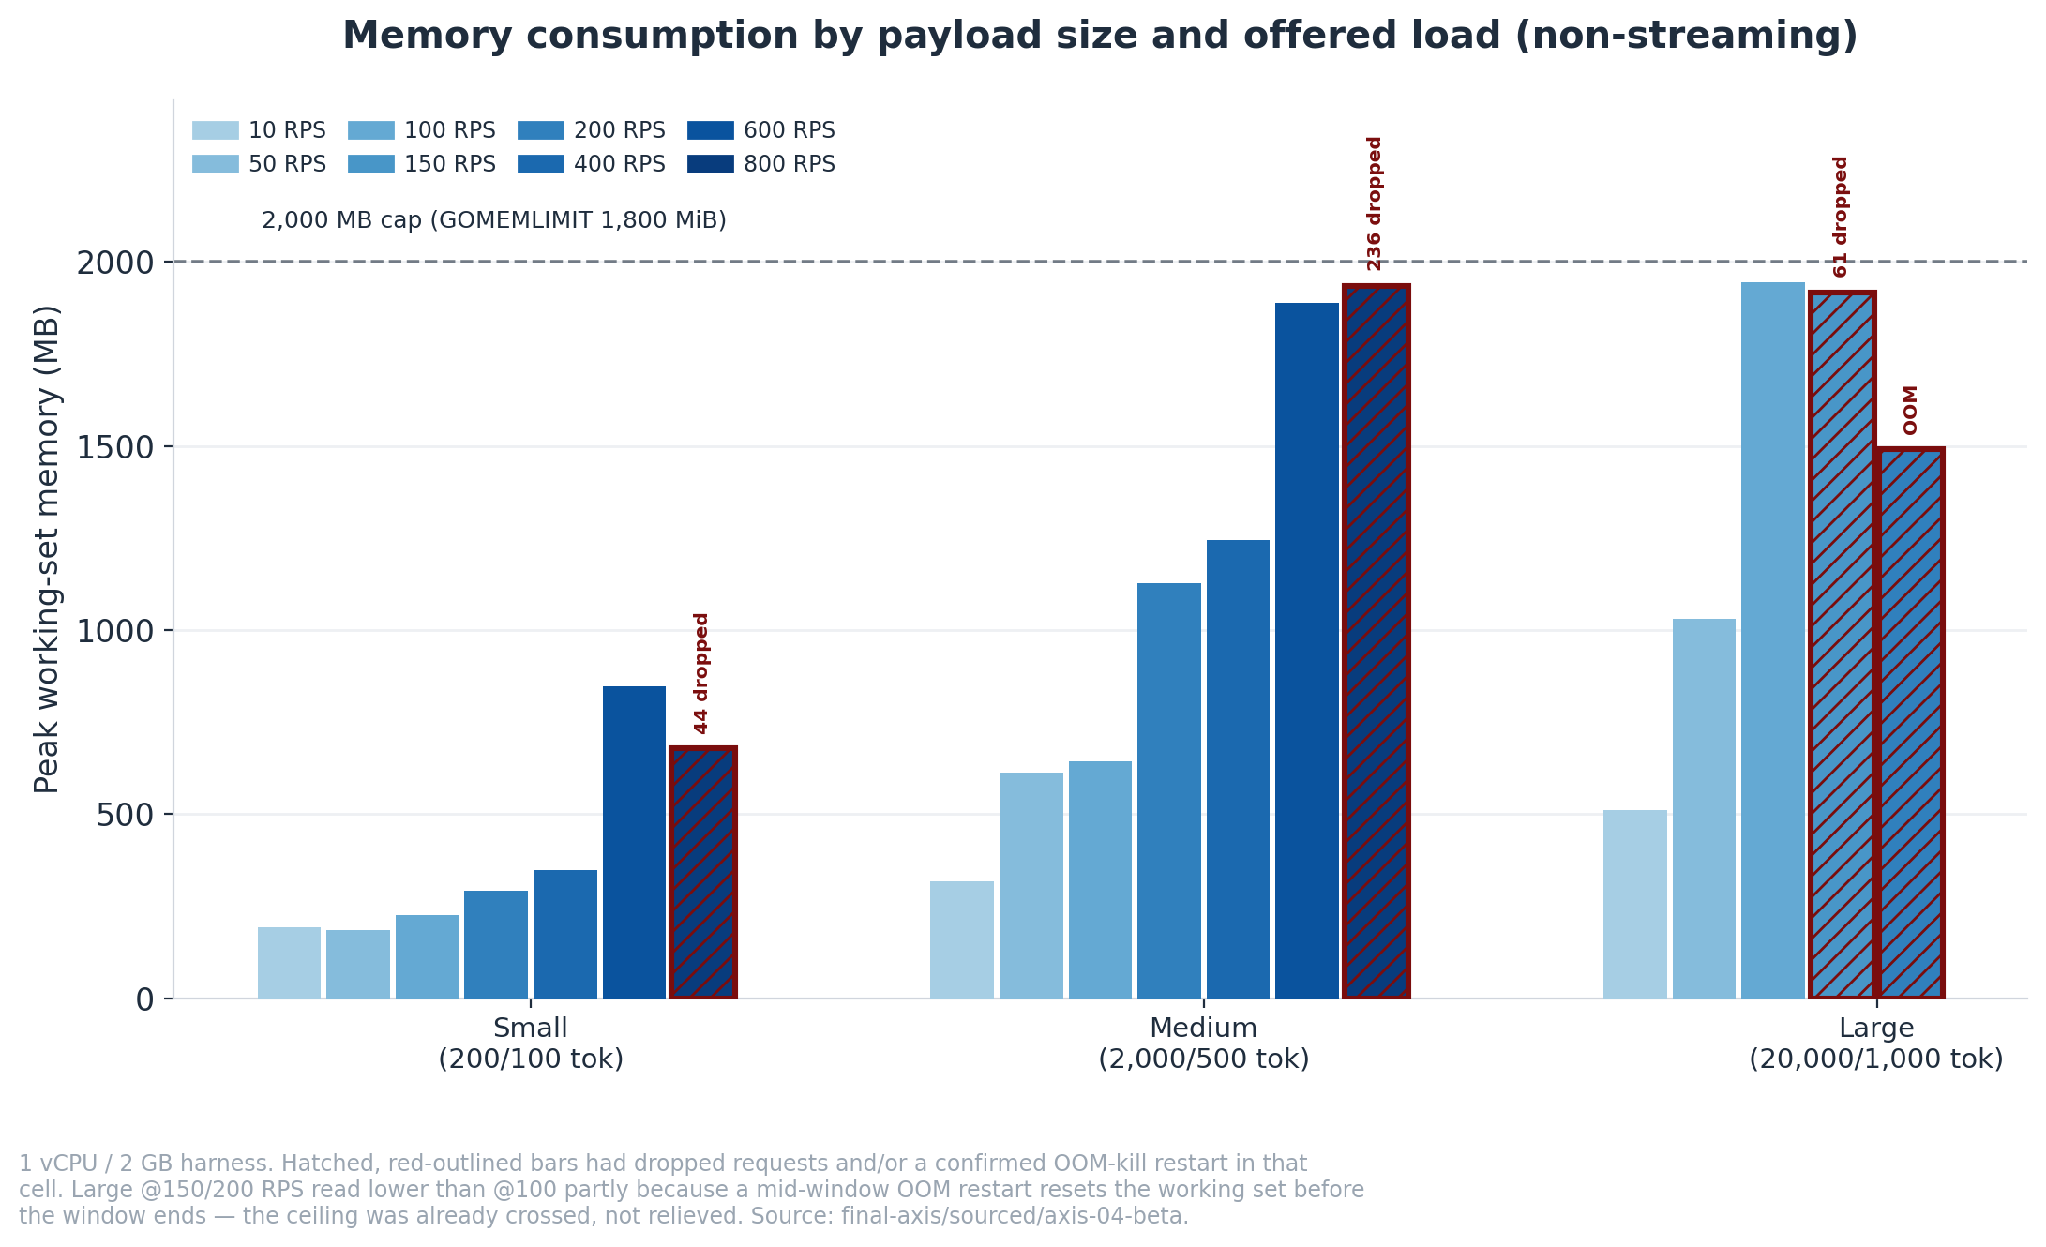
Klein stijgt geleidelijk en blijft ruim onder de 2.000 MB limiet (848 MB bij de hoogst geteste RPS). Middelgroot stijgt veel verder — 1.935 MB, 97% van de limiet, bij de hoogst geteste RPS — dus aan het einde van het bereik staat het geheugen evenals de CPU onder druk. Groot bereikt hetzelfde punt veel sneller: 1.944 MB — 97% van de limiet — bij slechts 100 RPS, de laatste goedgekeurde stap. De volgende stap is waar de OOM-kills beginnen. De rood omkaderde en gearceerde staven (groot @150, @200) geven daadwerkelijk lagere waarden aan dan de 100 RPS-staaf, wat lijkt op herstel maar dat niet is — een OOM-kill halverwege het venster herstart de pod en reset de working-set teller voordat het meetvenster eindigt, waardoor die staven de werkelijke piek onderschatten in plaats van overschatten.
CPU laat het tegenovergestelde beeld zien, en dat is precies het punt:
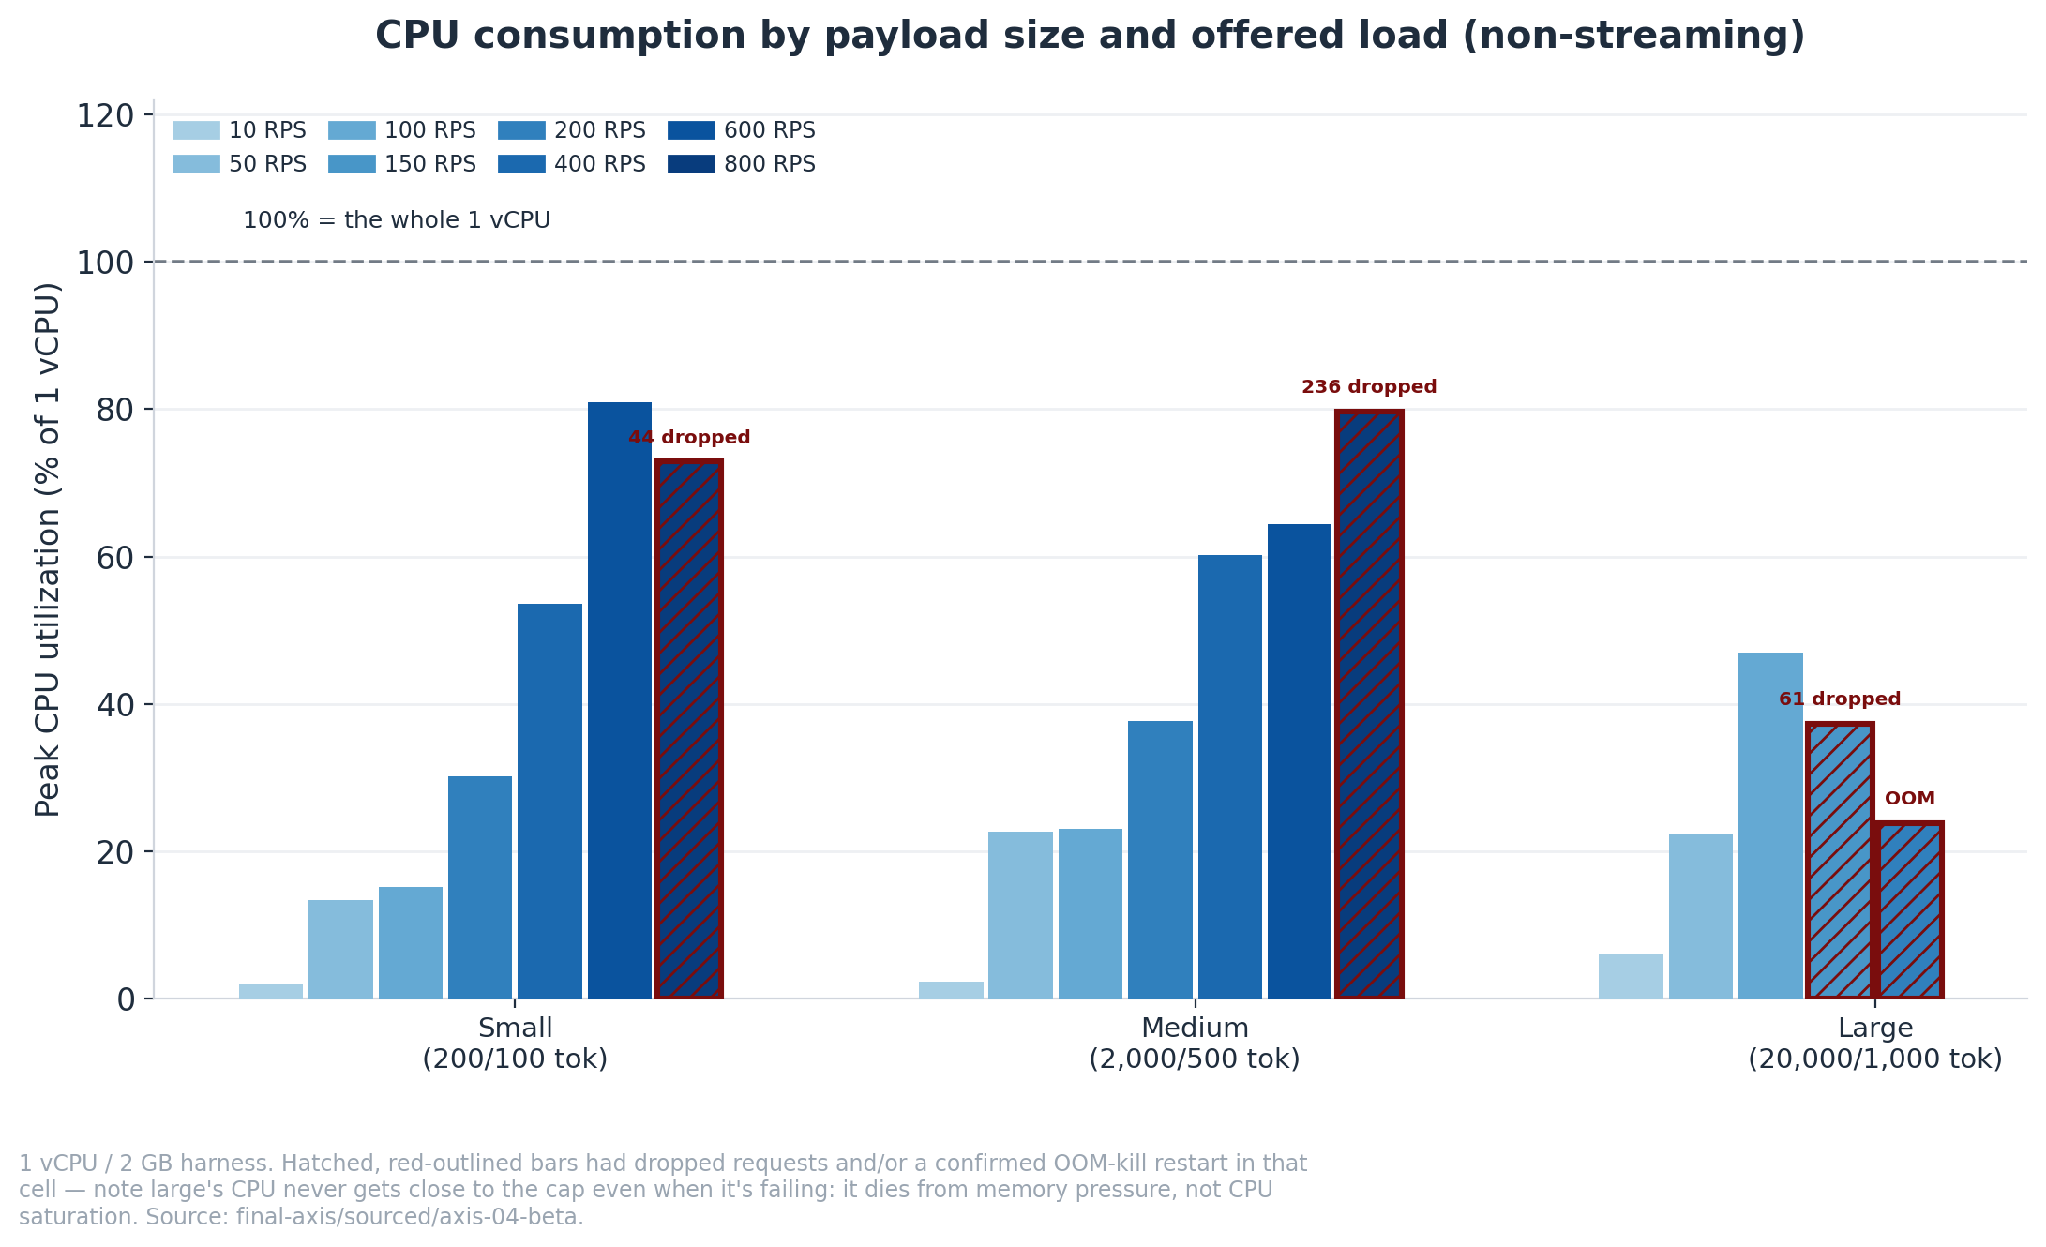
Klein en middelgroot stijgen beide naar het bereik van 73–80% bij hun hoogste RPS — wat de enkele vCPU zwaar belast. Groot doet dat nooit: zelfs in de cellen waarin actief requests worden geweigerd en OOM-kills optreden (rood omkaderd en gearceerd), piekt het CPU-gebruik op hoogstens 37% en 24%. Groot faalt niet omdat de CPU geen capaciteit meer had — het faalt omdat het geheugen volliep, terwijl de CPU nog overcapaciteit had. Als je workload uit lange documenten bestaat, is dat het cijfer om rekening mee te houden, niet het aantal vCPU's.
Een exact-match hit verandert een call van ~59 ms in ~4 ms. Semantische caching — het opvangen van een anders geformuleerde herhaling van dezelfde vraag — brengt een echte embedding-vertraging met zich mee, maar is nog steeds twee keer zo snel als een nieuwe call:
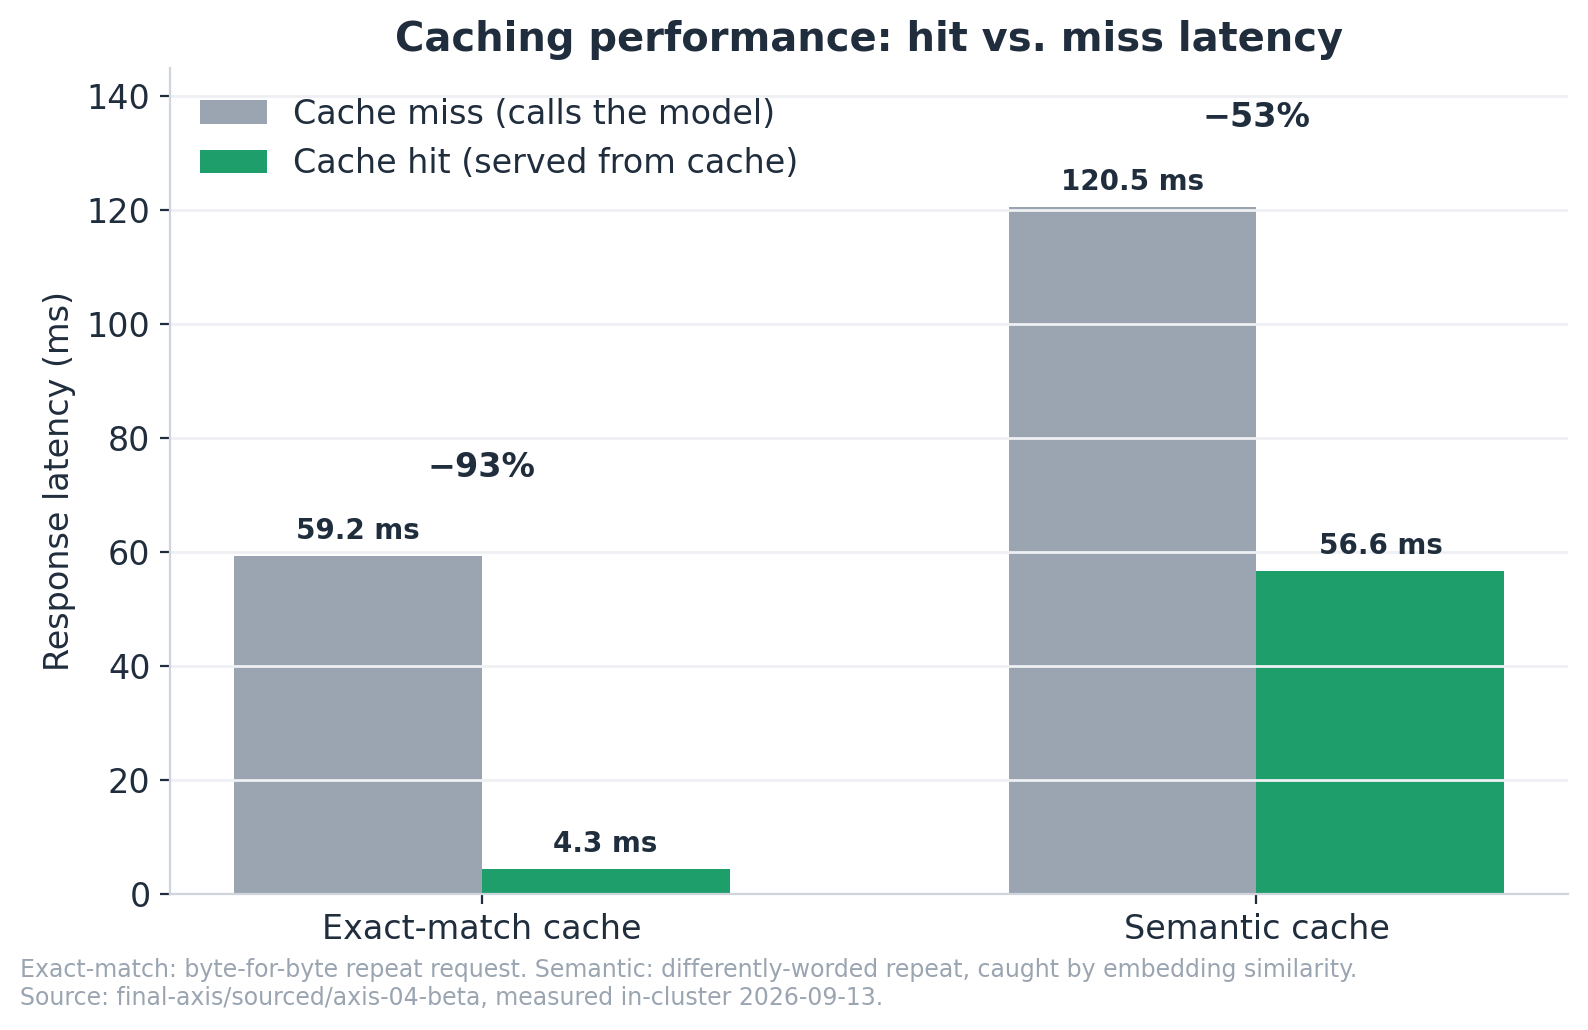
Geen van beide resultaten is op zichzelf verrassend — caching hoort sneller te zijn dan het aanroepen van het model, en dat is het ook. De cijfers hier zijn simpelweg de praktische meting van hoeveel sneller het precies is: 93% voor een exact-match hit, 53% voor een semantische hit zodra de embedding-kosten zijn betaald.
Nog twee cijfers voordat we verdergaan: de koude start duurt mediaan 8,7 seconden, waarvan 8,2 seconden opgaan aan het verplicht opnieuw downloaden van de catalogus bij elke herstart in een typische containeromgeving — dit is op te lossen met permanente opslag, maar hier niet afzonderlijk opnieuw getest.
Een opmerking over transparantie met betrekking tot de bovenstaande cijfers: specifiek bij de cel met kleine payloads ontdekten en verhielpen we een bug in onze eigen testopstelling (een netwerkinteractie door het Nagle-algoritme die onze baseline onrustig maakte) — na het verhelpen daarvan schoof het plafond voor kleine payloads bij Bifrost daadwerkelijk omhoog, van ~400 naar ~600–800 RPS. We vermelden dit omdat het het soort detail is dat je snel over het hoofd ziet bij het benchmarken van elke gateway, inclusief Bifrost, en we liever openheid van zaken geven dan de correctie verbloemen.
Op een enkele machine is de overhead van Bifrost AI op de mediaan echt laag: 2–6 ms bovenop een upstream call van ~55 ms, vrijwel gelijk over verschillende payloadgroottes en belastingniveaus. Dat is de verdedigbare variant van de claim "snelste gateway", en dat heeft waarde — als aandeel van een echte LLM-call valt het weg in de ruis. De tail vertoont een ander beeld. Toegevoegde p99 is gevoelig voor belasting en bereikt +41 tot +75 ms bij de limieten die we hebben gemeten, en grote payloads worden niet zozeer geleidelijk trager, maar stoppen er simpelweg mee: OOM-killed bij 150 RPS, met geweigerde requests tot gevolg. Caching werkt zoals geadverteerd (93% en 53% latentiereductie, gemeten). Het cijfer van 5.000 RPS van de leverancier geldt voor een grotere machine en een andere workload dan de meeste teams draaien. Dus voor een enkele node geldt: mediane snelheid is het probleem niet — tail-latentie onder belasting en geheugenruimte bij documentintensief verkeer zijn dat wel.
De lastigere vraag is wat er gebeurt als je meer dan één node draait. Een productie-gateway moet horizontaal kunnen opschalen, inschalen en het uitvallen van een pod kunnen opvangen zonder dat iemand het merkt. In de open-source versie wordt dat ingewikkeld. Configuratiewijzigingen worden niet live gedistribueerd naar replicas; het gedocumenteerde patroon is een gedeeld configuratiebestand gecombineerd met een herstart. Elke routingwijziging, sleutelrotatie of budgetupdate verandert daardoor in een gecoördineerde rollout over je gateway-pods in plaats van een instelling die je omzet. Tel daar een admindashboard bij op dat openstaat voor iedereen die het kan bereiken totdat het eerste admin-account is aangemaakt, en de open-source versie blijkt het meest geschikt voor een enkele node die je nauwgezet monitort, niet voor een complete fleet.
Bifrost Enterprise dicht een groot deel van dat gat: de gRPC-mesh verzendt configuratiewijzigingen binnen enkele seconden naar elke replica, zonder dat een herstart nodig is. Maar ook Enterprise blijft infrastructuur die je zelf moet implementeren, schalen, patchen en monitoren. Het aanschaffen van de licentie neemt de operationele last niet uit handen. (Enterprise-prijzen worden niet openbaar gemaakt; we behandelen wat bekend is in onze Bifrost overzicht van prijzen.)
De werkelijke afweging is dus minder "is Bifrost snel?" en meer "wie gaat het beheren?" Een team met toegewijde platform-/DevOps-capaciteit, of met strikte vereisten om alles in de eigen omgeving te houden, kan Bifrost goed draaien — idealiter op Enterprise als er meer dan één replica nodig is. Een klein team dat enkel een betrouwbare gateway nodig heeft voor zijn LLM-calls, haalt meestal meer waarde uit een beheerde oplossing dan uit het zelf beheren van de gateway-operations.
TrueFoundry's AI Gateway wordt volledig binnen je eigen VPC geïmplementeerd — zonder datstroom naar TrueFoundry-infrastructuur — en plaatst 1.000+ LLM's achter één OpenAI-compatibele API, met modeldeployment en de gateway in één enkel control plane. Het is SOC 2 Type II gecertificeerd. Bekijk hoe het functie voor functie presteert in onze TrueFoundry vs. Bifrost vergelijking, of boek een demo om het te zien op je eigen workload.
Methodologie: elke bovenstaande claim is herleidbaar tot ons eigen praktische Bifrost-dossier — geïnstalleerd, geconfigureerd en onderworpen aan belastingstests op een vaste 1 vCPU / 2 GB-testopstelling, gecontroleerd aan de hand van de officiële documentatie van Bifrost/Maxim, met een geverifieerde datum voor elk feit.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Bifrost AI is een open-source AI Gateway - een enkel Go-proces dat tussen uw applicaties en uw LLM-providers staat, en een OpenAI-compatibele API beschikbaar stelt over 28 ingebouwde provideradapters heen. Het is Apache-2.0-gelicentieerd en self-hosted: u draait het zelf, brengt uw eigen providersleutels mee, en betaalt de providers rechtstreeks, zodat de gateway geen per-token-aandeel inhoudt. Een betaalde Enterprise-editie voegt clustering, identiteit, guardrails, en audit toe. De Bifrost LLM Gateway is gebouwd door Maxim AI - juridische entiteit H3 Labs Inc., opgericht in 2023 door Vaibhavi Gangwar en Akshay Deo, actief in de Verenigde Staten en India - met de open-source kern op github.com/maximhq/bifrost en Enterprise verkocht via sales zonder gepubliceerde prijs.
De eigen benchmark van Bifrost claimt ~5.000 RPS bij ~11 microseconden overhead op een t3.xlarge, maar volgens de eigen bron van de leverancier sluit dat cijfer HTTP-verzoekafhandeling en JSON-marshalling uit - het is tijd binnen de interne pijplijn, geen netto latentie toegevoegd aan uw verzoek. End-to-end gemeten op een gestandaardiseerde box van 1 vCPU/2 GB kost het mediane verzoek 2-6 ms, en dat blijft zo over vrijwel het hele geteste bereik. De p99 is het cijfer om mee te plannen: +60 ms voor kleine payloads bij 600 RPS, +75 ms voor middelgrote bij 400, en +41 ms voor grote bij slechts 100 - de laatste stappen waarbij de toegevoegde p99 binnen een budget van 100 ms bleef. Één stap verder overschrijden alle drie dit hard (+186 ms klein bij 800 RPS, +137 ms middelgroot bij 600, +614 ms groot bij 150, waarbij de laatste twee ook verzoeken laten vallen). Zowel de microseconden van de leverancier als onze milliseconden zijn correct - ze meten verschillende dingen, en de milliseconden zijn degene die uw gebruikers voelen.
Dit klopt, maar het meet iets nauwers dan de meeste lezers aannemen. Volgens de eigen bron van Bifrost sluit het cijfer HTTP-verzoekafhandeling en JSON-marshalling uit - het is dus tijd besteed binnen de interne pijplijn van de gateway, niet de netto latentie toegevoegd aan het verzoek van een aanroeper. Het is ook een gemiddelde in plaats van een percentiel, gemeten op een t3.xlarge; dezelfde bron rapporteert 59 microseconden op een t3.medium, ongeveer 5x slechter op een kleinere box. Bij het meten van de volledige end-to-end-kost op 1 vCPU kregen we 2-6 ms bij de mediaan. Beide cijfers zijn waar; ze beantwoorden verschillende vragen.
Op een gestandaardiseerde box van 1 vCPU/2 GB waren de laatste belastingstappen waarbij de toegevoegde p99-latentie onder 100 ms bleef: ~600 RPS voor kleine payloads (200 in/100 uit tokens), ~400 voor middelgrote (2.000/500) en ~100 voor grote (20.000/1.000). De volgende stap mislukte in alle drie de gevallen. De eigen benchmark van Bifrost claimt ~5.000 RPS, maar op een t3.xlarge - viermaal de rekenkracht - tegen een gemockte upstream. Doorvoer schaalt mee met cores voor klein en middelgroot verkeer; voor grote payloads wordt geheugen de bindende beperking lang voordat CPU dat wordt, dus alleen vCPU's toevoegen zal dat plafond niet verleggen.
Ja, maar de replica's delen geen live configuratie. Op Bifrost OSS is het gedocumenteerde patroon een gedeeld configuratiebestand plus een herstart, dus een wijziging op een replica bereikt de andere niet totdat ze opnieuw opstarten. Dat maakt op- en afschalen, en het uitrollen van configuratiewijzigingen, een gecoordineerde operatie over al uw gateway-pods heen.
Voor multi-node-implementaties is het grootste operationele verschil configuratiepropagatie. Enterprise gebruikt een gRPC-mesh die configuratiewijzigingen binnen seconden uitzendt naar elke replica, zonder herstart; OSS vertrouwt op een gedeeld bestand en een herstart. Hoe dan ook, u implementeert, schaalt, en beheert de gateway-infrastructuur nog steeds zelf.
Meer dan u zou verwachten, en bij grotere payloads is geheugen - niet CPU - de beperking die daadwerkelijk toeslaat. Op een box van 2 GB piekten kleine payloads op 848 MB. Middelgrote bereikten 1.935 MB, 97% van het plafond, bij de hoogste geteste belasting. Grote bereikten 1.944 MB, eveneens 97% van het plafond, bij slechts 100 RPS, en werden vervolgens OOM-killed bij 150 - terwijl CPU slechts op 24-37% zat. Dimensioneer uw implementatie op basis van gelijktijdige verzoeken vermenigvuldigd met contextlengte, niet op basis van het aantal vCPU's.
Het vertraagt niet geleidelijk - het stopt. De latentie bij grote payloads is vlak van 10 tot 100 RPS, en valt dan van een klif bij 150 RPS, waar de toegevoegde p99 naar +614 ms springt en 61 verzoeken worden gedropt doordat de pod midden in de run OOM-killed wordt. Streaming is nog erger: bij 200 RPS met grote payloads bereikte de time-to-first-token p99 72,1 seconden en mislukten 3.023 van de 12.001 streams volledig. Behandel bij documentzware workloads het niveau boven het plafond als "stort in", niet als "trager".



Het laatste nieuws, artikelen en bronnen in je inbox

















