



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Request 51 mislukt.
Je controleert de modelpagina en daar staat nog steeds dat het gratis is. Je controleert je saldo en er staat geld op. Je controleert de documentatie en vindt een limiet van 20 requests per minuut, waar je niet eens in de buurt kwam, omdat je er misschien drie uitvoerde.
Waar je tegenaan liep, was de dagelijkse limiet. En hoe hoog die ligt, hangt af van iets waar geen enkele andere gateway aan zou denken om het aan te koppelen: hoeveel geld je ooit aan OpenRouter hebt gegeven. Onder de 10 gekochte credits gedurende de levensduur van je account, geven gratis modellen je 50 requests per dag. Bij 10 of meer krijg je er 1.000. De upgrade is permanent, dus je kunt het allemaal uitgeven, terugvallen op een nulsaldo en toch de hogere limiet behouden.
Dat is het nuttigste om te weten over OpenRouter rate limits, en het is niet de enige verrassing. We hebben twee weken lang het platform grondig getest voor een gateway-evaluatie. Dit is wat we hebben gevonden, inclusief enkele zaken die de documentatie niet vermeldt.
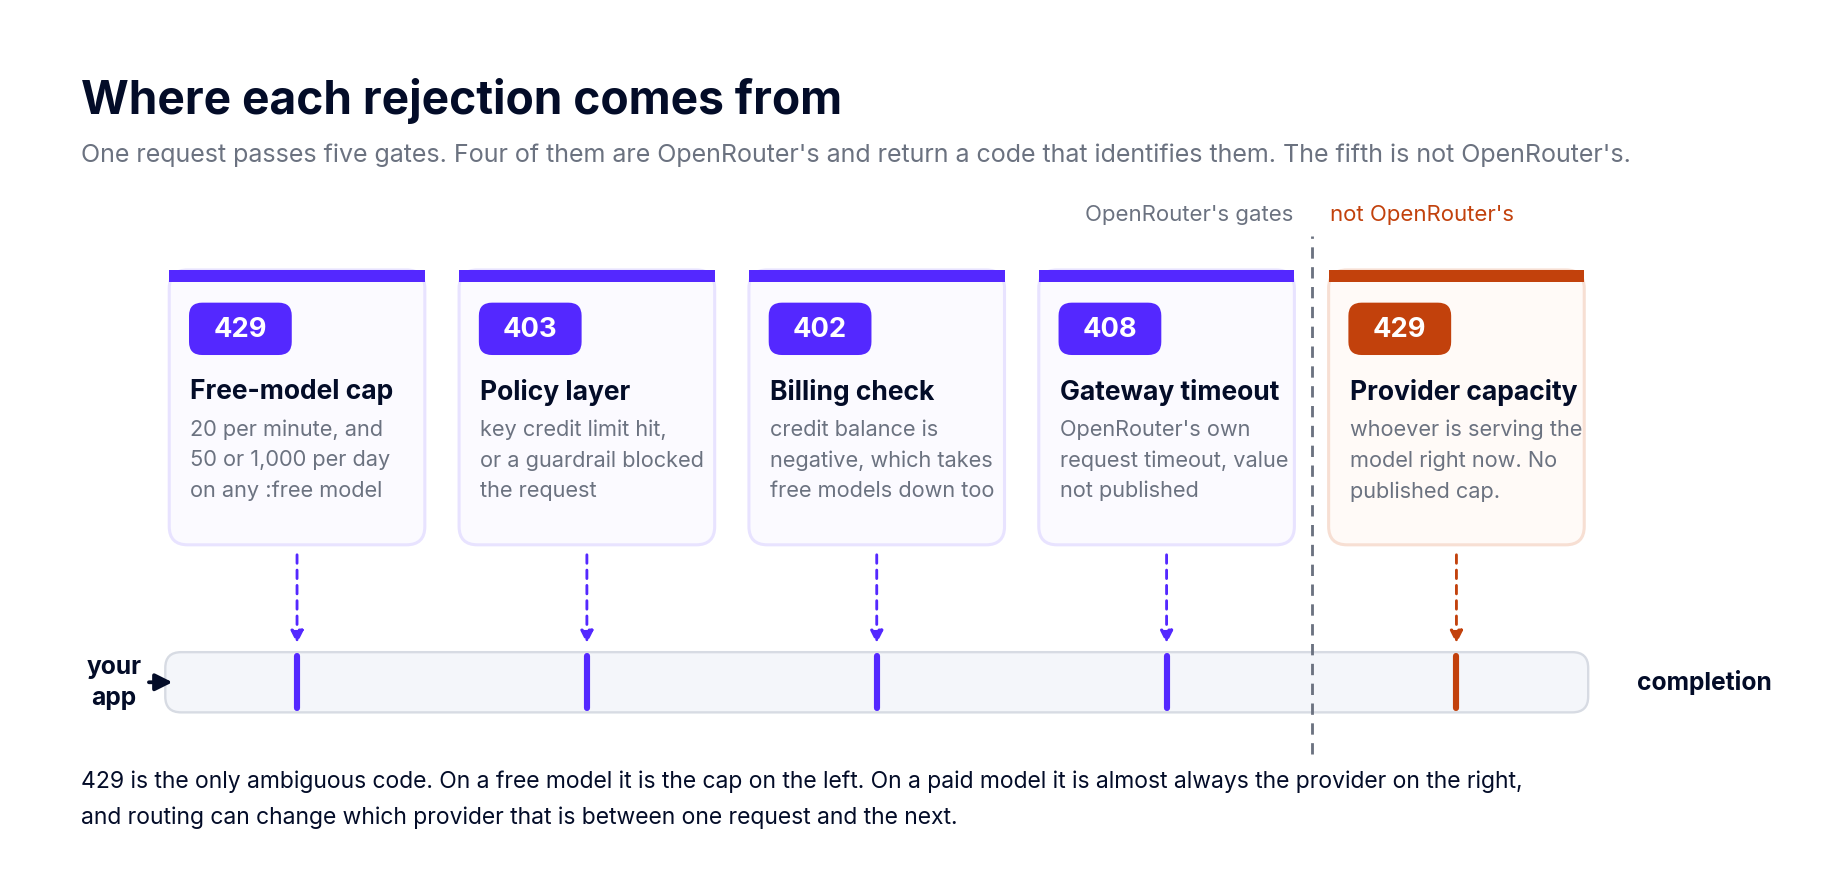
Vier afzonderlijke mechanismen kunnen je request weigeren, en ze zijn gemakkelijk met elkaar te verwarren.
Het eerste is de limiet voor gratis modellen: 20 per minuut, 50 of 1.000 per dag, toegepast op elk model-ID dat eindigt op :free. Die is gepubliceerd en voorspelbaar. Het tweede is de capaciteit van de provider die je betaalde request daadwerkelijk verwerkt, wat OpenRouter niet publiceert en niet echt kan controleren. Het derde is de DDoS-bescherming van Cloudflare, in hun documentatie alleen beschreven als het blokkeren van requests die het redelijke gebruik aanzienlijk overschrijden, zonder dat er een getal aan is gekoppeld. Het vierde is het budget of de creditlimiet die je zelf hebt geconfigureerd, wat helemaal geen rate limit is, maar het verkeer op dezelfde manier weigert.
Alleen het eerste mechanisme is een rate limit in de zin die je bedoelt als je het woord rate limit gebruikt. De rest is de capaciteit van iemand anders, een bot veiligheidsnet en je eigen boekhouding.
De limiet van 20 per minuut is vast. Deze verandert niet mee met je accountstatus, je saldo of je uitgaven. Als je meer dan 20 requests per minuut nodig hebt, zijn gratis modellen niet de oplossing en verandert geen enkele hoeveelheid geld daar iets aan.
De dagelijkse limiet is degene die is gekoppeld aan je betaalhistorie, en de drempel ligt op aankopen gedurende de gehele levensduur in plaats van je huidige saldo. De minimale credit-aankoop op OpenRouter is $5, dus $10 is een bewuste tweede stap, niet de instapprijs. Kopen in twee delen van $5 brengt je op dezelfde plek als één aankoop van $10, voor zover we kunnen beoordelen.
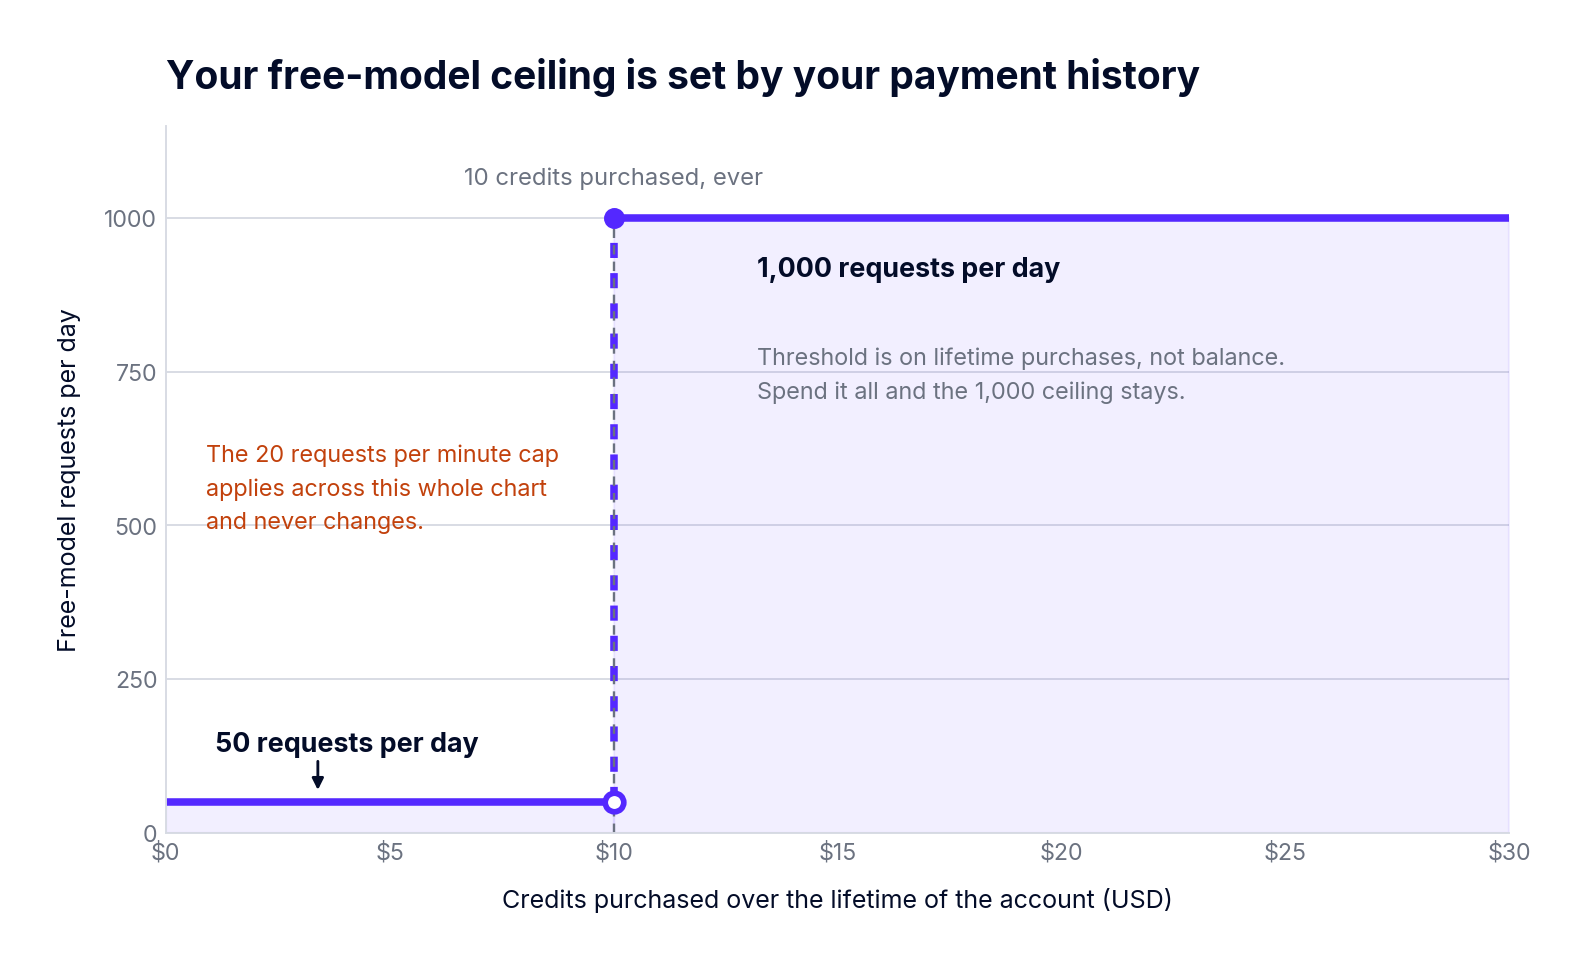
Wat dit vreemd maakt, is de richting van het oorzakelijk verband. Je doorvoerplafond is geen functie van je abonnement of je verkeerspatroon. Het is een functie van een inkoopbeslissing, wat betekent dat een financiële vraag nu een beschikbaarheidsvraag beantwoordt. Bij een hobbyproject is dat prima. Maar zodra je gebruikers hebt, ben je één vertraging in de boekhouding verwijderd van een capaciteitswijziging.
Er zit nog een tweede valkuil onder: mislukte requests kunnen nog steeds meetellen voor de dagelijkse limiet. Een retry loop die een drukbezet gratis model blijft bestoken, kan je 50 requests verbruiken zonder een enkele bruikbare completion terug te sturen. Als je retries gaat gebruiken, beperk dan het aantal pogingen.
Je werkelijke limieten zitten in één API-call
Het dashboard toont je geen limietteller. GET /api/v1/key doet dat wel, en het retourneert exact wat OpenRouter op dit moment voor die key afdwingt.
Twee dingen vallen op. Ten eerste is is_free_tier weer het mechanisme van de betaalhistorie, nu als een boolean die je doorvoerlogica moet uitlezen. Ten tweede, en dit is het deel waar mensen over struikelen, bevat de response nog steeds een rate_limit object dat de eigen documentatie van OpenRouter nu als verouderd markeert en adviseert te negeren.
Veel gidsen van derden en AI-coderingsvaardigheden zijn nog niet bijgewerkt. Je zult rate limit-tabellen vinden die 20 requests per 10 seconden citeren voor accounts zonder tegoed en 200 per 10 seconden voor accounts met tegoed, allemaal afgeleid van dat niet meer gebruikte veld. Die getallen beschrijven niets wat het platform vandaag de dag afdwingt. Als een dashboard, een waarschuwingsregel of een client-bibliotheek van jou rate_limit leest, leest het een waarde die niemand onderhoudt.
OpenRouter publiceert geen platform-requestlimiet voor betaalde modellen, en wij zijn ernaar op zoek gegaan. Een gelijktijdigheidstest op verkeer dat via credits wordt gefactureerd bij 1, 4, 8 en 16 requests in uitvoering leverde op elk niveau nul weigeringen op. Geen 429's, geen shedding, geen queuing. De meidantijd tot de eerste token veranderde nauwelijks tussen één request in uitvoering en zestien.
We hebben het plafond niet gevonden. De test stopte bij 16 en werd uitgevoerd op modellen die door OpenAI werden geserveerd, dus zie dat als een ondergrens in plaats van een vast getal: de gateway knelde ons niet af onder de 16 gelijktijdige requests, en waar het wel begint is nog steeds een open vraag.
Wat betekent dat een 429 op een betaald model meestal niet OpenRouter is die je vraagt het rustiger aan te doen. Het is de provider die op dat moment die model-string bedient. En aangezien routing je tussen hosts kan verplaatsen zonder dat de model-string verandert, kan de capaciteit waarmee je werkt veranderen tussen het ene request en het volgende. Je kunt het voorspelbaar maken door vast te pinnen met provider.order of provider.only, ten koste van de failover waarvoor je vermoedelijk een router hebt gekozen.
Niets in de documentatie van OpenRouter verzamelt deze op één plek, en de code is de snelste manier om te zien welke laag je zojuist heeft GEWEIGERD.
De 402 verrast mensen, omdat het betekent dat "gratis" voorwaardelijk is aan niet rood staan. Ga je in de min, dan stoppen de gratis modellen er ook mee.
Houd 403 volledig buiten je retry-pad. Het opnieuw proberen levert niets op, aangezien hetgeen je blokkeert een beleid is in plaats van een wachtrij. We liepen tijdens het testen tegen een uitgeputte key-limiet aan en kregen een strakke 403 terug met de tekst "Key limit exceeded (total limit)" en een directe link naar de instellingenpagina van die key. Ere wie ere toekomt: de foutmeldingen van OpenRouter voor hun eigen beslissingen zijn uitstekend. Fouten die worden doorgegeven van providers zijn wat de provider op dat moment wilde doorgeven, en beide komen binnen onder hetzelfde bericht op het hoogste niveau, dus de statuscode is je enige betrouwbare signaal in welke wereld je je bevindt.
Dit is het deel dat ons de meeste tijd heeft gekost. Retries, backoff en jitter zijn niet configureerbaar. We stuurden max_retries en een gestructureerd retry policy-object, en beide kwamen terug met HTTP 200 zonder foutmelding, wat geaccepteerd en genegeerd betekent in plaats van gehonoreerd. Datzelfde geldt voor timeout.
De oorzaak is een gebrek aan validatie. OpenRouter controleert keys in het provider object tegen een bekende lijst en weigert onbekende keys op de juiste manier. Keys op het hoogste niveau worden niet gecontroleerd. Dus een niet-ondersteunde instructie op het hoogste niveau levert je een succesvolle response op zonder enige indicatie dat er niets mee is gedaan, wat een ergere fout is dan een 400 zou zijn geweest.
Er is ook geen stream-idle timeout, noch op de server noch als client-parameter. Over ongeveer 4.300 requests hadden we twee streams die voortijdig eindigden zonder enige HTTP-fout. Zeldzaam, maar je client moet het opmerken, want niets anders zal het je vertellen.
Dit alles legt pacing, retries en timeouts bij jouw applicatie neer. Het engineering-blog van OpenRouter zegt dit zelf ook, en we hebben liever dat ze het eerlijk zeggen dan dat ze doen alsof het anders is. Het betekent wel dat als je meerdere services draait, je deze logica meerdere keren aan het schrijven bent.
Teams schuiven deze samen tot één idee en vragen zich vervolgens af waarom geen van beide afging zoals verwacht. Rate limits beschermen capaciteit binnen een tijdsbestek. Budgetten beschermen geld over een periode. Op OpenRouter zijn het gescheiden functies die verschillende statuscodes retourneren.
Key-creditlimieten worden dagelijks, wekelijks of maandelijks om middernacht UTC gereset, waarbij de weken van maandag tot en met zondag lopen. Laat je de reset oningesteld, dan heb je een limiet voor de gehele levensduur. Het ankerpunt is niet configureerbaar, dus als je boekjaar op de 25e begint, of je team werkt in IST, zullen je resets niet overeenkomen met je rapportage.
Guardrail-budgetten nestelen zich over periodes voor de gehele levensduur, maandelijks, wekelijks en dagelijks, en de limieten moeten strikt afnemen naarmate de periode korter wordt. Ze worden ook niet samengevoegd, wat mensen verrast: geef drie engineers dezelfde dagelijkse budget-guardrail en ieder krijgt dat budget afzonderlijk, terwijl een enkel request meetelt voor zowel het budget van de key als het budget van degene die eigenaar is van de key. BYOK-uitgaven blijven onzichtbaar voor budgetten tenzij include_byok_in_budgets is ingeschakeld, wat een verdedigbare standaardinstelling is voor facturering, maar een slechte voor governance.
Handhaving is een harde stop in plaats van een waarschuwing. Er is geen modus voor alleen waarschuwen gedocumenteerd, dus het eerste teken dat er een budget bestaat, is uitval van verkeer. De kostenkant van dit alles valt buiten het kader van dit artikel, maar onze OpenRouter prijs-analyse behandelt de 5.5% credit-aankoopfee en de BYOK-vergoeding in detail.
De dagelijkse gratis limiet telt requests, geen tokens. Een gesprek van 100.000 tokens en een prompt van twee woorden kosten je exact hetzelfde: één request. Dat klinkt genereus totdat je een tool loop uitvoert, waarbij één taak wel twintig calls kan maken en het request-plafond al bindt lang voordat iets dat op een token lijkt dat doet.
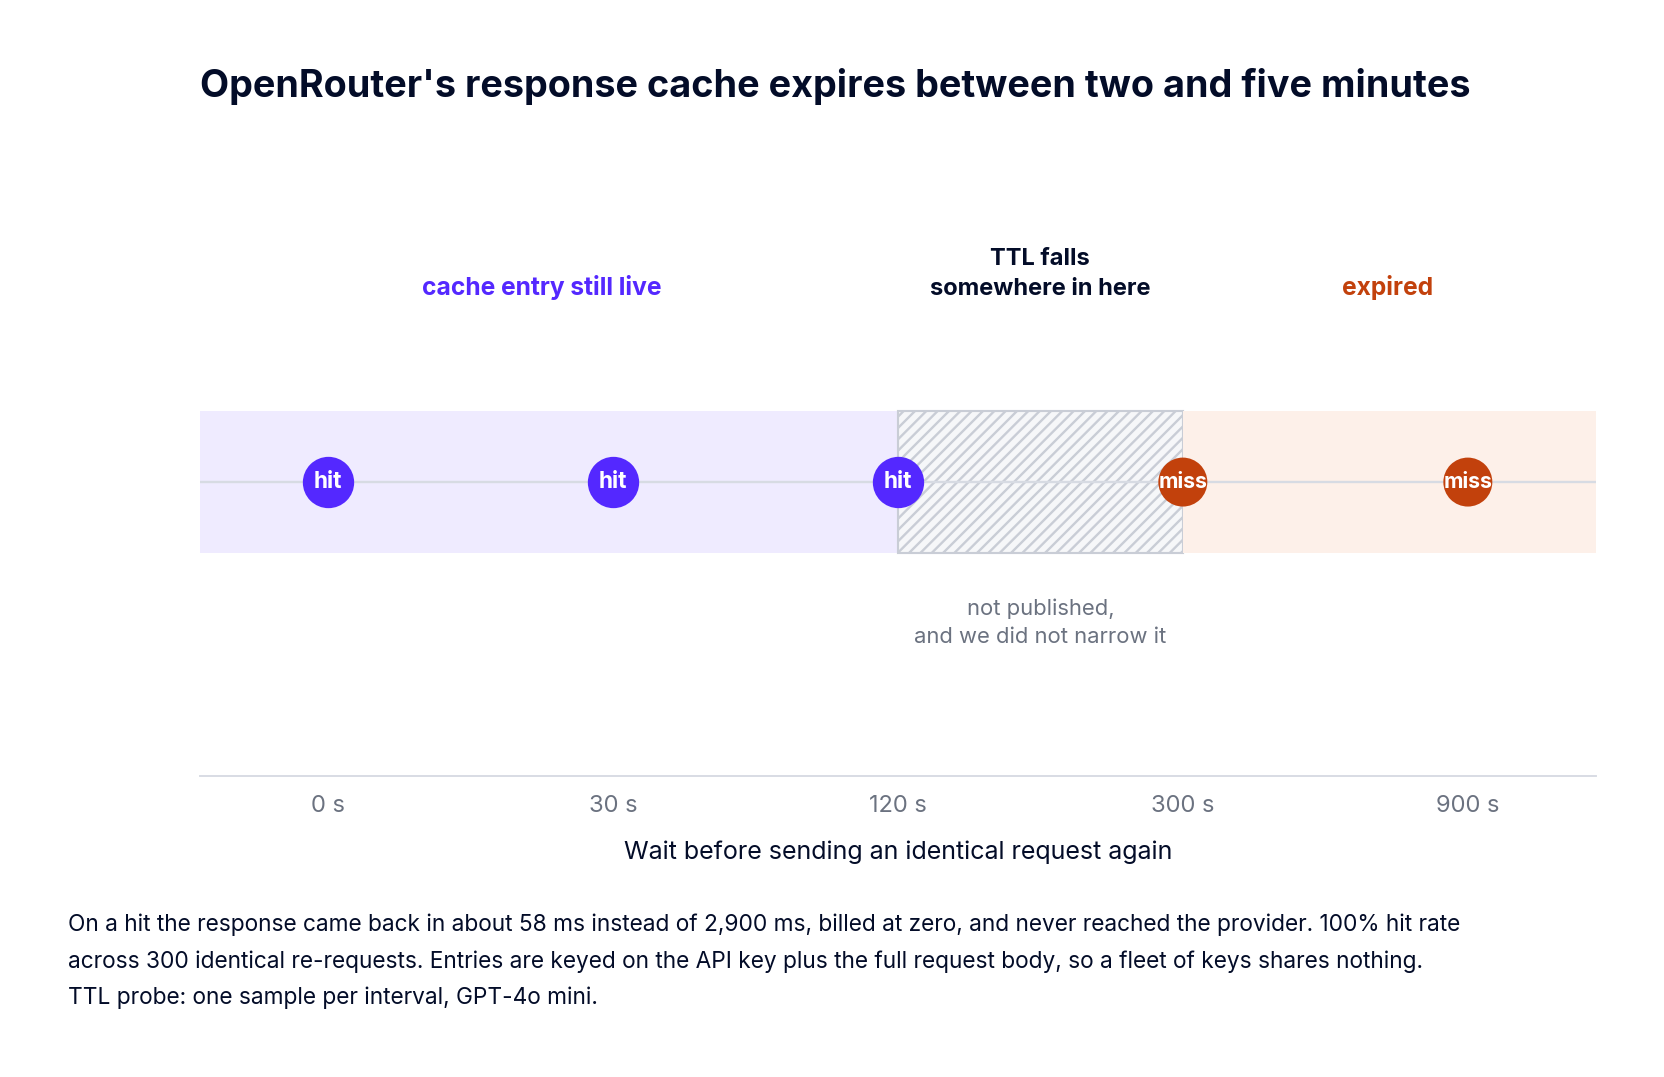
Response caching helpt, mits gericht ingezet. Opt-in per request met de X-OpenRouter-Cache: true header en een identiek nieuw request komt terug in ongeveer 58 ms in plaats van 2.900 ms, gefactureerd tegen nul kosten, en de hit verbruikt geen rate limit van de provider omdat het request de provider nooit bereikt. We hebben een hit-rate van 100% gemeten bij 300 identieke herhaalde requests. De beperkingen maken het pas echt interessant: vermeldingen zijn gekoppeld aan je API-key plus de gehele request body, dus een reeks services die elk een eigen key hebben, deelt niets met elkaar, en de gemeten TTL ligt ergens tussen de twee en vijf minuten. Nog aanwezig bij 120 seconden, verdwenen bij 300. OpenRouter publiceert dat getal niet. Het dekt retry-stormen en dubbele inzendingen binnen een sessie af, maar niet een query die elk uur terugkomt.
Nog een plafond dat opspeelt tijdens de evaluatie in plaats van in productie: een organisatie-account is gelimiteerd tot 10 leden, te verhogen door contact op te nemen met support. Een proefperiode starten met een platformteam van vijftig man begint met een supportticket.
Onze gateway neemt een ander standpunt in over twee zaken: welke eenheid je telt, en of capaciteit en geld dezelfde knop zijn.
Wij stellen rate limits in op zes eenheden, requests_per_minute, requests_per_hour, requests_per_day, en dezelfde drie voor tokens. Requests per minuut is een zwakke indicator voor belasting wanneer één call 200 tokens of 200.000 tokens kan zijn, dus een teller die 1.000 requests toestaat, kan je niet vertellen of je op het punt staat een dollar of vier cijfers uit te geven. Token-eenheden kunnen dat wel. Regels worden ingesteld met rate_limit_applies_per, zodat een limiet geldt per gebruiker, per team of per model in plaats van vast te zitten aan een key, en we staan maximaal twee waarden per regel toe om het gedrag voorspelbaar te houden.
De vorm van de tijdsperiode is belangrijker voor agents dan voor mensen, dus gebruiken we een sliding window van 60 seconden breed in blokken van 10 seconden, waarbij de laatste zes worden opgeteld. Een piek die het einde van de ene vaste minuut en het begin van de volgende overspant, kan er niet tussendoor glippen met het dubbele van de limiet. Onze gids voor token-gebaseerde rate limiting en budgetten doorloopt de configuratie.
Budgetten blijven gescheiden, alleen op kosten, in USD, afgedwongen voordat de inference draait in plaats van pas ontdekt op een factuur. De gateway voegt ongeveer 3 tot 4 ms overhead toe en verwerkt 350+ RPS op een enkele vCPU, dus het evalueren van deze regels kost je niets wat je zou merken.
En overstappen van gateway is niet de enige optie die er is, wat we graag eerlijk zeggen. TrueFoundry ondersteunt OpenRouter als provider, zodat je de catalogus en failover kunt behouden terwijl je token-bewuste limieten, budgetten per team en logging op gebruikersniveau er voor plaatst. Voor veel teams is dat de juiste eerste stap. Als je al verder bent en de bovenstaande beperkingen de reden zijn dat je dit leest, vergelijkt onze analyse over OpenRouter alternatieven de opties voor productiegebruik.
OpenRouter rate limits zijn eenvoudig te formuleren en lastig om tegenaan te bouwen. De gepubliceerde cijfers gelden alleen voor gratis modellen. Het plafond voor betaalde modellen behoort toe aan een provider die je niet zelf hebt gekozen. Retries en timeouts komen in jouw code terecht, of je daar nu op gerekend had of niet. En je gratis doorvoer is een functie van je betaalhistorie, wat een vreemde zin is om te moeten opschrijven.
Dat is een redelijke afweging om enkele honderden modellen achter één key te krijgen, en de meeste teams maken die keuze graag. Het helpt alleen om te weten waar de grenzen liggen voordat een agent loop ze voor je ontdekt.
Als je limieten wilt laten tellen in tokens, budgetten gescheiden wilt houden van capaciteit, en beide wilt afdwingen binnen je eigen infrastructuur, bekijk dan hoe de TrueFoundry AI Gateway omgaat met rate limiting.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox
















