



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Large Language Models (LLMs) bieden krachtige mogelijkheden, maar brengen ook hoge infrastructuurkosten, onvoorspelbare gebruikspatronen en risico op misbruik met zich mee. Naarmate ondernemingen LLMs integreren in klantgerichte tools, interne copilots en API-platformen, wordt de noodzaak van gecontroleerde en betrouwbare toegang cruciaal. Dit is waar rate limiting een sleutelrol speelt.
In de context van LLM-inference is traditionele rate limiting op basis van requests per second (RPS) niet voldoende. LLMs zijn resource-intensief, token-gebaseerd en sterk variabel in rekenbelasting. Eén enkele prompt voor een model met 70B parameters kan duizenden tokens verbruiken en de GPU-latency aanzienlijk beïnvloeden. Zonder de juiste controles kan een gedeelde infrastructuur snel onstabiel of onbetaalbaar worden.
Dit artikel legt uit hoe rate limiting werkt in een AI Gateway, waarom het essentieel is voor een schaalbare AI-infrastructuur, en hoe TrueFoundry dit standaard inschakelt om eerlijk gebruik, kostenefficiëntie en prestaties van enterprise-kwaliteit te garanderen in multi-tenant-omgevingen.
Rate limiting is een mechanisme dat wordt gebruikt om te controleren hoeveel verzoeken een client binnen een specifiek tijdsvenster naar een systeem kan sturen. Het is een kernfunctionaliteit van moderne AI gateways die LLM-verkeer beheren. Het garandeert eerlijkheid, voorkomt overbelasting en behoudt de beschikbaarheid, vooral in omgevingen met meerdere gebruikers. Traditionele API's hanteren vaak eenvoudige limieten zoals 100 verzoeken per minuut per gebruiker, wat goed werkt voor standaard REST-services.
LLMs werken echter heel anders. Elk verzoek kan een drastisch verschillende belasting op de infrastructuur leggen, afhankelijk van de invoergrootte, het modeltype en de verwachte uitvoer. Een prompt van 20 tokens voor een 7B-model kan bijvoorbeeld snel worden afgerond, terwijl een verzoek van 2000 tokens voor een 65B-model GPU's meerdere seconden kan blokkeren. Zelfs twee identieke verzoeken aan verschillende modellen kunnen een factor 5 of meer verschillen in rekenkosten.
Dit maakt limieten op basis van verzoeken onvoldoende. Moderne LLM gateways moeten tokenbewuste rate limiting toepassen voor elke LLM tool die ze bedienen, rekening houdend met het werkelijke aantal verwerkte tokens en de rekenlast per aanroep.
Belangrijke factoren bij tokenbewuste rate limiting zijn onder meer:
In vergelijking met vaste verzoeklimieten bieden tokenbewuste limieten:
In generatieve AI-workflows wordt rate limiting nog crucialer. Eén enkele gebruiker kan grootschalige verwerking aan de backend veroorzaken via lange prompts, document-ingestie of agents die uit meerdere stappen bestaan. Zonder controles kan dit leiden tot GPU-congestie, hoge latency of onverwachte kosten.
Het werkelijke gebruik is vaak onvoorspelbaar, gedreven door front-end-apps, testloops of automatisering. Rate limiting zorgt ervoor dat deze interacties stabiel en efficiënt blijven, zelfs wanneer de infrastructuur wordt gedeeld door meerdere gebruikers of tenants.
Voor elke productie-omgeving moet de beste LLM gateway intelligente rate limiting bieden als een fundamentele vereiste voor schaalbaarheid, betrouwbaarheid en kostenbeheersing.
Belangrijkste metrieken voor het evalueren van een Gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Dataresidentie | Bewaart logs binnen uw regio (EU/US)? | Afhankelijk van use case | ✅ Ondersteund |
| Latency-Based Routing | Routet automatisch om op basis van realtime latency/storingen? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

Rate limiting is meer dan een beveiliging aan de achterkant. Voor platformen die LLMs aanbieden — met name platformen die openbare of multi-tenant API's aanbieden — fungeert het als een strategische laag voor stabiliteit, governance en zakelijke afstemming. Of het nu gaat om OpenAI, Anthropic of platformen die zijn gebouwd met TrueFoundry, rate limits dienen meerdere cruciale doelen.
Bescherm de infrastructuur tegen misbruik
Generatieve AI-inference is resource-intensief. Een plotselinge piek in lange prompts of gelijktijdige verzoeken kan GPU-wachtrijen overbelasten, de latency verhogen of zelfs diensten platleggen. Rate limits zorgen ervoor dat het verkeer op een gecontroleerde en geprioriteerde manier wordt verwerkt, wat uitputting van resources voorkomt.
Dwing eerlijkheid af tussen gebruikers of tenants
In systemen met meerdere gebruikers mag het gebruik van de ene client de prestaties van andere niet verslechteren. Rate limits helpen isolatie af te dwingen tussen gebruikers, teams of API-sleutels. Dit garandeert een consistent serviceniveau, ongeacht hoeveel gebruikers er tegelijkertijd actief zijn.
Stem het gebruik af op prijsplannen
Veel Gen AI-platformen genereren inkomsten op basis van tokens of gebruikscategorieën. Rate limits helpen die grenzen te bewaken. Bijvoorbeeld:
Voorkom kostenoverschrijdingen en verrassingen
LLM-gebruik kan ongemerkt en snel opschalen. Zonder de juiste limieten kunnen het tokenverbruik en het GPU-gebruik omhoogschieten. Rate limiting helpt platformen onverwachte infrastructuurkosten te voorkomen en het budget onder controle te houden.
Verbeter de betrouwbaarheid en gebruikerservaring
Wanneer het gebruik onder controle is, blijven de systeemwachtrijen stabiel. Dit leidt tot een lagere latency, hogere succespercentages en een constantere gebruikerservaring, wat vooral belangrijk is in productie-omgevingen met SLA's.
In op LLM gebaseerde systemen heeft niet elk verzoek dezelfde impact. Een korte prompt naar een klein model verbruikt minimale resources, terwijl een lange query naar een groot model aanzienlijke GPU-tijd in beslag kan nemen. Vanwege deze variabiliteit passen moderne platformen rate limits toe op meerdere dimensies, in plaats van alleen te vertrouwen op het aantal verzoeken.
Hier zijn de meest voorkomende dimensies die worden gebruikt voor effectieve rate limiting:
Het gebruik van deze dimensies geeft platformteams de flexibiliteit om het resourceverbruik af te stemmen op de beperkingen van de infrastructuur, de behoeften van gebruikers en de verwachtingen ten aanzien van het serviceniveau.
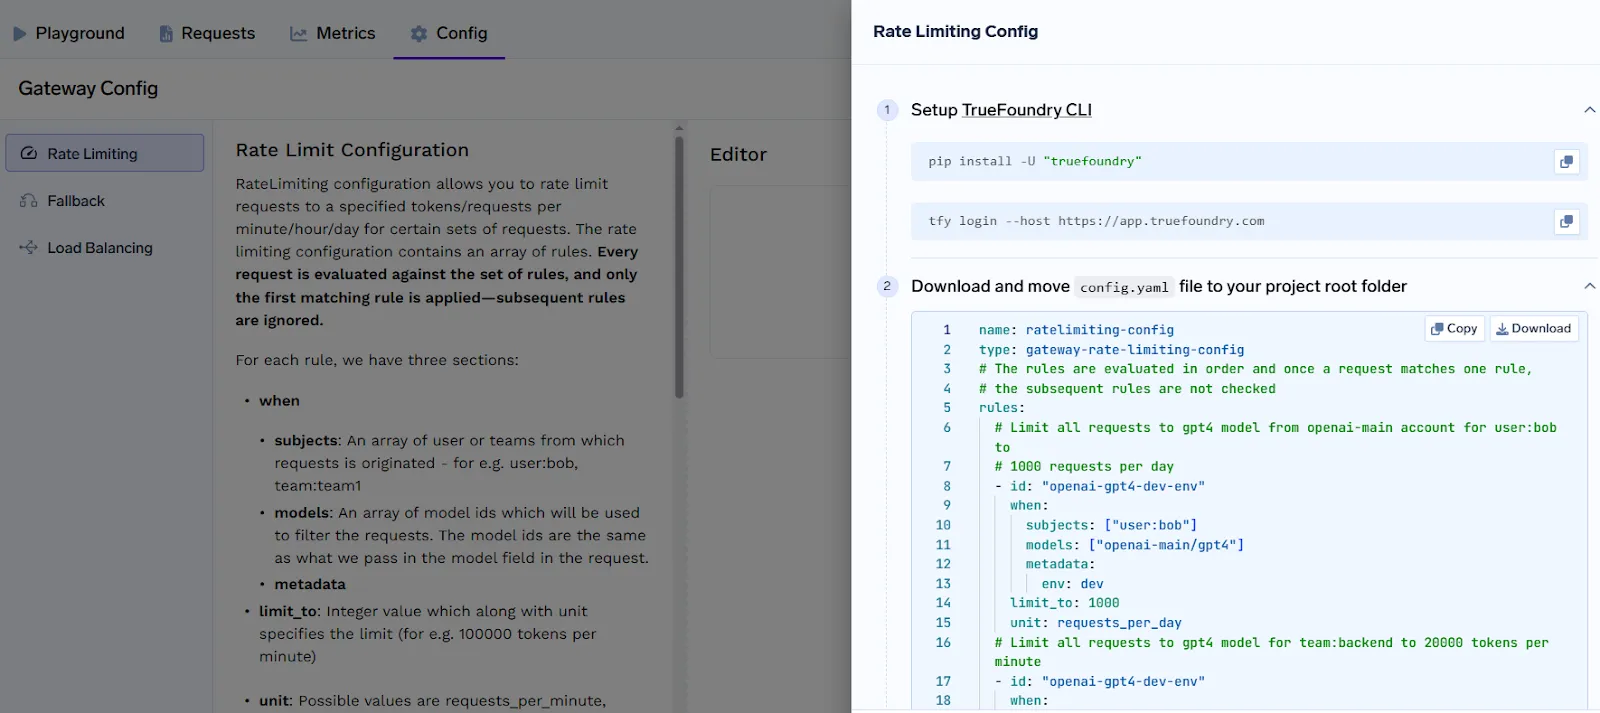
TrueFoundry biedt een robuust en flexibel rate-limitingsysteem waarmee platformteams de toegang tot LLM-endpoints kunnen beheren op basis van verzoeken of tokenverbruik. Dit zorgt voor een eerlijke toewijzing van rekencapaciteit, voorkomt misbruik en stemt het gebruik af op het beleid van de organisatie of de facturatieplannen.
De kern van het rate-limitingsysteem van TrueFoundry is een op regels gebaseerd configuratiesysteem waarmee teams een nauwkeurig beleid kunnen definiëren voor gebruikers, teams, virtuele accounts, modellen en metagegevens van verzoeken.
Op regels gebaseerde configuratie
Rate limiting in TrueFoundry wordt gedefinieerd via een lijst met regels, die elk het volgende specificeren:
Regels worden in volgorde geëvalueerd, dus specifiekere regels moeten boven algemenere regels worden geplaatst om een correcte overeenkomst te garanderen.
Ondersteunde limiettypen
TrueFoundry ondersteunt zowel op verzoeken gebaseerde als op tokens gebaseerde limieten over verschillende tijdsintervallen:
Dit maakt de handhaving van beleid mogelijk dat het werkelijke rekengebruik weerspiegelt, wat vooral belangrijk is bij het verwerken van prompts van variabele lengte naar modellen van verschillende grootte.
Veelvoorkomende use cases
De flexibiliteit van het configuratiesysteem ondersteunt een breed scala aan use cases:
Voorbeeldconfiguratie
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: "specific-rule"
    when:
      subjects: ["user:bob@email.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day
Dit voorbeeld beperkt het GPT-4-gebruik van een specifieke gebruiker tot 1.000 verzoeken per dag. Het rate-limitingsysteem van TrueFoundry is ontworpen om zowel krachtig als eenvoudig te beheren te zijn. Met tokenbewuste controles, gedetailleerde targeting en een helder, op YAML gebaseerd beleid kunnen teams het LLM-gebruik vol vertrouwen opschalen met behoud van controle over infrastructuur en kosten.
Hoe de configuratie toe te passen
1. Installeer de TrueFoundry CLI:
pip install -U "truefoundry"
tfy login --host https://app.truefoundry.com
2. Plaats uw config.yaml in uw projectmap.
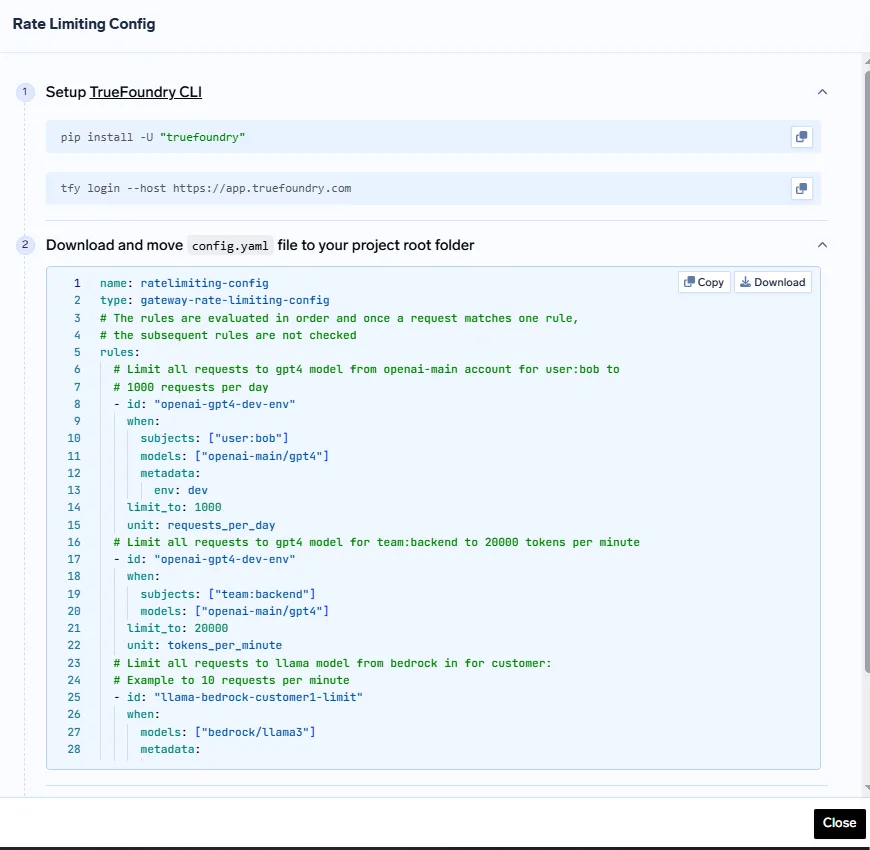
3. Pas de configuratie toe met:
tfy apply -f config.yaml
Deze declaratieve aanpak zorgt ervoor dat rate limits onder versiebeheer vallen, reproduceerbaar zijn en zijn afgestemd op de best practices van GitOps.
Realtime feedback over rate limits
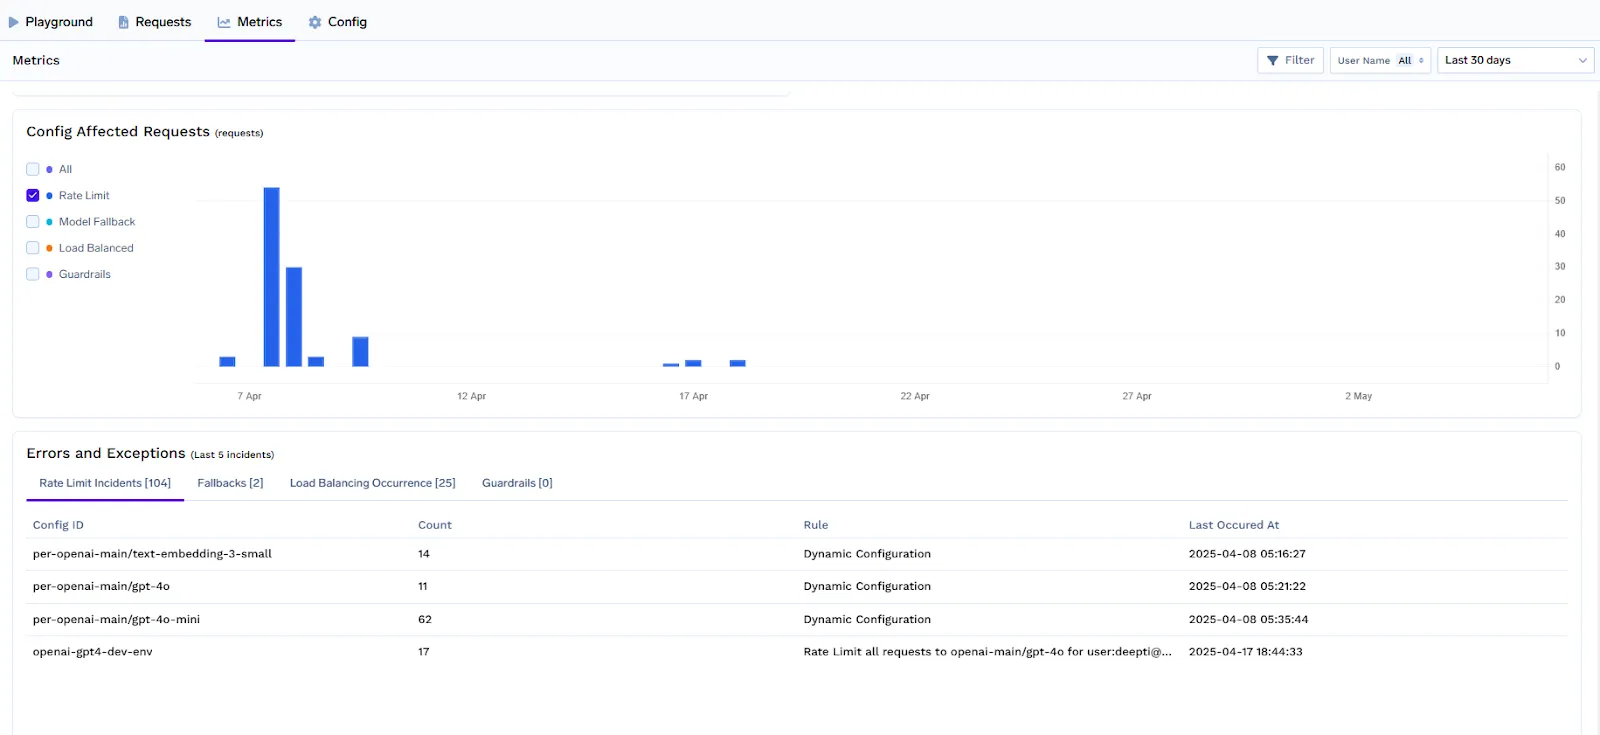
Het rate-limitingsysteem van TrueFoundry is ontworpen om onmiddellijke, transparante feedback te geven aan clients wanneer limieten worden overschreden of de maximale capaciteit naderen. Dit helpt ontwikkelaars de gebruiksgrenzen te begrijpen en throttling op een elegante manier af te handelen in hun toepassingen.
Wanneer een verzoek de ingestelde rate limit overschrijdt:
Dit feedbackmechanisme ondersteunt beter clientgedrag, maakt geautomatiseerde retry-logica mogelijk en zorgt ervoor dat het gebruik binnen de quotagrenzen blijft zonder giswerk.
Dashboards & Alerts
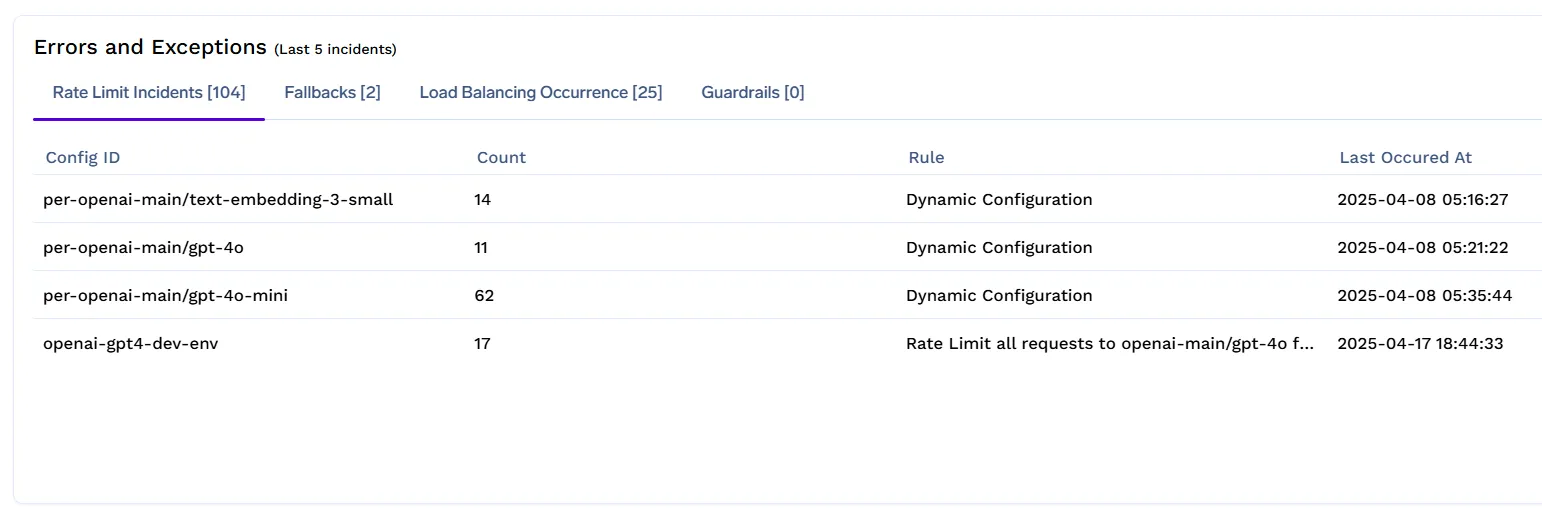
TrueFoundry biedt ingebouwde observabiliteit om platformteams te helpen bij het in realtime monitoren en optimaliseren van het rate limit-beleid.
Met behulp van het LLM Gateway-dashboard kunt u het volgende bijhouden:
Deze inzichten helpen bij het detecteren van misbruik, het proactief aanpassen van limieten en het garanderen dat hoogwaardige gebruikers een consistente service ontvangen.
Wanneer LLM-API's uitvallen, of dit nu komt door rate limits, interne fouten of tijdelijke storingen, zorgen fallback-mechanismen ervoor dat uw toepassingen soepel blijven werken. In plaats van foutmeldingen terug te sturen naar de eindgebruiker, kan TrueFoundry het verzoek automatisch omleiden naar een reservemodel of -provider, waardoor de beschikbaarheid behouden blijft met minimale onderbreking.
Fallback-regels worden geactiveerd op basis van specifieke voorwaarden, zoals het model-ID, de aanvragende gebruiker of het team, en responscodes zoals 429 of 500. Wanneer een verzoek aan deze voorwaarden voldoet, wordt het omgeleid naar een of meer alternatieve modellen die zijn opgegeven in de fallback-configuratie. Deze fallback-doelen kunnen optioneel overschrijvingen van parameters zoals temperature of max tokens bevatten, waardoor het gedrag kan worden fijnegestemd, afhankelijk van de modelprovider. Alleen de eerste overeenkomende regel wordt toegepast tijdens de evaluatie, wat zorgt voor een voorspelbare, deterministische afhandeling van storingen.
Een typische fallback-regel in TrueFoundry bevat de volgende componenten:
Voorbeeld van fallback-configuratie:
name: model-fallback-config
type: gateway-fallback-config
# The rules are evaluated in order. Once a request matches one rule, the subsequent rules are not checked.
rules:
  # Fallback to gpt-4 on Azure or AWS if openai-main/gpt-4 fails with 500 or 503.
  # The openai-main target also overrides some request parameters like temperature and max_tokens.
  - id: "openai-gpt4-fallback"
    when:
      models: ["openai-main/gpt4"]
      response_status_codes: [500, 503]
    fallback_models:
      - target: openai-main/gpt-4
        override_params:
          temperature: 0.9
          max_tokens: 800
  # Fallback to LLaMA3 on Azure or AWS if bedrock/llama3 fails with 500 or 429 for customer1.
  - id: "llama-bedrock-customer1-fallback"
    when:
      models: ["bedrock/llama3"]
      metadata:
        customer-id: customer1
      response_status_codes: [500, 429]
    fallback_models:
      - target: aws/llama3
      - target: azure/llama3
De LLM Gateway van TrueFoundry ondersteunt van nature een declaratieve fallback-instelling als onderdeel van het configuratiesysteem. Hierdoor kunnen teams fouttolerant beleid voor routing definiëren en uptime behouden zonder handmatige tussenkomst, vooral wanneer er met meerdere providers wordt gewerkt. Samen vormen slimme rate limiting en geautomatiseerde fallback de basis voor hoogbeschikbare Gen AI-diensten.
In elk multi-tenant AI-platform is rate limiting van cruciaal belang voor het waarborgen van stabiliteit, eerlijkheid en kostenbeheersing. Het stelt teams in staat om toegangsgrenzen te definiëren, niet alleen voor individuele gebruikers, maar ook voor teams, virtuele accounts en specifieke modellen, zonder dat daarvoor aangepaste logica nodig is.
De Gateway van TrueFoundry ondersteunt declaratieve rate limiting via YAML-configuratie, waarbij regels in volgorde worden geëvalueerd. De eerste overeenkomende regel wordt toegepast, wat betekent dat specifiekere regels bovenaan moeten staan en algemenere regels lager in de configuratie moeten worden geplaatst. Deze structuur zorgt voor gelaagde controle met behoud van schone, leesbare configuraties.
Elke regel kan de volgende componenten bevatten:
Voorbeelden van Multi-Tenant Rate Limiting
Verzoeken van specifieke gebruiker beperken: Stel dat u alle verzoeken aan het gpt4-model van het account openai-main voor de gebruikers bob@email.com en jack@email.com wilt beperken tot 1000 verzoeken per dag:
- id: "user-gpt4-limit"
  when:
    subjects: ["user:bob@email.com", "user:jack@email.com"]
    models: ["openai-main/gpt4"]
  limit_to: 1000
  unit: requests_per_day
Teambrede limieten toepassen: Als u het totale aantal verzoeken voor het 'frontend'-team wilt beperken tot 5000 per dag
- id: "team-frontend-limit"
  when:
    subjects: ["team:frontend"]
  limit_to: 5000
  unit: requests_per_day
Virtuele accounts beperken: Als u het aantal verzoeken voor het virtuele account 'va-james' wilt maximeren op 1500 per dag
- id: "va-james-limit"
  when:
    subjects: ["virtualaccount:va-james"]
  limit_to: 1500
  unit: requests_per_day
Stel globale plafonds in voor alle gebruikers en modellen:
- id: "{user}-{model}-daily-limit"
  when: {}
  limit_to: 1000000
  unit: tokens_per_day
Met deze instelling kunnen platformteams het gebruik segmenteren over bedrijfsonderdelen, quota per omgeving afdwingen en dure model-endpoints beschermen, terwijl schaalbare, betrouwbare AI-workloads worden ondersteund.
Rate limiting is meer dan een controle aan de achterkant. Het is een cruciale en onmisbare factor voor een betrouwbaar, kostenefficiënt en eerlijk gebruik van schaalbare LLM-infrastructuur. Of u nu een multi-tenant-platform beheert, gestratificeerde toegang biedt aan klanten of interne AI-workloads uitvoert over verschillende teams: het implementeren van slimme, tokenbewuste rate limits zorgt ervoor dat uw systeem voorspelbaar blijft onder druk.
Naast rate limiting geven functies zoals fallback routing, realtime feedback en gedetailleerde configuratie engineeringteams de middelen om prestaties en controle in balans te houden. De LLM Gateway van TrueFoundry brengt deze mogelijkheden samen met een declaratieve interface, waardoor platformteams beleid kunnen definiëren dat transparant en auditeerbaar is en aansluit bij de doelstellingen van de organisatie.
Nu de adoptie van generatieve AI versnelt, zullen systemen die intelligente toegangscontrole afdwingen zonder in te boeten aan gebruikerservaring of uptime, de volgende generatie van infrastructuur-resilience bepalen. Als u een AI gateway bouwt of opschaalt, is rate limiting niet zomaar iets om te overwegen. Het is iets dat vanaf dag één goed moet worden ingericht.
Rate limiting in een LLM gateway verwijst naar het mechanisme dat wordt gebruikt om de frequentie van inkomende verzoeken of het volume van tokens te controleren dat een gebruiker, team of toepassing binnen een specifiek tijdsvenster kan verwerken. In tegenstelling tot traditionele API-throttling is het tokenbewust en houdt het rekening met de werkelijke rekenbelasting van verschillende modelarchitecturen, waardoor wordt voorkomen dat zware queries het systeem laten crashen.
Het implementeren van rate limiting in LLM gateway-omgevingen helpt de kosten te beheersen door onverwachte pieken in het tokenverbruik en op hol geslagen scripts te voorkomen. Door gedetailleerde dagelijkse of urenlijkse quota in te stellen, kunnen organisaties de uitgaven voor specifieke gebruikers of niet-productie-omgevingen maximeren, wat ervoor zorgt dat AI-experimenten binnen een voorspelbaar budget blijven en tegelijkertijd beschermt tegen duur financieel verrassingen.
Rate limiting in LLM gateway-inrichtingen is essentieel om de infrastructuur te beschermen tegen misbruik en een hoge beschikbaarheid voor alle gebruikers te garanderen. Het voorkomt dat één enkele "noisy neighbor" de quota van providers of de GPU-capaciteit uitput, wat anders zou leiden tot een hogere latency en frequente HTTP 429 "Too Many Requests"-fouten. Deze beheerslaag is van cruciaal belang voor het behoud van stabiele SLA's in productie.
Veelvoorkomende strategieën voor rate limiting in een LLM gateway omvatten Request-Per-Minute (RPM) en Token-Per-Minute (TPM) limieten, die een nauwkeurige meting van het resourceverbruik bieden. Geavanceerde gateways ondersteunen ook gestratificeerde limieten op basis van gebruikersrollen of modeltypen, waardoor missiekritieke taken een hogere prioriteit kunnen krijgen terwijl ontwikkelworkloads met een lagere prioriteit worden geknepen tijdens perioden van drukte.
Hoewel het een kleine verwerkingsstap toevoegt, introduceert rate limiting in een LLM gateway doorgaans minder dan 4 milliseconden overhead, wat verwaarloosbaar is vergeleken met de seconden die nodig zijn voor modelgeneratie. In feite verbetert het vaak de waargenomen latentie door te voorkomen dat backend-wachtrijen verzadigd raken, wat ervoor zorgt dat requests soepel worden verwerkt zonder timeouts of servicestoringen te veroorzaken.
Ja, TrueFoundry biedt een productie-waardige implementatie van rate limiting in de LLM gateway via een declaratieve, op regels gebaseerde configuratie. Hiermee kunnen teams token-bewuste limieten afdwingen over meerdere modelproviders en tenants met behulp van eenvoudige YAML-bestanden. Dit systeem biedt realtime feedback en gedetailleerde dashboards, waardoor platformteams AI-workloads kunnen schalen met behoud van strikt kosten- en bronnenbeheer.
AI rate limiting werkt door bij te houden hoe vaak een gebruiker requests naar een AI API stuurt. Het systeem telt het aantal requests of tokens binnen een tijdsvenster. Als de gebruiker de toegestane limiet overschrijdt, blokkeert de API tijdelijk nieuwe requests of geeft een foutmelding terug totdat de limiet wordt gereset. Dit beschermt servers tegen overbelasting.
Absoluut. Door het tokenverbruik en de request-frequenties te maximeren, voorkomen gateways onverwacht GPU-overgebruik of onvoorziene clouduitgaven. Organisaties kunnen het gebruik afstemmen op budgetten, plannen maken voor gelaagde toegang en kostbare over-provisioning verminderen, terwijl een consistente service voor kritieke workloads behouden blijft.
Ja. Moderne AI gateways zoals TrueFoundry stellen teams in staat om rate-limit-regels in real-time of via geautomatiseerde scripts bij te werken. Dit zorgt ervoor dat de infrastructuur onverwachte pieken kan opvangen zonder downtime of verminderde prestaties. Dynamische aanpassingen houden de service responsief, terwijl eerlijk gebruik (fair usage) tussen tenants behouden blijft.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















