



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De OWASP Top 10 for Large Language Model Applications is een consensuslijst van de meest kritieke beveiligingsrisico's in software die door LLM's wordt ondersteund, onderhouden door het OWASP GenAI Security Project. De huidige versie is de 2025-lijst op genai.owasp.org/llm-top-10. De v1.1-lijst uit 2023/24 is daar nog steeds gearchiveerd en wordt nog steeds veel geciteerd - dus als een artikel Model Theft of Overreliance vermeldt, beschrijft het de oude versie.
De 2025-lijst zoals OWASP deze publiceert:
Wat er is veranderd, laat zien waar de aandacht naar uit is gegaan. System Prompt Leakage en Vector and Embedding Weaknesses zijn nieuw. Model Denial of Service is verbreed tot Unbounded Consumption. Insecure Plugin Design is opgegaan in supply chain en excessive agency toen tooling zich stabiliseerde rond protocollen zoals MCP. Model Theft is volledig verdwenen.
Dit is het gedeelte dat de meeste artikelen overslaan. De Top 10 vermeldt risico's, en een risico is geen productfeature. Vier risico's behoren tot het inferentiepad, waar een gateway zich bevindt. Drie behoren tot de applicatiecode. Drie behoren tot pipelines die een gateway nooit ziet.
Vier vallen er direct binnen de scope, drie gedeeltelijk en drie hebben elders een eigenaar nodig. Als uw AI security framework een gateway-rij bevat voor LLM04 en LLM08, dan is die rij louter decoratief.
Een gateway dekt LLM01, LLM02, LLM06 en LLM10 goed af omdat dit alle vier request-path-problemen zijn: ze ontstaan op het moment dat een prompt wordt verstuurd of een tool wordt geactiveerd, wat het enige moment is dat een gateway ziet. De rest is weken eerder al bepaald, tijdens een training-run of een indexeringstaak.
De lijst behandelen als een compliance-checklist. OWASP publiceert een risicotaxonomie met richtlijnen voor risicobeperking, geen certificering. Er bestaat geen OWASP LLM Top 10-audit en geen instantie die een certificaat uitgeeft. Een matrix die beweert dat alle tien de punten door één tool worden "afgedekt", is geschreven om een vergadering te overleven, niet een aanval.
Outputvalidatie op de verkeerde plek onderbrengen. LLM05 gaat over wat uw applicatie doet met de output van het model. Een gateway kan vlaggen dat een respons os.system of een niet-ge-escapte script-tag bevat. Het kan echter niet voorkomen dat uw service die string aan een shell voedt. De maatregel hoort daar te zitten waar de output wordt verwerkt; de controle in de gateway dient als defence-in-depth.
Aannemen dat injectiedetectie gelijk staat aan preventie. Detectie werkt via een classifier, classifiers hebben false negatives en aanvallers blijven itereren om ze te omzeilen. De duurzame oplossing voor LLM01 is ervan uitgaan dat een injectie soms slaagt en zorgen dat het systeem dat kan overleven - wat eigenlijk een LLM06-probleem is. Beperk het oppervlak van beschikbare tools, zodat een succesvolle injectie een model bereikt dat geen gevaarlijke functies kan aanroepen.
LLM10 negeren als een puur financiële zaak. Een agent die in een oneindige loop raakt, is een denial-of-service op uw eigen budget, en het op grote schaal uitvoeren van queries is hoe model-extractie werkt. Het is het makkelijkste lek om te dichten, en het lek dat het vaakst open blijft staan.
De AI Gateway van TrueFoundry implementeert deze maatregelen als guardrails op specifieke hooks in het request-pad. Er zijn er vier, en welke risico's u kunt aanpakken hangt af van de hook die u gebruikt.
Voor LLM-requests: input, voordat de prompt het model bereikt, en output, nadat het model reageert.

Voor MCP tool-calls: mcp_pre_tool, voordat de tool wordt uitgevoerd, en mcp_post_tool, nadat de tool gegevens retourneert.

Deze MCP-hooks maken het vraagstuk rond owasp mcp beheersbaar. Guardrails draaien op elke tool-call afzonderlijk - vijf tools achter elkaar betekent vijf sets met controles. Een fout bij een pre-tool controle zorgt ervoor dat de tool nooit wordt uitgevoerd; een fout bij een post-tool controle weerhoudt het resultaat.
Elke guardrail heeft een operation mode - validate inspecteert en kan blokkeren, mutate herschrijft daarnaast de inhoud - en een enforcement strategy voor overtredingen en guardrail-fouten:
De ingebouwde Prompt Injection-guardrail wordt aangedreven door Azure Prompt Shield en beheerd door TrueFoundry, zonder dat er keys van derden nodig zijn. Het analyseert de prompt van de gebruiker en eventuele document- of contextinhoud afzonderlijk. Hierdoor wordt indirecte injectie die verborgen zit in een opgehaald document even goed opgevangen als een directe instructie zoals "negeer alle voorgaande instructies". Alleen in validate-modus. Voeg deze toe vanuit de Guardrails-sectie:
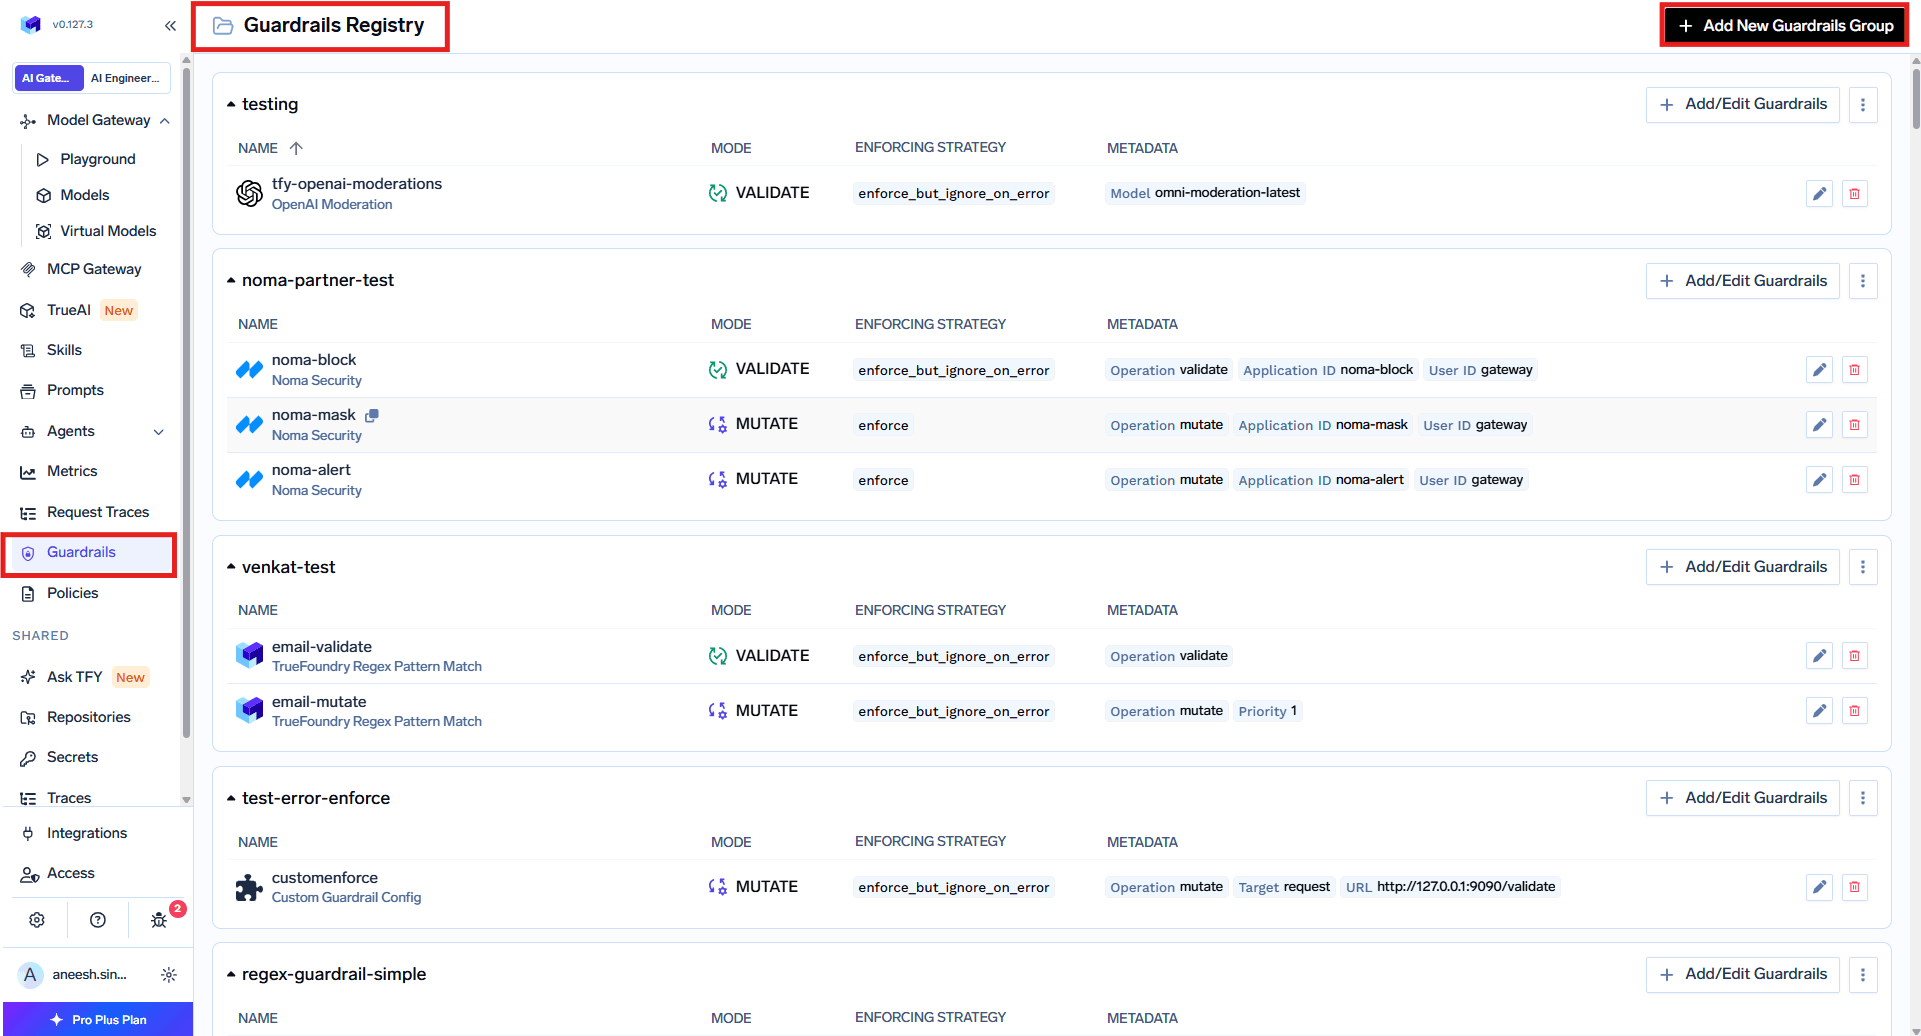
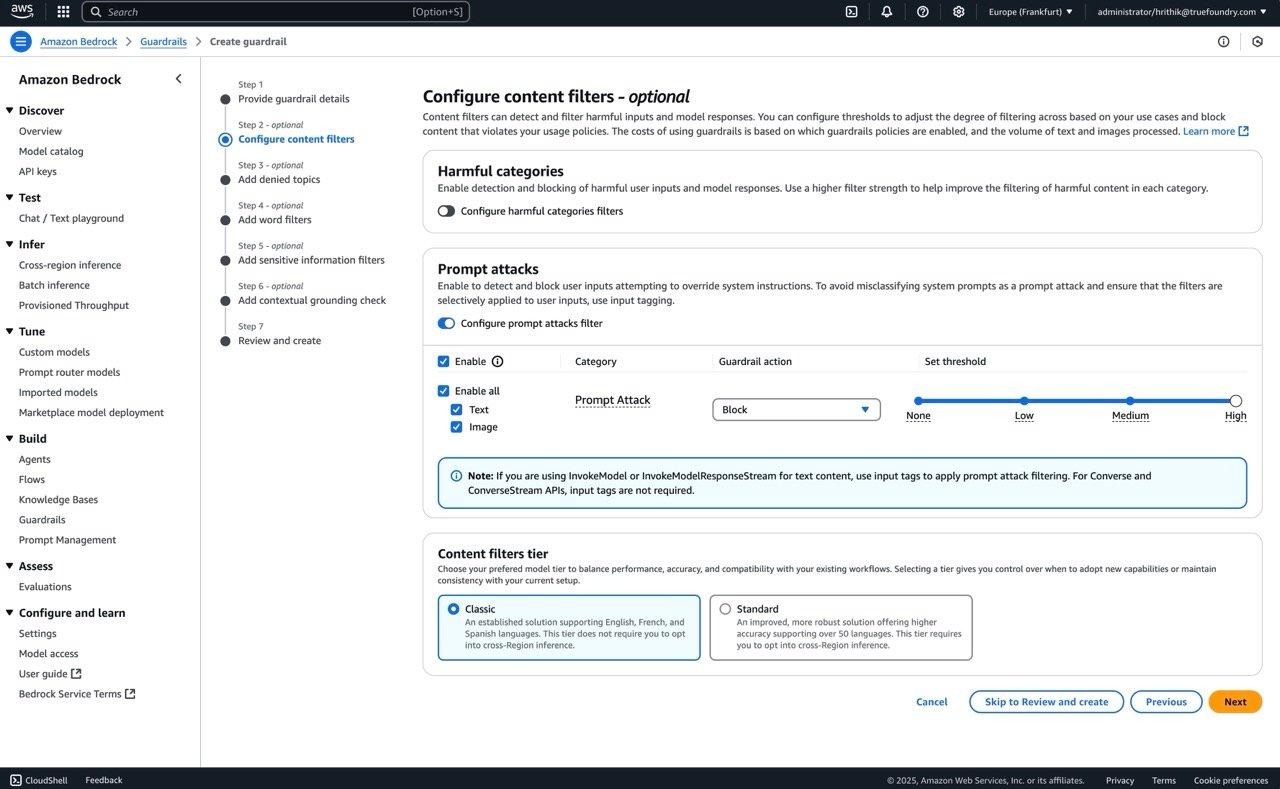
Het draait op LLM Input en MCP Pre Tool, waar het zoekt naar injecties binnen tool-parameters. Als u uw eigen credentials van leveranciers wilt gebruiken, doet AWS Bedrock Guardrails hetzelfde werk - schakel Prompt Attack in, zet de actie op Block en registreer deze:
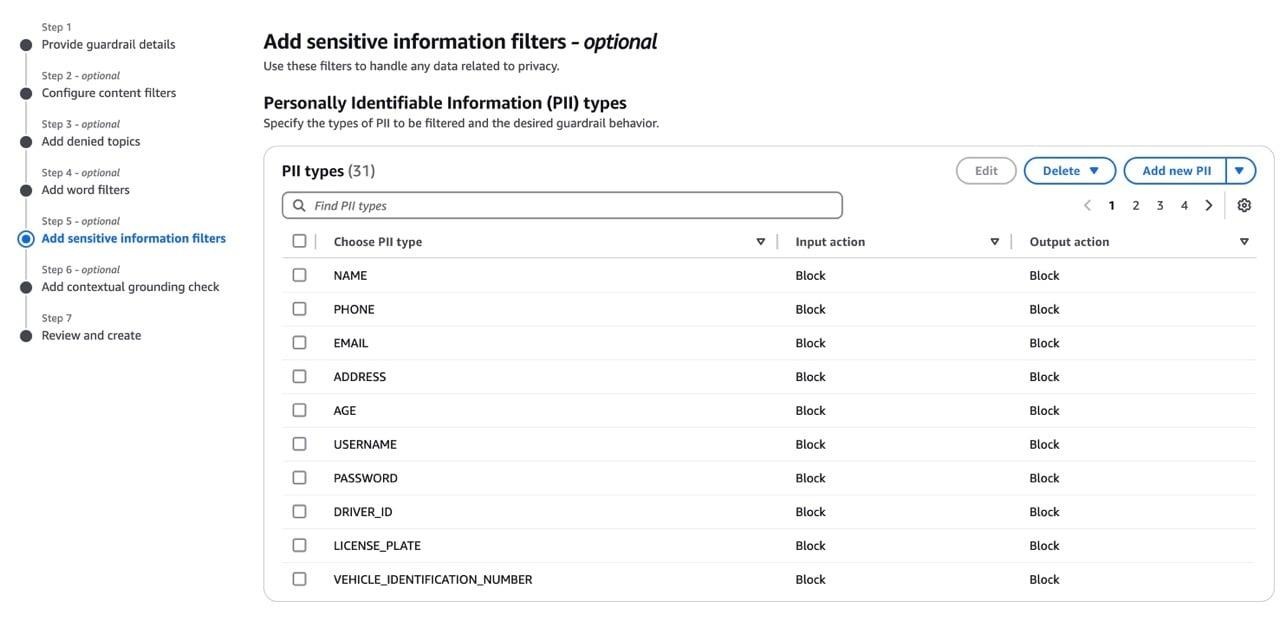
Twee ingebouwde functies dekken het grootste deel hiervan af. PII / PHI Detection detecteert namen, adressen, BSN's en medische dossiernummers met configureerbare entiteitscategorieën. Secrets Detection herkent AWS-keys, OpenAI- en Anthropic-API-keys, GitHub- en GitLab-tokens, JWT's, private keys, database-connection-strings en strings met een hoge entropie in de buurt van sleutelwoorden zoals api_key.
Secrets Detection is belangrijk om goed te begrijpen: het is de enige ingebouwde guardrail die op alle vier de hooks draait, waarbij elke hook een ander type probleem opvangt.
Het draait binnen de gateway zonder externe API-calls. In de mutate-modus worden gevonden gegevens vervangen door configureerbare tekst, standaard ***REDACTED***. Voor PII op self-hosted deployments werken Azure PII met uw eigen key, Presidio via een custom guardrail, of de filters van Bedrock allemaal prima.
Dit is waar de MCP-hooks hun waarde bewijzen. SQL Sanitizer vangt DROP, TRUNCATE, DELETE of UPDATE op zonder een WHERE-clausule, evenals string-interpolatie. Code Safety Linter vlagt eval, exec, os.system, subprocess-calls en gevaarlijke shell-opdrachten. Cedar en OPA passen een verfijnd policy-model toe op basis van default-deny voor MCP tool-calls.
Daaronder bevindt zich het toegangsmodel, de grootste helft van LLM06: tools kunnen worden uitgeschakeld zodat ze nooit verschijnen in tools/list, gevoelige calls kunnen een MCP Server Approver vereisen, en OAuth per gebruiker zorgt ervoor dat het bovenliggende systeem de werkelijke rechten van de actieve gebruiker evalueert in plaats van een gedeeld token. Ons artikel over MCP access control behandelt deze laag uitgebreid.
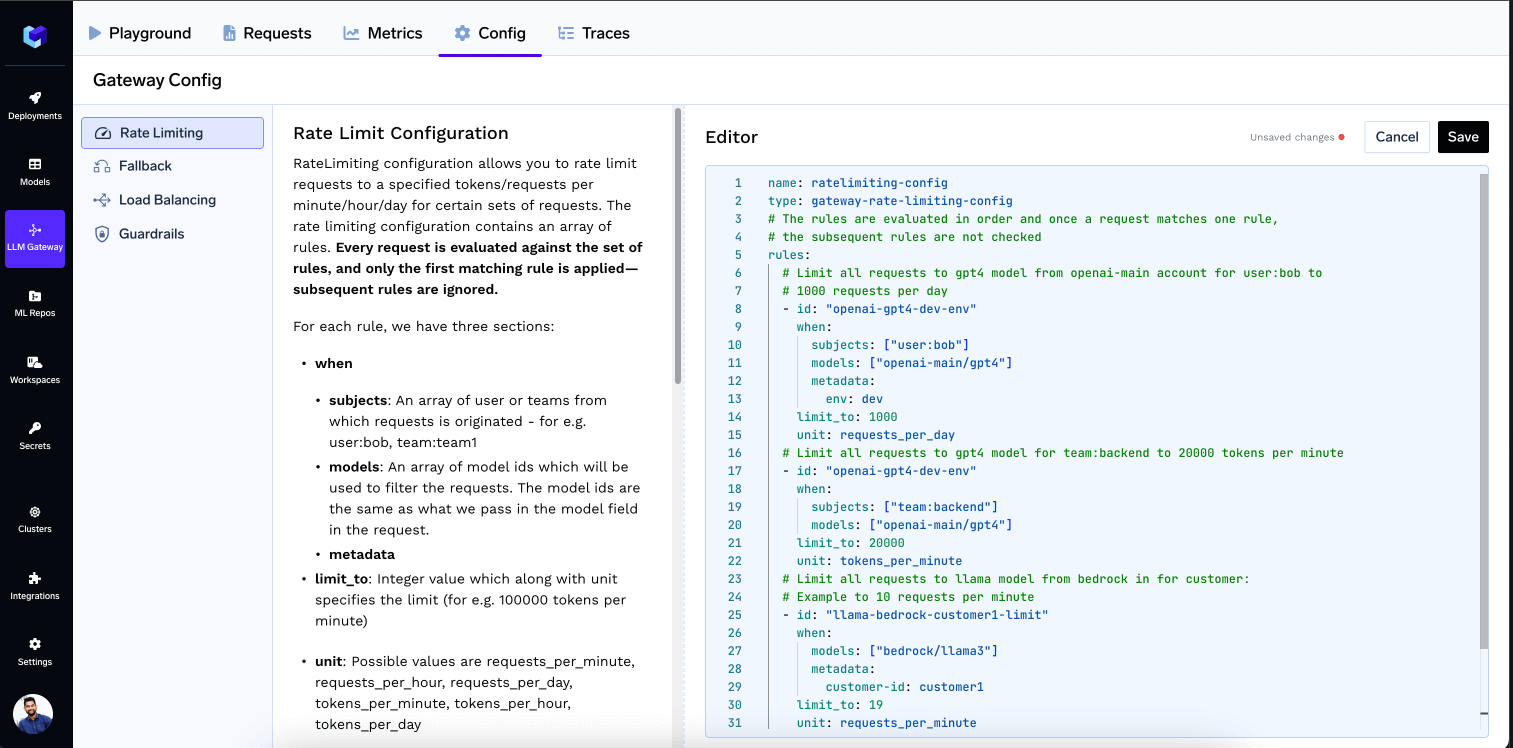
Dit is geen guardrail, maar betreft rate limiting en budgetconfiguratie, en biedt de meest complete dekking op de lijst. Regels matchen op subobject, model of metadata en begrenzen het aantal requests of tokens per minuut, uur of dag:
rate_limit_applies_per accepteert user, virtualaccount, model, of metadata.* (tot maximaal twee per regel), zodat elke entiteit zijn eigen teller krijgt in plaats van te concurreren om een gedeelde teller. De handhaving maakt gebruik van een sliding window; bij het overschrijden van een limiet wordt HTTP 429 geretourneerd met een x-tfy-applied-rules-header waarin de regel wordt genoemd:
LLM09 Misinformation is gedeeltelijk aan te pakken via externe providers - Patronus AI en Fiddler bieden evaluatoren voor hallucinaties en respons-getrouwheid op de output-hook. Zie deze als een signaal, niet als een definitieve oplossing.
LLM05 Improper Output Handling maakt gebruik van Code Safety Linter en Secrets Detection op de output-hook. Geen van beide vervangt de nodige validaties in uw eigen applicatiecode.
LLM03, LLM04 en LLM08 zijn de punten waar de mogelijkheden van de gateway ophouden. Supply chain is een vraagstuk voor inkoop en build-pipelines; de enige bijdrage van de gateway is het beheren van welke modellen en MCP-servers aanwezig zijn in uw registry. Poisoning vindt plaats tijdens de training. Vector weaknesses bevinden zich in een RAG-pipeline waar de gateway niet tussen zit. Als een leverancier iets anders beweert, vraag dan op welke hook de maatregel precies draait.
Neem een support-agent die tickets van klanten leest en via MCP queries uitvoert op een productie-database. Vier van de tien risico's zijn hier actief en vereisen vier verschillende maatregelen.
Stap een - registreer de guardrails. Maak een guardrail-groep aan en voeg Prompt Injection, PII Detection en Secrets Detection toe. Als er geen ingebouwde optie past, gebruik dan een Custom Guardrail die verwijst naar uw eigen HTTPS-endpoint:
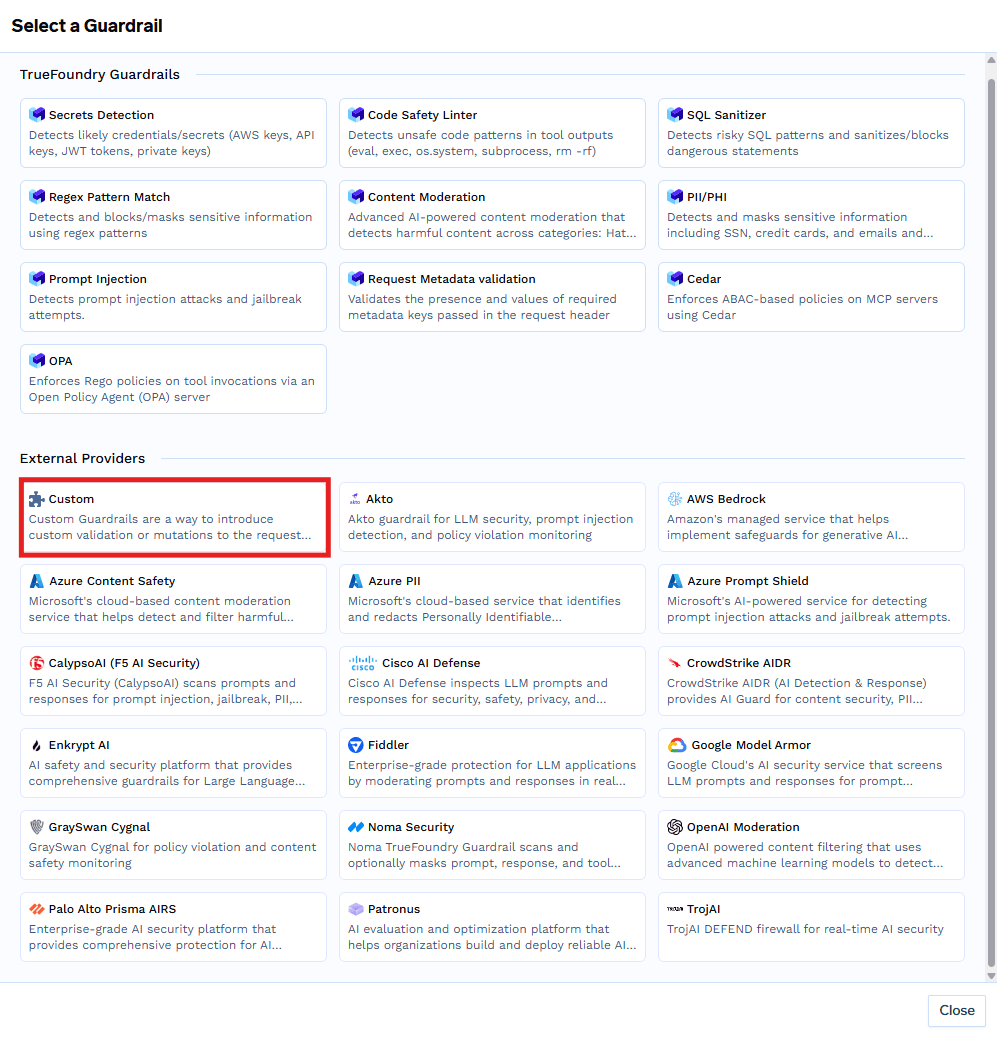
Een custom guardrail ontvangt de requestBody in OpenAI-formaat, een config-object dat in het formulier is ingesteld, en een context die het aanroepende subobject bevat. Voor MCP tool-guardrails bevat context.metadata ook een claims-object met geverifieerde claims uit de JWT van de aanroeper, zodat u kunt autoriseren op basis van applicatie of scope:
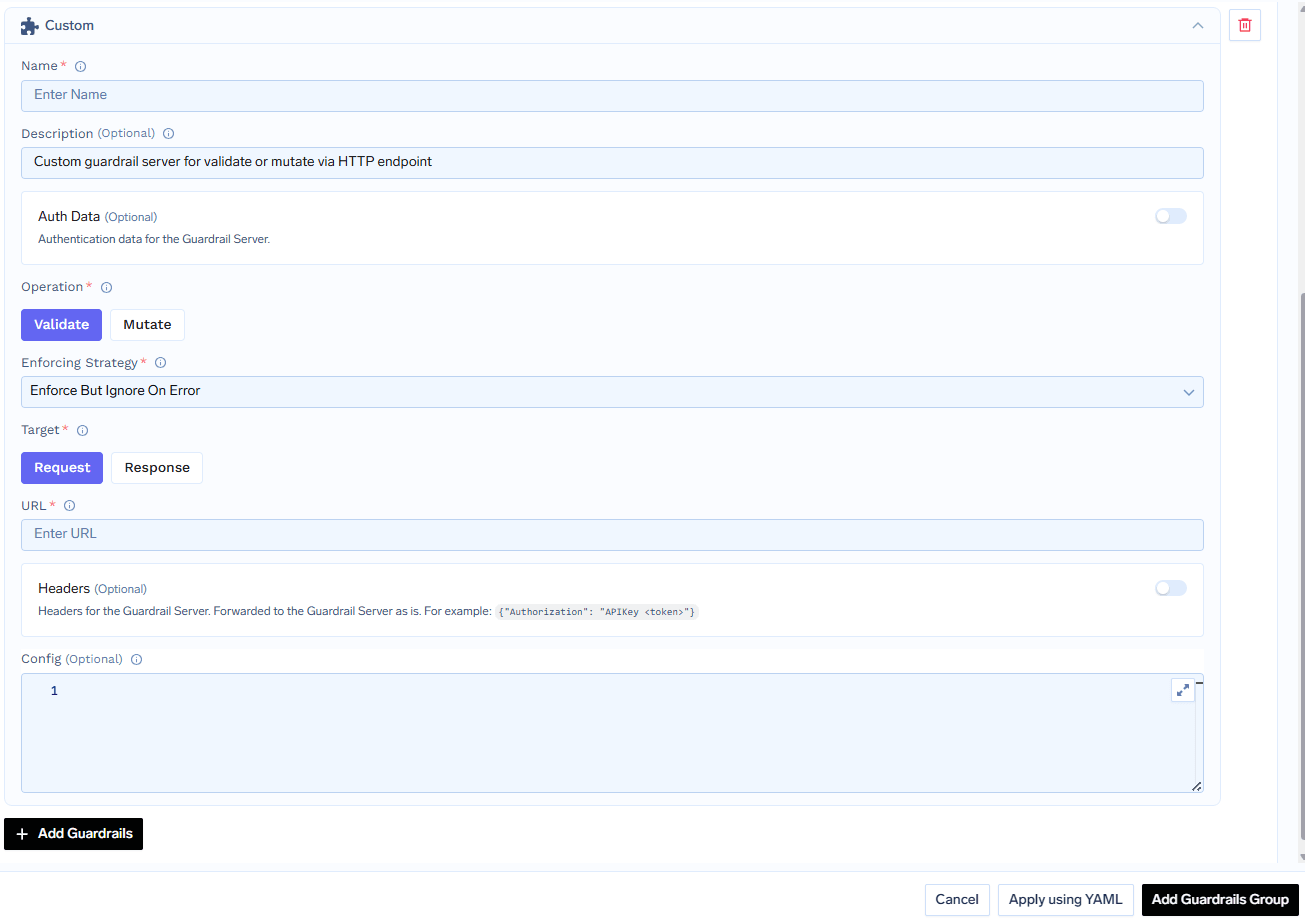
Er is één belangrijk detail over het contract waar men zich vaak op verkijkt: retourneer HTTP 2xx met verdict: false om een verzoek te weigeren. Een 400-respons wordt gelezen als een fout tijdens runtime, waardoor het verzoek onder enforce_but_ignore_on_error alsnog wordt doorgelaten.
Stap twee - schrijf de policy. Het registreren van een guardrail zorgt er niet voor dat deze automatisch op iets wordt toegepast. Maak onder Policies → Guardrails een regel aan die bepaalt welke guardrails op welke hooks draaien, voor welke modellen, MCP-servers, subobjecten en metadata.
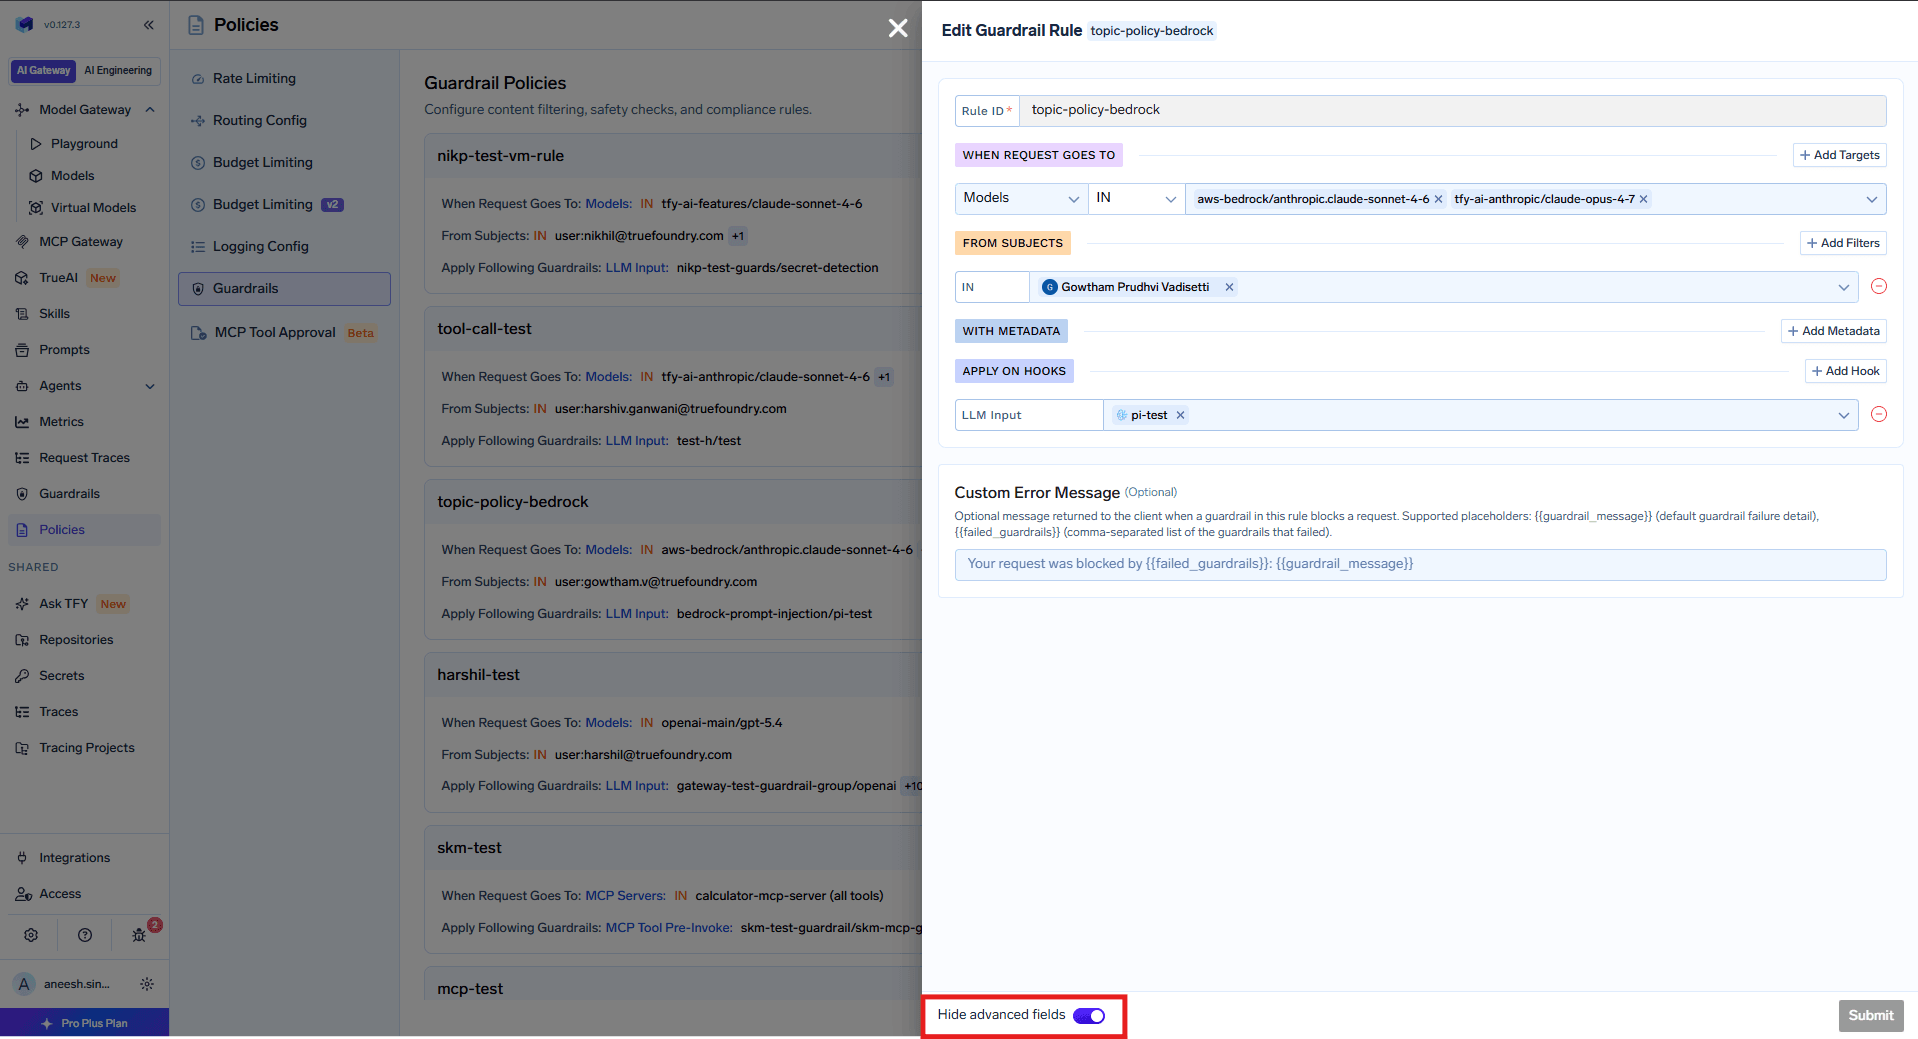
Voor deze agent geldt: Prompt Injection op LLM Input (LLM01); PII Detection op Input en Secrets Detection op Output (LLM02); SQL Sanitizer op MCP Pre-Invoke en Secrets Detection op Post-Invoke (LLM06). Een rate limit-regel met rate_limit_applies_per: ['user'] dekt LLM10 af.
Alle regels worden per request geëvalueerd en overeenkomende regels worden per hook samengevoegd. Zo zijn zowel een basisregel als een strengere productieregel tegelijk van toepassing. Een Custom Error Message waarin gebruik wordt gemaakt van {{failed_guardrails}} is duidelijker dan de ruwe output van de provider.
Stap drie - observeer voordat u vertrouwt. Start elke guardrail eerst in Audit-modus. Elk onderdeel verschijnt als een eigen span in Monitor → Request Traces, inclusief de latantie, het resultaat, de scope en de bevindingen:

Stap daarna over op Enforce But Ignore On Error. Dit blokkeert overtredingen zonder dat een storing bij de provider uw applicatie platlegt. Gebruik de volledige Enforce-modus alleen wanneer dit strikt vereist is voor compliance.
Output-guardrails draaien niet op gestreamde responsen. Wanneer stream: true is ingesteld, worden deze volledig overgeslagen. Het evalueren van een respons vereist immers de volledige tekst, terwijl streaming de tokens levert zodra ze gegenereerd worden. Dat is belangrijk voor de dekking van LLM02 en LLM05, omdat de chat-interfaces die tegenwoordig worden gebouwd standaard streamen. Zet stream: false waar output-controles essentieel zijn, valideer aan de client-zijde, of accepteer dat uw controles op de output-hook daar niet actief zijn. Input-guardrails blijven hierin ongewijzigd werken.
System prompts worden standaard uitgesloten van guardrails. De gateway verwijdert deze voordat de inhoud naar een guardrail wordt gestuurd, waardoor ze nooit worden geïnspecteerd, geblokkeerd of geredacteerd. CrowdStrike AIDR is hierop de enige uitzondering - deze ziet de system prompt wel, maar past deze nooit aan. Dit is handig om te weten voor LLM07: de gateway let op exfiltratiepogingen bij de inkomende stroom en op geheimen bij de uitgaande stroom, niet op de prompt zelf.
Waar validatiefouten geld kosten. Inputvalidatie draait parallel aan het model-request; als deze faalt, annuleert de gateway de lopende call zodat u niets betaalt. Outputvalidatie draait pas nadat de respons is binnengekomen - het blokkeren beschermt uw gebruiker, maar de tokens zijn op dat moment al verbruikt.
Drie ingebouwde opties zijn alleen beschikbaar voor SaaS. Content Moderation, PII / PHI Detection en Prompt Injection zijn niet beschikbaar op self-hosted deployments. Er zijn alternatieven - Azure Prompt Shield of Palo Alto Prisma AIRS voor injectie, Azure PII of CrowdStrike voor PII, OpenAI Moderations of Bedrock Guardrails voor moderatie - maar hiervoor heeft u uw eigen credentials nodig.
De OWASP LLM Top 10 is een waardevolle lijst die vaak verkeerd wordt toegepast. Als taxonomie laat het zien wat er mis kan gaan en in welke volgorde u aandacht aan de zaken moet besteden. Als een checklist die u met één aankoop afvinkt, levert het een matrix op die compleet lijkt, maar in de praktijk niets verdedigt.
De nuttige vraag is niet “dekt dit product de Top 10 af”, maar “welke van deze tien problemen spelen zich af in het request-pad, en is er iets dat daar actief controleert”. Dat geldt voor vier van de tien. Een gateway is de juiste plek voor die vier, en de enige plek waar u ze uniform kunt afdwingen over elk model, team en agent heen, in plaats van aan tien applicatieteams te vragen het allemaal zelf goed in te richten.
Zoek voor de overige zes risico's naar de verantwoordelijke binnen uw organisatie. Supply chain hoort bij degene die de modellen goedkeurt. Poisoning hoort bij degene die de trainingen uitvoert. Vector weaknesses horen bij degene die de index heeft opgebouwd. Noteer hun namen naast de betreffende risico's. Dat document is meer waard dan welke claim van een leverancier dan ook, inclusief die van ons.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



A consensus list of the ten most critical security risks in LLM applications, from the OWASP GenAI Security Project. The current version is the 2025 list: prompt injection, sensitive information disclosure, supply chain, data and model poisoning, improper output handling, excessive agency, system prompt leakage, vector and embedding weaknesses, misinformation, and unbounded consumption. It is guidance, not a certification - there is no audit to pass.
No. A gateway sits in the request path, so it addresses request-path risks well: prompt injection, sensitive information disclosure, excessive agency, and unbounded consumption. It partly helps with improper output handling, misinformation, and supply chain. Poisoning and vector weaknesses happen in training and retrieval pipelines a gateway never touches.
Vooral via LLM06 Excessive Agency en LLM01 Prompt Injection. Een MCP-tool-aanroep is waar een gecompromitteerde prompt verandert in een echte actie, dus de controles die ertoe doen zitten op het toolpad: een mcp_pre_tool-hook die argumenten valideert voor uitvoering, een mcp_post_tool-hook die resultaten opschoont voordat het model ze ziet, allowlisting op toolniveau, en goedkeuring op destructieve aanroepen. TrueFoundry draait guardrails op elke tool-aanroep afzonderlijk, niet één keer per gesprek.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















