



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Elke andere AI-workload draait op infrastructuur die uw eigendom is — uw cluster, uw netwerkbeleid, een credential die u kunt roteren. Codex is een CLI-proces op de laptop van een developer dat een TOML-bestand in hun home-directory leest en rechtstreeks communiceert met een model provider. Vijf eigenschappen maken dit een heel ander type probleem:
De gebruikelijke reflex is een beleidsdocument. Dat mislukt om één reden: alles wat daarin wordt gevraagd, staat in een bestand dat de developer kan bewerken.
Vier eigenschappen moeten bij elk request gelden:
Een gateway biedt u alle vier — maar alleen als de client daarnaar wijst en daarnaar blijft wijzen. Er zijn drie benaderingen daarvoor, en slechts één daarvan is enforcement:
Het vergrendelen van het bestand zonder de token te roteren pakt manipulatie aan, maar negeert diefstal van credentials; roteren zonder vergrendelen doet het omgekeerde. U heeft beide nodig.
Het account bij de model provider zien als het controlepunt. Identiteit, SSO, workspace-lidmaatschap en beheerdersconsole-beleid voor Codex bevinden zich in de console van OpenAI, niet in uw gateway — net zoals de bewaartermijn van prompts en outputs, die "wordt beheerd door uw overeenkomst met OpenAI". Een gateway beheert routing, uitgaven, guardrails en de eigen logging, niet uw providercontract.
Ervan uitgaan dat één MDM-push gelijkstaat aan permanente enforcement. Clients wijzigen de configuratieprioriteit tussen releases. Codex v0.149.0 heeft managed_config.toml op Windows volledig laten vallen — het negeert het bestand nu met een opstartwaarschuwing (Ignoring deprecated managed config file), zonder equivalent in het register. Een fleet die vóór die release is geconfigureerd, is niet onderworpen aan enforcement en meldt geen fout.
Een gedeelde API key uitrollen. De snelste manier om dertig developers aan het werk te krijgen, en het vernietigt direct elke downstream control. U kunt een persoon niet rate-limiten of de vraag "wie heeft die prompt verzonden" beantwoorden vanuit een tenant-brede credential.
Codex behandelt de TrueFoundry AI Gateway als een model provider; al het andere vloeit voort uit het feit dat verkeer aankomt op een plek die u beheert. De gateway-details zijn afkomstig uit het codesnippet in de UI.
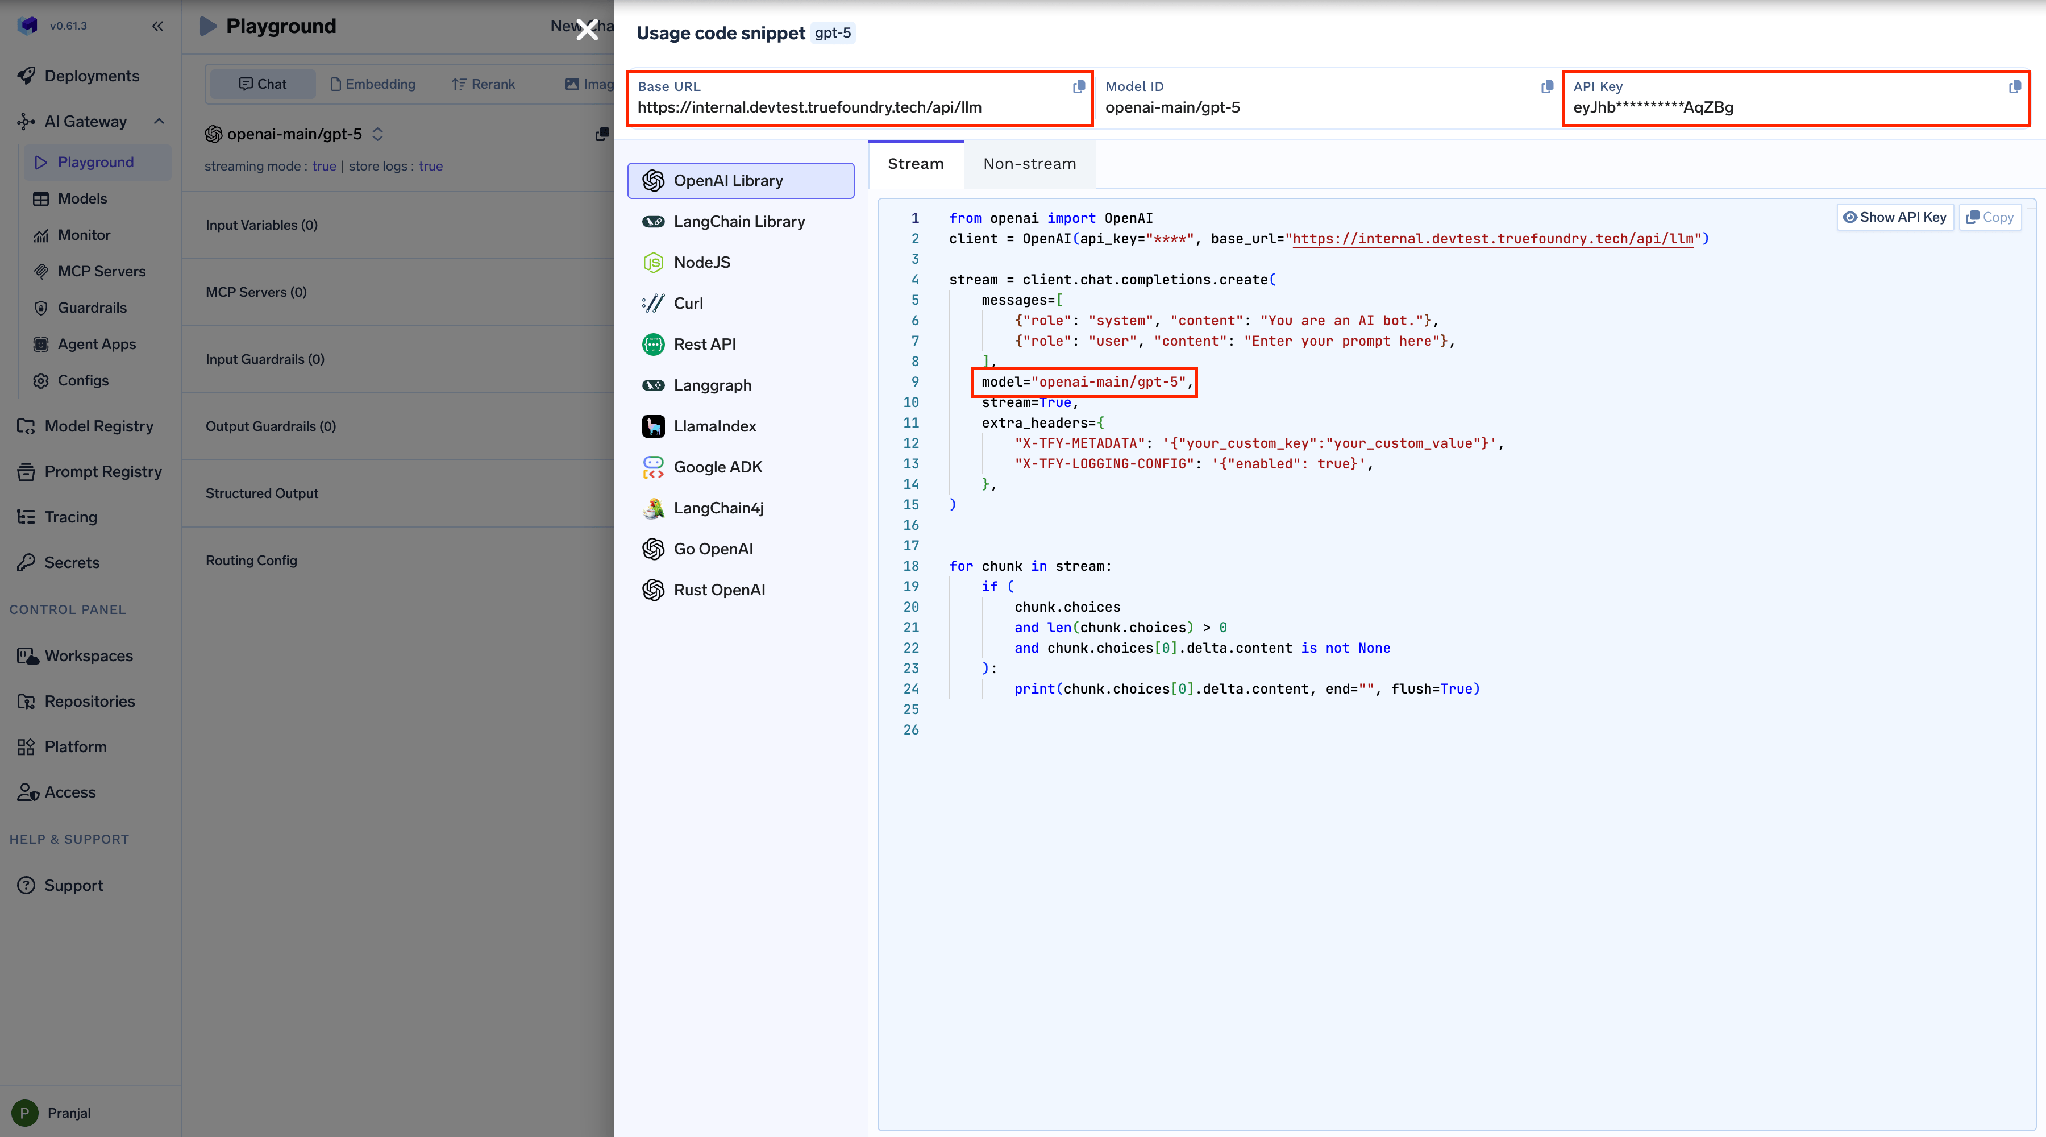
De vorm voor één developer: de token gaat in Authorization en de gateway herleidt deze naar een persoon.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer TFY_API_KEY"
Het ChatGPT-abonnement van de developer betaalt voor inference en de gateway beheert nog steeds het verkeer. Twee dingen veranderen: requires_openai_auth = true is vereist, en de TrueFoundry-credential verhuist van Authorization naar x-tfy-api-key, omdat Codex Authorization nodig heeft voor de eigen ChatGPT OAuth-token.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
requires_openai_auth = true
[model_providers.truefoundry.http_headers]
x-tfy-api-key = "TFY_API_KEY"
Maak aan de gateway-zijde een provider aan onder Integrations → Providers van het type OpenAI, base-URL https://chatgpt.com/backend-api/codex, en laat het veld voor de API key leeg.
Het lege veld is het signaal, geen omissie. Als er een opgeslagen key aanwezig is, gebruikt de gateway die in plaats van de ChatGPT-credentials van de developer — waardoor de abonnementsflow wordt onderbroken en het verkeer mogelijk onder het verkeerde account wordt gerouteerd. Een beheerder die dat veld "behulpzaam" invult, verandert dertig individueel toegewezen developers in één anonieme API-key-tenant, zonder dat er foutmeldingen verschijnen.
Wanneer u het leeg laat, krijgt u dubbele toewijzing: TrueFoundry registreert de developer via x-tfy-api-key, OpenAI wijst het gebruik toe aan hun ChatGPT-seat. Model-IDs zien eruit als chatgpt-codex/gpt-5.2-codex.
Twee beperkingen vloeien voort uit het feit dat de credential is gekoppeld aan één ChatGPT-account. Slechts één van de targets van een virtueel model kan een ChatGPT-abonnementsmodel-account zijn; targets op basis van een API key kunnen er naast bestaan. En een 401, 403 of 429 per developer plaatst het gedeelde target niet in de load-balancer-cooldown, dus de verbruikte quota van één developer kan geen invloed hebben op iemand anders.
(De documentatie spreekt zichzelf tegen over welke abonnementen in aanmerking komen: de enterprise-security-pagina vermeldt Business of Enterprise, de CLI-pagina vermeldt ook Personal. [VERIFIËREN] alvorens een tier te garanderen.)
Dit is de regel die teams verkeerd kopiëren en vervolgens een middag lang zitten te debuggen. De gateway voegt het /responses-endpoint alleen toe voor de Responses-wire. Stel wire_api = "chat" in en het request gaat naar /chat/completions tegen dezelfde base-URL, wat geen geldig endpoint is voor Codex-verkeer. Dit is tevens wat ervoor zorgt dat gpt-5.x-codex thinking-tokens correct werken.
De Codex CLI-pagina formuleert het wat milder — responses voor gpt-5.x-codex, chat voor andere modellen. Ze komen overeen: voor modellen uit de Codex-familie is de Responses-wire verplicht.
Codex stuurt thinking-tokens naar bepaalde modellen en identificeert deze door de model-string te vergelijken. Volledig gekwalificeerde namen — openai-main/gpt-5, azure-openai/gpt-5 — komen niet overeen, waardoor feature-detectie mislukt.
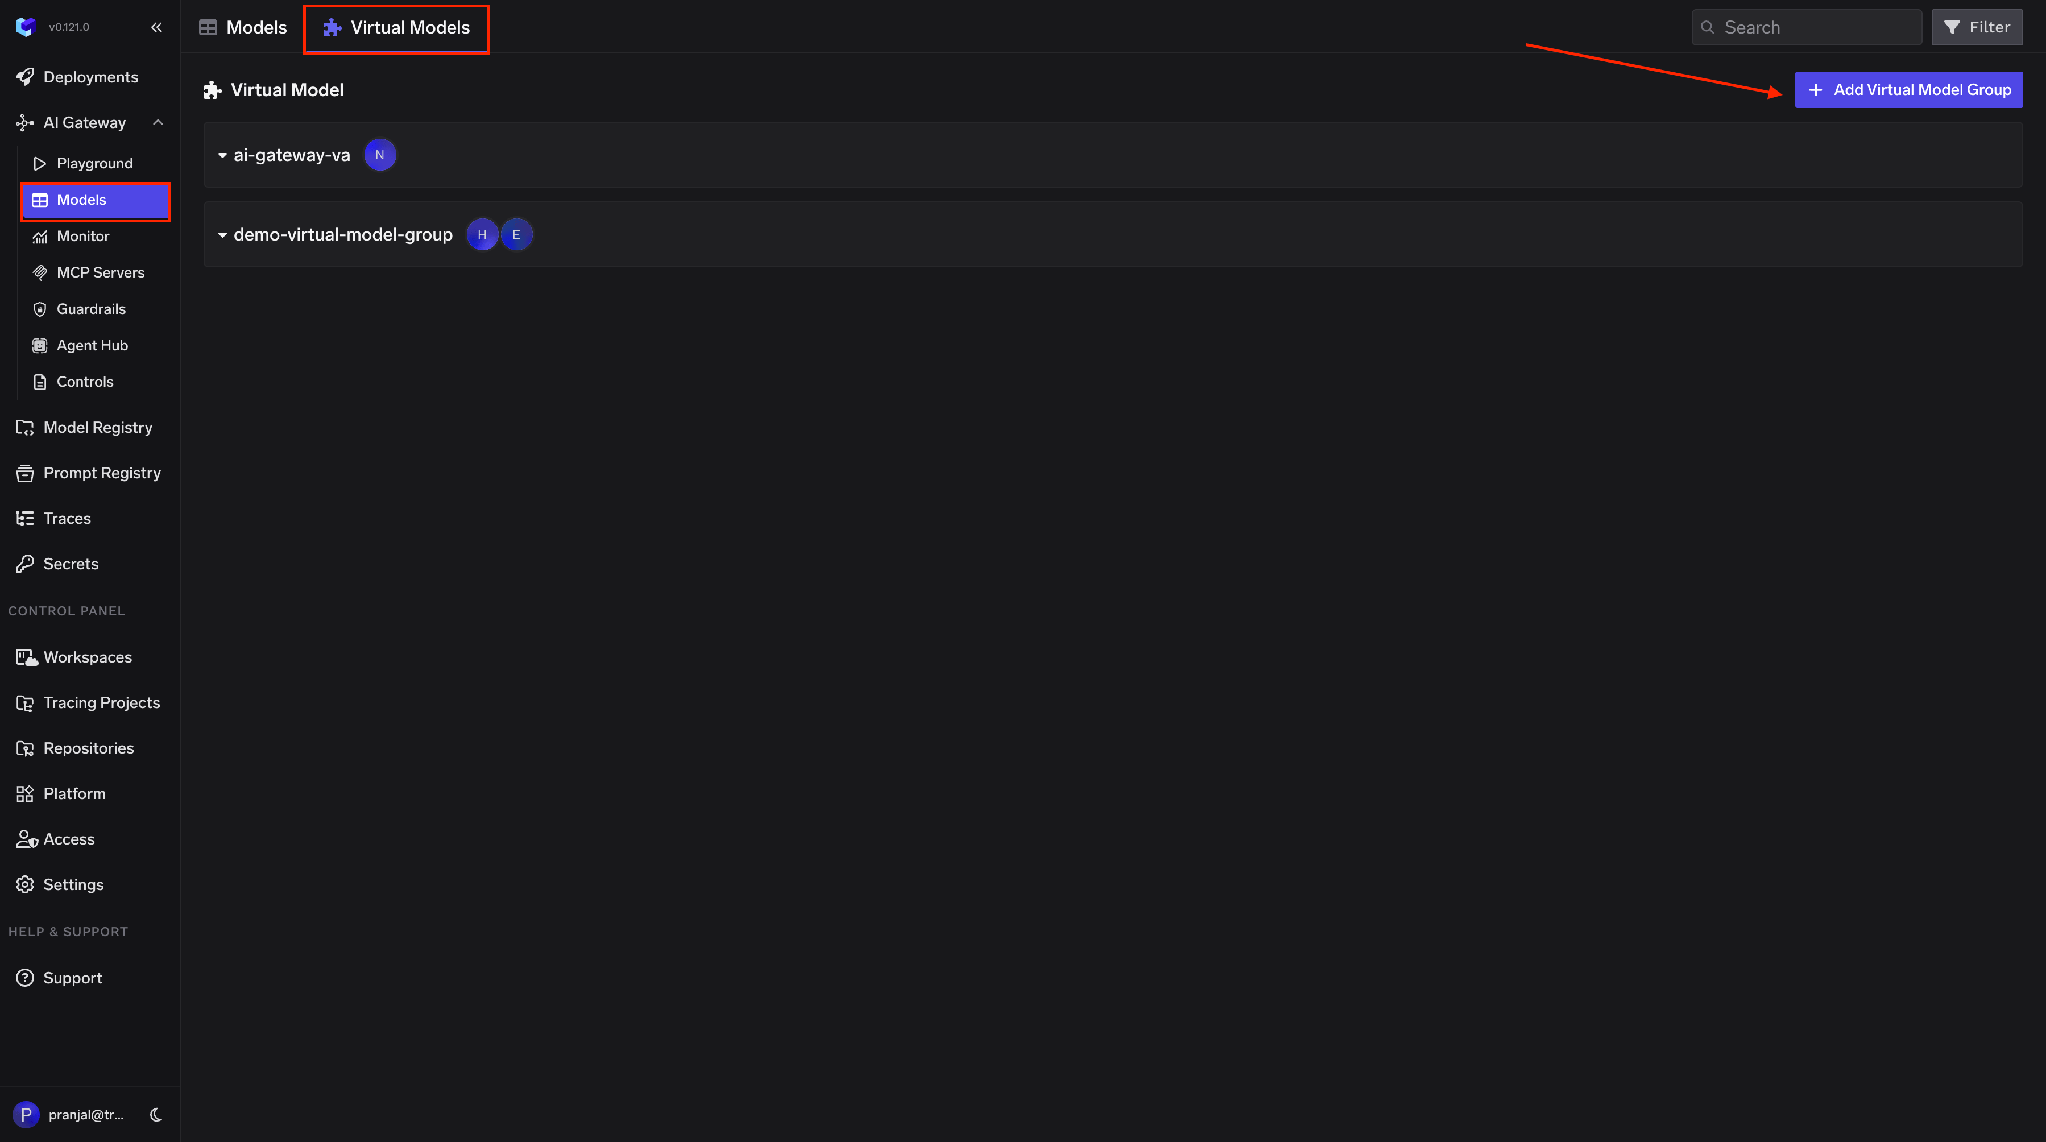
De regel: gebruik een slug die overeenkomt met de daadwerkelijke model-ID, bijv. gpt-5.2-codex. Codex herkent die IDs en schakelt de juiste functies in. Zet de volledig gekwalificeerde naam niet in de Codex-configuratie.
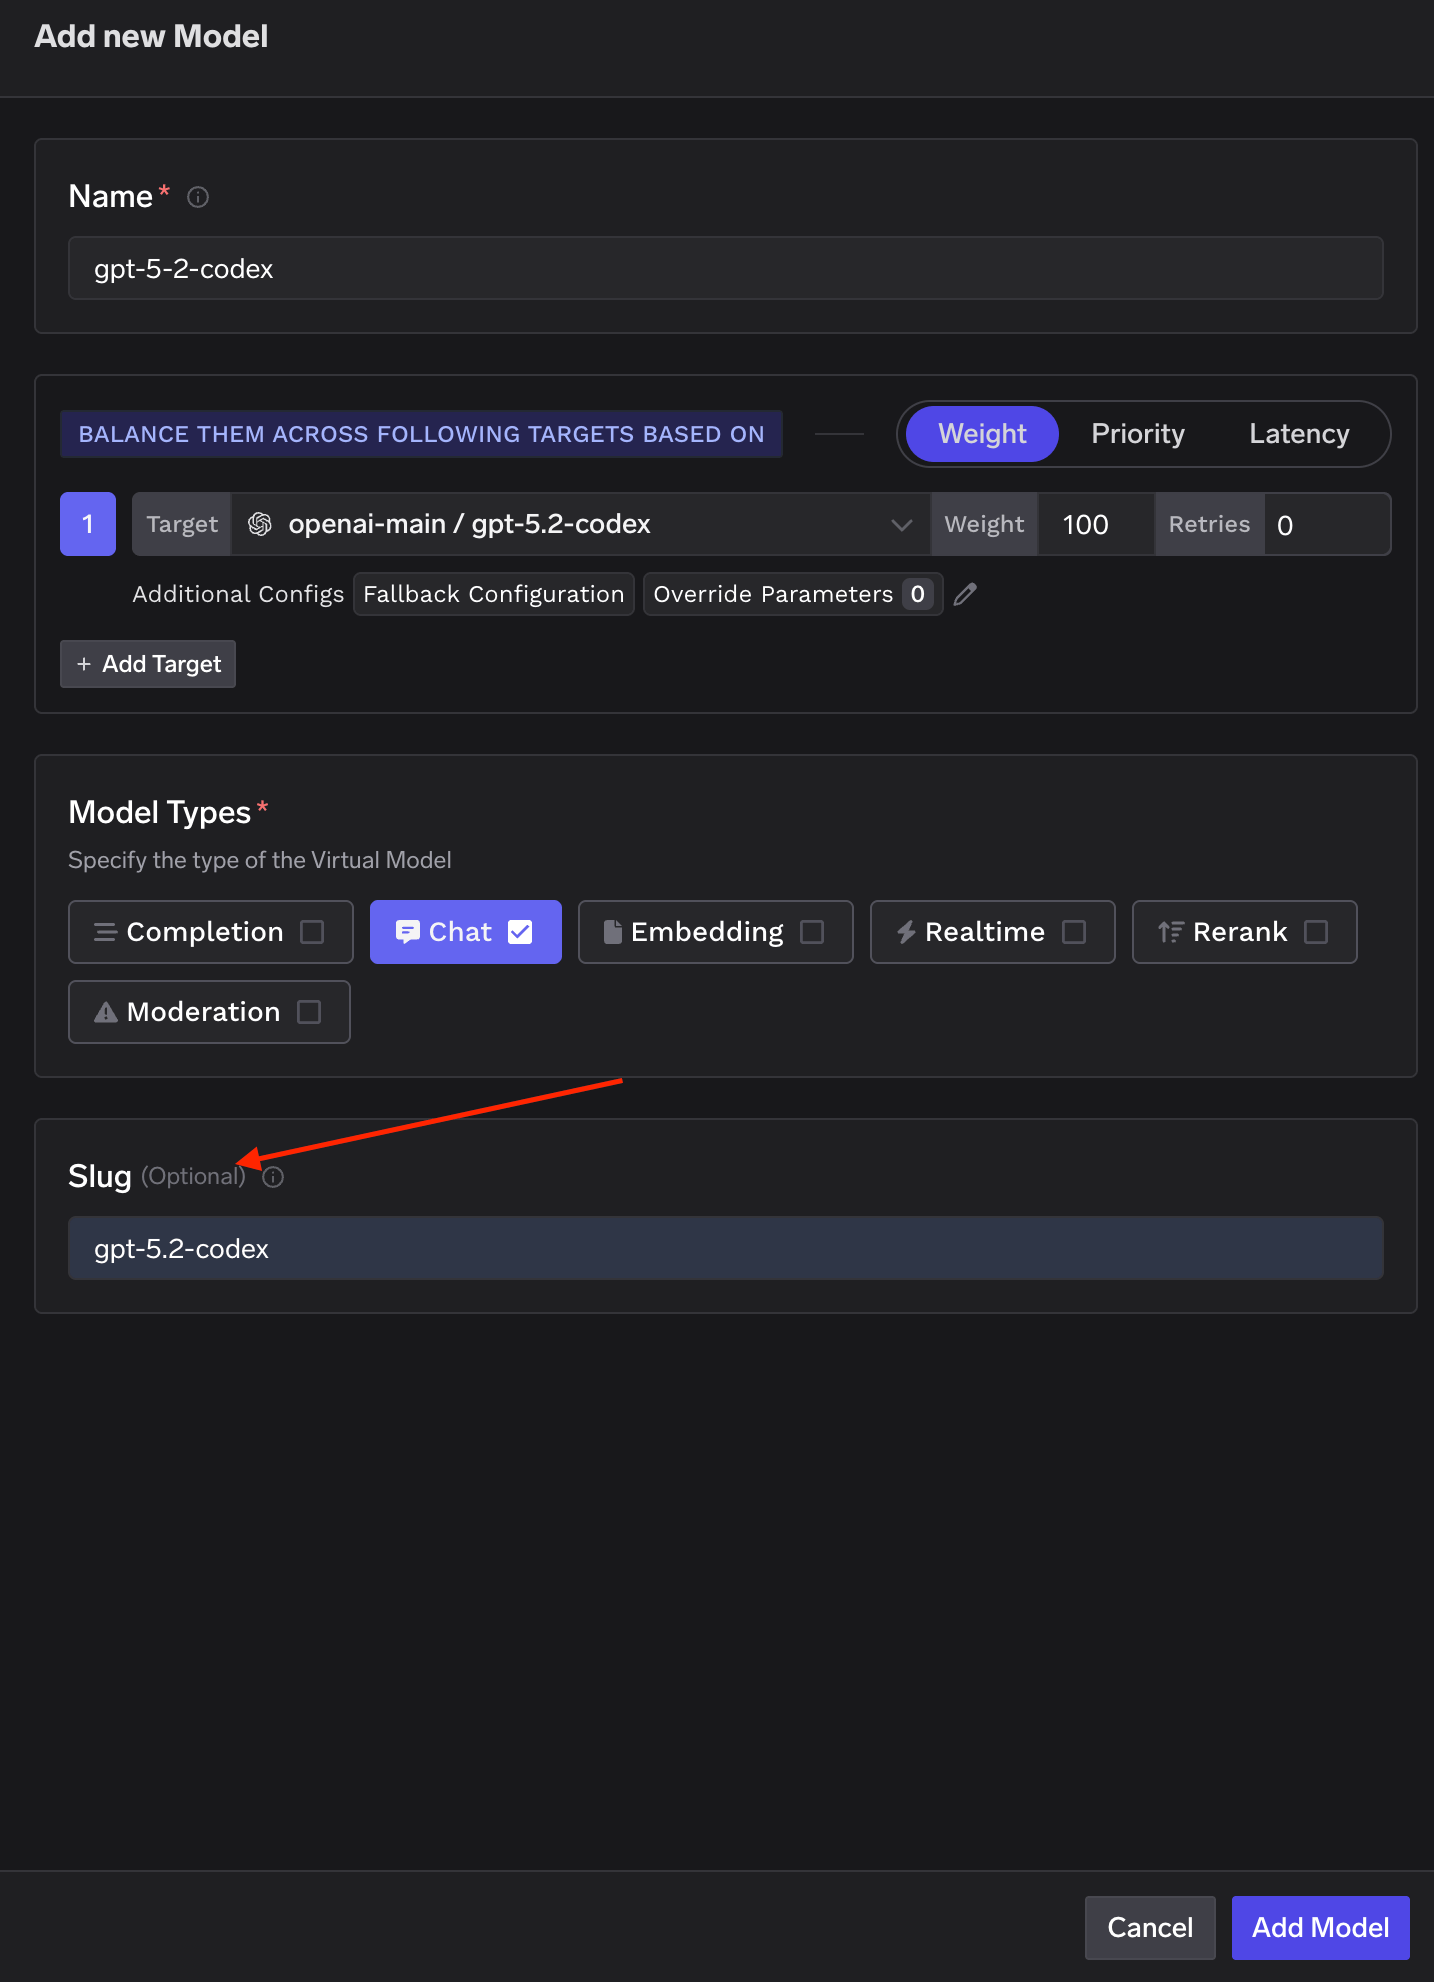
Slugs zijn uniek binnen de tenant en worden ingesteld in de Virtual Model Provider Group settings. Zowel de slug als het volledige groep/model-pad werken in een request body; Codex heeft de slug-vorm nodig.
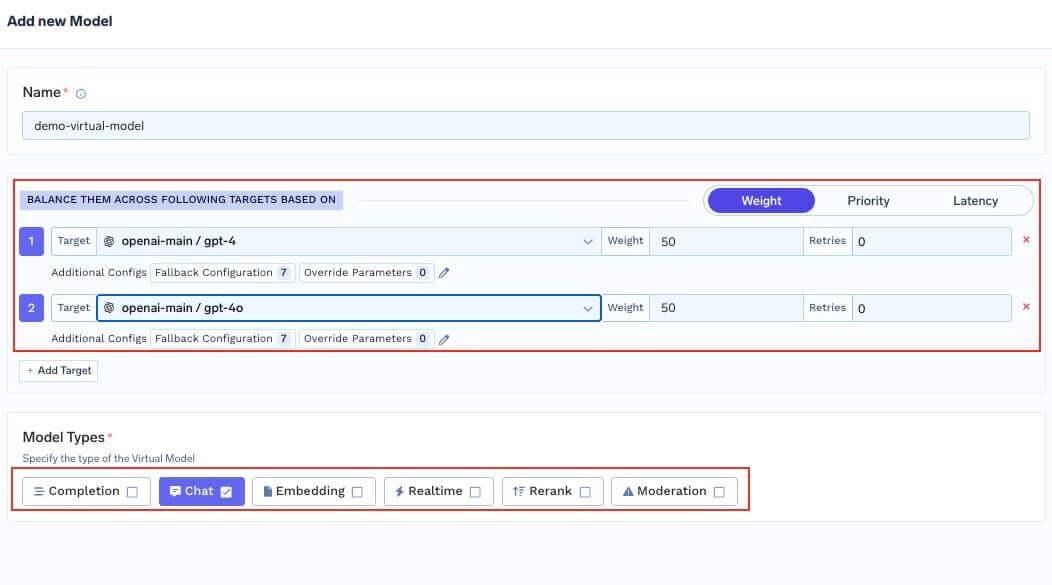
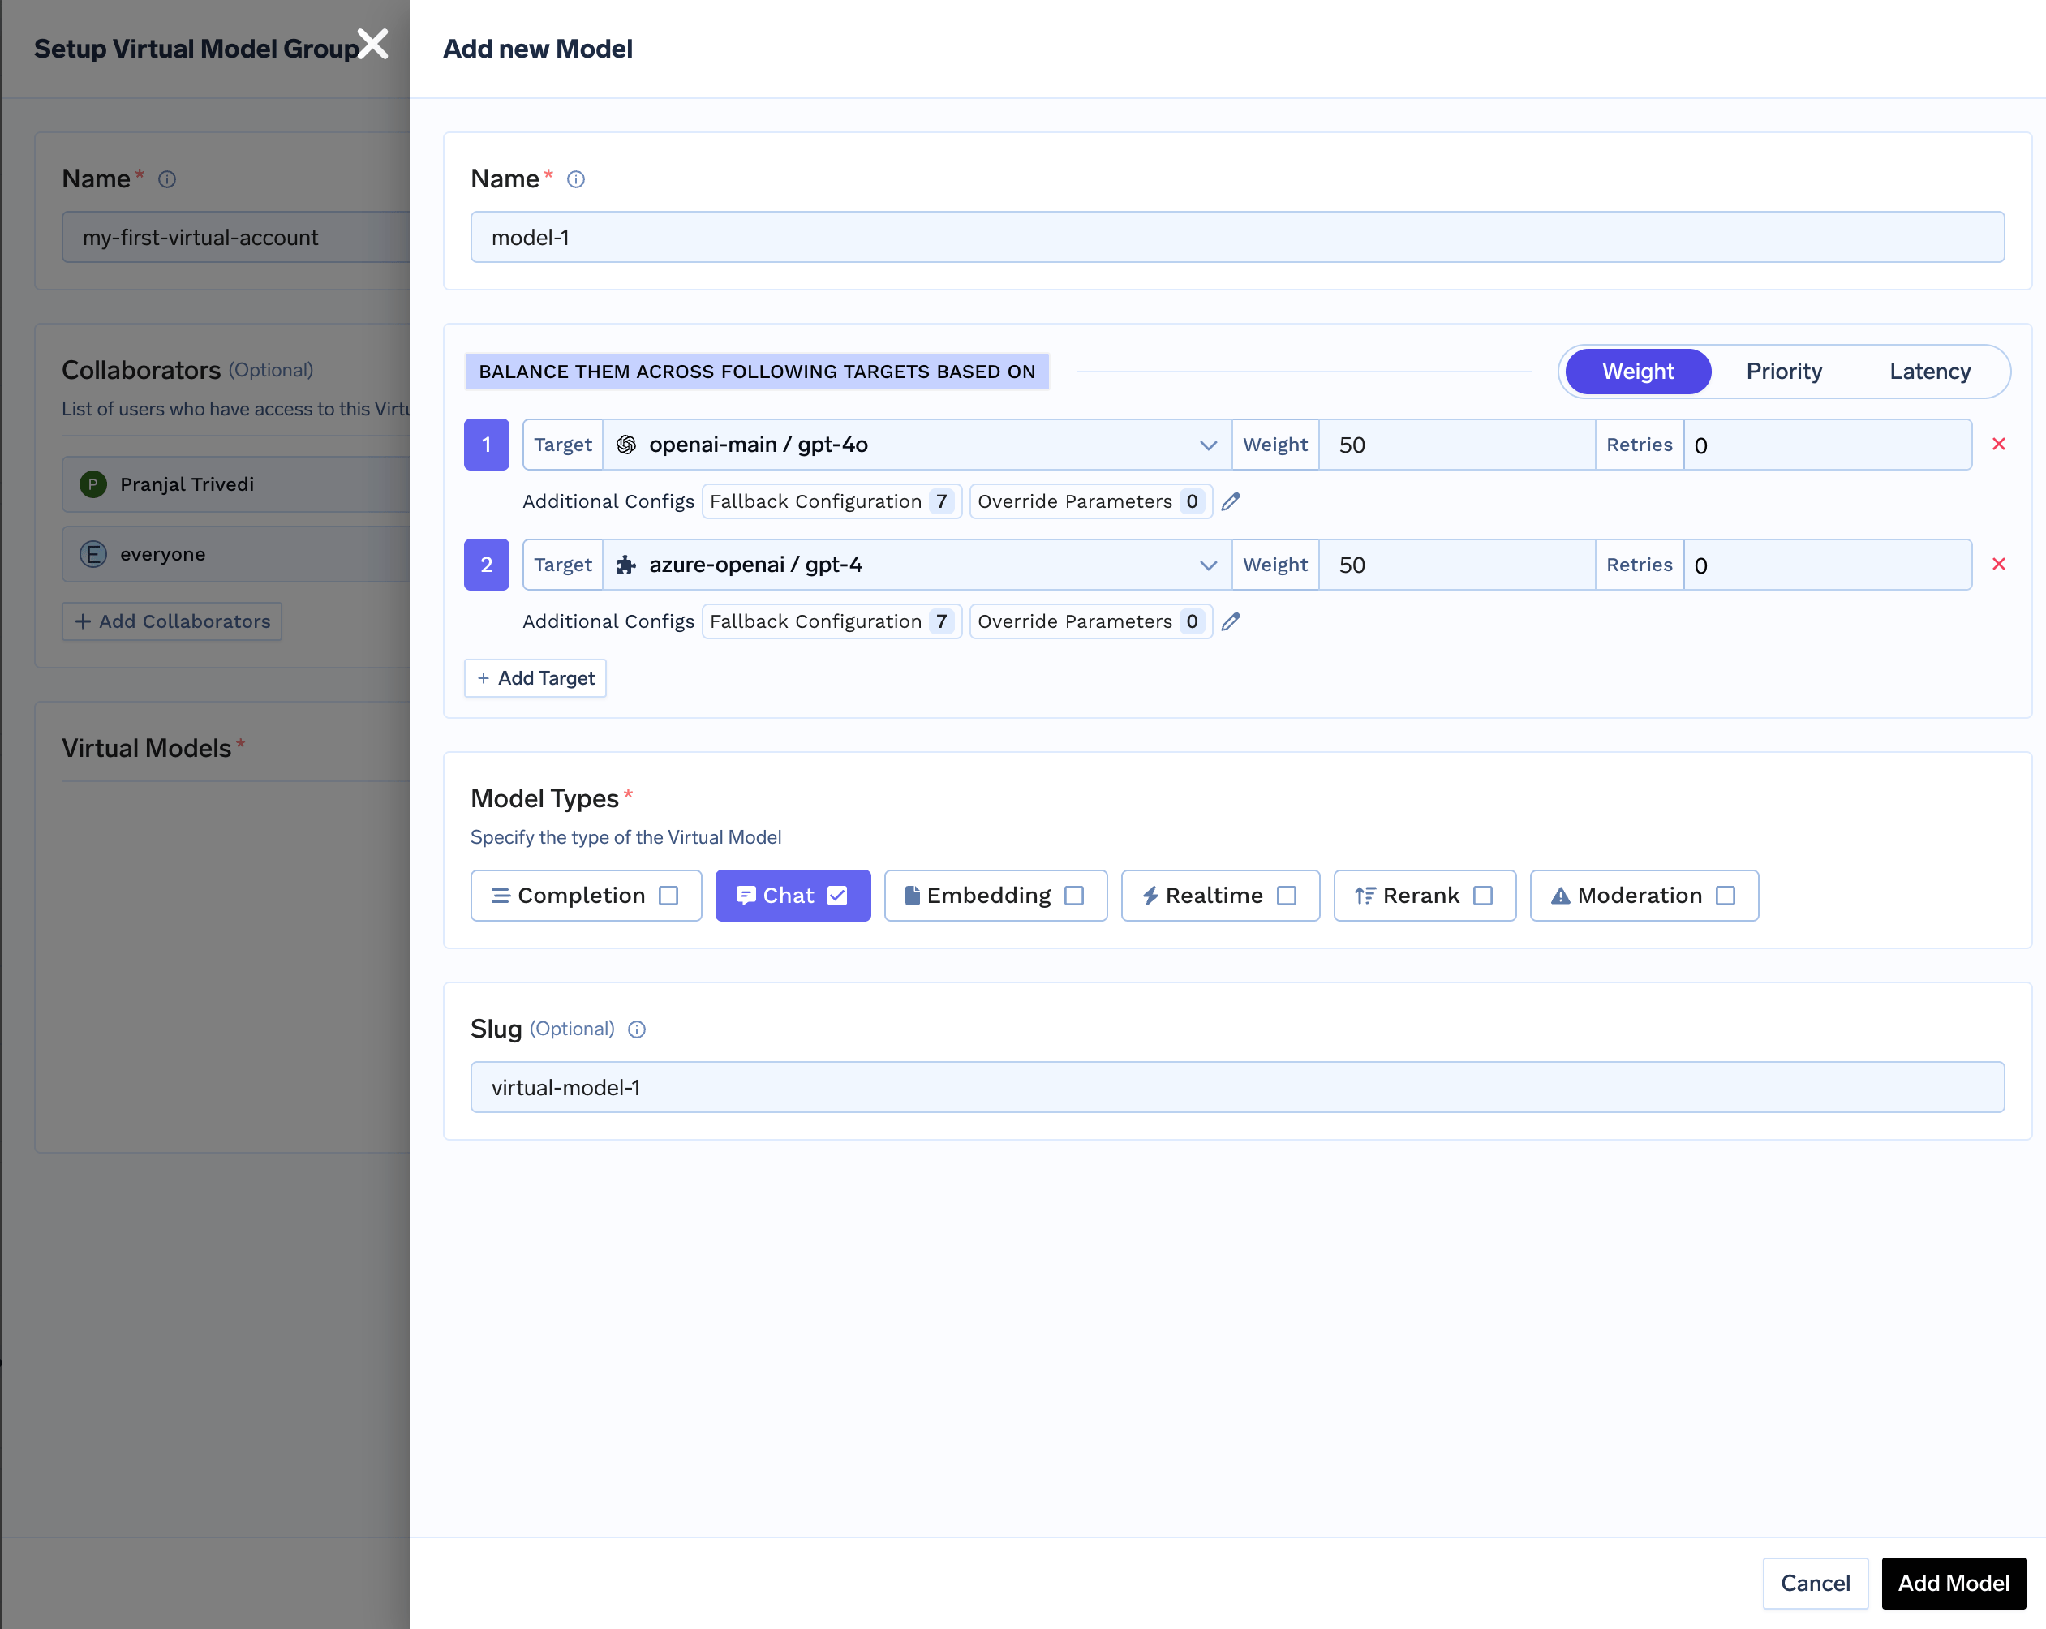
Achter één slug kunt u targets wegen — openai-main/gpt-5 op 70, azure-openai/gpt-5 op 30 — en de verhouding aanpassen zonder een laptop aan te raken, zoals bij model deprecations and staged cutovers.
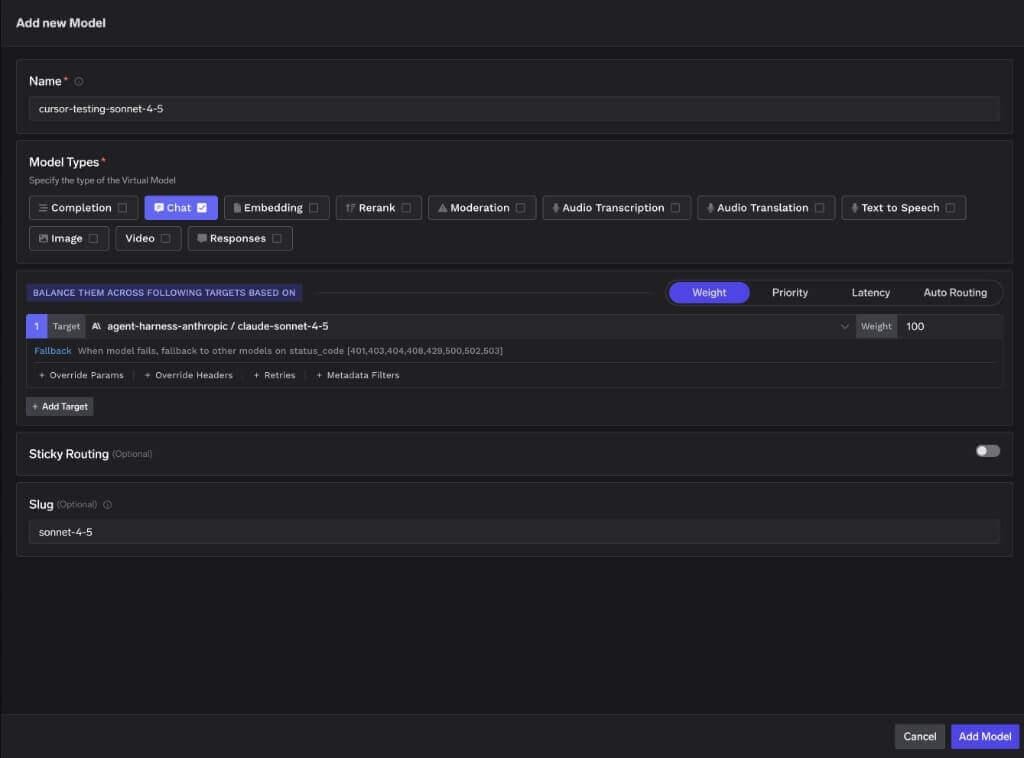
De naamgeving van slugs is ook het punt waar clients sterk van elkaar verschillen. Cursor kiest het request-formaat op basis van trefwoorden in de slug en wisselt stilzwijgend van formaat als de slug anthropic, claude, openai, gpt, gemini of vertex bevat. Codex wil de model-ID in de slug; Cursor wil die trefwoorden er juist uit.
Een configuratie per ontwikkelaar is een gedocumenteerde instelling, geen beheersmaatregel. Fleet-handhaving maakt gebruik van tfy-local-ai-setup, een binary die door uw MDM wordt gepusht en als root (Administrator op Windows) wordt uitgevoerd met een aanbevolen uurlijkse frequentie, vanaf github.com/truefoundry/tfy-local-ai-setup/releases; de Codex-scripts pinnen RELEASE_TAG="v1.3.5". Elke uitvoering doet vier dingen:
Stap drie is het belangrijkst. De laptop bevat nooit een langdurig gateway-token: het refresh-token is 30 dagen geldig vanaf de laatste uitgifte, elke succesvolle uitvoering roteert het, en de authenticatiegegeven in de beheerde configuratie is vers opgehaald en afgestemd op de identiteit van die gebruiker.
Vereiste configuratie: GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME. Optioneel: CODEX_GATEWAY_URL, CODEX_AUTH_MODE, CODEX_DEFAULT_MODEL, CODEX_SETTINGS_FILE. CODEX_AUTH_MODE="api-key" is de standaard; "chatgpt-subscription" zorgt ervoor dat de binary requires_openai_auth = true schrijft en het token verplaatst naar x-tfy-api-key. Machines zonder Codex vormen een schone no-op — de binary slaat ze over en sluit af.
Op macOS en Linux wint het admin-bestand, dat bij elke opstart opnieuw wordt toegepast:
/etc/codex/managed_config.toml → ~/.codex/config.toml → CLI flags
model_provider = "truefoundry"
model = "gpt-5.2-codex"
[model_providers.truefoundry]
name = "TrueFoundry Gateway"
base_url = "https://<your-truefoundry-gateway-url>"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer <freshly-fetched-tfy-token>"
De model-sleutel op hoogste niveau wordt alleen geschreven wanneer CODEX_DEFAULT_MODEL is ingesteld; indien niet ingesteld, blijft de modelkeuze bij de ontwikkelaar terwijl de provider gehandhaafd blijft.
Op Windows veranderen het bestand, de volgorde en het schema allemaal.
C:\ProgramData\OpenAI\Codex\requirements.toml → ~/.codex/config.toml → CLI flags → C:\ProgramData\OpenAI\Codex\config.toml
Let op de laatste positie: Windows config.toml is de machine-standaard met de laagste prioriteit van de vier, dus het eigen bestand van een ontwikkelaar wint hiervan. requirements.toml wint van alles. Het provider-blok komt overeen met macOS; de model-pin niet:
# C:\ProgramData\OpenAI\Codex\requirements.toml
model_provider = "truefoundry"
# ... dezelfde [model_providers.truefoundry] en http_headers blokken ...
[models.new_thread]
model = "gpt-5.2-codex"
Het requirements-schema heeft geen model-sleutel op het hoogste niveau. CODEX_DEFAULT_MODEL komt in plaats daarvan onder [models.new_thread]. Als u het macOS-blok ongewijzigd naar Windows kopieert, doet de model-pin stilzwijgend niets.
Twee versienummers bepalen of dit allemaal echt werkt op Windows. v0.149.0 heeft managed_config.toml daar laten vervallen. v0.156.0 is het minimum voor handhaving — Codex respecteert model_provider in requirements.toml pas vanaf die build; oudere builds vallen terug op het config.toml met de laagste prioriteit, dat een ontwikkelaar vanuit zijn home-directory kan overschrijven. Controleer codex --version voordat u Windows als beheerd beschouwt. Windows Codex-beheer in de setup-binary is beschikbaar vanaf tfy-local-ai-setup v1.3.5.
Vergrendeling verandert het bestand in een beheersmaatregel:
Op macOS is /etc/codex/ root:wheel 755 en is het bestand root:wheel 644 plus schg — root zelf moet chflags noschg uitvoeren om het te bewerken.
De Windows ACL-waarschuwing verdient een eigen regel. C:\ProgramData\OpenAI\Codex\ is eigendom van Administrators met gestripte overerving: SYSTEM en Admins volledig, Users lezen; beide TOML-bestanden SYSTEM volledig, Admins lezen, Users lezen. De reden is hard — ProgramData stelt elke geauthenticeerde gebruiker in staat om mappen aan te maken, en Codex laadt elke configuratie die het daar vindt, in plaats van een door de gebruiker beschrijfbare te weigeren. Versoepel die ACL niet; een al te permissieve directory verandert een gehandhaafde configuratie stilzwijgend in een suggestie.
Codex bereikt het open web op twee manieren. Door de provider gehoste zoekopdrachten sturen de Responses API web_search-tool, inclusief op ondersteunde modellen op AWS Bedrock Mantle — snel, maar het gedrag varieert per provider en het is geen tool call die u beheert. MCP web search — Tavily of Exa achter de TrueFoundry MCP Gateway — wordt aanbevolen voor consistentie, omdat MCP-tools client-side draaien in het Codex-proces, ongeacht naar welk model de gateway routeert.
[mcp_servers.web-search]
url = "https://<gateway>/<tenant>/mcp/<mcp-server-name>/server"
http_headers = { Authorization = "Bearer TFY_API_KEY" }
Gebruik bearer_token_env_var = "TFY_API_KEY" in plaats van het token inline op te nemen. Om door de provider gehoste zoekopdrachten uit te schakelen, stelt u web_search = "disabled" in in ~/.codex/config.toml — dit schakelt alleen het door de provider gehoste pad uit; de MCP-server blijft werken totdat u het bijbehorende [mcp_servers.<name>]-blok verwijdert. Het registreren van zoeken als een MCP-server is ook wat dat tool-verkeer bestuurbaar maakt onder MCP gateway access control.
Omdat elke completion de gateway passeert, bestaat het auditspoor of de ontwikkelaar dat nu wil of niet — elke request in Request Traces met de opgeloste gebruiker, het geleverde model, tokens en latency.
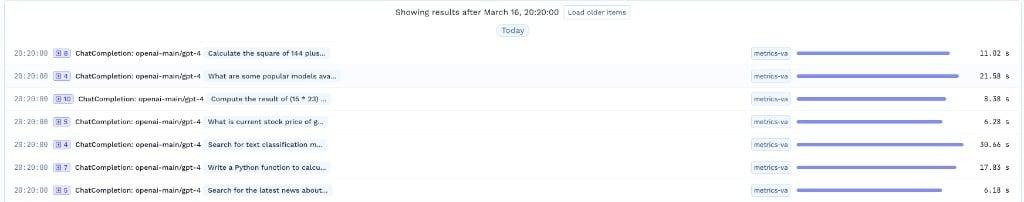
Daarboven aggregeert het metrics-dashboard de hele fleet: uitgaven en volume per gebruiker, team en model.
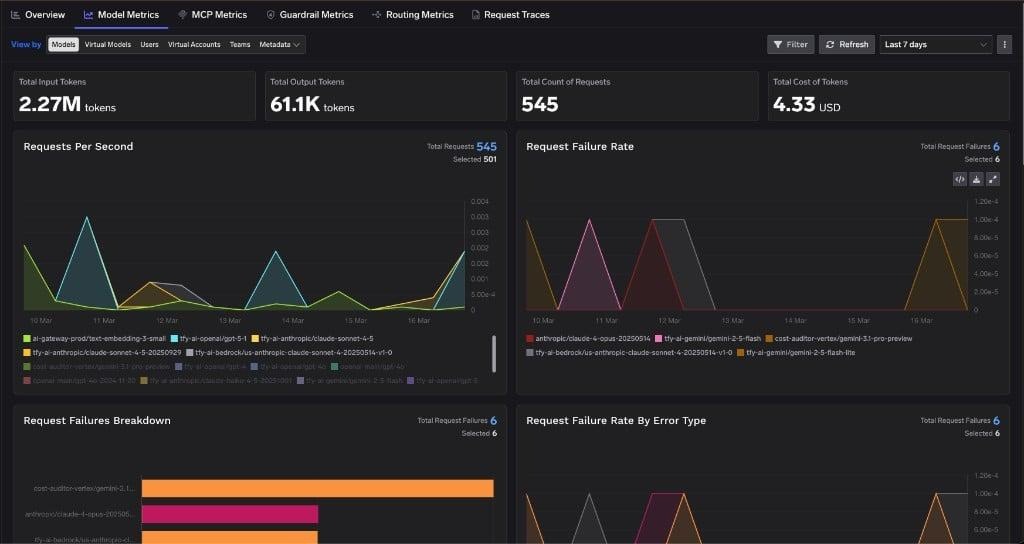
Elke coding-client op de gateway belandt in dezelfde weergave — één kostenbeeld in plaats van vier, zoals in centralising cost control across AI coding IDEs.
Twee honderd engineers, macOS en Windows, ChatGPT Enterprise al aangeschaft. Ontwikkelaars behouden Codex; security krijgt attributie; finance krijgt een getal per team.
1. Maak de provider aan. Integrations → Providers → OpenAI, base URL https://chatgpt.com/backend-api/codex, API key-veld leeg — noteer dat in het runbook zodat de volgende beheerder het niet gaat "repareren".
2. Maak het Virtual Model aan. Slug gpt-5.2-codex — het echte model-ID, niet de fully qualified name. Eén ChatGPT-subscription target, plus op API-key gebaseerde targets voor failover.
3. Stel de MDM-configuratie in. GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME, plus CODEX_AUTH_MODE="chatgpt-subscription" en CODEX_DEFAULT_MODEL="gpt-5.2-codex".
4. Push het script uurlijks, als root. Het installeert tfy-local-ai-setup v1.3.5, ververst het token van elke gebruiker, schrijft managed_config.toml op macOS en requirements.toml op Windows, en vergrendelt beide.
5. Koppel de Windows-rollout aan codex --version. Alles onder v0.156.0 is niet-gehandhaafd; rapporteer de versieverdeling van de fleet voordat u dekking claimt.
6. Verifieer. ls -lO voor schg, lsattr voor i, icacls voor eigenaar Administrators en Users:(RX). Open vervolgens Request Traces en bevestig dat de naam van een ontwikkelaar op de request staat, niet die van een service-account.
7. Sluit het web-search-pad af. Registreer Tavily of Exa achter de MCP Gateway en stel vervolgens web_search = "disabled" in.
De eerlijke beperking: deze stappen beheren de modelprovider, authenticatie en uitgaven. Ze bepalen niet welke MCP-servers een ontwikkelaar mag inschakelen.
Het MDM-script beheert geen MCP-servers. Het beheert managed_config.toml, wat de modelprovider en authenticatie omvat. De handhaving door Codex van welke MCP-servers een ontwikkelaar mag inschakelen, bevindt zich in een afzonderlijk /etc/codex/requirements.toml op macOS en Linux, dat niet door tfy-local-ai-setup wordt geschreven. Implementeer dat naast het script — en vertel een auditor niet dat de MDM-setup de allowlisting van MCP omvat.
Twee MDM-scripts, één configuratiebestand, verschillende gepinde versies. De Codex-scripts pinnen tfy-local-ai-setup v1.3.5; de Claude Code-scripts pinnen v1.3.4. Beide beschrijven één binary die één opgeslagen configuratiebestand op dezelfde machine deelt, dus een fleet die beide uitvoert, zou elk uur een andere versie opnieuw installeren — en Windows Codex-ondersteuning bestaat pas vanaf v1.3.5. [VERIFIEER] de pin voordat u beide inschakelt.
Modelversieverschillen in de documentatie. De Codex-pagina kondigt GPT-5.3-Codex aan, terwijl elk configuratievoorbeeld, de slug-richtlijn en de MDM-standaard gpt-5.2-codex gebruiken. Pin expliciet in CODEX_DEFAULT_MODEL; [VERIFIEER] het huidige model-ID vóór de rollout.
Cursor kan niet op dezelfde manier worden gehandhaafd. De MDM-policies daarvan omvatten hooks, geen modellen: base URL, API-key en modellijst zijn niet via MDM afdwingbaar, dus een ontwikkelaar kan ze op elk moment terugdraaien. Copilot CLI heeft ook geen settings.json-pad voor BYOK. Codex en Claude Code zijn de twee die standhouden — Cursor security dicht de kloof.
Het meeste advies over OpenAI Codex governance stopt bij "routeer het via een proxy." Dat is de makkelijke helft. De moeilijke helft bepaalt of de routing standhoudt in een echte fleet: een leeg API key-veld dat eruitziet als een fout maar het niet is, een verplicht wire-protocol, een slug die exact moet overeenkomen met een model-ID, een Windows-bestand met een eigen schema, een minimale versie waaronder de controle stilzwijgend niets doet, en een ACL die u niet mag versoepelen.
Geen van alle zijn het beleidsvragen. Het zijn configuratiefeiten, elk met een commando dat u kunt uitvoeren om het te controleren. Dat is het verschil tussen een governance-document en een beheerde fleet: iemand loopt naar een willekeurige laptop, voert ls -lO of icacls uit, en krijgt een ja of een nee.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Four controls that hold without developer cooperation: a per-developer identity on every request, admin control over reachable models, spend attributed to a person and a team, and audit produced on the network path. In practice: an admin-owned config file read at higher precedence than the developer’s, a file lock, and short-lived credentials.
Yes. Set requires_openai_auth = true, move the gateway credential to x-tfy-api-key so Codex can use Authorization for its own ChatGPT OAuth token, and create the gateway provider with the API key field empty — a stored key overrides the developer’s ChatGPT credentials and breaks the flow. You get the developer’s identity on the gateway side and their ChatGPT seat on OpenAI’s.
Only from Codex v0.156.0. v0.149.0 removed managed_config.toml support with no registry equivalent; enforcement moved to requirements.toml, a different schema with no top-level model key. Below v0.156.0 only the lowest-precedence config.toml applies, which a developer’s own config overrides.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog of Prometheus. Elke LLM-classifieraanroep produceert zijn eigen span, zodat de latentie van de classifier apart zichtbaar is van die van het geserveerde model.



Het laatste nieuws, artikelen en bronnen in je inbox



















