



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Muse Spark is de eerste modelfamilie van Meta Superintelligence Labs, geïntroduceerd op 8 april 2026 als vervanging voor de Llama-lijn (Meta AI). Versie 1.3 is de derde iteratie en is volgens de documentatie van Meta de aanbevolen standaard voor nieuw werk.
De specificaties, afkomstig van de Meta Model API-modellenpagina en -prijzenpagina, per september 2026:
Drie details zijn het waard om uit te lichten.
Het is geen open-weight model. Dit is het eerste waar de meeste mensen zich in vergissen, deels omdat Meta jarenlang het open-weights bedrijf was. Muse Spark 1.3 wordt uitsluitend via een API aangeboden. Meta's eigen release note sluit af met een roadmap-regel waarin “de Muse Spark open weights release” als een toekomstig item wordt genoemd — een duidelijk teken dat dit nog niet is gebeurd. Als je Meta-weights nodig hebt die je vandaag kunt downloaden, is het model Muse Glimmer: 30B parameters, dense multimodal, 128K standaardcontext, Apache 2.0, gedestilleerd uit Muse Spark (Muse Glimmer docs). Een echt permissieve licentie, een veel kleiner model. Haal deze twee niet door elkaar.
Audio is specifiek in 1.3 verslechterd. Op de modellenpagina van Meta staat in een voetnoot dat audiobegrip in 1.3 “momenteel niet volledig wordt ondersteund” en dat de responskwaliteit hieronder kan lijden. Meta raadt aan om in plaats daarvan 1.2 of het toegewijde Muse Voice Transcribe-model te gebruiken. Dat is een ongebruikelijke regressie om toe te geven in een point release, en het is van belang als jouw pipeline audio verstuurt.
Het context window heeft een vast tarief. 1.048.576 tokens zonder, in de woorden van Meta, toeslag voor lange context — hetzelfde tarief per token ongeacht of het window bijna leeg of bijna vol is. De meeste providers rekenen een hoger tarief boven een bepaalde drempel. Dit model doet dat niet.
[SCREENSHOT: Meta Model API — het dev.meta.ai dashboard met de muse-spark-1.3 model-entry en tierselectie]
Meta presenteert 1.3 als een bruikbaarheids-release in plaats van een sprong in mogelijkheden, en de gepubliceerde verschillen ondersteunen die lezing.
Bron: Introducing Muse Spark 1.3, Meta AI Research, 2 september 2026.
De efficiëntiecijfers hebben een direct commercieel gevolg: een tokenreductie van 25% op identiek werk is een kostenverlaging van 25% op die regel, nog vóór enige routeringsbeslissing. Maar lees de herkomst goed — dit is Meta's interne engineeringvergelijking, geen reproductie door derden. De richting klopt vrijwel zeker; de omvang op jouw specifieke workload moet je zelf meten.
De gedragsveranderingen zijn in stilte het interessantere gedeelte. Een model dat om bevestiging vraagt voordat het iets onomkeerbaars doet, en toegeeft wanneer het vastloopt, is een heel ander operationeel voorstel dan een model dat zelfverzekerd doorzet. Voor agent-runs over een lange horizon waar een slechte tool call echt geld kost, is dat meer waard dan een punt op een benchmark.
Meta publiceert een benchmark-scorecard waarin Muse Spark 1.3 wordt vergeleken met Muse Spark 1.2, GPT-5.6 Sol en Claude Opus 5 op het gebied van agentic-, codeer-, instructievolgende en lang-context evaluaties. De suite, volgens het evaluation methodology report van Meta:
De individuele scores moeten worden gecontroleerd. Meta publiceert ze alleen in een gerenderde afbeelding in de release-post, niet als machineleesbare tekst. Daarom zal deze post geen cijfers overnemen die hij niet precies kan citeren. Haal ze uit de scorecard op de pagina van Meta voordat je een cijfer citeert.
Wat het methodology report in tekst zegt, is sowieso nuttiger dan de scores, en drie kanttekeningen horen bij elk cijfer dat je citeert.
Vergelijkingen zijn uitgevoerd op verschillende effort-niveaus. Muse Spark 1.3, Opus 5 en GPT-5.6 Sol zijn geëvalueerd op max reasoning effort; Muse Spark 1.2 op xhigh. Een deel van elk verschil tussen 1.2 en 1.3 is dus een instellingsverschil, niet puur een modelverschil.
De OSWorld-vergelijking is niet op versie afgestemd. Elk model is geëvalueerd op OSWorld 2.0 versie 08.08, behalve Muse Spark 1.2, dat draaide op versie 06.24. Meta vermeldt dit eerlijk, wat ze siert, maar het betekent wel dat die specifieke rij geen eerlijke vergelijking is.
Scores zijn best-of-source. Meta rapporteert “de hoogste vergelijkbare primaire-metric-waarde die beschikbaar is uit onze evaluatie, het officiële leaderboard, of de door de modelprovider zelf gerapporteerde resultaten.” Het beste beschikbare cijfer nemen voor elk model in elke rij is een verdedigbare methode, maar het is geen enkele gecontroleerde run.
Meta is ook ongewoon openhartig over de grenzen van de eigen vergelijkingstests met concurrenten, en merkt op dat hun runs “mogelijk niet zijn afgestemd op propriëtaire modellen en mogelijk niet hun beste provider-geoptimaliseerde prestaties weerspiegelen.” Dat is een eerlijke disclaimer, en een goede reden om elke scorecard van een vendor — inclusief deze — te beschouwen als een uitgangshypothese in plaats van een definitief resultaat. De enige benchmark die de doorslag geeft bij een routeringsbeslissing is jouw eigen data op jouw prompts, wat het argument is om je eigen evaluatie uit te voeren voordat je je vastlegt.
Meta hanteert twee tiers, en het gat daartussen is het meest ingrijpende feit in deze hele post.
Bron: Meta Model API pricing and rate limits, september 2026.
De Contributor tier is 92% goedkoper op input en 95% goedkoper op output. Meta is volledig transparant over de ruil: sterk afgeprijsde tokens “in ruil voor toestemming om jouw prompts en completions te gebruiken om toekomstige Meta-modellen te trainen.” Model-ID's zijn verschillend — muse-spark-1.3-contributor in plaats van muse-spark-1.3 — dus de keuze is expliciet op het moment van aanroepen, niet verborgen in een accountinstelling.
Die transparantie is een goede praktijk. Het creëert ook een specifiek operationeel risico, waar we zo op terugkomen.
Nog twee aanvullende opmerkingen over de prijzen. Web search grounding kost $2,50 per 1.000 query's bovenop de tokenkosten, dus alles wat de web_search tool gebruikt, laat een tweede teller lopen. En max reasoning is alleen beschikbaar in de Standard-tier — de goedkope tier kan de modus die de opvallendste benchmarks oplevert niet bereiken.
Vier failure modes zijn specifiek voor deze release in plaats van algemeen voor de ingebruikname van modellen.
De Contributor tier is één configuratieregel verwijderd van een dataincident. Een korting van 92% is precies het soort besparing dat een engineer doorvoert tijdens een kostenherziening zonder de tweede helft van de zin te lezen, en de twee model-ID's verschillen slechts door één achtervoegsel. Als een developer een productiedienst naar muse-spark-1.3-contributor laat wijzen om een budgetdoel te halen, worden klantprompts trainingsdata voor Meta en ziet niets in de applicatie er anders uit. Dat moet ergens centraal worden afgedwongen, want het zal niet betrouwbaar in elke repository worden gecontroleerd.
Rate limits geldt per team, niet per sleutel. Meta is expliciet: alle sleutels binnen één team delen het budget van 3.000 RPM en 4M TPM. Het uitgeven van een sleutel per dienst verdeelt de capaciteit niet, dus één slecht ingestelde batch-job kan een interactief product blokkeren. Het advies van Meta is om de x-ratelimit-remaining-tokens header uit te lezen en te vertragen voordat je de limiet bereikt — wat betekent dat iets in je stack dat ook daadwerkelijk moet doen.
Closed weights betekenen dat de discussie over datalocatie snel stopt. Met een open-weight model kun je discussiëren over waar je het draait. Hier is er één antwoord: prompts gaan naar de API van Meta. Jouw juristen bepalen wat acceptabel is; het punt is dat de mogelijkheid tot self-hosting die wel bestaat voor Muse Glimmer, niet bestaat voor Muse Spark.
Versies volgen elkaar snel op. Drie versies tussen april en september 2026, ongeveer vier weken tussen 1.2 en 1.3, en een gedocumenteerde audio-regressie in een point release. Elke integratie die een model-string hardcoded gebruikt, zal sneller moeten worden herzien dan de planningscyclus aanneemt — en dat is waar virtuele modelnamen en gefaseerde overstappen voor bedoeld zijn.
Een closed model verandert het doel van een gateway. Bij een open-weight release is de taak van de gateway portabiliteit. Hier is het controle, toewijzing en de mogelijkheid om van gedachten te veranderen.
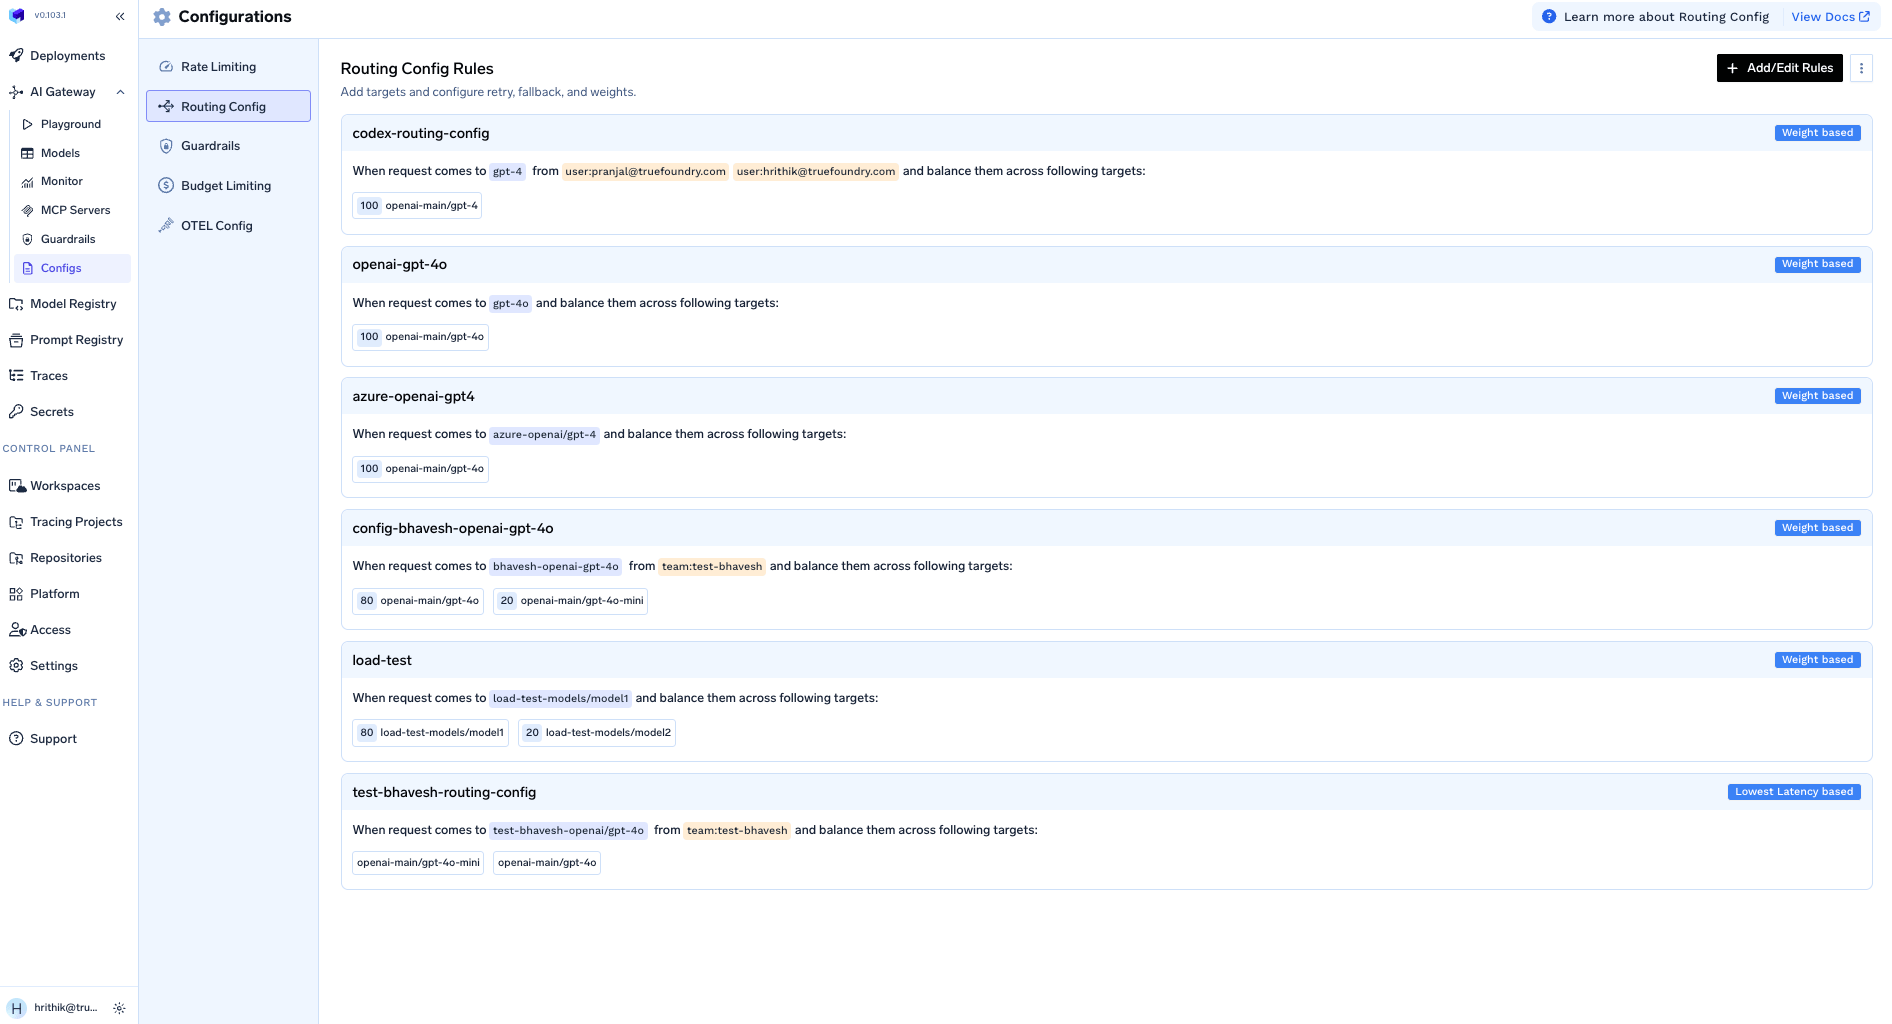
Maak van de tier een policy, geen voorkeur. De beslissing over Contributor moet één keer worden genomen door de mensen die er verantwoordelijk voor zijn, en daarna worden afgedwongen. Met policy enforcement op gateway-niveau kun je muse-spark-1.3 beschikbaar stellen voor productiediensten en de contributor-variant beperken tot een sandbox — of deze volledig blokkeren. Applicaties vragen om een modelnaam; de gateway bepaalt waar dat naar verwijst.
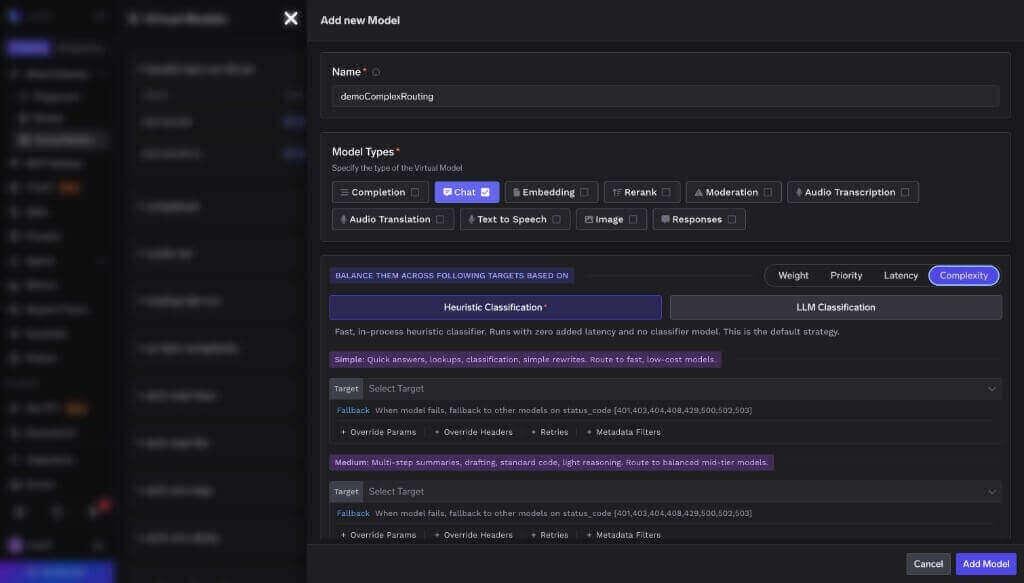
Routeer op basis van taak, niet op basis van vendor-loyaliteit. Meta's eigen scorecard plaatst 1.3 tegenover Opus 5 en GPT-5.6 Sol in plaats van te beweren dat ze op alle vlakken winnen, wat een argument is voor een gemengde inzet. Agent-runs over een lange horizon en werk met een context van een miljoen tokens gaan naar Muse Spark; ander werk gaat naar waar het beter presteert. In TrueFoundry's Auto Routing benchmark over 550 prompts verlaagde het zo categoriseren van requests de kosten met 69% met behoud van 98% van de basiskwaliteit, waarbij de gemiddelde latency daalde van 7,6s naar 4,0s; op realistisch productieverkeer bereikte de reductie zelfs 80%.
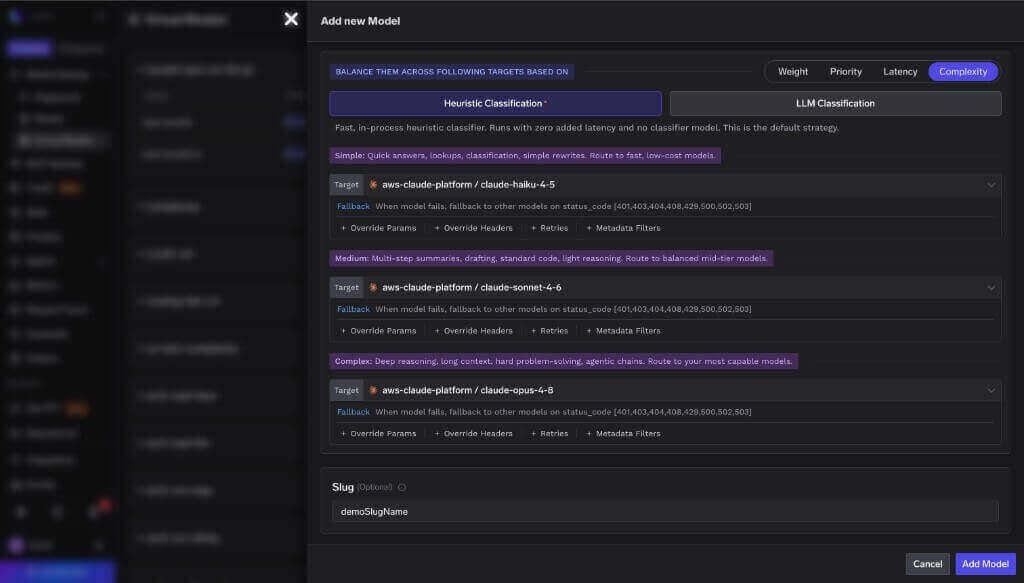
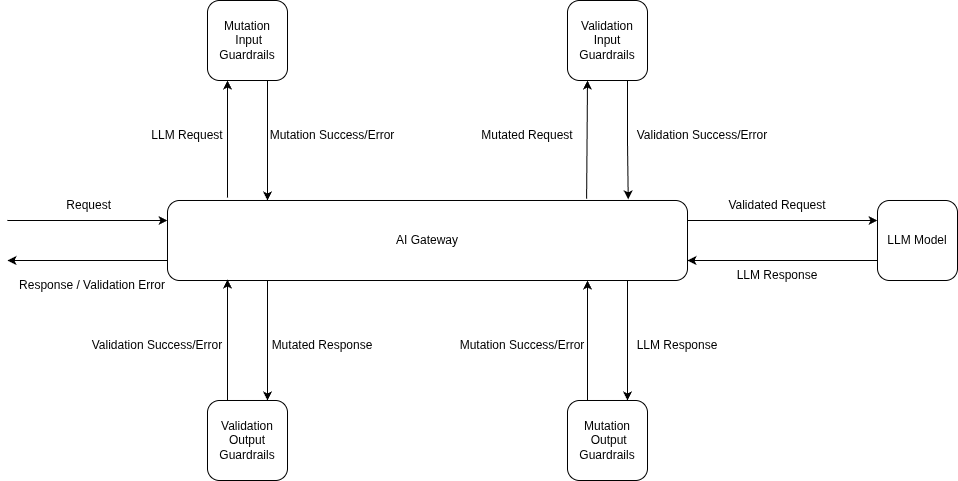
Opvangen van de gedeelde rate limit. Omdat het quota van Meta per team geldt, is de gateway de logische plek om dit te beheren: rate limiting per verbruikend team, queuing en failover naar een andere provider wanneer Meta een 429 retourneert. Eén gedeeld budget heeft één plek nodig die dit overziet.
Behoud je eigen guardrails. Meta meldt een verbeterde weerstand tegen prompt injection in 1.3, wat welkom is, maar het is geen controlemechanisme dat je zelf in handen hebt. Gateway guardrails draaien op het request- en response-pad, ongeacht welke provider antwoordt, zodat je beleid niet verandert wanneer je model verandert.
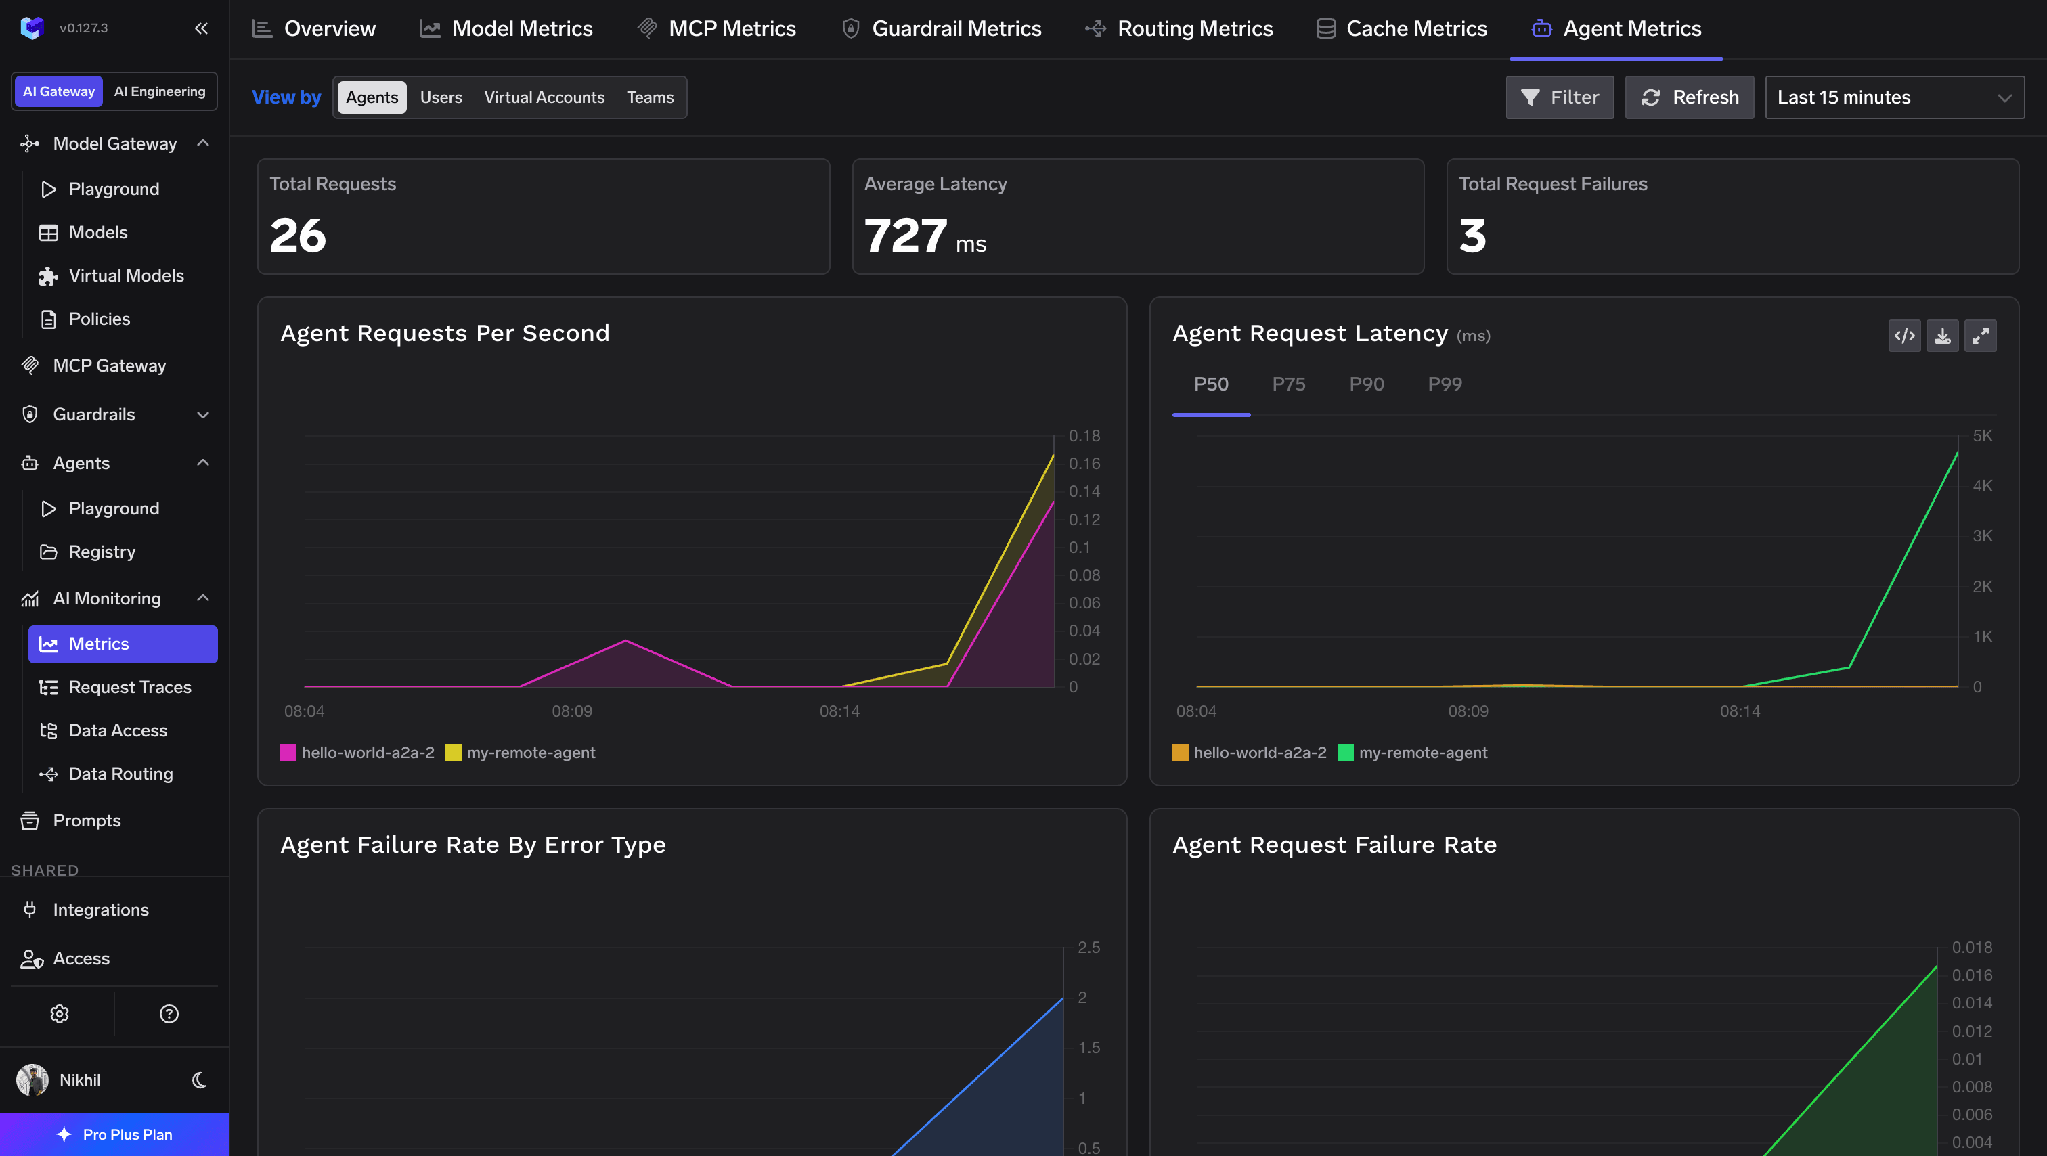
Meet de claim over efficiëntie. Meta zegt dat 1.3 ~25% minder tokens gebruikt dan 1.2. Kosten per request en tokentoewijzing per team is de manier om dat te bevestigen op jouw verkeer in plaats van het zomaar aan te nemen.
De korte versie, per september 2026:
[SCREENSHOT: Muse Code — terminal-sessie met een agentic run op Muse Spark 1.3]
Muse Spark 1.3 is een degelijke, onopvallende release, en het onopvallende gedeelte is precies waar het om gaat. Meta claimde geen nieuwe grens te verleggen. Het claimde minder tool calls, minder tokens, beter gedrag in lange threads en een beter oordeel over onomkeerbare acties — de dingen die bepalen of een agent-run netjes eindigt of een hele middag verspilt. Voor een team dat al over meerdere providers routeert, maakt dat het een geloofwaardige vierde optie voor agentic werk over een lange horizon, met een vast geprijsd context window van een miljoen tokens als onderscheidende factor.
Wees realistisch over waar het verliest. De weights zijn closed, dus de argumenten over portabiliteit en datalocatie die een open-weight model interessant maken, gaan hier niet op — en als je zocht naar het open model van Meta, dan is dat Muse Glimmer, een veel kleiner model. Audio is achteruitgegaan in deze release. De opvallendste scores zijn gepubliceerd als een afbeelding, deels gemeten bij ongelijksoortige instellingen, en overgenomen als best-of-source. En de goedkoopste manier om het te draaien kost je je eigen prompts.
Dat brengt ons bij de eerlijke conclusie: dit komt neer op wat je zelf in beheer wilt hebben. Als je het beste model van Meta wilt, huur je het, op de voorwaarden van Meta. De interessante beslissing is dan niet of je het in gebruik neemt, maar waar het tierbeleid zich bevindt en wie het kan wijzigen. Plaats die beslissing achter een gateway voordat het eerste team het rechtstreeks koppelt, en het toevoegen van Muse Spark 1.3 aan de rotatie kost je een configuratiewijziging in plaats van een migratie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Muse Spark is de modelfamilie van Meta Superintelligence Labs, geintroduceerd op 8 april 2026 en nu de opvolger van de Llama-lijn van Meta. Muse Spark 1.3, uitgebracht op 2 september 2026, is de huidige versie, met een contextvenster van 1.048.576 tokens en input van tekst, afbeelding, video, en PDF.
Nee. Muse Spark 1.3 is gesloten en alleen via API. Het releasebericht van Meta vermeldt een open-weights-release als toekomstig roadmap-item. Het open-weight model van Meta dat vandaag beschikbaar is, is Muse Glimmer - 30B parameters, Apache 2.0, gedistilleerd uit Muse Spark, met een standaard contextvenster van 128K.
Op het Standard-niveau, $1,25 per miljoen inputtokens, $0,15 voor gecachete input en $4,25 per miljoen outputtokens, zonder toeslag voor lange context. Het Contributor-niveau is $0,10 input en $0,20 output, in ruil voor toestemming om te trainen op uw prompts en completions.
Meta evalueert 1.3 tegenover Muse Spark 1.2, Claude Opus 5, en GPT-5.6 Sol op GDPVal-AA v2, JobBench, OSWorld 2.0, DeepSearchQA, AutomationBench, DeepSWE v1.1, SWE-Atlas Codebase QnA, Terminal-Bench 2.1, MRCR v2, en een interne instructievolgindex. Individuele scores worden alleen gepubliceerd in een afbeelding op het releasebericht van Meta - lees ze daar in plaats van via secundaire berichtgeving.
De AI Gateway van TrueFoundry voegt ongeveer 3-4 ms toe en houdt 350+ RPS vol op 1 vCPU, wat verwaarloosbaar is naast generatietijden van meerdere seconden.
Nee, en de benchmarkspreiding hierboven is het argument daartegen. Routeren op taaktype over open en gesloten modellen heen is meestal goedkoper en beter dan standaardiseren op één model.



Het laatste nieuws, artikelen en bronnen in je inbox

















