



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het launchen van een LLM-prototype duurt tegenwoordig slechts enkele dagen. Model-API's vereisen een enkele HTTP-call, terwijl frameworks een groot deel van de onderliggende structuur afhandelen. Een klein team kan snel een generatieve AI-assistent demonstreren. Het moeilijke gedeelte begint meestal de maandag daarop, wanneer live gebruikers, data, facturen en compliance-vereisten om de hoek komen kijken.
Het model verandert zelden tussen prototype en lancering. Alles eromheen verandert zodra er productieverkeer binnenkomt. Een LLM in productie moet onvoorspelbaar verkeer verwerken, latency-doelen halen en de uitgaven aan inference binnen het budget houden. Het heeft ook auditeerbare traces, toegangsregels, failover en duidelijk eigenaarschap bij storingen nodig.
Deze gids definieert wat LLM in productie betekent en vergelijkt prototypes met live enterprise-systemen. Het behandelt zes infrastructuurlagen, deployment, evaluatie, kostenbeheersing en governance. Het doel is een betrouwbare LLM-applicatie die is afgestemd op de bedrijfsdoelen, terwijl de gebruikerservaring, dataprivacy en operationele controle beschermd blijven.
Een LLM in productie bedient echte gebruikers of downstream systemen onder live operationele omstandigheden. De outputs bereiken klanten, supportwachtrijen, compliance-processen of geautomatiseerde beslissingen. Een slecht antwoord brengt nu een reële bedrijfskost met zich mee. Het risico neemt toe wanneer één use-case de output van het model verbindt met operationele acties.
De betekenis van een productie-LLM omvat meer dan het endpoint van het model. Het omvat routing, versiebeheer, observabiliteit, kostenbeheersing, toegangsbeleid en governance. Deze lagen veranderen gewone LLM-inference in een verantwoordbare productie-omgeving. Een betrouwbare LLM-deployment is daarom afhankelijk van het gehele omliggende systeem.
Teams die zoeken naar wat een productie-LLM is, vragen meestal naar het besturingssysteem rondom het model. Een prototype bewijst dat een LLM een taak kan voltooien. Een live deployment bewijst dat het gehele systeem betrouwbaar, veilig en binnen het budget werkt. Het moet ook om kunnen gaan met wisselend verkeer, echte gebruikersvragen en infrastructuurkosten die ontstaan door aanhoudend gebruik.
De meeste teams onderschatten deze kloof omdat de demo al werkt. Een prototype valideert de mogelijkheid binnen een gecontroleerde baseline. Productie voegt betrouwbaarheid, governance, kosten en compliance-druk toe onder live verkeer. De belangrijkste factoren zijn nu modelprestaties, responstijd, foutpercentage, outputkwaliteit en kostentoewijzing.
Twee rijen verdienen extra aandacht. Kostenregistratie lijkt onschuldig tijdens een prototype, waar een enkele gedeelde API-key voldoende kan lijken. Productieteams hebben datapunten nodig per team, feature, model en omgeving. Een gedeelde key belemmert chargeback, kostenverlaging en verantwoordelijkheid over uitbreidende LLM-workloads.
Foutafhandeling verdient dezelfde mate van engineering-aandacht. Elke cloudprovider kan te maken krijgen met een onverwachte servicestoring. OpenAI meldde op 10 juni 2025 verhoogde foutpercentages bij 10 API-componenten. Het incident duurde meer dan 15 uur vanaf de eerste update tot de oplossing. Een applicatie die aan één provider gekoppeld was, miste een betrouwbaar fallback-pad.
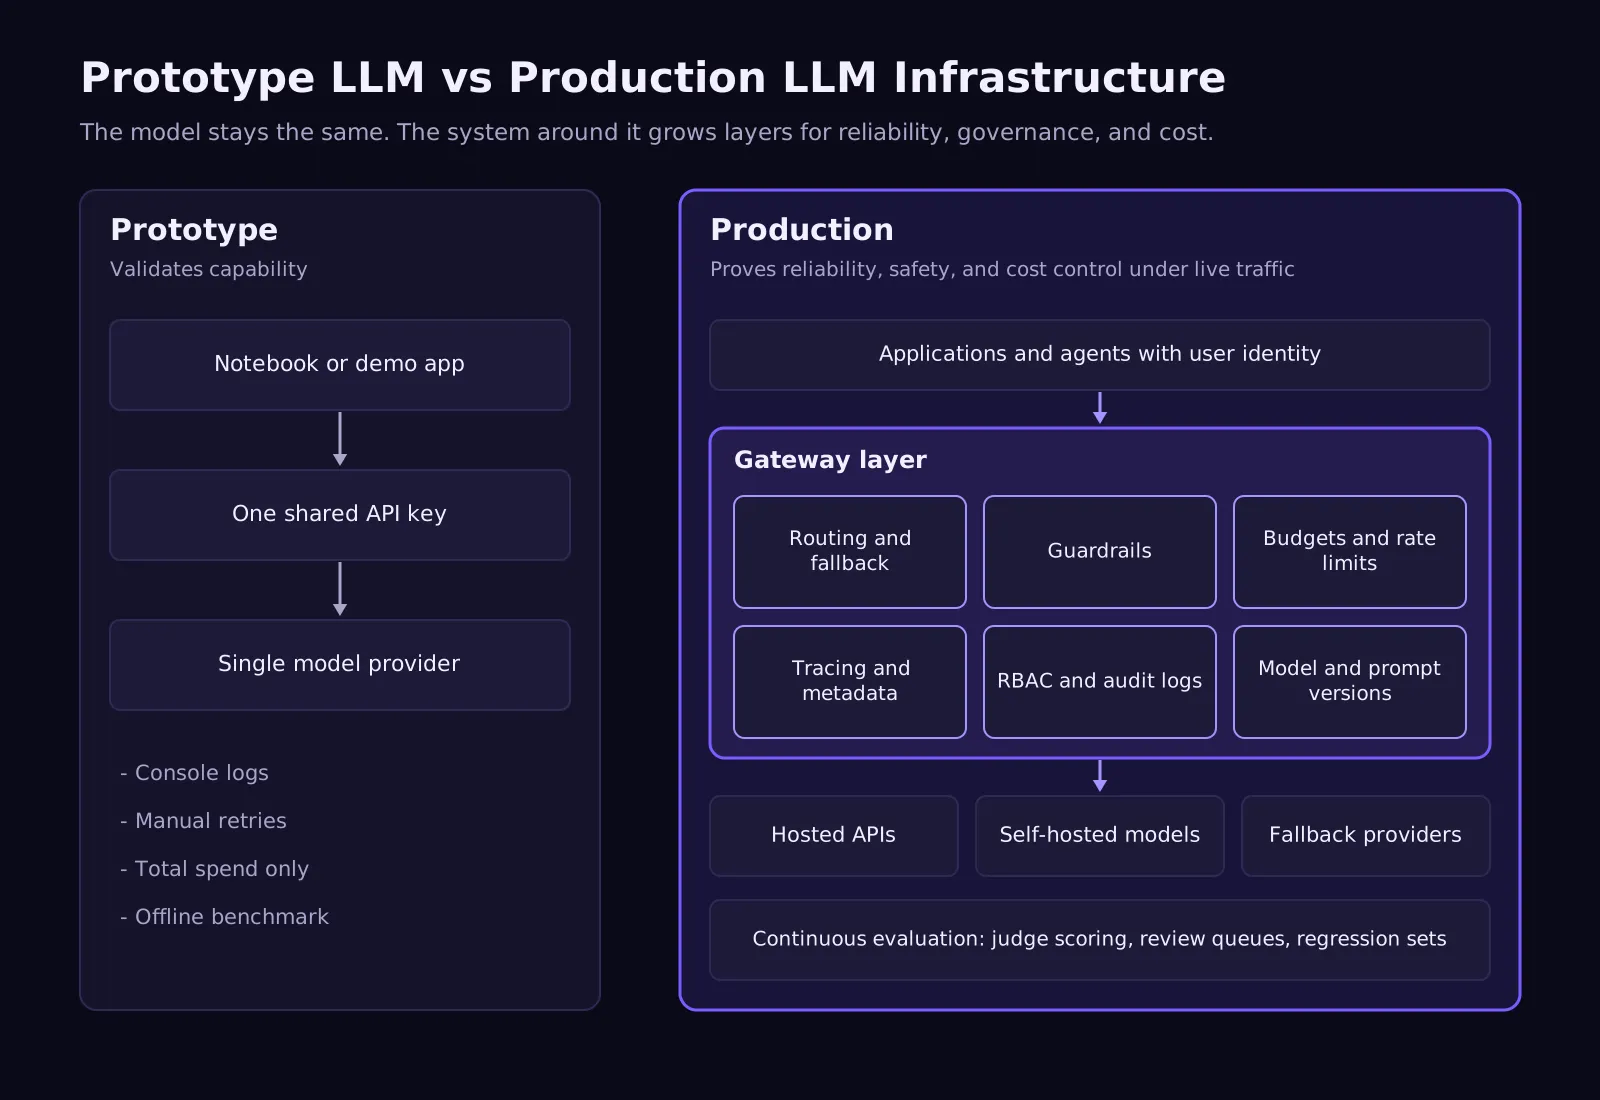
Een productieklare LLM is net zo afhankelijk van het systeem eromheen als van het model zelf. Enterprise teams moeten zes lagen verifiëren voordat workloads gebruikers bereiken. Samen dekken deze lagen deployment-architectuur, serving, routing, observabiliteit, evaluatie en governance af. Ontbrekende limieten uiten zich later meestal als incidenten op het gebied van betrouwbaarheid, beveiliging, prestaties of kosten.
De eerste beslissing is waar elk model draait, en datalimieten geven hierbij vaak al vroeg de doorslag. Teams kunnen gehoste API's aanroepen, open-source modellen zelf hosten op cloud-GPU's, or modellen on-premises draaien. De juiste keuze hangt af van dataresidentie, controle over het model, doorvoer en infrastructuurkosten. Teams moeten ook rekening houden met hun capaciteit voor doorlopend resourcebeheer.
Gehoste API's bieden de snelste route omdat providers de GPU's beheren. Zelf hosten geeft meer controle over modelgrootte, GPU-geheugen en serving-optimalisatie. Teams moeten ook de wachtrijdiepte, continuous batching, schalen en capaciteitsplanning beheren. Een klein model kan de kosten verlagen, terwijl grotere modellen meer GPU-resources nodig hebben.
On-premises en air-gapped opties zijn van belang wanneer inference-data de goedgekeurde infrastructuur niet mag verlaten. Deze keuzes komen vaak voor waar dataprivacy of regelgeving externe verwerking beperken. De meeste enterprise-organisaties gebruiken uiteindelijk een mix van deze deployment-opties. De ene chat-app kan een gehost model aanroepen, terwijl een gevoelige documenten-pipeline privé binnen de VPC van het bedrijf draait.
Voor een LLM in productie vereist serving dezelfde release-discipline als elke kritieke softwaredienst. Al het verkeer naar een nieuw model, een nieuwe prompt of een nieuw routingbeleid sturen, creëert onnodig risico. Modelversies, promptwijzigingen en routingregels moeten geleidelijk veranderen, met duidelijke rollback-paden en meetbare prestatievergelijkingen.
De belangrijkste beheersmaatregelen zijn canary-releases, het vastzetten (pinning) van modelversies, prompt-versiebeheer, rollback-workflows en A/B-testen. Pinning is belangrijk omdat een zwevende model-alias het gedrag kan veranderen zonder dat de applicatie verandert. Prompt engineering vereist een vergelijkbare release-discipline, aangezien de formulering de outputkwaliteit en weigeringspatronen kan veranderen. Het kan ook het succes van taken bij live verkeer beïnvloeden.
Bij de gateway wordt een canary een routingregel. Op gewicht gebaseerde routing kan 5% van het verkeer naar een nieuw doel sturen. De overige 95% blijft op de huidige baseline totdat de resultaten verbeteren. Rollback betekent dan het gewicht van het nieuwe doel op nul zetten, zonder de applicatiecode te wijzigen of actieve gebruikers te onderbreken.
Prompts hebben hetzelfde gedisciplineerde versiebeheer nodig als modellen. Een geversioneerde registry kan een geteste prompt promoveren zonder een volledige hernieuwde deployment. Het kan ook de laatst werkende versie herstellen na een regressie. TrueFoundry’s workflow voor prompt-versiebeheer ondersteunt onveranderbare historie, scheiding van omgevingen, vergelijking en rollback voor prompt-gestuurde applicaties.
Een productie-LLM mag niet afhankelijk zijn van één provider. Storingen, snelheidslimieten, latency-pieken en veranderingen in modelgedrag kunnen kritieke workflows verstoren. Multi-provider routing stelt teams in staat doelen te selecteren op basis van kosten, status, capaciteit of latency. Fallback-ketens houden de dienst beschikbaar wanneer het voorkeursmodel uitvalt.
De applicatiecode kan ongewijzigd blijven omdat deze een enkele logische modelnaam aanroept via de gateway-API. Een contextuele LLM Gateway kan de provider-afhandeling buiten de applicatiecode houden. Dit patroon vermindert het migratiewerk tussen in Azure gehoste modellen, OpenAI-endpoints en zelfgehoste inference.
In TrueFoundry kan een virtueel model gebruikmaken van op prioriteit gebaseerde routing met retries en fallbacks:
Dit is hoe de gateway het leest:
De gateway stuurt verkeer naar het gezonde doel met het laagste prioriteitsnummer. Retry-regels handelen tijdelijke storingen af voordat het verkeer ergens anders heen gaat. Fallback-codes bepalen wanneer het volgende doel verkeer ontvangt. Statustracking kan ongezonde doelen een lagere prioriteit geven totdat recente storingen buiten het monitoringvenster vallen.
Elke request van een LLM in productie heeft een gestructureerde trace nodig. Nuttige traces leggen gebruikersidentiteit, model, provider, promptversie, tokens, kosten, latency en foutdetails vast. Teams hebben ook informatie nodig over de latency van het eerste token, de totale responstijd, output-tokens, doorvoer en het foutpercentage. Deze velden koppelen het gedrag van het model aan de gebruikerservaring.
Deze signalen beantwoorden terugkerende vragen over de productie voor engineering-teams. Teams kunnen identificeren waarom een antwoord is mislukt en welke versie van de prompt het heeft gegenereerd. Ze kunnen ook SLA-prestaties vergelijken tussen providers of omgevingen. Bestaande ML-monitoringpraktijken helpen, hoewel natuurlijke taaloutputs rijkere traces vereisen dan gewone machine learning-metrieken.
Label requests bij de bron, zodat elke gebruikersvraag zakelijke context met zich meedraagt. Het onderstaande Python-voorbeeld behoudt de bestaande OpenAI SDK en voegt TrueFoundry-metadata toe:
Vervang de twee placeholders door de API-key en de base URL uit de instellingen van uw gateway. De modelwaarde noemt een virtueel model, dus routingwijzigingen raken deze code nooit. De header X-TFY-METADATA voegt string sleutel-waardeparen toe die de gateway gebruikt voor routing, snelheidslimieten, budgetten en metriekfilters.
Elke trace voor deze call bevat nu het team, de feature en de omgeving. Dat is wat een kostenrapport per team aan het einde van de maand mogelijk maakt. Voor diepere analyses exporteert de gateway traces via OpenTelemetry naar platforms zoals Grafana Cloud of Datadog, en TrueFoundry's artikel over observabiliteit in LLM-workflows gaat dieper in op de opzet van traces.
Productie-evaluatie verschilt van offline benchmarking omdat echte gebruikers rommelige, domeinspecifieke requests genereren. Zoekmachines, RAG-systemen en assistenten introduceren ook opgehaalde context die onverwacht kan veranderen. Het gebruik van lange contextvensters introduceert nog een variabele, aangezien irrelevante informatie het uiteindelijke antwoord kan veranderen of de kosten kan verhogen.
Teams hebben gegrondheidscontroles (groundedness checks), weigeringsmonitoring, PII-detectie, prompt injection-filtering en antwoordveiligheidscontroles nodig. De Top 10 van OWASP voor 2025 plaatste prompt injection op de eerste plaats en het lekken van gevoelige informatie op de tweede. Effectieve best practices combineren evaluatie daarom met afdwingbare guardrails om te voorkomen dat onveilige content gebruikers of downstream systemen bereikt.
Voer guardrails uit via een AI Gateway zodat applicaties consistente regels volgen. TrueFoundry ondersteunt input, output, MCP pre-tool en MCP post-tool guardrail-punten. Een guardrail kan payloads blokkeren of transformeren, inclusief de redactie van gevoelige data vóór inference. Teams kunnen beginnen in auditmodus om false positives te meten voordat ze het beleid handhaven.
Een LLM in productie heeft financiële beheersmaatregelen nodig voordat het verkeer schaalt. Tokenkosten stijgen snel wanneer LLM-agents planning, tools, validatie en retries aansturen. Productiesystemen hebben toewijzing, budgetten, snelheidslimieten, cachebeleid, RBAC, audit trails en identiteitsbewuste toegang nodig voordat duur werk wordt uitgevoerd.
TrueFoundry scheidt momenteel snelheidslimieten voor requests van financiële budgetten. Snelheidsregels kunnen requests of tokens per tijdsvenster beperken, terwijl budgetregels de uitgaven beheren. De token-snelheidslimieten en budgetten ondersteunen afzonderlijke plafonds voor requests en tokens per gebruiker:
Een geschonden regel retourneert HTTP 429 en identificeert de toegepaste regel in de antwoordmetadata. Dat geeft clients een duidelijk signaal voor backoff en geeft operators een auditeerbare controle. Teams moeten ook de prijzen van modellen bekijken, aangezien gelijke tokenvolumes kunnen resulteren in zeer verschillende uitgaven over verschillende modelfamilies.
Caching kan herhaald inference-werk over productieverkeer verminderen. Semantische caching vergelijkt nieuwe requests met eerdere requests met behulp van embeddings. Een cache-hit retourneert een opgeslagen antwoord zonder een nieuwe model-call. TrueFoundry raadt aan te beginnen met een drempelwaarde van 0,9 voor overeenkomst, en vervolgens af te stemmen op basis van de waargenomen kwaliteit en risicotolerantie. De gids voor semantische caching legt de afweging uit.
De zes lagen beschrijven wat een productiestack bevat. De onderstaande stappen plaatsen die beheersmaatregelen in een praktische bouwvolgorde. Elke opeenvolgende stap moet architectonische keuzes verbinden met de use-case van de workload, het risicoprofiel, de verwachte schaal en het operationele team. Die volgorde voorkomt dat platformbeslissingen afwijken van de bedrijfsdoelen.
Begin met data- en compliance-vereisten, aangezien deze ongeschikte opties onmiddellijk kunnen uitsluiten. Gehoste API's passen bij teams die prioriteit geven aan snelheid en minder operationeel werk. Zelf hosten past bij gevallen die diepere controle over het model of voorspelbare compute vereisen. VPC-, on-premises- en air-gapped-opties worden belangrijk wanneer dataresidentie of regelgeving externe verwerking beperken.
Leg de beslissing voor elke workload schriftelijk vast, inclusief de dataclassificatie erachter. Dat dossier is nuttig wanneer teams later de kosten heroverwegen. Het voorkomt ook dat een goedkopere cloudprovider-optie stilzwijgend een deployment vervangt die is gekozen om redenen van regelgeving of privacy.
Plaats een gateway tussen applicaties en modellen voordat meerdere teams onafhankelijk van elkaar gaan bouwen. De gateway centraliseert routing, authenticatie, caching, guardrails, beleid en observabiliteit. Zonder gateway moet elk applicatieteam retries, keys, logging en providerafhandeling opnieuw creëren. Governance varieert dan over workloads, en één beleidswijziging kan bewerkingen in meerdere codebases vereisen.
De meeste gateways bieden een OpenAI-compatibele interface, dus vroege adoptie vereist vaak alleen het wijzigen van een base URL. Eén enkele gateway kan verschillende interfaces ondersteunen zonder de governance-patronen te veranderen. Een chatassistent, een RAG-zoektool of een social media-pipeline kunnen één beleidsgrens delen. Dat geldt ook voor workloads die LinkedIn- en Twitter-content gebruiken.
Beheer het versiebeheer van zowel modellen als prompts voordat productieverkeer de gebruikers bereikt. Eén prompt-bewerking kan een workflow even gemakkelijk verstoren als een model-upgrade. Definieer uitrolregels, goedkeuringsfases, regressiedatasets en rollback-procedures vóór de lancering. Elke kandidaat moet draaien tegen geanonimiseerde productievoorbeelden voordat een beoordelaar de nieuwe versie promoveert.
Deze discipline houdt prompt-wijzigingen verbonden met meetbare resultaten. Het maakt rollback ook voorspelbaar wanneer de kwaliteit daalt. Versie-identificatoren moeten met traces over het volledige request-pad meereizen. Engineers kunnen antwoorden dan verbinden met exacte model- en prompt-configuraties.
Productiesystemen hebben live kwaliteitsmonitoring nodig omdat offline benchmarks niet elke echte request kunnen vertegenwoordigen. Volg feitelijkheid, relevantie, veiligheid, weigeringspercentages, latency en gebruikersfeedback. Stuur antwoorden met een lage betrouwbaarheid naar menselijke beoordeling wanneer het bedrijfsrisico aanvullende beoordeling vereist.
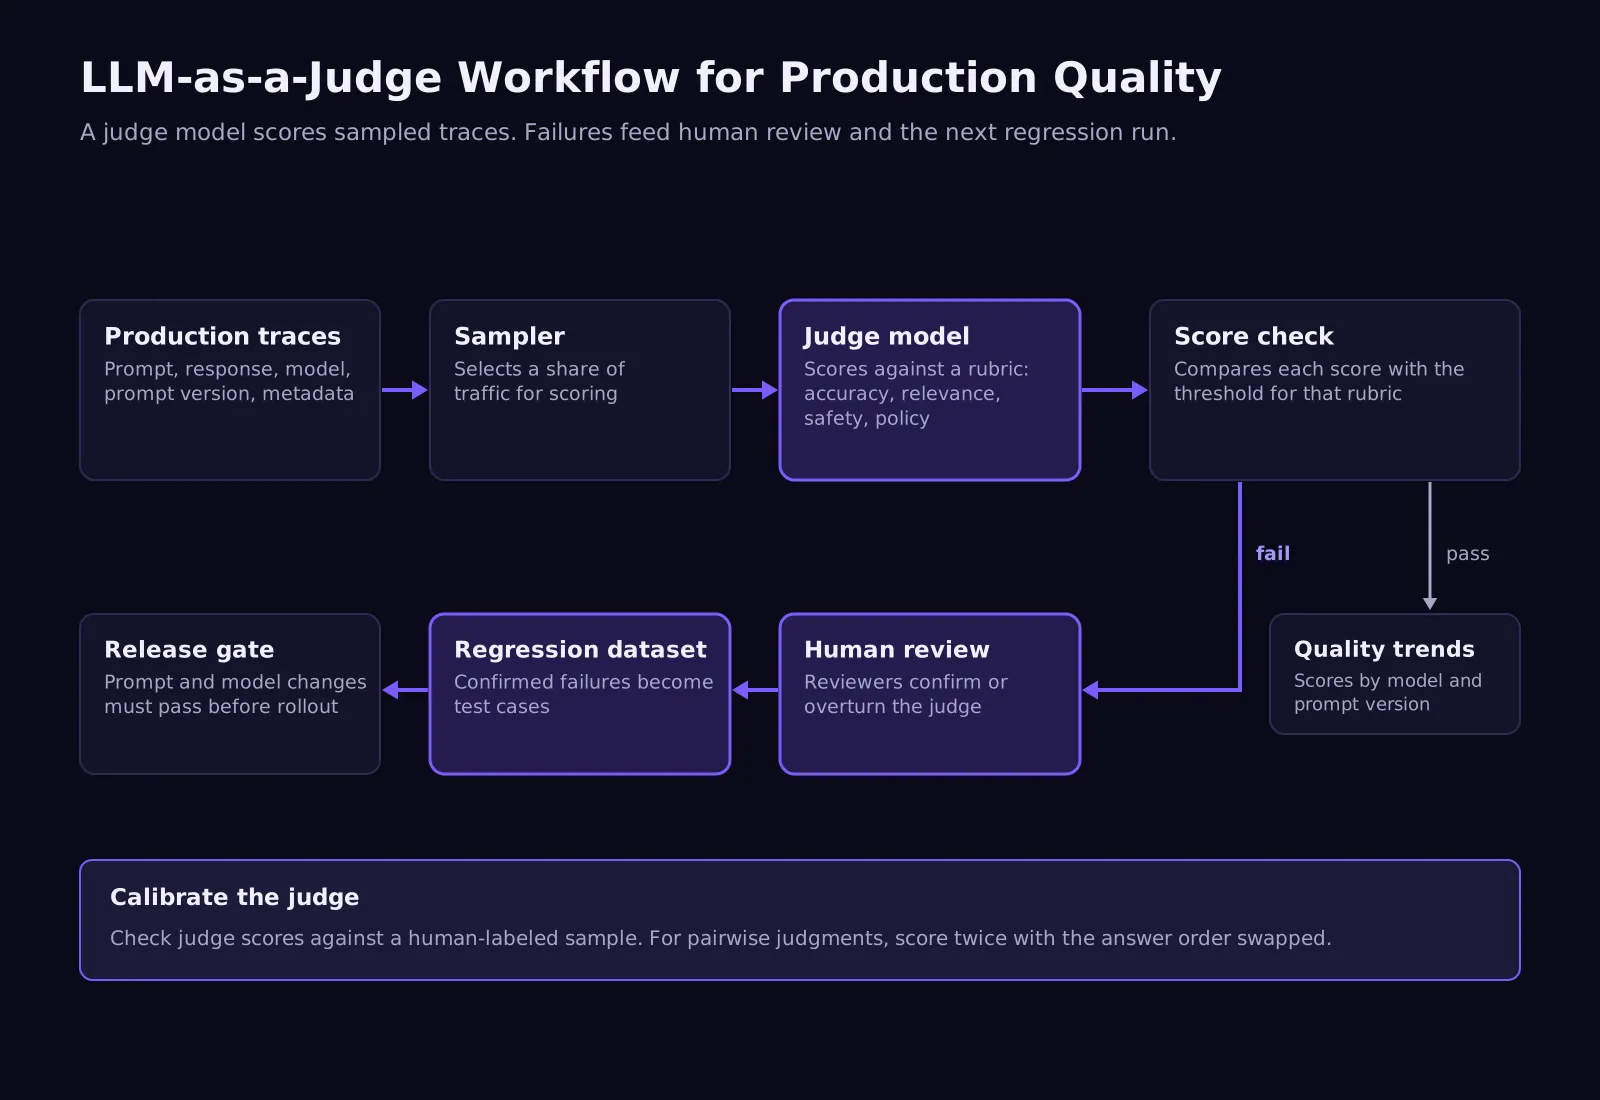
Mislukte antwoorden moeten worden toegevoegd aan regressiedatasets, zodat incidenten toekomstige releases versterken. Geautomatiseerde scoring kan grote steekproeven monitoren, terwijl menselijke labels een kwaliteitsbaseline bieden voor gevoelige beslissingen. Dit proces verandert evaluatie in continue release-controle in plaats van een eenmalige test vóór de lancering.
Stel vóór de lancering tokenbudgetten in per team, applicatie, model en omgeving. Voeg automatische onderbrekers (circuit breakers) toe voor agents, fallback-regels voor storingen bij providers en RBAC voor modeltoegang. Een limiet op het aantal stappen of tokens per run kan voorkomen dat een agent in een lus de dagelijkse toewijzing met één enkele request verbruikt.
Elke request moet metadata bevatten over identiteit, model, kosten en omgeving. Finance kan uitgaven toewijzen, engineering kan incidenten debuggen en compliance kan toegang reconstrueren. Deze gedeelde metadata ondersteunt ook beleidsoptimalisatie naarmate nieuwe modellen, teams en workloads het platform betreden.
Continue evaluatie heeft een beoordelaar nodig die het productievolume kan bijhouden. LLM as a judge gebruikt een afzonderlijk model om de primaire productie-LLM te beoordelen aan de hand van gedefinieerde criteria. Een judge kan nauwkeurigheid, volledigheid, relevantie, naleving van het beleid of veiligheid beoordelen met behulp van een geschreven rubriek en een gestructureerd resultaat.
In productie kunnen judges gesampelde traces asynchroon beoordelen zonder dat mensen elk antwoord hoeven te lezen. Ze kunnen ook inline draaien voordat een antwoord de gebruiker bereikt, wat een extra model-call en extra latency toevoegt. Sommige inputcontroles kunnen parallel met de primaire request draaien, terwijl outputcontroles moeten wachten op de gegenereerde content.
Judge-modellen kunnen meetbare, herhaalbare evaluatievoorkeur (bias) vertonen. Eén studie evalueerde 12 LLM-judges over meer dan 100.000 instanties en vond een systematische positievoorkeur (position bias). De sterkte ervan varieerde sterk per judge en taak. Paarsgewijze evaluatie moet daarom de volgorde van antwoorden verwisselen, terwijl teams resultaten van de judge moeten kalibreren met door mensen gelabelde voorbeelden voordat ze erop vertrouwen.
LLM as a judge mag menselijk toezicht bij beslissingen met een hoog risico niet vervangen. Het werkt het beste als een vroegtijdige waarschuwingslaag voor kwaliteitsverloop, onveilige patronen en regressies. Een kleinere judge kan ook de evaluatiekosten verlagen wanneer de prestaties aan de vereiste norm voldoen.
Productiestoringen ontstaan vaak na de eerste succesvolle request. Ze verschijnen binnen governance, evaluatie, kostenbeheersing, toegangsbeheer en gereedheid voor audits. Deze zaken lijken tijdens vroege prototypes vaak van secundair belang. Ze worden essentieel zodra het potentieel van LLM's meer bedrijfsworkloads bereikt.
Drie scenario's komen herhaaldelijk voor:
Elk scenario is in feite een probleem met de productie-architectuur. Gartner voorspelde dat meer dan 40% van de agentic AI-projecten tegen 2027 zal worden geannuleerd. Het noemde escalerende kosten, onduidelijke bedrijfswaarde en ontoereikende risicobeheersing als de belangrijkste oorzaken.
Teams vermijden deze storingen door vóór de lancering governance, observabiliteit en kostenbeheersing toe te voegen. Wanneer er een incident plaatsvindt, moet het platformteam de ontbrekende beheersmaatregel opsporen en centraal herstellen. Die reactie voorkomt dat dezelfde storing zich verspreidt naar andere teams of workloads.
TrueFoundry biedt een enterprise-besturingslaag voor AI-productiesystemen. De gateway-laag bevindt zich tussen applicaties, modelproviders, MCP-servers en agent-workflows. Het centraliseert routing, observabiliteit, governance, kostenbeheersing en guardrails voor gehoste en zelfbeheerde modellen.
De AI Gateway centraliseert modeltoegang, routing, guardrails, observabiliteit en kostenbeheersing. Dit beleid wordt consistent toegepast op alle productie-LLM-workloads. Dit is belangrijk wanneer meerdere teams verschillende modellen, providers, prompts, omgevingen of eisen voor snelheidslimieten gebruiken.
Een beveiligingsteam kan een PII-regel centraal toepassen in plaats van de beveiliging in elke service opnieuw op te bouwen. Dezelfde beleidslaag kan authenticatie, op metadata gebaseerde controles, budgetten en routing ondersteunen. Centralisatie geeft engineering-teams één operationeel model, terwijl beveiligings- en financieel teams consistent toezicht krijgen.
De LLM Gateway routeert requests naar gehoste en zelfgehoste modellen via een enkele interface. Virtuele modellen ondersteunen op prioriteit, gewicht en latency gebaseerde strategieën, evenals retries en fallbacks. Teams kunnen daarom van provider veranderen zonder applicatie-integraties opnieuw te bouwen of modelleveranciers hardcoded in elke service op te nemen.
Provider-afhankelijkheid neemt af doordat elke workload het model kan gebruiken dat aansluit bij de vereisten. Routing kan worden geoptimaliseerd voor beschikbaarheid, latency, functionaliteit of kosten. Applicatieteams gebruiken één logische modelnaam, terwijl platformteams de doelen aanpassen via configuratie.
De MCP Gateway beheert hoe AI-systemen toegang krijgen tot tools, API's, databases en interne services. Het ondersteunt enterprise-identiteit, op OAuth gebaseerde autorisatie, RBAC, metadata-policies en observabiliteit op toolniveau. Deze controles zijn van belang wanneer modelrespons verder gaat dan aanbevelingen en acties begint te triggeren binnen bedrijfssystemen.
Tool-governance moet de identiteit en rechten van de gebruiker waar mogelijk behouden. Een agent mag alleen de tools bereiken die volgens zijn policy zijn toegestaan. Rate limits en audit-records voegen een extra grens toe door het verzoekvolume te beheren en vast te leggen welke tools zijn uitgevoerd.
De Agent Gateway beheert stapsgewijze agent-workflows met retries, timeouts, quota en toegangscontroles. Het biedt ook end-to-end traces over de gehele workflow-uitvoering. Runtime-limieten kunnen herhalend gedrag, overmatig toolgebruik of onbeperkt tokenverbruik stoppen.
Agent-observabiliteit verbindt vervolgens elke stap met modellen, tools, latency, tokens en kosten. Dit is belangrijk omdat autonome workflows meerdere model- en tool-calls kunnen triggeren vanuit één enkel verzoek. Context op workflow-niveau maakt debugging, governance en incidentreconstructie veel duidelijker.
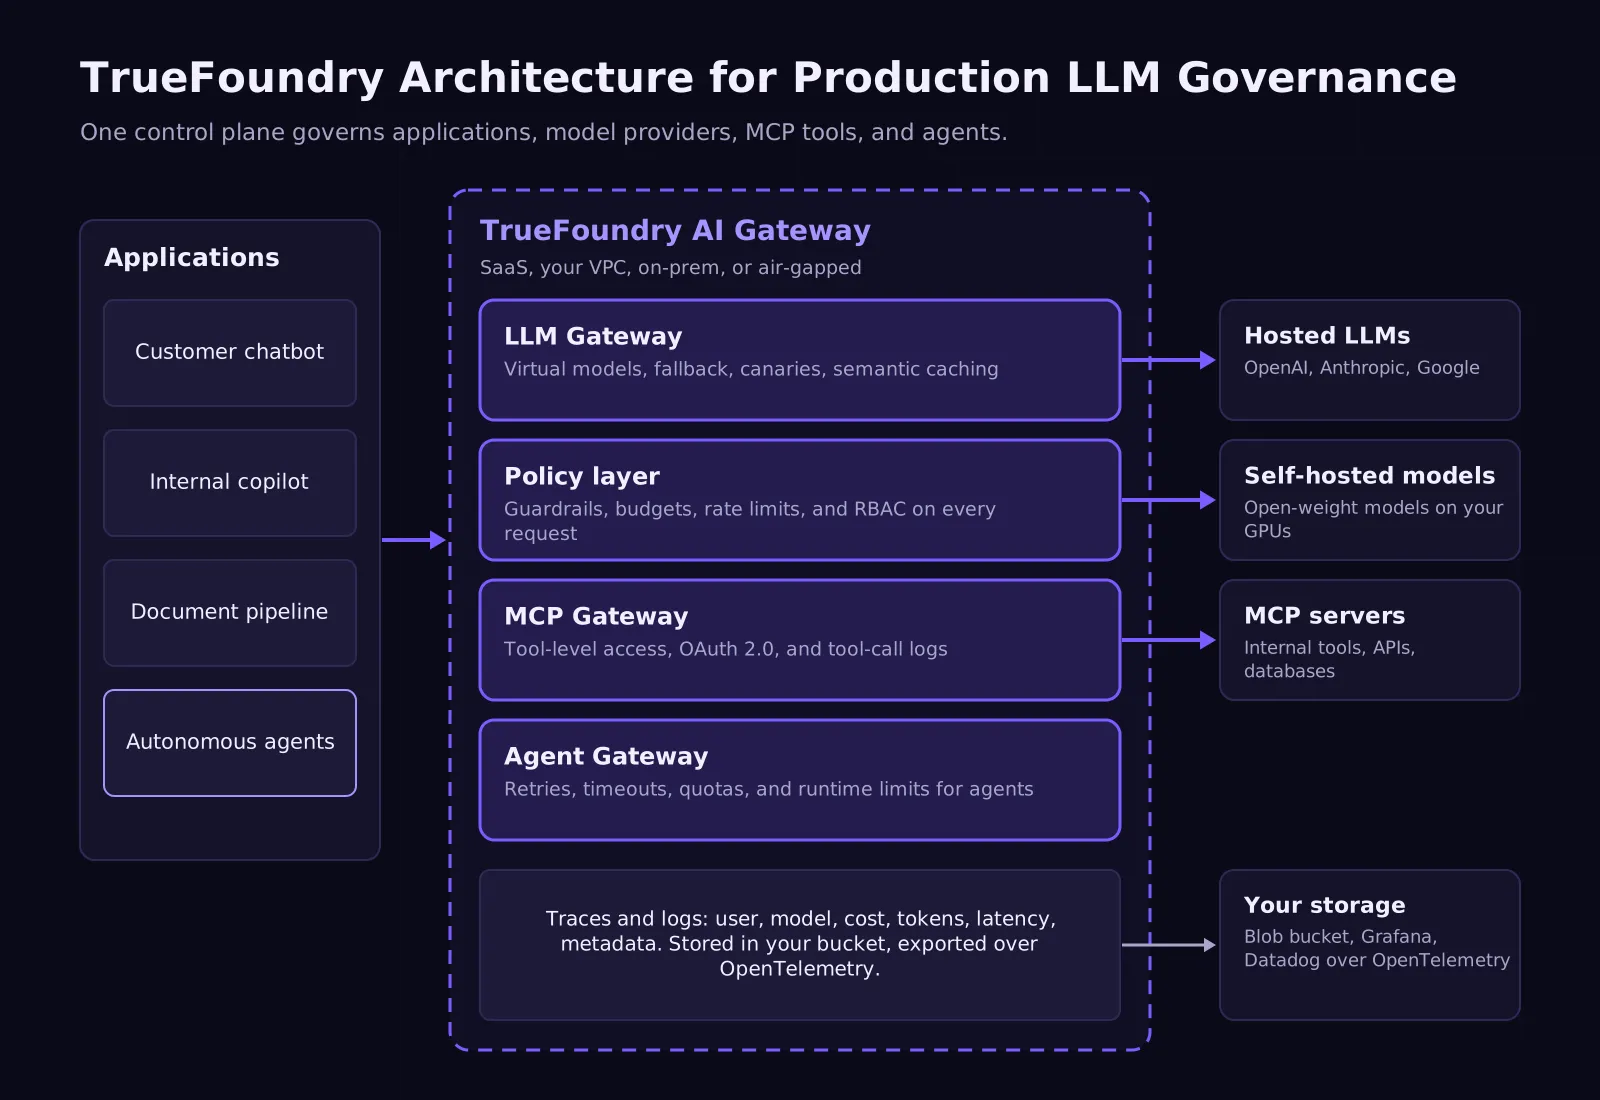
TrueFoundry kan verzoeklogs binnen de omgeving van de klant bewaren. In de hybride deployment draait het gateway-vlak in uw infrastructuur en schrijft het verzoek- en responsdata naar uw eigen blob storage in Parquet-formaat, waar tools zoals Spark of DuckDB er query's op kunnen uitvoeren. Data-routingregels kunnen traces van verschillende workloads naar verschillende buckets sturen.
Elke trace bevat gebruikersidentiteit, model, kosten, token-aantallen, latency en de metadata die uw applicaties toevoegen. De beheerde infrastructuur van TrueFoundry is SOC 2-, ISO 27001-, GDPR- en HIPAA-compliant.
Het bedrijf kondigde in december 2025 ook ITAR-compliant gateway-deployments aan voor on-premises en private VPC-omgevingen, en air-gapped deployments houden governance-data volledig buiten externe infrastructuur.
Als u deze controles in actie wilt zien op uw eigen modellen en verkeer, boek dan een demo met het TrueFoundry-team.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















