March 25, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De factuur kwam binnen op de eerste van de maand en was drie keer hoger dan het team had gemodelleerd.
Ze hadden hun huiswerk gedaan. Iemand avait de prijzenpagina van elke provider in een spreadsheet gezet, gesorteerd op dollars per miljoen tokens, en het goedkoopste model gekozen dat de kwaliteitstoets doorstond. Op papier klopte de berekening als een bus.
Toen kwam de praktijk. De retrieval werd rijker. De prompts werden langer. De agents begonnen tools aan te roepen die nog meer context in de volgende call voedden. En het ene getal waarop ze hadden geoptimaliseerd, de catalogusprijs, bleek het getal te zijn dat er amper toe deed.
Als je ooit hebt gestaard naar een AI-factuur die niet overeenkwam met je schatting, dan is deze gids voor jou. LLM-kosten zijn niet willekeurig. Het komt neer op vier knoppen, en ze zijn alle vier inzichtelijk en afstelbaar. Aan het einde kun je je eigen factuur modelleren in plaats van te gokken.
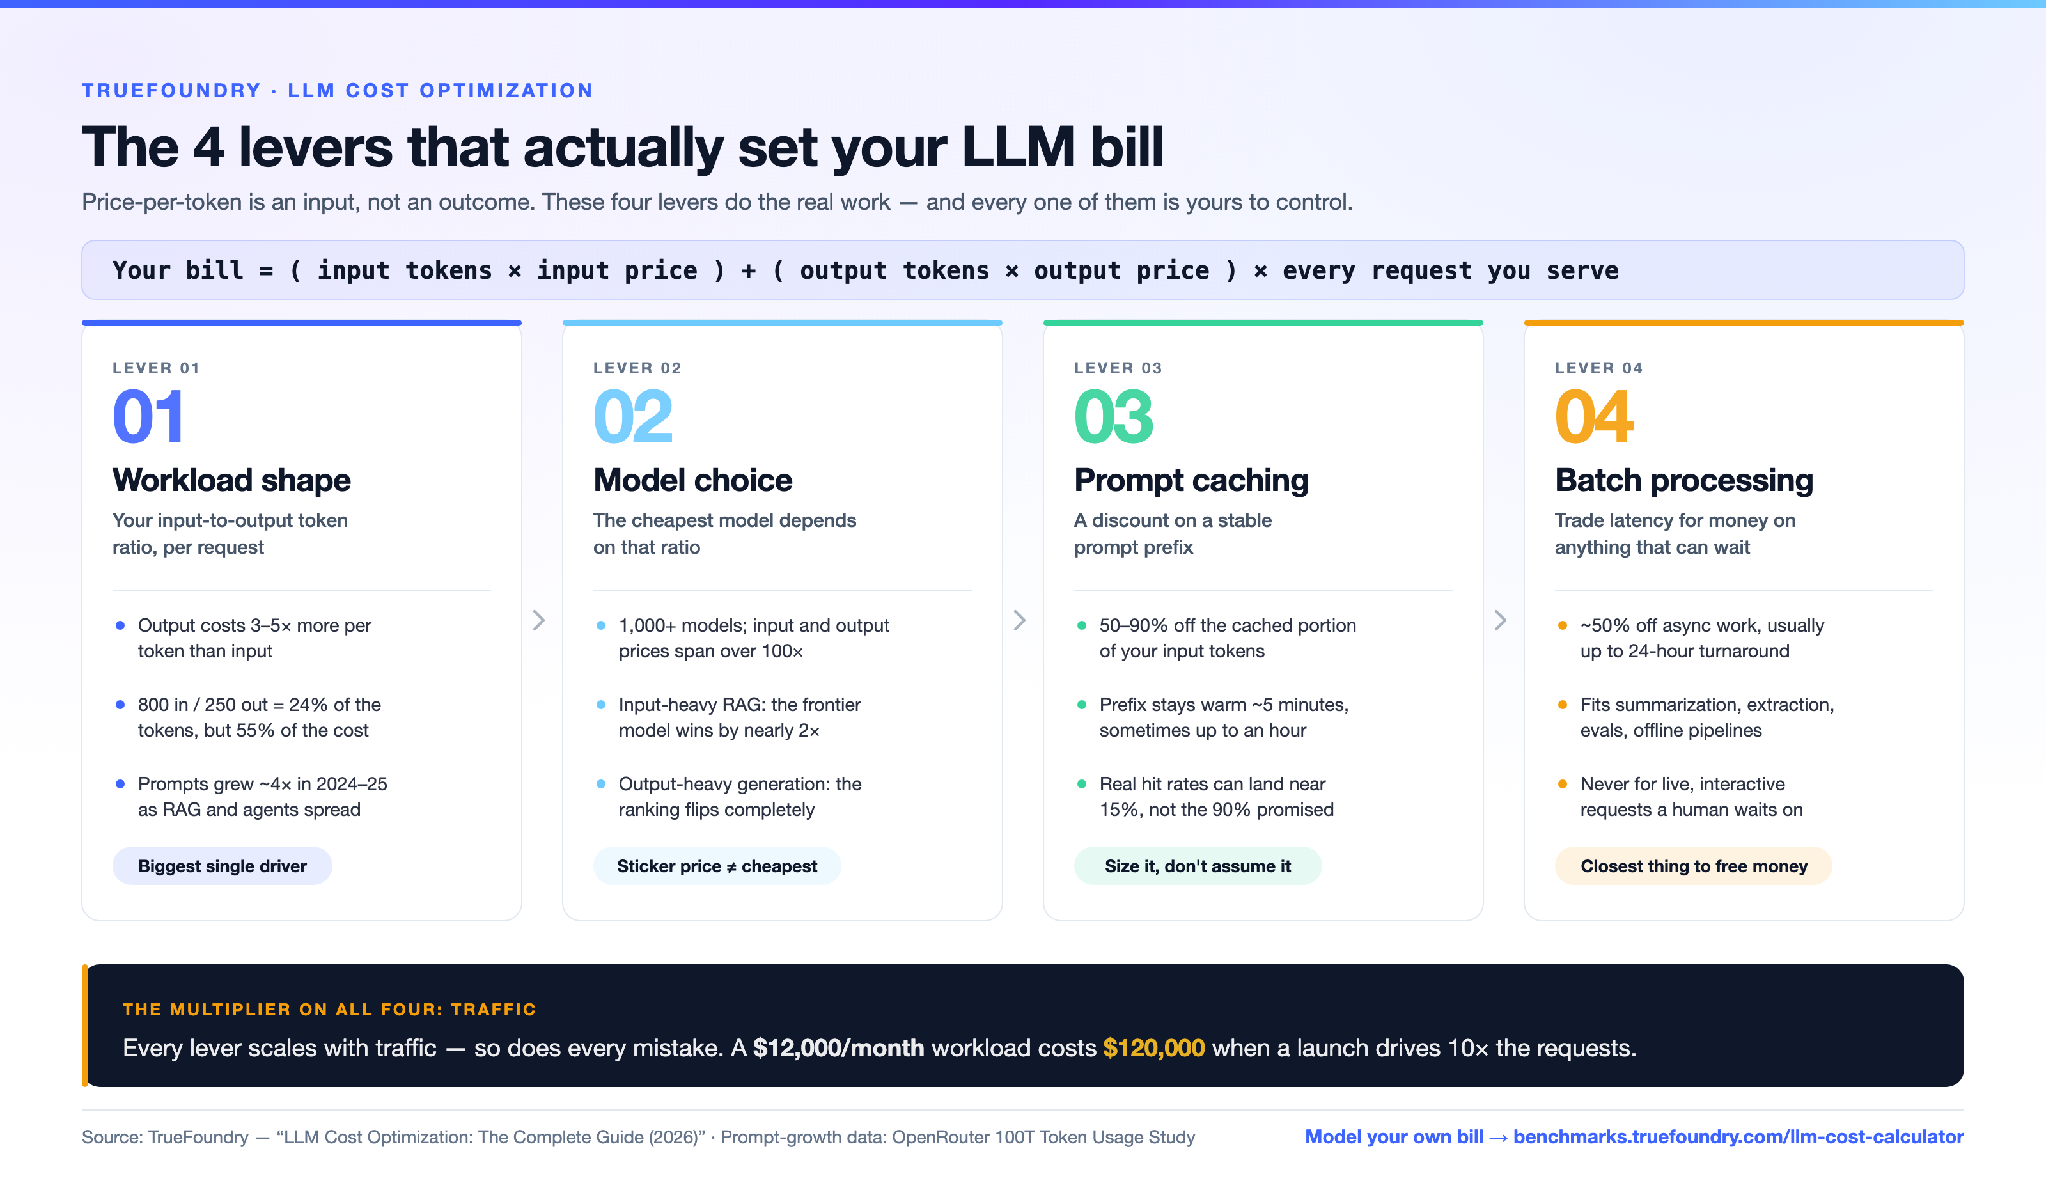
De vier knoppen voor LLM-kostenoptimalisatie. Workload shape bepaalt je verhouding tussen input- en output-tokens, waarbij output 3 tot 5 keer zo duur is als input. Modelkeuze heeft pas zin als je die verhouding kent, omdat het goedkoopste van 1.000+ modellen wisselt tussen input-zwaar en output-zwaar werk. Prompt caching haalt 50% tot 90% van een stabiele prompt-prefix af, maar alleen tegen de hit rate die je verkeer ondersteunt. Batch processing haalt ongeveer 50% af van alles wat tot 24 uur kan wachten. En verkeer vermenigvuldigt ze alle vier: een workload van $ 12.000/maand kost $ 120.000 bij een piek van 10×.
Prijs-per-token is reëel, het is gepubliceerd en het is het makkelijkst te vergelijken, wat precies is waarom iedereen zich erop vastpinnen. Het vergelijken ervan voelt als gedegen onderzoek.
Maar prijs-per-token is een input, geen resultaat. Je daadwerkelijke factuur ziet er zo uit:
(input tokens × inputprijs) + (output tokens × outputprijs), vermenigvuldigd met elke request die je afhandelt.
Elke factor in die vergelijking, behalve de prijs, is iets waar je controle over hebt, en de meeste daarvan schaduwen het prijsverschil tussen twee vergelijkbare modellen volledig. Twee teams die het "zelfde" model op "dezelfde" use case draaien, komen regelmatig uit op facturen die een factor 5 tot 10 verschillen, omdat hun token-berekening totaal anders is.
Stop dus met focussen op het prijskaartje en begin bij de vier zaken die je token-mechanica bepalen.
Elk request bestaat uit twee helften, en ze worden afzonderlijk geprijsd.
Input is alles wat je naar het model stuurt: de system prompt, de instructies, de opgehaalde documenten, de chatgeschiedenis, de vraag van de gebruiker. Het is meestal de grotere, goedkopere helft.
Output is wat het model terug genereert: het antwoord, de code, de samenvatting. Het is bijna altijd de duurdere helft.
Hoeveel duurder? Bij de meeste geavanceerde modellen kost output 3 tot 5 keer meer per token dan input. GPT-4o rekent bijvoorbeeld $ 2,50 per miljoen input tokens en $ 10,00 per miljoen output tokens. Dat is een gat van 4x op hetzelfde request.
Dat verschil wordt snel zichtbaar. Neem een eenvoudige chatbot-interactie: 800 tokens erin, 250 tokens eruit. De output vormt slechts 24 procent van de tokens, maar 55 procent van de kosten. Je zou je prompt kunnen halveren en de factuur nauwelijks beïnvloeden. Kort het antwoord in en je merkt het meteen.
Workloads zijn aan beide kanten ook zwaarder geworden. De OpenRouter 100T Token Usage Study laat zien dat de gemiddelde promptgrootte tussen begin 2024 en 2025 ongeveer 4x is gegroeid, van circa 1.500 tokens naar meer dan 6.000, toen retrieval-augmented generation en tool use mainstream werden. Completions groeiden in dezelfde periode met ongeveer 3x.
Het kostencentrum is verschoven. Vroeger lag het vrijwel volledig bij output. Nu stapelen RAG en agentic workloads duizenden input tokens op elke call, waardoor de inputkant ook een kostenpost is die je niet kunt negeren.
Voordat je een enkel model vergelijkt, moet je je input-to-output verhouding kennen. Het is de grootste factor in wat je gaat betalen, en het bepaalt welk model voor jou het goedkoopst is.
Omdat input en output apart geprijsd zijn, hangt het goedkoopste model volledig af van je workload shape. De rangschikking draait om.
Stel je twee modellen voor:
Model A lijkt goedkoper. Het is lager geprijsd op input en het belangrijkste getal is kleiner. Maar doe de token-berekening:
Dezelfde twee modellen, tegengestelde conclusies. Het enige wat veranderde, was de vorm van het werk.
Dit is waarom "wat is de goedkoopste LLM?" de verkeerde vraag is. Er zijn meer dan duizend modellen op de markt, en hun input- en outputprijzen lopen meer dan twee grootteordes uiteen. De juiste vraag is specifieker: gegeven mijn input-to-output verhouding en mijn kwaliteitseisen, welk model heeft de laagste totale kosten? Dat is een vergelijking die je nooit handmatig zou moeten doen, en het is het eerste wat onze calculator voor je berekent.
Prompt caching is de meest overschatte knop op deze lijst.
Het idee is goed. Als het begin van je prompt identiek is bij meerdere requests — denk aan een grote system prompt, een vast instructieblok of een set few-shot voorbeelden — kan de provider dit cachen en je een forse korting geven, vaak 50 tot 90 procent op dat deel voor herhaalde calls. Voor een workload met een grote, stabiele prefix loopt dat snel op.
Maar claims over hit rates zoals "90 procent cache hits!" gaan uit van een best-case scenario dat je mogelijk nooit bereikt. Twee factoren bepalen je werkelijke hit rate:
Als je de som maakt, kan een workload met een paar duizend requests per dag, verdeeld over een paar dozijn prompt-varianten, uitkomen op een hit rate van slechts 15 procent op een venster van 5 minuten, en niet de 90 procent uit de brochure. Caching is daar niet stuk. Het gedraagt zich gewoon zoals het altijd doet: als een functie van je verkeer in plaats van een knop voor korting die je zomaar omzet.
Bereken de impact van caching dus goed voordat je erop rekent. Consolideer prompt-varianten, concentreer verkeer en kies voor het langere venster waar de provider dat aanbiedt. Controleer het getal vervolgens met je daadwerkelijke volume.
We gaan hier dieper op in in Prompt Caching: Why Your Hit Rate Won't Be 97%, een uitgebreidere blik op wat caching je werkelijk bespaart.
Als een request niet direct een antwoord nodig heeft, is batch processing de knop met het hoogste rendement. Providers bieden ongeveer 50 procent korting voor werk dat je asynchroon wilt indienen en binnen een bepaalde tijd wilt ophalen, meestal binnen 24 uur.
Vijftig procent korting, enkel voor het accepteren van een vertraging. Er is bijna niets anders in softwareontwikkeling waar je de kosten halveert door alleen de SLA aan te passen.
Het addertje onder het gras is de SLA zelf. Batch is geschikt voor alles wat offline gebeurt:
En het is een no-go voor alles waarop een mens zit te wachten, zoals live chat, interactieve assistenten of iets binnen een request-response UI. Dat is de hele afweging: latency inruilen voor geld.
De fout die we het vaakst zien, is vergeten dat batch bestaat voor de helft van de workload die er gebruik van zou kunnen maken. Veel "real-time" AI-systemen hebben een grote offline staart, zoals de herindexeringstaak of de nachtelijke classificatie, waarvoor de volle prijs wordt betaald.
Lees meer over waar de korting echt is en waar niet in LLM Batch Processing: When the 50% Discount Is Real.
De vermenigvuldiger die je vergat: verkeerspieken
Verkeer is wat een beheersbare factuur verandert in een noodgeval voor het budget.
Elke knop hierboven schaalt met het verkeer. Dat geldt ook voor elke fout. Een workload die bij een normale belasting $ 12.000 per maand kost, kost geen $ 12.000 wanneer een lancering zorgt voor een piek van 10x. Het kost $ 120.000, en dat gebeurt precies in de week waarin je de minste tijd hebt om erin te duiken.
De besparingen versterken elkaar hier in je voordeel. Het gat tussen een geoptimaliseerde deployment en een naïeve wordt groter naarmate het verkeer toeneemt. Het moment om de uitersten te modelleren is dus vóór de piek. Vraag jezelf nu af: hoe ziet deze factuur eruit bij 3x? Bij 10x? Als je het niet weet, ben je aan het hopen in plaats van aan het budgetteren.
We hebben een gratis LLM Cost Calculator gebouwd die deze hele gids omzet in een oefening van één minuut. Voer je verkeer en workload shape in, kies uit meer dan duizend modellen, schakel caching en batch in/uit, en zie je maandelijkse kosten en piekscenario's live updaten. Er is geen registratie en geen verkoopgesprek nodig, gewoon jouw cijfers.
Hier is de volledige methode, op volgorde:
Doe dit in een spreadsheet en het kost je een middag. Doe het in de LLM Cost Calculator en het kost je een minuut, inclusief live grafieken, een modelvergelijking over alle providers heen en een heldere aanbeveling bovenaan het rapport.
Het modelleren van de besparingen is stap één. Het realiseren ervan over tientallen modellen en teams, zonder je app telkens te herschrijven als de prijzen veranderen, is het moeilijkere deel.
Dat is waar de TrueFoundry AI Gateway voor dient. Eén OpenAI-compatibel endpoint geeft toegang tot meer dan duizend modellen bij elke grote provider. Overschakelen naar het goedkoopste model voor jouw workload shape is daardoor een configuratiewijziging, geen migratie. Ingebouwde kostenbeheersing, verbruikstracking per team, rate limits en fallbacks zorgen ervoor dat de besparingen die je hier hebt gemodelleerd niet wegsijpelen in productie. Je kunt zien waar elke dollar naartoe gaat en hierop sturen.
De calculator vertelt je wat je moet doen. De gateway is hoe je het eenmalig inricht en blijft uitvoeren, zelfs als modellen en prijzen onder je voeten veranderen.
Je workload shape, oftewel de verhouding tussen input- en output tokens per request, gecombineerd met het model dat je voor die specifieke vorm kiest. Dit beïnvloedt de factuur veel sterker dan de prijs per token die je op een prijzenpagina zou vergelijken.
De boosdoener is meestal het schatten op basis van de prijs per token in plaats van de werkelijke token-mechanica. Output tokens kosten 3 tot 5 keer meer dan input tokens, retrieval en tool use blazen de input op tot ver buiten de initiële prompt, en verkeerspieken vermenigvuldigen alles. Modelleer je werkelijke input- en output tokens en je verkeer om dit gat te dichten.
Ja, maar alleen voor zover je verkeer dat ondersteunt. Caching geeft korting op een stabiele prompt-prefix bij herhaalde requests, dus de besparing hangt af van hoe geconcentreerd je verkeer is en hoeveel verschillende prompts je gebruikt. Hoog volume op een klein aantal gedeelde prompts bespaart veel. Laag volume verdeeld over vele prompts bespaart weinig. Bereken de impact op basis van je echte cijfers voordat je er op rekent.
Elke keer dat het resultaat kan wachten. Batch verlaagt de kosten typisch met ongeveer 50 percent in ruil voor een asynchrone verwerkingstijd, vaak tot 24 uur. Dit maakt het ideaal voor samenvattingen, extractie, evals en offline pipelines, maar ongeschikt voor live, interactieve workloads.
Niet op basis van de catalogusprijs. Bereken de totale kosten per request, wat neerkomt op (input tokens × inputprijs) + (output tokens × outputprijs), voor jouw specifieke workload shape, en vergelijk ze daarna. Het goedkoopste model voor een input-zware RAG-toepassing is vaak niet het goedkoopste voor een output-zware generatie-toepassing. De LLM Cost Calculator doet dit automatisch voor meer dan duizend modellen.
Kortom: het getal op de prijzenpagina is het getal dat je het minst moet vertrouwen. Je factuur wordt bepaald door je workload shape, het model dat je daarvoor kiest, hoe goed je cacht en hoeveel je in batch verwerkt. Elk van die factoren heb je zelf in de hand. Stop dus met gissen en modelleer het in ongeveer een minuut.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox