



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een LLM agent werkend krijgen in een demo is bevredigend. Deze betrouwbaar laten werken in productie voor echte gebruikers, op schaal, dag in dag uit, is een heel andere discipline.
In een recente video onderzocht educator en ontwikkelaar Sam precies deze kloof. Hij legde een raamwerk van zeven onderdelen uit voor teams die serieus de stap willen maken voorbij de proof of concept. De laatste drie principes die hij behandelt — tools en MCP servers, monitoring en tracing, en agent evals — zijn waar de meeste productie-implementaties in stilte mislukken. Maar ze rusten op vier fundamenten die eerst stevig moeten staan.
Dit bericht breidt dat raamwerk uit tot een complete gids. Als je een engineeringteam, een CTO of een oprichter bent die een agentic AI-systeem naar echte gebruikers brengt, zijn dit de zeven dingen waar je geen bochten in kunt afsnijden.
Het patroon van falen is bijna altijd hetzelfde. Een agent presteert uitstekend in een notebook — één gebruiker, gecontroleerde invoer, een geduldige evaluator. Vervolgens komt hij in aanraking met de echte wereld: gelijktijdige sessies, inconsistente invoer, uitval van tools, compliance-eisen en gebruikers die zich totaal anders gedragen dan de testcases.
De modellen zijn het probleem niet. De huidige frontier LLMs zijn echt krachtig. Het probleem is de operationele laag — alles wat zich om het model heen bevindt. Dit is wat LLMOps inhoudt: de discipline van het draaien van op LLM gebaseerde systemen in productie met dezelfde rigoureuze aanpak die je zou toepassen op elk ander kritiek softwareonderdeel. De meeste teams die LLM agents in productie bouwen, leren het belang hiervan op de harde manier.
Hier zijn de zeven pijlers.
Prompts zijn het meest breekbare onderdeel van elk LLM-systeem — en de meeste teams behandelen ze als Post-its.
In prototypes staan prompts in Python-strings binnen Jupyter notebooks. Niemand houdt bij wanneer ze zijn gewijzigd, wat de vorige versie was, of dat een aanpassing van afgelopen dinsdag de reden is dat de agent deze week ineens anders reageert. Dat is prima voor experimenten. In productie is het een tikkende tijdbom.
Wanneer een prompt verandert — zelfs subtiel — kan dit het gedrag van de agent ongemerkt veranderen op manieren die niet meteen zichtbaar zijn. Een weggehaald teken uit een system prompt. Een anders geformuleerde instructie. Een gewijzigd few-shot voorbeeld. Elk van deze punten is een potentiële regressie zonder audit trail.
Prompt management is het fundament van elke serieuze LLMOps-praktijk. Elke andere laag in de stack is afhankelijk van stabiele, auditeerbare invoer voor het model.
Multi-step agents zijn stateful. Het overzichtelijk beheren van die status (state) over verschillende interacties, tool calls en sessies heen is een van de moeilijkste onopgeloste problemen in productie van agentic AI — en een van de minst besprokene.
Een agent in productie moet context behouden binnen een gesprek, over de stappen van een taak met meerdere tools heen, en soms zelfs over verschillende sessies voor terugkerende gebruikers. Gaat er hier iets mis, dan krijg je agents die halverwege de taak kritieke context vergeten, informatie tussen gebruikers laten lekken, of tot verkeerde conclusies komen omdat ze redeneren op basis van verouderde status.
De kwestie van het geheugen is niet alleen technisch — het is architecturaal. Wat blijft er in het context window? Wat wordt samengevat? Wat wordt opgeslagen in een vector store? Wat wordt volledig weggegooid? Er zijn geen universele antwoorden, maar er moet wel een weloverwogen antwoord zijn voor jouw specifieke use case.
Geheugenbeheer wordt vaak als een bijzaak behandeld. In productie is het het verschil tussen een agent die samenhangend en betrouwbaar aanvoelt en een die wispelturig overkomt.
Als je bouwt voor één gebruiker, kun je dit onderdeel overslaan. Als je bouwt voor een team, een bedrijf of een multi-tenant use case — en dat geldt voor de meeste serieuze LLM agents in productie — is dit vanaf dag één onmisbaar.
Multi-user omgevingen brengen een reeks uitdagingen met zich mee die niet bestaan bij prototypes: wie kan welke agents aanroepen, tot welke gegevens heeft elke gebruiker toegang, hoe worden kosten toegewezen, en wat is de audit trail als er iets misgaat? LLM agents werken vaak met verhoogde rechten — ze voeren queries uit op databases, roepen externe API's aan en schrijven naar opslag. Zonder de juiste governance wordt zelfs een goedbedoelde agent een risico voor beveiliging en compliance.
Het achteraf toevoegen van toegangsbeheer aan een agentarchitectuur die daar niet op is ontworpen, is duur en foutgevoelig. Bouw het meteen vanaf het begin in.
In een prototype roep je één model aan. In productie beheer je een portfolio: verschillende aanbieders, verschillende modelgroottes, verschillende afwegingen tussen latency, kosten en functionaliteit — en je hebt intelligente routing daartussen nodig. Dit type AI agent orchestration — het sturen van de juiste taak naar het juiste model tegen de juiste kosten — onderscheidt een productiewaardig systeem van een prototype.
Een AI gateway werkt als de verkeersregelaar voor al je LLM-aanroepen. Het centraliseert API-sleutelbeheer, dwingt rate limits af, routeert verzoeken op basis van kosten of type taak, regelt fallbacks bij uitval van een provider en biedt één centrale plek voor observatie over elke modelaanroep in de organisatie.
Zonder gateway eindig je met schaduw-AI — teams die hun eigen verbindingen met modellen opzetten met hun eigen sleutels, hun eigen kosten en nul zicht op wat er wordt aangeroepen. Op schaal is dit zowel een governance-fout als een kostenprobleem.
Dit is een van de drie principes die Sam gedetailleerd behandelt in de video — en het onderdeel waar hij de meeste tijd aan besteedt.
Tools zijn de manier waarop je agent actie onderneemt in de wereld. In het moderne agentic ecosysteem zijn MCP (Model Context Protocol) servers de standaardinterface geworden om tools beschikbaar te stellen aan agents — een gestructureerde, ontdekbare manier voor een agent om te interageren met externe systemen: databases, API's, code-executieomgevingen, zoekmachines en meer.
Maar tools zijn ook de meest voorkomende oorzaak van ongemerkte uitval in productie. Een agent die een kapotte tool aanroept, faalt niet op een nette manier. Vaak raakt hij in een spiraal — opnieuw proberen, aannemelijk klinkende output genereren op basis van een fout die hij als succes heeft geïnterpreteerd, of vervolgacties uitvoeren op verkeerde data. Deze fouten zijn verraderlijk omdat ze lijken op redeneerfouten van de agent, terwijl het werkelijke probleem een kapotte integratie is.
Het punt van Sam is helder: elke tool heeft tests nodig, en authenticatie moet worden gecentraliseerd. Dit zijn geen optionele extra's. Het is de minimale ondergrens voor productie.
De beste productieteams behandelen tools als hoogwaardige services met hun eigen operationele levenscyclus. Als je niet weet of je tools goed werken, weet je ook niet of je agent goed werkt.
Sams zesde principe — en degene die alles wat daarna komt mogelijk maakt.
Standaard APM- en loggingtools zijn niet ontworpen voor de uitvoeringspatronen die LLM agents genereren. Een enkele agenttaak kan wel tientallen LLM-aanroepen bevatten, vijf tool-aanroepen, vertakkende logica, retries en delegatie naar sub-agents — allemaal niet-deterministisch en potentieel langdurig. Een Datadog-trace of een CloudWatch-log kan je de responstijd vertellen. Het kan je niet vertellen waarom de agent bij stap vier de verkeerde conclusie trok.
LLM tracing lost dit op. Het volgt een volledige agent-run van begin tot eind en legt elke verzonden prompt, elk ontvangen antwoord, elke uitgevoerde tool call en elke beslissing vast — samengevoegd tot één inspecteerbare uitvoeringsgrafiek. Zonder LLM tracing is het oplossen van een productiefout alsof je een gesprek uit je geheugen moet reconstrueren.
LLM observability is de bredere praktijk: niet alleen de mogelijkheid om individuele runs te tracen, maar de mogelijkheid om het gedrag van de agent in het algemeen te monitoren — het opvangen van kostenafwijkingen, kwaliteitsverlies, uitschieters in latency en ongebruikelijke tool-patronen voordat gebruikers er iets van merken.
Sam omschrijft dit als weten "wat er werkt en wat er misgaat." Dat is het minimale. Goed uitgevoerde LLM observability vertelt je ook waarom dingen werken en waarom ze misgaan — en dat is de invoer die je nodig hebt voor continue verbetering.
Monitoring is wat agent evals mogelijk maakt. Je kunt niet evalueren wat je niet kunt zien.
Sams zevende en laatste principe — en degene die de cirkel rondmaakt.
Agent evals zijn de manier waarop je weet of je LLM agents in productie daadwerkelijk beter of slechter worden bij elke verandering die je doorvoert.
Bij traditionele ML is evaluatie relatief helder: een gereserveerde testset, een gedefinieerde metriek, een duidelijk antwoord. Bij agentic AI is dat lastiger. Output is lang en bestaat uit meerdere stappen. Correctheid is vaak subjectief. De agent communiceert met live tools, dus het uitvoeren van een eval kan al echte gevolgen hebben. En omdat agents niet-deterministisch zijn, kan dezelfde invoer bij verschillende runs andere uitvoer opleveren.
Geen van deze uitdagingen is een excuus om agent evals over te slaan. Sam is hier heel stellig in: je kunt niet verantwoord wijzigingen in agents doorvoeren — nieuwe promptversies, model-upgrades, tool-aanpassingen — zonder een evaluatielaag die kwaliteitsverlies opvangt voordat het de gebruiker bereikt. Zonder agent evals ben je aan het gokken.
Het belangrijkste inzicht dat Sam belicht: agent evals moeten voortbouwen op je LLM observability- en tracing-infrastructuur. Je beste eval-cases zijn niet synthetisch — het zijn echte productieruns, geannoteerd en geselecteerd uit je trace-data. Dit is waarom monitoring op de eerste plaats komt.
Agent evals vormen de motor voor feedback. LLM observability vertelt je wat er is gebeurd. Agent evals vertellen je of het goed genoeg was. Samen zorgen ze ervoor dat je een LLM agent in productie continu kunt verbeteren zonder deze stuk te maken.
Deze principes vormen geen afvinklijstje waaruit je kunt kiezen. Het is een systeem, en de volgorde is van belang.
Prompt management geeft je een stabiel LLMOps-fundament om op te bouwen. State- en memory management zorgt ervoor dat je agent door de tijd heen samenhangend blijft. Multi-user architectuur maakt het veilig om de agent aan echte gebruikers beschikbaar te stellen. De AI gateway en de AI agent orchestration-laag geven je controle over het gehele modelportfolio. Tools en MCP servers laten je agent betrouwbaar handelen in de praktijk. Monitoring en LLM observability bieden het inzicht om te begrijpen wat er runtime echt gebeurt. En agent evals sluiten de feedbackcirkel — door productie-tracedata om te zetten in systematische kwaliteitsverbetering.
De video van Sam richt zich op de laatste drie omdat dit de onderdelen zijn die teams het vaakst overslaan als ze snel willen opleveren. De eerste vier worden vaak al gedeeltelijk aangepakt — je hebt enige prompt-discipline, enige authenticatie, enig modelbeheer. Maar monitoring, LLM tracing en agent evals zijn de onderdelen die bewust worden uitgesteld en vervolgens nooit meer worden opgepakt. Dat is precies het moment waarop incidenten in productie onvermijdelijk worden.
De teams die slagen met LLM agents in productie zijn de teams die alle zeven principes serieus nemen — ongeacht welk agent-framework ze gebruiken, op welke cloud ze draaien of voor welke use case ze bouwen.
TrueFoundry is een enterprise AI-platform dat vanaf de basis is opgebouwd voor deze uitdaging: het naar productie brengen van LLM agents in productie, van proof of concept tot operationele werkelijkheid, met de complete LLMOps-stack en enterprise-governance ingebouwd in elke laag.
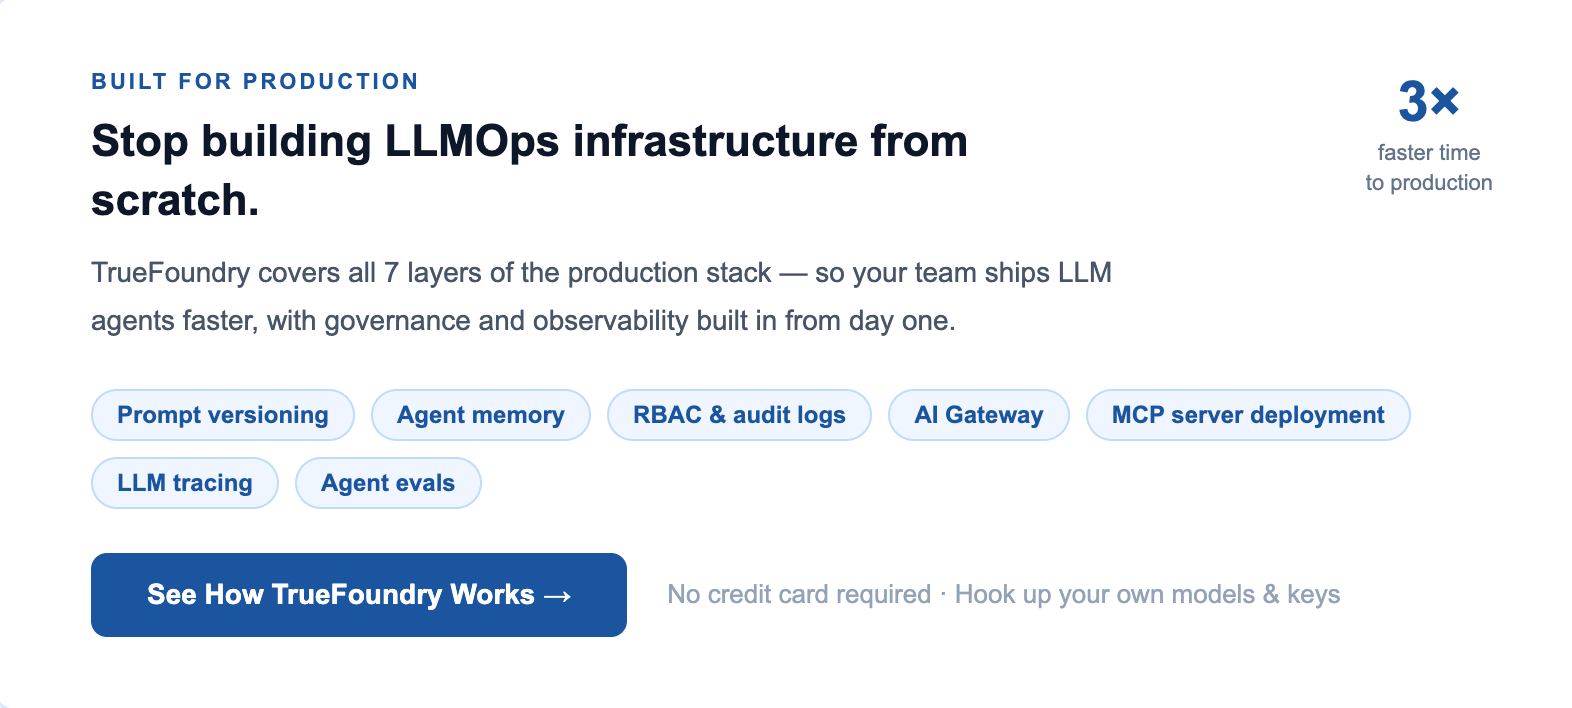
Het omvat alle zeven:
Klanten die TrueFoundry gebruiken melden 80% hoger GPU-clustergebruik, 3× snellere time-to-value met AI-agents en 35–50% reductie in infrastructuurkosten.
Sam noemt TrueFoundry aan het einde van de video: "Je kunt je eigen modellen en je eigen sleutels koppelen om direct aan de slag te gaan, wat het eenvoudig maakt om iets daadwerkelijk in productie te nemen met je team."
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



LLMOps (Large Language Model Operations) is the set of practices, tools, and infrastructure required to develop, deploy, monitor, and improve LLM-based applications in production. It extends MLOps to address properties unique to generative AI: non-determinism, prompt sensitivity, multi-step reasoning, and tool use. It covers everything from prompt management and model routing to LLM observability and agent evals.
The most common causes: prompts changing without version control creating silent regressions; state management errors causing agents to confuse or lose context; missing LLM observability making failures impossible to diagnose; untested tool integrations causing cascading errors; and lack of agent evals meaning nobody knows quality has degraded until users complain.
LLM observability is the practice of gaining visibility into what language models and agents are doing at runtime, at both the individual run level (LLM tracing: prompts, responses, tool calls, latency, tokens) and the aggregate level (dashboards, anomaly detection, cost monitoring). It's the operational foundation for debugging production failures and driving systematic quality improvement.
LLM tracing is a form of distributed tracing purpose-built for multi-step agent runs. It captures the complete execution graph of an agent task: every LLM call, every tool invocation, every branching decision, all stitched together into an inspectable trace. This is what enables root-cause analysis of production failures in non-deterministic, multi-step AI systems.
Agent evals are systematic processes for measuring the quality and reliability of AI agent outputs across prompt versions, model changes, and tool updates. Unlike traditional unit tests, agent evals must handle non-deterministic outputs, multi-step completion, and subjective quality criteria. Best practice combines automated metrics, LLM-as-judge scoring, and human review, ideally drawing test cases from real production traces.
MCP (Model Context Protocol) is an open standard for exposing tools and external integrations to LLM agents in a structured, discoverable way. An MCP server hosts a collection of tools (database queries, API calls, web search, code execution) that an agent can invoke. In production, MCP servers should be deployed, versioned, tested, and monitored like any microservice. Authentication for MCP tools should be centralized, not scattered across individual tool implementations.
TrueFoundry is a Kubernetes-native enterprise AI platform that covers the full LLMOps stack, from prompt management and multi-tenant access control to AI gateway, MCP server deployment, LLM tracing, and eval infrastructure. It's designed for teams moving agentic AI systems from proof-of-concept to production, with enterprise governance included by default.



Het laatste nieuws, artikelen en bronnen in je inbox



















