



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Kubernetes RBAC is de autorisatiemodus die bepaalt of een geauthenticeerd verzoek aan de API-server wordt toegestaan. Het wordt geleverd in de rbac.authorization.k8s.io/v1 API-groep en is ingeschakeld op vrijwel elk beheerd cluster.
Authenticatie en autorisatie zijn afzonderlijke stappen. De API-server stelt eerst vast wie u bent – via een clientcertificaat, OIDC-token, ServiceAccount-token of cloud IAM-identiteit – en vraagt vervolgens aan RBAC of die identiteit deze verb mag uitvoeren op deze resource. RBAC bepaalt nooit de identiteit, alleen de permissie.
Een RBAC-regel controleert een beperkte set verzoekvelden:
Twee eigenschappen zijn belangrijker dan welk syntaxisdetail ook.
RBAC is additief. Er is geen deny. Als een binding u een permissie verleent, heeft u deze. De enige manier om deze te intrekken is door elke binding die deze verleent te verwijderen. Vandaar het bekende ticket: "Ik heb hun admin-rol ingetrokken, maar ze kunnen nog steeds pods verwijderen."
RBAC is default-deny. Een verb die door niemand is verleend, wordt geweigerd. Het praktische risico is dus bijna nooit een ontbrekende regel – het is een regel die veel breder is dan de bedoeling was.
Een Role is een object met een namespace. Het verleent permissies op resources met een namespace, en uitsluitend binnen de namespace waarin het zich bevindt.
Een ClusterRole is niet gebonden aan een namespace. Het bestaat één keer voor het hele cluster en maakt drie dingen mogelijk die een Role niet kan:
De vraag k8s Role vs ClusterRole wordt meestal gesteld alsof het om rechten of macht gaat. Het gaat echter om scope en hergebruik:
Er zijn vier standaard ClusterRoles die u moet kennen voordat u uw eigen definieert: view (meeste resources met een namespace lezen, expliciet exclusief Secrets), edit (meeste lezen/schrijven, inclusief Secrets), admin (edit plus het maken van Roles en RoleBindings in de namespace), en cluster-admin (* op *, overal).
view, edit en admin zijn geaggregeerde ClusterRoles: de controller vult hun regels aan vanuit elke ClusterRole met een label dat overeenkomt met hun aggregationRule. Dat is de ondersteunde manier om deze uit te breiden voor uw eigen CRDs.
Een Role of ClusterRole op zichzelf verleent niets. Een binding koppelt deze aan subjects.
Een RoleBinding is gebonden aan een namespace en verleent de roleRef aan de subjects binnen de eigen namespace.
Het meest nuttige om te weten over RoleBinding in Kubernetes is dat de roleRef kan verwijzen naar een ClusterRole, waarbij de permissies beperkt blijven tot de namespace van de RoleBinding. Definieer de functionaliteit één keer; verleen deze per namespace:
Een ClusterRoleBinding heft die grens op en verleent een ClusterRole overal – elke namespace, plus alle cluster-scoped resources in de rol.
Drie regels die vaak voor verrassingen zorgen:
RBAC kent exact drie typen subjects, en het verschil zit in hun herkomst.
Er is geen User-resource – u kunt geen kubectl create user uitvoeren. Kubernetes vergelijkt de gebruikersnaam en groepslijst die de authenticator doorgeeft als platte tekst met de bindings. Een typfout in een subject-naam verleent dus stilzwijgend niets, zonder een foutmelding bij het toepassen.
ServiceAccounts vormen de identiteit die uw workloads gebruiken. Een pod die er geen specificeert, draait onder het default-account van zijn namespace. Dit account heeft geen permissies, maar het token wordt wel gekoppeld en geauthenticeerd – stel automountServiceAccountToken: false in op plekken waar een pod de API-server nooit aanroept.
Kubernetes genereert ook groepen die u nooit zomaar moet koppelen: system:authenticated (elke geauthenticeerde identiteit), system:serviceaccounts (allemaal, clusterbreed) en system:masters, dat door een standaardbinding rechtstreeks naar cluster-admin wordt gemapped.
De officiële richtlijnen zijn kort, en gaan vrijwel allemaal over scope.
Geef de voorkeur aan Roles met een namespace. Gebruik in eerste instantie een Role en RoleBinding. Gebruik pas een ClusterRole als de resource echt cluster-scoped is of als u één herbruikbare definitie wilt – en koppel deze ook dan met een RoleBinding, tenzij het subject daadwerkelijk toegang tot elke namespace nodig heeft.
Deel geen cluster-admin uit. Dit betreft * op *, inclusief de RBAC-objecten zelf, waardoor een houder zichzelf permanent alle rechten kan verlenen. Bewaar dit uitsluitend voor noodgevallen (break-glass).
Vermijd wildcards. resources: ["*"] dekt stilzwijgend ook CRDs af die maanden later worden geïnstalleerd, en verbs: ["*"] bevat ook deletecollection. Specificeer de acties expliciet.
Koppel groepen, geen individuele gebruikers. Een binding per persoon veroorzaakt problemen bij uitdiensttredingsprocessen. Map uw IdP-groepen naar het cluster en koppel die, zodat teamwijzigingen geen YAML-aanpassingen vereisen.
Beschouw list op Secrets als lees-toegang tot Secrets. list retourneert volledige objecten, dus het is even krachtig als get. Het lezen van Secrets legt bovendien de ServiceAccount-inloggegevens van die namespace bloot.
Ken de escalatie-verbs. create op pods stelt de gebruiker in staat om een pod uit te voeren als een willekeurig ServiceAccount in de namespace en de bijbehorende permissies over te nemen. escalate en bind heffen de beveiliging op die voorkomt dat u permissies verleent die u zelf niet bezit. impersonate maakt het mogelijk om te handelen als een andere identiteit.
Auditeer met de CLI, niet via de YAML. Omdat toegekende rechten additief zijn en uit verschillende bindings voortkomen, heeft alleen de API-server het juiste overzicht:
kubectl auth can-i delete pods --namespace team-alpha
kubectl auth can-i --list --namespace team-alpha
kubectl auth can-i list secrets \
--as=system:serviceaccount:team-alpha:reporting -n team-alpha
--as vereist impersonation-permissie, waarover beheerders doorgaans beschikken. Pas RBAC-manifesten toe met kubectl auth reconcile, wat regels en subjects samenvoegt in plaats van ze te vervangen.
Grijpen naar ClusterRoleBinding wanneer een RoleBinding zou volstaan. De meest voorkomende fout in de praktijk. Iemand heeft view-rechten nodig in de eigen namespace, de ClusterRole bestaat al, en een ClusterRoleBinding is één regel korter – maar verleent ook leesrechten over elke namespace, inclusief overal waar Secrets staan.
Aannemen dat namespaces meer isoleren dan ze daadwerkelijk doen. Een namespace is het bereik voor RBAC en niets meer – het is geen netwerk-, node- of resource-grens. "Ze hebben alleen toegang tot hun namespace" is een bewering over de API-server, niet over het cluster.
Koppelen aan system:authenticated voor het gemak. Het lijkt op "iedereen in het team". Het betekent echter elke identiteit die kan authenticeren, inclusief elk ServiceAccount in elke namespace.
Veronderstellen dat cluster-RBAC de platformlaag op het cluster dekt. Een data scientist zonder enige Kubernetes-permissies kan nog steeds een service deployen, een model aanroepen of een secret lezen, omdat die acties via een platform-API verlopen die buiten de scope van cluster-RBAC valt.
Kubernetes RBAC beantwoordt één specifieke vraag: wie mag deze verb uitvoeren op dit Kubernetes-object? Het heeft geen betrekking op een tweede vraag die even belangrijk is op een AI-platform: wie mag dit model deployen, dit provider-account gebruiken, deze MCP-tool aanroepen of deze secret-groep lezen? Dat zijn geen Kubernetes-objecten. Ze bevinden zich in een control plane, bereikbaar via een platform-API, en er is geen Role of RoleBinding die hierop toeziet.
TrueFoundry is Kubernetes-native – de compute plane bestaat uit een of meer van uw eigen EKS-, GKE-, AKS-, OpenShift- of on-premise-clusters, die uitgaand zijn verbonden met de control plane via een lichtgewicht tfy-agent. Beide lagen zijn tegelijkertijd aanwezig, dus het is van belang om precies te weten wat het verschil is.
De twee modellen delen dezelfde terminologie, en dat is geen toeval. In de key concepts van TrueFoundry is een Cluster een echt Kubernetes-cluster en een Workspace een Kubernetes-namespace. Wijst u iemand de rol van Workspace Member toe, dan beperkt u de toegang tot hetzelfde object als een RoleBinding zou doen.
Wat u niet doet, is het schrijven van een RoleBinding. Platformrollen en cluster-RBAC-objecten worden onafhankelijk van elkaar geconfigureerd op verschillende locaties. De documentatie beschrijft geen mechanisme dat de een genereert, synchroniseert of omzet naar de ander. Twee lagen met één gedeelde grens. De documentatie hanteert dezelfde scheidingslijn voor auditing: platform-auditlogs dekken platformactiviteit en vervangen expliciet geen auditlogs op infrastructuurniveau van Kubernetes of uw cloudprovider.
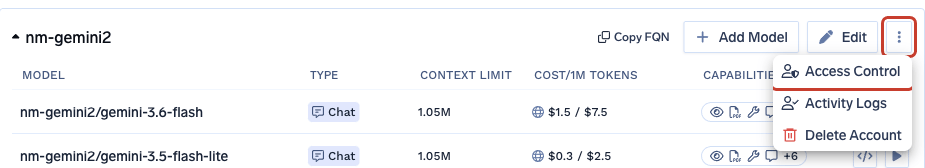
Het model is subject + resource + role = role binding, wat vertrouwd zal voorkomen. Een subject is een gebruiker, team, virtueel account of agent; een resource is een cluster, workspace, repository, secret-groep, provider-account of MCP-server. Het toewijzen van rechten begint bij de resource – open het menu met de drie puntjes en kies Access Control:
Selecteer vervolgens subjects en een rol. Het venster toont de acties die elke rol bevat:
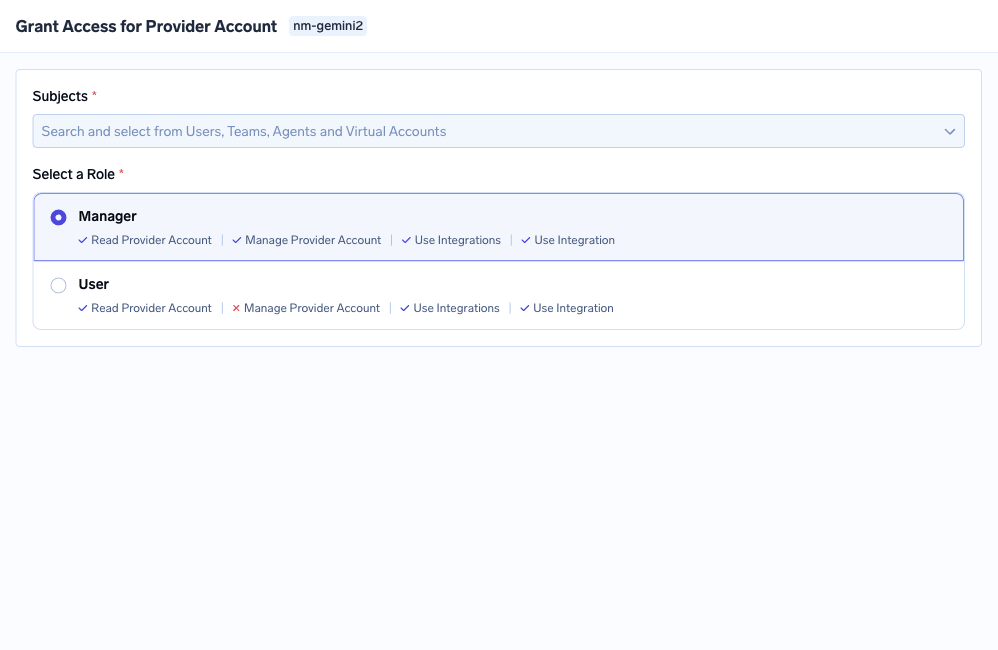
De beschikbare rollen hangen af van het resourcetype: Cluster Admin / Member / Viewer op een cluster, Workspace Admin / Member / Viewer op een workspace, Manager / User / Approver op een MCP-server. Onderliggend zijn de permissies opgebouwd als sleutels in de vorm resource:Action – cluster:ReadCluster, workspace:ManageWorkspace, secret-group:ReadData. Dezelfde regelstructuur als Kubernetes, maar voor andere objecten:
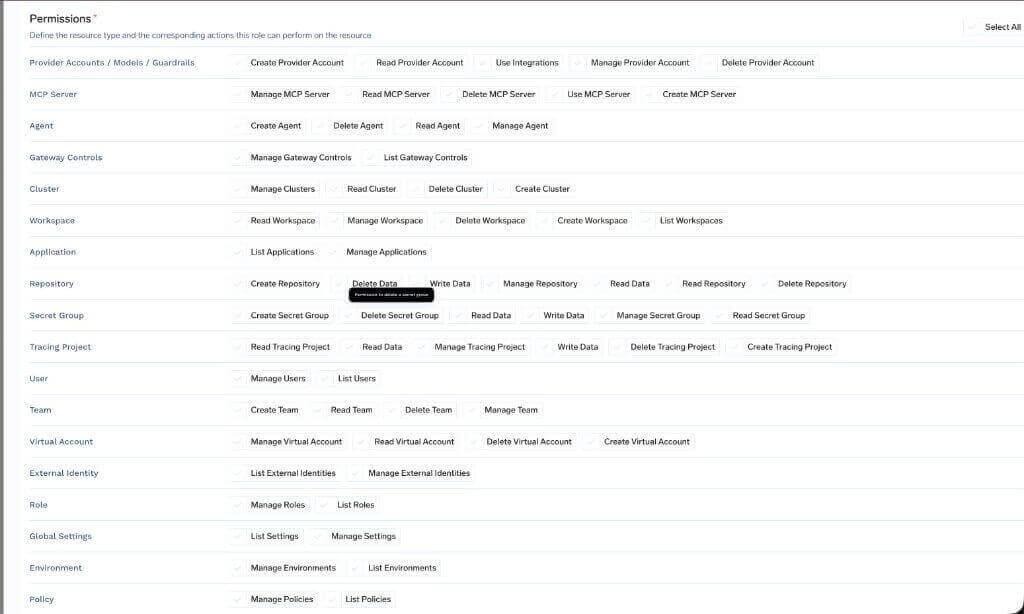
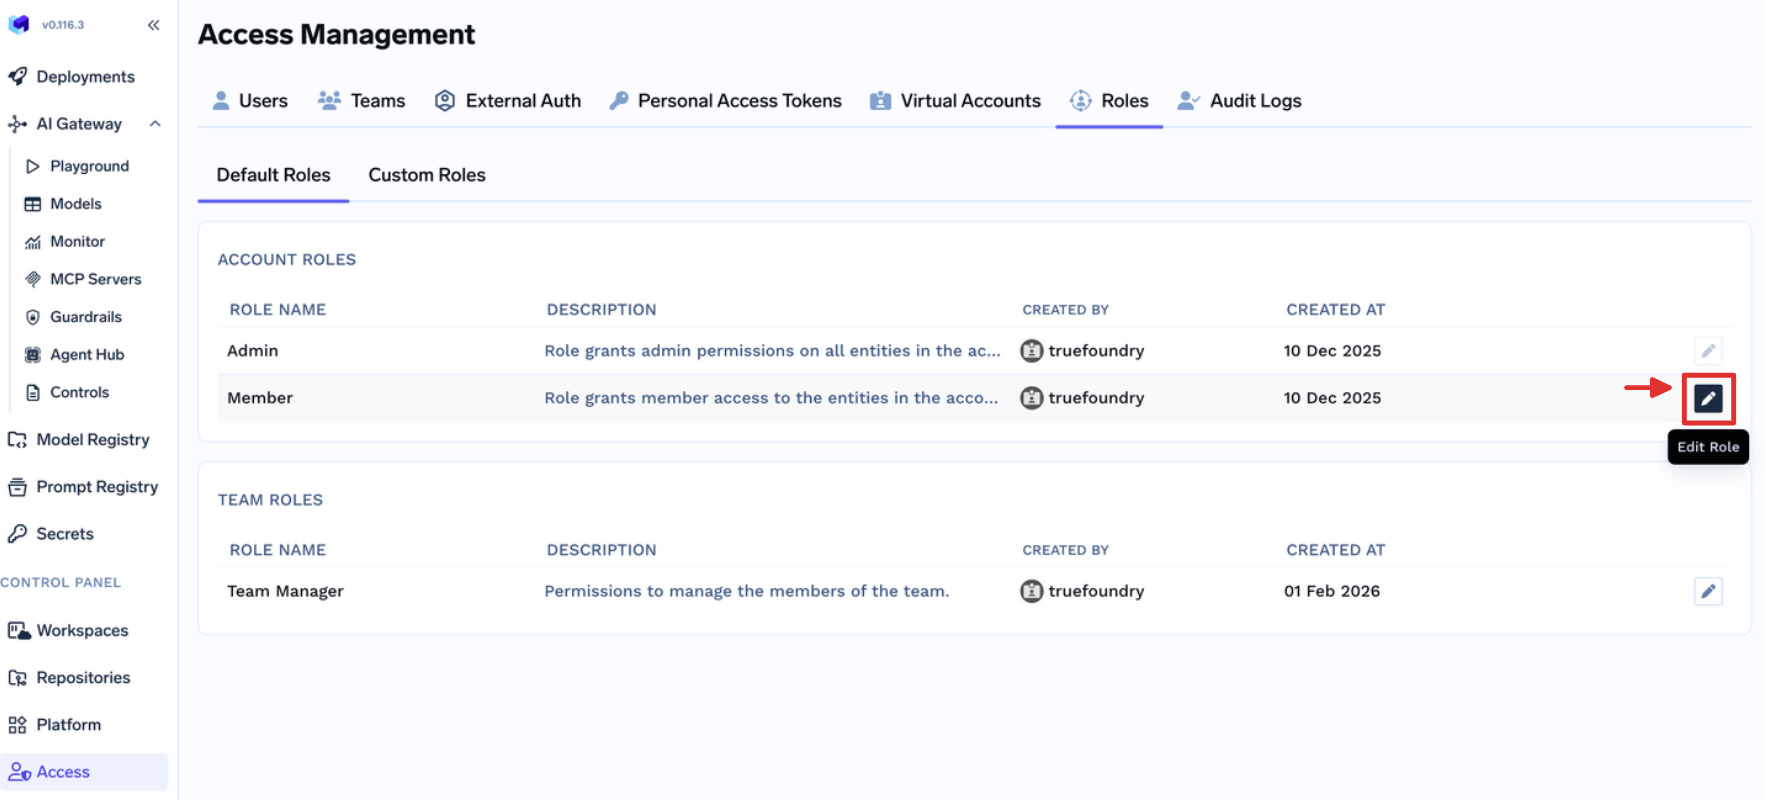
Tenant-brede rollen zijn het platform-equivalent van een ClusterRoleBinding en dragen dezelfde waarschuwing. Admin en Read-Only Member kunnen niet worden bewerkt. Member, de bewerkbare basisrol die elke gebruiker krijgt, is bewust beperkt – cluster:ReadCluster, user:ListUsers, agent:CreateAgent en nog enkele – zonder toegang tot individuele workspaces, modellen of MCP-servers.
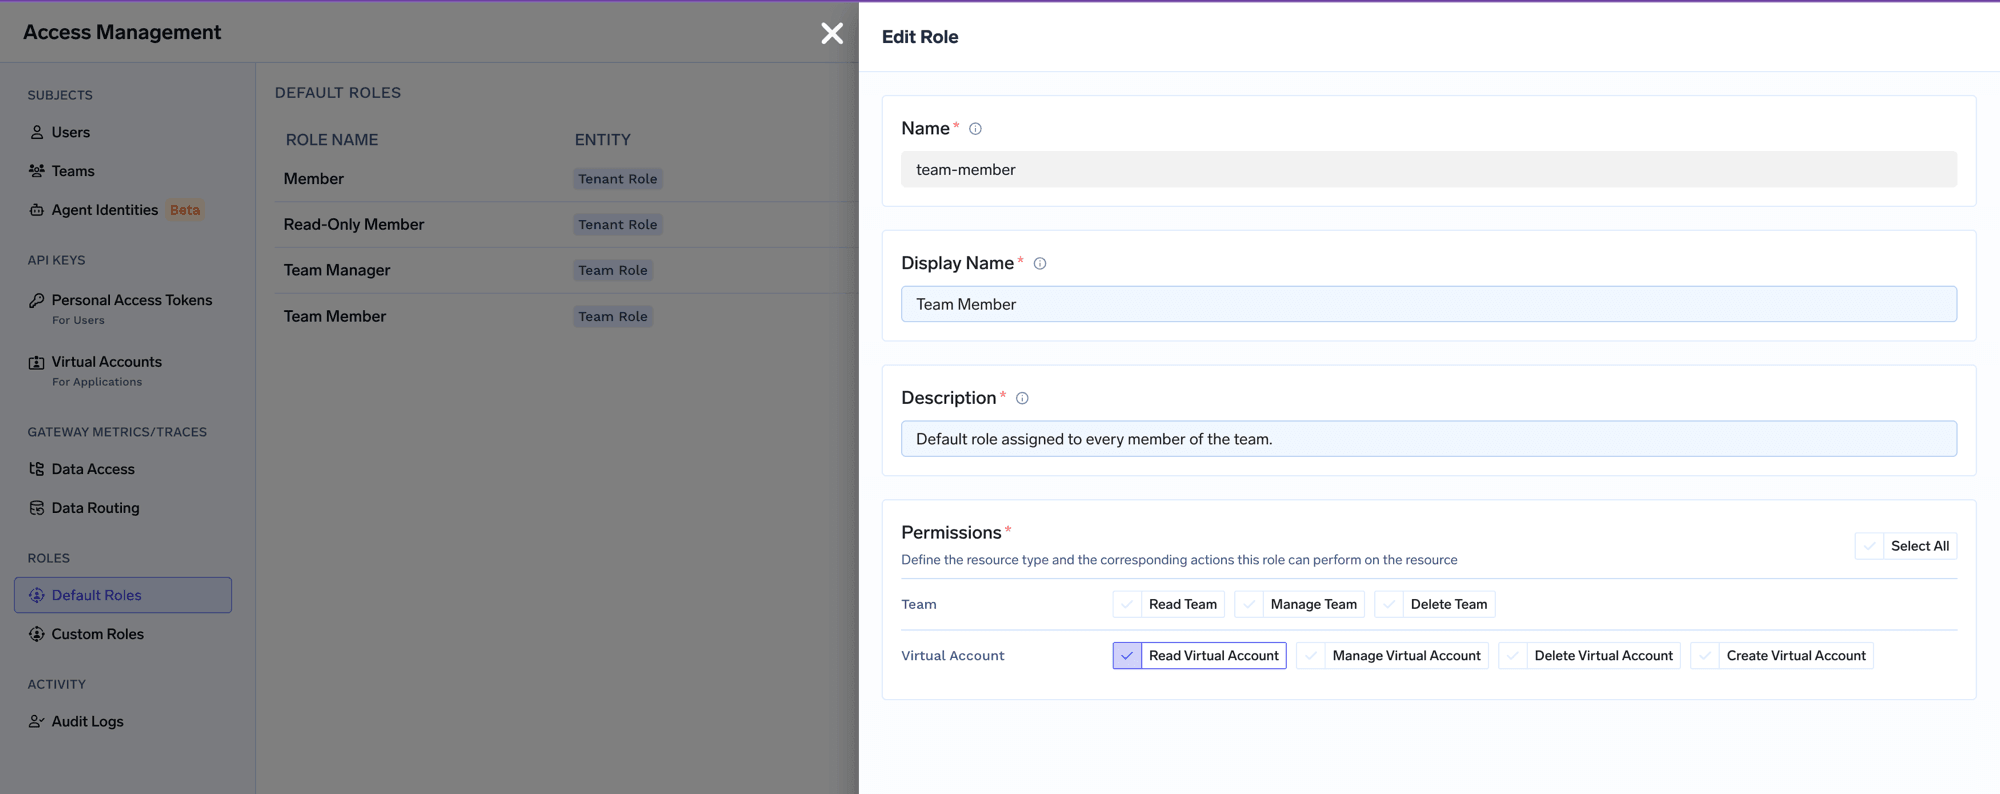
Teamrollen komen overeen met een RoleBinding gekoppeld aan eigenaarschap: Team Member bevat virtual-account:ReadVirtualAccount, beperkt tot Virtual Accounts die eigendom zijn van teams waar de gebruiker deel van uitmaakt.
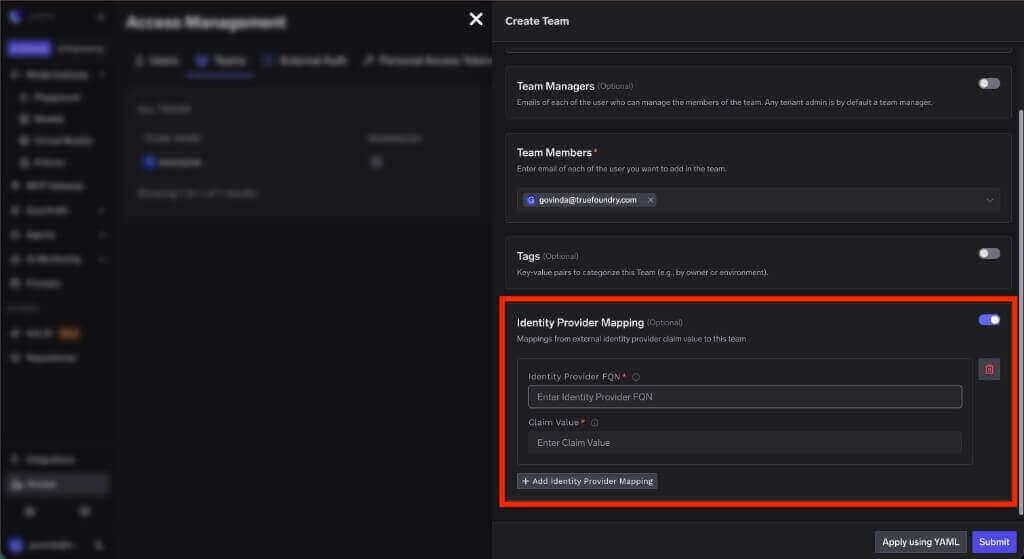
De best practice om groepen te koppelen in plaats van individuele gebruikers geldt ook hier. Een IdP-claimwaarde wordt gekoppeld aan een TrueFoundry-team, zodat dezelfde directorygroep die uw clusterbindings aanstuurt ook het platformlidmaatschap regelt:
Een realistisch scenario: stel het ML-team in staat te deployen naar hun eigen namespace en een MCP-server op te zetten, zonder iemand cluster-admin of tenant-admin te maken.
In Kubernetes. De namespace is ml-prod. Koppel edit aan die specifieke namespace via een RoleBinding waarvan het subject de door de IdP ondersteunde groep is:
Controleer dit, en controleer de reikwijdte ook in negatieve zin:
Let op: edit bevat Secrets in die namespace. Als het team deze niet mag lezen, koppel dan een beperktere, aangepaste ClusterRole.
In het platform. Niets van het bovenstaande geeft iemand het recht om een MCP-server aan te maken, omdat MCP-servers geen Kubernetes-objecten zijn. De neiging kan ontstaan om Admin-rechten te verlenen. Maak in plaats daarvan een aangepaste rol aan via Access > Custom Roles met exact de permissie mcp-server:CreateMcpServer:
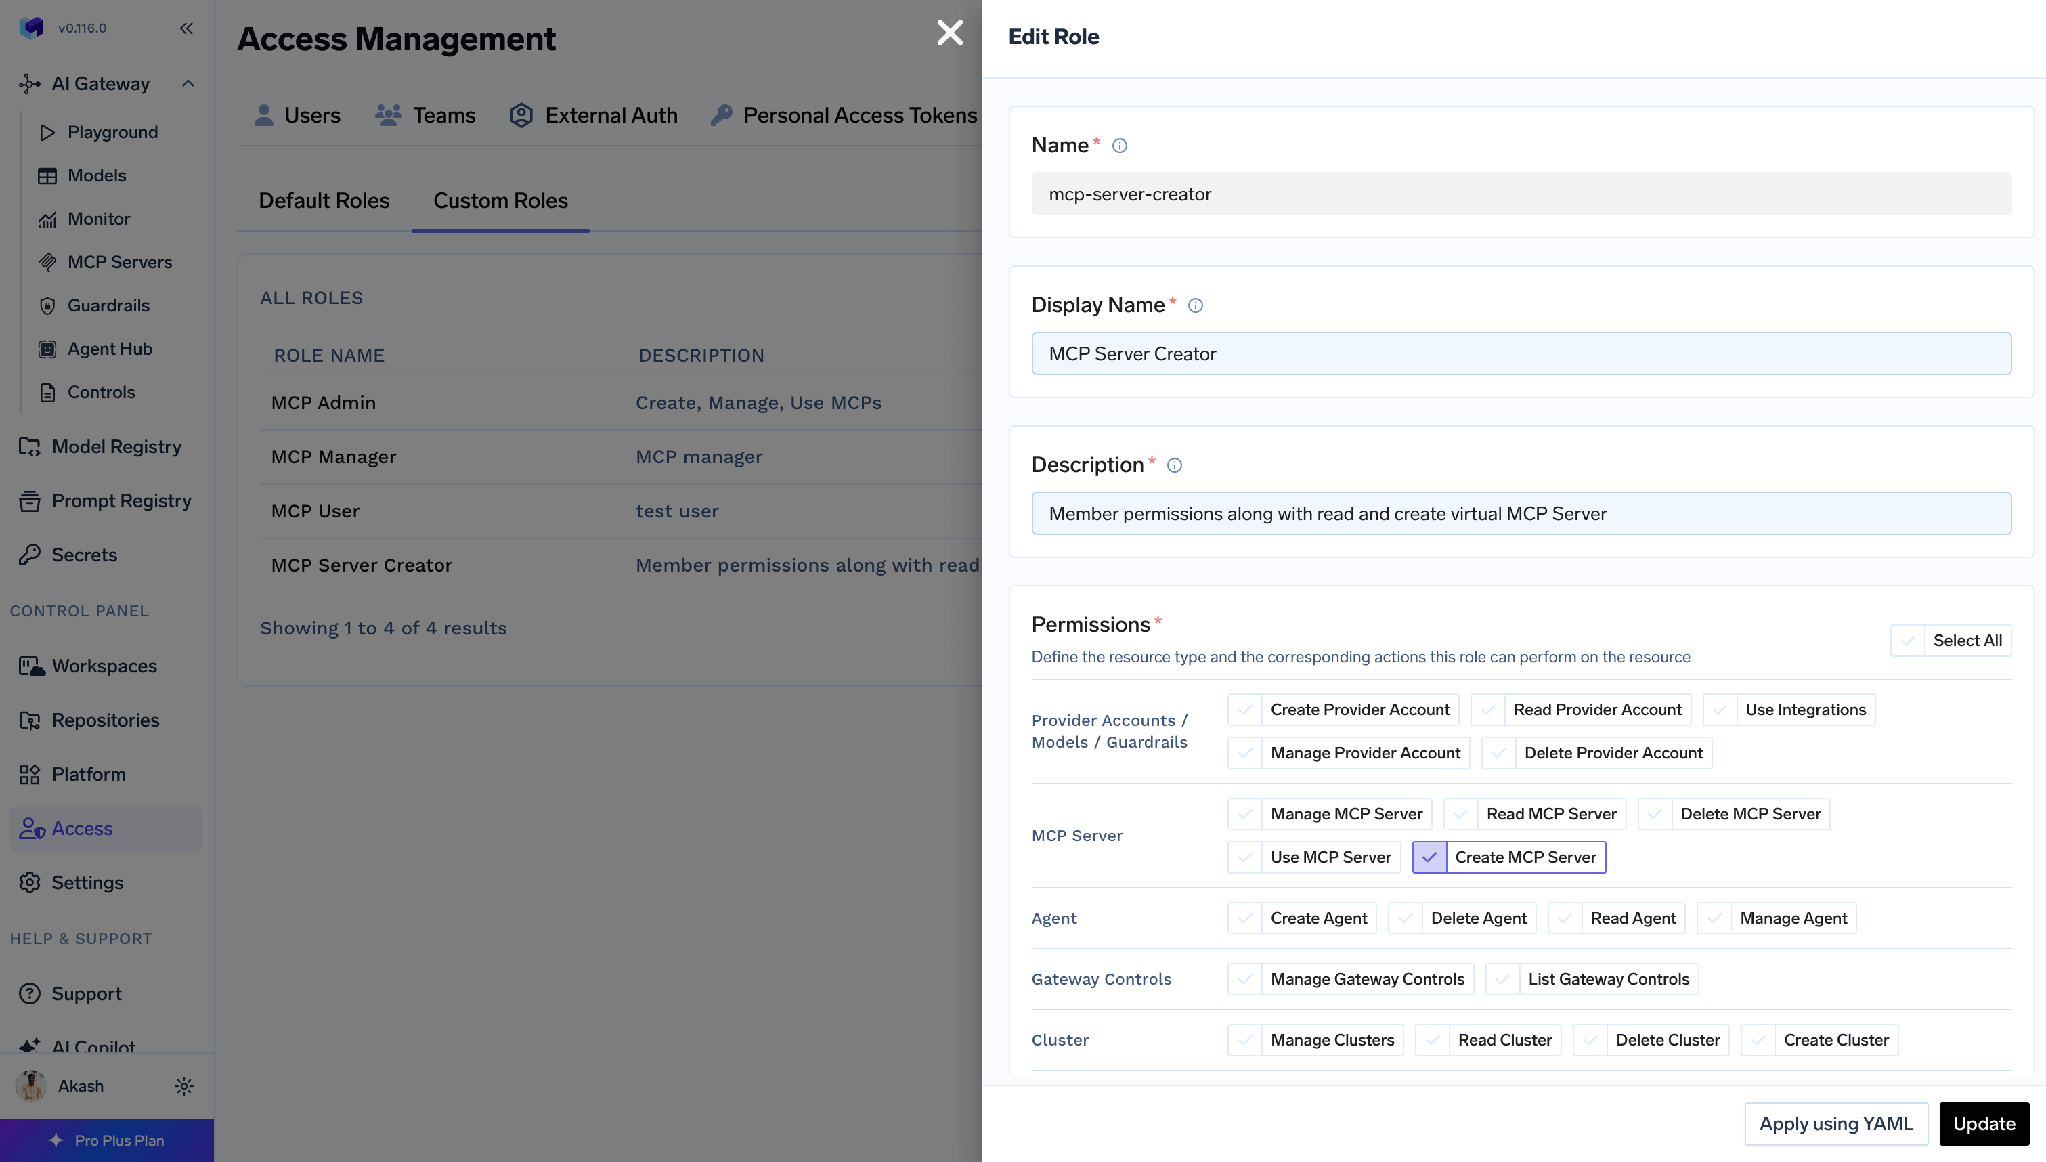
Wijs deze vervolgens toe via Access > Users of Access > Teams.
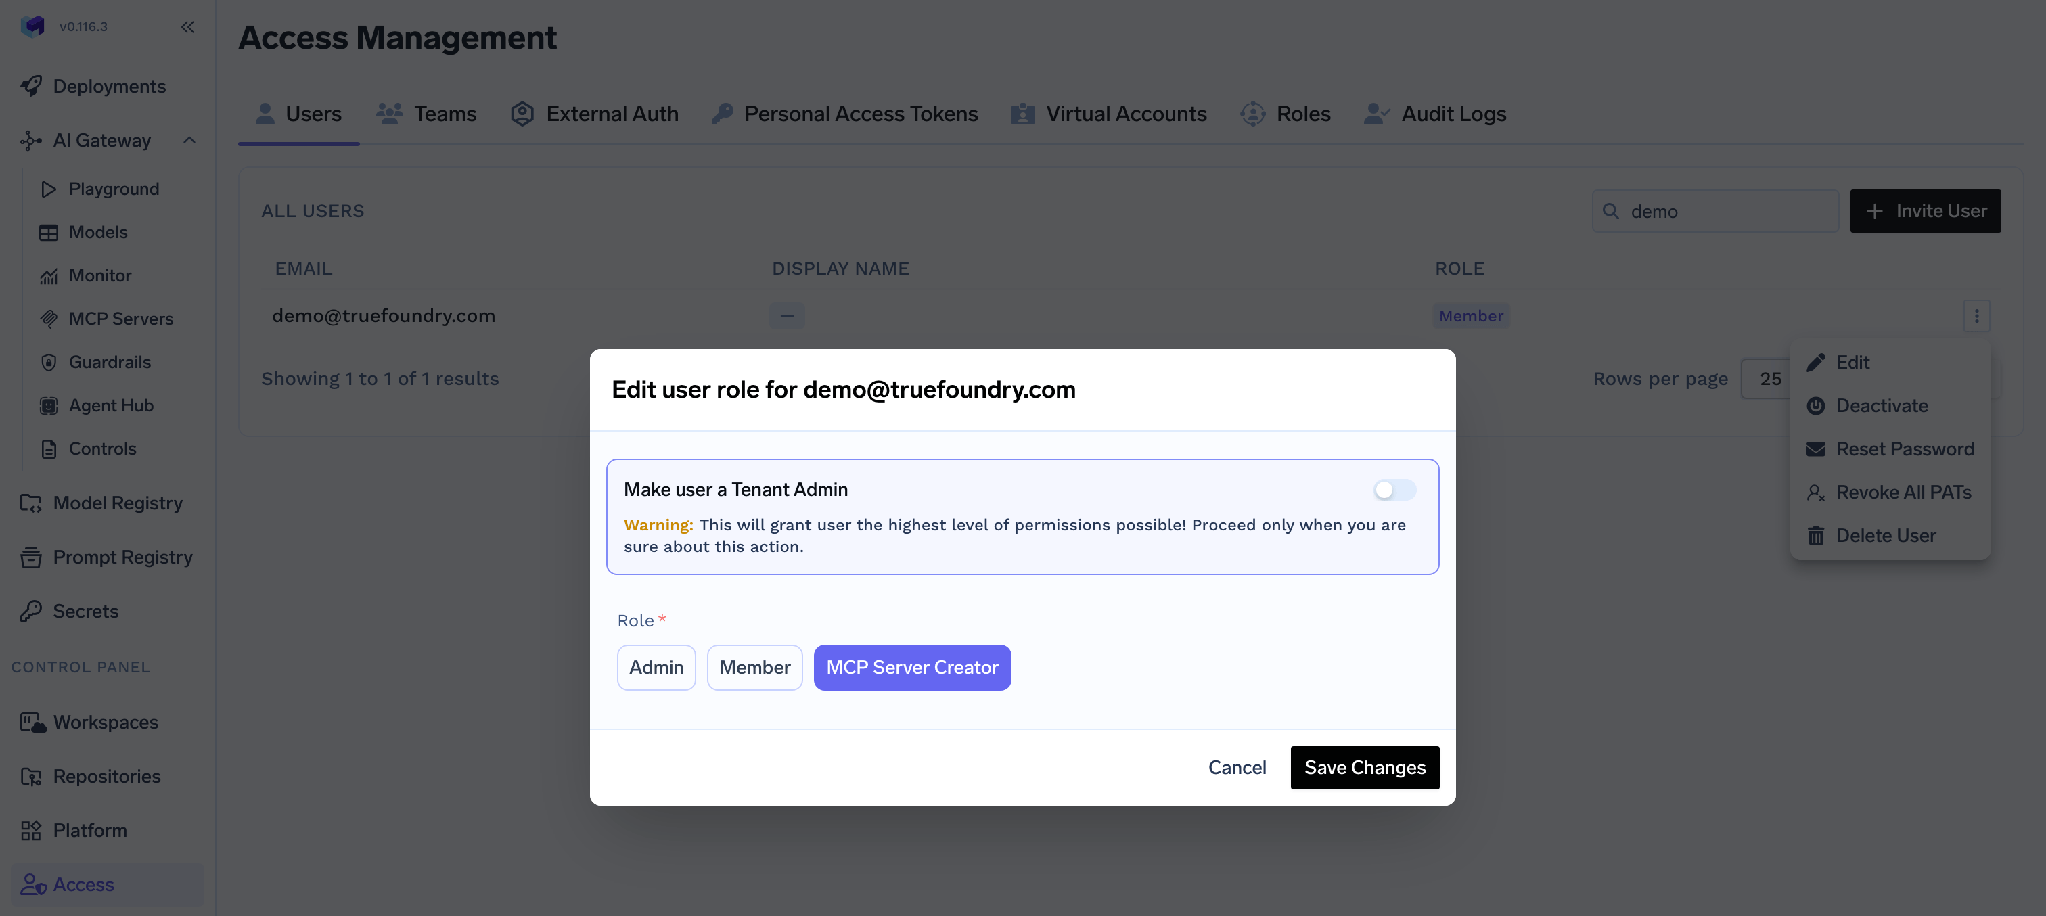
De werking is identiek aan die van Kubernetes. Create MCP Server staat het aanmaken van een nieuwe server toe en verleent geen rechten op bestaande servers – precies zoals create op een Kubernetes-resource geen rechten verleent op reeds bestaande objecten. De eigenaar verleent zichzelf vervolgens MCP Server Manager vanaf de Access Control-pagina van die specifieke server, waarna MCP access control bepaalt welke tools de agent mag aanroepen.
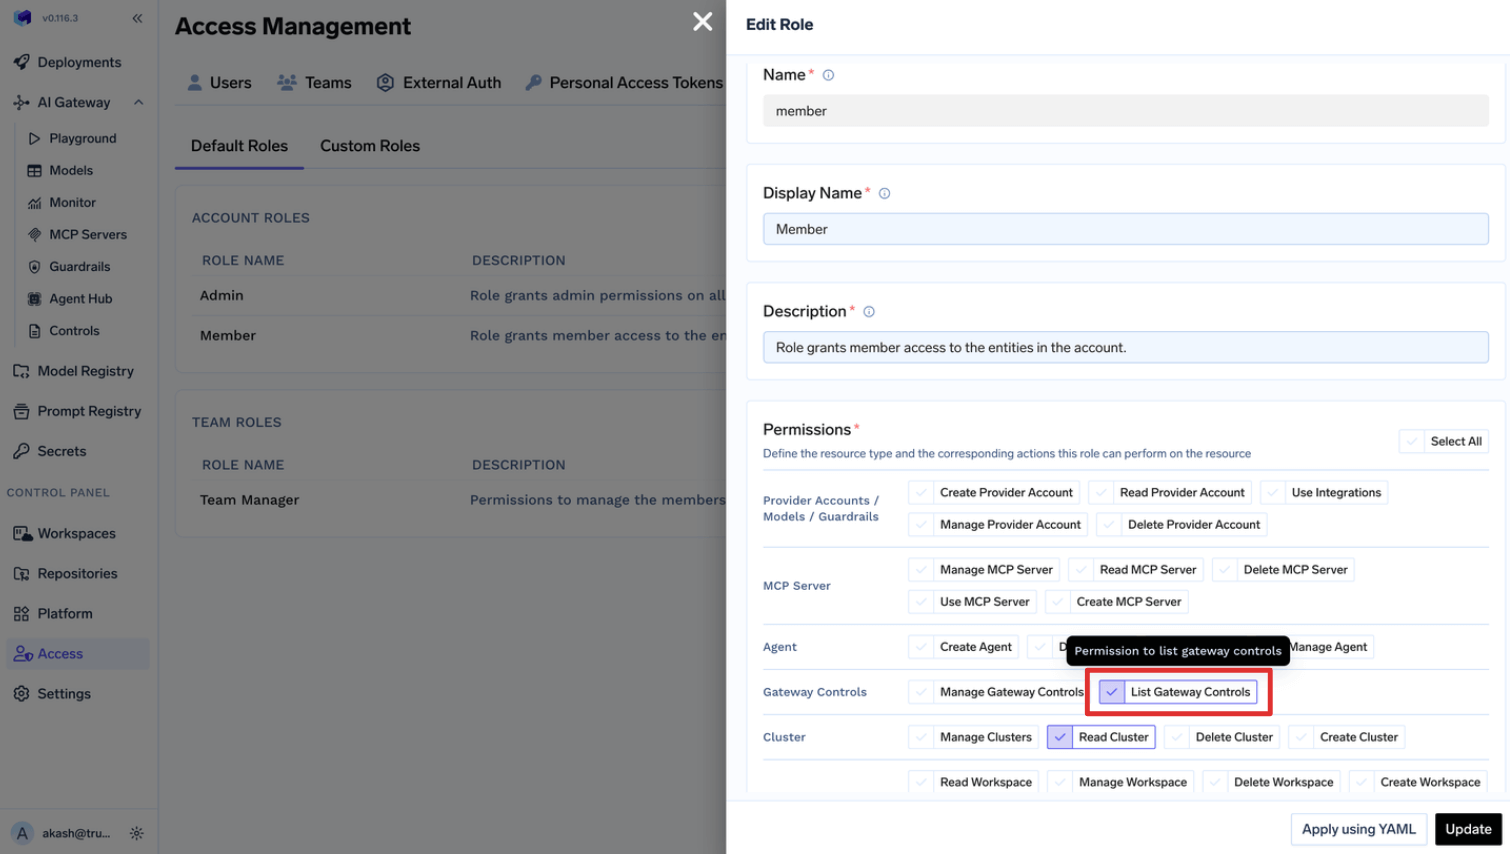
Nog een vergelijking: permissies van aangepaste rollen gelden voor alle resources van het geselecteerde type, net zoals een ClusterRoleBinding geldt voor alle namespaces. Gebruik voor één specifieke resource de Access Control-pagina van die resource. Hetzelfde geldt bij het uitbreiden van de basisrol – het toevoegen van gateway-controls:ListGatewayControls aan Member kent dit toe aan elke gebruiker:
De agent van het platform zelf is een praktijkvoorbeeld van Role vs ClusterRole. tfy-agent heeft een ClusterRole en ClusterRoleBinding nodig om informers uit te voeren, omdat Kubernetes-informers geen subset van namespaces kunnen monitoren – het werkt dus read-only en filtert aan de clientzijde. tfy-agent-proxy, die daadwerkelijk schrijfoperaties uitvoert, kan wel worden ingeperkt: config.allowedNamespaces schakelt dit om naar RoleBindings per namespace, en tfyAgentProxy.clusterRole.strictMode: true beperkt het tot een minimale set permissies. Dat is de algemene regel in het klein.
Toekenningen worden op beide lagen gecombineerd; het intrekken van de ene verwijdert de andere niet. In Kubernetes is de effectieve toegang de vereniging van elke overeenkomende binding. In TrueFoundry kan een subject rechtstreeks toegang hebben en deze overerven van een team. Controleer elke bron voordat u concludeert dat een intrekking is mislukt.
Het bewerken van een standaard platform-teamrol wijzigt deze voor elk team. Team Member en Team Manager worden bewerkt onder Access > Default Roles, en de wijziging is globaal. Het toevoegen van virtual-account:ManageVirtualAccount zodat één team tokens kan ophalen, verleent dit recht aan elk team. Kubernetes kent hetzelfde risico in een andere vorm: het bewerken van een gedeelde ClusterRole wijzigt deze voor elke binding die ernaar verwijst.
De meeste Kubernetes RBAC-problemen zijn scope-problemen, geen syntaxis-problemen. Twee typen objecten beschrijven permissies en twee typen delen ze uit; de kunst is om de specifieke variant te kiezen wanneer de brede eenvoudiger in te voeren is. Gebruik primair een Role met een namespace, een ClusterRole gekoppeld via een RoleBinding wanneer hergebruik nodig is, en een ClusterRoleBinding uitsluitend wanneer een subject daadwerkelijk toegang tot het gehele cluster vereist. Koppel groepen, vermijd wildcards en controleer met kubectl auth can-i.
Wat snel over het hoofd wordt gezien, is dat dit alles slechts één specifieke vraag beantwoordt. Alles wat uw teams doen via een platform-API – het deployen van een model, het aanroepen van een MCP-tool, het lezen van een secret-groep – is onzichtbaar voor cluster-RBAC en vereist een eigen autorisatiemodel.
Op TrueFoundry zijn dit twee lagen over dezelfde infrastructuur: ze delen een grens omdat een workspace een namespace is, maar worden onafhankelijk geconfigureerd omdat ze verschillende objecten beheren. Een platform engineer heeft beide nodig. De valkuil is veronderstellen dat een van beide de lading van de ander dekt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It is the authorization mode that decides whether an authenticated identity may perform a verb on a resource through the API server. You write permissions into a Role (namespaced) or ClusterRole (cluster-wide), then attach them to subjects with a RoleBinding (that namespace only) or a ClusterRoleBinding (cluster-wide). Rules are additive with no deny, and anything not granted is refused.
A Role is namespaced and can only grant on namespaced resources inside its own namespace. A ClusterRole is cluster-scoped and can additionally grant on cluster-scoped resources such as nodes and persistent volumes, and on non-resource URLs like /healthz. The practical difference is reuse: a ClusterRole is defined once and can be bound into any single namespace with a RoleBinding.
Yes, and it is the recommended pattern. Permissions stay limited to the RoleBinding’s namespace, so you define a capability once and grant it team by team. The reverse is not allowed: a ClusterRoleBinding can never reference a Role.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















