



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Naarmate multi-agent systemen complexer worden, is de uitdaging niet langer alleen om individuele agents betrouwbaar te laten werken. Het gaat om het ontwerpen van de wijze waarop ze verbinding maken, verantwoordelijkheden verdelen, taken delegeren en coördineren tijdens runtime. Dit is het idee achter graph engineering, een concept dat is verkend in een ExplainX.ai-artikel gepubliceerd op 18 juli 2026, waarin een multi-agent organisatie wordt geframed als een engineered graph in plaats van een verzameling losjes verbonden agents.
Graph engineering definieert de topologie van het systeem: welke nodes er bestaan (agents, deterministische functies, routers en menselijke checkpoints), waar elk verantwoordelijk voor is, welke overgangen zijn toegestaan en hoe het werk zich door het systeem beweegt. Loop engineering richt zich daarentegen op hoe elke agent zijn taken uitvoert. Hoewel de oorsprong van de term onzeker blijft en de naam overlapt met het gevestigde vakgebied van kennis-graphs (knowledge graphs), bouwt op graphs gebaseerde orchestratie voort op langbestaande concepten in de informatica en gedistribueerde systemen.
Voor ondernemingen heeft het onderscheid praktische gevolgen. De orchestrator definieert en beheert de workflow-graph, terwijl TrueFoundry het beheer (governance) verzorgt van model- en MCP-tool-operaties die via de gateways worden geleid, en een beheerde runtime biedt voor Agent Harness-agents. Het begrijpen van waar deze verantwoordelijkheden beginnen en eindigen is essentieel voor het ontwerpen van betrouwbare, bestuurbare multi-agent systemen.
Graph engineering is het ontwerp en de werking van een multi-agent systeem als een expliciete graph van heterogene nodes — agents, deterministische functies, routers, joins, tools, menselijke checkpoints — met communicatie en delegatie als edges, waarbij de topologie zelf — wie er bestaat, wat iedereen bezit, wie met wie mag spreken, hoe het werk wordt geleid — wordt behandeld als een programmeerbaar, versieerbaar artefact in plaats van een toevallig ontstaan verschijnsel.
Het eigendomsvoorbeeld uit het synthetiserende artikel maakt het concreet: een security-agent die verantwoordelijk is voor auth, machtigingen en auditlogs; een data-agent die verantwoordelijk is voor schema's en migraties; een API-agent die verantwoordelijk is voor endpoints en contracten; een frontend-agent die verantwoordelijk is voor componenten en status — elk een node met een mandaat, ingebed in een organisatie waarvan de structuur zelf het engineered object is (explainx.ai).
Één verduidelijking is direct van belang, zowel voor lezers als voor iedereen die via een zoekmachine binnenkomt: dit is geen knowledge-graph engineering — de gevestigde discipline van het bouwen van graph-gestructureerde data (entiteiten, relaties, triple stores) voor retrieval en redenering.
Knowledge graphs structureren wat een systeem weet; graph engineering in de zin van 2026 structureert wie het systeem is — de leden, mandaten en berichtpaden. De twee kunnen en zullen naast elkaar bestaan in één architectuur; ze beantwoorden verschillende vragen.
Nieuwe termen verdienen inzicht in hun oorsprong, en graph engineering heeft een bijzonder rijke historie die het waard is om te volgen. Die geschiedenis helpt verklaren hoe de praktijk zich kan ontwikkelen. Een van de diepste roots is het idee dat berekening een graph is. Vroege dataflow-architecturen verkenden dit concept in hardware, en het dook overal op waar werk moest worden opgedeeld en ingepland.
Compiler dependency graphs en de impliciete DAG van MapReduce volgden hetzelfde principe. Later maakten workflow-orchestrators zoals Airflow DAG's centraal in data engineering, terwijl deep-learning frameworks computation graphs centraal maakten in de uitvoering van modellen.
Een tweede, meer directe root ligt in decennia van onderzoek naar multi-agent systemen. Computation in Actor-stijl modelleerde onafhankelijke actors die berichten uitwisselden, terwijl contract-net protocollen agents in staat stelden te bieden op taken en deze te delegeren — waardoor een werk-graph ontstond lang voordat de term bestond. De distributed-AI community ontwikkelde ook vocabulaire voor agentcommunicatie en -organisatie die vandaag de dag leest als ontwerpdocumenten voor de systemen die engineers nu bouwen.
Een derde root komt voort uit organisatieontwerp. Organogrammen, RACI-matrices en bedrijfsprocesnotaties brengen allemaal eigenaarschap en de stroom van werk in kaart. Het concept van een "org graph" uit het artikel van 18 juli brengt deze traditie over naar software, al dan niet intentionally.
De moderne convergentie vond snel plaats. Agent-frameworks maakten van graphs first-class objects in code: LangGraph geeft dit al aan in de naam, terwijl AutoGen en CrewAI multi-agent gesprekken en teams structureerden. Het A2A-protocol van Google (2025) stelde een gestandaardiseerde aanpak voor agent-discovery, taakbeheer, berichtenverkeer, artefacten en coördinatie voor — een laag die we hebben onderzocht in onze gedetailleerde gids over multi-agent governance.
Tegen het midden van 2026 was de progressie onder professionals verschoven van prompt naar context naar loop engineering, waarbij de discussie in juni rond loop engineering een sjabloon bood waarop de juli-discussie rond graph engineering voortbouwde.
Onze synthese, met de voorzichtigheid die een opkomende term verdient, is dat graph engineering geen uitvinding is maar een naamgevingsevent: het punt waarop een praktijk die zich over decennia heeft ontwikkeld, herkenbaar en bespreekbaar werd als één enkele discipline. Naamgevingsevents zijn belangrijk omdat ze bepalen hoe mensen praten over tooling, werving en — in ons geval — operations.
Graph engineering is nuttig wanneer een AI-workflow parallelle uitvoering, voorwaardelijke routing, herhaalde validatie of coördinatie tussen gespecialiseerde agents vereist. Niet elke taak heeft echter een graph nodig. De juiste aanpak hangt af van de hoeveelheid controle en coördinatie die de workflow vereist.
Gebruik graph engineering wanneer:
U hebt mogelijk geen graph engineering nodig wanneer een enkele agent een taak kan voltooien via redenering, tool-calls en zelfcontroles, of wanneer elke stap een vaste volgorde volgt. Een basisassistent voor klantenservice of een pijplijn voor het samenvatten van documenten kan uitstekend werken met een single-agent loop of een lineaire workflow.
De afweging is complexiteit. Graphs bieden meer controle over de uitvoering, maar brengen extra overhead met zich mee voor orchestratie, statusbeheer en debugging. Begin met de eenvoudigste aanpak die aan uw eisen voldoet en voer graph engineering in wanneer vertakkingen, afhankelijkheden of coördinatie moeilijk te beheren worden.
Een single-agent loop vertrouwt op één agent om een taak te doordenken, tools aan te roepen, resultaten te evalueren en te beslissen wat er nu moet gebeuren. De agent bewaakt zijn acties binnen de loop, wat deze aanpak eenvoudiger maakt om te implementeren en te debuggen wanneer de taak één duidelijk doel heeft. Graph engineering definieert de relaties tussen taken en de regels voor de overgang daartussen. Het is nuttig wanneer gespecialiseerde agents duidelijke verantwoordelijkheden, expliciete overdrachten of parallelle uitvoering nodig hebben.
Zo kan een coding-agent een kleine bugfix zelfstandig afhandelen, terwijl voor een complexe software-release mogelijk afzonderlijke security-, API- en testing-agents nodig zijn die via een graph worden gecoördineerd.
Het belangrijkste verschil is waar de uitvoeringslogica zich bevindt: bij een single-agent loop kan de agent zijn volgende actie bepalen, terwijl een graph belangrijke overgangen en afhankelijkheden expliciet maakt. Graphs kunnen ook agent loops bevatten, dus de twee benaderingen sluiten elkaar niet uit.
Een lineaire workflow voert stappen uit in een vooraf bepaalde volgorde, waarbij elke fase begint nadat de vorige is voltooid. Dit maakt het geschikt voor voorspelbare taken zoals het extraheren van documenttekst, het classificeren ervan en het genereren van een samenvatting. De structuur is eenvoudig te volgen, maar het toevoegen van voorwaardelijke paden of parallelle taken kan extra vertakkingslogica vereisen.
Graph engineering representeert taken als verbonden nodes, waardoor de uitvoering kan vertakken, onafhankelijke stappen gelijktijdig kan uitvoeren, kan teruglopen na storingen of kan wachten op goedkeuring. Een release-workflow kan bijvoorbeeld beveiligings- en testcontroles parallel uitvoeren, mislukte controles doorsturen voor herstel en implementatie pas toestaan nadat de vereiste validaties zijn geslaagd.
Het belangrijkste verschil is vaste opeenvolging tegenover flexibele uitvoeringspaden. Gebruik een lineaire workflow wanneer de stappen en de volgorde ervan vooraf bekend zijn. Kies een graph wanneer de workflow voorwaardelijke routing, parallelle uitvoering, retries of afhankelijkheden nodig heeft die niet netjes door een vaste volgorde kunnen worden afgehandeld.
De meeste multi-agent systemen gebruiken een combinatie van graph-patronen. De juiste structuur hangt af van hoe voorspelbaar de taak is, of stappen onafhankelijk kunnen draaien en waar de workflow moet pauzeren of herstellen.
Een sequentiële workflow verplaatst werk door een gedefinieerde reeks nodes, waarbij elke stap afhankelijk is van de vorige. Een voorwaardelijke workflow voegt vertakkingen toe: de volgende node hangt af van een resultaat, regel of beslissing. Een code review graph kan bijvoorbeeld een succesvolle build doorsturen naar beveiligingscontrole, maar een mislukte build eerst naar debugging leiden.
Fan-out stelt een graph in staat om werk naar meerdere nodes tegelijk te sturen. Een software-release-workflow zou beveiligingsanalyse, testgeneratie en afhankelijkheidscontroles parallel kunnen uitvoeren en de resultaten vervolgens samenbrengen bij een review-node. Parallelle uitvoering kan de latentie verminderen, maar de graph moet definiëren hoe resultaten worden verzameld en wat er gebeurt als één tak mislukt of te lang duurt.
Niet elke workflow volgt een recht pad. Cycli zorgen ervoor dat een taak kan terugkeren naar een eerdere node wanneer de uitvoer de validatie niet doorstaat. Een coding-agent kan bijvoorbeeld een patch genereren, deze naar een test-runner sturen en terugkeren naar de coding-node als de testen mislukken. De graph moet retry-limieten, foutroutes en uitstapvoorwaarden definiëren om oneindige loops of dubbel werk te voorkomen.
Sommige beslissingen mogen niet worden overgelaten aan geautomatiseerde agents. Een graph kan werk omleiden naar een menselijk checkpoint voorafgaand aan een gevoelige actie, zoals het implementeren van code, het goedkeuren van een betaling of het wijzigen van de productie-infrastructuur. De workflow moet specificeren wat goedkeuring vereist, welke context de beoordelaar ontvangt en of een afwijzing de taak terugstuur voor revisie dan wel de uitvoering stopt.
De progressietabel in het synthetiserende artikel is de meest heldere manier om de term te plaatsen, en het levert met één toevoeging veel inzicht op.
Prompt engineering beheert één modelrespons; het basiselement is instructietekst; het is voldoende voor statische, eenmalige taken. Context engineering beheert wat het model ziet; de basiselementen zijn retrieval, geheugen en window-budgetten.
Loop engineering beheert de gedragscyclus van één agent — de observe-reason-act-verify-loop, de stopcondities, de tool-discipline — en dat is waar onze eigen tweedelige behandeling zich bevindt: Deel Één betoogde dat een loop die op een laptop werkt en een loop die in een onderneming draait, niet verschillen in de loop zelf, maar in wat eromheen staat (identiteit, budgetten, guardrails, traces), en Deel Twee betoogde dat veel beheerde loops samen een vloot vormen — een operationeel probleem met eigen disciplines, niet slechts een grotere loop.
Graph engineering beheert de topologie over heterogene nodes — agentic loops, deterministische operaties, routers, joins, tools en menselijke checkpoints — en definieert welke nodes bestaan, wat elke node bezit, welke overgangen zijn toegestaan en hoe het werk daartussen stroomt. De toevoeging die expliciet moet worden gemaakt: deze lagen vullen elkaar aan in plaats van elkaar te vervangen.
Een graph waarvan de nodes on-ge-engineerde loops hebben, is een organogram van onbetrouwbare werknemers; een graph waarvan de loops uitstekend zijn maar waarvan de topologie toevallig is, is de waarschuwing uit onze vloot-post die werkelijkheid wordt — coördinatiefouten op schaal. Iedereen die zoekt of graph engineering de plaats inneemt van loop engineering, moet vertrekken met het antwoord: nee; het benoemt de laag erboven en erft de vereisten daarvan met een vermenigvuldigingsfactor die wordt bepaald door topologie en runtime-gedrag — fan-out, retries, concurrency, toolgebruik, contextgrootte en caching — niet door het aantal nodes alleen.
Het bouwen van een multi-agent graph begint met het definieren van wat elke component doet en hoe het werk zich daartussen beweegt. U hebt ook heldere regels nodig voor gedeelde status, foutafhandeling en het traceren van de uitvoering. Deze beslissingen helpen de workflow voorspelbaar te houden naarmate u meer agents en complexere taken toevoegt.
Begin met het identificeren van het werk dat uw systeem moet uitvoeren. Elke node moet een duidelijke verantwoordelijkheid hebben, zoals het plannen van een taak, het beoordelen van code, het uitvoeren van testen, het aanroepen van een tool of het vragen om menselijke goedkeuring. Een node kan een AI-agent zijn, een deterministische functie, een router of een menselijk checkpoint. Houd de verantwoordelijkheden klein genoeg zodat u elke node kunt testen en de uitvoer ervan kunt begrijpen.
Edges definieren hoe werk tussen nodes beweegt. Sommige overgangen zijn onvoorwaardelijk, terwijl andere afhangen van een resultaat of regel. Een code-review-node kan goedgekeurde code bijvoorbeeld doorsturen naar testen en afgekeurde code terugsturen naar de coding-agent. Definieer deze voorwaarden expliciet, inclusief wat er gebeurt als een node een onverwacht resultaat retourneert. Dit maakt routing eenvoudiger te testen en vermindert onduidelijkheid tijdens de uitvoering.
Agents hebben vaak context nodig die is geproduceerd door eerdere stappen, maar als u elke node toegang geeft tot alle beschikbare data, kan dit onnodige koppeling en beveiligingsrisico's veroorzaken. Definieer welke status elke node kan lezen of bijwerken, hoe de uitvoer tussen nodes wordt doorgegeven en hoe conflicterende updates worden afgehandeld.
Houd informatie op run-niveau, zoals taakstatus en identificaties, gescheiden van de werkcontext van individuele agents. Dit maakt de graph eenvoudiger te debuggen en helpt te voorkomen dat de ene node onbedoeld de invoer van een andere wijzigt.
Ontwerp foutafhandeling voordat u de graph in productie neemt. Stel retry-limieten, timeouts, validatieregels en fallback-paden in voor nodes die mislukken of onbruikbare resultaten retourneren. Niet elke fout moet een retry activeren; sommige storingen moeten de workflow stopzetten of naar een menselijke beoordelaar gaan.
U moet ook elke run over de nodes heen traceren. Leg node-invoer en -uitvoer vast waar toepasselijk, evenals uitvoeringsstatus, latentie, model- en tool-calls en fouten. Gebruik consistente graph-, run- en node-identificaties zodat u orchestratie-traces kunt correleren met model- en tool-activiteiten die door uw gateways zijn geregistreerd. Dit helpt u knelpunten te lokaliseren, storingen te onderzoeken en de kosten van individuele onderdelen van een workflow te begrijpen.
Sommige enterprise-vereisten blijven relevant, ongeacht hoe de definitie van graph engineering zich ontwikkelt. Multi-agent graphs in productie combineren agentische en deterministische componenten. Agentische callers kunnen identiteiten bezitten, modellen en tools aanroepen en dynamisch werk creëren. De resulterende operationele belasting hangt af van topologie, fan-out, retries, concurrency en runtime-mutatie.
Governance: Elke onafhankelijk beheerde caller of service-agent heeft een opgeloste identiteit nodig. Deterministische nodes in-process kunnen werken onder de identiteit van hun bevattende service, tenzij de architectuur een afzonderlijk beleid of attributie vereist. Dit bouwt voort op de virtuele accounts, RBAC en delegatie per gebruiker die worden behandeld in onze inventarisatie van agent-identiteit. Immers: "de graph heeft het gedaan" is geen geldig antwoord bij een audit.
Door de gateway bemiddelde modelverzoeken en MCP tool-invocaties die door de graph worden gegenereerd, hebben ook beleidscontroles nodig. Welke nodes toegang hebben tot welke tools is een kwestie van registerconfiguratie, inclusief beperkingen op toolniveau en virtuele MCP-servers die elke node afbakenen tot zijn mandaat.
De vier gedocumenteerde guardrail-hooks kunnen ook worden toegepast op door de gateway bemiddelde modelverzoeken en MCP-tool-invocaties die door de graph worden gegenereerd: llm_input, llm_output en het paar voor en na de tool-invoke. Output-guardrails vereisen niet-gestreamde reacties en systeemprompts zijn standaard uitgesloten. Deze hooks kunnen helpen om geconfigureerde klassen van risicovolle inhoud te detecteren, te blokkeren of te redigeren voordat ze zich verspreiden tussen deelnemende nodes. Ze nemen het risico op prompt-injection tussen agents niet volledig weg. Zie de guardrails-documentatie en MCP Gateway-documentatie.
Kostenbeheersing: Een werk-graph kan het aantal model- en tool-calls verhogen door fan-out, retries en dynamisch gegenereerde subtaken, dus kostenbeheersing moet expliciet zijn. Budgetregels worden gemaakt op tenant- of teamniveau en kunnen afzonderlijke limieten toewijzen per virtueel account of metadatawaarde. Rate-limit-regels kunnen verzoeken vergelijken of verdelen op basis van ondersteunde metadatadimensies.
Het doorgeven van graph_id of node_id creëert deze koppeling; de gateway leidt het graph-lidmaatschap niet automatisch af. Bijvoorbeeld:
Illustratief correlatiepatroon: een uniek token voor een virtueel account plus doorgegeven graph-, run- en node-identificaties.
Zie de budget-documentatie en rate-limit-documentatie.
Observability: Observability helpt bij het onderscheiden van beoogde rollen van het werk dat daadwerkelijk is uitgevoerd. Voor verzoeken die door de gateway worden bemiddeld en stabiele graph-, run- en node-identificaties dragen, kunnen gateway-metriek en verzoekrecords analyses ondersteunen van kosten, latentie, modellen en tools die aan een node zijn gekoppeld. Records op verzoekniveau bieden ook caller-identiteit en beleidsresultaten.
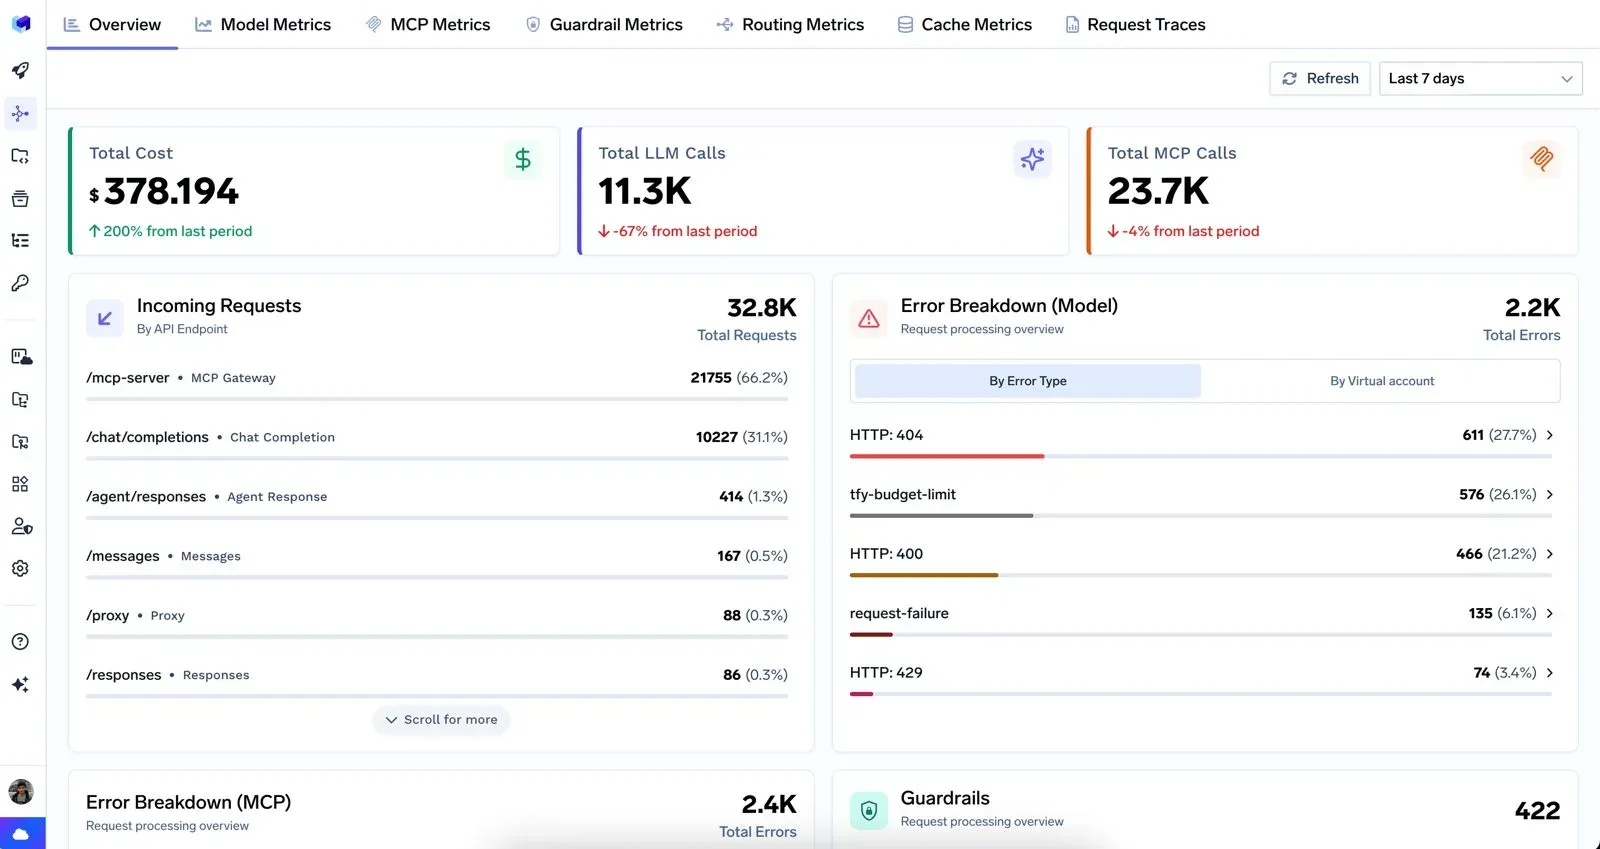
Wanneer de orchestrator stabiele graph_id, run_id en node_id identificaties verzendt, kunnen deze records worden gerelateerd aan de uitvoerings-trace ervan. De orchestrator blijft de bron van waarheid voor de topologie; de gateway levert bewijs voor model, tool, beleid, latentie en kosten voor de operaties die hij waarneemt. Zie de Metrics Dashboard-documentatie.
De beheerde agent-runtime: Agentische nodes voeren loops uit; andere nodetypes — deterministische functies, routers, joins en menselijke checkpoints — doen dat niet. De TrueFoundry Agent Harness is de gedocumenteerde plaats om een beheerde loop uit te voeren, met orchestratie, geheugen, toegang tot MCP-tools, traces op stapniveau met kosten per stap en menselijke goedkeurings-gates voor geconfigureerde gevoelige acties.
Binnen een graph worden deze goedkeurings-gates iets specifieker: structurele checkpoints — menselijke goedkeuringspunten geplaatst voor geconfigureerde gevoelige tool-calls, op de punten waar de consequenties zich concentreren.
Optimalisatie: Aan nodes gekoppelde attributie, beschikbaar voor door de gateway bemiddelde verzoeken die stabiele identificaties dragen, verandert de graph in een afstembaar systeem. Een dwaze of dure node kan een goedkoper model gebruiken via routing; een herhaalde subtaak kan profiteren van semantische caching; en een onbetrouwbaar modeldoel kan gebruikmaken van een gateway-fallback-keten. Retry- en herstelgedrag voor orchestratie-edges blijft de verantwoordelijkheid van de graph-runtime. Dit zijn dezelfde optimalisatie-instrumenten die in onze gateway-posts zijn behandeld, nu met een specifieke topologie om op te richten.
Voor het team dat dit kwartaal de opdracht krijgt om een multi-agent graph naar productie te brengen, laten de vereisten zich samenvatten in zeven vragen, die elk betrekking hebben op zowel de orchestratielaag als het beheerde uitvoeringsvlak:
Elk onbeantwoord punt is een aannemelijke locatie voor een incident.
Het volgende zijn voorspellingen, geen zekerheden. De terminologie zal waarschijnlijk evolueren: “org graph” en “work graph” blijven mogelijk niet hangen, en binnen enkele weken kunnen er concurrerende definities ontstaan, net zoals gebeurde bij loop engineering.
Frameworks zullen ook meedingen om hun eigen interpretatie van graph engineering te vestigen. De meer interessante engineering-uitdagingen zullen waarschijnlijk ontstaan waar de kernideeën uit het artikel van 18 juli samenkomen: runtime-wijzigingen in de werk-graph die binnen stabiel organisatiebeleid werken. Belangrijke vragen zijn onder meer wie een nieuwe node kan maken, welke machtigingen en context die node erft, en hoe neveneffecten worden afgehandeld wanneer een taak wordt geannuleerd.
Standaarden zoals A2A en de opvolgers daarvan zullen de communicatie tussen agents blijven vormgeven. Naarmate multi-agent systemen zich verplaatsen van geïsoleerde experimenten naar gedeelde productie-omgevingen, zullen enterprise-vereisten concreter worden. De vragen in de checklist van deze gids zullen dan de architectonische discussie ontstijgen en inkooppunten worden.
Één principe zal echter waarschijnlijk standhouden, ongeacht welke termen overleven: paradigma's worden misschien geboren op X en in frameworks, maar ze worden volwassen in productie. Het betrouwbaar op schaal laten werken van multi-agent systemen vereist nog steeds duidelijk eigenaarschap, beheerde uitvoering, observability, kostenbeheersing en goed gedefinieerde operationele grenzen.
Graph engineering is nog steeds een opkomende discipline, en zelfs de oorsprong van de term staat nog niet vast. De aanpak van TrueFoundry richt zich op de enterprise-vereisten die constant blijven naarmate orchestration-frameworks evolueren: het beheren van model- en MCP-tooltoegang, het beheren van agent-executie en het behouden van zichtbaarheid in runtime-gedrag.
In een multi-agent graph roepen sommige nodes modellen of MCP-tools aan, terwijl andere deterministische operaties uitvoeren of menselijke beslissingen omvatten. De gateways van TrueFoundry beheren de modelverzoeken en MCP-toolaanroepen die erdoorheen worden geleid, wat zorgt voor beleidshandhaving, toegangscontroles en operationele zichtbaarheid. Deze gegevens kunnen worden gecorreleerd met de eigen executie-data van de orchestrator om enterprises te helpen begrijpen wat er binnen een workflow is gebeurd. De orchestrator blijft verantwoordelijk voor het definiëren en beheren van de graph zelf.
Voor agentic nodes biedt TrueFoundry Agent Harness een beheerde runtime waarin agents plannen, handelen en observeren, met ondersteuning voor goedkeuringen, sandboxing en traces op stapniveau. Onze gids voor loop engineering en gids voor fleet-scale onderzoeken hoe u individuele agent loops beheert en ze als een vloot laat werken.
Samen richten deze functionaliteiten zich op twee verschillende lagen van enterprise multi-agent systemen: de runtime waarin individuele agents worden uitgevoerd en de gateway-laag die hun model- en tool-interacties beheert. Graph engineering verbindt deze lagen via een orchestratiestructuur die door de enterprise is gedefinieerd.
Boek een demo om te zien hoe TrueFoundry werkt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



No. Knowledge graph engineering structures data — entities and relationships for retrieval and reasoning. Graph engineering in the 2026 multi-agent sense structures the system: heterogeneous nodes, permitted transitions, responsibilities, and the runtime work graph. One architecture can use both.
Production graph engineering spans the orchestrator, application instrumentation, and governed execution plane. The orchestrator records topology and runtime graph state; participating callers propagate graph, run, and node identifiers; and TrueFoundry can apply identity, access policy, budgets, rate limits, guardrails, approvals, records, and metrics to gateway-mediated model and MCP operations.



Het laatste nieuws, artikelen en bronnen in je inbox



















