



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Wanneer een LLM-call traag, duur of onjuist is, moet je kunnen zien wat er daadwerkelijk is gebeurd. Heeft een guardrail de prompt geanonimiseerd? Hoe lang deed het model erover vergeleken met het netwerk? Wat heeft de gateway naar de provider gestuurd? Request logging en tracing op de AI Gateway beantwoorden deze vragen voor elke call.
Omdat elke request toch al door de gateway stroomt, krijg je deze zichtbaarheid zonder elke applicatie handmatig te hoeven instrumenteren.
Met de request logging documentatie kun je beheren welke requests worden gelogd. De eenvoudigste bediening is per request, met behulp van de X-TFY-LOGGING-CONFIG header met een stringified JSON-waarde. Stel enabled in op true om de request te loggen of op false om deze over te slaan.
Een belangrijk aandachtspunt: de waarde van die header is stringified JSON en geen ruw JSON-object, omdat de meeste SDK's headers als strings serialiseren. De oudere globale loggingmodi worden vervangen door regelgebaseerde loggingconfiguratie, waarmee je logging kunt beheren per subject, model of metadata en gevoelige waarden kunt anonimiseren.
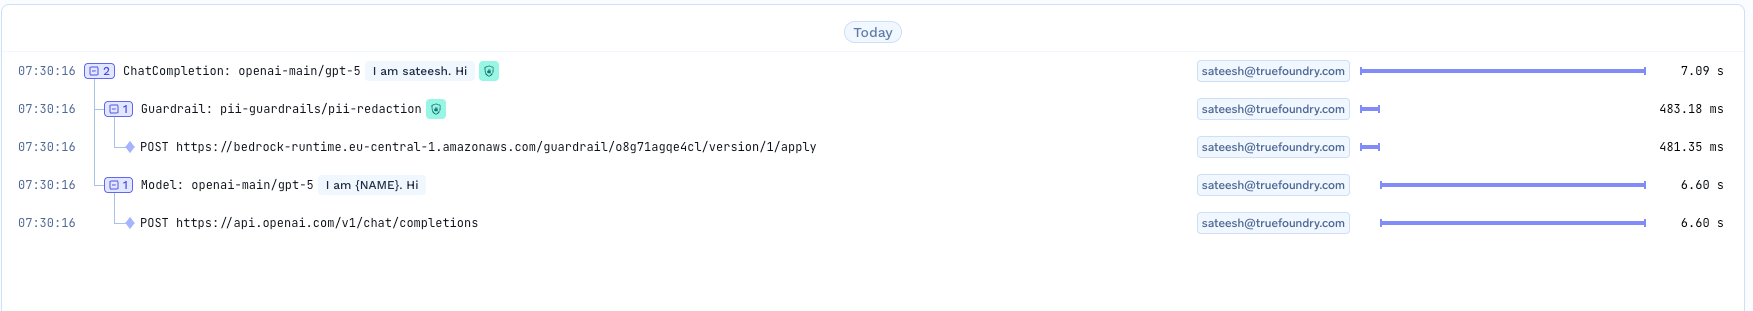
Om gelogde requests in de UI te bekijken, ga je naar AI Gateway, vervolgens naar Monitor en dan naar Requests. Dit geeft je de lijst van alle gelogde calls, die je kunt openen om een enkele request in detail te inspecteren.
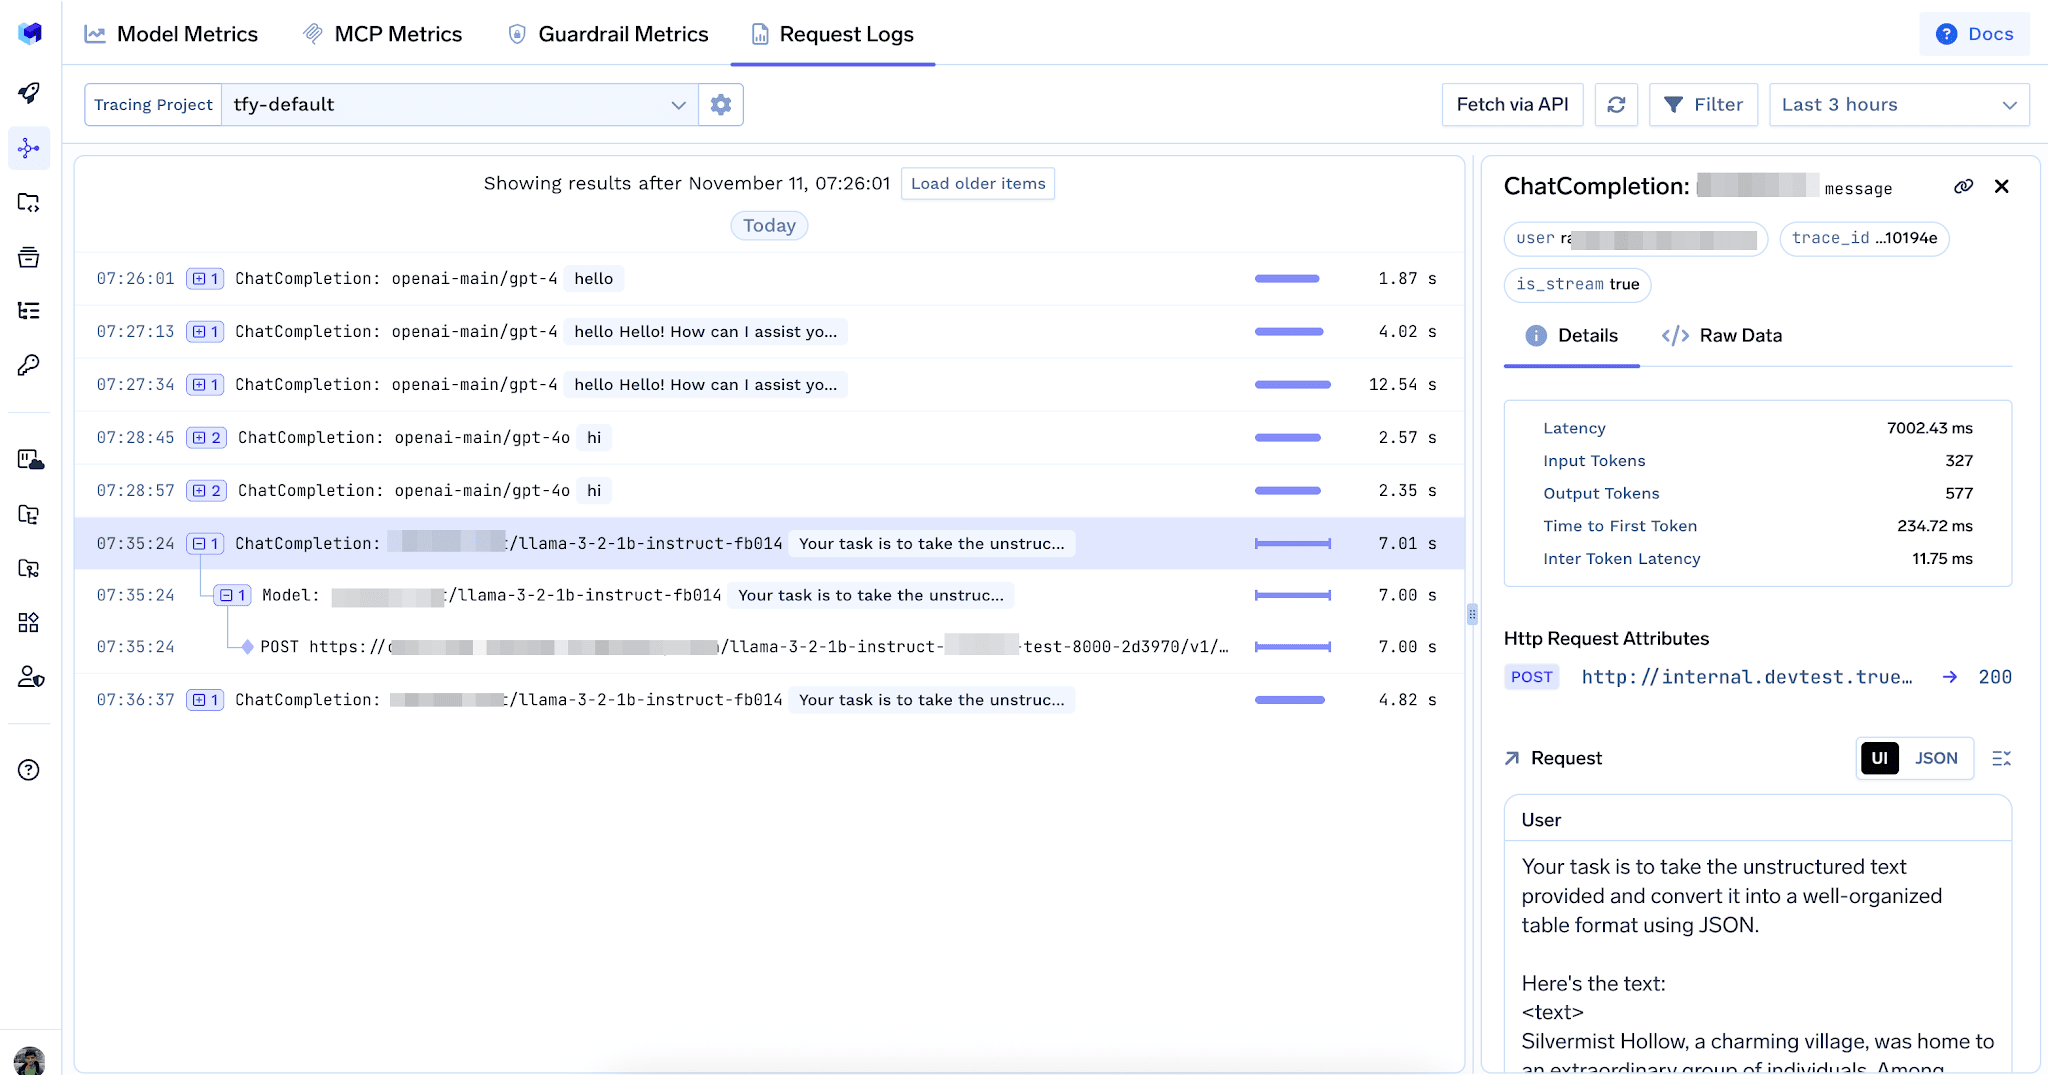
De tracing documentatie beschrijft een trace als de volledige levenscyclus van een request terwijl deze door de services stroomt die interactie hebben met de LLM. Meestal komt een trace overeen met een enkele API-call van een applicatie.
Een span is een individuele werk-eenheid binnen die trace, zoals een functie-call, een HTTP-request of een model-inference. Een trace is een boomstructuur van spans met parent- en child-relaties, waarbij een child-span meestal wordt veroorzaakt door zijn parent. TrueFoundry biedt een OpenTelemetry collector backend die deze traces opslaat en een UI om ze te bevragen en te analyseren, en het kan traces ontvangen van elke OpenTelemetry-compatibele SDK.
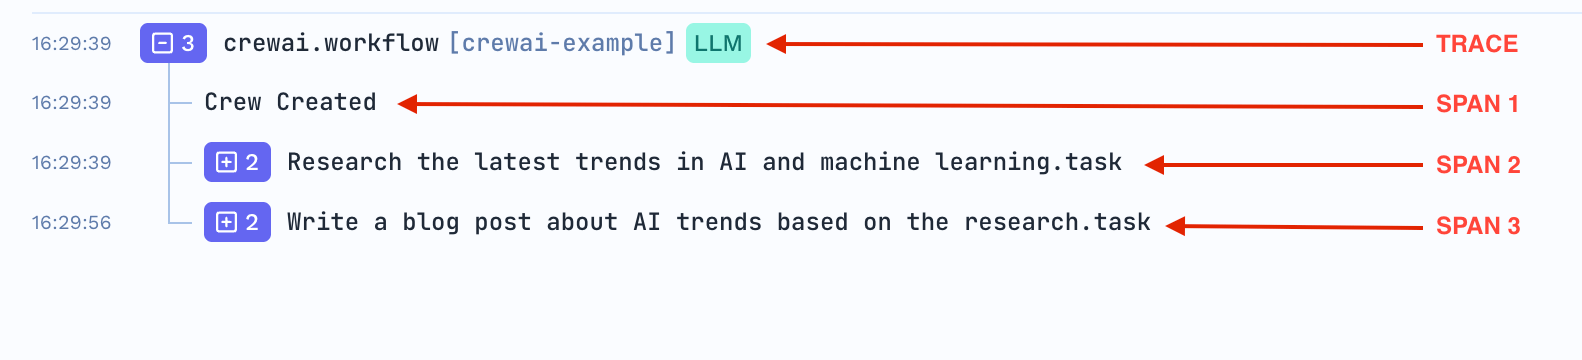
De trace-inspectie documentatie doorloopt een echt voorbeeld: een chat completion met een PII-redactie guardrail, vastgelegd als vijf spans die een hiërarchie vormen.
In datzelfde voorbeeld is de input zichtbaar geanonimiseerd van een naam naar een placeholder, wat aantoont dat de PII-guardrail end-to-end werkt binnen de trace.
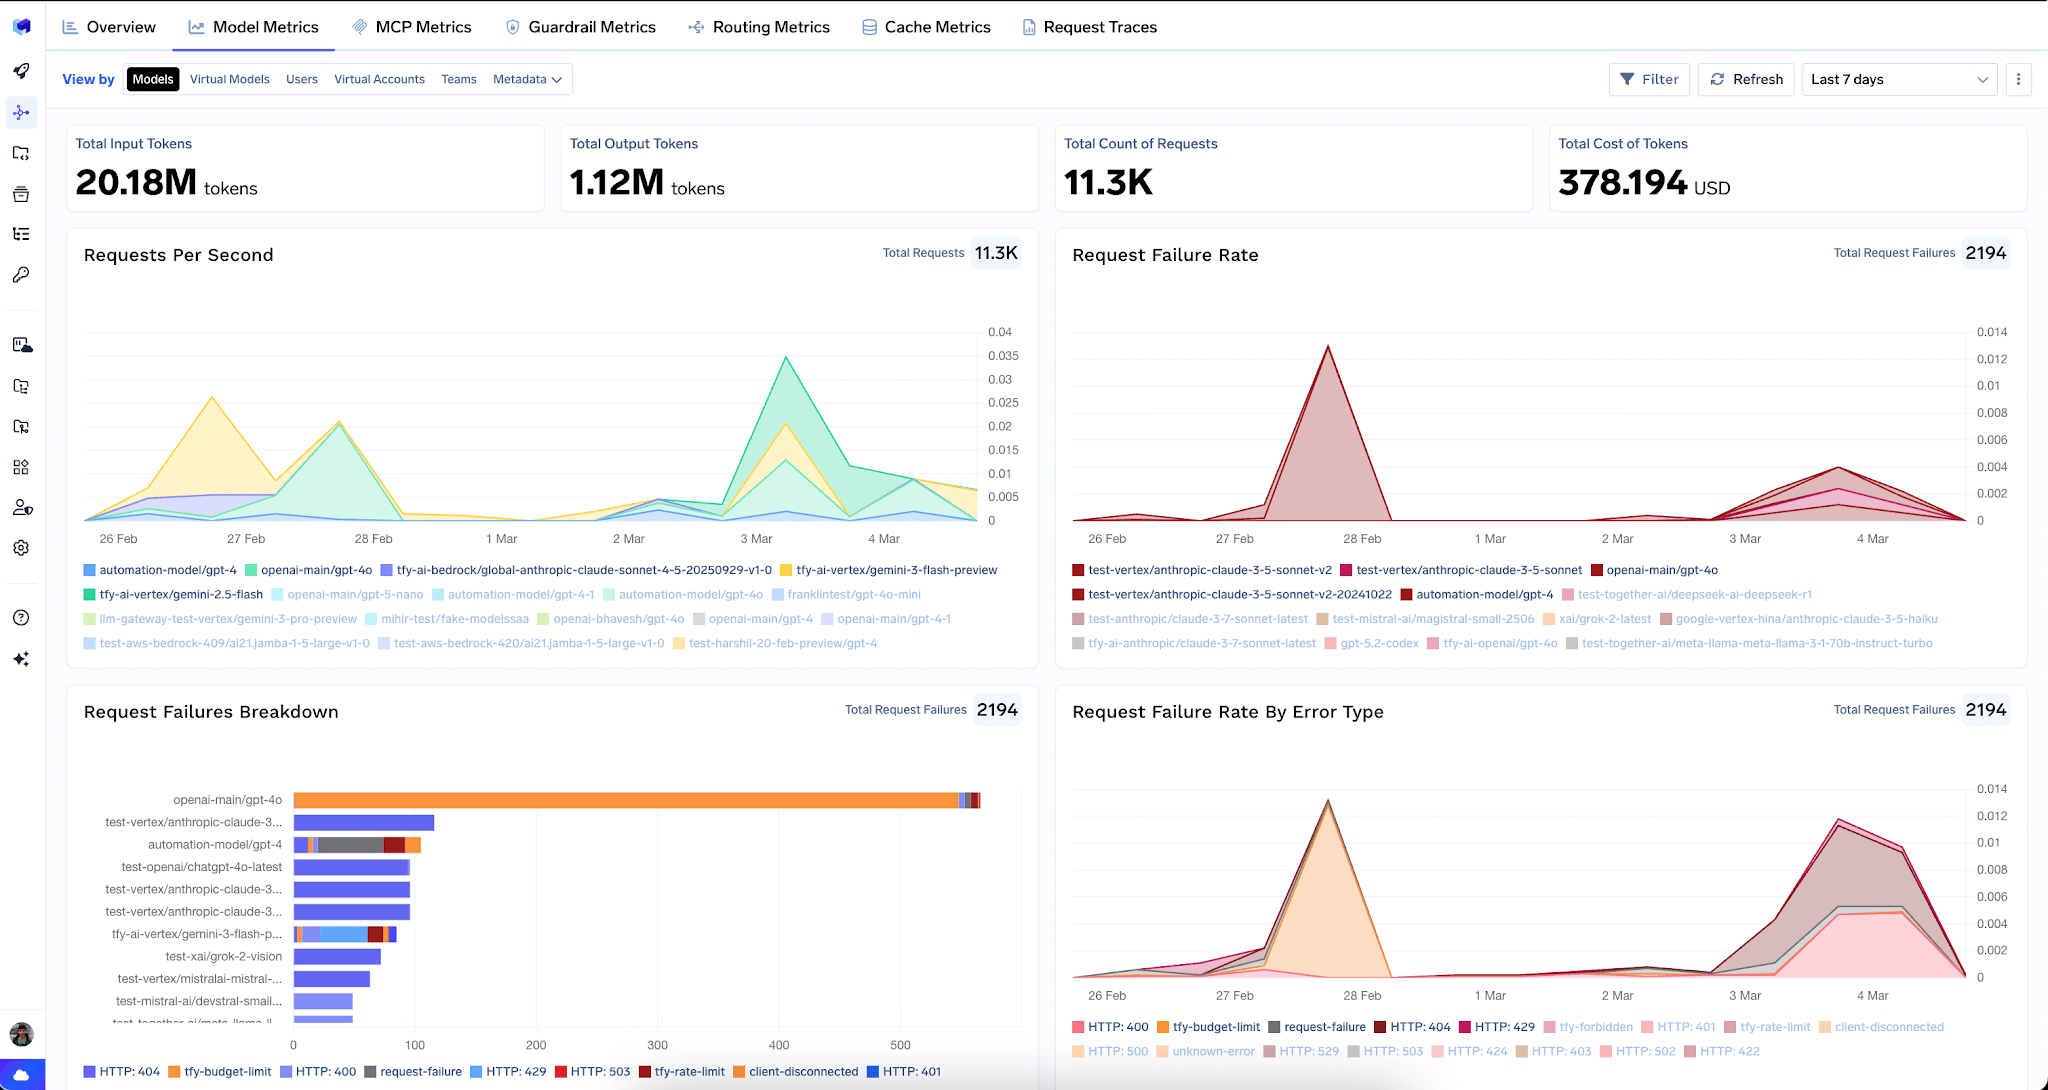
Individuele traces zijn bedoeld voor debugging. Voor trends voegt het analytics dashboard dezelfde gegevens samen. Tabbladen omvatten Overview, Model Metrics, MCP Metrics, Guardrail Metrics, Routing Metrics en Cache Metrics.
Model metrics kunnen worden gegroepeerd op models, virtual models, users, virtual accounts, teams of metadata, en de latency-weergaven splitsen request latency, time to first token, inter token latency en time per output token op. Samen met traces per request geeft dit je zowel de microscoop als het dashboard.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.



Het laatste nieuws, artikelen en bronnen in je inbox



















