



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
DeepSeek-V4-Pro ging op 24 april 2026 in preview en werd op 13 augustus 2026 algemeen beschikbaar (GA) — in iets minder dan vier maanden. De API-modelnaam is nooit veranderd: je aanroept nog steeds deepseek-v4-pro, en de GA-build heeft de preview erachter eenvoudigweg vervangen.
De specificaties, afkomstig van DeepSeek’s Models & Pricing-pagina en de GA model card, per september 2026:
Twee details zijn belangrijker dan het aantal parameters.
Ten eerste: de weights zijn echt open. De GA-checkpoint is gepubliceerd op deepseek-ai/DeepSeek-V4-Pro-0813 onder de MIT-licentie — geen aangepaste communitylicentie met een omzetplafond of beperkingen op het gebruiksgebied. MIT is zo permissief als het maar kan. Dat is het belangrijkste feit dat de rest van dit artikel het schrijven waard maakt.
Ten tweede: het efficiëntiewerk is het echte architectuurverhaal. De preview model card beschrijft een hybrid attention-ontwerp dat Compressed Sparse Attention combineert met Heavily Compressed Attention, en meldt dat V4-Pro bij een context van 1M tokens ongeveer 27% van de single-token inference FLOPs en 10% van de KV cache van DeepSeek-V3.2 nodig heeft. Lange context is hier goedkoop om te serveren op een manier die in de V3-generatie niet mogelijk was, wat de berekening rond self-hosting juist zo interessant maakt.
[SCREENSHOT: DeepSeek chat — de Expert Mode-selector die op app en web naar V4-Pro routeert]
DeepSeek is hier opvallend direct over. De GA model card vermeldt dat V4-Pro-0813 “is gebouwd op de DeepSeek-V4-Pro (Preview) modelstructuur, met een DSpark speculative decoding-module toegevoegd” — het basismodel is hetzelfde; de post-training en het decoding-pad niet.
De verschillen die het publiceert, van preview naar GA:
Bron: DeepSeek-V4-Pro-0813 model card, september 2026.
Een waarschuwing bij het interpreteren hiervan. DeepSeek merkt op dat code-agent scores zijn gegenereerd met behulp van de eigen DeepSeek Harness in minimale modus bij max reasoning effort, temperature = 1.0, top_p = 0.95. Een bijna vijfvoudige sprong op DeepSWE is een post-trainingsresultaat gemeten onder de eigen harness van de leverancier, geen onafhankelijke reproductie. De stijgende lijn is duidelijk te zien; de omvang verdient je eigen evaluatie.
Naast het model bracht GA ook native ondersteuning voor de OpenAI Responses API met een one-click Codex-configuratie, en de drie-traps reasoning_effort-instelling die de binaire thinking-schakelaar vervangt.
De GA model card publiceert een vergelijkingstabel tegenover zowel open als gesloten concurrenten. Hier is het deel dat iedereen overneemt, gevolgd door het deel dat de meeste artikelen weglaten.
Bron: DeepSeek-V4-Pro-0813 model card, september 2026.
Waar V4-Pro de leiding neemt. Terminal-achtige agentic taken en beveiligingsgerichte coding. Het scoort hoger dan Opus-4.8 op Terminal Bench 2.1, DeepSWE, Cybergym en AutomationBench. Voor een model dat je kunt downloaden, is dat een indrukwekkend resultaat.
Waar gesloten modellen nog steeds winnen. Pure kennis en het complexere werk aan repositories. Opus-4.8 ligt ruim acht punten voor op NL2Repo, evenals op DSBench-Hard, Toolathlon-Verified en HLE zonder tools. Fable-5 met fallback loopt voorop bij de meeste van dezelfde tests. Als je workload wordt gedomineerd door complexe repository-wijzigingen in meerdere bestanden of brede kennisvragen, blijven de gesloten frontier-modellen de betere keuze, ongeacht hoe enthousiast je bent over de licentie.
Waar de andere open modellen staan. Kimi K3 scoort net iets beter dan V4-Pro op Terminal Bench 2.1 en DeepSWE. De titel “beste open-weight model” staat ter discussie en is niet definitief beslist. De interessante claim is specifieker en duurzamer: een downloadbaar model komt nu zo dicht bij de frontier dat de hostingvraag actueel wordt.
DeepSeek introduceerde met de GA-release een tariefstructuur met piek- en daluren, ingegaan op 16 augustus 2026 om 16:00 UTC. De dalurentarieven zijn precies de helft van de piektarieven. Piekuren zijn van 01:00-04:00 en 06:00-10:00 UTC, van maandag tot en met vrijdag, uitgezonderd Chinese feestdagen; al het andere, inclusief het weekend, valt onder de daluren.
Bron: DeepSeek Models & Pricing, september 2026.
Drie zaken vallen op. De prijs voor een cache-hit is 30x lager dan voor een cache-miss, waardoor de structuur van je prompt enorm belangrijk is voor toepassingen met een vaste system prompt. Het verschil tussen piek- en daluren is een hulpmiddel voor het inplannen van taken, geen korting — door batchverwerking naar de daluren te verplaatsen, halveer je de rekening. Verder heeft DeepSeek de prijzen bij GA verhoogd ten opzichte van de preview, hoewel de gepubliceerde tarieven van de preview nog geverifieerd moeten worden — ze staan niet meer op de prijspagina en we halen ze niet uit secundaire bronnen.
Een operationele opmerking: de API concurrency-limiet voor deepseek-v4-pro is 500. DeepSeek heeft op 10 september 2026 ook bevestigd dat het de V4 Pro API na 14 september 2026 blijft aanbieden tegen ongewijzigde tarieven (change log).
[SCREENSHOT: DeepSeek Platform — verbruiksdashboard met tokenuitgaven tijdens piek- vs daluren]
Vier valkuilen komen herhaaldelijk voor bij open-weight frontier-modellen, en V4-Pro heeft ze alle vier.
De self-hosting rekening draait om een node, niet om een GPU. Het referentie-servingcommando van DeepSeek in de model card richt zich op een enkele 4-node GB300-configuratie via vLLM, met FP8 KV cache, expert parallelism en DSpark speculative decoding ingeschakeld. Een MoE met 1,7T parameters is niet iets wat je even draait op een overgebleven A100. De open weights geven je de mogelijkheid tot self-hosting; of de berekening voordeliger uitvalt dan $ 1,98 per miljoen output-tokens hangt volledig af van je bezettingsgraad. Bij een lagere constante belasting wint de API het op kosten.
Er is geen chat template. De GA-release bevat geen Jinja chat template. In plaats daarvan levert DeepSeek een encoding-map met Python-scripts om berichten in OpenAI-formaat om te zetten naar modelinvoer en de uitvoer weer te verwerken. Alles in je stack wat uitgaat van tokenizer.apply_chat_template zal aanpassing vereisen.
V4-Pro ondersteunt geen vision. Vision-functionaliteit is voorbehouden aan de Flash-lijn, niet aan Pro. Een strategie die uitgaat van één enkel multimodaliteitsmodel werkt hier niet, wat betekent dat je over minimaal twee modellen moet routeren, of je dat nu gepland had of niet.
Dataresidency en API-gebruik zijn nu gescheiden beslissingen. Prompts naar api.deepseek.com sturen is een heel ander datastroomvraagstuk dan dezelfde weights binnen je eigen VPC draaien. Teams halen “we kunnen DeepSeek V4 gebruiken” en “we kunnen de DeepSeek API aanroepen” vaak door elkaar, terwijl die bij dezelfde beveiligingsbeoordeling een andere uitkomst krijgen. Je eigen juridische adviseur bepaalt wat acceptabel is; het punt is alleen dat de open weights beide opties technisch mogelijk maken.
Een open-weight frontier-model veranderd je kostenstructuur pas als je het daadwerkelijk ergens kunt onderbrengen. Dat is precies wat TrueFoundry verzorgt.
Host het zelf in je eigen VPC. De AI Gateway registreert self-hosted open-weight models naast gehoste providers: je implementeert V4-Pro op je eigen Kubernetes met vLLM of SGLang, verwijst de gateway naar het eindpunt, en het verschijnt in de modelcatalogus met dezelfde routing, rate limiting, cost tracking en observabiliteit als elk API-model (self-hosted models docs). Omdat vLLM en SGLang standaard allebei een OpenAI-compatibele API bieden, heeft de gateway geen specifieke DeepSeek-adapter nodig.
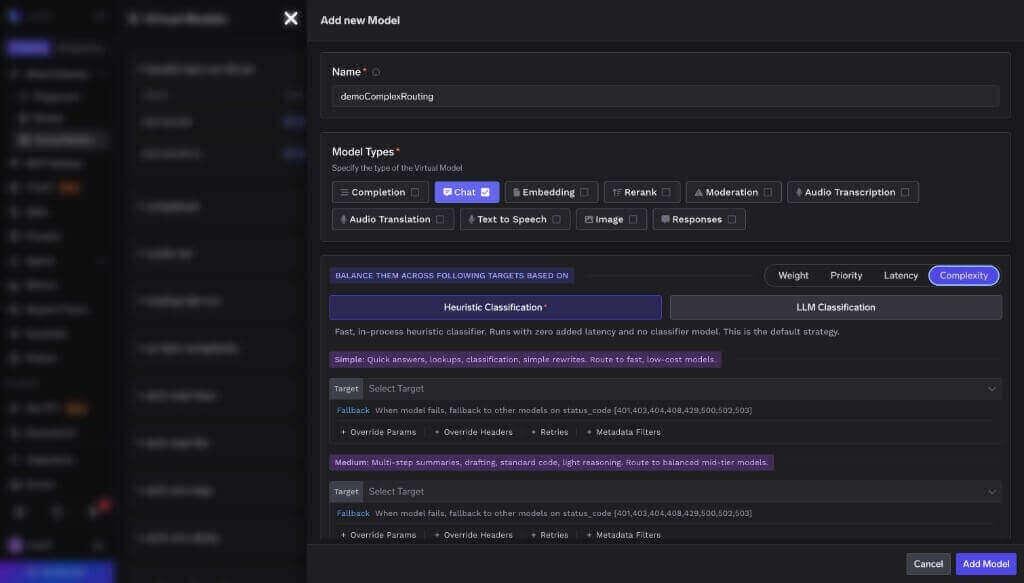
Of roep de API aan en houd de optie open. Als je nog niet klaar bent voor self-hosting, routeer dan via de gateway naar de API van DeepSeek en behoud hetzelfde aanroepad dat je later voor een self-hosted deployment zou gebruiken. De overstap van het gehoste eindpunt naar je eigen cluster wordt zo een configuratiewijziging in plaats van het herschrijven van de applicatie.
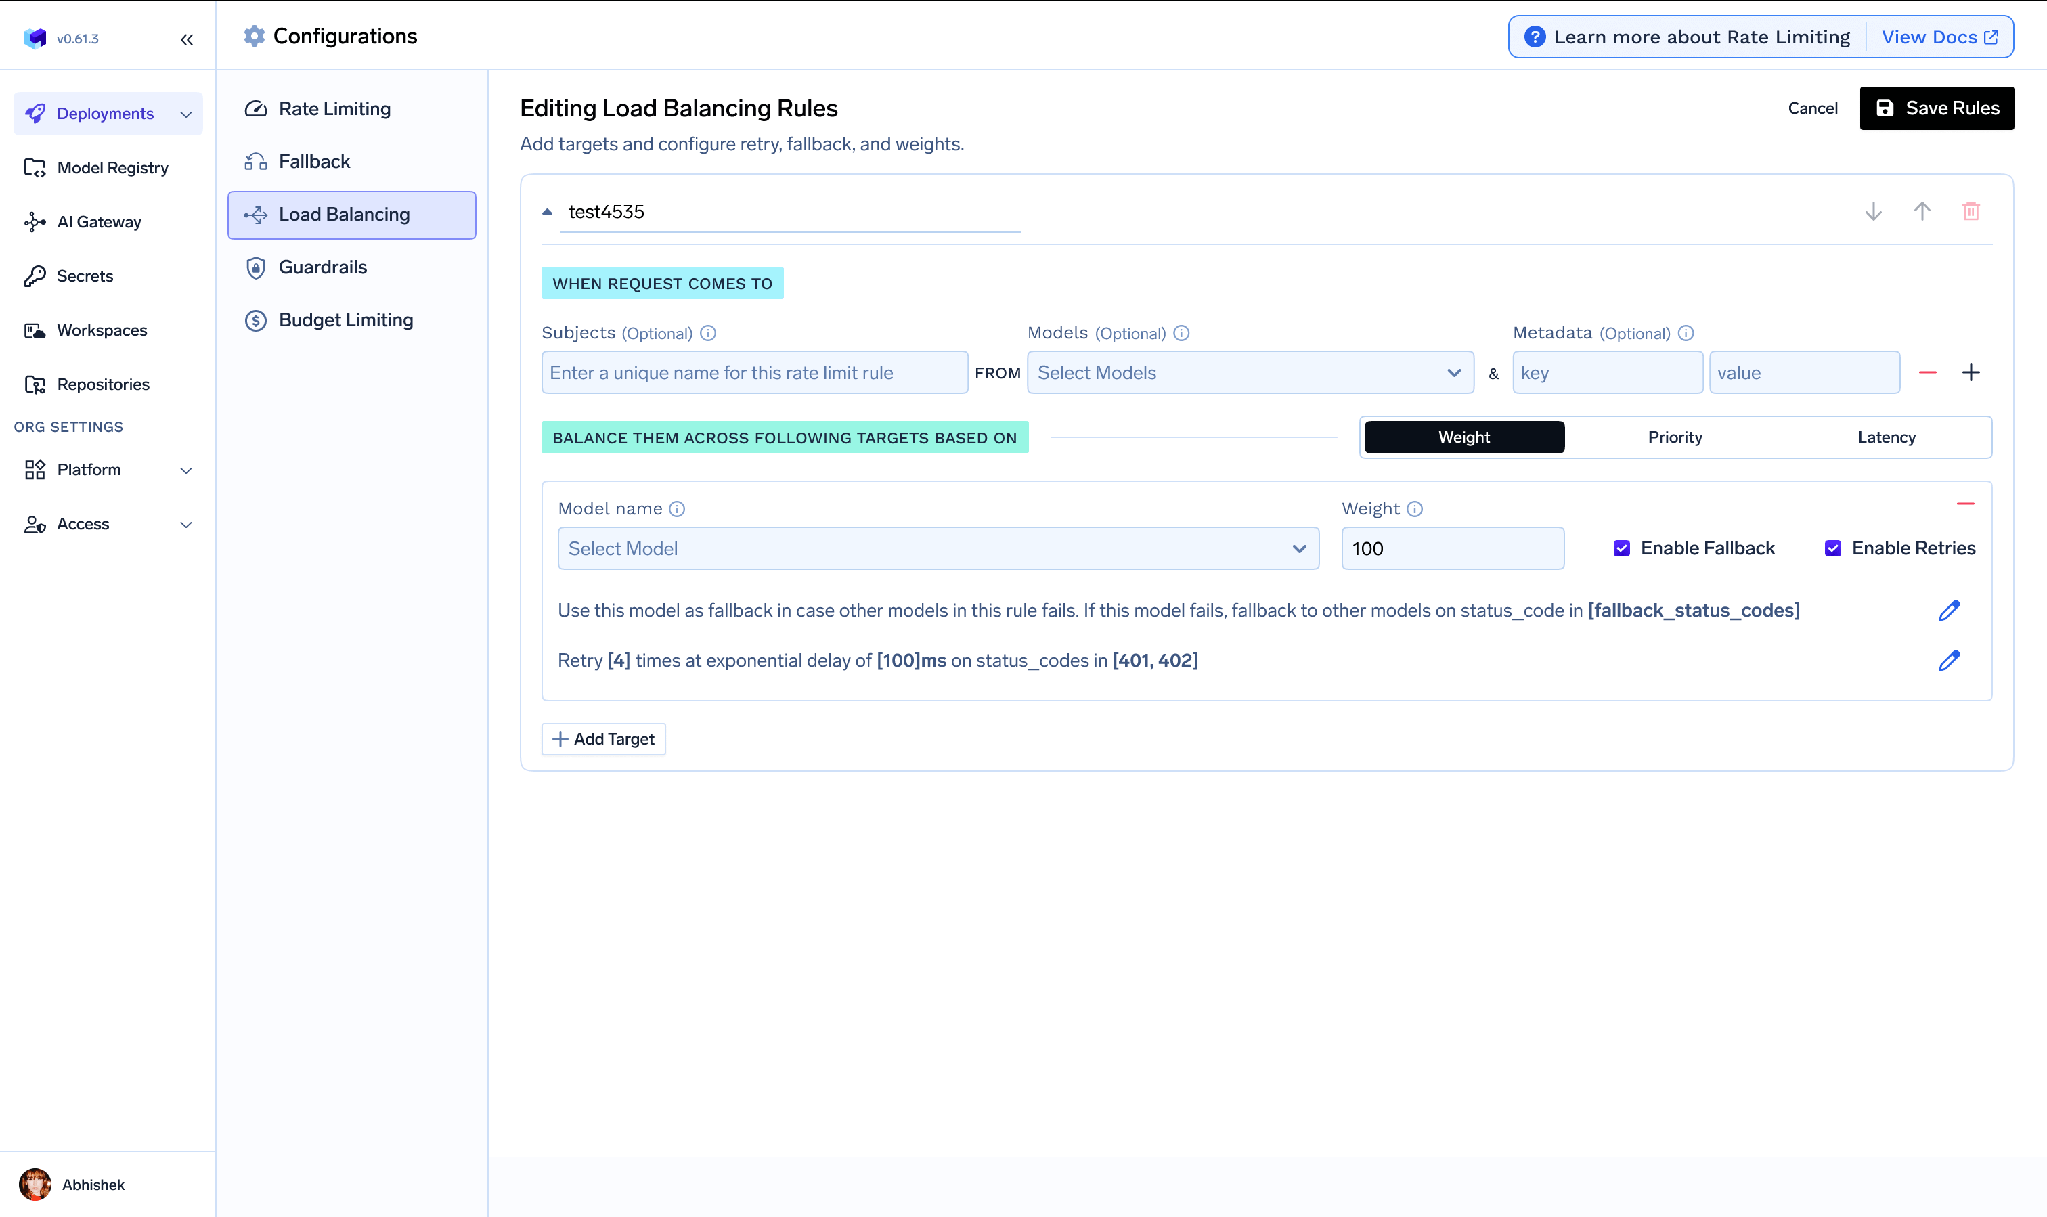
Routeer op basis van complexiteit, niet op basis van gewoonte. De benchmarktabel hierboven pleit voor een gemengde infrastructuur, niet voor een volledige migratie, en cost- and quality-aware routing is de manier om die te beheren. Complex repository-werk naar Opus-4.8, terminal-achtige agent-runs naar V4-Pro, en classificatie of extractie naar een goedkoper model. In TrueFoundry’s eigen Auto Routing benchmark over 550 prompts verlaagde het categoriseren van requests de kosten met 69% met behoud van 98% van de basiskwaliteit, terwijl de gemiddelde latency daalde van 7,6s naar 4,0s; bij realistisch productieverkeer liep de besparing op tot 80%.
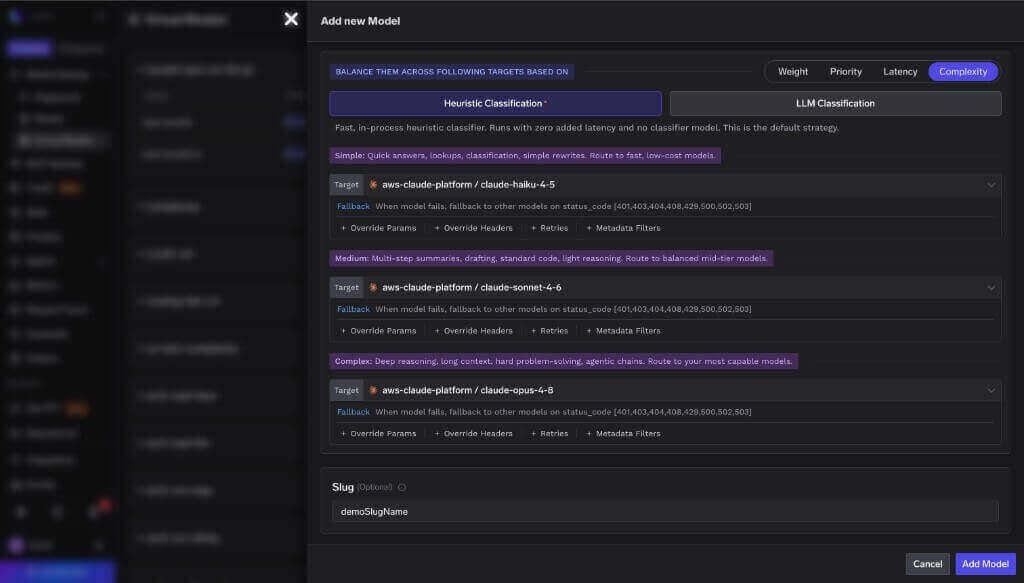
Pas in beide gevallen dezelfde guardrails toe. Een self-hosted model erft niet automatisch de veiligheids-stack van een provider. Guardrails op gateway-niveau worden toegepast op de request- en response-paden, ongeacht of het model op het eindpunt van DeepSeek draait of in je eigen pod.

Meet voordat je keuzes maakt. Inzicht in de kosten en latency per request per team is de enige manier om te ontdekken of de dalurentarieven van V4-Pro of een self-hosted node echt voordeliger zijn dan wat je nu gebruikt.
Kort samengevat, per september 2026:
De GA-release van DeepSeek V4-Pro draait niet primair om benchmarks. Kijkend naar de cijfers die DeepSeek zelf publiceert, wint het van Opus-4.8 op specifieke agentic taken, maar verliest het bij complexer repository-werk en algemene kennis, terwijl Kimi K3 de koppositie onder open modellen betwist. Als puur benchmark-resultaat is het een goed model met een wisselvallige scorekaart.
Kijk je naar de licentie, dan wordt het een heel ander verhaal. Een model met 1M context dat dicht genoeg bij de frontier zit om een serieus alternatief te zijn, uitgebracht onder MIT, zorgt ervoor dat de hostingvraag niet langer theoretisch is. Je kunt het draaien in je eigen VPC, prompts binnen je eigen infrastructuur houden en betalen voor rekenkracht in plaats van tokens — mits je bezettingsgraad een zware node rechtvaardigt en je bereid bent de serving-stack zelf te beheren. Voor de meeste teams zal dat nu nog niet het geval zijn, en is de verstandige stap om te routeren naar de API, terwijl je de weg naar self-hosting openhoudt.
Dat is de eerlijke conclusie: het komt neer op de vraag wat je zelf wilt beheren. Wil je dat een ander het model draait, dan blijven de gesloten frontier-modellen de snelste route en de beste keuze voor het zwaarste werk. Wil je de optie behouden om het model naar je eigen infrastructuur te halen zonder je applicatie te herschrijven, dan is een open-weight model achter een gateway de manier om die optie voordelig vast te leggen — en die optie wil je geregeld hebben voordat je hem nodig hebt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



DeepSeek V4 is DeepSeek’s mixture-of-experts model family. The V4 preview, covering V4-Pro and V4-Flash, launched on 24 April 2026. DeepSeek-V4-Pro reached general availability as DeepSeek-V4-Pro-0813 on 13 August 2026.
The weights and repository are published under the MIT licence on Hugging Face at deepseek-ai/DeepSeek-V4-Pro-0813. That covers the weights and code, not the training data, so “open weight” is the more precise term than “open source”.
As of September 2026: $0.66 per million input tokens off-peak and $1.32 at peak on a cache miss, $0.022 and $0.044 on a cache hit, and $1.98 and $3.96 per million output tokens. Peak hours are 01:00-04:00 and 06:00-10:00 UTC on weekdays.
Yes, and DeepSeek publishes vLLM and SGLang serving recipes. Be realistic about scale: it is a 1.7T-parameter model and the reference configuration in the model card is a multi-GPU GB300 node.
De AI Gateway van TrueFoundry voegt ongeveer 3-4 ms toe en houdt 350+ RPS vol op 1 vCPU, wat verwaarloosbaar is naast generatietijden van meerdere seconden.
Nee, en de benchmarkspreiding hierboven is het argument daartegen. Routeren op taaktype over open en gesloten modellen heen is meestal goedkoper en beter dan standaardiseren op één model.



Het laatste nieuws, artikelen en bronnen in je inbox



















