



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Deepgram is een speech-to-text- en text-to-speech-provider die is gebouwd voor realtime spraak in productiewetgeving. Het huidige vlaggenschipmodel voor transcriptie, Nova-3, verwerkt zowel vooraf opgenomen als streaming audio, met slimme opmaak, diariseerfunctie en meertalige ondersteuning. Aan de uitvoerkant zet Aura tekst om in natuurlijke spraak voor voice agents en IVR.
Binnen elke transactie van de spraakapp nemen ze tegenovergestelde zijden in; de beller zegt iets, waarna Nova-3 het audiosignaal omzet in tekst, een LLM op basis van die informatie een conclusie trekt, en vervolgens Aura (of een andere TTS-engine) het resultaat hardop uitspreekt. Omdat Deepgram snel en nauwkeurig is, wordt het de standaardtool voor zowel transcriptie-hops als in toenemende mate spraak-hops.
Het probleem zit in de praktijk. Deepgram is weer een extra leverancier, met weer een API-sleutel, weer een SDK, weer een kostenpost — en omdat het wordt gefactureerd op basis van de tijd en het aantal getranscribeerde tekens en niet via tokens, maakt het geen deel uit van de kostentracking van uw LLM. Voor één ontwerp kan dat nog wel. In een onderneming met een team van voicebots is dit echter een schoolvoorbeeld van een gebrek aan governance.
Hier is het pay-as-you-go tarievenoverzicht voor de modellen die u het meest waarschijnlijk zult gebruiken.
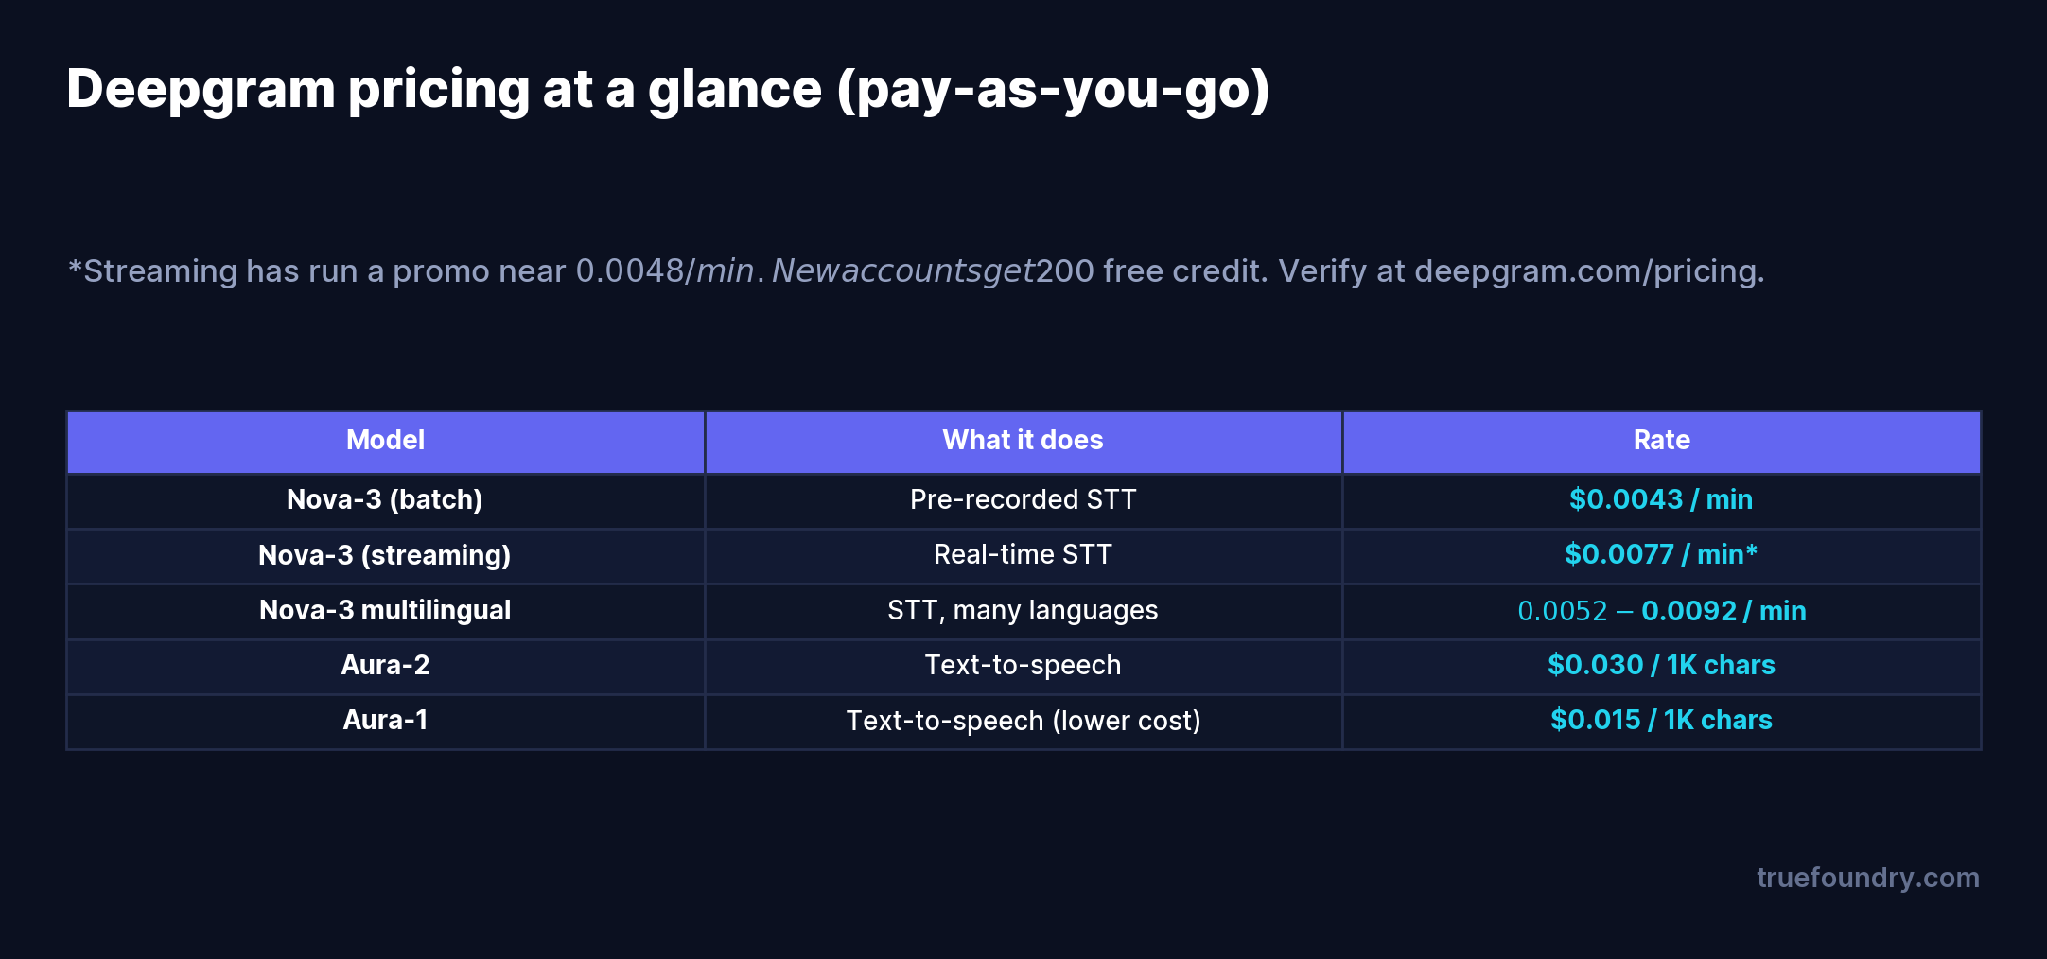
Twee dingen om op te letten. Ten eerste: de eenheid is niet de token. STT wordt gefactureerd per minuut audio, TTS per 1.000 tekens aan invoertekst. Die discrepantie is precies de reden waarom spraakkosten de neiging hebben te ontsnappen aan dashboards die op tokens zijn gebaseerd. Ten tweede: streaming kost meer dan batch — realtime transcriptie valt duurder uit dan vooraf opgenomen audio, dus een live voice agent heeft een andere prijsstructuur dan een offline transcriptiepijplijn. Nieuwe accounts ontvangen $ 200 aan gratis wisselgeld/tegoed om te starten [VERIFIEER huidige tarieven en wisselgeld op deepgram.com/pricing; promotionele streamingprijzen hebben geschommeld].
Een voice agent is niet één enkele model-aanroep — het is een keten, en elke hop is een leverancier die u betaalt, monitort en die kan uitvallen. Door de hele keten achter één gateway te plaatsen, verandert u die wildgroei in één beheerd pad.
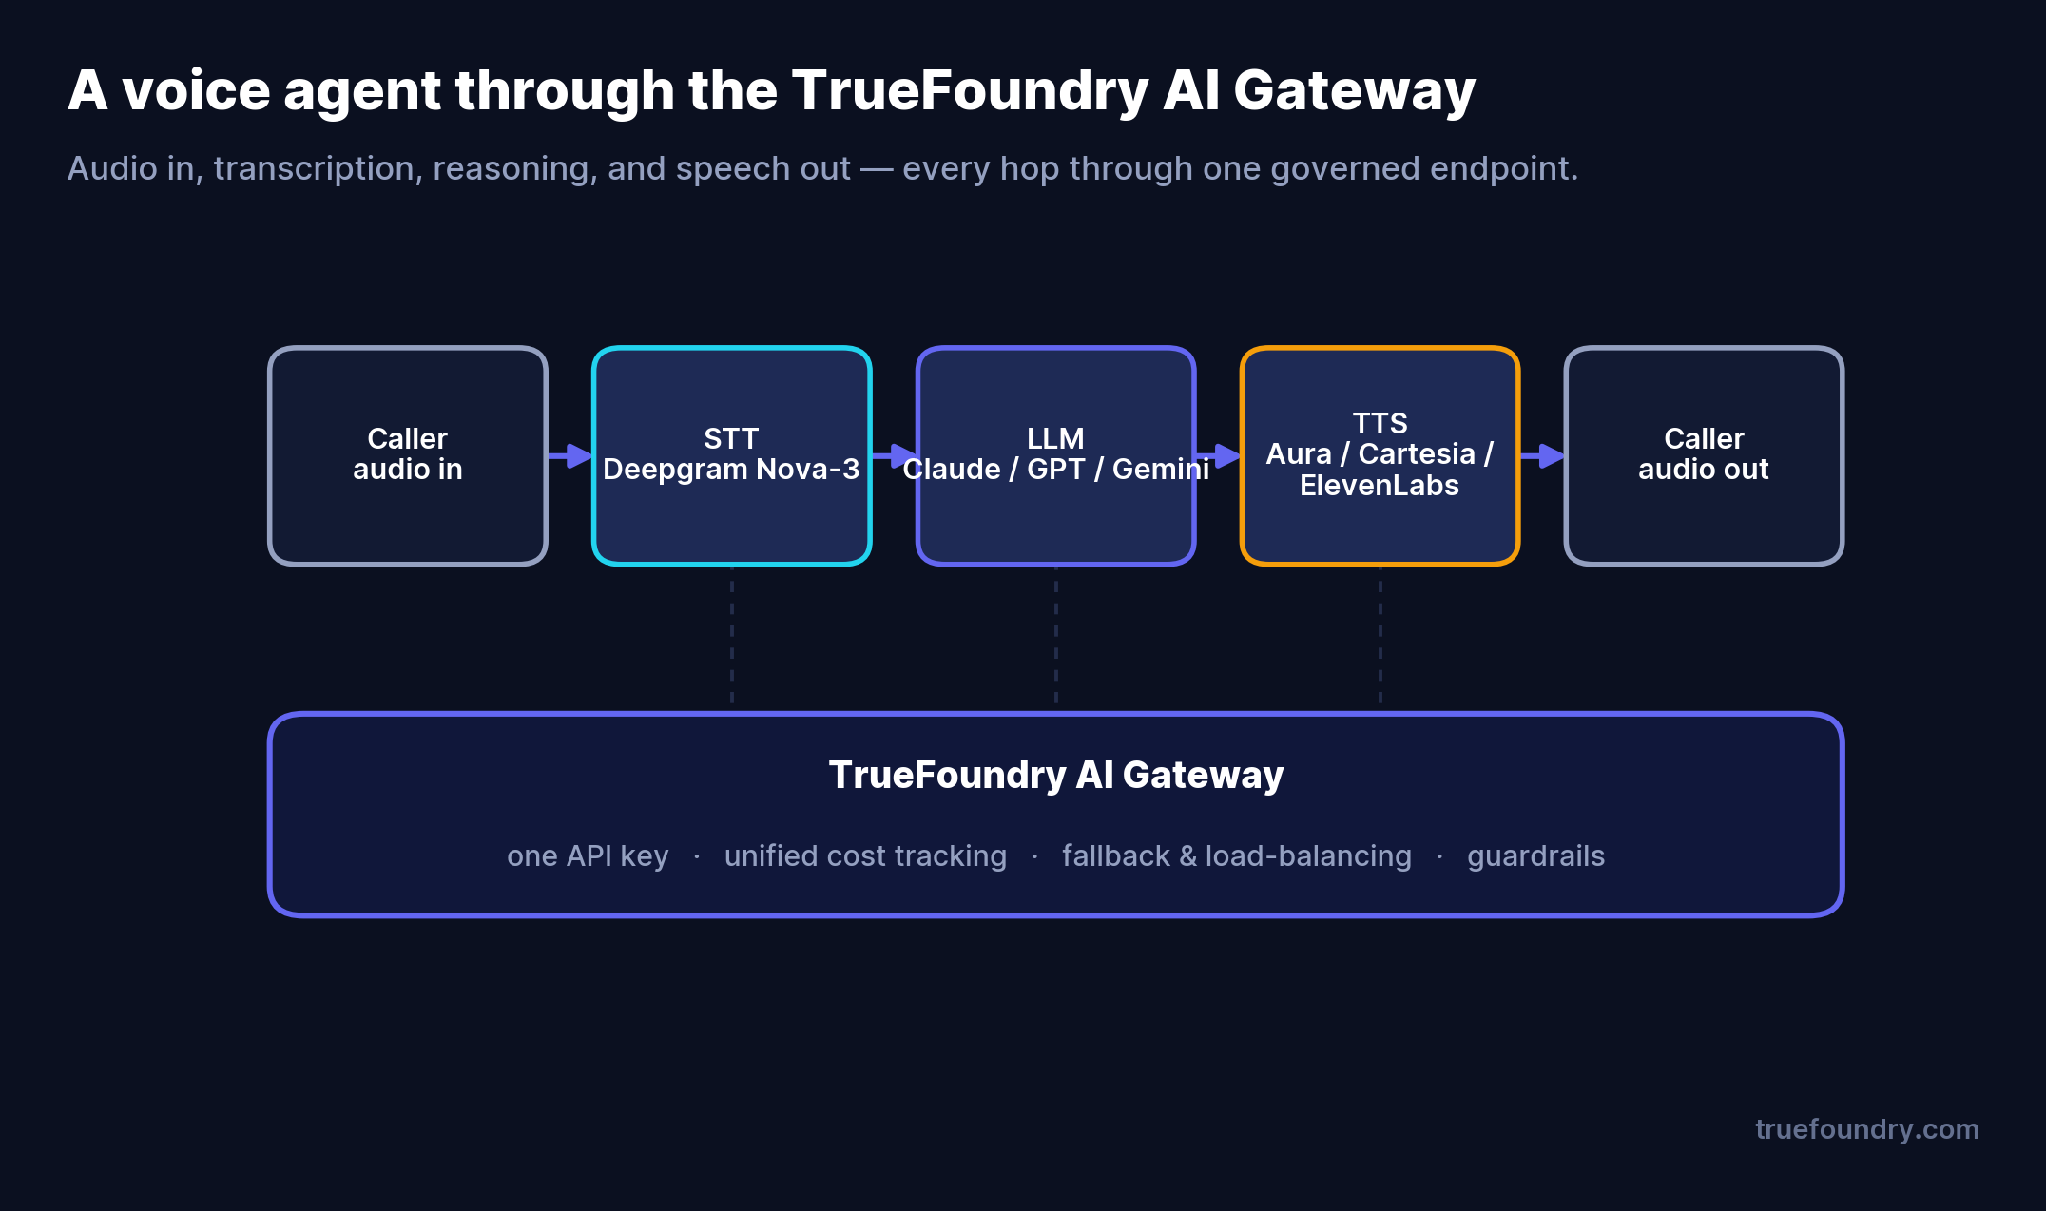
Het routeren van Deepgram via de TrueFoundry AI Gateway levert u vier zaken op die u niet krijgt wanneer u het rechtstreeks aanroept:
Deepgram is niet de enige spraakprovider die door de gateway wordt ondersteund, en dat is precies wat fallback en vergelijkingen mogelijk maakt.
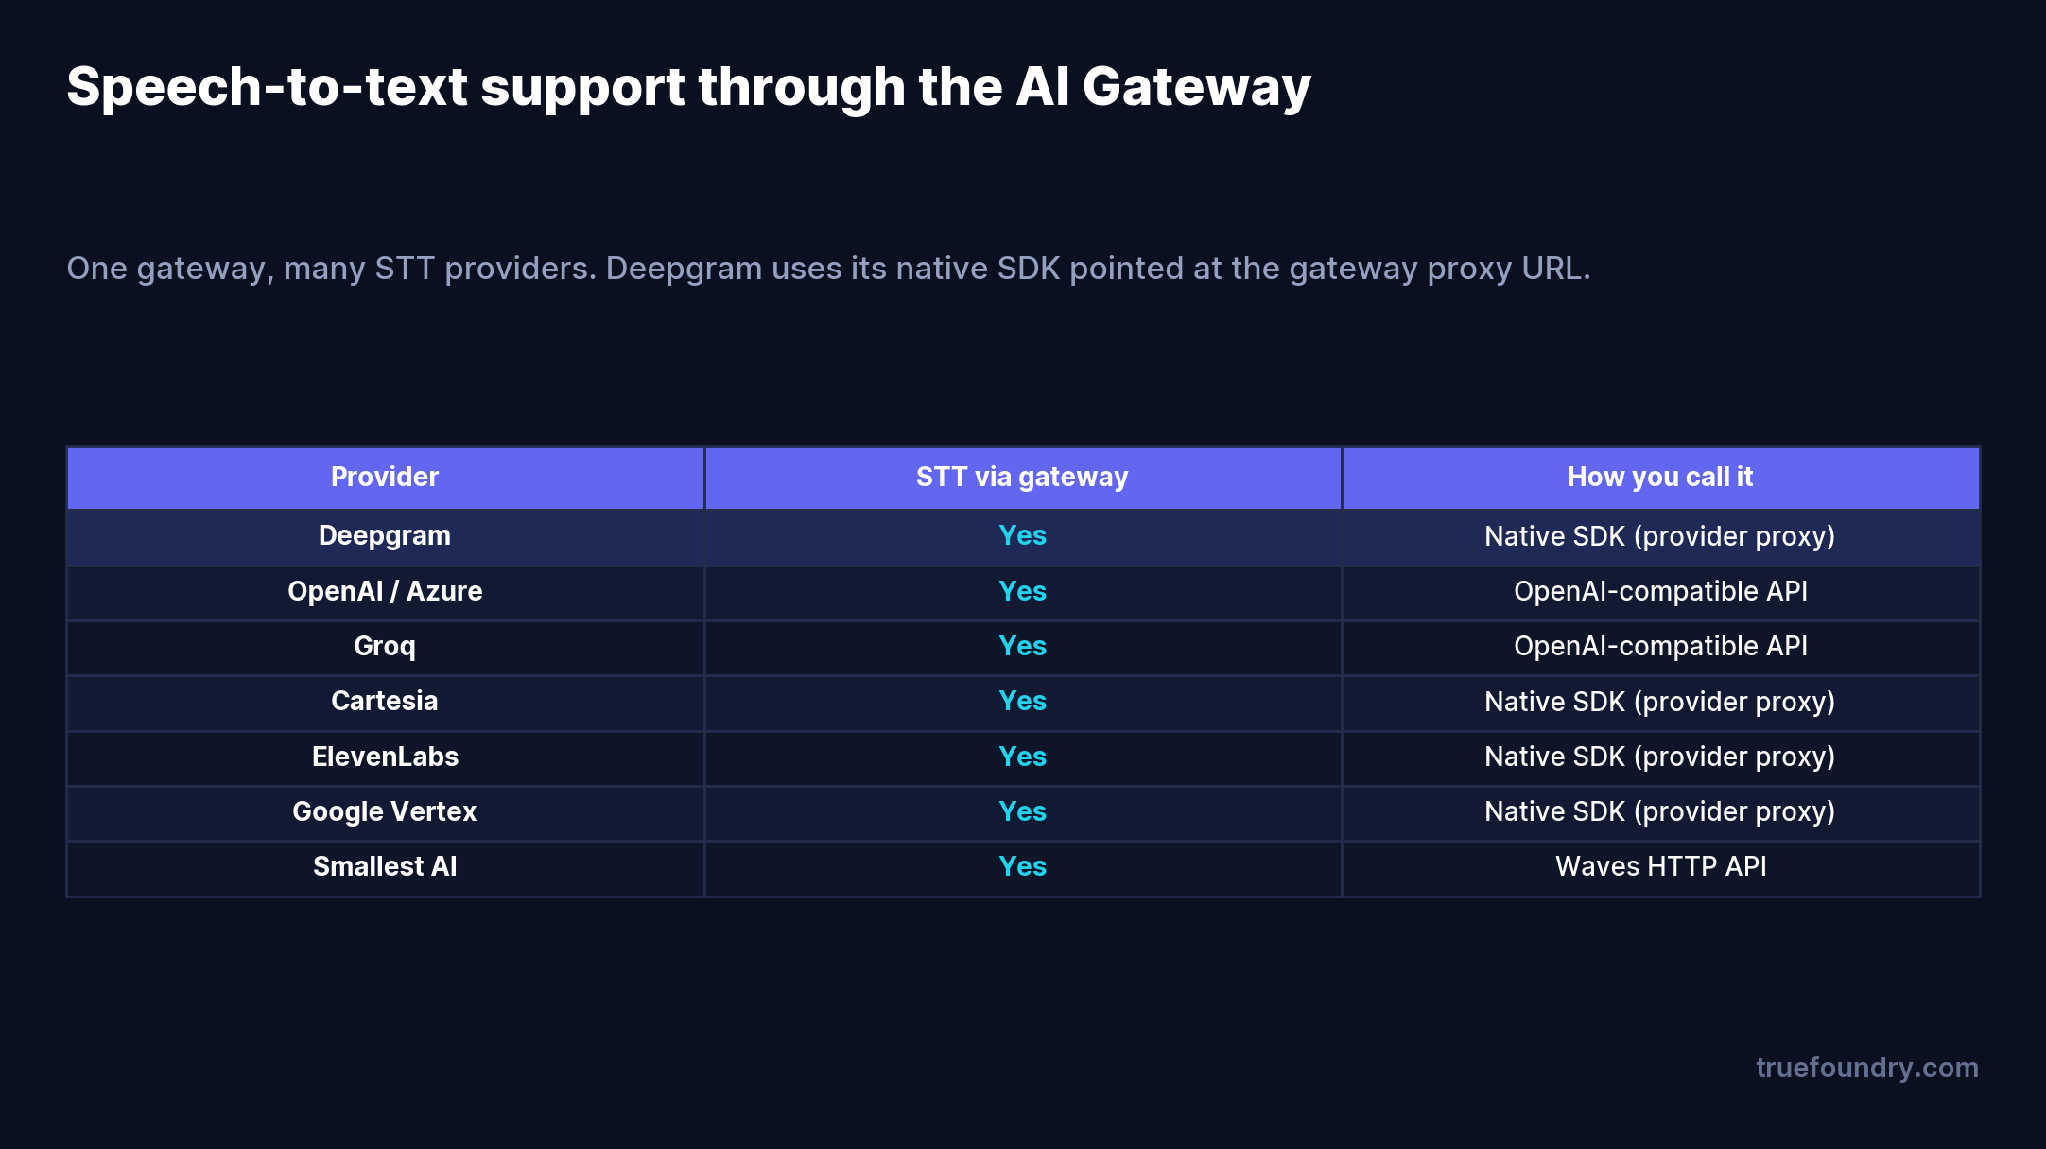
Deepgram, Cartesia, ElevenLabs, Google Vertex en Smallest AI worden aangeroepen via de provider-proxy van de gateway met behulp van de native SDK van elk systeem, terwijl OpenAI, Azure en Groq gebruikmaken van de OpenAI-compatibele API. Dat betekent dat u de exacte functieset van Deepgram behoudt — u reduceert het niet tot een API van het kleinste gemene deler — terwijl u toch profiteert van één sleutel, één factuur en één failover-laag.
Ze houden LLM-kosten bij en vergeten audio. Token-dashboards zien de uitgaven per minuut en per teken volledig over het hoofd. Bij een drukbezocht spraakproduct kunnen transcriptie en spraak de LLM-factuur evenaren — en niemand ziet het totdat de financiële afdeling vragen stelt.
Ze hardcoden de Deepgram-sleutel in elke service. Wanneer elke spraakdienst zijn eigen Deepgram-authenticatiegegevens bevat, betekent rotatie een nieuwe deployment en is er geen centrale plek om het verbruik te maximeren of toe te wijzen.
Ze hebben geen failover voor de spraak-hops. Teams bouwen wel LLM-fallback, maar laten STT/TTS achter als 'single points of failure'. Als Deepgram een minuut lang een storing heeft, valt de hele agent stil.
Ze halen streaming- en batchprijzen door elkaar. Een realtime agent laten draaien op basis van de aanname van batchtarieven onderschat de kosten. Streaming is hoger geprijsd; neem dat zo op in het model.
De instelling bestaat uit drie stappen. Ga in het dashboard naar AI Gateway → Models en selecteer Deepgram.
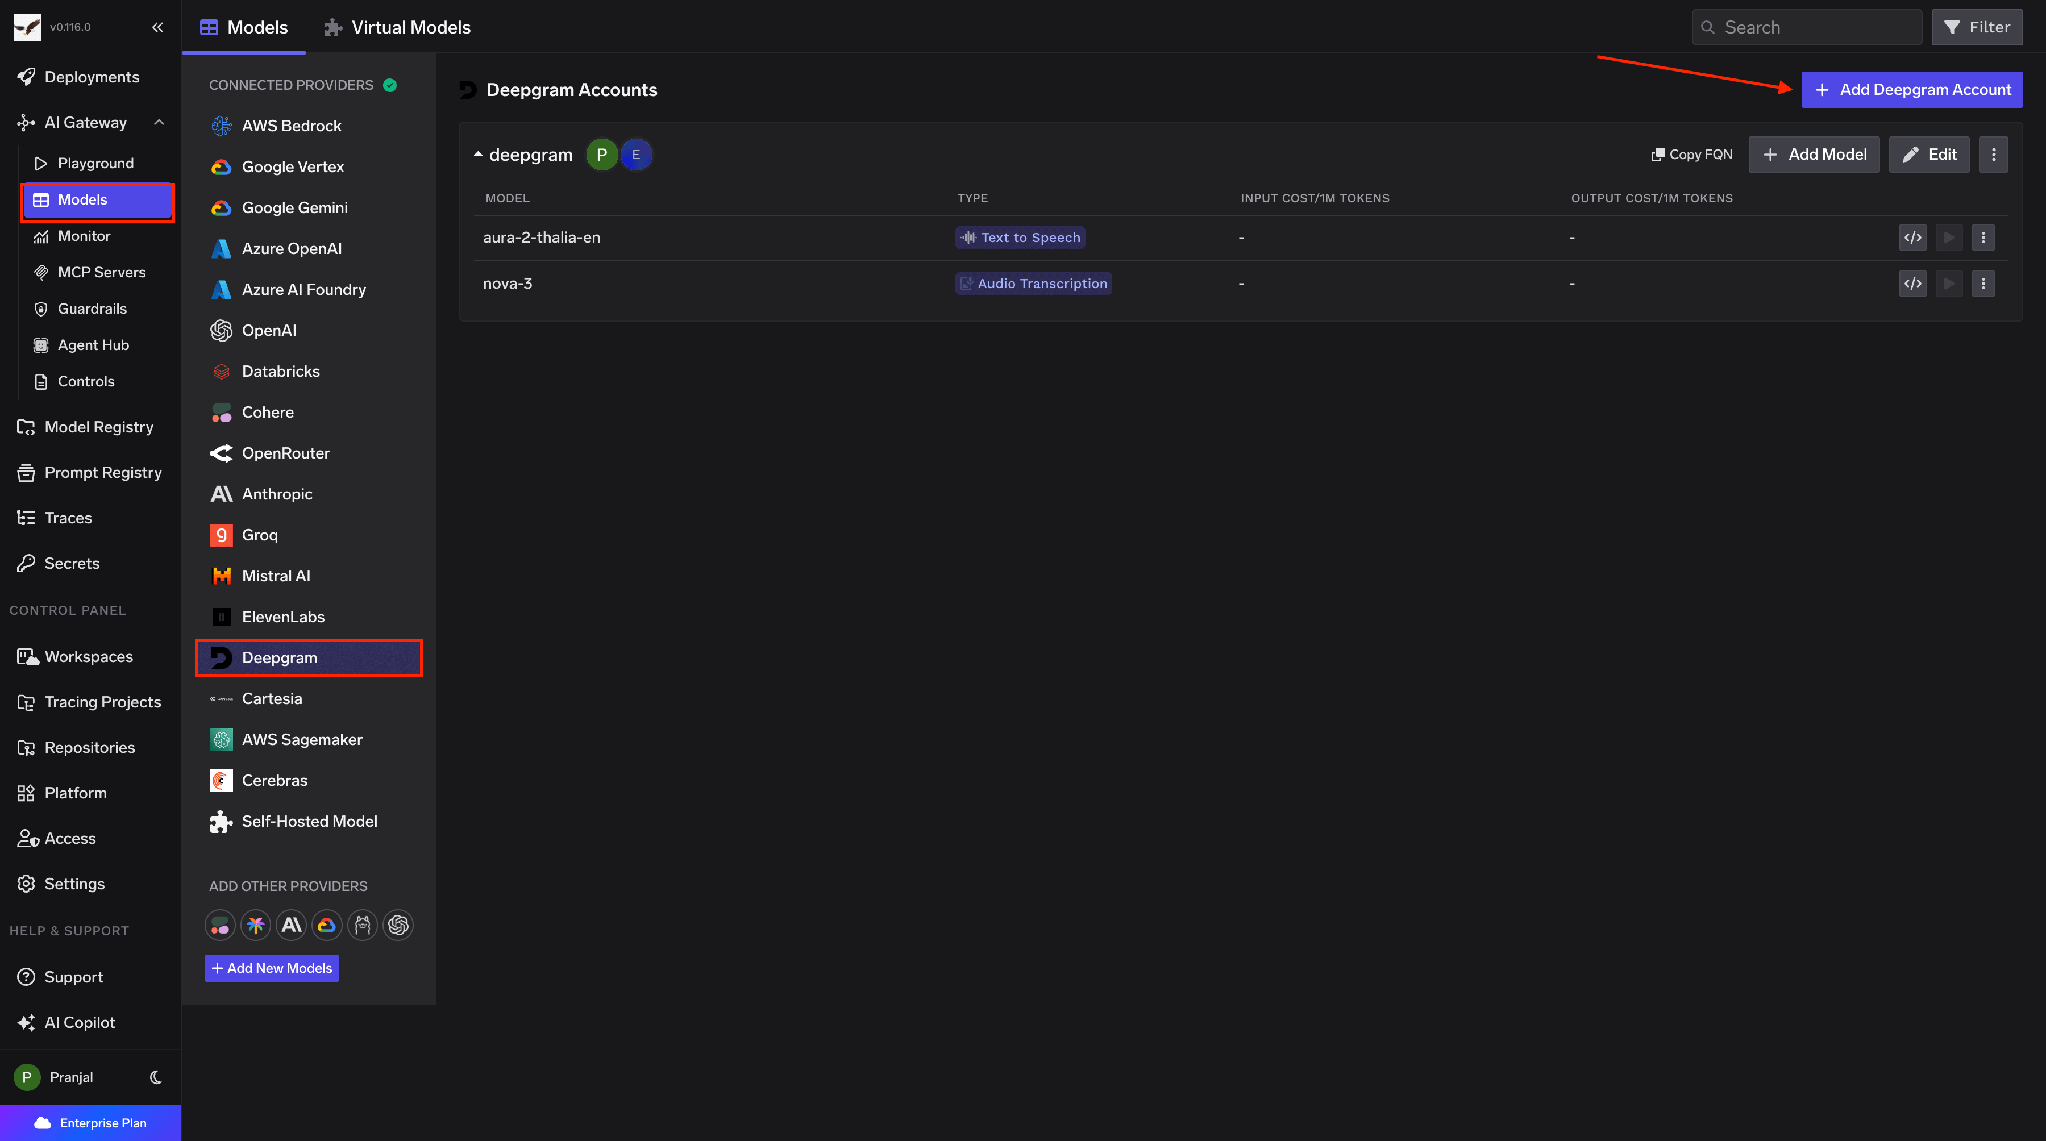
Voeg uw Deepgram-account toe met de bijbehorende API-sleutel, geef het een naam, stel optioneel een aangepaste basis-URL in en voeg medewerkers toe voor toegangsbeheer.
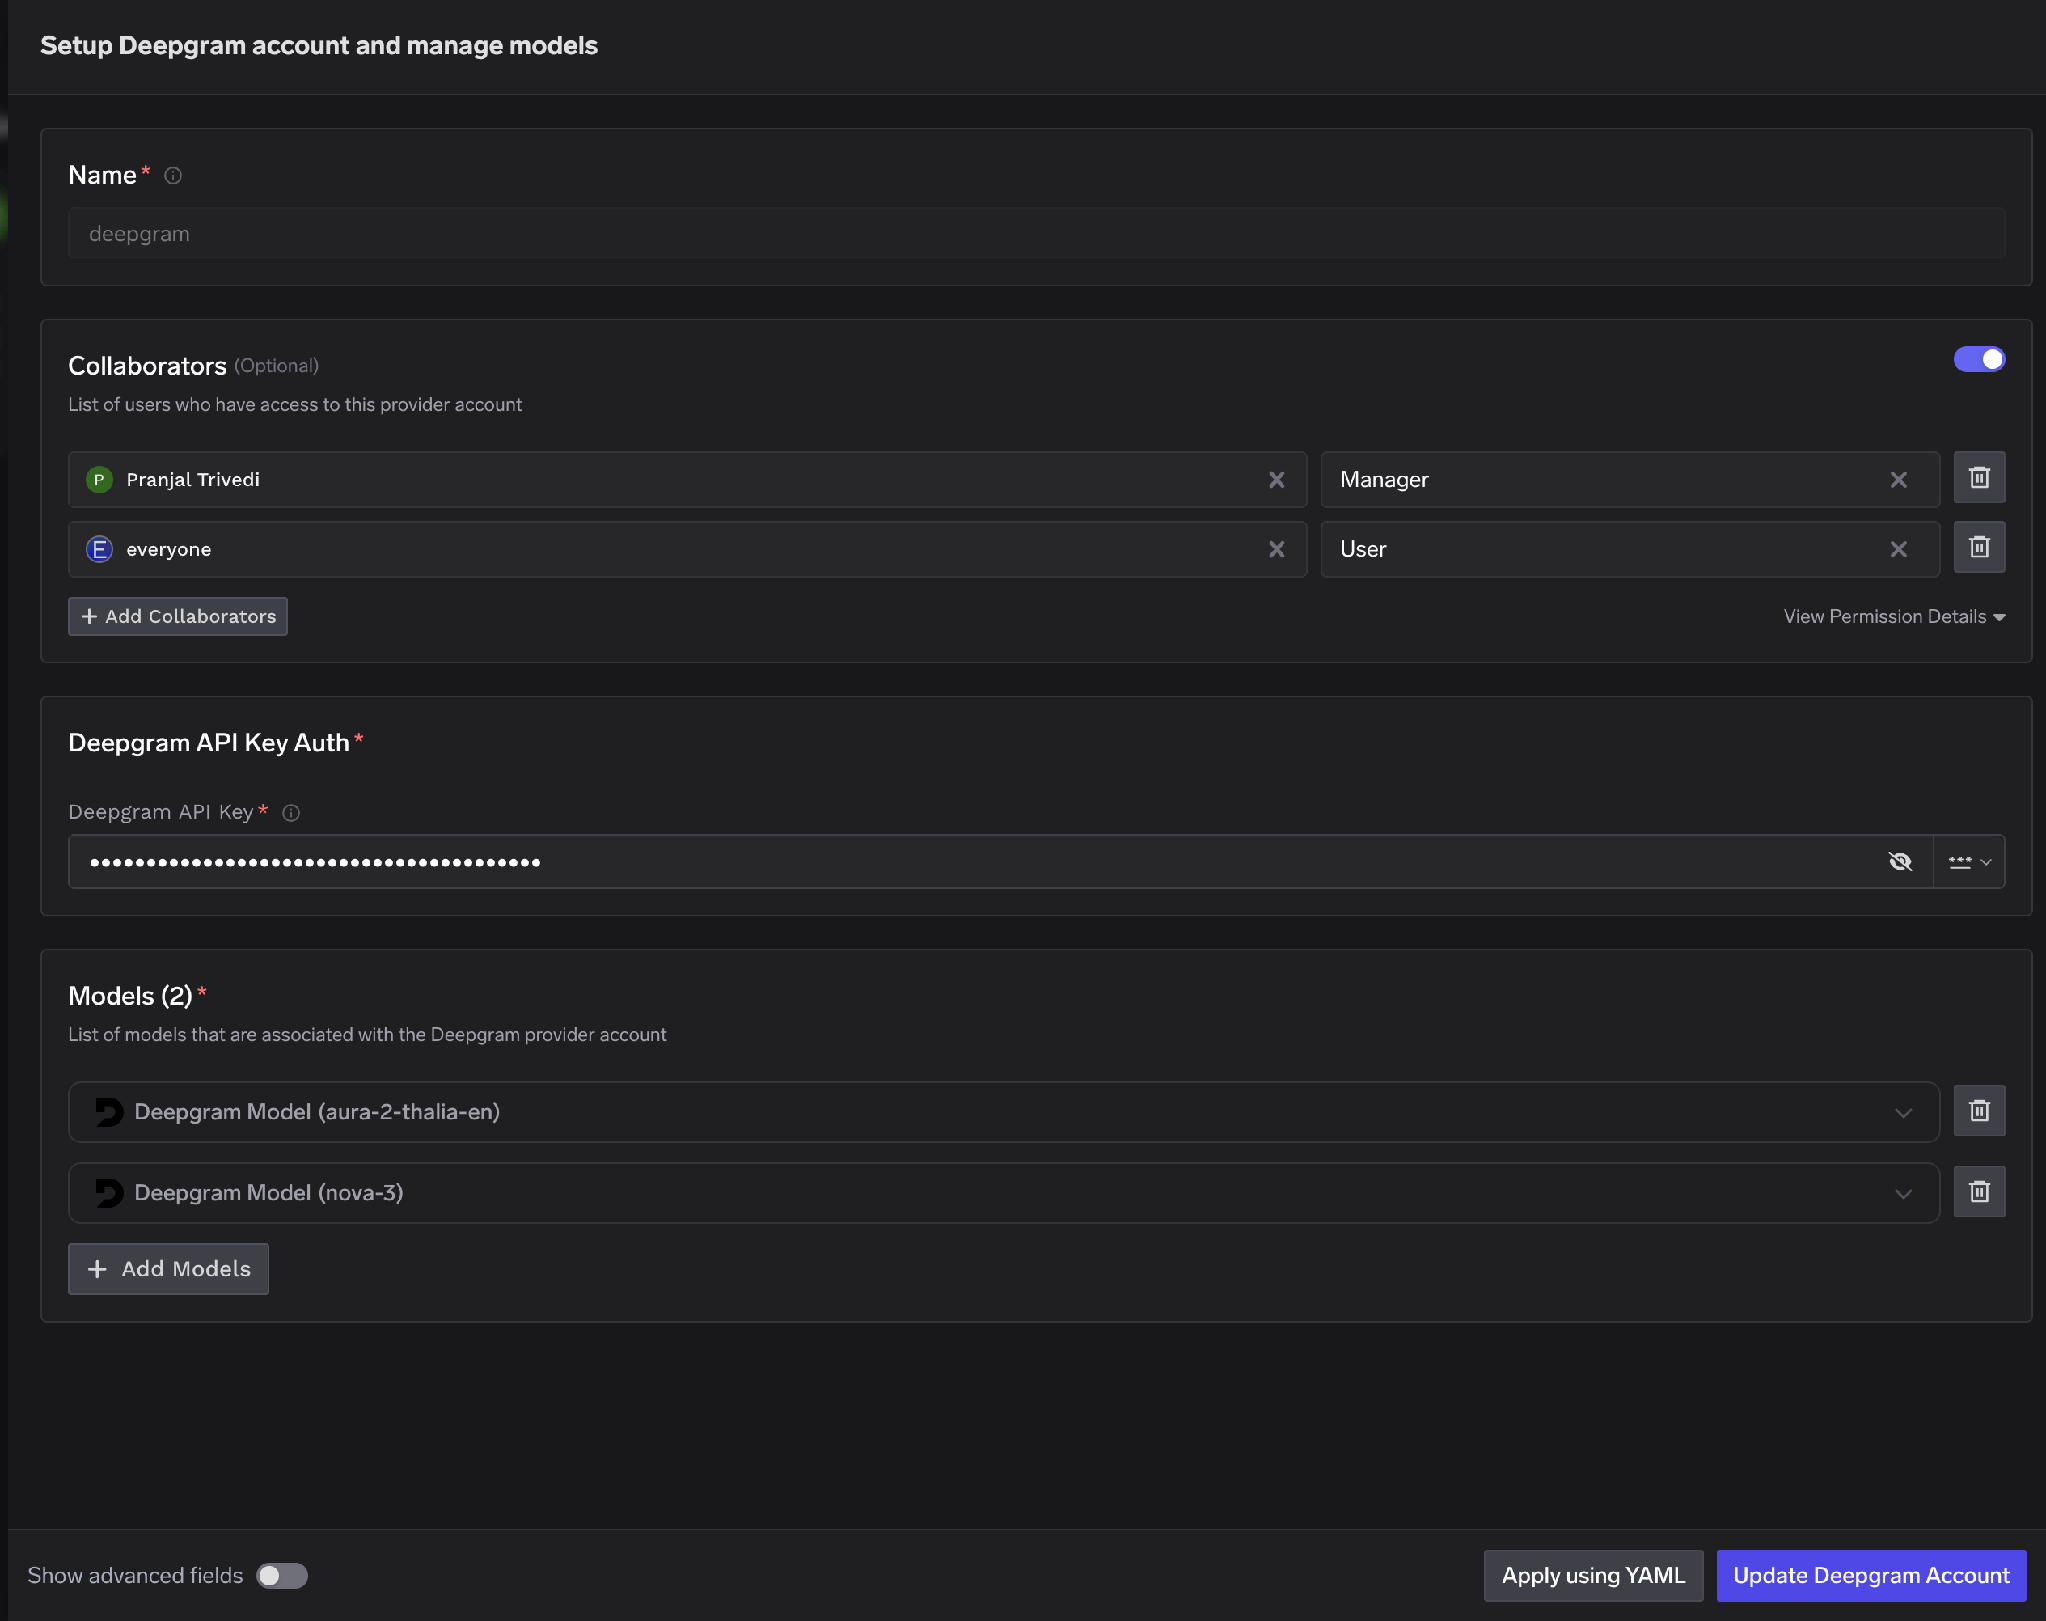
Voeg vervolgens het model toe met de Display name, Model ID en Model type. Eén belangrijk detail: voor Deepgram moeten de Model ID en Display name identiek zijn.
Zodra het is toegevoegd, roept u Deepgram aan met de eigen native SDK, gericht op de provider-proxy-URL van de gateway:
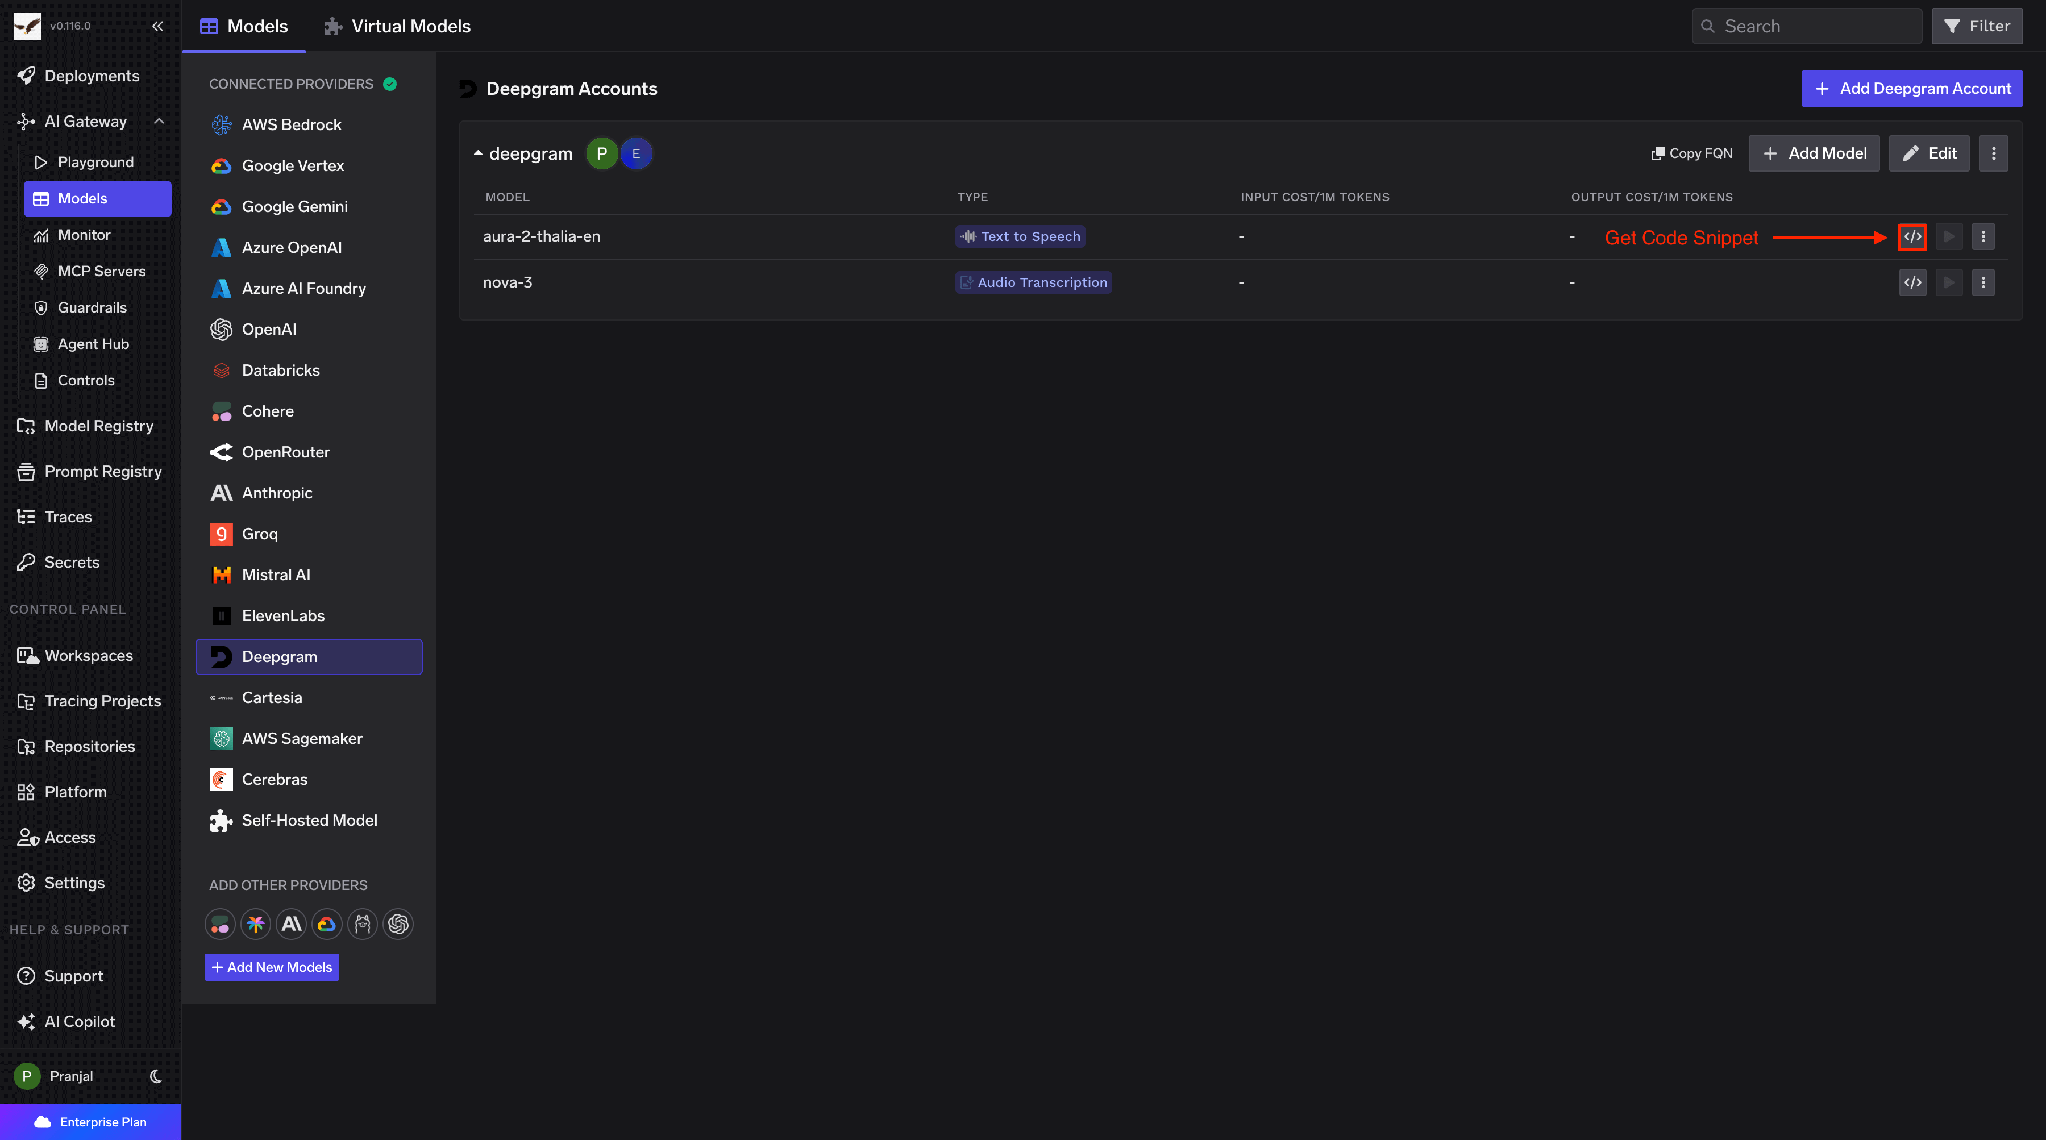
De applicatie bevat een TrueFoundry-sleutel (een dummy vervangt de Deepgram-sleutel, die zich in de gateway bevindt). U behoudt smart_format, diarize, taalselectie en elke andere Deepgram-parameter — de gateway stuurt ze ongewijzigd door.
Een bedrijf runt een telefonische klantenservice-voice-agent: 20.000 gesprekken per maand, met een gemiddelde van 4 minuten streaming-transcriptie en ongeveer 2.500 tekens aan gesproken reactie per gesprek, met een LLM-beurt daartussenin.
Globale maandelijkse berekening tegen pay-as-you-go-tarieven:
Het punt is dat tweederde van deze spraakfactuur uit audio bestaat, niet uit het LLM — en zonder meting op gateway-niveau staat die $2.100+ aan Deepgram-uitgaven op een afzonderlijke factuur, niet toegewezen aan het team of de functie die er verantwoordelijk voor is. Via de gateway is het één regelitem dat u kunt opsplitsen, limiteren en optimaliseren, direct naast de modelkosten.
Deepgram is een provider die u eenvoudig in gebruik neemt, maar ook gemakkelijk uit het oog verliest. Het model is snel, de SDK is overzichtelijk en de prijs per minuut lijkt laag — totdat u beschikt over een vloot van voice agents, een Deepgram-factuur die niemand afstemt, en geen failover wanneer de transcriptie een minuut lang houterig verloopt.
Door Deepgram via de TrueFoundry AI Gateway te routeren, dicht u dat gat zonder iets in te leveren: native SDK, volledige functieset, plus één sleutel, geconsolideerde audio- en LLM-kostentracking, toegangsbeheer en fallback over meerdere providers. Uw spraak-stack verandert zo van drie losse onderdelen in één beheerd traject.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Deepgram biedt speech-to-text (Nova-3) en text-to-speech (Aura) voor real-time en vooraf opgenomen audio. Het wordt vaak gebruikt voor voice agents, gesprekstranscriptie, vergadernotities, en IVR, waar lage latentie en nauwkeurigheid belangrijk zijn.
Pay-as-you-go kost Nova-3-transcriptie ongeveer $0,0043 per minuut voor vooraf opgenomen audio en $0,0077 per minuut voor streaming; Aura-2 tekst-naar-spraak kost $0,030 per 1.000 karakters (Aura-1 is $0,015). Audio wordt per minuut en per karakter gefactureerd, niet per token.
Ja. Voeg Deepgram toe als een modelaccount, en roep het vervolgens aan met de native SDK van Deepgram, gericht op de provider-proxy-URL van de gateway. U behoudt de volledige functieset van Deepgram, terwijl u een sleutel, unified kostentracking, en fallback krijgt.
Ja. De gateway meet STT per minuut audio en TTS per karakter, en toont die uitgaven naast LLM-kosten, toegewezen per model, team, gebruiker en verzoek.
Ja. Maak een virtueel model aan met het Audio Transcription-type dat meerdere providers omvat; de gateway doet load balancing en failover tussen hen zonder codewijziging.
Ja. Het dataverkeer van TrueFoundry draait in uw VPC of on-prem, zodat audio- en gebruiksdata binnen uw omgeving blijven.



Het laatste nieuws, artikelen en bronnen in je inbox

















