



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De dbt MCP server is een remote MCP server die wordt beheerd door dbt Labs als onderdeel van dbt Cloud. Model Context Protocol is de open standaard waarmee een agent tools op een extern systeem kan ontdekken en aanroepen, en dbt's implementatie stelt je dbt Cloud-project beschikbaar als aanroepbare tools. Volgens de documentatie van TrueFoundry kan het metrieken opvragen via de Semantic Layer, model-metadata inspecteren en SQL uitvoeren.
De meeste data MCP servers geven een agent data — Snowflake geeft rijen, Postgres geeft rijen. De dbt MCP server geeft de kaart: welke modellen bestaan er, waar zijn ze uit opgebouwd, wat betekent elke kolom, welke tests bewaken ze en hoe definieert jouw organisatie een metriek.
Eerlijkheid gebiedt te zeggen: de documentatie beschrijft functionaliteitsgebieden, geen functielijst, en noemt één tool: execute_sql. Lees alles buiten de bovenstaande families op het tabblad Tools. De documentatiepagina beschrijft geen tools voor het starten van jobs of run-orchestratie, dus we hebben deze niet geclaimd.
Hier is het foutscenario dat elk analyticsteam herkent. Iemand vraagt een agent: "wat was de net revenue retention afgelopen kwartaal." De agent heeft inloggegevens om een SQL database te raadplegen. Hij ziet fct_subscriptions, dim_customers en veertig kolommen met namen als mrr_amt en mrr_amount_usd. Dus hij schrijft een query. Er komt een getal terug. Het is onjuist, en niets geeft dat aan.
De agent faalde niet bij de SQL. Hij faalde bij de definitie. Hij gokte welke kolom wat betekende, hoe churn behandeld moest worden, of downgrades meegenomen moesten worden, en produceerde een zelfverzekerd antwoord gebaseerd op vier gissingen. De dbt MCP server neemt het gokken op twee manieren weg.
Lineage en kolomcontext. Een agent kan vragen waar fct_subscriptions uit is opgebouwd, wat elke kolom betekent en welke tests ervoor slagen — de context die een menselijke analist wel heeft en een directe warehouse-verbinding niet.
Benoemde metrieken. Als net revenue retention is gedefinieerd in de Semantic Layer, stelt de agent deze helemaal niet zelf samen. Hij roept de metriek bij naam aan met een 'grain' en een dimensie, en dbt compileert de SQL. De definitie staat in versiebeheer, beoordeeld door de eigenaren. Dat is waarom semantic layer MCP een eigen zoekterm is: het scheidt een agent die query's schrijft van een agent die je overeengekomen antwoorden leest.
Dat is het argument om dbt aan te sluiten vóór een warehouse. Een text-to-SQL agent zonder semantische laag is een hallucinatiemachine met queryrechten. Met dbt er voor heeft hij een woordenboek.
De nuttige werkstromen koppelen tools aan elkaar in plaats van er één aan te roepen:
Drie van die vier hebben alleen metadata nodig, wat verklaart waarom deze integratie eenvoudig veilig te maken is.
We zullen hier voorzichtiger zijn dan bij een warehouse-server; het risico opblazen zou niet eerlijk zijn.
Metadata lezen is een laag risico. Modelnamen, kolombeschrijvingen, lineage-verbindingen en testresultaten zijn geen klantgegevens. Er lekt niets en niets kost geld.
execute_sql is waar de consequenties beginnen. De documentatie is expliciet: schakel het uit, tenzij agents directe SQL-uitvoering nodig hebben. Het vereist een ontwikkelomgeving-ID en een gebruikers-ID om überhaupt te werken, wat op zichzelf al een signaal is. Een agent die hiermee in een lus blijft draaien op een grote tabel zorgt voor een warehouse-rekening en, afhankelijk van het bereik van het token, een datalek-pad (egress).
Semantic Layer-query's vormen het tweede punt. Veiliger dan ruwe SQL omdat de definitie vaststaat, maar niet gratis. Een metriekquery wordt gecompileerd naar warehouse-werk, en een agent die deze verspreidt over elke dimensie gedurende drie jaar op dagbasis genereert een dure scan.
Tokenbereik vermenigvuldigt beide. Een Personal Access Token erft de rechten van de gebruiker; een service token gebruikt toegewezen rechtensets. Een PAT van een Account Admin, geplakt in een agentconfiguratie, geeft die agent beheerdersbereik. De documentatie verwijst naar een service token voor gedeelde leestoegang, de juiste standaardinstelling voor alles wat onbemand draait. En drie headers plus een token, gekopieerd naar de laptop van elke analist, is oncontroleerbaar bij vijftien personen.
Niets hiervan is een argument tegen het aansluiten van dbt. Het is een argument voor een controlelaag ervoor, en dat is waar een MCP gateway voor bedoeld is.
dbt is geen keuze van één klik in de Managed MCPs-catalogus. Het wordt toegevoegd via Connect any Remote MCP Server, omdat het een token vereist dat jij aanmaakt en headers die alleen jij kent.
Vereisten: een dbt Cloud-account op Starter, Team of Enterprise; Account Admin-toegang; een productie-omgeving, plus een ontwikkelomgeving voor execute_sql; dbt AI-functies ingeschakeld.
Stap 1 — Maak een dbt-token aan. Gebruik een Personal Access Token voor individuele toegang of wanneer je execute_sql nodig hebt; een service token voor gedeelde leestoegang. Kopieer het direct.
Stap 2 — Verzamel de numerieke ID's uit de dbt Cloud-URL's:
Stap 3 — Open de kiezer. Klik in de MCP Gateway op Add Server en kies Connect any Remote MCP Server.
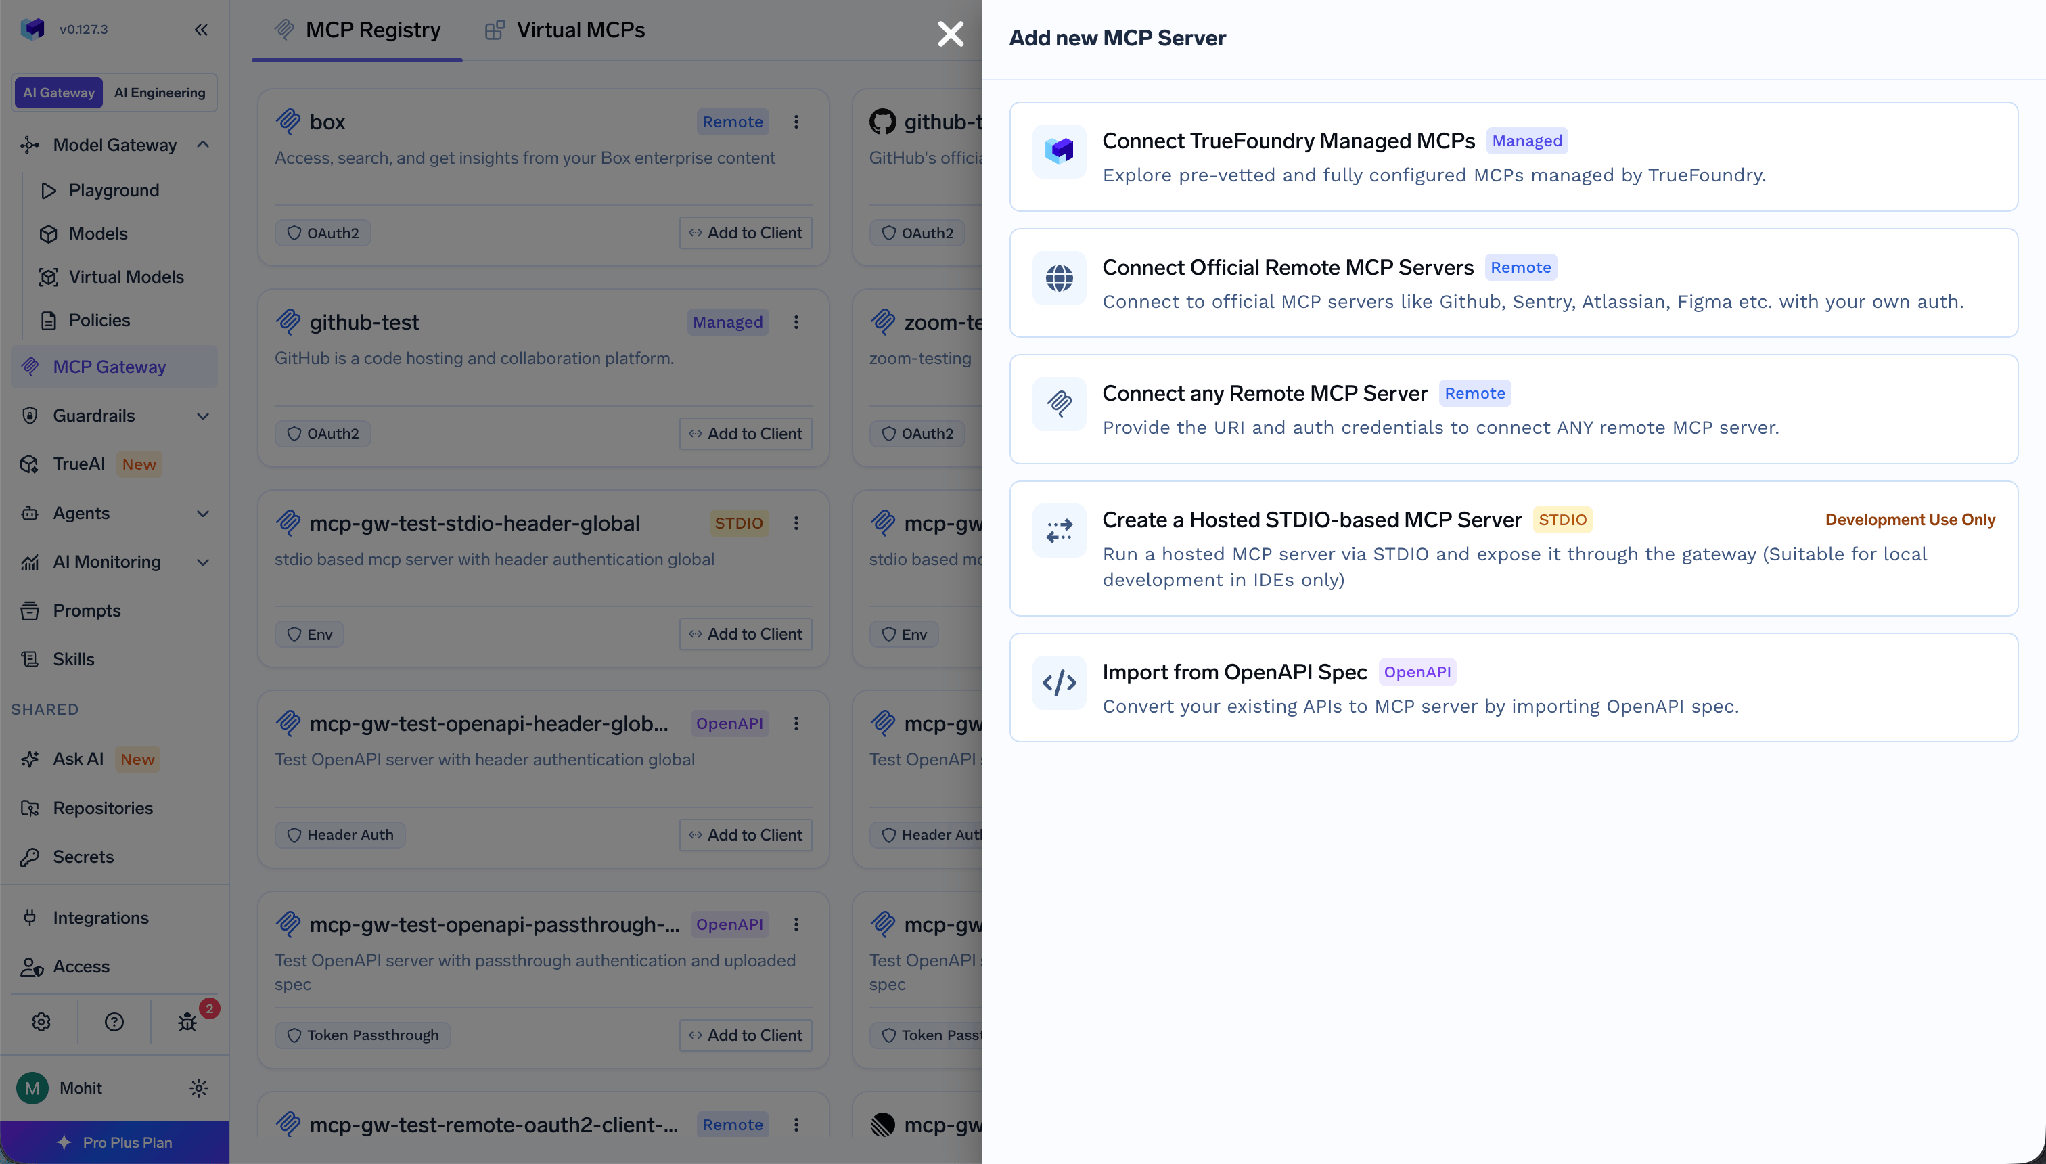
Stap 4 — Vul de servergegevens in. Voer een Name, Description, URL, Collaborators en Auth Data in. De URL is het standaard dbt MCP-eindpunt:
https://cloud.getdbt.com/api/ai/v1/mcp/
Gebruik voor accounts met meerdere cellen de hostnaam van je cel, bijvoorbeeld https://abc123.us1.dbt.com/api/ai/v1/mcp/.
Stap 5 — Configureer authenticatie en headers. Voeg bearer-token-authenticatie toe, configureer het dbt-token en stel de x-dbt-*-headers in. Om risicovolle tools bij de verbinding zelf te verbergen, voeg je x-dbt-disable-toolsets of x-dbt-disable-tools toe — twee onafhankelijke plaatsen om een tool te verwijderen, wat zorgt voor 'defense in depth'.
TrueFoundry maakt onderscheid tussen inbound authenticatie (hoe een client zich bewijst tegenover de gateway) en outbound (hoe de gateway zich bewijst tegenover dbt).
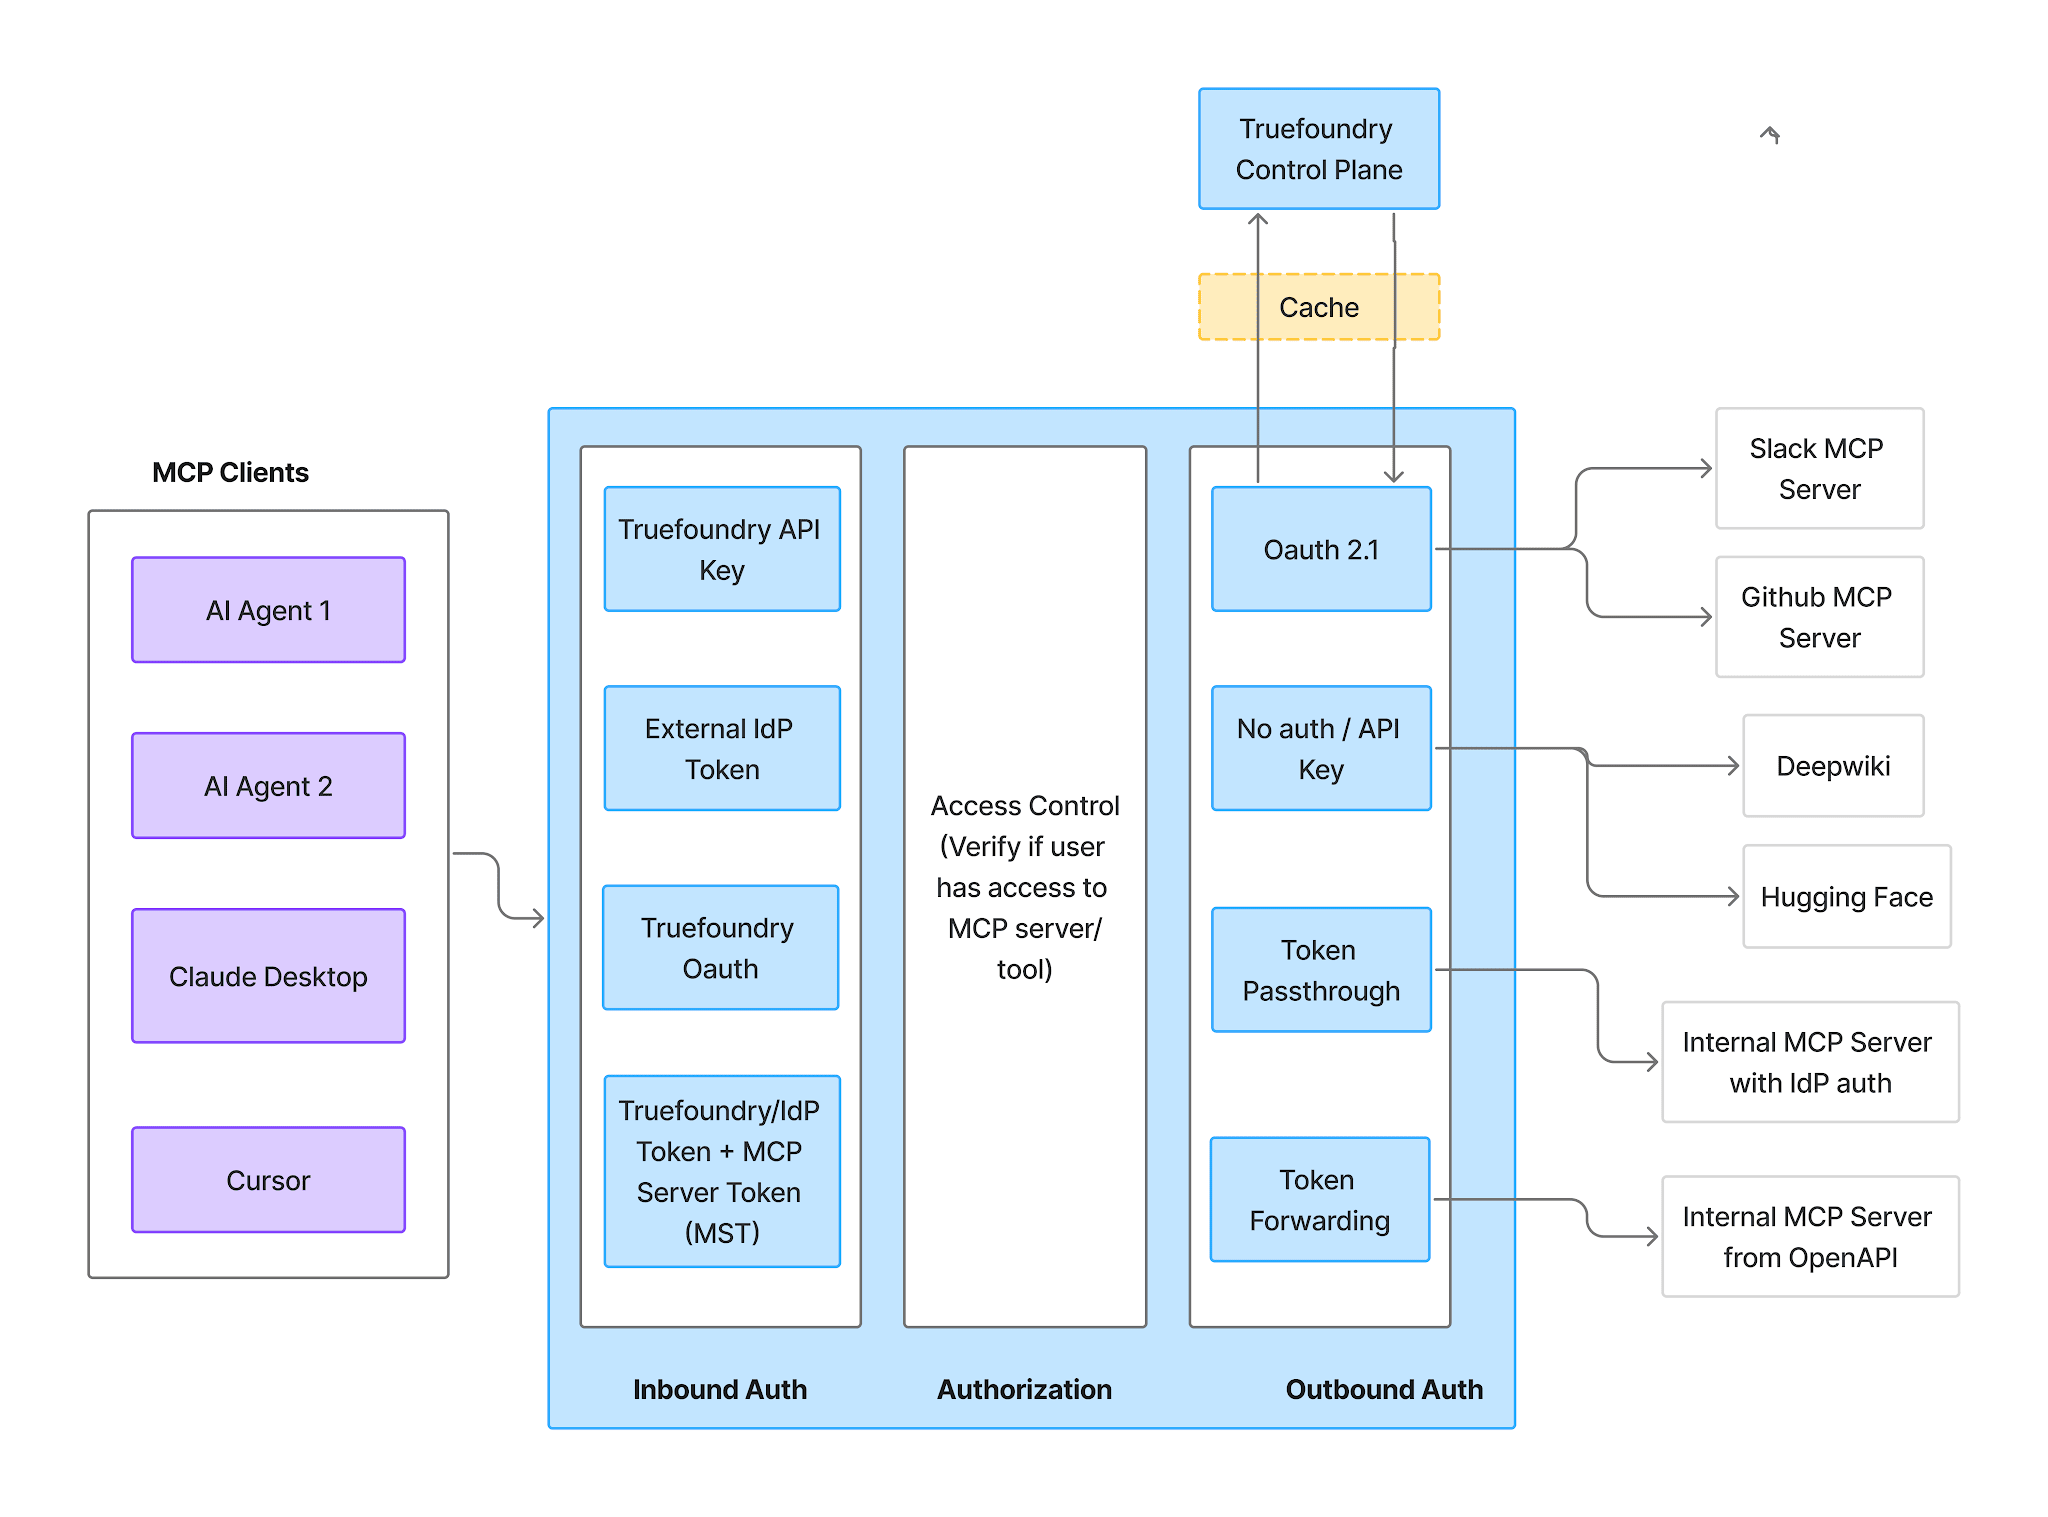
Inbound ondersteunt TrueFoundry API-sleutels, Virtual Account-tokens voor service-to-service-aanroepers, Identity Provider-tokens voor JWT's van je eigen IdP (Okta, Entra, Auth0, Cognito) en TrueFoundry OAuth voor IDE-tools. Eén kanttekening: Virtual Account-tokens geven elk verzoek identieke toegang, dus ze kunnen geen bereik per gebruiker uitdrukken.
Outbound voor dbt is het type API Key, met twee authenticatiemodi.
Shared Credentials betekent één sleutel voor iedereen: configureer de headernaam en -waarde één keer. Dit is de modus voor een service token met een bereik van alleen-lezen metadata.
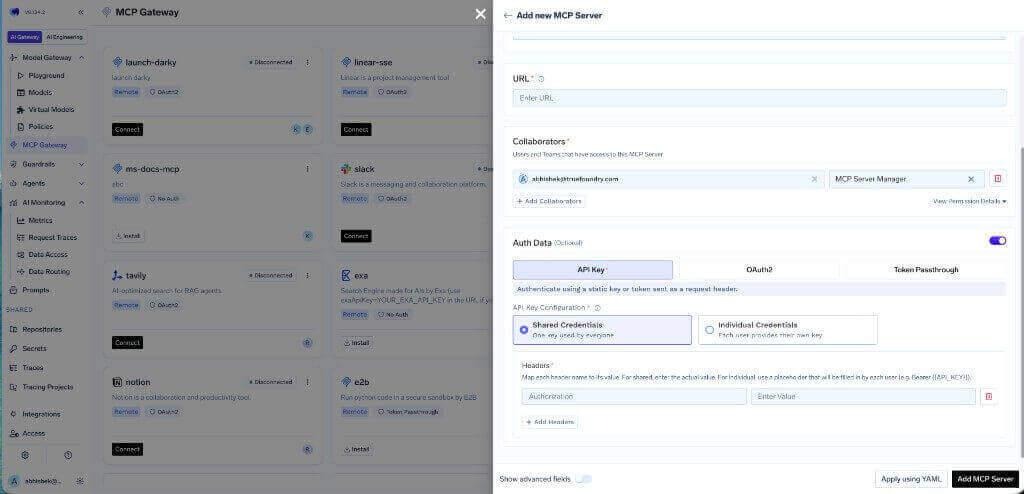
Individual Credentials betekent dat elke gebruiker zijn eigen sleutel aanlevert: configureer de header met een tijdelijke aanduiding zoals Bearer {{API_KEY}}, en elke persoon voegt zijn token toe via het tabblad Auth Overrides.
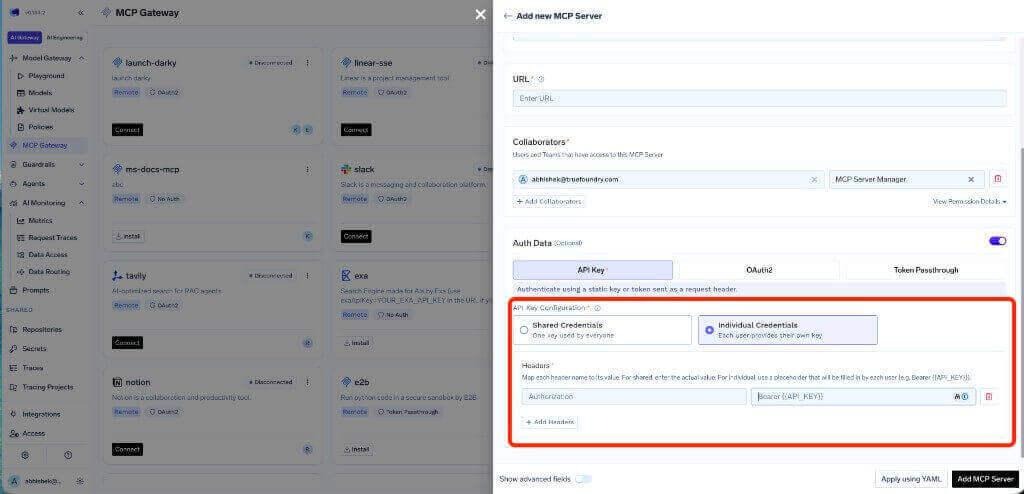
De koppeling is rechtstreeks: Shared Credentials hoort bij een service token; Individual Credentials hoort bij PAT's, en is wat je wilt als execute_sql überhaupt is ingeschakeld, omdat het de SQL-uitvoering beperkt tot de persoon die het heeft uitgevoerd.
Omdat dbt bearer-token-authenticatie gebruikt, is er hier geen OAuth-toestemmingsscherm of redirect-URI. Als je OAuth2 configureert op een zelf-geregistreerde remote server, is de redirect-URI de callback van je control plane, https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback, en niet de auth.truefoundry.com callback die wordt gebruikt door Managed MCPs.
Het tabblad Tools is de plek waar je beslist wat agents kunnen doen — voor dbt zijn dit de meest waardevolle vijf minuten van de instelling.
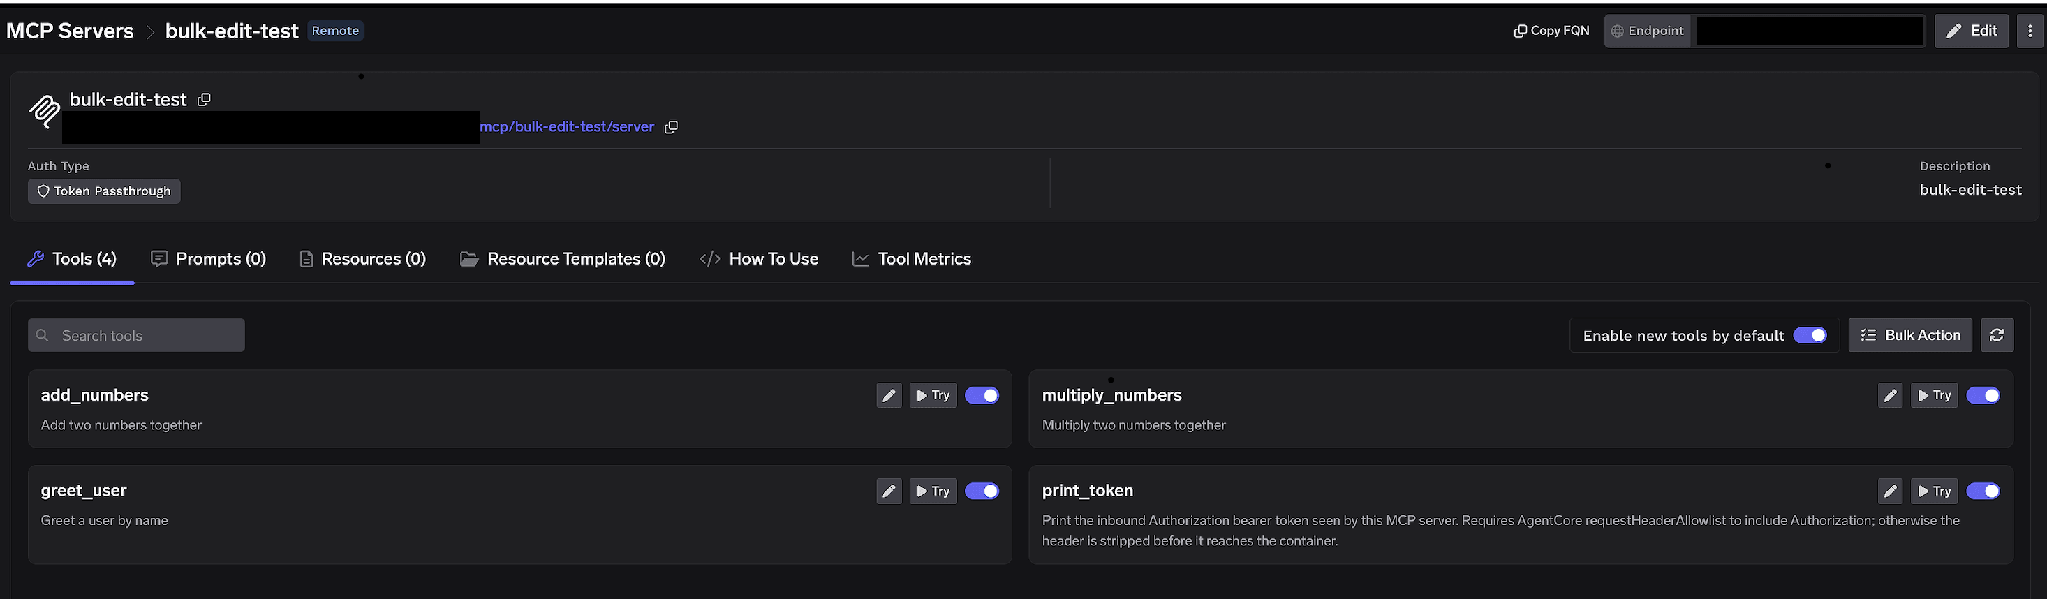
Schakelaars per tool. Schakel een tool uit en deze wordt volledig weggelaten uit tools/list; clients zien deze nooit en het kan niet worden aangeroepen. Dit is geen filtering op prompt-niveau. De aanbevolen dbt-configuratie is eenvoudig: laat metadata- en ontdekkingstools aanstaan, schakel execute_sql uit tenzij een specifieke agent dit nodig heeft. Een agent die execute_sql niet kan aanroepen, kan niet worden verleid tot een uit de hand gelopen query.
Nieuwe tools standaard inschakelen. Als dit aan staat, verschijnen nieuwe stroomopwaartse tools automatisch. Als het uit staat, zijn alleen de door jou ingeschakelde tools beschikbaar, zodat een toekomstige dbt-release niet stilzwijgend kan uitbreiden wat agents kunnen doen.
Bulk Action. Verandert elke rij in een selectievakje, zodat je veel tools tegelijk kunt omschakelen.
Klik op het potlood bij een tool om aan te passen hoe deze aan het model wordt gepresenteerd:
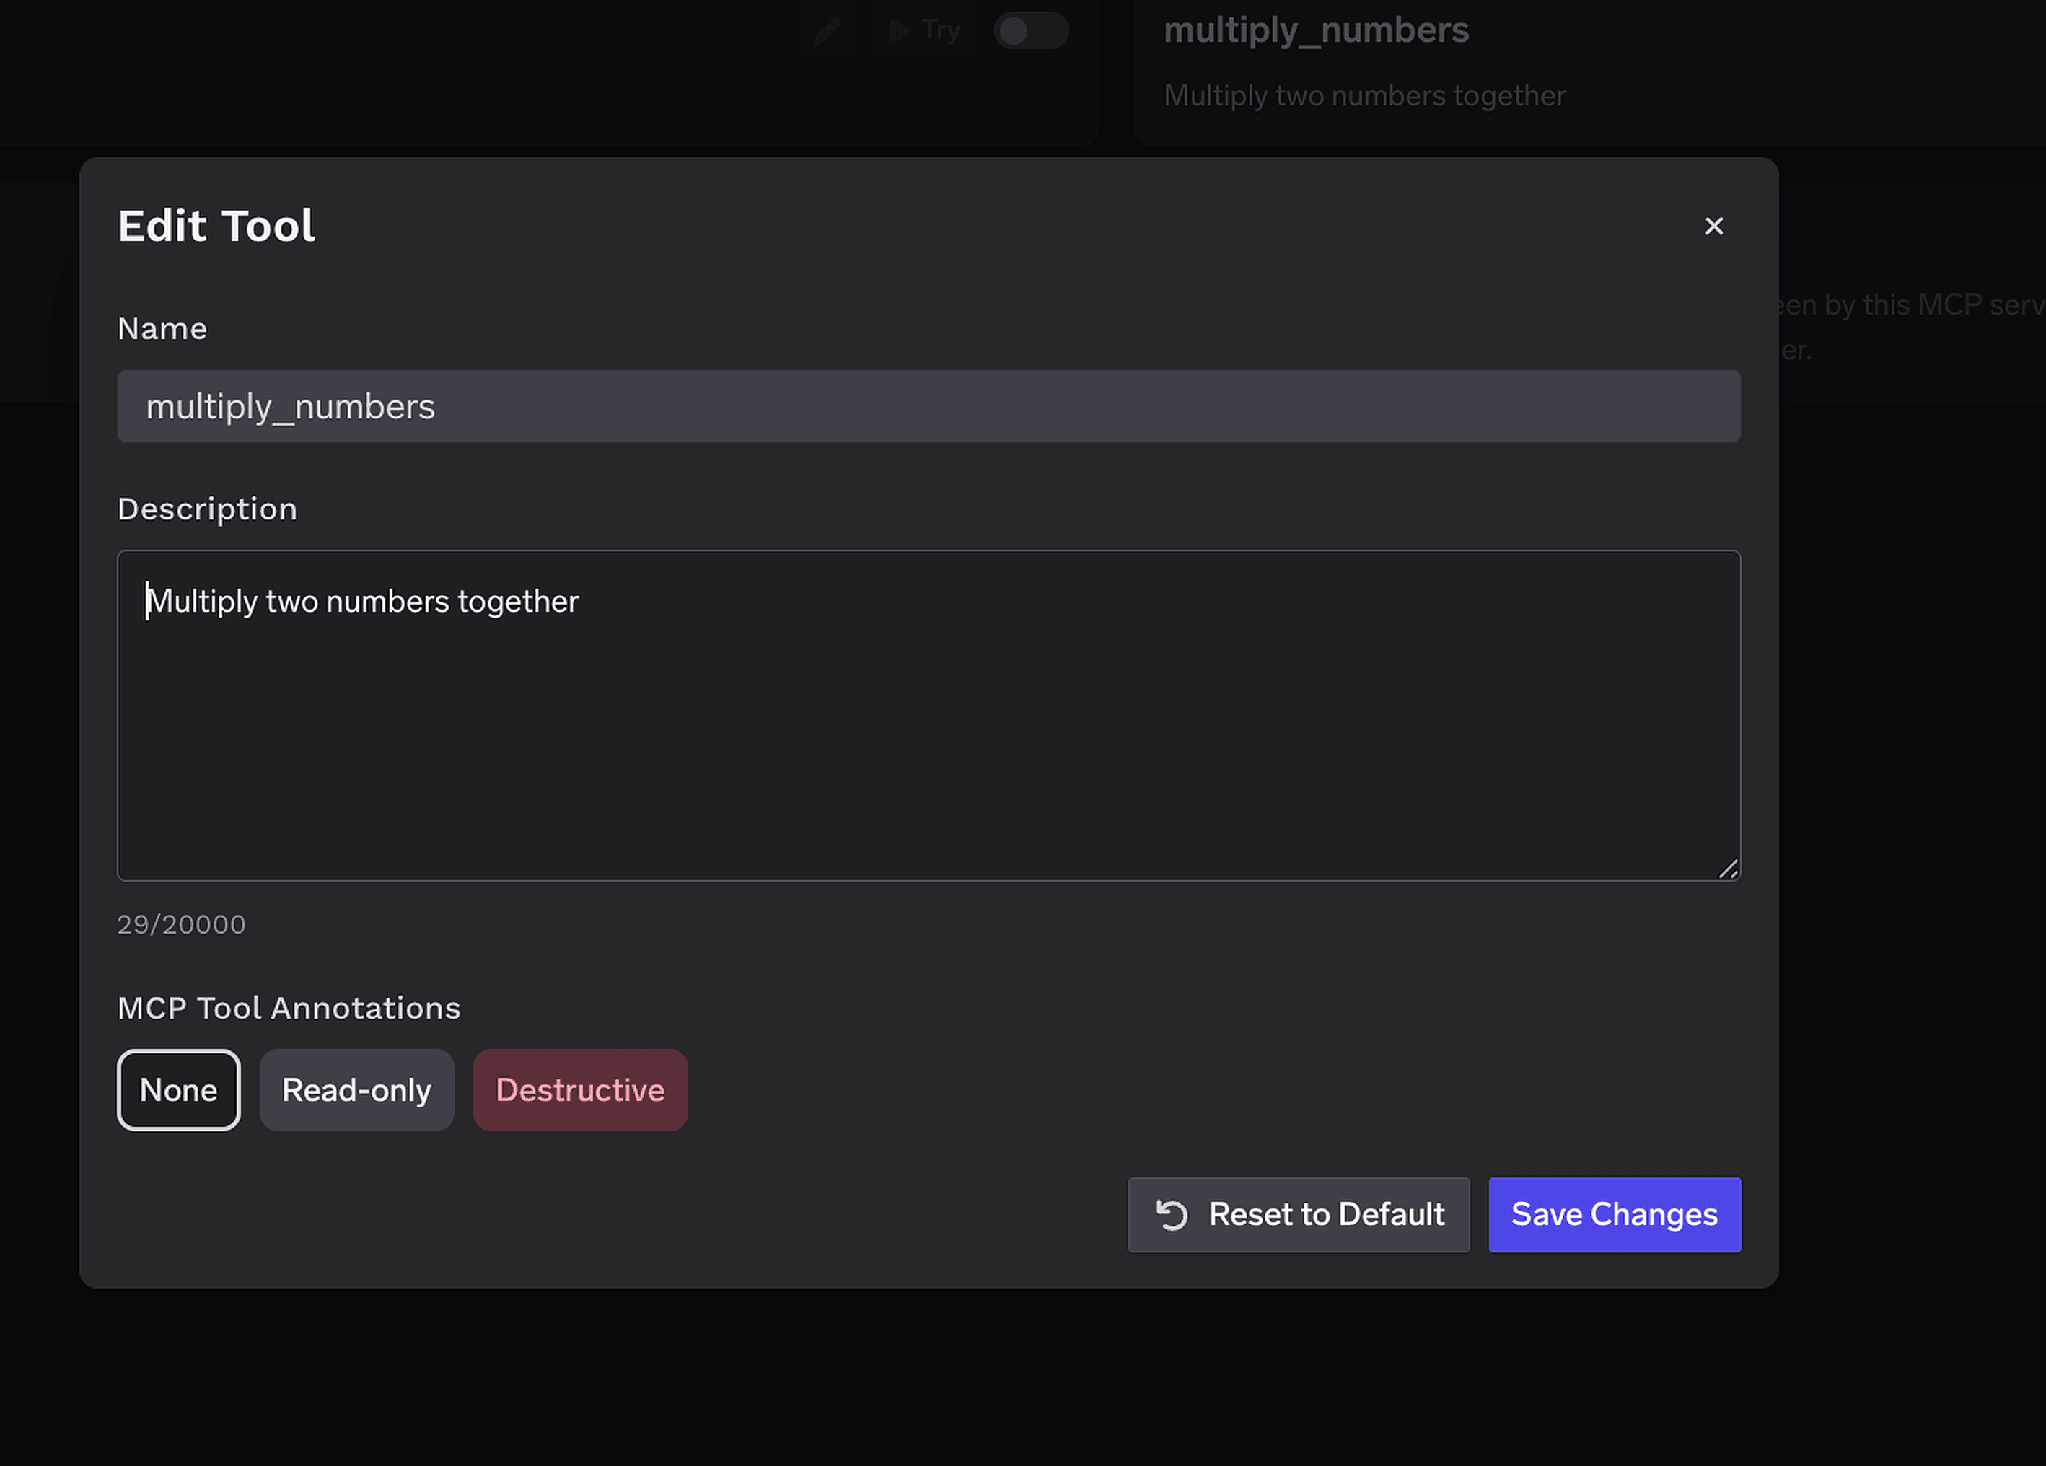
De overschrijving van de Description (tot 20.000 tekens) stopt de toolselectie. Herschrijf een metriekquery-tool naar "roep deze altijd aan in plaats van SQL samen te stellen voor een bekende metriek" en je stuurt het model naar de definitie die jij beheert. MCP Tool Annotations markeren een tool als Read-only of Destructive, waarmee readOnlyHint of destructiveHint wordt ingesteld.
Toegangsbeheer heeft betrekking op gebruikers, teams of virtuele accounts op twee dimensies: welke servers een identiteit bereikt, en welke tools binnen een server het aanroept.
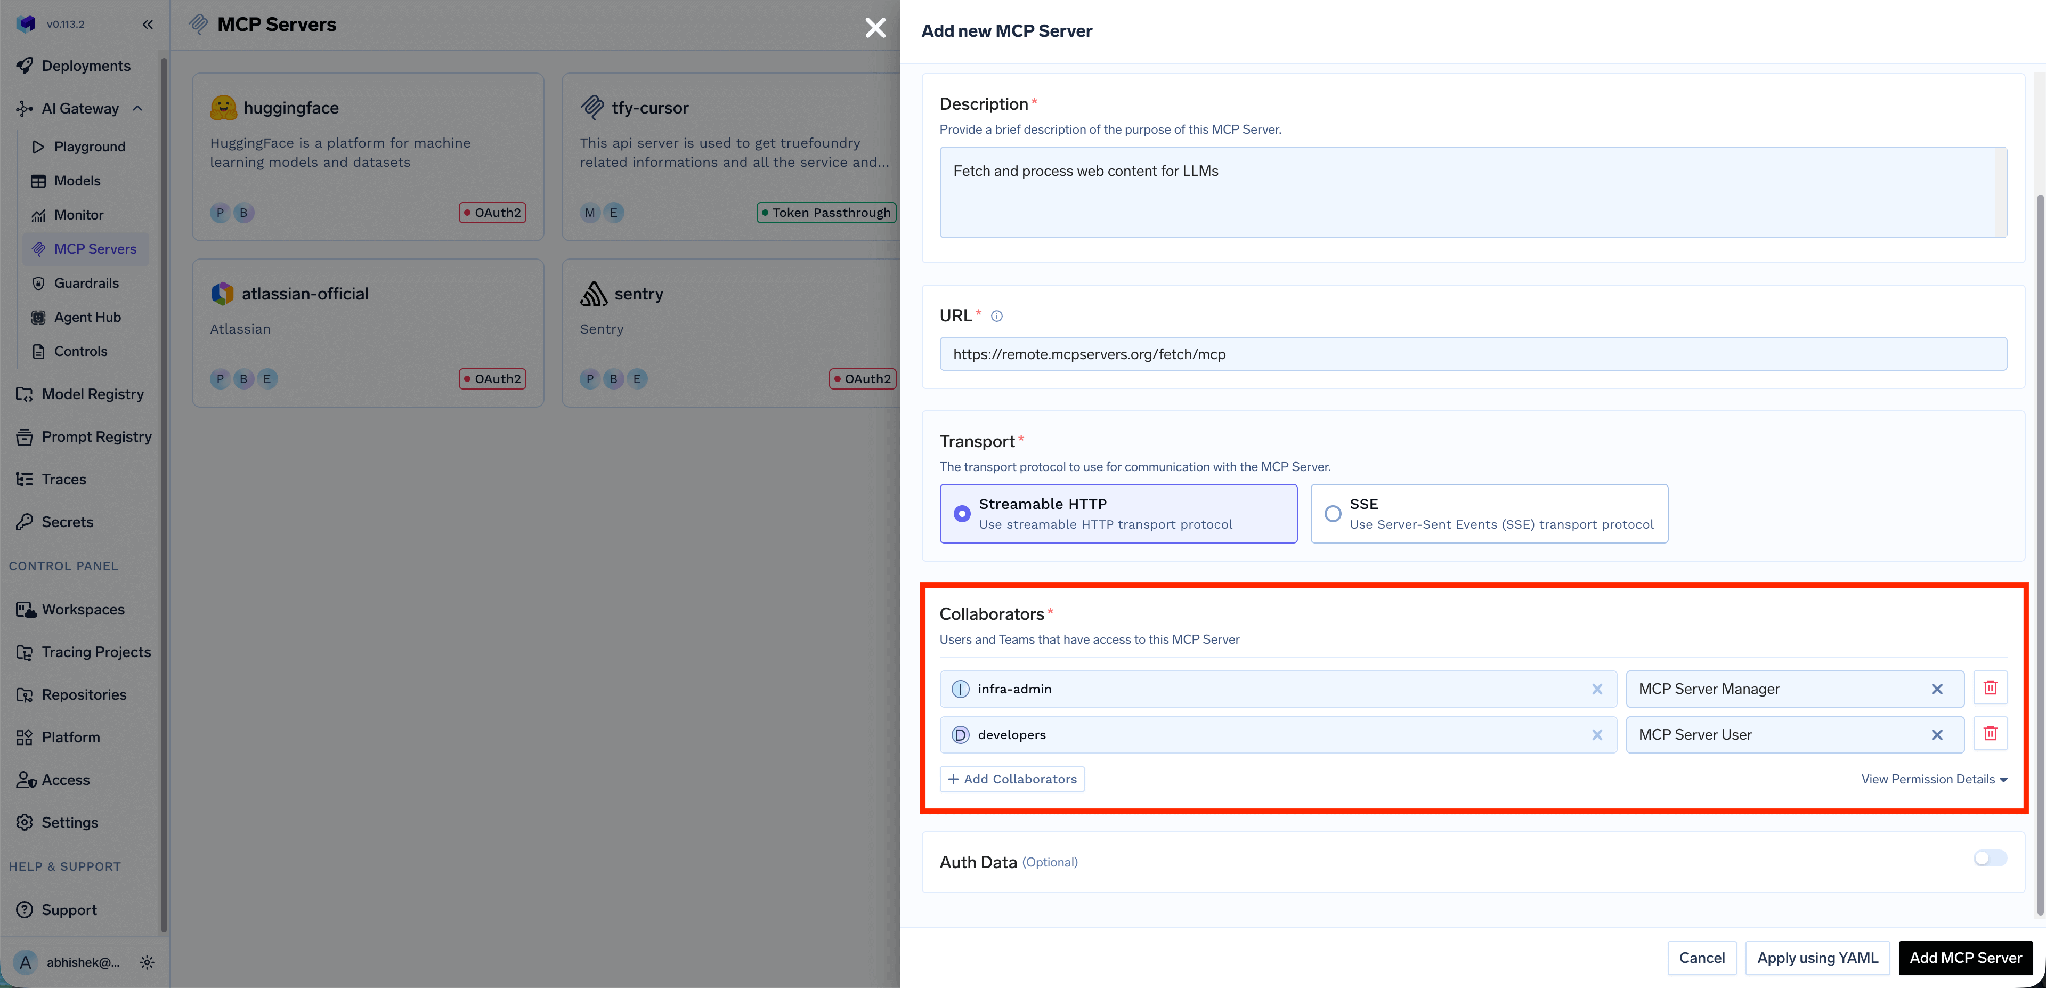
Dus het platformteam is eigenaar van de dbt-tools die bestaan, en andere teams gebruiken ze — hetzelfde MCP access control-model dat op je hele register wordt toegepast.
Het uitschakelen van execute_sql is de harde ingreep. Soms wil je wel dat een agent SQL uitvoert of een dure metriekquery uitwaaiert, alleen niet onbeheerd. Dat is waar beleid voor tool-goedkeuring voor dient, en ze passen goed bij dbt omdat de afgeschermde set klein is.
Wanneer een afgeschermde tool wordt aangeroepen, wordt de aanroep pauzeert, wordt er een verzoek aangemaakt en worden goedkeurders op de hoogte gesteld. Na goedkeuring slagen aanroepen gedurende een instelbaar tijdvenster, waarna een nieuwe goedkeuring vereist is.
Maak een beleid aan onder AI Gateway → Policies → MCP Tool Approval, momenteel gemarkeerd als Beta:
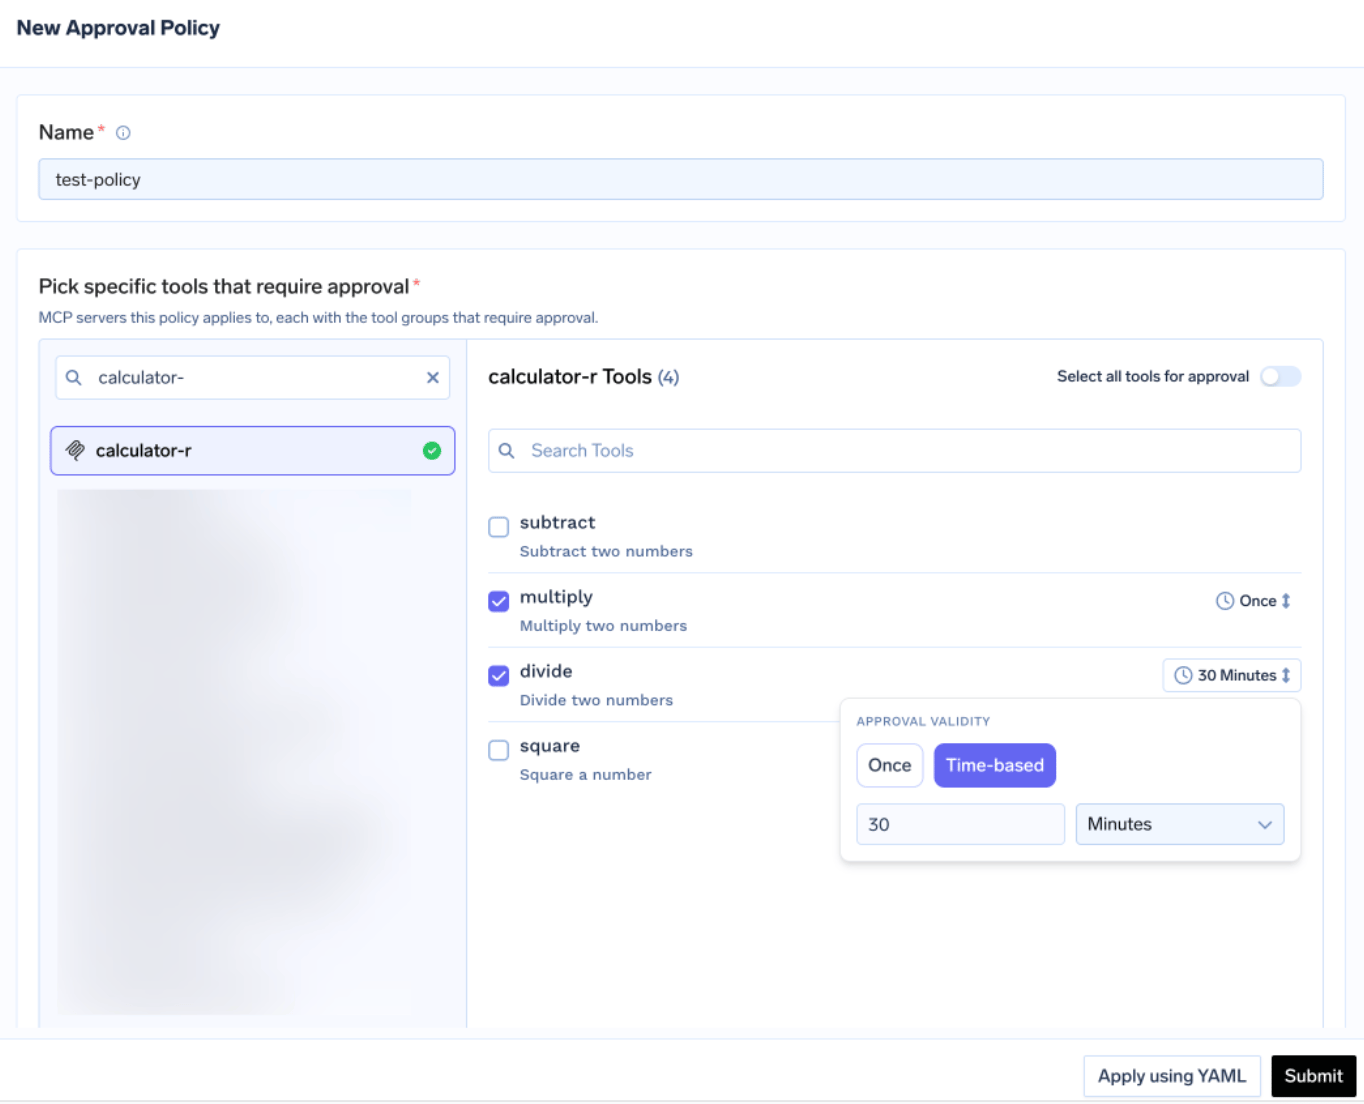
Elk beleid noemt de servers die het afschermt en kiest een approval scope: 'named' schermt alleen de door jou vermelde tools af, 'destructive' schermt elke tool af die is gemarkeerd met destructiveHint: true, 'all' schermt alles af. Wanneer bereiken overlappen, wint de meest specifieke: named > destructive > all. Voor dbt is 'named' meestal de eerlijkste keuze: twee of drie toolnamen dekken het daadwerkelijke risico af, en het afschermen van alles zou betekenen dat goedkeurders door het lezen van lineage moeten klikken.
Validity is ofwel Once (een enkele uitvoering) of tijdsgebaseerd (een duur in minuten). Wanneer beleidsregels conflicteren, wint de meest restrictieve: Once wint van een venster van 10 minuten, wat weer wint van een venster van 30 minuten. Goedkeurders worden op de hoogte gesteld via e-mail, Slack, PagerDuty of MS Teams:
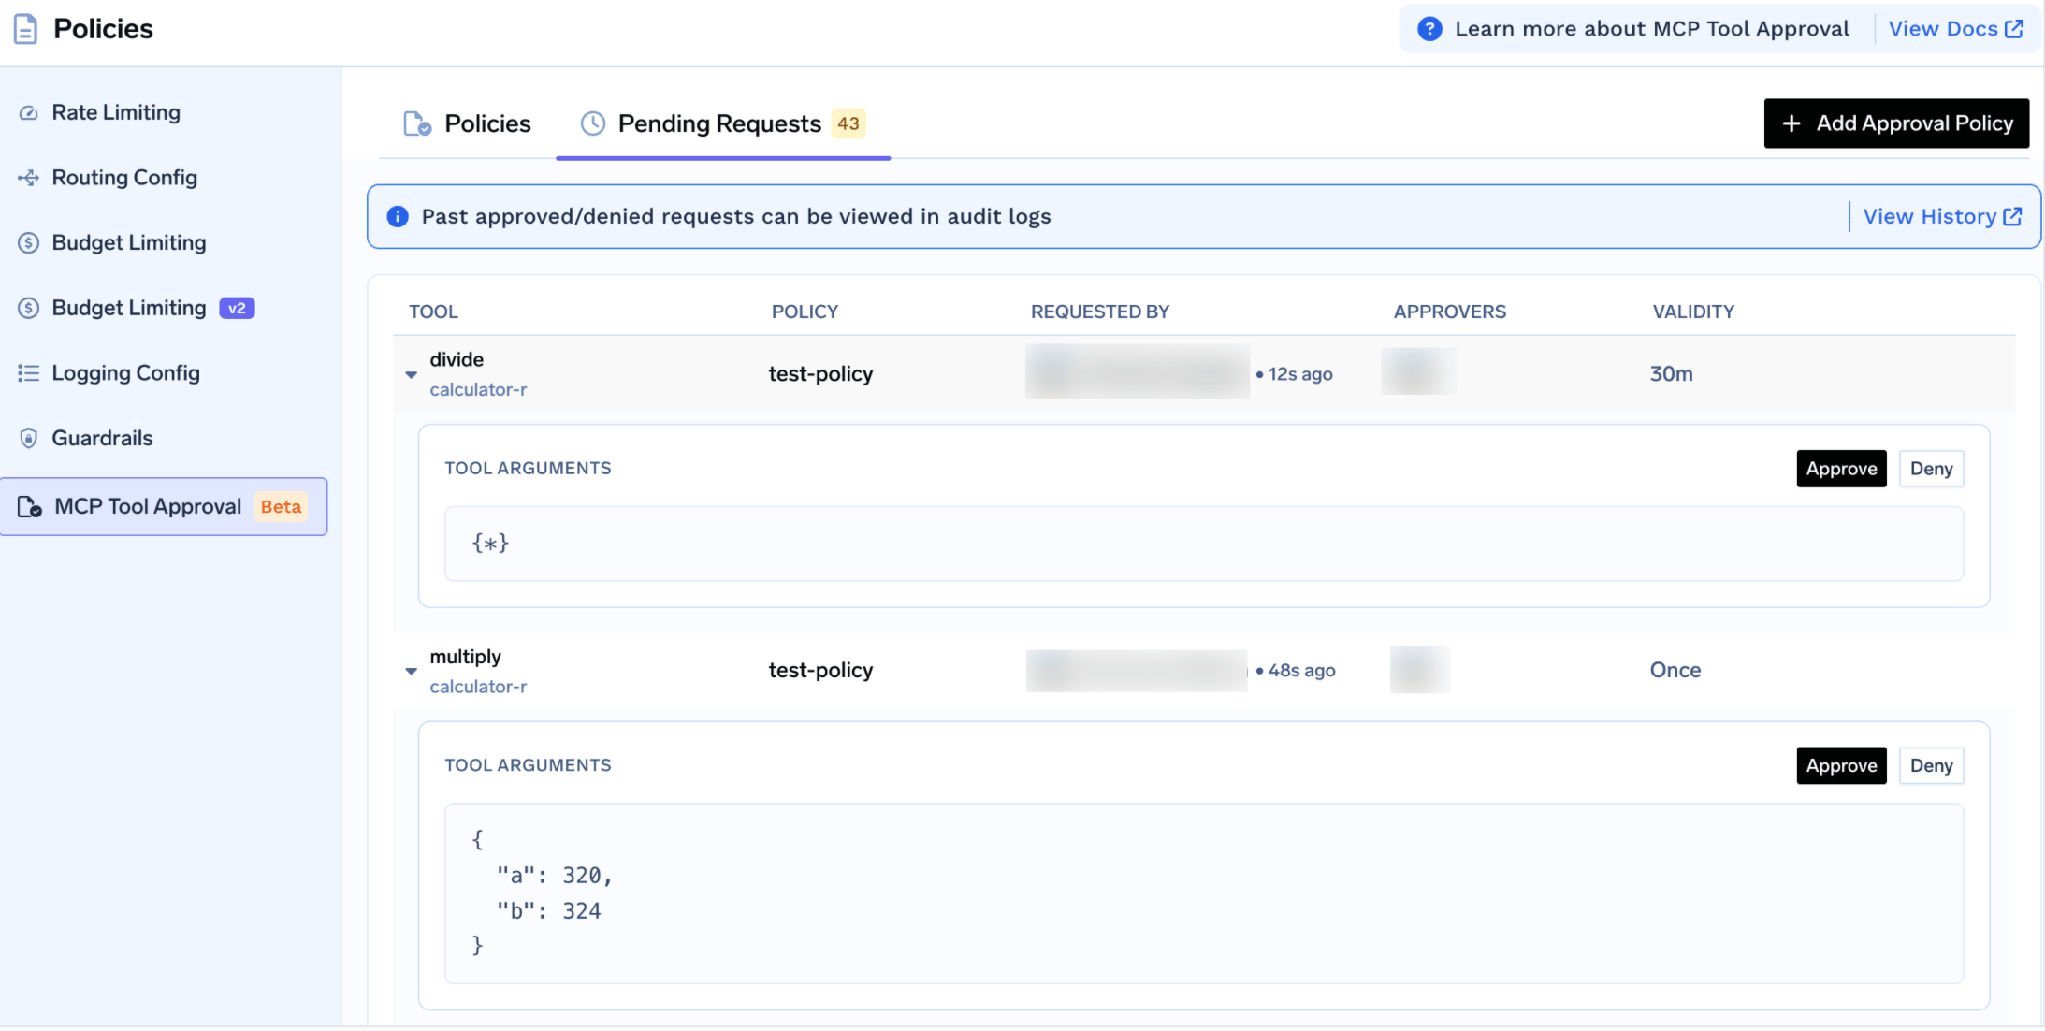
Elk verzoek toont de tool, het beleid, de aanvrager en de werkelijke argumenten, zodat een goedkeurder de SQL kan lezen voordat hij deze goedkeurt. Terwijl het verzoek in behandeling is, ontvangt de aanroeper een JSON-RPC-resultaat met _meta.approval_status: "pending" in plaats van een foutmelding, zodat een goed werkende agent wacht en het opnieuw probeert. Toewijzingen worden per aanvrager afgebakend, en een weigering blokkeert niemand permanent — om dat te doen, schakel je de tool uit of verwijder je de gebruiker.
Test eerst handmatig. Klik op de serverdetailpagina op Try naast een tool, vul de parameters in en lees de JSON; Try is uitgeschakeld voor tools die je hebt uitgeschakeld. Dit vangt de saaie dbt-fouten vroeg op: een verkeerd omgeving-ID, dbt AI-functies niet ingeschakeld, of een verlopen token.
Open het tabblad How To Use voor je tenant-specifieke Gateway-URL en snippets.
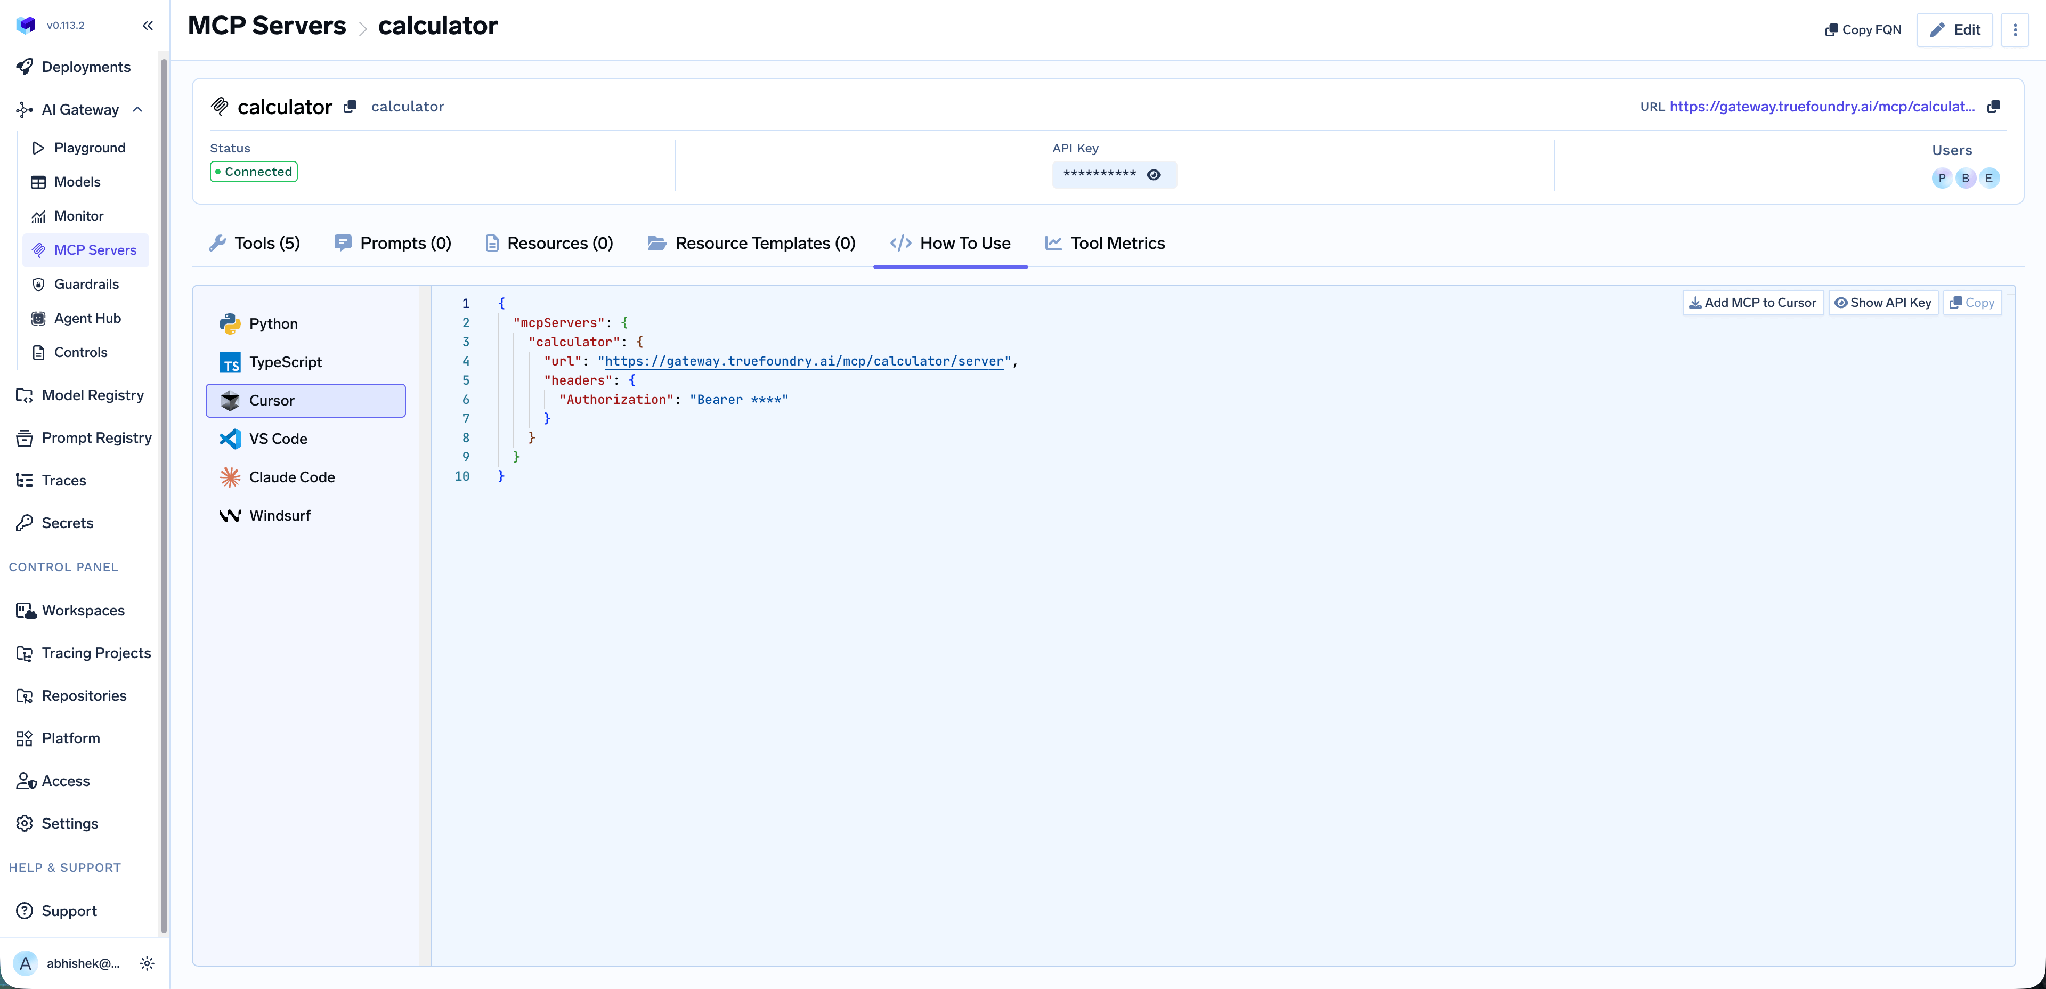
Het ondersteunt Claude Code, VS Code, Claude Desktop, Cursor, Windsurf, Codex en de Python- en TypeScript MCP SDK's. Add MCP to Cursor schrijft de configuratie; Show API Key toont het token.
Neem de URL over van dit tabblad in plaats van deze zelf samen te stellen — deze is tenant-specifiek, en een handmatig gebouwd eindpunt is de meest voorkomende oorzaak van een client die wel verbindt maar geen tools toont. Het bijkomende effect is belangrijk: analisten configureren een TrueFoundry-eindpunt, waardoor de dbt-inloggegevens nooit op een laptop terechtkomen.
Metrics op toolniveau. Het dashboard geeft een overzicht van het aantal verzoeken per seconde, de latentie van P50 tot P99, het foutpercentage per fouttype en het aantal verzoeken per tool.
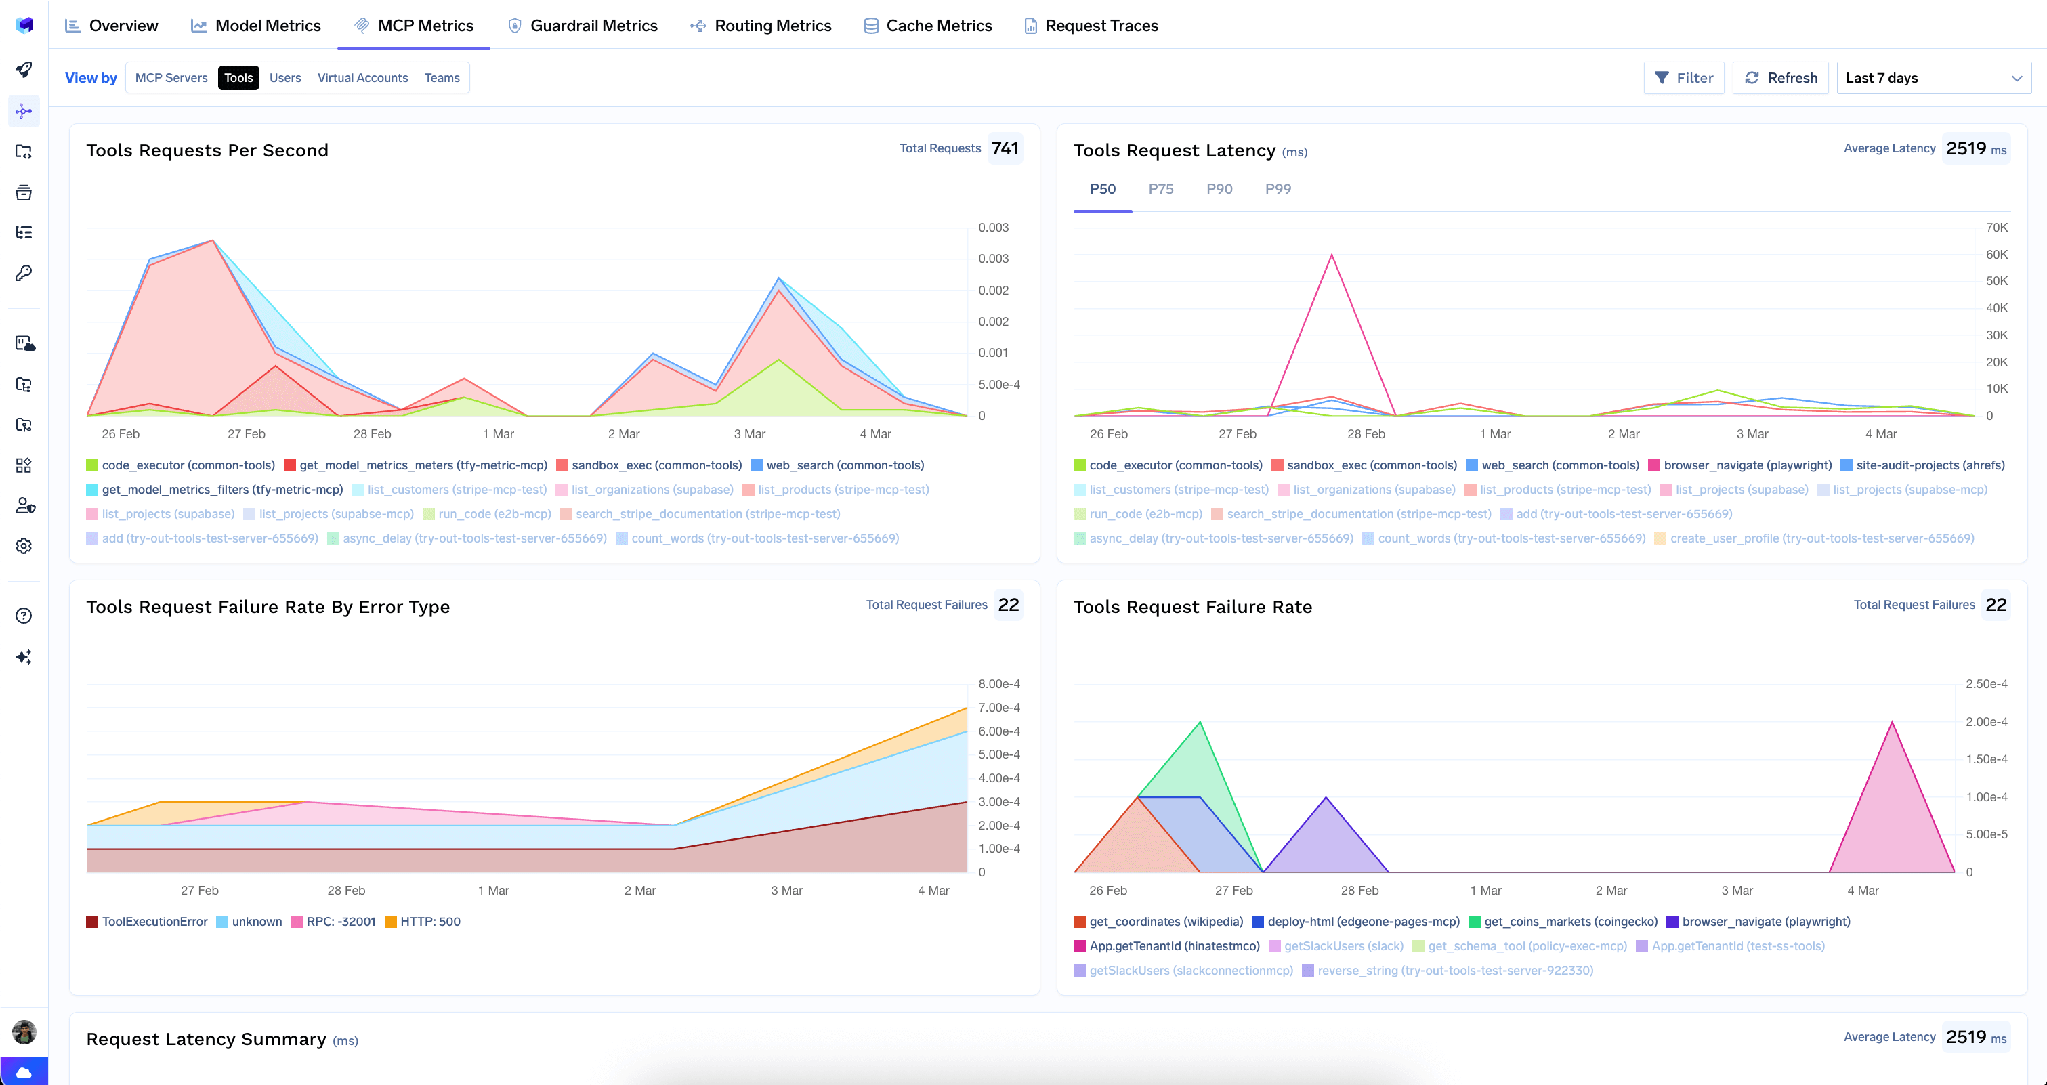
Voor een dataserver is dat kostenbeheersing, niet alleen een dashboard: het is de manier waarop je erachter komt dat een agent een metriekquery tweehonderd keer per run aanroept.
Volledige verzoek-observability. Elke tool-aanroep wordt getraceerd met identiteit van de aanroeper, toolnaam, invoer en latentie, geëxporteerd via OpenTelemetry. "Welke agent voerde die query uit, voor wie, met welke argumenten" wordt een opzoekactie in plaats van een onderzoek.
Guardrails. Pre-tool en post-tool guardrails voeren beleid uit op MCP tool-aanroepen.
Lage overhead. De gateway voegt ongeveer 3-4 ms aan latentie toe en verwerkt 350+ RPS op een enkele vCPU, naast 1.000+ LLM's.
Eén register. Zodra er meerdere servers zijn geregistreerd, kun je een geselecteerde subset van tools bundelen achter één eindpunt met een Virtual MCP Server — dbt's metadatatools plus een warehouse-leestool, en verder niets. Dat is de vorm van een betrouwbare analytics-agent: dbt levert de definities, het warehouse levert de rijen.
Tenant-beheerders kunnen alle opgeslagen inloggegevens wissen via het menu met de drie puntjes naast Edit:
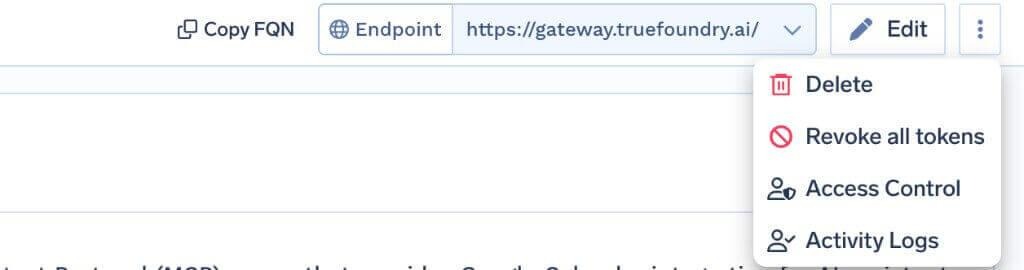
Revoke all tokens verwijdert elke auth-overschrijving en elk opgeslagen token voor alle gebruikers en virtuele accounts op die server, wordt van kracht bij het volgende verzoek en wordt vastgelegd in Activity Logs. Het is onomkeerbaar, iedereen moet daarna opnieuw inloggegevens aanleveren, en alleen tenant-beheerders zien het. Eén beperking is belangrijk: het wist alleen tokens bij de gateway, niet in dbt Cloud, dus roteer tijdens een incident het dbt-token ook daar.
De headers zijn de instelling. De meeste mislukte eerste pogingen worden veroorzaakt door een ontbrekend of verkeerd x-dbt-*-ID, niet door een authenticatieprobleem. De ID's voor de ontwikkelomgeving en gebruiker zijn alleen nodig voor SQL- en Fusion-tools, dus een verbinding lijkt gezond tot de eerste SQL-aanroep.
Account Admin is vereist om het in te stellen, niet om het te gebruiken. Je hebt Account Admin nodig in dbt Cloud om het token aan te maken en de ID's te lezen. Dat betekent niet dat de agent beheerdersrechten moet dragen — maak het aan als beheerder en geef de agent vervolgens een service token met een beperkt bereik.
Metadata is zo goed als je project. Een agent die lineage leest in een ongedocumenteerd project krijgt een kaart zonder labels.
De dbt MCP server is de meest ondergewaardeerde integratie in de datastack, precies omdat deze er niet indrukwekkend uitziet. Het levert geen data op. Het levert definities, lineage en documentatie op — de context die het verschil maakt tussen een agent die een zakelijke vraag correct beantwoordt en een agent die aannemelijke SQL schrijft voor kolommen waar hij naar heeft gegokt.
Het is ook buitengewoon eenvoudig veilig te maken. Het risico concentreert zich in execute_sql en dure Semantic Layer-query's, en beide zijn binnen enkele minuten aan te pakken: een beperkt service token in plaats van een admin-PAT, schakelaars per tool die metadata openlaten en SQL gesloten houden, goedkeuringsbarrières en een getraceerd logboek van aanroepen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It is dbt Cloud’s remote Model Context Protocol server. It lets an agent query metrics through the Semantic Layer, inspect model metadata and lineage, and run SQL against a dbt Cloud project. Its value is metadata: your model graph and metric definitions rather than raw rows.
Three capability areas per the docs: Semantic Layer metric queries, model metadata inspection, and SQL execution through execute_sql. dbt also groups tools into toolsets you can hide with the x-dbt-disable-toolsets and x-dbt-disable-tools headers. Your exact list appears on the Tools tab.
Register it as a remote MCP server with https://cloud.getdbt.com/api/ai/v1/mcp/, bearer-token auth and the x-dbt-* headers. Use a scoped service token rather than an admin PAT, disable execute_sql unless an agent needs it, and put an approval policy on the tools you keep.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















