



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Claude in productie faalt in de praktijk stilzwijgend op twee manieren: de factuur loopt op om redenen die geen enkel dashboard verklaart, en een slechte respons is achteraf onmogelijk te reconstrueren. Beide zijn observability-lacunes, en beide hebben een Claude-specifieke addertje onder het gras. De kosten-lacune is specifiek omdat het tokengebruik van Claude geen enkel cijfer is — het splitst zich in normale input, cache writes en cache reads, elk anders geprijsd — dus een naïeve tokentelling levert een getal op dat niet overeenkomt met de factuur. De debugging-lacune is specifiek omdat de interessante fouten (een weigering, een tool-fout, een cache die stilzwijgend stopte met hits genereren) vaak niets achterlaten in de application logs.
Dit artikel gaat over het dichten van beide lacunes: waar je rekening mee moet houden in het tokengebruik van Claude, wat je moet trace'en en hoe je volledige dekking krijgt bij de gateway in plaats van elke service handmatig te instrumenteren. De details van de gebruiksvelden zijn afkomstig uit de documentatie van Anthropic, vanaf oktober 2026.
Het eerste dat je goed moet hebben, is dat "input-tokens" bij Claude drie getallen zijn die elk iets anders kosten.
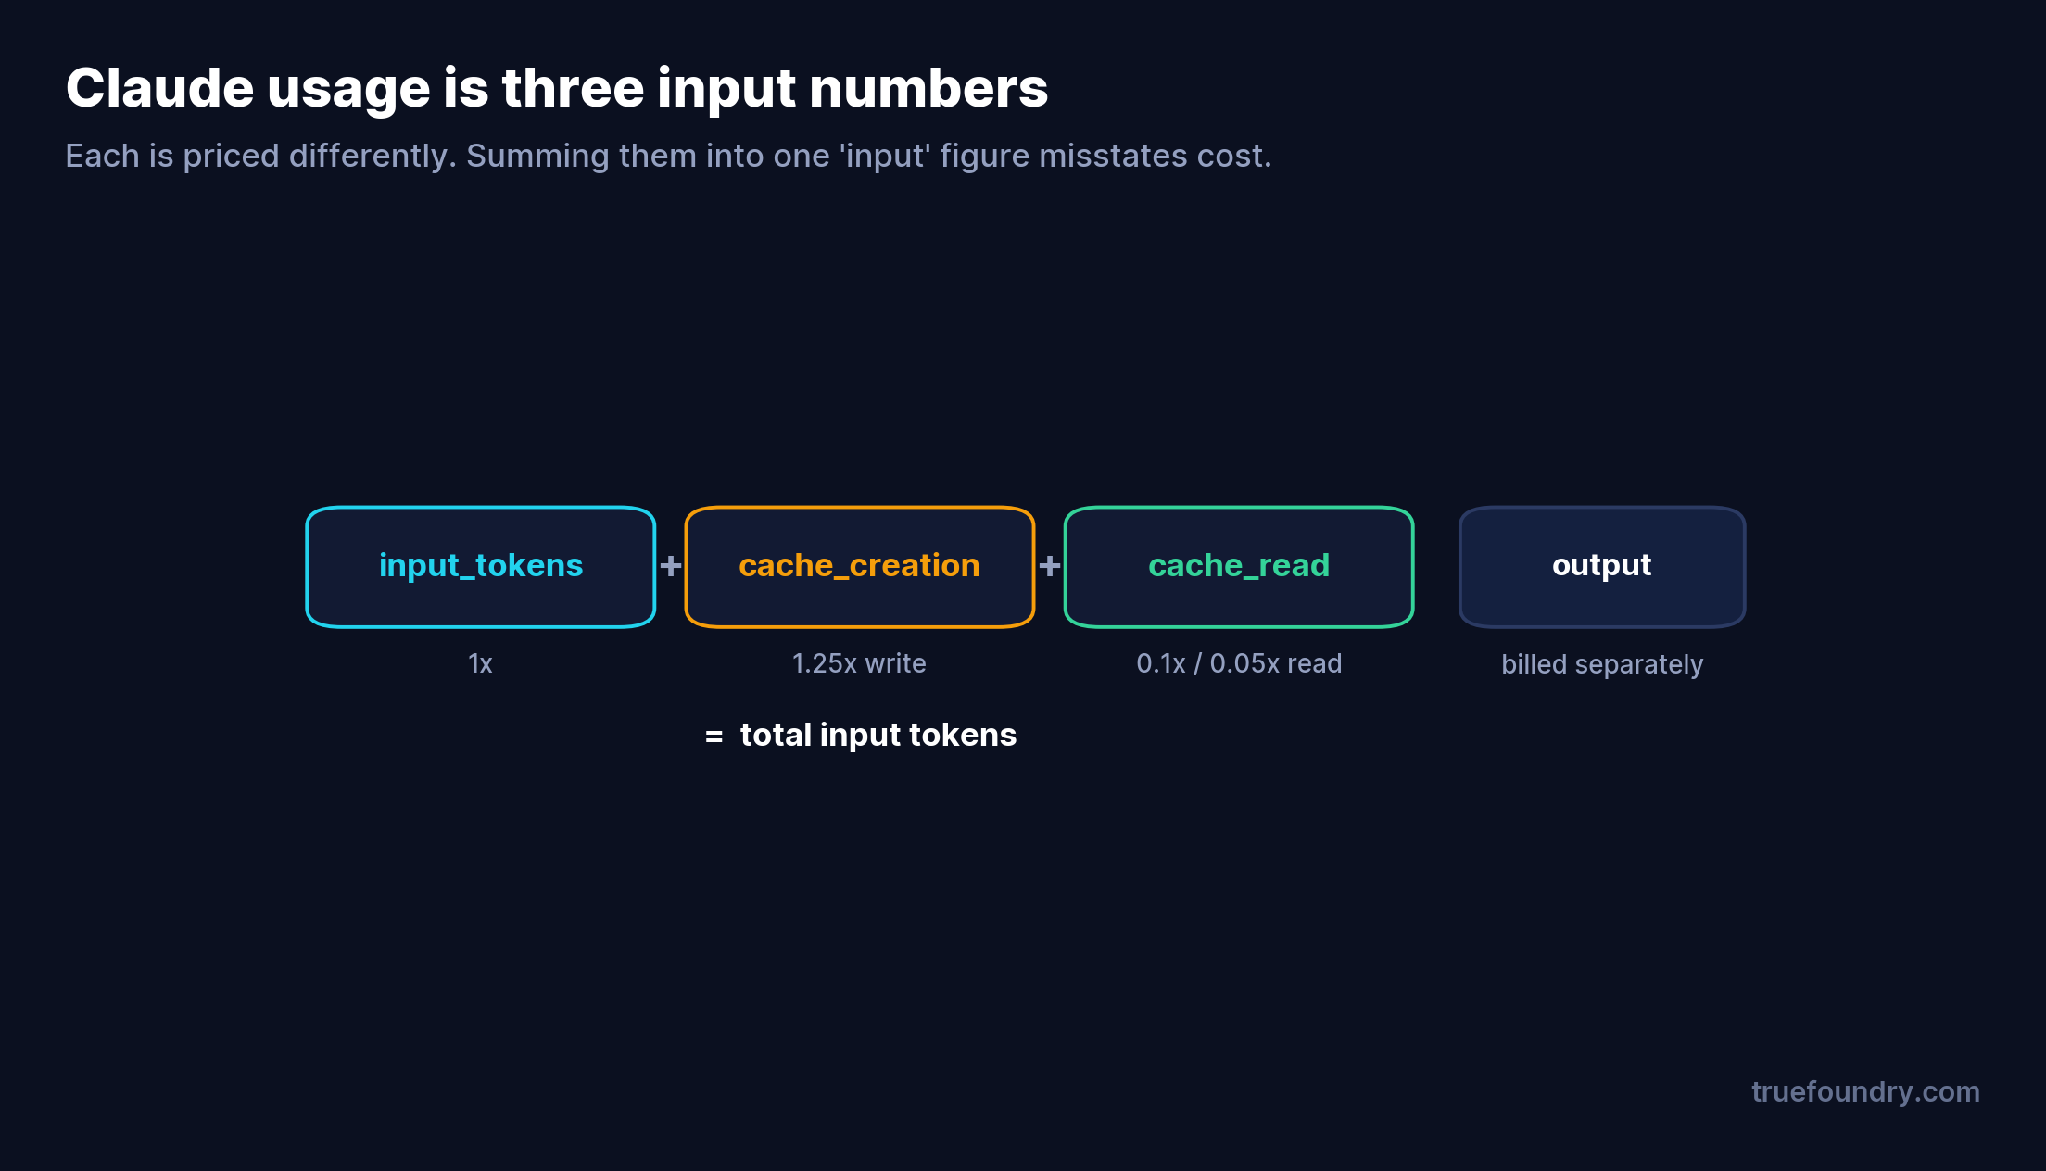
Elke Claude-respons rapporteert input_tokens, cache_creation_input_tokens en cache_read_input_tokens, en de werkelijke totale input is de som van alle drie. Ze zijn niet inwisselbaar wat betreft kosten: een normale input-token is 1x, een cache write is 1,25x (2x voor de 1-uurs TTL), en een cache read is 0,1x — of 0,05x op Opus 5.5 en Sonnet 5.5. Twee requests met identieke totale tokentellingen kunnen dus heel anders kosten, afhankelijk van hoe die tokens zijn verdeeld. Een boekhoudsysteem dat alleen "input-tokens" optelt, zal zowel de uitgaven verkeerd rapporteren als het meest nuttige signaal verbergen: of je cache wordt gelezen of alleen wordt geschreven.
Dat signaal is de cache hit rate, en het is het getal dat je vertelt of prompt caching daadwerkelijk loont. Als cache_creation hoog is en cache_read bijna nul blijft, betaal je de write-premium zonder enige korting te ontvangen — een probleem dat onzichtbaar is voor alles wat input-tokens niet opsplitst in onderdelen.
Naast de token-verdeling dekt een kleine, vaste set signalen de Claude-foutmodi die er toe doen.
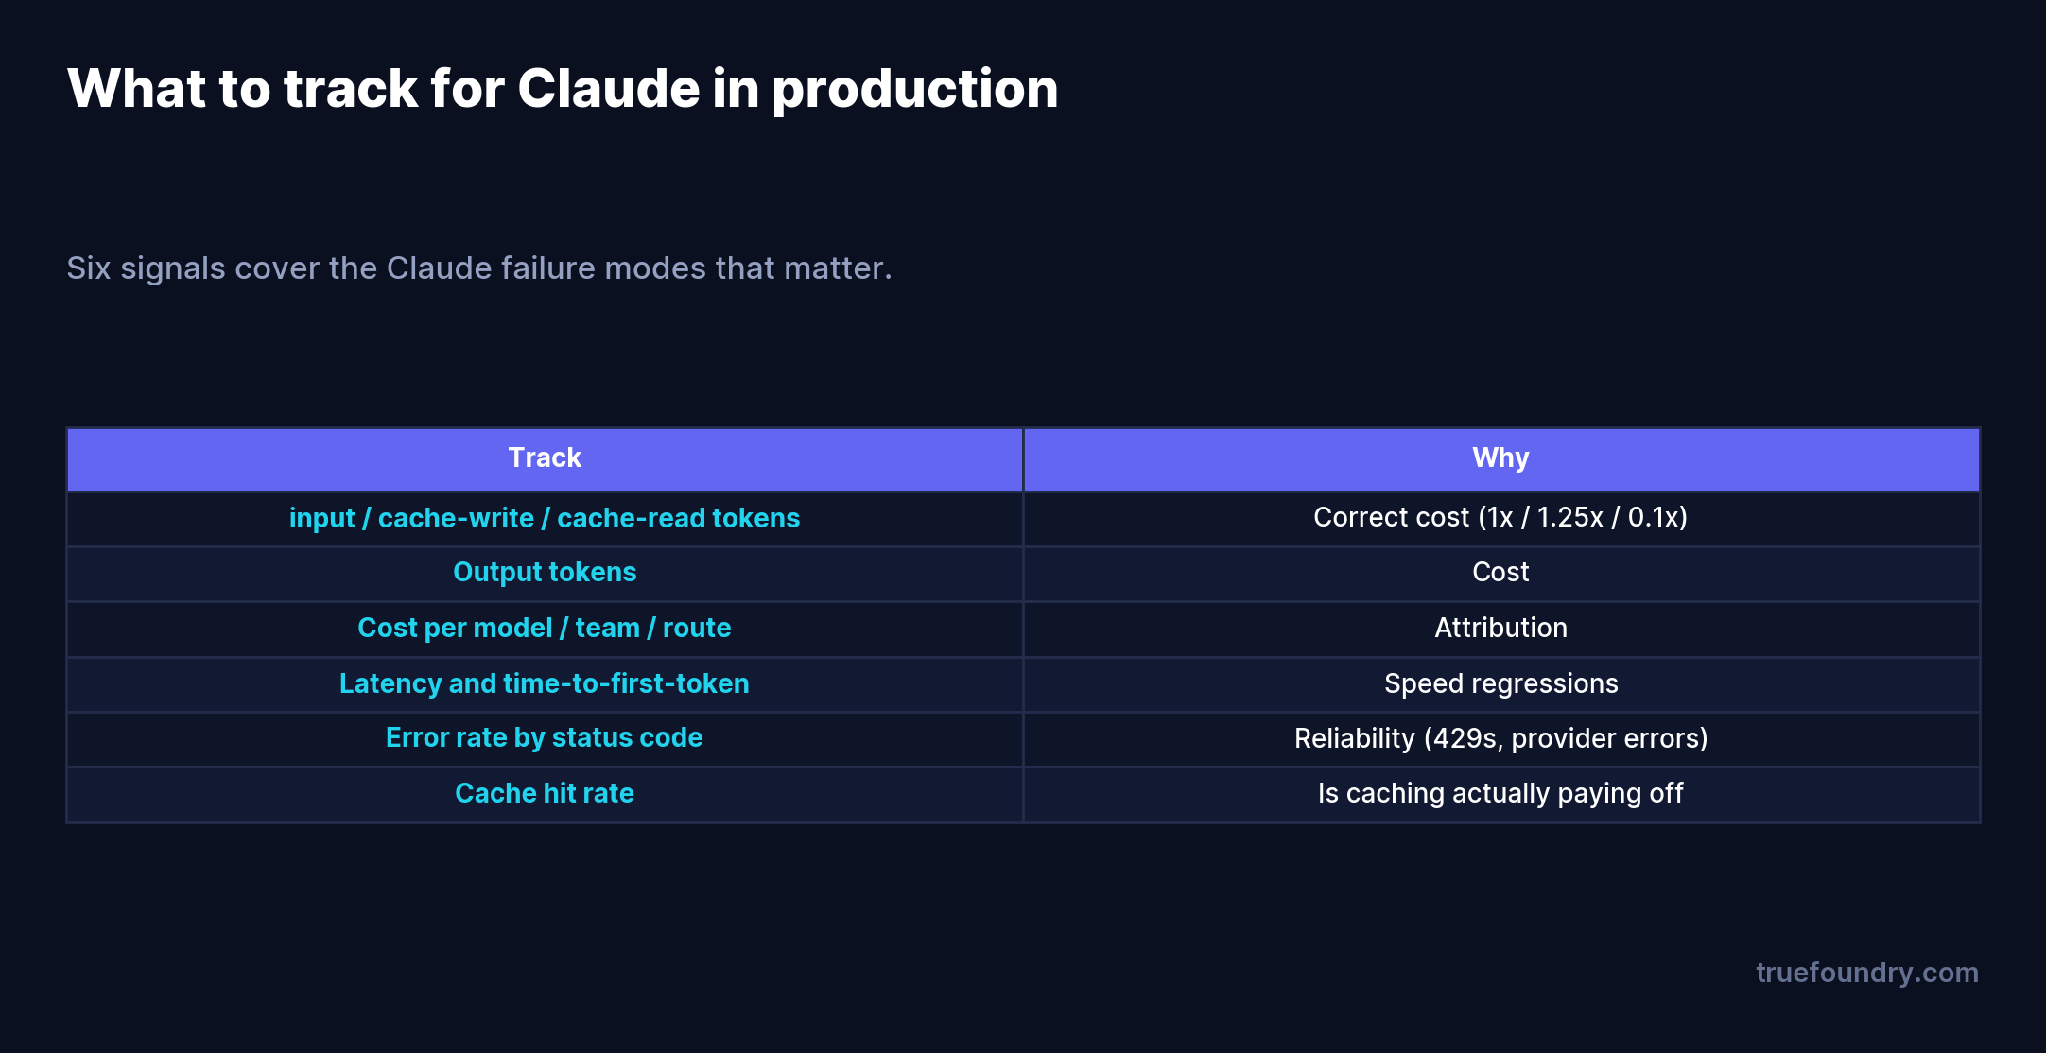
Volg, per request en geaggregeerd op model, team en route: de drie input-token-buckets plus output-tokens (voor correcte kosten), de kosten zelf, latency (en time-to-first-token voor streaming), error rate per statuscode (429's en providerfouten zijn je betrouwbaarheidssignaal), en cache hit rate (je signaal dat caching werkt). Dat is genoeg om de drie vragen te beantwoorden die er daadwerkelijk toe doen — waarom veranderden de kosten, waarom is dit traag, en waarom is dit request mislukt — zonder te verdrinken in metrics die niemand leest.
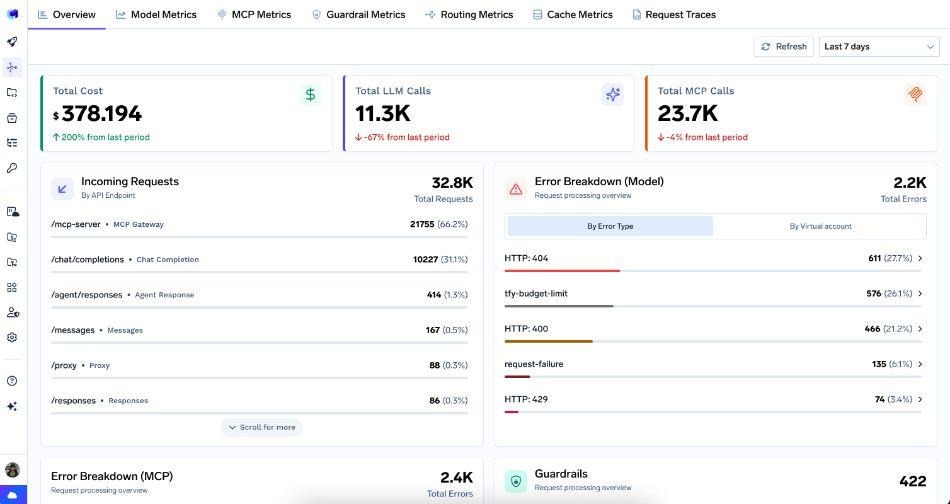
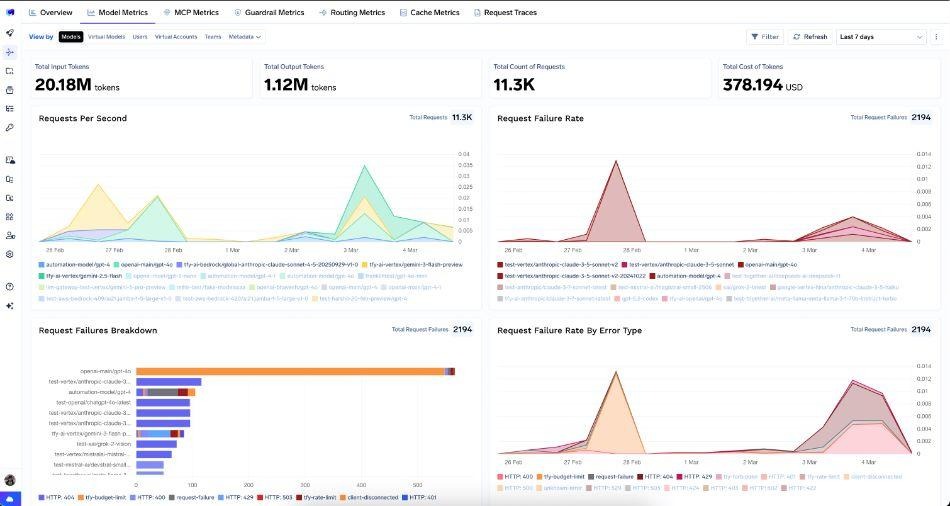
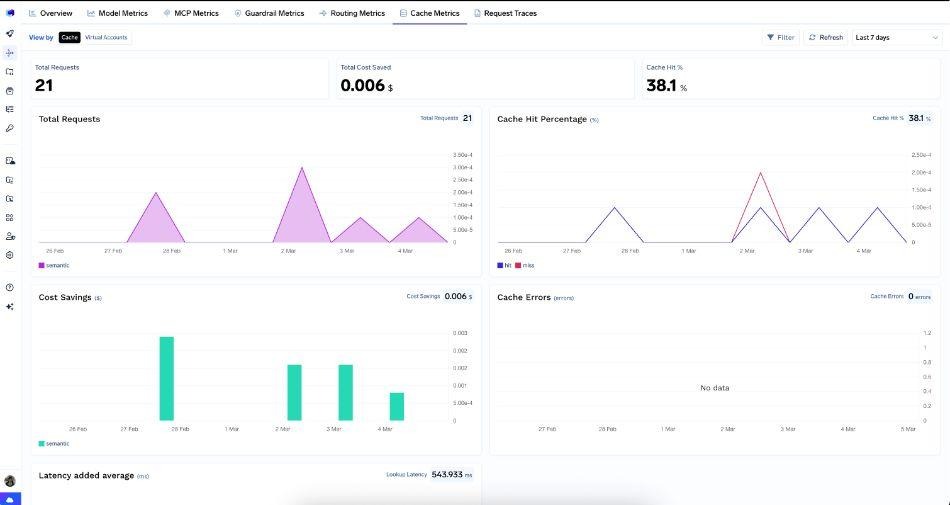
Metrics vertellen je dat er iets veranderde; traces vertellen je wat er gebeurde met een specifiek request. Voor Claude zijn de traces die de moeite waard zijn degene die application logging de neiging heeft te missen: een request dat werd geweigerd, een tool-call die een fout gaf, een guardrail die de prompt blokkeerde, of een request dat terugviel op een ander model. Als je instrumentatie zich in de applicatie bevindt en alleen succesvolle completions logt, laten die gevallen geen sporen achter — en het zijn precies de gevallen waarvoor je wordt opgepiept.
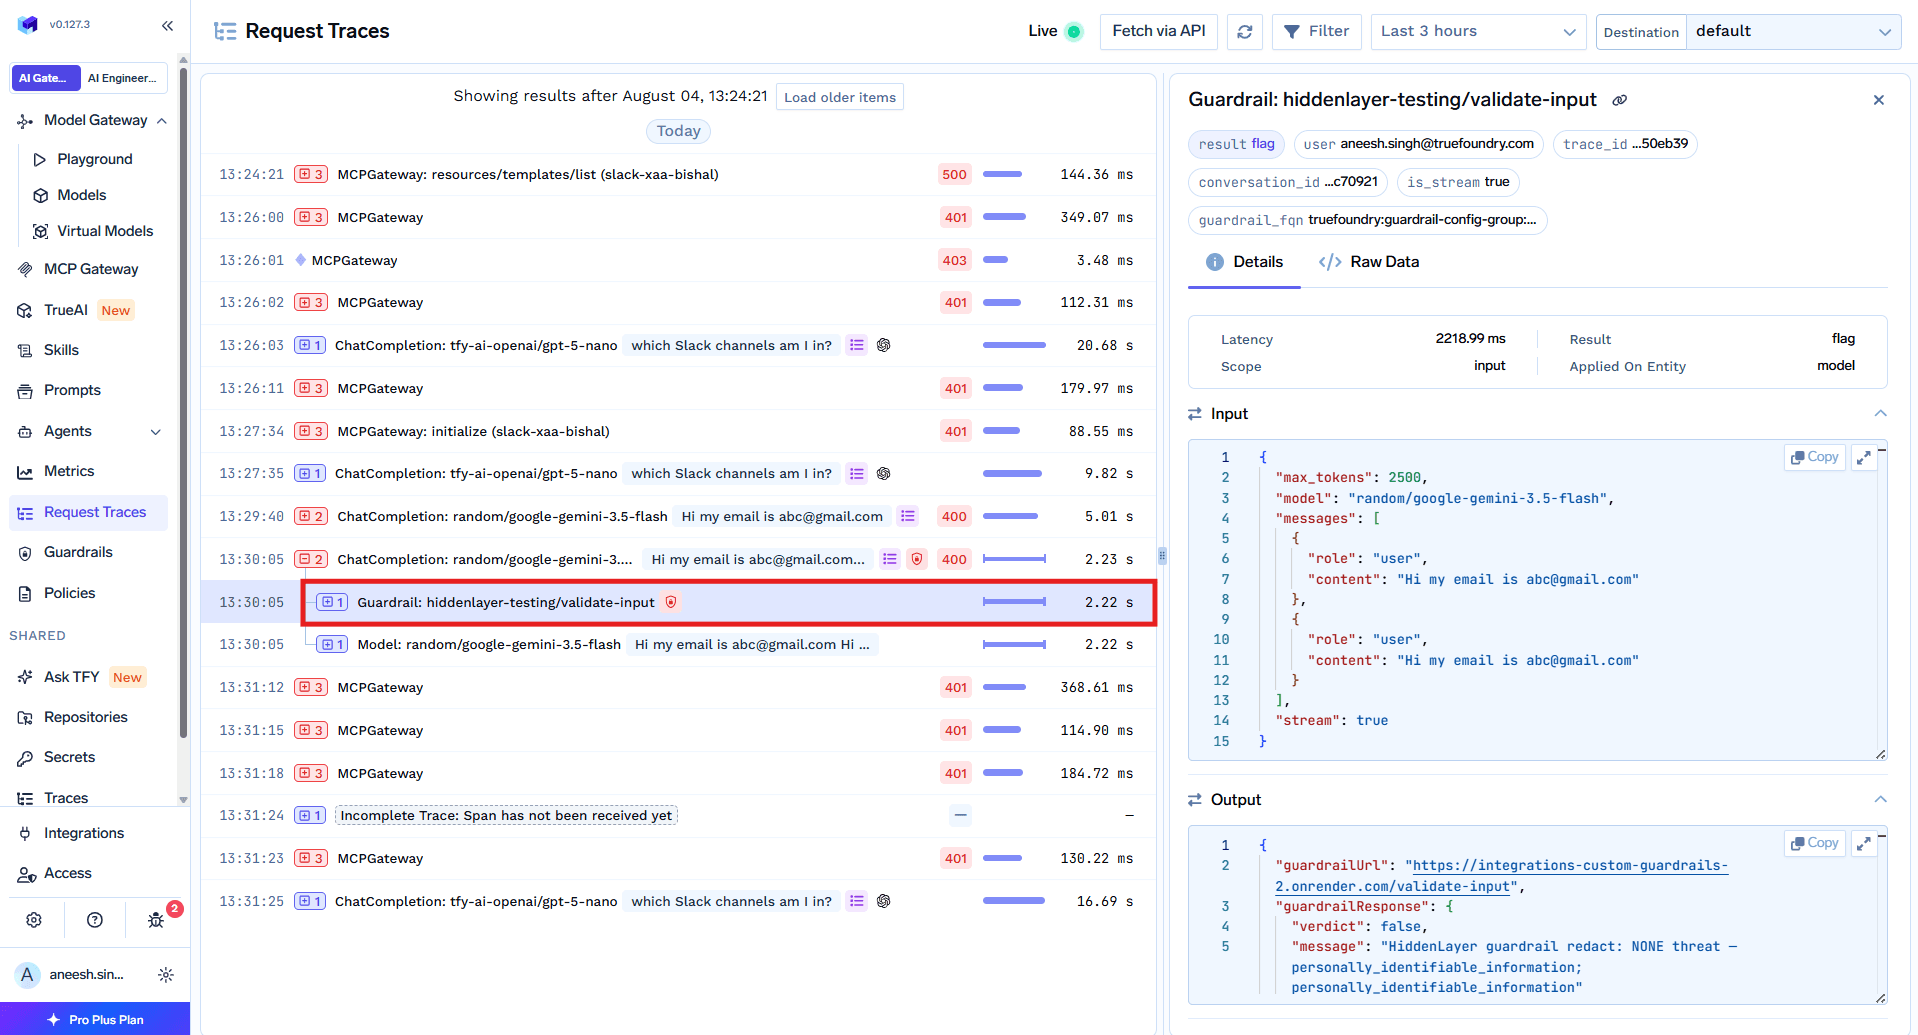
Een trace moet het volledige verhaal van de call bevatten: welk model deze heeft bediend (na eventuele fallback), de token-verdeling, de latency van elke stap, elk guardrail- of tool-resultaat, en de uiteindelijke status — inclusief weigeringen en fouten. Daarmee is het reconstrueren van "waarom kreeg deze gebruiker dit antwoord" een kwestie van het lezen van een trace, in plaats van gissen op basis van gedeeltelijke logs.
De reden waarom observability een project wordt, is dekking: een SDK in elke service, gaten door het team dat het is vergeten, en helemaal niets voor geweigerde requests. Het routen van Claude via een gateway neemt dat weg, omdat elk request door één plek gaat en wordt geregistreerd als een side-effect — kosten, de token-verdeling, latency, fouten, cache-resultaten en guardrail-resultaten, voor elke call, zonder instrumentatie per service.
Dat betekent geen tweede monitoringstack. Als je al Datadog, Grafana of iets dergelijks gebruikt, moet de gateway exporteren in plaats van vervangen: Claude-traces en -metrics via OpenTelemetry naar de tools die je al gebruikt. Je krijgt een volledige, Claude-bewuste dekking bij de gateway en behoudt je bestaande dashboards en alerts.
Ze tellen "input-tokens" op en noemen het kosten. Claude-input splitst zich in normaal, cache-write en cache-read op 1x, 1,25x en 0,1x. Voeg ze samen en je kostencijfer klopt niet meer en je cache-signaal is verdwenen.
Ze volgen de cache hit rate niet. Zonder deze metric kun je een werkende cache niet onderscheiden van een cache die bij elk request schrijft en nooit leest. Het is de meest waardevolle Claude-specifieke metric.
Ze loggen alleen succesvolle calls. Weigeringen, fouten, blokkades en fallbacks zijn de requests die je moet debuggen. Leg ze vast — dat is waarom tracing aan de gateway-zijde beter is dan logging aan de applicatiezijde.
Ze bouwen een parallelle monitoringstack. Die heb je niet nodig. Exporteer Claude-telemetrie via OpenTelemetry naar de observability-tools die je al gebruikt.
Observability voor Claude is gewoon van vorm en specifiek in detail. De vorm is het gebruikelijke trio — kosten, latency, fouten — plus tracing. Het detail is dat de input-tokens van Claude drie anders geprijsde getallen zijn, en als je ze niet afzonderlijk administreert, kloppen je kosten niet en is je cache-signaal onzichtbaar. Voeg de cache hit rate toe aan het dashboard, trace zowel de fouten als de successen, en je kunt beantwoorden waarom de factuur veranderde, waarom iets traag was en waarom een request is mislukt.
Doe het bij de gateway zodat de dekking compleet is zonder elke service te instrumenteren, en exporteer naar de stack die je al gebruikt zodat je er niet twee hoeft te onderhouden. Dan stopt Claude in productie een black box te zijn met een oplopende factuur.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.


Tel de drie inputcategorieen apart op: input_tokens (1x), cache_creation_input_tokens (1,25x, of 2x voor de TTL van 1 uur), en cache_read_input_tokens (0,1x, of 0,05x op Opus 5.5 en Sonnet 5.5), plus outputtokens. Ze samenvoegen tot één 'input'-cijfer geeft een verkeerd beeld van de kosten.
Cache-hitrate, naast kosten en foutpercentage. Het is het enige signaal dat een cache die daadwerkelijk wordt gelezen onderscheidt van een die alleen de schrijfpremie betaalt.
Metrics vertellen u dat een getal bewoog; een trace reconstrueert een enkel verzoek - inclusief weigeringen, toolfouten, guardrail-blokkades, en fallbacks die applicatiezijdige logs meestal missen.
Niet als Claude via een gateway gaat. Elke aanroep wordt daar als bijeffect vastgelegd, zodat de dekking volledig is - inclusief geweigerde verzoeken - zonder instrumentatie per dienst.
Ja. Exporteer Claude-traces en -metrics via OpenTelemetry naar Datadog, Grafana, of uw huidige stack, in plaats van een aparte te draaien.



Het laatste nieuws, artikelen en bronnen in je inbox

















