



August 24, 2023
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Met de lancering van Claude Fable 5 op 9 juni 2026 biedt Anthropic ontwikkelaars nu twee niveaus van frontier-modellen: de nieuwe Mythos-klasse Fable 5 en de gevestigde Opus 4.8. Ze zijn nauw aan elkaar verwant; de waarborgen van Fable 5 kunnen terugvallen op Opus 4.8, maar ze zijn heel anders geprijsd en gepositioneerd.
In deze blog vergelijken we Fable 5 met Opus 4.8 en begrijpen we hoe je beide kiest en gebruikt zonder je stack te hoeven herschrijven.
Als je haast hebt, is hier een snelle vergelijking: Fable 5 is aanzienlijk capabeler bij lange, complexe, autonome taken en ongeveer 2x zo duur. Opus 4.8 is de betere standaardkeuze voor het meeste dagelijkse werk wanneer kosten en latency van belang zijn. De slimme zet is om te routen per taak: Fable 5 voor de moeilijke klussen, Opus 4.8 voor de rest.
Het belangrijkste verschil is de balans tussen capaciteit en kosten.
Fable 5 werd geïntroduceerd als het meest capabele, op brede schaal uitgebrachte model van Anthropic bij de lancering, met een focus op veeleisend redeneren, software engineering, wetenschappelijk onderzoek, kenniswerk en langlopende taken. Opus 4.8 werd gepositioneerd voor complexe agentische coding en enterprise-werk.
Als je kiest tussen Fable 5 en Opus 4.8, geeft Claude Fable 5 je het hoogste capaciteitsplafond, vooral voor complexe coding en langduriger autonoom werk. Claude Opus 4.8 kost minder en biedt nog steeds sterke prestaties op frontier-niveau, wat het praktischer maakt wanneer je workloads met een hoger volume moet uitvoeren of de inference-kosten onder controle wilt houden.
De documentatie van Anthropic bevestigt de context window van 1M tokens, een maximale output van 128K en de prijzen voor Fable 5.
Modelspecificaties en prijzen kunnen veranderen. Controleer de actuele documentatie van de provider voordat je een van beide modellen implementeert.
Het grootste verschil ontstaat bij moeilijkere, meerstaps coding-taken. Fable 5 scoort 11,1 punten hoger op SWE-Bench Pro en 15,9 punten hoger op FrontierCode. In de praktijk is dit voordeel van belang wanneer je het model vraagt om door een grote codebase te werken, te debuggen over meerdere bestanden, of een langere autonome taak te voltooien.
De benchmarkresultaten tonen een groter verschil bij de geciteerde coding-evaluaties. Benchmarkscores meten echter specifieke taken onder specifieke evaluatie-omstandigheden. Ze moeten niet worden beschouwd als een volledige meting van productie-routingprestaties.
Voor een enterprise-evaluatie moet je representatieve workloads testen naast de benchmarkresultaten. Meet het voltooien van taken, herpogingen, latency, tokenverbruik, de nauwkeurigheid van gestructureerde output, de betrouwbaarheid van tool-use en de mate van vereiste menselijke interventie.
Wat dit in de praktijk betekent
De conclusie: Zie de benchmarkscores niet als een eenvoudige 'winner-takes-all'-vergelijking. Het voordeel van Fable 5 is het belangrijkst wanneer de workload moeilijk en langlopend is; Opus 4.8 is logischer wanneer kosten en doorvoer belangrijker zijn.
Fable 5 kost twee keer zoveel per input- en output-token als Opus 4.8 tegen de prijzen die in deze vergelijking worden gebruikt.
Twee kostennuances zijn van belang:
Desalniettemin is Opus 4.8 tegen de helft van de prijs voor hoog-volume, eenvoudige of latency-gevoelige workloads meestal de rationele standaardkeuze.
Het verschil tussen Fable 5 en Opus 4.8 gaat niet alleen over welk model hoger scoort op een benchmark. Als je er een kiest voor productie, moet je kijken naar hoe het omgaat met het werk dat je het daadwerkelijk geeft.
Beide modellen kunnen complexe prompts aan, maar de belangrijke vraag is hoe ze omgaan met problemen die meerdere beslissingen vereisen voordat een antwoord wordt bereikt. Voor engineeringteams is dit van belang wanneer een taak inhoudt dat vereisten moeten worden begrepen, een probleem in kleinere stappen moet worden opgedeeld, het resultaat moet worden gecontroleerd en fouten moeten worden gecorrigeerd.
Een model kan er ook sterk uitzien op een benchmark, terwijl het zich anders gedraagt op rommelige, echte inputs. Als je prompts onvolledige vereisten, grote hoeveelheden context of tegenstrijdige instructies bevatten, test dan hoe consistent elk model tot een nuttig resultaat komt in plaats van te vertrouwen op één enkel benchmarkcijfer.
Coding is meer dan het genereren van een functie vanuit een prompt. In een agentische engineering-workflow moet het model mogelijk bestaande code inspecteren, de oorzaak van een fout identificeren, meerdere bestanden wijzigen, tools uitvoeren, de output interpreteren en het opnieuw proberen.
Dit maakt agentisch gedrag bijzonder belangrijk. Wanneer je de twee modellen vergelijkt, kijk dan naar hoe vaak ze menselijke interventie nodig hebben, hoe goed ze herstellen van mislukte tool-calls en of ze een taak tot het einde kunnen volbrengen.
Voor teams die coding-agents bouwen, zijn taken op repository-niveau daarom informatiever dan een eenvoudige code-generatietest.
Langlopende taken brengen een andere set problemen met zich mee. Het model moet onthouden wat het probeerde te bereiken, voltooide stappen bijhouden en voorkomen dat het na meerdere tool-calls een ongerelateerd pad inslaat.
Dit is vooral relevant voor agents die onderzoek, softwareontwikkeling, data-analyse of meerstaps automatisering afhandelen. Een nuttige test is om beide modellen dezelfde taak te geven en niet alleen te meten of ze deze uiteindelijk voltooien, maar ook hoeveel correcties, herpogingen en menselijke interventies onderweg nodig zijn.
Output-kwaliteit hangt ook af van wat je applicatie van het model verlangt. Een chatbot die alleen korte tekst retourneert, heeft andere vereisten dan een applicatie die strikte JSON, lange code-outputs, tool-calls of gestructureerde antwoorden nodig heeft die rechtstreeks naar een ander systeem worden gestuurd.
Controleer de ondersteunde output-formaten, context- en outputlimieten, en hoe betrouwbaar het model een vereiste structuur volgt. Kleine fouten hier kunnen leiden tot extra parsing-, validatie- of herpogingswerk in productie.
Waarborgen kunnen een directe impact hebben op hoe een applicatie zich gedraagt. Een model kan sommige verzoeken weigeren, om verduidelijking vragen of delen van een antwoord beperken, afhankelijk van de aard van de taak.
Voor ontwikkelaars is het belangrijkste om te begrijpen hoe die waarborgen legitieme use-cases beïnvloeden. Test het model met representatieve prompts uit je applicatie in plaats van aan te nemen dat een algemene veiligheidsbeschrijving je alles vertelt over het gedrag in productie.
Er is geen enkele metriek die omvat of een model bij je workload past. De juiste keuze hangt af van wat je het vraagt om te doen en wat dat werk op schaal kost.
Een agent die bijvoorbeeld een lange coding-taak uitvoert, kan baat hebben bij sterk redeneervermogen en betrouwbaar tool-gebruik, terwijl een hoog-volume applicatie die duizenden kortere verzoeken verwerkt meer gewicht kan toekennen aan tokenprijzen, latency en voorspelbare output.
Dat is waarom Fable 5 en Opus 4.8 moeten worden geëvalueerd ten opzichte van de workload die je daadwerkelijk van plan bent uit te voeren. Vergelijk het voltooien van taken, herpogingen, latency, tokenverbruik en menselijke interventie samen met benchmarkscores en de officiële prijzen.
Dit is het deel dat gemakkelijk over het hoofd wordt gezien: Fable 5 en Opus 4.8 zijn rechtstreeks aan elkaar gekoppeld. Fable 5 wordt geleverd met classifiers voor waarborgen op het gebied van cyberbeveiliging, biologie/chemie en distillatie. Wanneer een verzoek er een triggert, draagt Fable 5 het over aan Opus 4.8 en wordt de gebruiker op de hoogte gesteld. Anthropic geeft aan dat dit in minder dan 5% van de sessies gebeurt.
Praktische implicaties:
Er is geen universele modelkeuze voor elke workload. Het geschikte model hangt af van vereiste mogelijkheden, kostenbeperkingen, verwachtingen rond latency en applicatiegedrag.
Je hoeft niet noodzakelijk te standaardiseren op één model. In productie kan een betere aanpak zijn om beide te gebruiken en te beslissen waar elk verzoek naartoe moet gaan.
Je zou bijvoorbeeld routinematige, hoog-volume verzoeken naar Opus 4.8 kunnen sturen en Fable 5 kunnen reserveren voor taken waar sterker redeneervermogen of een langere uitvoeringshorizon de extra kosten rechtvaardigt. Dit geeft je een manier om uitgaven te controleren zonder elk verzoek door hetzelfde model te jagen.
De routinglogica kan gebaseerd zijn op een paar praktische signalen:
Dit wordt veel eenvoudiger wanneer beide modellen via dezelfde gateway worden beheerd. Met de TrueFoundry AI Gateway kunnen Fable 5 en Opus 4.8 achter een enkel
OpenAI-compatibel endpoint zitten. Je kunt daarom het model wijzigen dat voor een verzoek wordt gebruikt, zonder afzonderlijke integraties voor elke provider of elk model te hoeven onderhouden.
De instelling kan vrij eenvoudig worden gehouden.
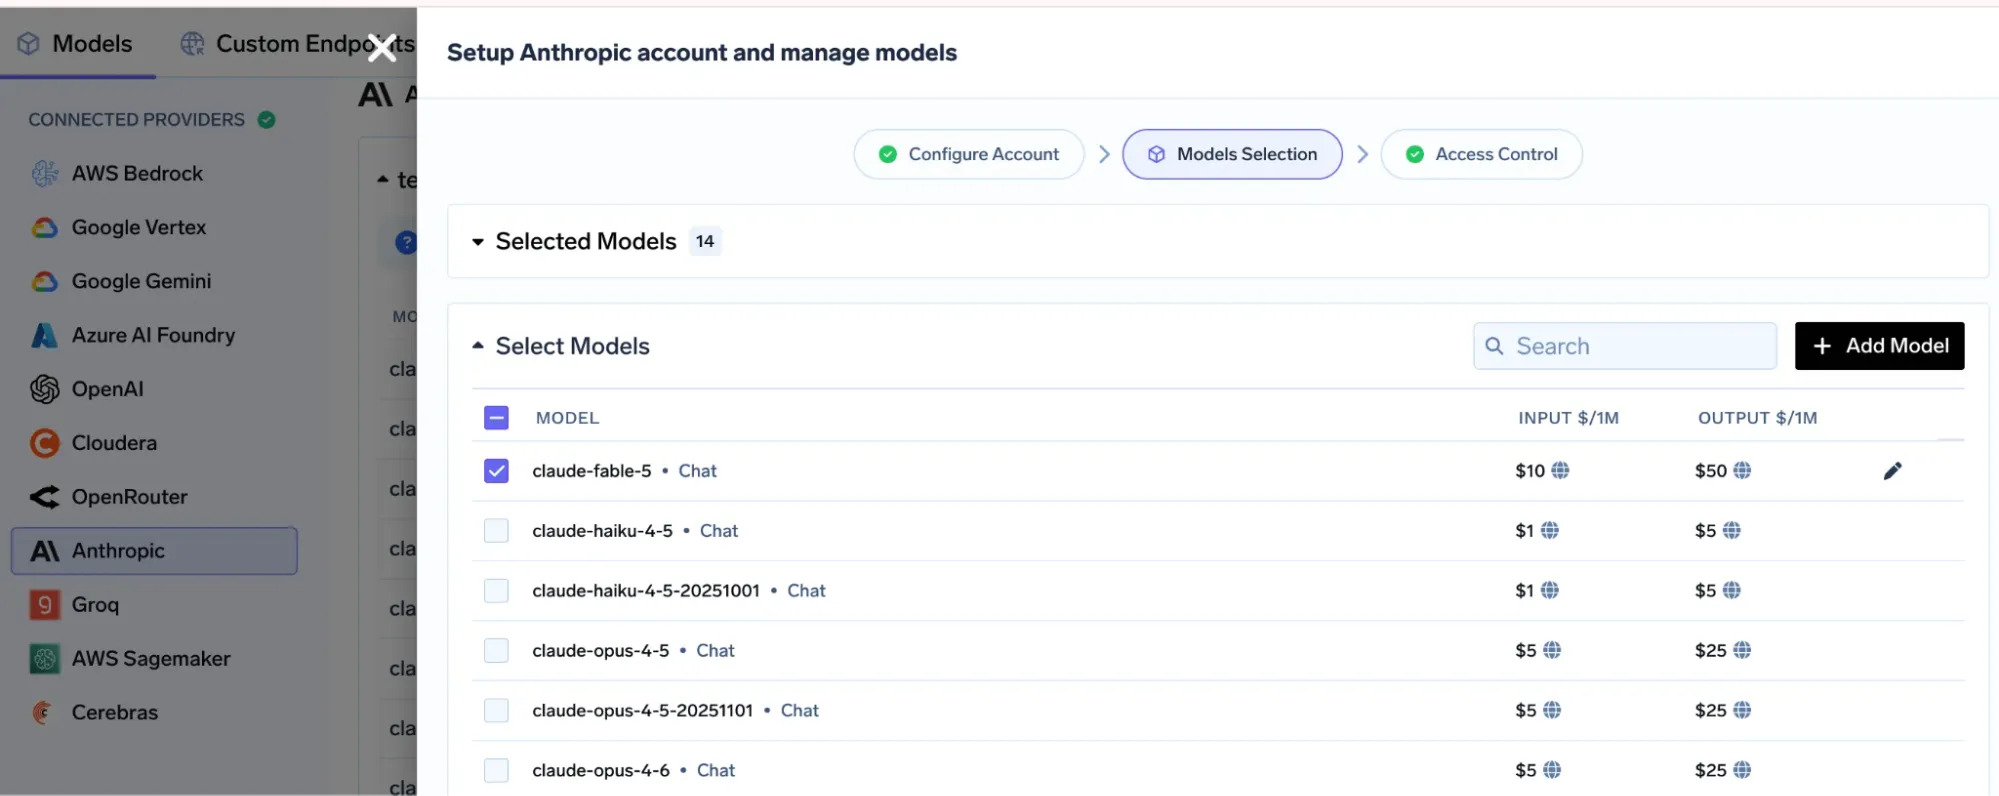
Schakel vanuit de verbonden Anthropic-provider in TrueFoundry claude-fable-5 en claude-opus-4-8 in via het Models Selection-scherm. Je kunt ook Access Control gebruiken om te bepalen welke teams of applicaties toegang hebben tot elk model.
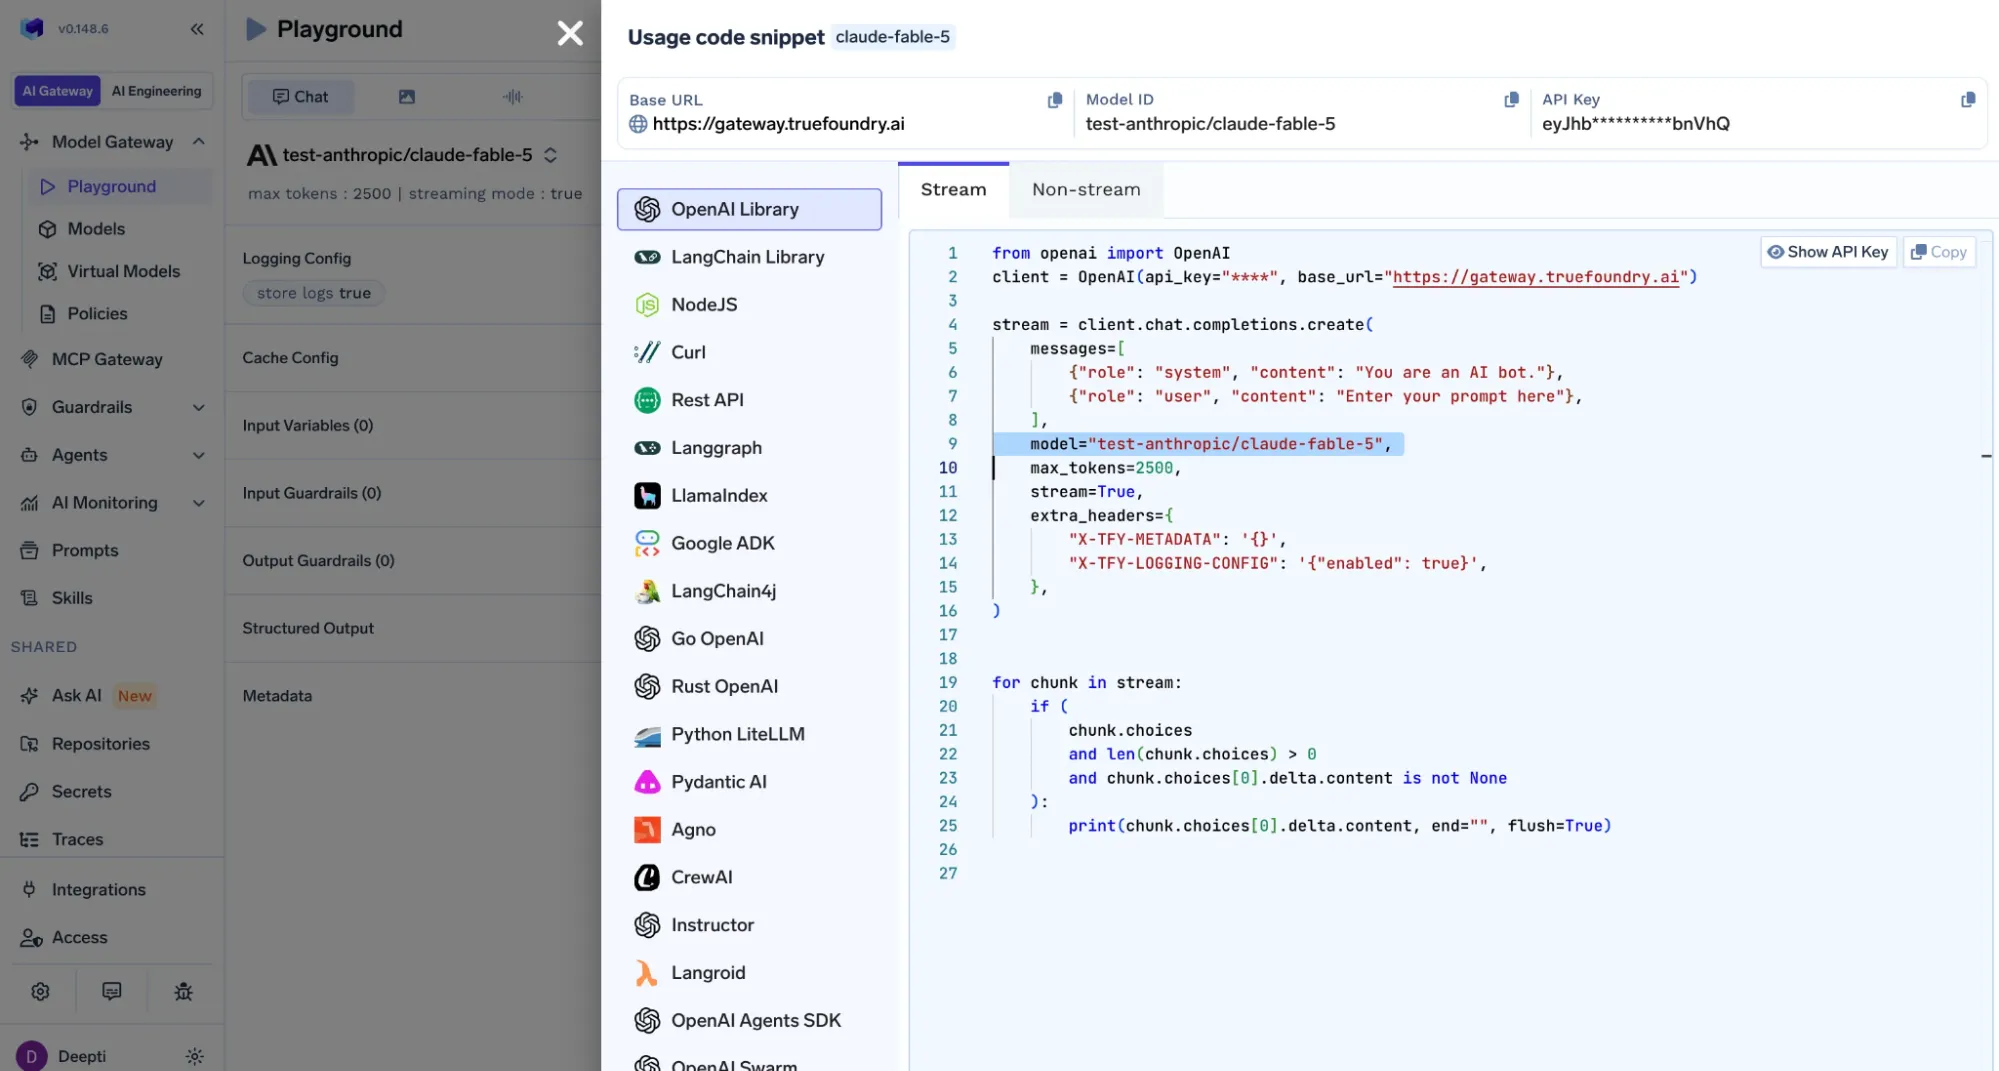
Selecteer vanuit de Playground het model dat je wilt gebruiken en kopieer het gebruikssnippet. Omdat beide modellen beschikbaar zijn via dezelfde gateway base-URL, komt het wisselen tussen de modellen voornamelijk neer op het wijzigen van de model-ID.
Dit geeft je ook de ruimte om de routingstrategie later aan te passen. Je zou kunnen beginnen met Opus 4.8 als standaard, geselecteerde workloads routen naar Fable 5, en die regels vervolgens aanpassen naarmate je echte gebruiksgegevens verzamelt.
Het belangrijke onderdeel is om de routingbeslissing te meten in plaats van deze als een eenmalige keuze te behandelen. Houd kosten, latency, taakvoltooiing, herpogingen, fouten en fallback-frequentie bij voor beide modellen. Als Fable 5 wordt gebruikt voor taken waar Opus 4.8 hetzelfde resultaat oplevert, heb je een duidelijke kans om uitgaven te verlagen. Als goedkopere routing leidt tot meer herpogingen of menselijke interventie, is de schijnbare besparing mogelijk geen echte besparing.
Dat maakt model-routing meer dan een manier om tussen twee API's te schakelen. Het wordt een manier om modelcapaciteit af te stemmen op workload-vereisten, terwijl je kosten en operationele controles op één plek houdt.
Meld je aan om te zien hoe TrueFoundry AI Gateway je helpt bij het routen van workloads over modellen, het beheersen van kosten en het beheren van AI-gebruik vanuit één OpenAI-compatibele gateway.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Anthropic’s published benchmarks show Fable 5 ahead on several demanding coding and reasoning tests, including SWE-Bench Pro and FrontierCode. The difference is more relevant for complex, long-running tasks; for routine workloads, Opus 4.8 may still meet your requirements at a lower cost.
Fable 5 costs $10 per million input tokens and $50 per million output tokens. Opus 4.8 costs $5 and $25 respectively. That makes Fable 5 roughly twice the price on both input and output tokens.
Anthropic says some flagged cyber, bio-chemical, or model-distillation requests may be routed from Fable 5 to Opus 4.8. This applies to a small share of sessions, and those requests are billed at the Opus 4.8 rate rather than the Fable 5 rate.
Fable 5 is positioned for more demanding reasoning, coding, and long-horizon agentic workloads. However, benchmark differences do not mean that Opus 4.8 cannot perform these tasks. The practical difference depends on task complexity, accuracy requirements, cost, and how much supervision your workflow needs.
Fable 5 is the newer, higher-priced model, while Opus 4.8 costs about half as much per input and output token. Their reported benchmark performance also differs, particularly on complex coding and reasoning workloads.
Yes. Both models can be accessed through the same TrueFoundry AI Gateway endpoint. You can route requests to either model using its model ID, allowing your application to switch between models without maintaining separate integrations.
Controleer de actuele modeldocumentatie voor implementatie, aangezien contextlimieten kunnen verschillen per model en API-configuratie. Contextvenstergrootte moet worden beoordeeld samen met outputlimieten, prijsstelling, en daadwerkelijke promptvereisten, in plaats van te worden behandeld als de enige capaciteitsmetric.
Yes. If you are selecting a model for a new deployment, compare the models currently available for your platform rather than relying only on a Fable 5 vs Opus 4.8 comparison. Anthropic's current documentation lists newer models, including Fable 5.1 and Opus 5.5.
For workloads where Opus 4.8 provides sufficient quality, its lower token price can make it a practical option. Teams can also use both models, routing more demanding tasks to Fable 5 while keeping routine or high-volume traffic on Opus 4.8.



Het laatste nieuws, artikelen en bronnen in je inbox























